Alibaba beendet benutzerdefinierte KI-Agenten? Alibaba hat angekündigt, dass vom Nutzer erstellte KI-Agenten auf Tongyi Qianwen vor der regulatorischen Frist am 15. Juli entfernt werden. Ähnliche Anpassungen wurden auch von ByteDance und Tencent kommuniziert, während sich chinesische KI-Plattformen an die neuen Vorschriften für anthropomorphe KI anpassen. Da generative Künstliche Intelligenz die Art und Weise verändert, wie Webinhalte und digitale Entitäten konsumiert werden, müssen KI-Plattformen weiterhin in einem sich wandelnden Compliance-Umfeld navigieren. Historisch gesehen steigerten personalisierte KI-Begleiter das Nutzerengagement durch die Förderung langfristiger Interaktionen. Da Regulierungsbehörden heute Risiken mindern wollen, die mit anthropomorphen KI-Interaktionen verbunden sind, müssen Plattformen auf streng geprüfte, nicht-personifizierte Produktivitätstools umstellen.
Warum Alibaba benutzerdefinierte KI-Agenten beendet: Plattformfunktionen im Einklang mit neuen Regeln
Auf einen Blick
- Alibabas Tongyi Qianwen und ByteDances Doubao haben die Deaktivierung von angepassten Agentenfunktionen angekündigt, die mit der Compliance-Frist am 15. Juli in Kraft treten.
- Der regulatorische Rahmen zielt auf KI-Systeme ab, die menschliche Persönlichkeiten für anhaltende emotionale Begleitung simulieren; rein transaktionsorientierte Tools sind ausgenommen.
- Der Plattformwandel markiert eine breitere strategische Neuausrichtung von Diensten für emotionale Begleitung hin zu streng geprüften, nicht-personifizierten Produktivitätsanwendungen.
Verbraucher-KI-Plattformen rücken mit Inkrafttreten neuer Vorschriften von personalisierten Begleitfunktionen ab. In den letzten zwei Jahren wurden angepasste KI-Begleiter zu einem der beliebtesten Features auf Verbraucher-KI-Plattformen. Durch die Aufrechterhaltung eines langfristigen Konversationsgedächtnisses und konsistenter Persönlichkeiten förderten diese Dienste wiederholte Nutzerinteraktionen. Das wachsende regulatorische Interesse hat jedoch die Prioritäten der Plattformen in Richtung Compliance, Transparenz und aufgabenorientierter KI-Erfahrungen verschoben.
Die Verwaltung von dauerhaftem Gedächtnis, emotionalen Interaktionen und Jugendschutz bei hoher Skalierung hat die operative Komplexität deutlich erhöht. Diese Herausforderungen werden in detaillierten regionalen Berichten erörtert, die die operativen Veränderungen der großen Plattformen nachverfolgen.
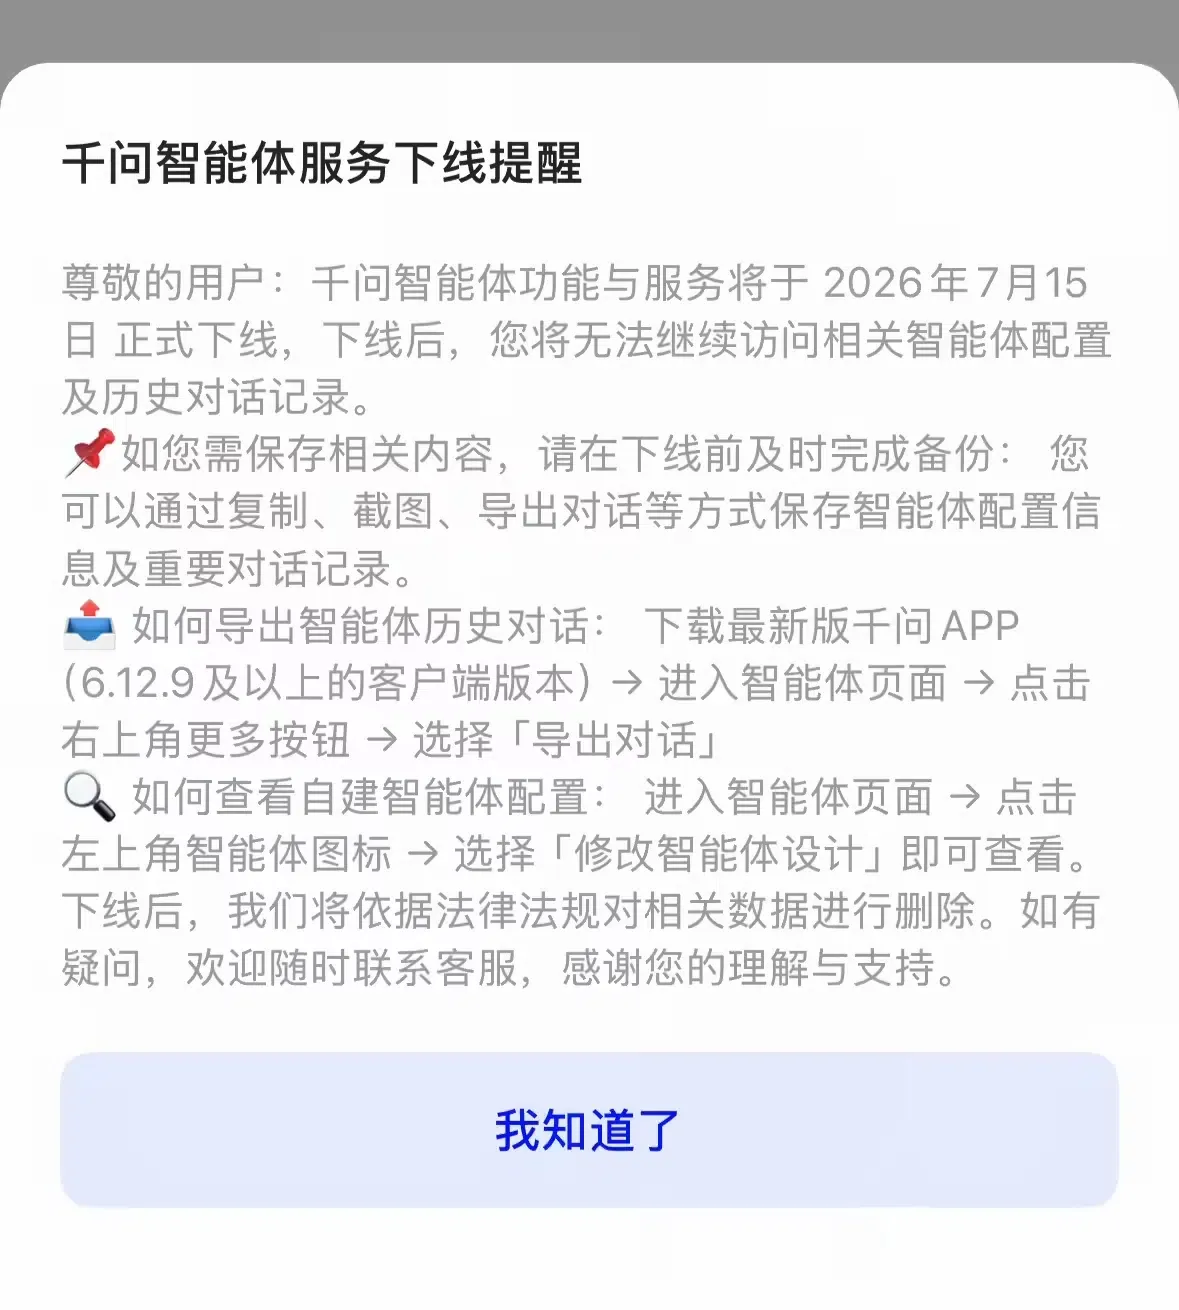
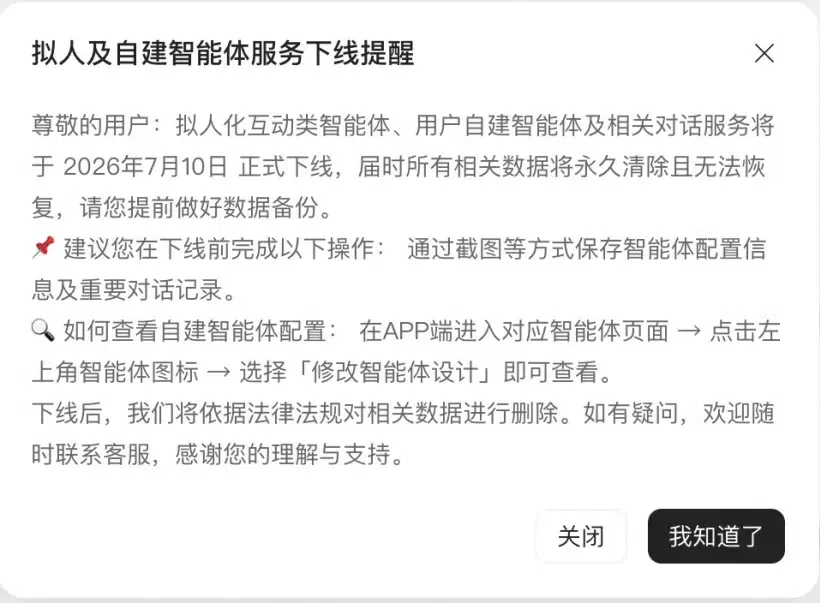
Diese Entscheidung spiegelt einen breiteren Branchentrend wider. Laut der Plattform-Benachrichtigung werden vom Nutzer erstellte Konfigurationen und Gesprächsprotokolle auf Tongyi Qianwen deaktiviert, gefolgt von einer Datenlöschung gemäß der veröffentlichten Datenaufbewahrungsrichtlinie der Plattform. Gleichzeitig kündigte ByteDance an, dass die Doubao-Agentenfunktion am 15. Juli 2026 offline gehen wird, mit einer Nachfrist zur Datensicherung bis zum 15. Oktober 2026. Medienberichten zufolge hat Tencent seine Yuanbao-Assistenten-App ähnlich angepasst und bestimmte persönliche Begleitkonfigurationen im Juni entfernt. Im Rahmen dieser regulatorischen Umstellung sollen Plattformen Produktivität gegenüber Personifizierung priorisieren und Ressourcen von emotionalen Begleit-Bots hin zu Arbeitsplatz-Assistenten und Unternehmens-Tools lenken.
Verständnis der Hintergründe hinter der Alibaba-Richtlinie zum Ende benutzerdefinierter KI-Agenten
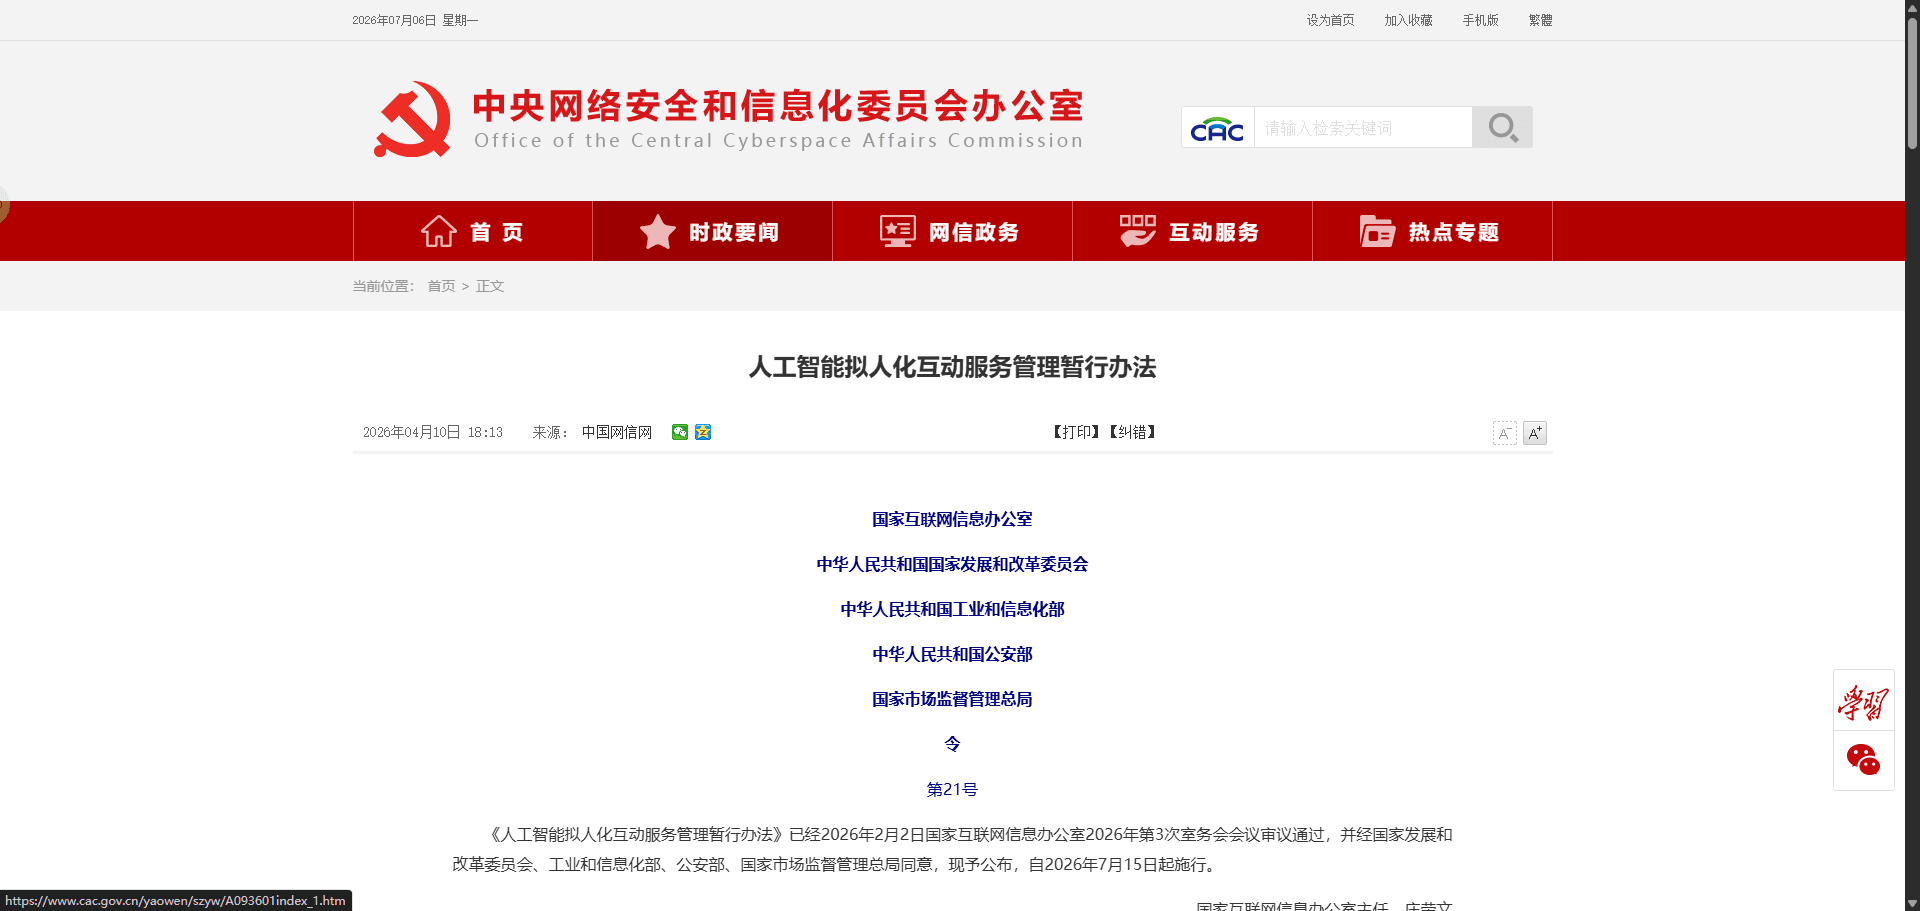
Der grundlegende Faktor für die plötzliche Deaktivierung dieser Begleitfunktionen ist die offizielle Durchsetzung der neu erlassenen Vorschriften für Dienste zur anthropomorphen KI-Interaktion (《人工智能拟人化互动服务管理暂行办法》), die am 15. Juli 2026 in Kraft treten. Dieser regulatorische Rahmen stellt einen umfassenden Versuch dar, eine Aufsicht für KI-Dienste zu etablieren, die menschliche Persönlichkeiten, Denkmuster und Kommunikationsstile simulieren. Die Verordnung adressiert verschiedene Bedenken, darunter das Potenzial für emotionale Abhängigkeit oder Konsuminduktion bei Minderjährigen, die Preisgabe personenbezogener Daten und die Verbreitung ungeprüfter Informationen.
Wichtig ist, dass die Verordnung eine klare Grenze zwischen verbotenen Begleit-Bots und erlaubten Utility-Tools zieht. Kundenservice-Bots, Wissens-Q&A-Plattformen, Arbeitsassistenten für Unternehmen und Bildungsressourcen sind von diesen strengen Beschränkungen ausgenommen, sofern sie keine anhaltende, menschlich simulierte emotionale Interaktion beinhalten. Diese regulatorische Aufteilung zwingt Entwickler dazu, ihre Systemarchitekturen von zustandsbehafteten, persönlichkeitsspeichernden Chat-Schleifen auf saubere, zustandslose Transaktions-APIs umzustellen.
Technische Unterscheidung: Zustandsbehaftete Identität vs. Zustandslose Compliance
Um diese Compliance-Anforderungen zu erfüllen, wird von Engineering-Teams erwartet, ihre Datenbankstrukturen anzupassen. Die Aufrechterhaltung einer dauerhaften Agenten-Persona erfordert typischerweise das Speichern von Nutzerpräferenzdaten oder eines langfristigen Konversationsgedächtnisses. Unter den neuen Vorschriften stellt diese zustandsbehaftete Nachverfolgung eine Compliance-Herausforderung dar. Im Gegensatz dazu verarbeiten zustandslose Architekturen jede Anfrage als isolierte Transaktion, was die Menge der vom Plattformbetreiber gespeicherten, dauerhaften Nutzerdaten reduziert.
Das Diagramm unten veranschaulicht den strukturellen Unterschied zwischen diesen beiden Datenflüssen:
[Zustandsbehaftete Persona-Speicherung (Hohes regulatorisches Risiko)]
  Nutzereingabe ──> Persona-Gedächtnis-Cache (Persistente Identitätsprofile) ──> Langfristiges emotionales Profil protokolliert


[Zustandsloser Sitzungsfluss (Risikoarmes Compliance-Ziel)]
  Nutzereingabe ──> Zustandsloser Verarbeitungsknoten (Kurzlebiger Sitzungskontext) ──> Temporärer Kontext (Souveräner Kontext bewahrt)
Die Implementierung einer zustandslosen Verarbeitung stellt sicher, dass kein persistenter, emotional manipulativer Kontext generiert oder gespeichert wird. Ähnliche Herausforderungen bestehen bei der mobilen Attribution, bei der Datenschutzbeschränkungen ebenfalls die Abhängigkeit von persistenten, clientseitigen Identifikatoren verringern. Wenn Nutzerinteraktionen von dauerhaften, zustandsbehafteten lokalen Cookies entkoppelt werden, um Datenschutzrichtlinien zu erfüllen, wird die Aufrechterhaltung einer nahtlosen Sitzungskontinuität über verschiedene Umgebungen hinweg äußerst komplex. Wenn beispielsweise Standard-Browser-Referrer fehlen oder Cookies blockiert werden, müssen mobile Attributionssysteme auf serverseitige Zustandsabgleiche zurückgreifen, um separate Ereignisse zu korrelieren, ohne den Datenschutz der Nutzer zu beeinträchtigen.
Build vs. Buy: Management des Sitzungszustands unter neuen Compliance-Regeln
Während Plattformen ihre Konversationsframeworks umstrukturieren, um dem Mandat vom 15. Juli zu entsprechen, müssen Entwickler ihre Strategien zum Management von Sitzungszustand und Nutzeridentität neu bewerten. Die Verwaltung von Sitzungszuständen in der Ära nach dem Ende benutzerdefinierter KI-Agenten bei Alibaba erfordert Architekturen, die sowohl datenschutzkonform als auch hochpräzise sind. Unternehmen, die Nutzerreisen über Web- und Mobile-Erfahrungen hinweg bewahren müssen, setzen zunehmend auf serverseitiges Sitzungsmanagement statt auf persistente, clientseitige Identifikatoren. Abhängig von den geschäftlichen Anforderungen können Teams diese Fähigkeiten intern aufbauen oder bestehende Attributionsplattformen nutzen.
Architektonische Bewertung: Eigenentwicklung vs. standardisiertes SDK
Der Aufbau eines internen Systems für serverseitiges Zustands-Matching bietet maximale Flexibilität, erfordert jedoch erhebliche laufende Engineering-Ressourcen. Entwickler müssen manuell Datenbankschemata konstruieren, sichere kryptografische Hashing-Funktionen schreiben und das System kontinuierlich aktualisieren, um sich ändernden regionalen Vorschriften zu entsprechen. Im Gegensatz dazu reduziert die Bereitstellung eines vorgefertigten, zertifizierten SDK die Integrationskomplexität und garantiert langfristige Compliance ohne zusätzlichen Overhead.
Die folgende Tabelle vergleicht Standardmethoden zur Verwaltung von Sitzungszustand und Konversionskontext:
| Lösung | Persistenter Speicher | Compliance-Aufwand | Wartungsaufwand |
|---|---|---|---|
| Interne Sitzungsdatenbank | Hoch (kontinuierliche Synchronisation) | Hoch (manuelle Prüfung) | Extrem hoch |
| Browserbasiertes Sitzungs-Tracking | Niedrig (Sitzungs-Cookies) | Niedrig (keine Server-Protokollierung) | Niedrig |
| Serverseitiges Caching (z.B. OpoInstall) | Keiner (kurzlebige Token-Zuordnung) | Hoch (standardisierte Sandbox) | Niedrig (einfache Integration) |
Während benutzerdefinierte Datenbankkonfigurationen grundlegenden Kontext verarbeiten können, kann eine spezialisierte serverseitige Zustandsbewahrung Entwicklungsressourcen optimieren. Abhängig von den Implementierungsanforderungen können Unternehmen ihr eigenes serverseitiges Sitzungsmanagementsystem aufbauen oder kommerzielle Plattformen wie OpoInstall nutzen. OpoInstall bietet beispielsweise Frameworks zur serverseitigen Wiederherstellung des Zustands und zur Parameterdurchleitung, wobei Sitzungs-Metadaten einer serverseitigen Sitzungsdatenbank zugeordnet werden, um die Kontinuität anonym zu wahren, ohne sensible, langfristige persönliche Konversationshistorien zu speichern. Durch die Zuordnung von Sitzungs-Metadaten zu einer zentralen Datenbank, anstatt sich auf browserbasierte Redirects zu verlassen, stellt ein solches System sicher, dass Konversionskontexte konsistent bleiben, selbst wenn ursprüngliche Aufgaben anonym ausgeführt werden. Engineering-Teams können diese Ansätze bewerten, um Datenschutz und Messkonsistenz in Einklang zu bringen.
Integrations-Checklisten: Wie Engineering-Teams sich auf Plattformänderungen vorbereiten können
Um das plötzliche Deaktivieren zustandsbehafteter Agentenfunktionen zu überstehen, müssen Engineering- und Produkt-Teams klare Data-Governance-Zeitpläne erstellen. Dies stellt sicher, dass Nutzerdaten sicher behandelt werden, Compliance-Grenzen respektiert werden und Marketing-Pipelines intakt bleiben.
Checkliste für die Entwickler-Implementierung
- Audit der Datenaufbewahrung von Sitzungen: Überprüfen Sie alle Datenbanken, um sicherzustellen, dass persistente, emotional begleitende Chat-Verläufe gemäß den Datenlöschfristen bereinigt werden.
- Implementierung zustandsloser Sitzungs-Handshakes: Stellen Sie API-Routen auf zustandslose Verarbeitungsmodelle um und nutzen Sie kryptografisch signierte Token, um temporären Kontext zwischen Knoten zu übertragen.
- Durchsetzung von Altersverifizierungs-Gateways: Setzen Sie bei verbraucherorientierten Produkten Jugendschutzvorkehrungen ein, um Minderjährigen den Zugriff auf eingeschränkte Konversationsfunktionen zu verwehren.
Checkliste für Produkt- & Wachstumsstrategie
- Reorganisation von User Experience Flows: Schwenken Sie von begleiterbasierten Engagement-Modellen hin zu aufgabenorientierten, hochfunktionalen Tools, die nicht auf emotionaler Abhängigkeit basieren.
- Optimierung von Konversionstrichtern: Nutzen Sie nicht-intrusive Frameworks zur Parameterdurchleitung, um das Akquisitions-Tracking ohne Verletzung von Datenschutzrichtlinien aufrechtzuerhalten.
- Überwachung der Plattform-Compliance: Stellen Sie sicher, dass alle integrierten SDKs von Drittanbietern den lokalen Datenschutzgesetzen und dem anstehenden Mandat vom 15. Juli entsprechen.
Durch die Etablierung dieser strukturierten Richtlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die operative Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Welche KI-Funktionen sind unter den neuen Vorschriften weiterhin erlaubt?
Was ist der Unterschied zwischen einem verbotenen Begleit-Bot und einem erlaubten Arbeitsassistenten?
Was passiert mit den Daten benutzererstellter Agenten nach dem Stichtag 15. Juli?
Wichtige Erkenntnisse für Engineering-Teams
Da KI-Plattformen sich von persistenten Begleitfunktionen entfernen, müssen Entwickler Produkte auf Privatsphäre, Transparenz und konformes Datenmanagement ausrichten. Während regionale Cyberspace-Regulierungsbehörden Grenzen für emotionale Interaktion und Nutzerprofilierung durchsetzen, müssen Entwickler durch die Konzeption widerstandsfähiger, datenschutzfreundlicher Systeme reagieren. Das Vertrauen auf zustandsbehaftete, identitätsverfolgende Cookies und persistente Kontextprofile ist für moderne digitale Plattformen keine nachhaltige Strategie mehr.
Während sich KI-Plattformen an neue regulatorische Anforderungen anpassen, werden Engineering-Teams zunehmend auf zustandslose Architekturen, serverseitiges Sitzungsmanagement und Privacy-by-Design setzen. Organisationen, die sich frühzeitig auf diese Veränderungen vorbereiten, sind besser positioniert, um konforme und nachhaltige KI-Produkte zu betreiben.
Share this article



