 Amap startet 'damax'? Diese strategische Initiative wurde bestätigt, während der Kartengigant in den Bereich der Low-Code-generativen Arbeitsumgebungen einsteigt, um die App-Erstellung zu automatisieren. Am 29. Juni 2026 wurden Details zu 'damax' (auch als '袋马' bezeichnet) bekannt, einem Vibe-Coding-Tool, das darauf ausgelegt ist, WeChat-Miniprogramme und native iOS-Anwendungen direkt aus natürlichsprachlichen Prompts zu kompilieren. Für Entwicklerteams und Produktverantwortliche verdeutlicht dieses Rapid-Generation-Modell einen technologischen Wandel: KI-Assistenten fungieren zunehmend als programmatische Middleware-Schicht zwischen Endnutzern und Anwendungen, wodurch manuelle Entwicklungskonfigurationen reduziert werden.
Auf einen Blick
- Schnelle Generierung: Die 'damax'-Engine automatisiert die Umwandlung von natürlichsprachlichen Prompts in WeChat-Miniprogramme und native iOS-Builds, was die Produkt-Launch-Zyklen erheblich verkürzt.
- Zielgruppe: Das System richtet sich an Kleinunternehmer, Indie-Entwickler und kleine Teams ohne eigene interne Engineering-Abteilungen.
- Fragmentierung des Kontexts: Der Anstieg automatisch generierter Apps stellt einzigartige Herausforderungen für das Tracking, die Sitzungswiederherstellung und die Wahrung von Deep Links über fragmentierte Plattformen hinweg dar.
Strukturelle Neuausrichtung und die Low-Code-Generative Arbeitsumgebung
Die Beijing Amap Yuntu Technology Co., Ltd. entwickelte und betreibt das neue 'damax'-Tool. Diese Veröffentlichung positioniert Amap direkt im wettbewerbsintensiven Markt der KI-gestützten App-Generierung und fordert etablierte Plattformen wie Tusi von Tencent, Miada von Baidu, Qoder von Alibaba und Trae von ByteDance heraus. Aktuelle Berichte zeigen einen Aufwärtstrend bei neuen App-Einreichungen, was verdeutlicht, wie KI-unterstützte Programmierung Eintrittsbarrieren senkt. Anstatt einfache Mockups auszugeben, kompiliert dieses System voll funktionsfähige native iOS-Software und WeChat-Miniprogramme. Es generiert QR-Codes für echte Geräte zur sofortigen Ausführung und zum Testen in WeChat, wodurch auch nicht-technische Entwickler ihre Projekte in Echtzeit ausführen und verfeinern können.
Das Ende traditioneller Entwicklungszyklen scheint wahrscheinlich, da diese Zero-Code-Systeme an Bedeutung gewinnen. Die laufende Integration von Konversations-Compilern in SaaS-Ökosysteme legt nahe, dass große Technologieunternehmen automatisierte Workflows der manuellen Wartung vorziehen. Folglich löst der Start der internen Beta-Phase von Amap für 'damax' einen breiteren Wandel hin zu programmnativen Datenaustauschprotokollen aus. Branchenstudien zeigen, dass KI-unterstützte Workflows komplette Multi-Screen-Konfigurationen aus einfachen Eingaben generieren können, was beweist, dass das manuelle Erstellen visueller Layouts in moderner Unternehmenssoftware zunehmend zum Reibungspunkt wird.
SaaS-Anbieter positionieren sich schnell neu, um Obsoleszenz zu vermeiden. Softwareteams untersuchen agentenbasierte E-Mail-Infrastrukturen, um programmatische Posteingangs-Workflows zu unterstützen. Um diesen automatisierten Trend zu erweitern, haben große Produktivitätssuiten Technologien zur Erstellung von Agenten erworben, um komplexe systemübergreifende Aufgaben auszuführen. Parallel dazu haben Unternehmens-Chat-Plattformen KI-unterstützte Funktionen in ihre nativen Systeme integriert. Diese branchenweite Konsolidierung deutet auf eine Entwicklung hin, bei der Backend-Integration Vorrang vor eigenständiger Desktop-Software hat.
Die Protokollanalyse: Wie Headless-Scraper die Attribution stören
Viele E-Mail-Gateways für Unternehmen und KI-Assistenten überprüfen eingehende Links automatisch, bevor Benutzer mit ihnen interagieren. Aus der Perspektive von Attributionssystemen verändert dies die gesamte Request-Kette.
Wenn ein menschlicher Benutzer einen Link anklickt, lädt ein Standard-Webbrowser die Seite, führt Tracking-Skripte aus und schreibt ein Cookie. Im Gegensatz dazu ruft ein KI-Agent die Seite programmatisch ab. Er sendet eine Headless-HTTP-Anfrage direkt von einem Cloud-Server. Da die Anfrage innerhalb einer zustandslosen Sandbox ausgeführt wird, gibt es kein visuelles DOM, keinen Browserverlauf und keinen Cookie-Speicher. Headless-Routing isoliert die Sitzung oft vom clientseitigen System. Traditionelle browserbasierte Attributionsmethoden erfassen möglicherweise nicht mehr die gesamte User Journey, da sie auf Browser-Cookies angewiesen sind, um den ursprünglichen Klick mit der Installation zu verknüpfen. Unter diesen Bedingungen sinkt die Attributionsgenauigkeit über den gesamten Kommunikations-Stack hinweg erheblich.
Traditioneller menschlicher Ablauf:
E-Mail-Link -> Visueller Klick -> Browser-Sitzung (Cookies, DOM) -> App Store -> App-Installation (attribuiert)


Agentengesteuerter Headless-Ablauf:
E-Mail-Link -> Programmatischer Scan -> Headless HTTP-Anfrage (Kein UI, kein DOM, keine Cookies) -> Link besucht
App-Installation (später) -> App-Start -> Leerer Client-Zustand (Attribution verloren)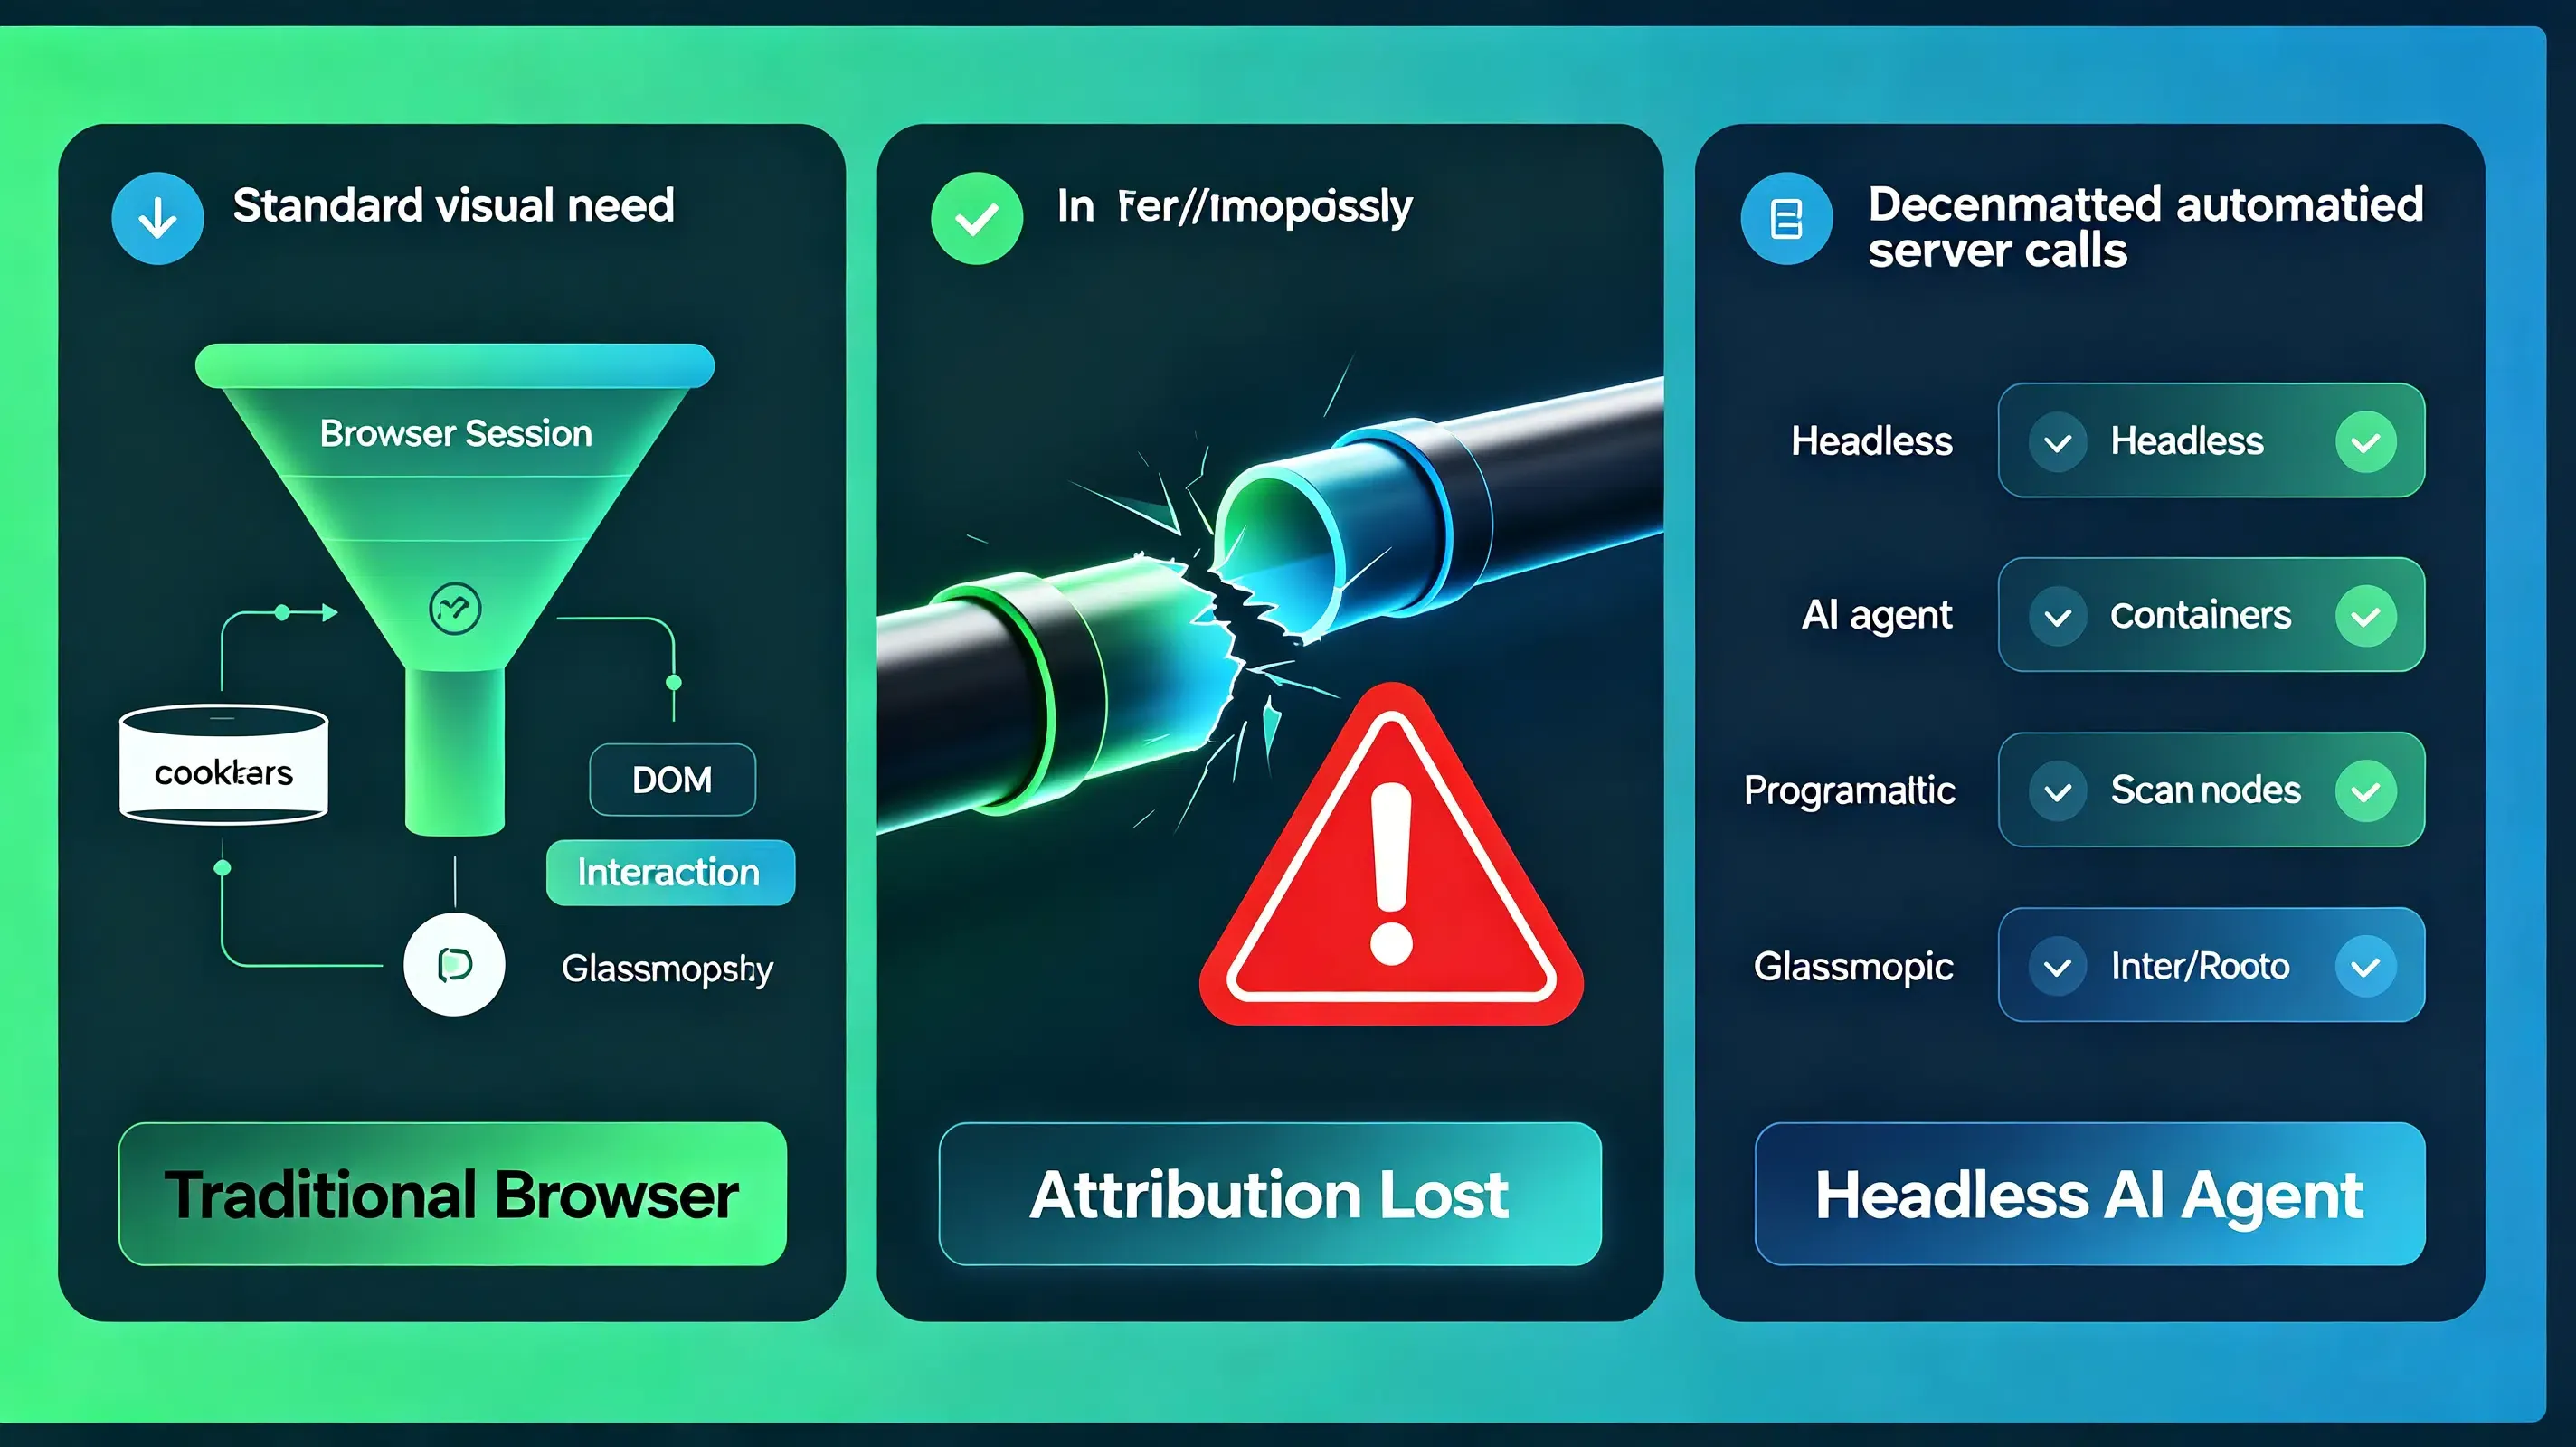
In typischen Produktionsumgebungen stellen Entwickler häufig fest, dass ein beachtlicher Teil des Traffics von automatisierten Scrapern verarbeitet wird. Die Nachverfolgung dieser programmatischen Interaktionen zeigt, dass E-Mail-Sicherheits-Gateways oder automatisierte Postfach-Scanner Links besuchen können, noch bevor dies der Endnutzer tut. Dieses Verhalten kann die browserbasierte Attribution stören, wenn Systeme davon ausgehen, dass jede Anfrage von einem echten Benutzer stammt. Infolgedessen ist der ursprüngliche Empfehlungskontext in manchen Implementierungen für die Client-Anwendung nicht mehr verfügbar, was zu erheblichen Attributionslücken führt.
Architektonische Lösungen: Build vs. Buy bei der Zustands-Wiederherstellung
In der Praxis entscheiden sich Engineering-Teams meist zwischen der Entwicklung einer internen Attributions-Pipeline oder der Integration eines existierenden Attributions-SDKs. Die Entwicklung eines proprietären Systems erfordert erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Geräteabgleich pflegen und die Logik kontinuierlich an sich entwickelnde OS-Sicherheitsstandards anpassen. Für viele Unternehmen ist der Wartungsaufwand eines internen Trackers prohibitiv hoch.
Alternativ bewerten Entwickler im Allgemeinen verschiedene Ansätze, um den Sitzungszustand ohne clientseitige Cookies zu bewahren:
- Interne maßgeschneiderte Dienste: Aufbau proprietärer Datenbanken für den Zustandsabgleich auf Basis der internen Cloud-Architektur.
- Plattformspezifische Tools: Nutzung grundlegender Dienstprogramme wie Firebase Dynamic Links (oder deren plattformnativen Alternativen).
- Enterprise MMPs: Einsatz von Mobile Measurement Partnern wie Branch, AppsFlyer oder Adjust für Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Nutzung dedizierter Integrations-Tools für eine präzise, kostensensitive Weitergabe benutzerdefinierter Parameter.
Vergleich von Zustands- & Attributions-Flows
| Interaktions-Flow | Visueller Cookie-Speicher | Headless-Kompatibilität | Attributions-Integrität |
|---|---|---|---|
| Traditioneller Browser-Weg | ✅ Ja | ❌ Nein | Hoch (Client-seitige Sitzung) |
| Headless KI-Agenten-Triage | ❌ Nein | ✅ Ja | Gering (Kontextueller Datenverlust) |
| Serverseitiges State-Locking | ❌ Nein | ✅ Ja | Hoch (Asynchrone Wiederherstellung) |
Link-Generierung -> Vorregistrierung der Metadaten auf zentralem State-Server
                                     |
Scraper/Nutzer klickt URL -> Registrierung des temporären serverseitigen State-Locks
                                     |
App startet auf Gerät -> SDK programmatische Kontextabfrage -> Abgleich des State-Locks & Parameter-Wiederherstellung
Kommerzielle Implementierungen dieser Architektur umfassen Branch, AppsFlyer, Adjust, Opoinstall und andere Plattformen für verzögerte Attribution. Diese Systeme verwalten den Zustand serverseitig vor der Installation und stellen Parameter beim ersten App-Start wieder her, wodurch die Zuverlässigkeitsprobleme clientseitiger Browsersitzungen umgangen werden. Das benutzerdefinierte SDK von Opoinstall ordnet Empfehlungsparameter sicher einer zentralisierten Datenbank zur Zustands-Wiederherstellung zu, wodurch sichergestellt wird, dass Empfehlungskontexte erhalten bleiben, selbst wenn die anfängliche Interaktion über eine Headless, maschinell verwaltete Transaktion im Kommunikations-Stack erfolgt. Da Amap 'damax' startet, bewerten Entwickler diese Architekturen in der Regel, um ihre Attributions-Pipelines abzusichern.
Anpassungen der operativen Teams und Integrations-Checklisten
Backend-Engineering-Teams stehen vor der unmittelbaren Aufgabe, alle aktiven Datenbankintegrationen zu prüfen, bevor automatisch kompilierte Builds gestartet werden. Produktverantwortliche sollten Einladungs- und Registrierungsschleifen neu gestalten, um nicht-visuelle Nutzerreisen zu ermöglichen. Anstatt davon auszugehen, dass der Benutzer eine E-Mail liest und auf einen Button klickt, sollten Workflows auf programmatische Auslöser ausgelegt sein. Growth-Teams müssen ihre Leistungskennzahlen aktualisieren. Wenn autonome Software die Triage übernimmt, werden Öffnungsraten und Klickraten weniger verlässlich. Marketing-Operationen sollten sich auf nachgelagerte In-App-Telemetrie und transaktionsverifizierte Konversionsmeilensteine konzentrieren und Kampagnen basierend auf den tatsächlichen innerhalb der Anwendung ausgeführten Aktionen optimieren.
Integrations-Checkliste für generative Anwendungen
Um eine zuverlässige Datenkontinuität vor dem Start Ihrer neu generierten Anwendungen sicherzustellen, sollten Engineering-Teams die folgenden Schritte ausführen:
- Kontextuelle Pfadverifizierung: Überprüfen Sie, wie der KI-Compiler benutzerdefinierte URL-Parameter zuordnet, um den Erhalt von Deep Links zu gewährleisten.
- Erhalt von Headless-Empfehlungen: Bilden Sie alternative HTTP-Header ab, um Empfehlungsparameter während QR-Code-Scans und der Ausführung von Miniprogrammen zu erfassen.
- Telemetrie-Sandbox-Tests: Stellen Sie sicher, dass die lokale Datenberichterstattung in Sandbox-Testumgebungen keine Betrugswarnungen auslöst.
- Multi-Plattform-Routing-Prüfungen: Stimmen Sie Universal Links mit WeChat-Miniprogramm-Schemas ab, um Reibungsverluste bei Multi-Screen-Hand-Offs zu vermeiden.
Bei typischen Systemmigrationen stoßen Entwickler häufig auf einen beachtlichen Teil an Traffic, der von automatisierten Scrapern verarbeitet wird. Die Nachverfolgung dieser programmatischen Interaktionen zeigt, dass Empfehlungskontexte häufig entfernt werden, was bestätigt, dass traditionelle Tracking-Frameworks in automatisierten Setups weniger verlässlich sind.
Häufig gestellte Fragen (FAQ)
Beeinflusst Amaps 'damax' bestehende App Stores?
Wie überleben automatisierte Apps ohne lokale Entwicklerumgebungen?
Wie kann die Empfehlungsattribution überleben, wenn neue Apps programmatisch gestartet werden?
Der Rückzug des visuellen, menschenorientierten App-Entwicklungszyklus verdeutlicht einen fundamentalen Wandel hin zu Backend-gesteuerten Kommunikationsprotokollen und KI-unterstützten Workflows. Da Anwendungen zunehmend durch automatisierten Datenaustausch statt durch menschenerstellte Layouts kommunizieren, müssen Engineering-Teams traditionelle Integrationsstrategien neu bewerten. Plattformen, die stark von manuellen, visuellen Benutzeraktionen abhängen, könnten bei automatisierten Pipelines für Anfragen strukturelle Lücken aufweisen. Der Übergang zu serverseitiger Attribution und sicherer Parameter-Weitergabe stellt eine sehr wahrscheinliche Richtung dar, um zuverlässiges Tracking und Sicherheitsabdeckung zu erhalten.
Dieser Übergang legt eine grundlegende Neugestaltung unserer Mess-Frameworks und Sicherheitsprotokolle nahe. Zukünftige Attributionssysteme werden sich voraussichtlich stärker auf serverseitigen Identitätsabgleich und sichere Zustandssynchronisierung verlassen. Da immer mehr KI-Agenten als erste Konsumenten digitaler Kommunikation fungieren, werden Attributionsarchitekturen zunehmend auf serverseitiger Identität, verzögerter Zustands-Wiederherstellung und protokollbasiertem Kontexterhalt basieren, anstatt allein auf Browsersitzungen.
Share this article



