Anthropic startet „Sonnet 5“? Anthropic hat am 30. Juni Claude Sonnet 5 veröffentlicht und ersetzt damit Claude Sonnet 4.6 in allen Tarifen, wie in der offiziellen Ankündigung von Anthropic detailliert dargelegt wird. Obwohl die veröffentlichten Listenpreise des Modells niedriger sind, hängen die tatsächlichen Einsatzkosten stark von der Art der Arbeitslast, den Cache-Trefferraten und den Eingabeformaten ab. Aufgrund der Token-Inflation durch den aktualisierten Tokenizer können die API-Kosten in produktiven Szenarien mit stark strukturiertem Code deutlich ansteigen, wodurch das neue Modell in vielen typischen Einsatzbereichen nicht günstiger als Claude Opus 4.8 ist. Diese Veröffentlichung unterstreicht eine breitere Entwicklung in der KI-Entwicklung für Unternehmen: Die Bewertung eines Modells umfasst heute nicht mehr nur die Benchmark-Leistung, sondern auch das Tokenisierungsverhalten, die Caching-Effizienz und die Gesamtbetriebskosten.
Auf einen Blick
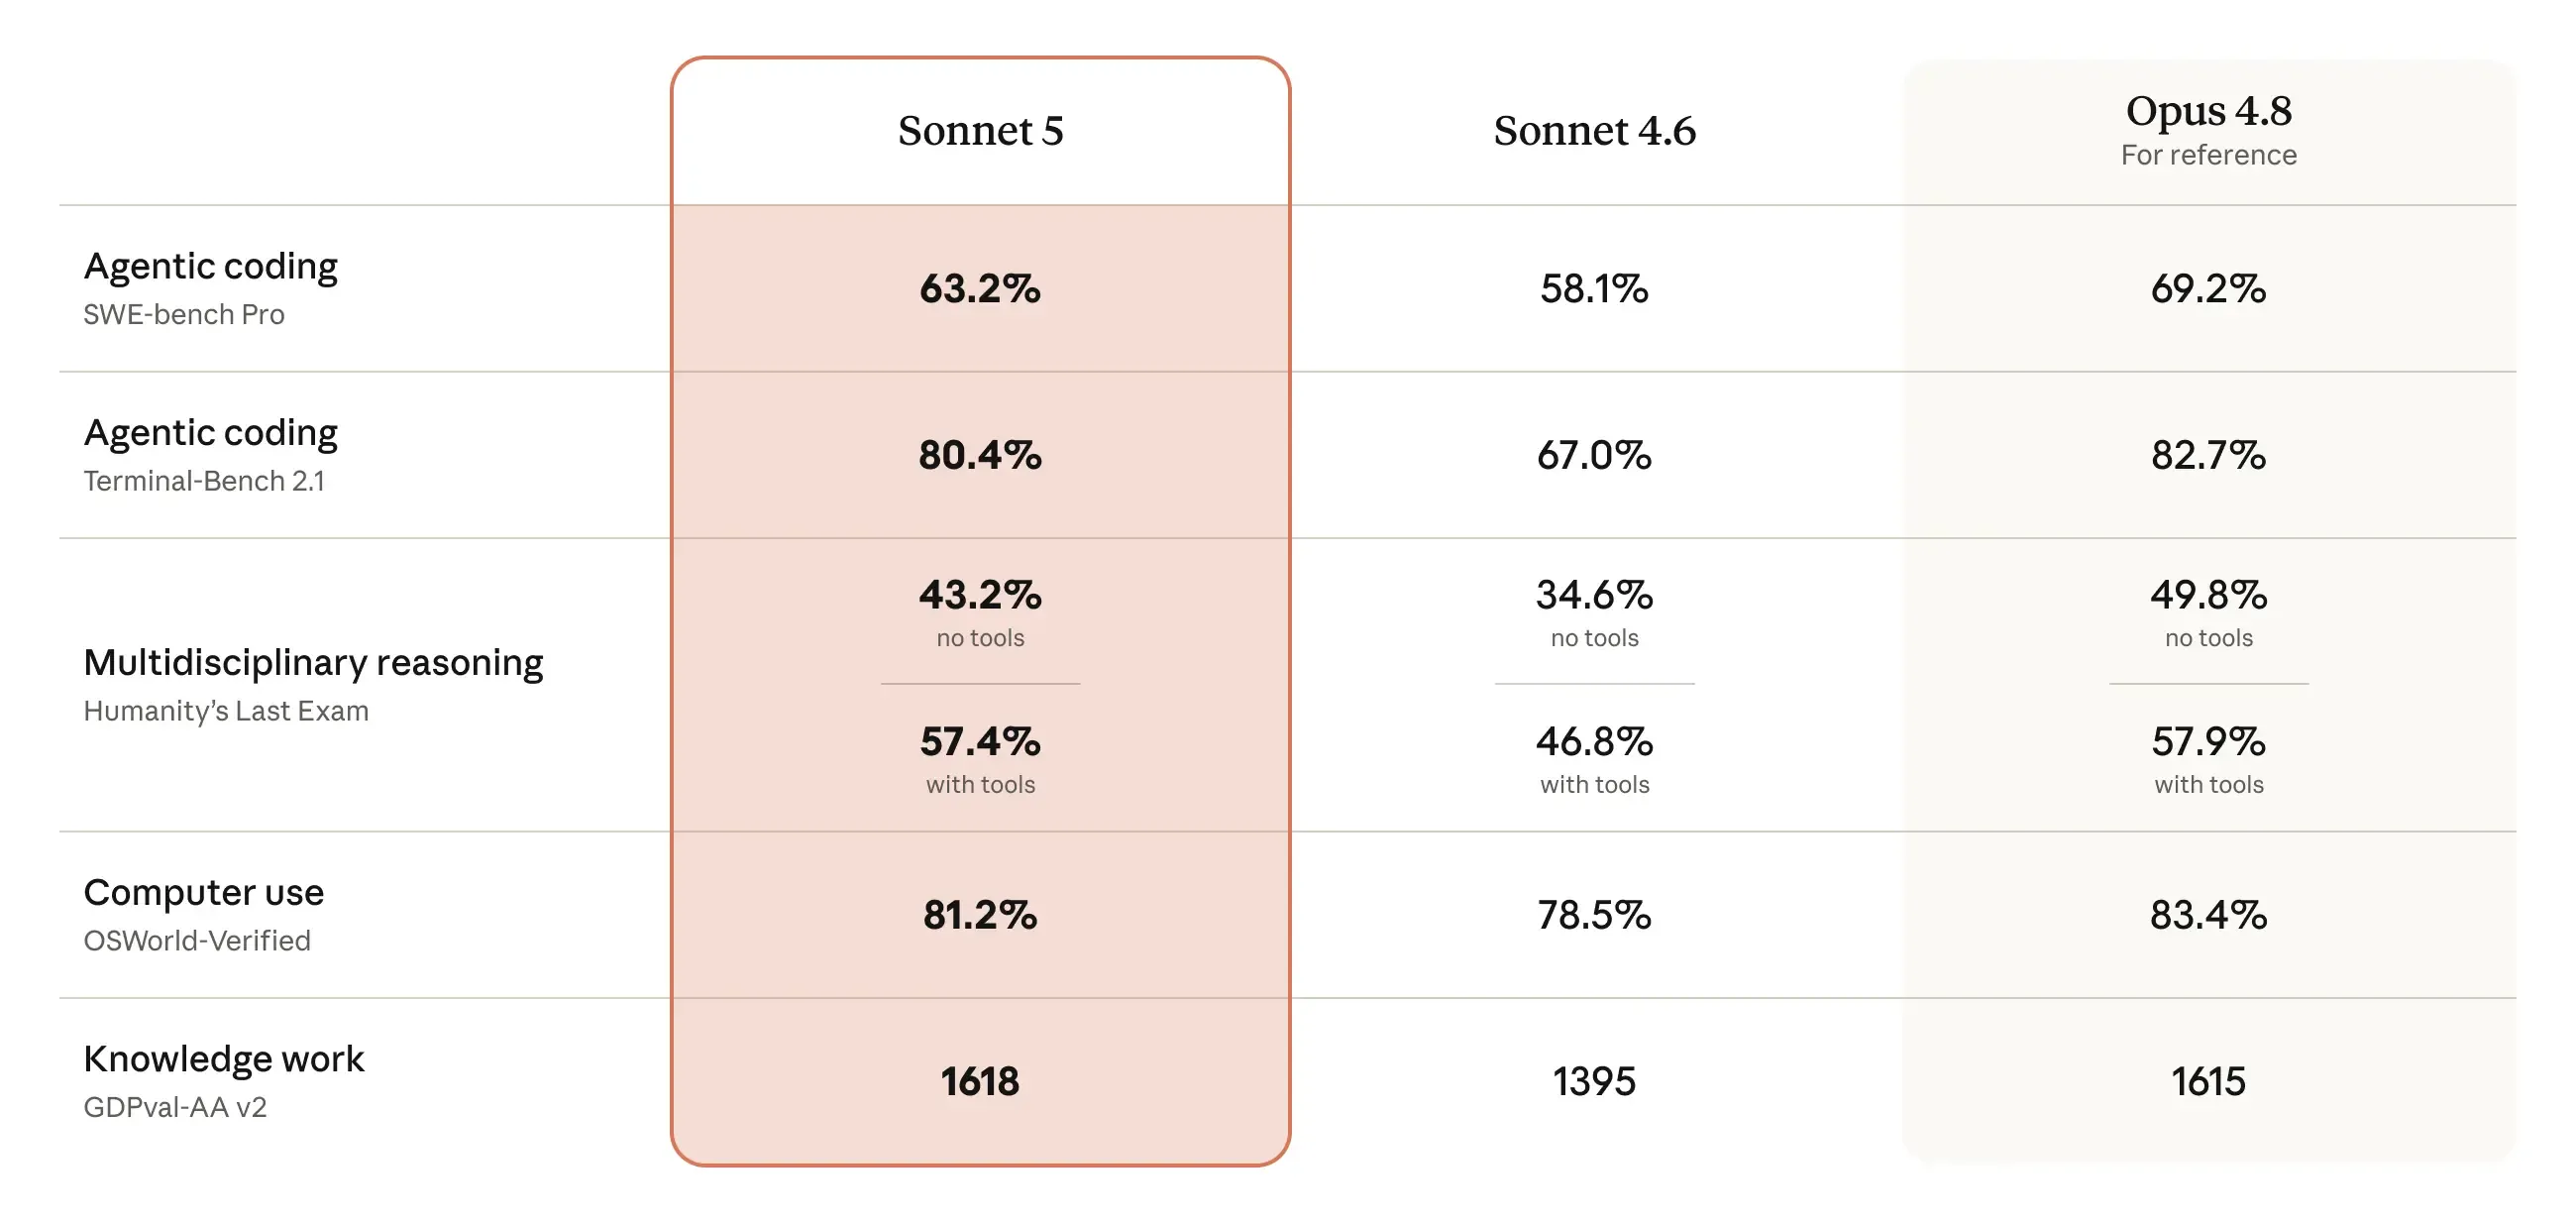
- Leistung nahe an Opus: Claude Sonnet 5 bietet eine Performance, die der von Claude Opus 4.8 sehr nahe kommt, wobei die tatsächlichen API-Einsparungen jedoch geringer ausfallen können, als es die Listenpreise vermuten lassen.
- Potenzielle Token-Inflation: Je nach Inhaltstyp kann der aktualisierte Tokenizer etwa das 1,0- bis 1,35-Fache an abrechenbaren Tokens für dieselbe Eingabe generieren.
- Wandel bei der SaaS-Abrechnung: Angesichts immenser Rechenlasten durch unbeaufsichtigte Agenten-Aktionen bewegen sich Anbieter weg von Pauschalgrenzen hin zu einer strikten, tokenbasierten Abrechnung.
Das Preisdilemma: Warum Listenpreise und Token-Inflation kollidieren
Die Preisankündigung vom 30. Juni 2026 führte einen Einführungspreis von $2 pro eine Million Eingabe-Tokens und $10 pro eine Million Ausgabe-Tokens auf der Claude-Plattform ein. Der Aktionspreis gilt bis zum 31. August 2026, danach treten die Standardpreise von $3 pro eine Million Eingabe-Tokens und $15 pro eine Million Ausgabe-Tokens in Kraft. Während diese Listenpreise niedriger erscheinen als die Raten von $5 (Eingabe) und $25 (Ausgabe) für Claude Opus 4.8, variieren die tatsächlichen Projektkosten. Der in Claude Sonnet 5 implementierte neue Tokenizer bildet identische Textzeichen auf das 1,0- bis 1,35-Fache der Token-Anzahl im Vergleich zu den Vorgängermodellen ab. Aufgrund dieser strukturellen Anpassung ist das Standard-Preisschema eher ein kostenneutraler Übergang als ein direkter Rabatt.
Um zu verstehen, wie sich diese Token-Inflation auf Unternehmensbudgets auswirkt, betrachten Sie ein beispielhaftes Kostenszenario bei der Verarbeitung von einer Million rohen Eingabe-Tokens. Nehmen wir zur Veranschaulichung an, dieselbe Codebasis wurde mit dem Tokenizer von Claude Sonnet 4.6 mit 1.000.000 Tokens gemessen. Unter Claude Sonnet 5 könnte dieselbe Codebasis – basierend auf dem von Anthropic beschriebenen oberen Ende des Multiplikators von 1,35× – etwa 1.350.000 Tokens erzeugen. Zum Einführungspreis von $2,00 pro Million betragen die Kosten $2,70 – eine geringfügige Ersparnis von 10 %. Sobald jedoch der Standardpreis von $3,00 pro Million greift, kostet dieselbe Codebasis $4,05. Dies entspricht einem Kostenanstieg von 35 % gegenüber dem Vorgängermodell und einer Ersparnis von nur 19 % gegenüber dem Flaggschiff Claude Opus 4.8, anstatt des erwarteten Rabatts von 40 %.
Beispielhaftes Kostenszenario (1 Mio. Token-Workload)
| Ausführungsszenario | Token-Multiplikator (illustrativ) | Rate pro Million Eingabe | Gesamtkosten pro 1 Mio. Tokens |
|---|---|---|---|
| Claude Sonnet 4.6 | 1,00x (Referenzbeispiel) | $3,00 (Standard) | $3,00 |
| Claude Sonnet 5 (Aktion) | bis zu 1,35x | $2,00 (Einführung) | $2,70 |
| Claude Sonnet 5 (Standard) | bis zu 1,35x | $3,00 (Standard) | $4,05 |
| Claude Sonnet 5 (+ 90% Caching) | 0,135x (90% Cache-Treffer) | $3,00 (Standard) | $0,77 |
| Claude Opus 4.8 | 1,00x (Referenzbeispiel) | $5,00 (Standard) | $5,00 |
 Mechanik des Tokenizers: Wie KV-Cache und Kontextlänge die Abrechnung verändern
Laut der Claude Sonnet 5 System Card verwendet Claude Sonnet 5 einen aktualisierten Tokenizer. Anthropic merkt an, dass dieselbe Eingabe je nach Inhaltstyp auf etwa das 1,0- bis 1,35-Fache an Tokens abgebildet werden kann, wodurch die Einführungspreise von $2 pro Million Eingabe-Tokens und $10 pro Million Ausgabe-Tokens ungefähr kostenneutral sind. In der Praxis können strukturierte Eingaben wie Quellcode, Markdown oder JSON-Dokumente größere Unterschiede bei der Token-Anzahl aufweisen als einfacher natürlicher Text.
Eine mögliche Erklärung hierfür ist, dass Code, Markdown und JSON von Natur aus dichtere syntaktische Strukturen enthalten als gewöhnliche Prosa. Moderne LLM-Tokenizer tokenisieren diese Strukturen oft anders als natürliche Sprache, was die Gesamtzahl der abrechenbaren Tokens erhöhen kann. Anthropic hat keine Implementierungsdetails zum Tokenizer von Claude Sonnet 5 offengelegt, sodass der genaue Mechanismus unbekannt bleibt.
Illustratives Beispiel:

Gleiche Eingabe
      │
      ├── Claude Sonnet 4.6 → 1.000.000 Tokens
      │
      └── Claude Sonnet 5   → bis zu 1.350.000 Tokens (je nach Inhaltstyp)
Für Anwendungen mit langem Kontext bleibt Prompt-Caching ein zentraler Mechanismus zur Senkung der API-Kosten. Das System ermöglicht es Entwicklern, Systemanweisungen, Standard-Referenzbibliotheken und große statische Dokumente zwischenzuspeichern, wodurch die Eingabekosten je nach Trefferrate um bis zu 90 % gesenkt werden können. Cache-Misses bei dynamisch kompilierten, dateiübergreifenden Code-Durchläufen können jedoch schnell massive Abrechnungs-Overheads verursachen. Wenn sich das aktive Kontextfenster dem Limit von 1 Mio. Tokens nähert, können der kumulative Verbrauch an Eingabe- und Ausgabe-Tokens sprunghaft ansteigen, ohne verwertbare Code-Ergebnisse zu liefern.
Interne Token-Optimierung vs. vorgefertigte Budget-Architekturen
In der Praxis müssen sich Engineering-Teams zwischen dem Aufbau eines internen Kosten-Überprüfungs-Frameworks, der Bereitstellung selbst gehosteter API-Gateways oder der Einführung vorgefertigter SDK-Lösungen entscheiden. Die Entwicklung eines eigenen Systems erfordert erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Ausführungsstatus pflegen und die Logik kontinuierlich aktualisieren, um Sicherheitsstandards des Betriebssystems einzuhalten. Für viele Organisationen sind die Wartungskosten für einen internen Tracker hoch.
Alternativ evaluieren Entwickler im Allgemeinen verschiedene Ansätze, um die Laufzeitausführung zu überwachen, ohne sich vollständig auf cloudseitige Metriken verlassen zu müssen:
- Lokale Modellbereitstellungen: Ausführen kleiner, hochspezialisierter Open-Source-Modelle in sicheren Offline-Umgebungen.
- Strikte Firewall-Sandboxing-Methoden: Einschränkung aktiver Entwicklungs-Container, um externe ausgehende Netzwerkverbindungen zu unterbinden.
- Enterprise-MMPs: Nutzung robuster Third-Party-Plattformen für das Mobile Measurement bei Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Bereitstellung dedizierter Integrations-Utilities für präzise, kostenbewusste Durchleitung von benutzerdefinierten Parametern.
Vergleich der Entwicklungsumgebungen
| Optimierungsstrategie | Potenzial zur Kostensenkung | Latenzzeit | Empfohlene Workload |
|---|---|---|---|
| Direkte API-Aufrufe | ❌ Keine | ⚡ Niedrig (<1s) | Echtzeit-Benutzeranfragen |
| Prompt Caching | ✅ Hoch (bis zu 90%) | ⚡ Niedrig (<1s) | Wiederkehrende Kontexte mit hohem Volumen |
| Kontext-Kompression | 🔄 Moderat | ⚠️ Mittel | Analyse langer Dokumente |
| Lokale Modelle | ✅ Hoch (keine API-Kosten) | ⚠️ Mittel | Leichtgewichtige Offline-Tests |
| Batch-Anfragen | ✅ Hoch (50% Rabatt) | ❌ Hoch (verzögert) | Nicht-dringende Hintergrundoperationen |
Vergleich von Funktionen und Kosten
| Modell | Eingabepreis (Aktion/Std) | Ausgabepreis (Aktion/Std) | Schlussfolgerungsniveau | Tokenizer-Overhead |
|---|---|---|---|---|
| Claude Sonnet 5 | $2.00 / $3.00 pro M | $10.00 / $15.00 pro M | Hoch (nahe Opus) | ⚠️ 1.0x–1.35x |
| Claude Opus 4.8 | $5.00 pro M | $25.00 pro M | Maximal (Frontier) | ✅ 1.0x (Basis) |
Roh-Prompt-Kontext -> Analyse Systemanweisungen -> Prompt Caching (90% Einsparung) -> Cache-Treffer (Ausführung)
                               |
Cache-Miss -> Kontext-Kompression -> Segment-Payload -> Ausführung zu Einführungspreisen
Während die KI-Kostenoptimierung sich auf die Reduzierung unnötigen Token-Verbrauchs konzentriert, stehen viele mobile Teams vor einer ähnlichen Effizienz-Herausforderung, nachdem Benutzer den Browser verlassen und eine App installieren. Die Beibehaltung von Empfehlungsparametern über diesen Übergang hinweg erfordert oft die Beibehaltung des Status auf Serverseite. Plattformen wie Opoinstall adressieren diese separate Ebene des Workflows. Ähnliche Plattformen sind Branch, AppsFlyer, Adjust und andere Systeme für verzögerte Attributionsmodelle. Unter diesen bietet Opoinstall ein SDK an, das Transaktionsvariablen und Sitzungsmetadaten auf eine zentrale Statusdatenbank abbildet und so sicherstellt, dass Sitzungskontexte erhalten bleiben, selbst wenn anfängliche Aufgaben kopflos über Warteschlangen außerhalb der Spitzenzeiten ausgeführt werden. Engineering-Teams können diese Ansätze entsprechend ihren Bereitstellungsanforderungen und Kostenzielen bewerten, und da Anthropic „Sonnet 5“ startet, stehen Entwickler vor der Wahl, diese integrierten Bibliotheken zu nutzen.
Kontroll-Checklisten für Betriebskosten und Integration
Backend-Engineering-Teams stehen vor der unmittelbaren Aufgabe, alle aktiven Datenbankintegrationen zu überprüfen, bevor automatisch kompilierte Builds gestartet werden. Produktverantwortliche sollten Einladungs- und Registrierungsschleifen so umgestalten, dass sie nicht-visuelle Nutzerreisen berücksichtigen. Anstatt davon auszugehen, dass ein Benutzer eine E-Mail liest und auf einen Button klickt, sollten Workflows entworfen werden, die programmatische Auslöser erwarten. Wachstumsteams müssen ihre Leistungsmetriken aktualisieren. Wenn autonome Software die Triage übernimmt, werden Öffnungsraten und Klickraten weniger zuverlässig. Marketing-Operationen sollten sich auf nachgelagerte In-App-Telemetrie und transaktionsgeprüfte Konversionsmeilensteine konzentrieren und Kampagnen auf Basis der tatsächlichen Aktionen innerhalb der Anwendung optimieren.
Checkliste zur programmatischen Kostenüberprüfung
Um die Budgetsicherheit zu gewährleisten und unerwartete Anstiege bei der Token-Abrechnung zu verhindern, sollten sich die technischen Schritte auf die folgenden Parameter konzentrieren:
- Prompt-Cache-Audit: Konfigurieren Sie ein aggressives Kontext-Caching für Systemanweisungen und lange statische Referenzen, um die Basis-Eingabekosten zu senken.
- Auslöser für Kontext-Kompression: Richten Sie automatisierte lokale Grenzwerte ein, um Verlaufsprotokolle zu komprimieren oder zu kürzen, bevor die Schwelle von 200k Tokens überschritten wird.
- Tests der Tokenizer-Overheads: Testen Sie Ihre Codebasen gegen die neue Token-Mapping-Engine, um den genauen Multiplikator (bis zu 1,35x) für die Abrechnung zu ermitteln.
- Integration von Kosten-Dashboards: Richten Sie Echtzeit-Telemetrie ein, um die Token-Auslastung über verschiedene Projektebenen hinweg zu verfolgen und zu visualisieren.
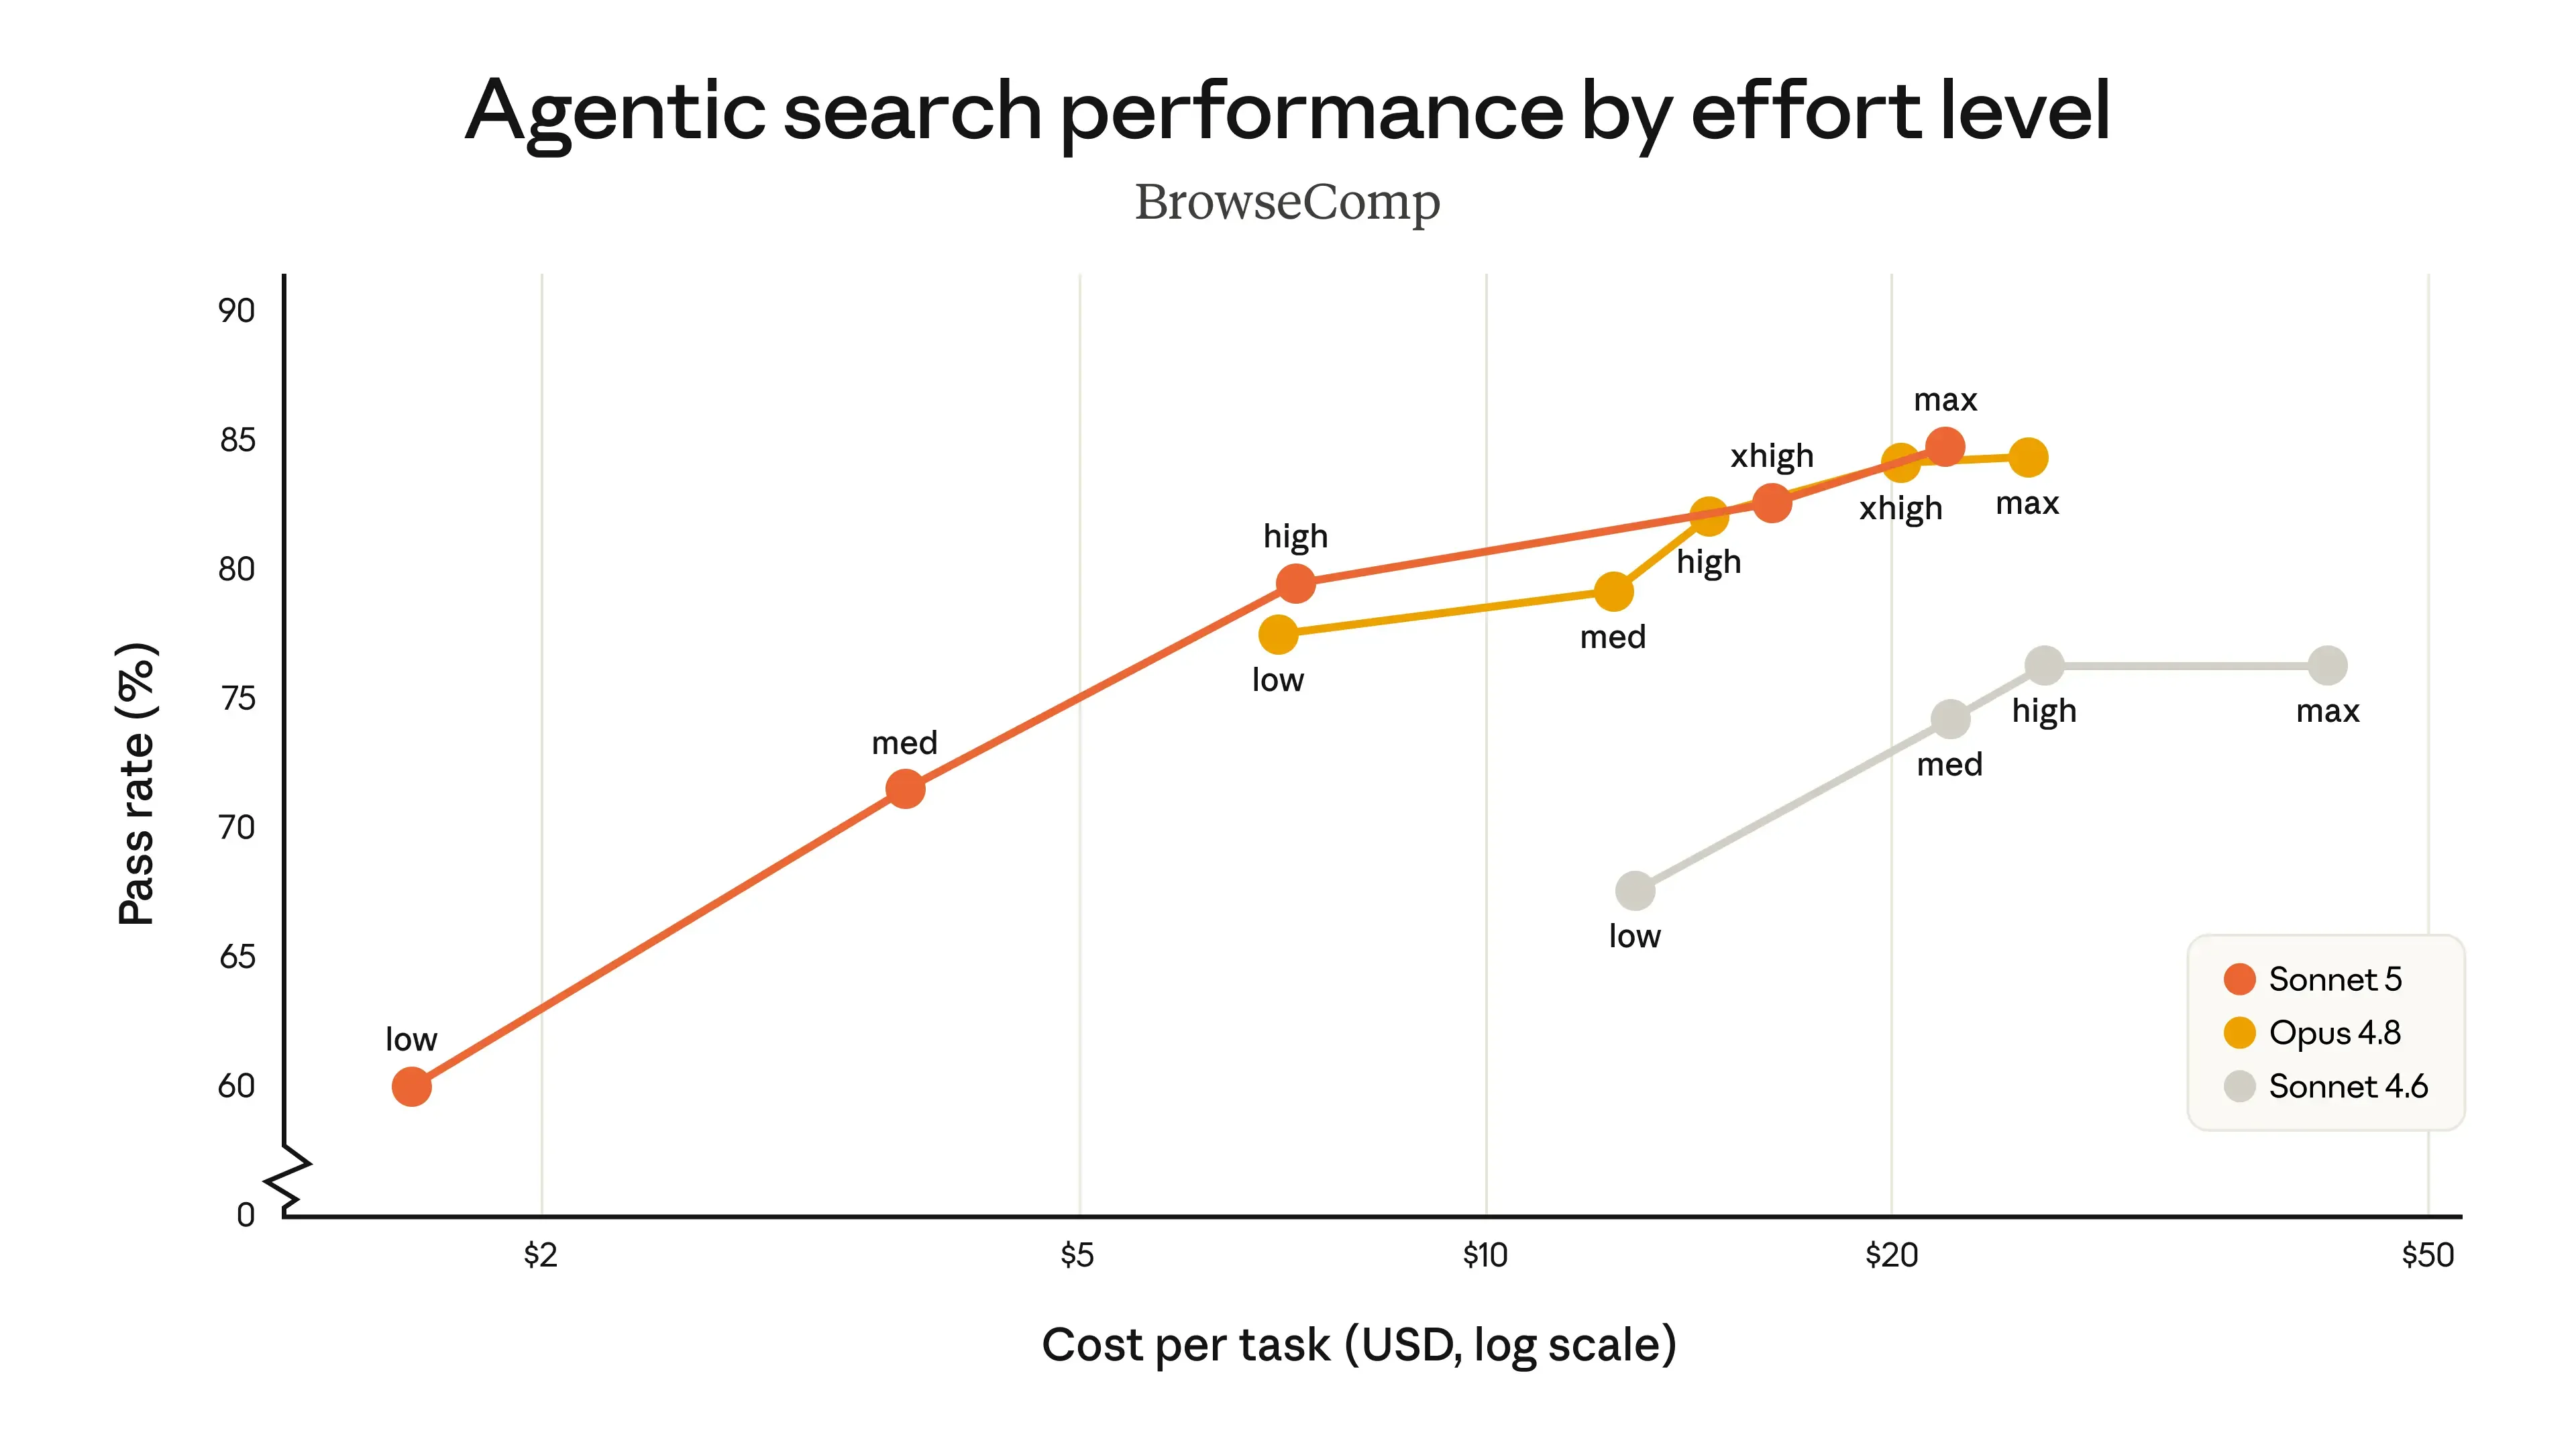
- Modellauswahl-Routing: Etablieren Sie eine Routing-Richtlinie, die Claude Sonnet 5 für Ausführungen mit hohem Volumen nutzt und Claude Opus 4.8 nur für komplexe Schlussfolgerungsaufgaben reserviert.
Häufig gestellte Fragen (FAQ)
Warum ist Claude Sonnet 5 möglicherweise nicht so günstig, wie die Listenpreise vermuten lassen?
Ersetzt Claude Sonnet 5 Claude Sonnet 4.6?
Wie wirkt sich der Tokenizer auf die Abrechnung in Entwicklungsumgebungen aus?
Sollten Entwickler Claude Sonnet 5 anstelle von Claude Opus 4.8 für die Programmierung verwenden?
Da die Token-Preisgestaltung dynamischer wird, werden Engineering-Teams weniger Zeit mit der Auswahl des leistungsstärksten Modells verbringen und mehr damit, das kosteneffizienteste zu wählen. Benchmark-Werte allein reichen nicht mehr aus. Das Verständnis von Tokenisierung, Caching und Workload-Planung wird Teil des täglichen KI-Engineerings.
Share this article



