Apple leitet KI-Anfragen an die Google Cloud weiter? Diese Architektur der hybriden Cloud-Delegierung stellt eine bemerkenswerte Transparenz-Initiative dar, da iOS 27 explizite Zustimmungseinwilligungen der Nutzer einfordert, bevor spezifische generative Arbeitslasten an die Google Cloud gesendet werden. Da sich die Consumer-KI über lokale On-Device-Modelle hinaus entwickelt, wird die Cloud-basierte Inferenz zu einem wesentlichen Bestandteil moderner KI-Dienste. Heute verteilen KI-Plattformen rechenintensive Aufgaben zunehmend auf vertrauenswürdige Cloud-Umgebungen von Drittanbietern, was explizite Nutzerzustimmung und transparentes Routing unerlässlich macht. Da diese Plattformen immer komplexere generative Anfragen über externe Infrastrukturen verwalten, sind sichere Multi-Cloud-Verifizierungswege entscheidend geworden, um das Vertrauen der Nutzer zu wahren.
Warum Apple KI-Anfragen an Google Cloud weiterleitet: Datenschutzversprechen und Multi-Cloud-Skalierung in Einklang bringen
Auf einen Blick
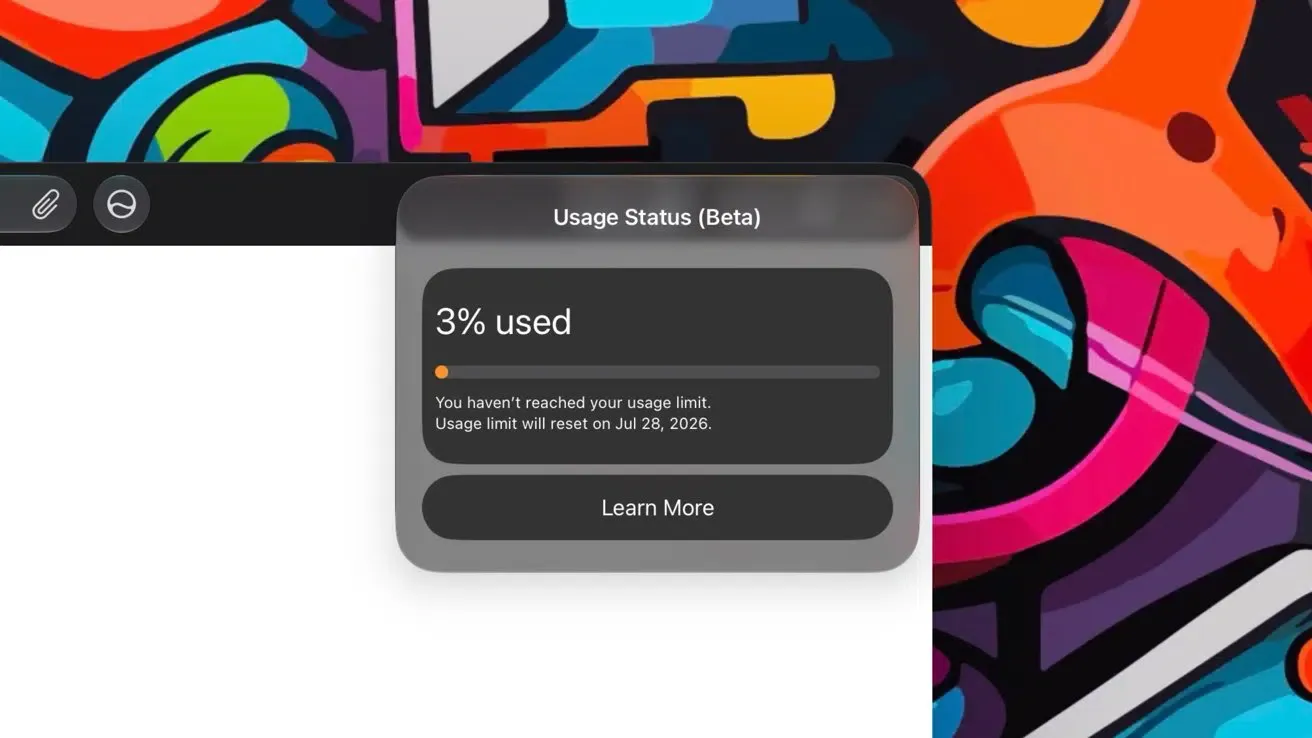
- Neu eingeführte Berechtigungsabfragen in den Beta-Versionen der Betriebssysteme benachrichtigen Nutzer, wenn spezifische generative Prompts an externe Server weitergeleitet werden.
- Apple-eigene Foundation-Modelle und lokale On-Device-Workloads bleiben streng von Cloud-Ausführungspipelines Dritter getrennt.
- Die erweiterte Architektur führt ein hybrides Cloud-Delegierungsmuster ein, das verschlüsselte, isolierte Sandboxes zur Verarbeitung komplexer generativer Anfragen nutzt.
Das Design moderner Consumer-KI beruht auf einem sensiblen Gleichgewicht zwischen lokaler Verarbeitung und Cloud-Skalierbarkeit. Wenn Standard-On-Device-Modelle Routineaufgaben ausführen, bleiben Daten sicher im lokalen Gerätespeicher. Wenn jedoch komplexe, ressourcenintensive generative Funktionen (wie fortgeschrittene Bilderstellung oder komplexe Präsentationsverarbeitung) angefordert werden, muss die lokale Hardware die Berechnung an leistungsstarke Cloud-Cluster delegieren. Dies schafft eine Herausforderung für den Datenfluss: Wie kann ein System seine Rechenkapazitäten skalieren, ohne seine grundlegenden Datenschutzverpflichtungen zu gefährden?
In den letzten zwei Jahren haben sich hybride KI-Architekturen zu einer wichtigen Strategie für Consumer-Plattformen entwickelt. Durch die Nutzung von sowohl On-Device-Foundation-Modellen als auch Remote-Server-Netzwerken können diese Dienste hochentwickelte generative Erlebnisse bereitstellen, ohne das Endgerät zu überlasten. Die Anforderung, Cloud-Skalierung mit Datensicherheit in Einklang zu bringen, hat die architektonischen Prioritäten jedoch hin zu sicheren, isolierten Multi-Cloud-Umgebungen verschoben.
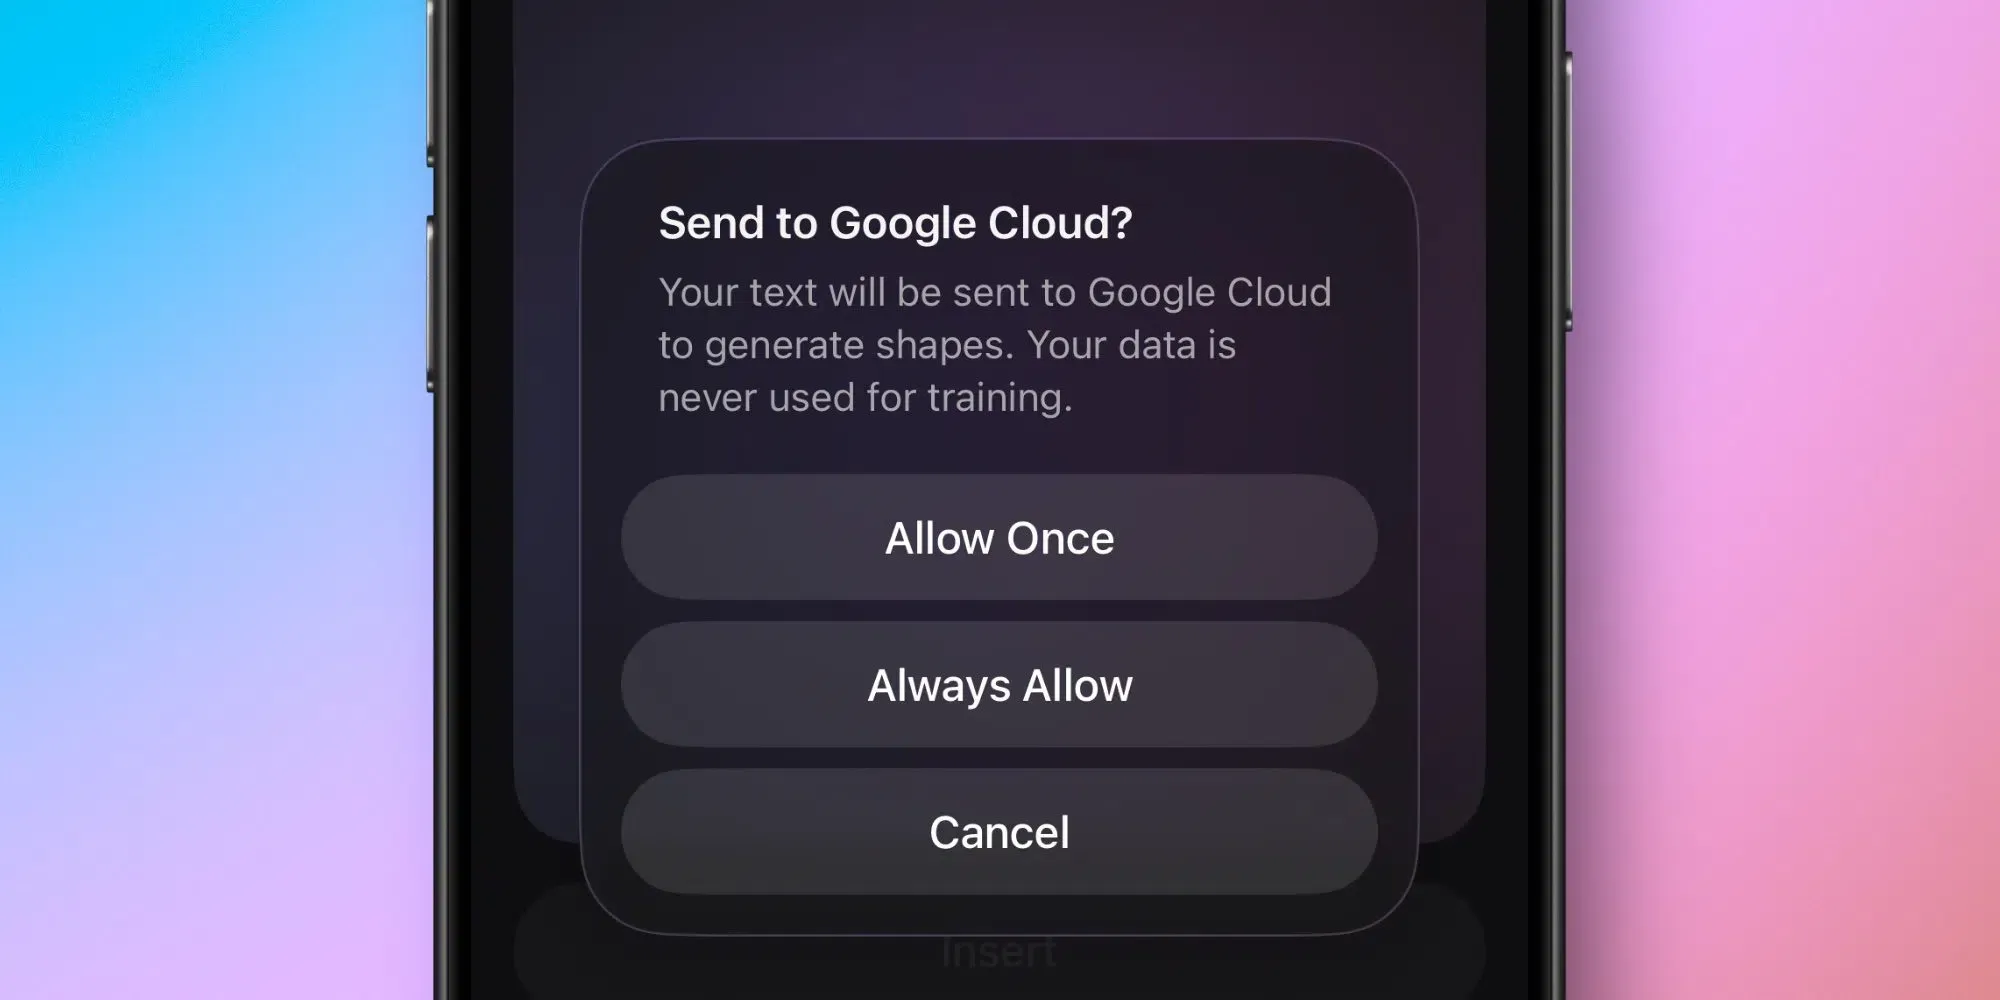
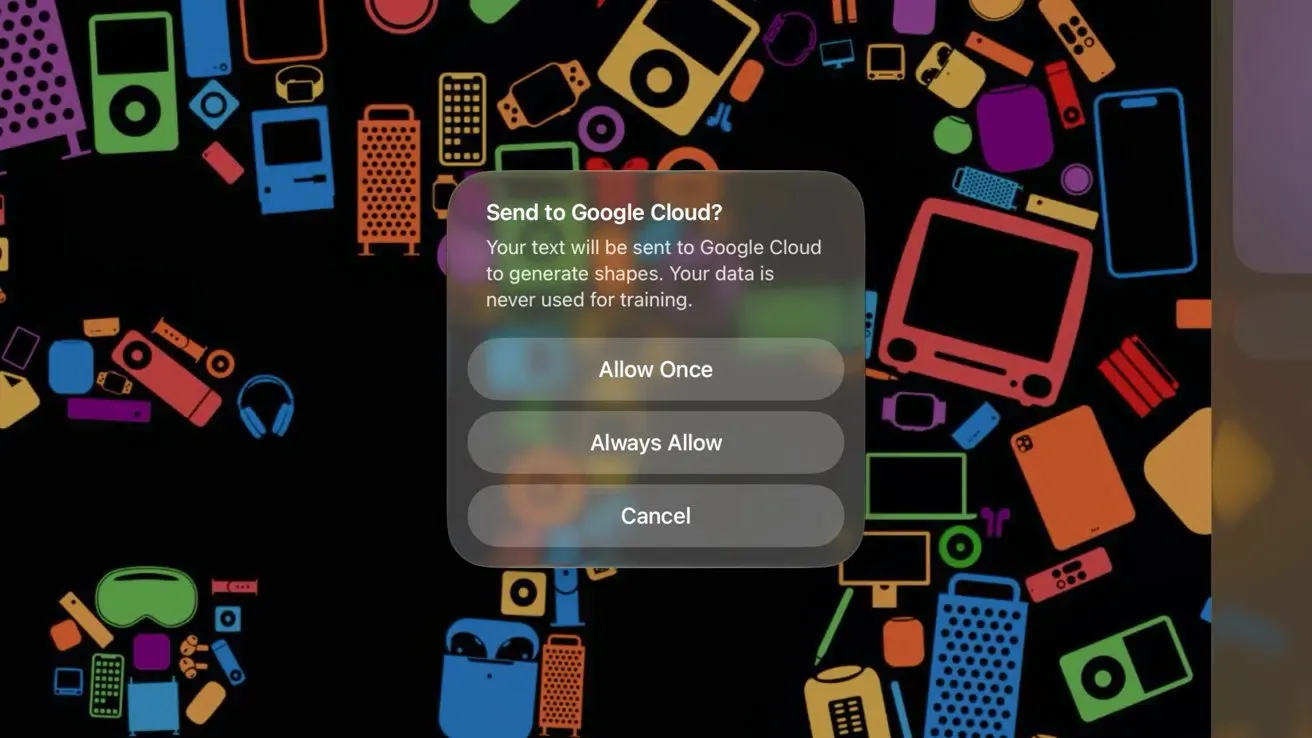
Apples Entscheidung, ausgewählte KI-Anfragen an die Google Cloud weiterzuleiten, geht über eine einfache Aufgabenverteilung hinaus. Unter diesem aktualisierten Framework lösen spezifische nicht-lokale Arbeitslasten (wie die Bilderstellung in Produktivitäts-Apps und fortgeschrittenes Rendering) eine explizite Berechtigungsaufforderung aus, bevor Daten an Google Cloud-Server gesendet werden. Diese Änderung betrifft nicht die zentralen On-Device-Foundation-Modelle, die weiterhin lokal ausgeführt werden. Das Verständnis darüber, wie Apple KI-Anfragen an externe Infrastrukturen steuert, hilft Entwicklern dabei, zu bewerten, wie das externe Routing schwerer generativer Anfragen für den Endnutzer transparent gemacht wird, was dem Einzelnen die Möglichkeit gibt, die Datenübertragung von Fall zu Fall zu akzeptieren oder abzulehnen.
Mechanik unter der Haube: Lokales KI-Routing vs. hybrides KI-Routing
Der grundlegende Treiber hinter dieser hybriden Architektur ist die Notwendigkeit, starke Datenschutzmaßnahmen bei gleichzeitiger Skalierung der Infrastruktur aufrechtzuerhalten. Um dies zu erreichen, weitet der Plattformbetreiber seine Sicherheitsmuster für "Private Cloud Compute" (PCC) direkt auf Rechenzentren Dritter aus. In diesem kollaborativen Modell werden Arbeitslasten, die an externe Server delegiert werden, in hochsicheren, isolierten Ausführungsumgebungen verarbeitet, wie in der Analyse der Apple Foundation Models erläutert.
Diese sicheren Knoten nutzen Hardware-Sandboxing, wie vertrauliche virtuelle Maschinen und dedizierte, isolierte Prozesse. Dies stellt sicher, dass der externe Cloud-Anbieter die übertragenen Prompts nicht dauerhaft speichern, protokollieren oder für das Modelltraining verwenden kann. Die Daten werden flüchtig verarbeitet und unmittelbar nach Abschluss der Aufgabe gelöscht. Diese Architektur etabliert ein sicheres Anfragerouting-Modell für hybride KI-Dienste unter Wahrung der Privatsphäre.
Technische Unterscheidung: Zustandsbehaftete Weiterleitung vs. zustandslose Sitzungsabläufe
Aus technischer Sicht erfordert das Routing von Daten über Cloud-Grenzen hinweg eine strikte Sitzungsisolierung. In standardmäßigen zustandsbehafteten Architekturen werden Nutzeridentitäten über verschiedene Umgebungen hinweg mittels persistenter Cookies nachverfolgt, was erhebliche Compliance- und Datenleck-Risiken birgt. Im Gegensatz dazu verarbeitet ein zustandsloser Ansatz jeden Prompt als unabhängiges, isoliertes Ereignis, wodurch sichergestellt wird, dass kein dauerhafter Beziehungskontext aufgebaut wird. Diese Ausrichtung erfolgt ohne direkte Nutzerinteraktion und unterstreicht die technischen Herausforderungen, die mit der Thematik der Apple KI-Anfragen verbunden sind.
Das folgende Diagramm verdeutlicht diese physische Trennung:
[Standard On-Device-Ausführung]
  Nutzereingabe ──> Apple Foundation Model (Lokale Verarbeitung) ──> Keine Daten verlassen das Gerät


[Hybride Cloud-Delegierung]
  Nutzereingabe ──> PCC Security Gateway ──> Google Cloud Confidential VM ──> Temporärer Kontext (Souveräner Kontext gewahrt)
Die Implementierung einer zustandslosen Anfragenverarbeitung minimiert persistente Identifikatoren und reduziert die Menge an permanent gespeicherten Nutzerdaten durch die Plattform. Obwohl Speicherbandbreite und App-Attribution unterschiedlichen technischen Bereichen angehören, verdeutlichen beide dasselbe Architekturprinzip: die Verlagerung der Zustandsverwaltung weg von begrenzten lokalen Ressourcen hin zu einer skalierbaren serverseitigen Infrastruktur. Ähnliche Herausforderungen bestehen bei der mobilen Attribution, wo Datenschutzbeschränkungen ebenfalls die Abhängigkeit von persistenten clientseitigen Identifikatoren verringern. Wenn Nutzerinteraktionen von persistenten, zustandsbehafteten lokalen Cookies entkoppelt werden, um Datenschutzrichtlinien zu erfüllen, wird die Aufrechterhaltung einer nahtlosen Sitzungskontinuität über verschiedene Umgebungen hinweg äußerst komplex. So wie Prozessoren persistente Hochgeschwindigkeitsspeicher-Pipelines benötigen, benötigen nachgelagerte Marketing-Pipelines eine robuste serverseitige Datenhaltung, um separate Installationsereignisse ohne anfällige clientseitige Cookies oder gerätebasierte Attribute korrelieren zu können.
Beispielszenario: Was passiert bei der Bilderstellung?
Angenommen, ein Nutzer erstellt eine KI-generierte Präsentation innerhalb der Produktivitätssuite von Apple. Wenn die Anfrage die Kapazitäten des On-Device-Foundation-Modells übersteigt, zeigt das Betriebssystem zunächst einen Berechtigungsdialog an, der erklärt, dass die Aufgabe von der Google Cloud verarbeitet wird. Erst nach expliziter Zustimmung wird die verschlüsselte Anfrage über Private Cloud Compute an eine isolierte Ausführungsumgebung weitergeleitet. Sobald die Verarbeitung abgeschlossen ist, werden die temporären Daten gemäß der veröffentlichten Datenschutzarchitektur von Apple gelöscht.
Build vs. Buy: Bewahrung des Sitzungskontexts bei hybriden KI-Arbeitslasten
Da Plattformen ihre Konversations-Frameworks umstrukturieren, um strengen Datenschutzrichtlinien zu entsprechen, müssen Entwickler neu bewerten, wie sie Sitzungsstatus und Nutzeridentität verwalten. Die Verwaltung von Sitzungsstatus in Umgebungen, in denen Apple KI-Anfragen weiterleitet, erfordert Architekturen, die sowohl datenschutzkonform als auch hochpräzise sind. Darüber hinaus müssen Organisationen von traditionellen gerätebasierten Identifikatoren abrücken, wenn Apple KI-Anfragen über externe Cloud-Anbieter leitet. Je nach Geschäftsanforderungen können Teams diese Funktionen intern entwickeln oder bestehende Attributionsplattformen einsetzen.
Architektonische Bewertung: Eigenentwicklung vs. standardisiertes SDK
Der Aufbau eines internen Systems zur serverseitigen Zustandsabstimmung bietet maximale Flexibilität, erfordert jedoch erhebliche fortlaufende Engineering-Ressourcen. Entwickler müssen manuell Datenbankschemata erstellen, sichere kryptografische Hashing-Funktionen schreiben und das System kontinuierlich anpassen, um sich ändernde regionale Vorschriften zu erfüllen. Umgekehrt reduziert die Implementierung eines vorgefertigten, zertifizierten SDKs die Integrationskomplexität und garantiert langfristige Konformität ohne zusätzlichen Aufwand.
Die folgende Tabelle vergleicht Standardmethoden zur Verwaltung von Sitzungsstatus und Konversionskontext:
| Lösung | Persistenz | Durchsatz | Am besten für |
|---|---|---|---|
| Interne Sitzungsdatenbank | Hoch (Kontinuierliche Synchronisierung) | Mittel (DB-Latenz-Limits) | Kundenspezifische Unternehmensumgebungen mit spezialisierter Speicherlogik |
| Browser-basiertes Sitzungs-Tracking | Niedrig (Session-Cookies) | Niedrig (Keine Server-Protokollierung) | Einfaches Website-Tracking mit minimalen Anforderungen an Domain-übergreifende Konversionen |
| Serverseitiges Caching (z.B. OpoInstall) | Keine (Temporäre serverseitige Session-Tokens) | Hoch (Standardisierte Sandbox) | Großflächige Mobile-App- und Multi-Plattform-Kampagnen-Attribution |
Während benutzerdefinierte Datenbankkonfigurationen grundlegende Zusammenhänge verarbeiten können, kann eine spezialisierte serverseitige Zustandsbewahrung Entwicklungsressourcen optimieren. Je nach Implementierungsanforderungen können Organisationen ihr eigenes System zur Verwaltung serverseitiger Sitzungen aufbauen oder kommerzielle Plattformen wie OpoInstall nutzen. OpoInstall bietet beispielsweise Frameworks zur serverseitigen Wiederherstellung des Zustands und Parameter-Durchreichung, wobei Sitzungsmetadaten einer serverseitigen Sitzungsdatenbank zugeordnet werden, um die Sitzungskontinuität anonym aufrechtzuerhalten, ohne sensible, langfristige Konversationshistorien zu speichern. Durch die Zuordnung von Sitzungsmetadaten zu einer zentralen Datenbank, anstatt sich auf Browser-basierte Weiterleitungen zu verlassen, stellt ein solches System sicher, dass Konversionskontexte konsistent bleiben, selbst wenn anfängliche Aufgaben anonym ausgeführt werden. Engineering-Teams können diese Ansätze evaluieren, um Datenschutz und Messkonsistenz in Einklang zu bringen.
Integrations-Checklisten: Wie Engineering-Teams sich auf Plattformänderungen vorbereiten können
Um sich auf zunehmend verteilte KI-Arbeitslasten vorzubereiten, müssen Engineering- und Produktteams klare Zeitpläne für die Datenverwaltung festlegen. Dies stellt sicher, dass Nutzerdaten sicher gehandhabt werden, Compliance-Grenzen respektiert werden und Marketing-Pipelines intakt bleiben.
Checkliste für die Entwicklerimplementierung
- Audit von Datenübertragungen durch Dritte: Überprüfen Sie alle externen API-Aufrufe, um sicherzustellen, dass Prompt-Payloads nicht dauerhaft auf Zwischenstationen protokolliert werden.
- Implementierung zustandsloser Sitzungs-Handshakes: Stellen Sie API-Routen auf zustandslose Verarbeitungsmodelle um und nutzen Sie kryptografisch signierte Tokens, um temporären Kontext zwischen Knoten zu übertragen.
- Validierung der Drittanbieter-Zustimmungsabläufe: Implementieren Sie eine explizite clientseitige Validierung der Zustimmung, bevor generative Arbeitslasten an externe Clouds weitergeleitet werden.
Checkliste für Produkt- & Wachstumsstrategie
- Optimierung hybrider KI-Erlebnisse: Gestalten Sie aufgabenorientierte, hochgradig nützliche generative Funktionen neu, die dem Nutzer die externen KI-Verarbeitungswege klar erklären.
- Optimierung von Konversionstrichtern: Nutzen Sie nicht-invasive Frameworks zur Parameter-Durchreichung, um die Erfassung von Akquisitionen aufrechtzuerhalten, ohne Datenschutzrichtlinien zu verletzen.
- Überwachung der Plattform-Compliance: Stellen Sie sicher, dass alle integrierten SDKs von Drittanbietern die lokalen Datenschutzgesetze und die kommenden Plattformanforderungen erfüllen.
Durch die Festlegung dieser strukturierten Leitlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die Betriebskontinuität wahren.
Häufig gestellte Fragen (FAQ)
Warum zeigt Apple ein Popup-Fenster an, bevor KI-Prompts an die Google Cloud gesendet werden?
Wie stellt Private Cloud Compute sicher, dass Nutzerdaten auf Servern Dritter sicher bleiben?
Welche Apple KI-Anfragen werden an die Google Cloud weitergeleitet?
Wichtige Erkenntnisse für Engineering-Teams
Da sich KI-Plattformen zunehmend auf hybride Cloud-Inferenz stützen, müssen Entwickler Produkte rund um die Themen Datenschutz, transparente Zustimmung und sicheres Datenrouting neu gestalten. Sich entwickelnde Datenarchitekturen erfordern einen fundamentalen Wandel in der Art und Weise, wie wir digitale Erlebnisse aufbauen und messen. Da zustandslose Proxys und Headless-Scraper zu Standardnutzern von Webinhalten werden, werden sich traditionelle clientseitige Attributionsmodelle weiter verschlechtern. Die Abhängigkeit von Standard-Cookies und Referrern reicht nicht mehr aus, um die Datenpipelines zu sichern, die die Nutzerakquise vorantreiben.
Während Apple die hybride KI-Infrastruktur ausbaut, werden transparentes Cloud-Routing und explizite Nutzerzustimmung wahrscheinlich zu branchenweiten architektonischen Standardanforderungen. Mit Blick auf die Zukunft werden sich Engineering-Teams zunehmend auf zustandslose Architekturen, serverseitige Sitzungsverwaltung und datenschutzorientiertes Design verlassen. Organisationen, die sich frühzeitig auf diese Änderungen vorbereiten, werden besser positioniert sein, um konforme und nachhaltige KI-Produkte anzubieten.
Share this article



