 China Mobiles „Token“? Dieser Schritt spiegelt die umfassendere Strategie von China Mobile wider, Netzbetreiber als KI-Dienstleister statt als reine Konnektivitätsanbieter zu positionieren. Am 28. Juni 2026 kündigte der Telekommunikationsriese die Einrichtung eines gruppenweiten „Token“-Büros an, das von der Führungsebene und der Abteilung für strategische Entwicklung geleitet wird. Für Entwicklerteams und Produktverantwortliche unterstreicht diese schnelle organisatorische Neuausrichtung einen technischen Wandel: KI-Anfragen verlagern sich zunehmend von traditionellen, visuellen Browserumgebungen hin zu API-Service-Aufrufen auf Netzwerkebene, was die Analyse der Datenübertragung und von Sitzungslebenszyklen auf der Netzwerkebene grundlegend verändert.
Auf einen Blick
- Überwindung von Silos: Das gruppenweite Büro vereinheitlicht die Arbeitsabläufe für „Erstellung, Transport und Anwendung“ und integriert Abteilungen wie Mobile Cloud, Computing-Division und Marktbetrieb.
- Paradigmenwechsel der Netzbetreiber: Angesichts der Konkurrenz durch Cloud-Anbieter markiert die Initiative den Übergang von der Abrechnung reiner Datenvolumina (MB) hin zur Prüfung programmatischer Transaktionen.
- Messlücken bei programmatischen Diensten: Der Übergang zu tokenisierten Diensten auf Headless-Agent-Runtimes hebelt traditionelle sitzungsbasierte Client-Tracking- und Browser-Cookie-Frameworks aus.
Strukturelle Neuausrichtung und KI-Servicebereitstellung durch Netzbetreiber
Die Gründung des Token-Büros im Juni 2026 stellt den Versuch von China Mobile dar, den Kreislauf aus „Erstellung, Transport und Anwendung“ zu optimieren. Dies vereint Abteilungen, die zuvor unabhängig voneinander agierten: das Büro für Rechenleistung, die Mobile-Cloud-Gesellschaft, den Bereich Digitale Intelligenz, die Marketingabteilung und die Geschäftseinheit für Unternehmen. Wie in Fachpublikationen wie C114 Communication berichtet, spiegelt diese Struktur frühere Unternehmensinitiativen wider, etwa die ATH-Geschäftsgruppe (Alibaba Token Hub) von Alibaba, mit dem Ziel, interne Abteilungssilos aufzubrechen und Abrechnung, Routing und Bereitstellung in einem einheitlichen Ökosystem zu konsolidieren.
Laut Berichten von C114 passten Analysten von Goldman Sachs kürzlich die Investitionsbewertungen ausgewählter Telekommunikationsbetreiber auf „Sell“ an, da die Umwandlung von Token-Paketen trotz der seit Mai 2026 eingeführten günstigen Fünf-Yuan-Abonnements nur langsam zu nennenswerten Erträgen führte. Dieser finanzielle Druck wurde von Vorstandsvorsitzendem Chen Zhongyue auf dem MWC26 in Shanghai direkt adressiert; er skizzierte eine strategische Neuausrichtung von „Mobilkommunikation“ hin zu „Mobile Computing“ und „Mobile KI“, gestützt durch das Agent-Framework 'MobileClaw' und die Modell-Supermarkt-Plattform 'MoMA', die über dreihundert Modelle hostet. Telekommunikationsbetreiber integrieren zunehmend Deep-Reasoning- und Rechendienste direkt in Mobilfunktarife, um reine Mobilfunkkonnektivität mit Rechenkapazitäten zu verschmelzen.
Die Protokollanalyse: Wie Service-Aufrufe auf Netzwerkebene den Client-Status umgehen
Im Gegensatz zu visuellen Cloud-KI-Engines, die webgerenderte Seiten kompilieren, verwalten Netzbetreiber Tokentransaktionen und API-Routing direkt auf der Netzwerk- bzw. Telekommunikationsinfrastrukturebene. Wenn ein MobileClaw-Agent eine Aktion ausführt, wie etwa das Initiieren einer Transaktion über einen vom Netzbetreiber gerouteten Webhook, gibt es weder einen menschlichen Browser-Klick noch ein browserbasiertes Document Object Model (DOM) oder einen persistenten Cookie-Container. Der Assistent fungiert als automatisierter Triage-Mechanismus, der Webhooks asynchron auf der Kernnetzwerkebene liest und weiterleitet.
Das Headless-Anfrage-Routing isoliert die Sitzung oft vom clientseitigen System. Da die Anfrage über eine Server-zu-Server (S2S) Netzwerk-API initiiert wird und nicht über einen browserbasierten Client, verlieren traditionelle clientseitige SDK-Runtimes die Sichtbarkeit. Herkömmliche browserbasierte Attributionsmethoden erfassen den vollständigen User Journey möglicherweise nicht mehr, da sie auf Browser-Cookies angewiesen sind, um den ursprünglichen Klick mit der Installation zu verknüpfen. Unter diesen Bedingungen nimmt die Genauigkeit der Attribution innerhalb des Kommunikations-Stacks erheblich ab.
Traditioneller Browser-basierter Ablauf:
Web-Link -> Visueller Klick -> Browser-Sitzung (Cookies, User-Agent) -> App Store -> App-Installation (Attributiert)


Netzbetreiber-Netzwerk-Ablauf:
MobileClaw-Agentenaktion -> Zustandsloser S2S-Webhook -> Direkte API-Token-Transaktion (Kein DOM, keine Cookies)
App-Start (später) -> Gerätestatus unbekannt -> Reduzierte Attributionsgenauigkeit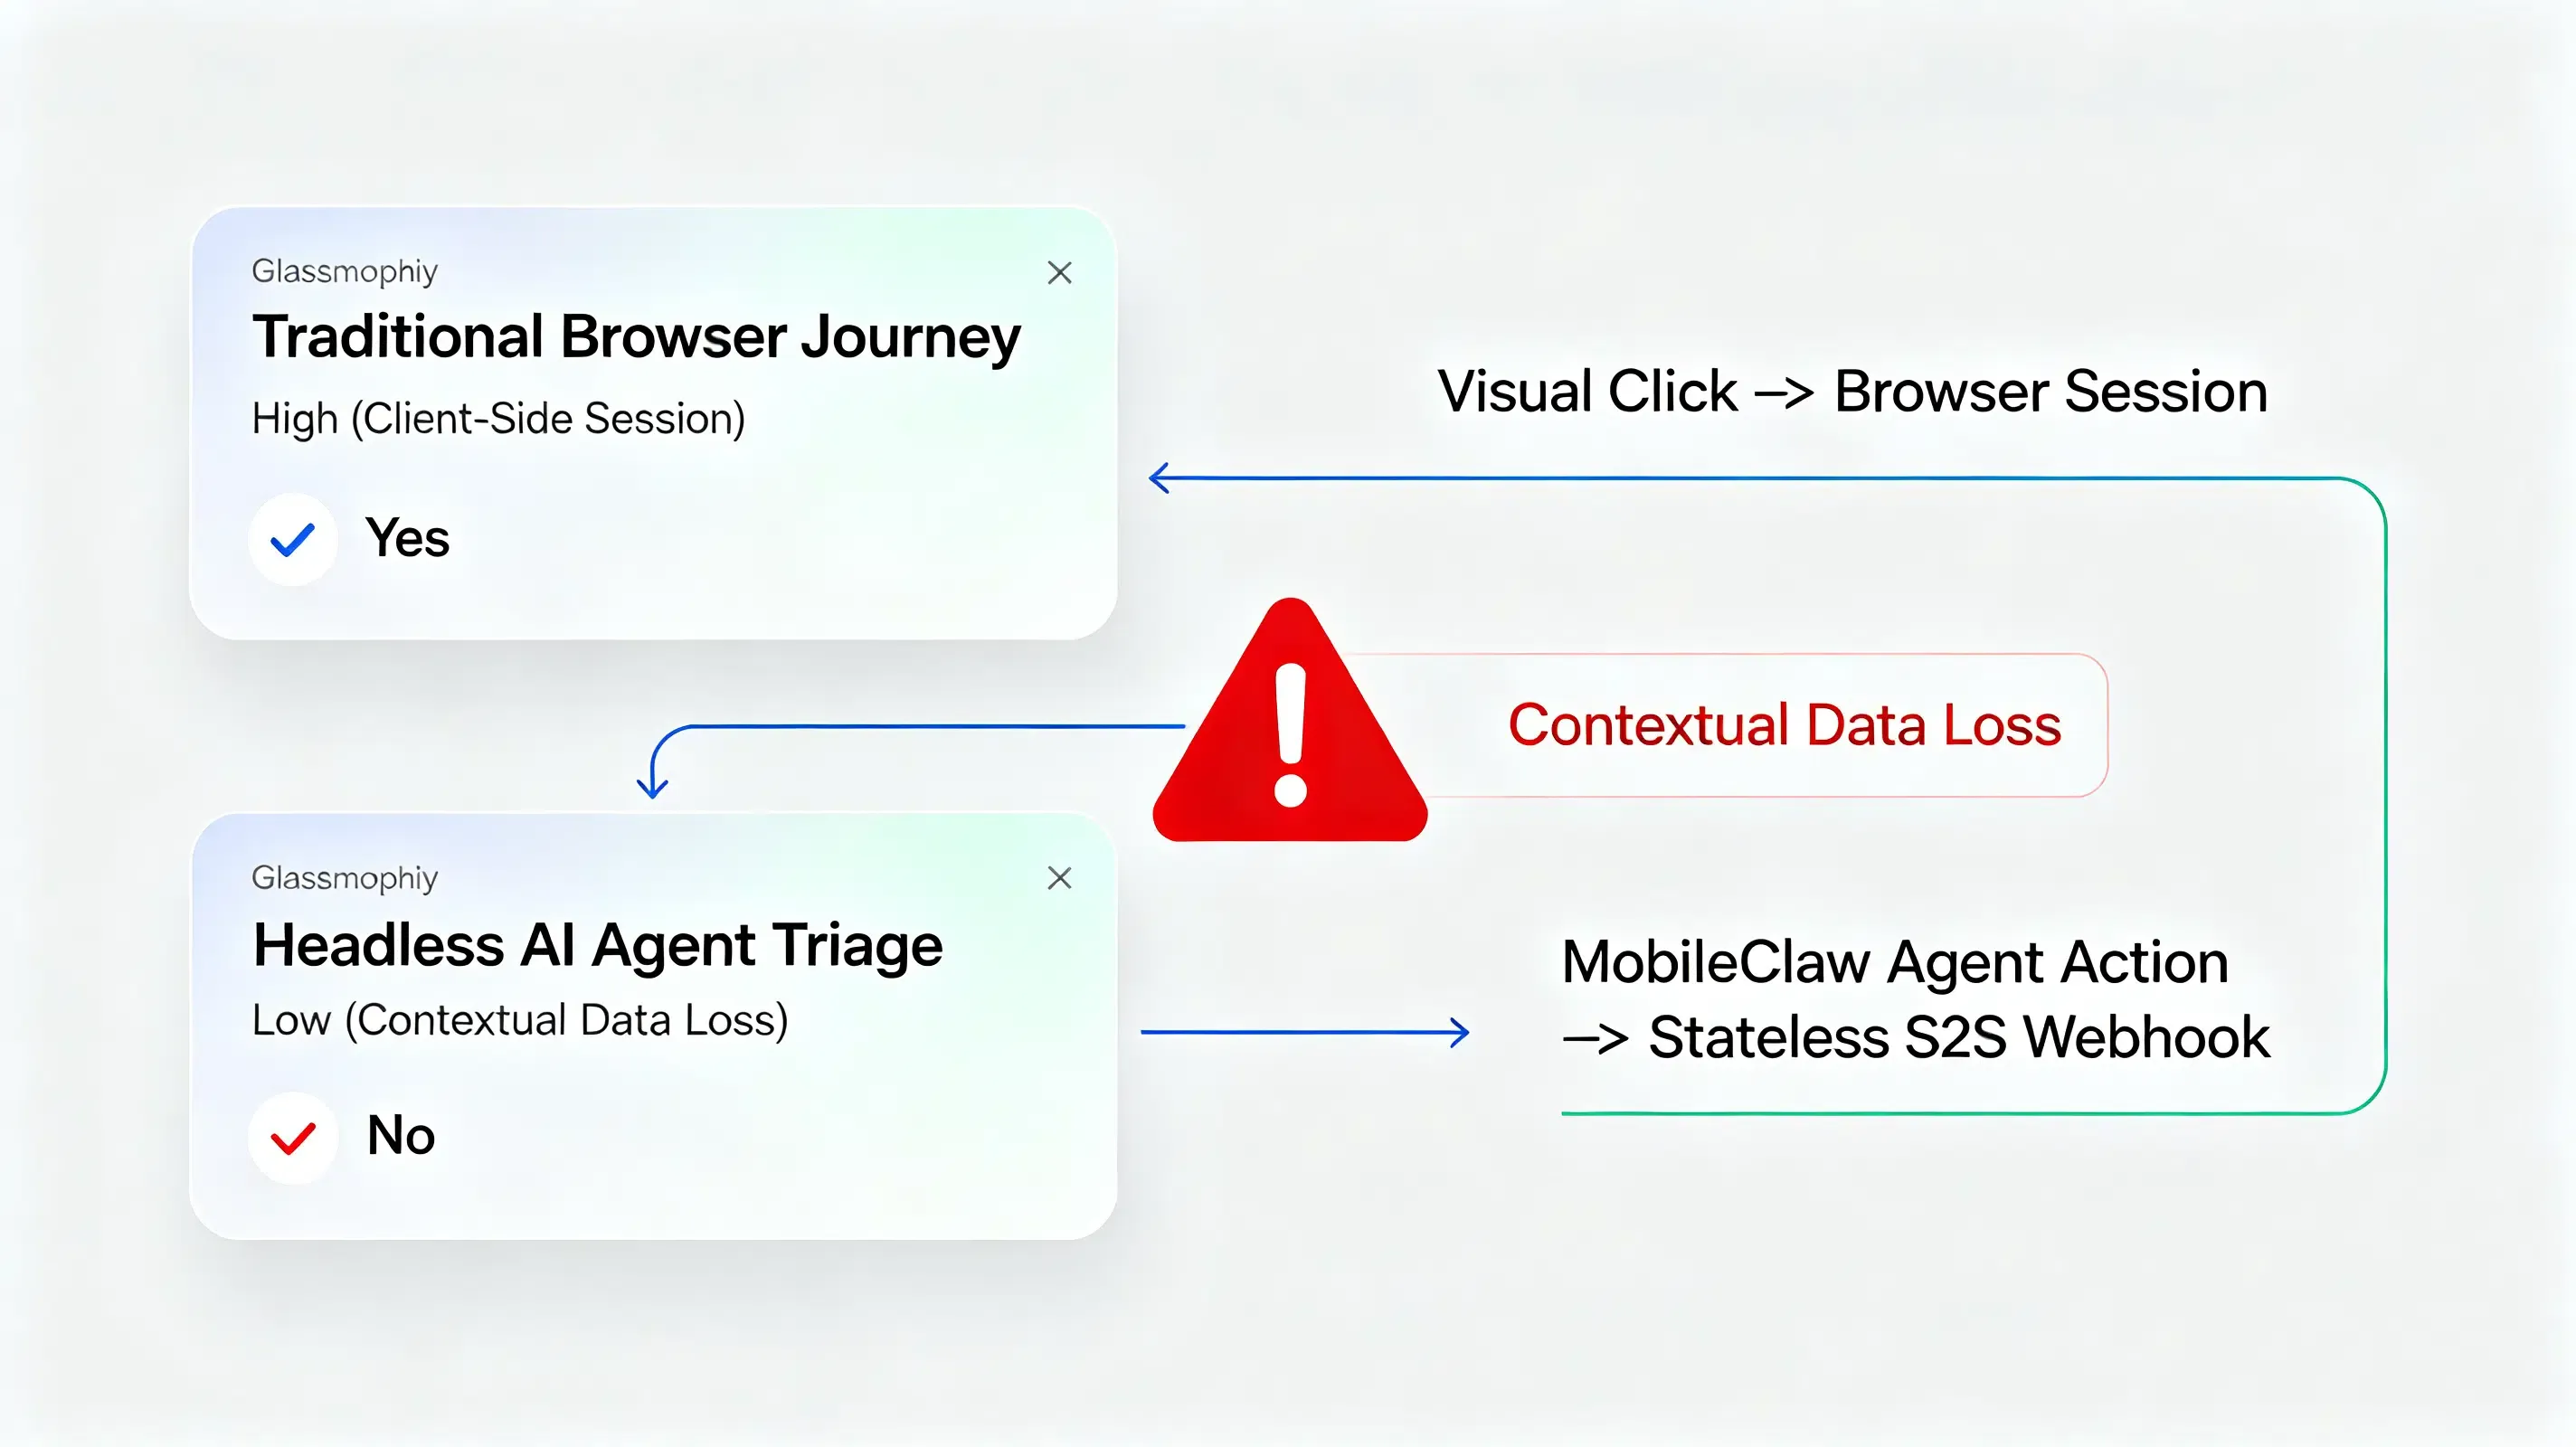
In typischen Produktionsumgebungen stellen Entwickler häufig fest, dass ein beachtlicher Teil des Traffics von automatisierten Scrapern verarbeitet wird. Die Nachverfolgung dieser programmatischen Interaktionen zeigt, dass Sicherheits-Gateways für E-Mails oder automatisierte Mailbox-Scanner Links besuchen, bevor dies Endnutzer tun. Dieses Verhalten kann die browserbasierte Attribution beeinträchtigen, wenn Systeme davon ausgehen, dass jede Anfrage von einem echten Nutzer stammt. Infolgedessen ist bei einigen Implementierungen der ursprüngliche Empfehlungskontext für die Client-Anwendung möglicherweise nicht mehr verfügbar, was zu signifikanten Attributionslücken in der Abrechnungsschnittstelle auf Netzbetreiberebene führt.
Architektonische Lösungen: Build vs. Buy bei der Statuswiederherstellung
In der Praxis entscheiden sich Engineering-Teams meist zwischen der Entwicklung einer internen Attributions-Pipeline oder der Integration eines bestehenden Attributions-SDKs. Die Entwicklung eines proprietären Systems erfordert einen erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Abgleich des Gerätestatus pflegen und die Logik kontinuierlich aktualisieren, um den sich entwickelnden Sicherheitsstandards der Betriebssysteme zu entsprechen. Für viele Unternehmen sind die Wartungskosten eines hauseigenen Trackers prohibitiv hoch.
Alternativ bewerten Entwickler im Allgemeinen mehrere Ansätze, um den Sitzungsstatus ohne clientseitige Cookies zu erhalten:
- Hauseigene benutzerdefinierte Dienste: Aufbau proprietärer Statusabgleichs-Datenbanken auf Basis der internen Cloud-Architektur.
- Plattformspezifische Tools: Nutzung grundlegender Dienstprogramme wie Firebase Dynamic Links (oder deren plattformnativen Alternativen).
- Enterprise MMPs: Einsatz von Mobile Measurement Partners wie Branch, AppsFlyer oder Adjust für Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Nutzung dedizierter Integrations-Utilities für eine präzise, kostensensitive Übergabe benutzerdefinierter Parameter.
Vergleich von Status & Attributionsfluss
| Interaktionsfluss | Visueller Cookie-Speicher | Headless-Kompatibilität | Attributionsintegrität |
|---|---|---|---|
| Traditioneller Browser-Ablauf | ✅ Ja | ❌ Nein | Hoch (Client-seitige Sitzung) |
| Headless-KI-Agent-Triage | ❌ Nein | ✅ Ja | Niedrig (Kontextueller Datenverlust) |
| Serverseitiges State-Locking | ❌ Nein | ✅ Ja | Hoch (Asynchrone Abfrage) |
Token-Dispatch auf Netzbetreiberebene -> Registrierung eines eindeutigen Metadaten-Locks
                                           |
Headless S2S-Webhook-Transaktion -> Bindung eines Transaktions-Hashs (Netzbetreiber-IP, Geräte-OS)
                                           |
App-Start auf dem Client -> SDK-Kontextabfrage auf Programmebene -> Abruf übereinstimmender Parameter
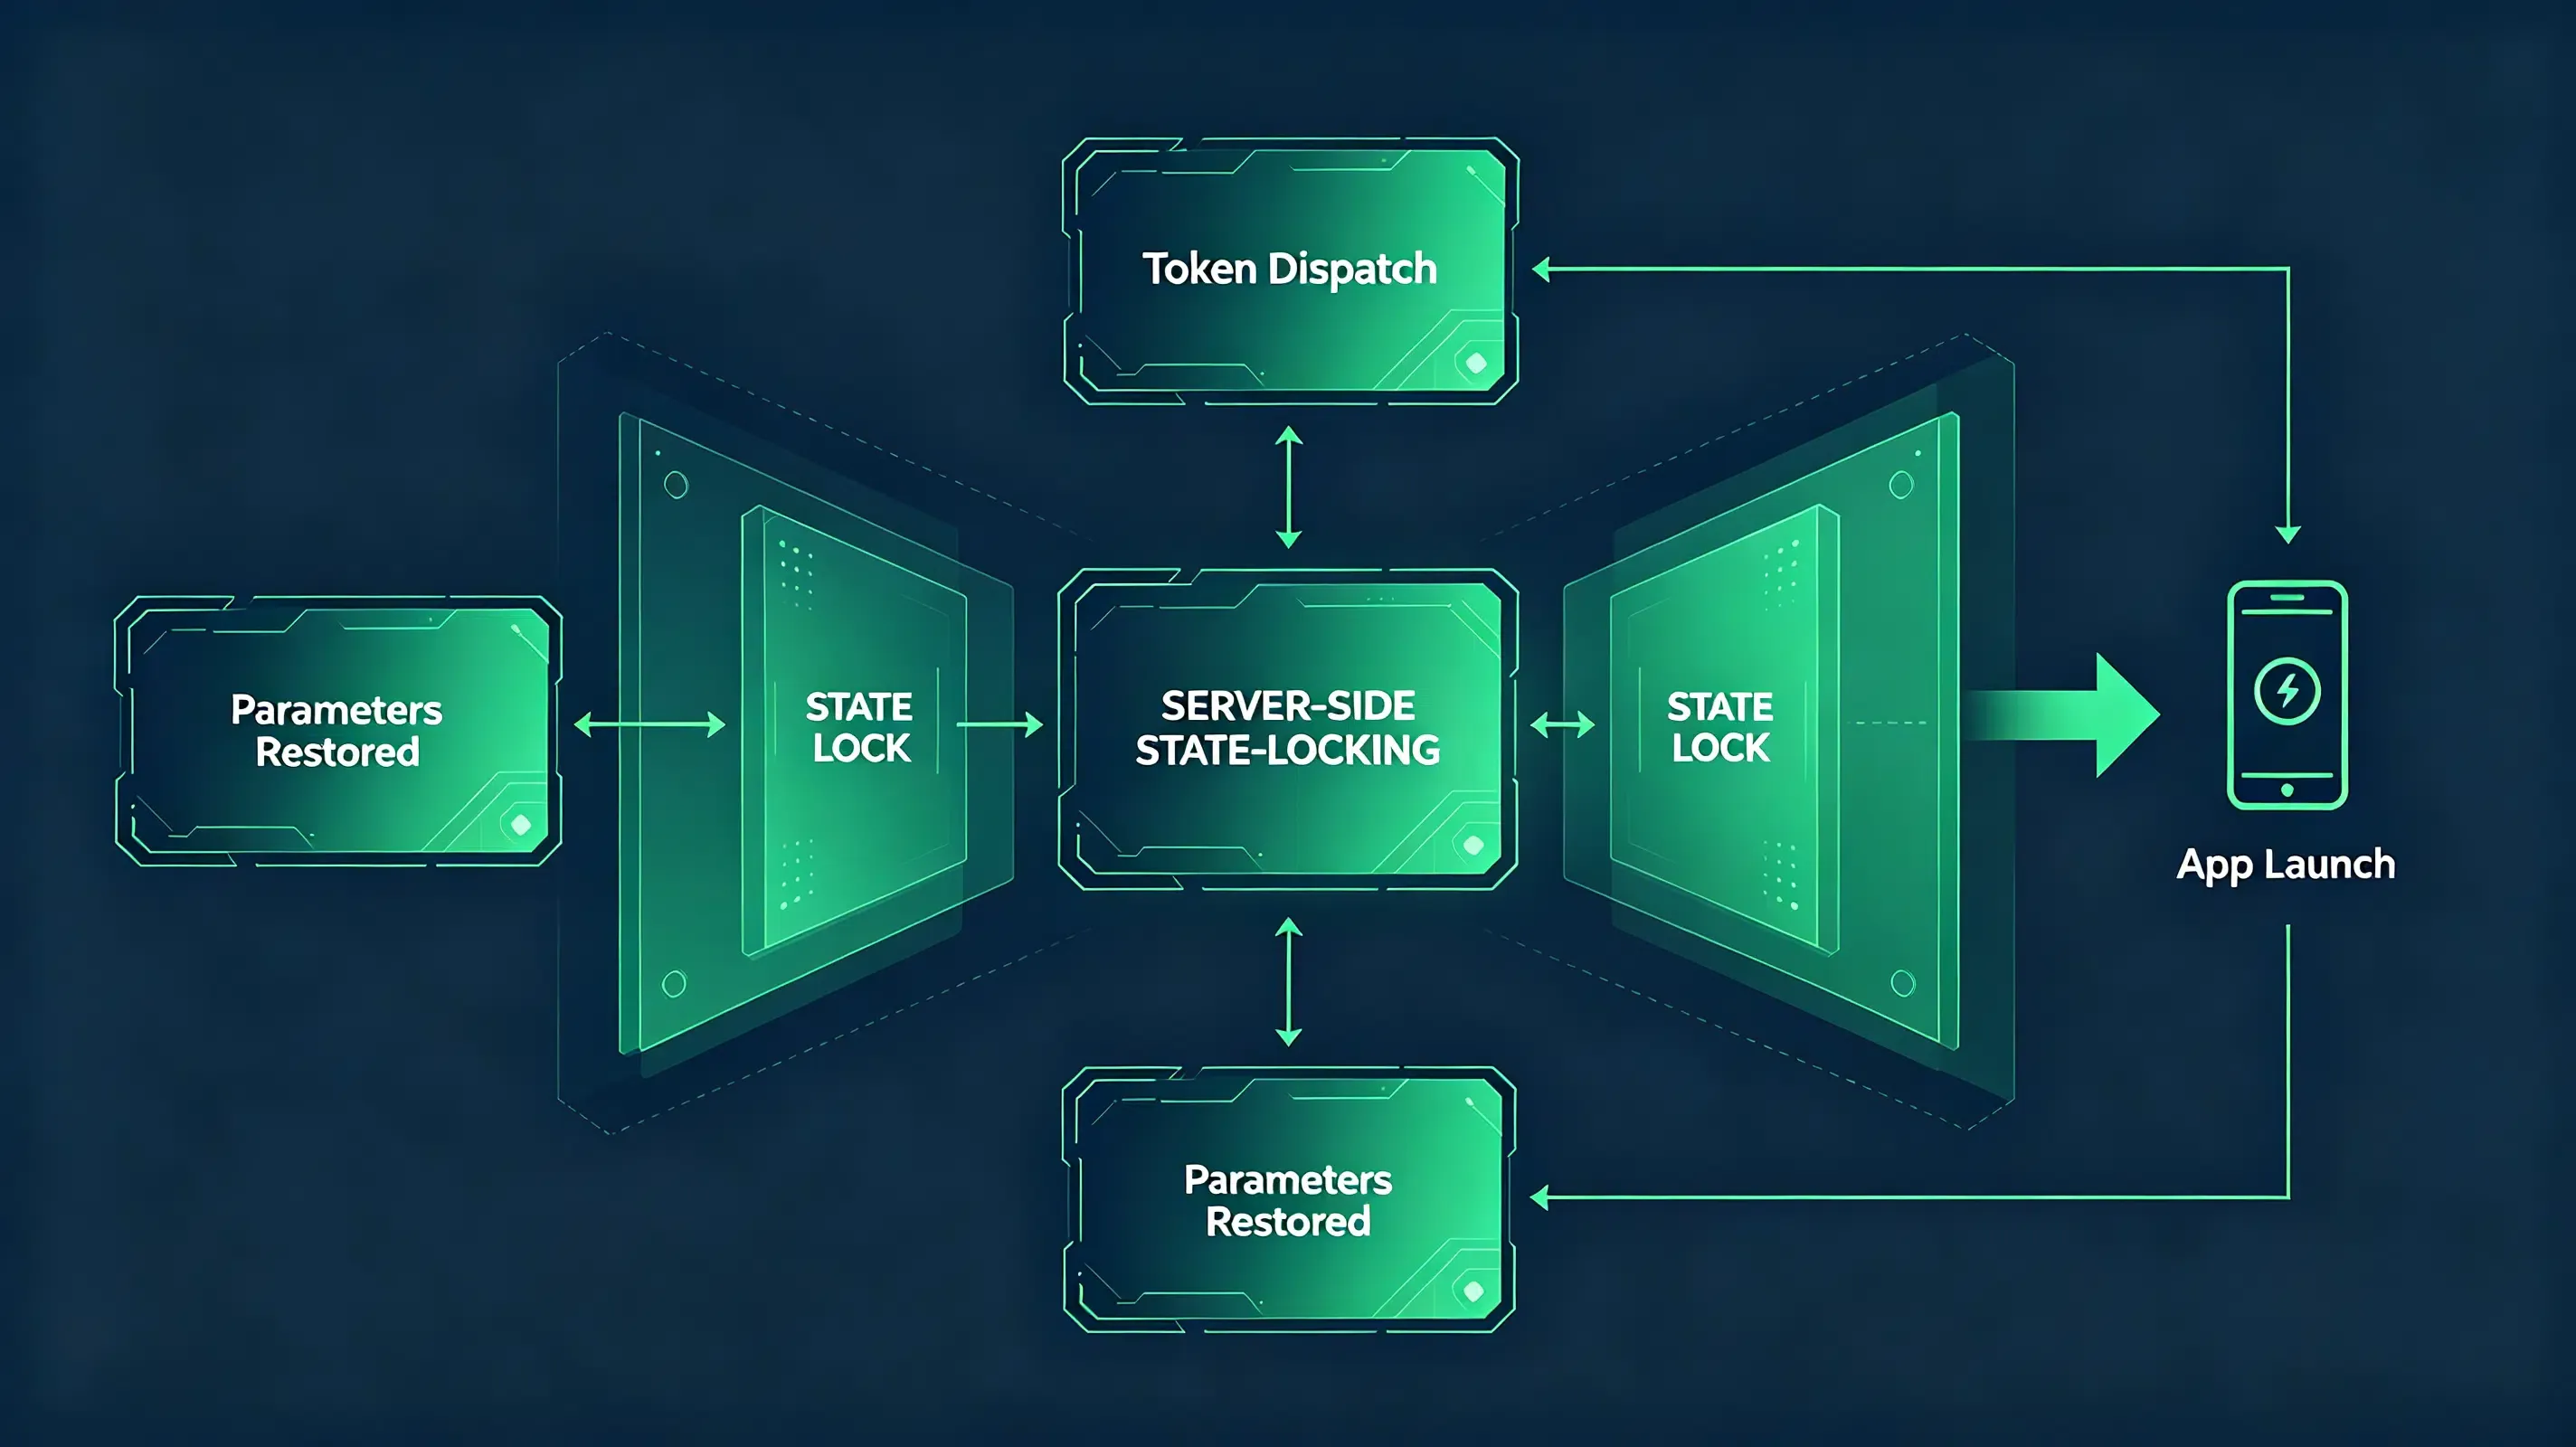
Kommerzielle Implementierungen dieser Architektur umfassen Branch, AppsFlyer, Adjust, Opoinstall und andere Plattformen für verzögerte Attribution. Diese Systeme halten den Status serverseitig vor der Installation aufrecht und stellen Parameter beim ersten App-Start wieder her, wodurch die mit clientseitigen Browser-Sitzungen verbundenen Zuverlässigkeitsprobleme umgangen werden. Engineering-Teams können diese Ansätze entsprechend ihren Bereitstellungsanforderungen und Attributionszielen bewerten.
Anpassungen der operativen Teams und Integrationschecklisten
Backend-Engineering-Teams stehen vor der unmittelbaren Aufgabe, alle aktiven Datenbankintegrationen zu prüfen, bevor automatisch kompilierte Builds gestartet werden. Produktverantwortliche sollten Einladungs- und Registrierungsschleifen so überarbeiten, dass sie nicht-visuelle User Journeys unterstützen. Anstatt davon auszugehen, dass der Nutzer eine E-Mail liest und auf einen Button klickt, sollten Workflows auf programmatische Auslöser ausgelegt sein. Growth-Teams müssen ihre Leistungsmetriken aktualisieren. Wenn autonome Software die Triage übernimmt, werden Öffnungs- und Klickraten weniger zuverlässig. Das Marketing-Operations-Team sollte sich auf die nachgelagerte In-App-Telemetrie und transaktionsverifizierte Konversionsmeilensteine konzentrieren, um Kampagnen auf der Grundlage der tatsächlich innerhalb der Anwendung ausgeführten Aktionen zu optimieren.
Checkliste für die tokenisierte Unternehmensintegration
Um die Datenkontinuität vor dem Start Ihrer integrierten agentischen Workflows sicherzustellen, sollten Engineering-Teams die folgenden Schritte ausführen:
- Überprüfung kontextueller Pfade: Überprüfen Sie, wie der MobileClaw-Compiler benutzerdefinierte URL-Parameter zuordnet, um sicherzustellen, dass Deep-Links erhalten bleiben.
- Erhalt von Headless-Empfehlungen: Mappen Sie alternative HTTP-Header, um Empfehlungsparameter während der Server-zu-Server (S2S)-Agentenausführung zu erfassen.
- Sandbox-Tests für Telemetrie: Stellen Sie sicher, dass die lokale Datenberichterstattung keine Betrugswarnungen in den Sandbox-Testumgebungen der Netzbetreiber auslöst.
- Routing-Prüfungen für Multi-Plattformen: Stimmen Sie Universal Links mit den MoMA-Plattform-Schemas ab, um Reibungsverluste bei Multi-Screen-Hand-Offs zu vermeiden.
Häufig gestellte Fragen (FAQ)
Beeinflusst das „Token“-Programm von China Mobile bestehende Verträge?
Müssen Entwickler bestehende SDK-Integrationen für die tokenisierte Abrechnung ändern?
Wie kann Referral-Attribution in tokenisierten Mobilfunk-Ökosystemen bestehen?
Der Aufstieg KI-gestützter Dienste unter Verwaltung der Netzbetreiber signalisiert einen umfassenderen Wandel hin zu netzwerknativer, programmatischer Kommunikation. Da Anwendungen zunehmend über automatisierte Datenaustausche statt über visuell gerenderte Layouts kommunizieren, müssen Engineering-Teams traditionelle Integrationsstrategien neu bewerten. Plattformen, die stark von manuellen, visuellen Nutzeraktionen abhängen, könnten mit strukturellen Lücken konfrontiert sein, wenn automatisierte Agenten die Anfrage-Pipeline verwalten. Der Übergang zu serverseitiger Attribution und sicherer Parameterübergabe stellt eine höchst wahrscheinliche Richtung dar, um zuverlässiges Tracking und Sicherheit zu gewährleisten.
Dieser Übergang legt eine grundlegende Neugestaltung unserer Mess-Frameworks und Sicherheitsprotokolle nahe. Zukünftige Attributionssysteme werden sich voraussichtlich stärker auf den serverseitigen Identitätsabgleich und eine sichere Statussynchronisierung stützen. Da immer mehr KI-Agenten als primäre Akteure digitaler Kommunikation fungieren, werden Attributionsarchitekturen zunehmend von serverseitiger Identität, verzögerter Statuswiederherstellung und protokollbasierter Kontextwahrung abhängen – statt ausschließlich von Browser-Sitzungen.
Share this article



