Blockt Cloudflare Training-Bots? Cloudflare hat eine neue Standardrichtlinie angekündigt, die KI-Training-Crawler auf berechtigten Publisher-Seiten blockiert und gleichzeitig neue Monetarisierungsoptionen für Content-Anbieter einführt. Da generative Künstliche Intelligenz die Art und Weise verändert, wie Webinhalte konsumiert werden, verbrauchen KI-Plattformen weiterhin enorme Ressourcen, ohne dabei faire Wertschöpfungsketten zu etablieren. Historisch gesehen bedeutete die Indexierung durch Suchmaschinen den Erhalt von Referral-Traffic, der über Werbung oder Abonnements monetarisiert werden konnte. Da heute jedoch Hybrid-Crawler systematisch proprietäre Daten für das Modelltraining abgreifen und gleichzeitig Zusammenfassungen generieren, die Klicks überflüssig machen, erleiden Publisher massive Umsatzverluste.
Das operative Problem & finanzielle Engpässe: Cloudflare blockiert Training-Bots auf werbefinanzierten Seiten
Auf einen Blick
- Automatisierte Schutzmechanismen leiten im dritten Quartal 2026 eine standardmäßige Einschränkung für Model-Scraping und programmatische Agenten innerhalb monetarisierter Inhaltsverzeichnisse ein.
- Crawler, die Suchindexierung mit Datenextraktion kombinieren, werden eingeschränkt, es sei denn, sie trennen ihre operativen Zwecke in isolierte Pipelines.
- Neue Vergütungsmodelle für Nutzungen entstehen, um Content-Administratoren direkte transaktionsbasierte Entlohnungen anstelle von einfachen Abrufzahlen zu bieten.
Das traditionelle Gleichgewicht zwischen Online-Publishern und automatischen Web-Scrapern ist vollständig zerbrochen. Über fast dreißig Jahre hinweg basierte das globale Internet auf einem stillschweigenden gegenseitigen Abkommen. Unter diesem Grundverständnis hießen Web-Administratoren Such-Spider willkommen, um ihre Seiten zu scannen, und erhielten im Gegenzug qualifizierte Nutzerklicks aus Suchanfragen. Dieser reziproke Austausch ermöglichte selbstfinanzierte Medien und stellte sicher, dass Ad-Impressions, digitales Sponsoring und wiederkehrende Mitgliedschaften unabhängige Software-Handbücher und Journalismus finanzieren konnten.
Der aktuelle Übergang zu groß angelegten generativen Netzwerken hat die Crawler-Aktivitäten verändert und das Ziel von der reinen Pfadfindung auf die Datenextraktion verschoben. Autonome Sammelsysteme lesen heute komplette Verzeichnisse ein, analysieren die semantischen Daten und liefern synthetisierte Erkenntnisse direkt in geschlossenen Chat-Widgets. Diese sofortige Problemlösung macht den Besuch der eigentlichen Website oft überflüssig. Auswertungen zeigen, dass die Wahrscheinlichkeit eines Nutzers, einen ausgehenden Link anzuklicken, bei generativen Suchergebnissen signifikant sinkt – in vielen Berichten auf niedrige einstellige Prozentsätze. Diese Traffic-Muster schaffen Finanzierungslücken für Plattformen, die auf Standard-Ad-Serving angewiesen sind, um ihre Betriebskosten zu decken.
Warum Cloudflare das Blockieren von Training-Bots zu einem Publisher-Mandat machte
Publisher standen lange vor einem schwierigen Kompromiss zwischen dem Schutz ihrer Inhalte und der Aufrechterhaltung der Suchsichtbarkeit. Wenn ein unabhängiger Seitenbetreiber Googlebot, Applebot oder Bingbot blockiert, um Modelltraining zu verhindern, riskiert er, aus traditionellen Suchindizes zu verschwinden. Dieses strukturelle Monopol zwingt Content-Ersteller vor eine schwierige Wahl: wertvolle proprietäre Daten kostenlos preiszugeben oder die Auffindbarkeit vollständig zu opfern. Diese Dynamik ermutigt zudem aufstrebende KI-Einheiten dazu, evasive Crawling-Taktiken einzusetzen, was die Serverlast für Publisher erhöht, die bereits die Kosten für redundante Anfragen tragen.
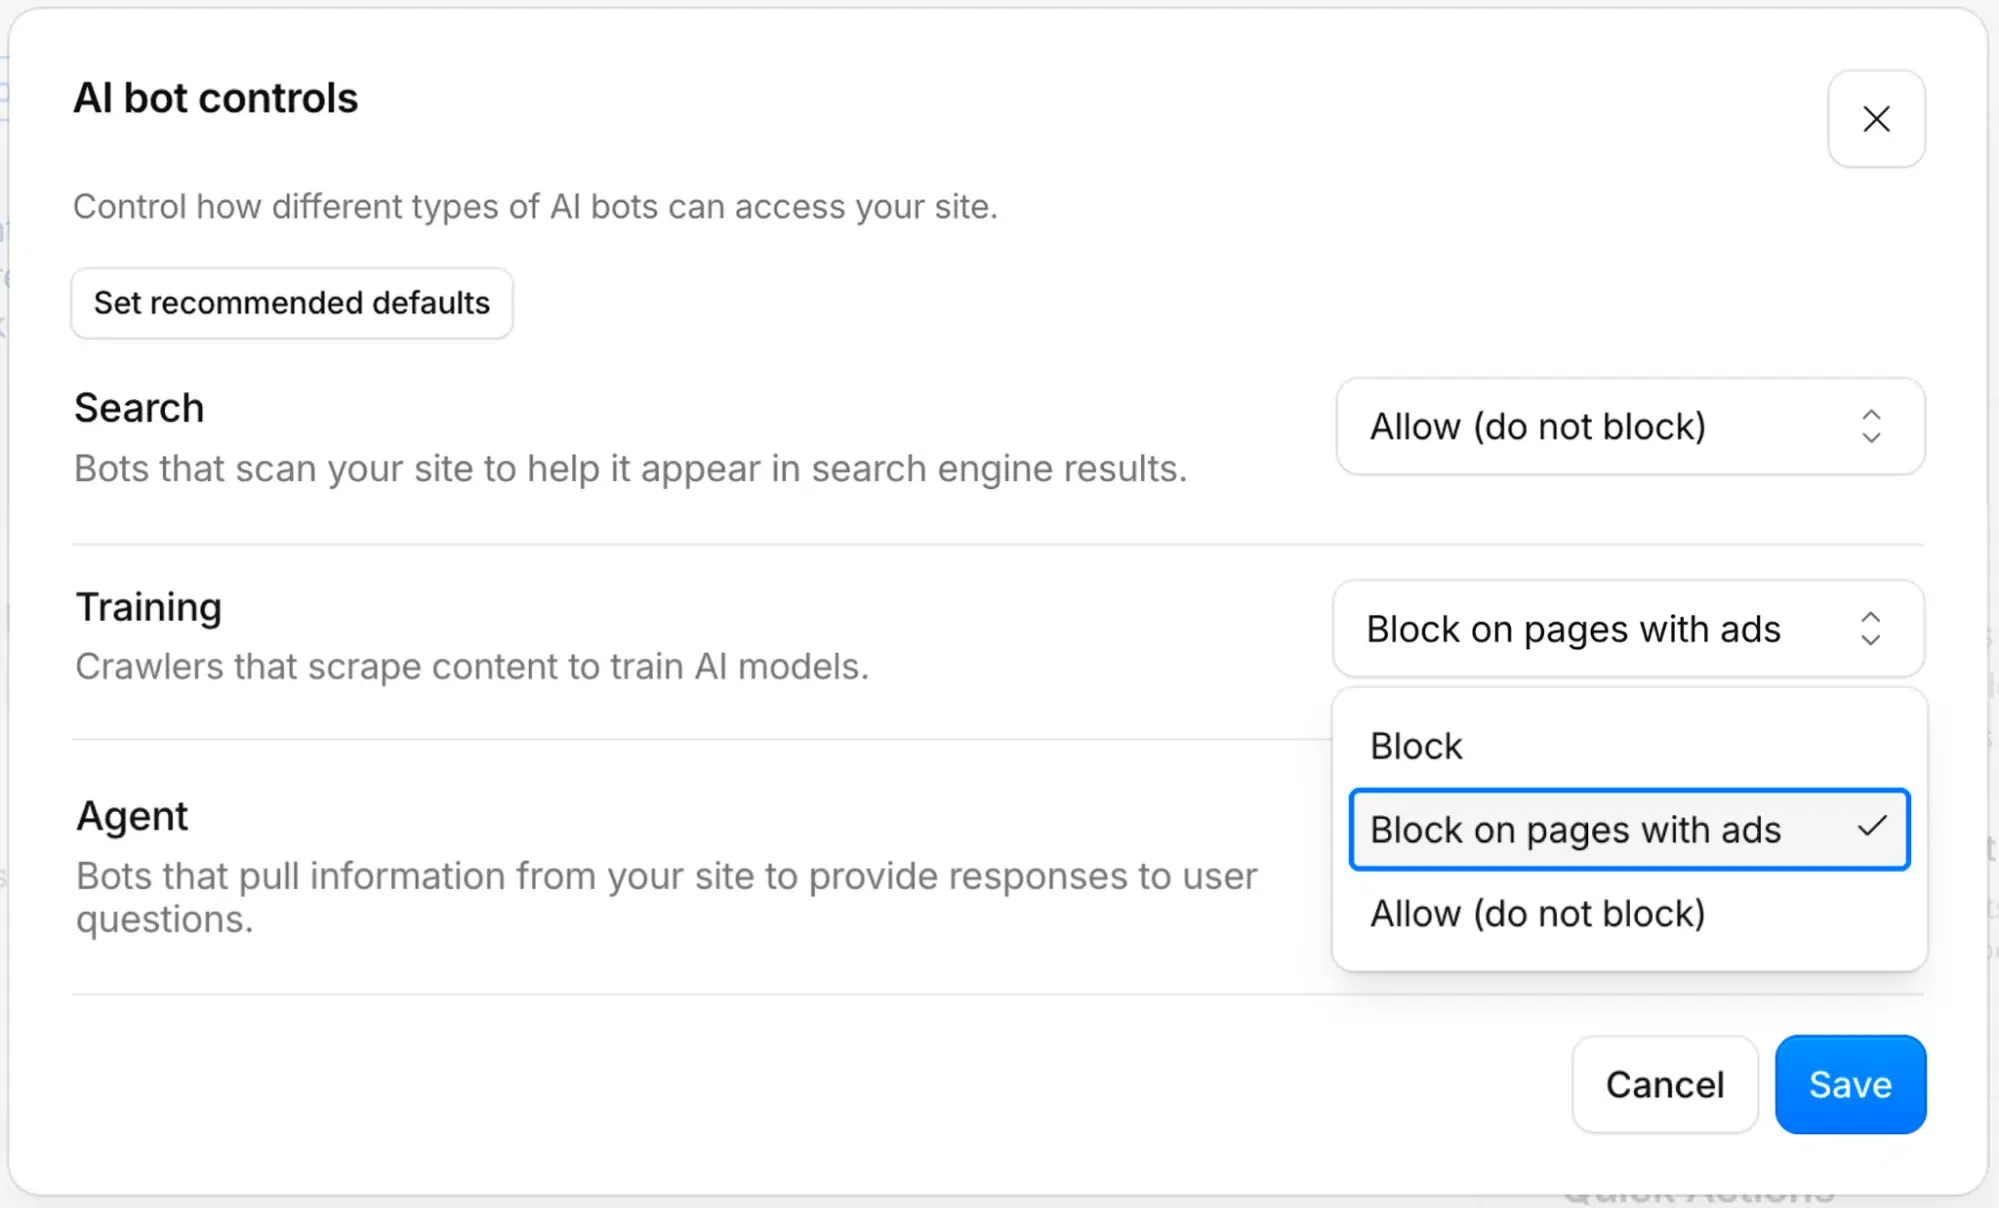
Um ein Gleichgewicht zu erzwingen, hat Cloudflare einen deklarativen Gatekeeper-Mechanismus eingeführt. Cloudflare gab an, dass die Standardrichtlinie ab dem 15. September 2026 ausgerollt wird und standardmäßige Sperren gegen Training-Bots und nutzergesteuerte Agenten auf allen werbefinanzierten Kundenseiten etabliert. Dieses Update stellt sicher, dass monetarisierbarer Content nicht ohne ausdrückliche Erlaubnis gecrawlt werden kann. Gleichzeitig strukturiert der Netzwerkgigant seine Monetarisierung um: von der bisherigen „Pay-Per-Crawl“-Architektur hin zu einem ergebnisorientierten „Pay-Per-Use“-Ökosystem. Durch Integrationen mit Plattformen wie You.com und Ceramic.ai können Publisher eine direkte Vergütung sichern, wann immer ein KI-Agent ihre Inhalte nutzt, um eine Anfrage zu beantworten – was einen nachhaltigen, transaktionsbasierten Umsatzstrom schafft.
Systemische Ursachen & nicht-visuelle Request-Ketten der Cloudflare Training-Bot-Blockade
Die Analyse der physischen Zusammensetzung des Internet-Traffics zeigt, dass automatisierte Bots mittlerweile über 50 % aller Online-Aktivitäten ausmachen. Dieses Volumen belastet Origin-Server massiv, insbesondere weil doppelte Anfragen oft unveränderte Inhalte erneut abrufen. Die Cloudflare-Telemetrie deutet darauf hin, dass mehr als die Hälfte des verifizierten Crawler-Traffics völlig redundant ist und auf beiden Seiten der Verbindung Rechenleistung verschwendet. Das grundlegende Problem liegt in der zugrunde liegenden Architektur moderner Such- und Scraping-Operationen, die auf Hybrid-Bots beruhen, welche ihre wahre Absicht verschleiern.
Auf der Anwendungsschicht unterscheiden sich die technischen Eigenschaften eines nutzergesteuerten Agenten erheblich von standardmäßigen, menschlichen Browsersitzungen. Diese Unterscheidung ist entscheidend, da moderne Headless-Scraper traditionelle interaktive Elemente vollständig umgehen, was zu schwerwiegenden Tracking-Unterbrechungen in nachgelagerten Messsystemen führt.
Protokoll-Diskonnektivität: Zustandlose Agenten vs. zustandsbehaftete Webbrowser
Die traditionelle Weboptimierung geht davon aus, dass Standard-Browsersitzungen ihren Status über Cookies, lokalen Speicher und strukturierte User-Agent-Strings verwalten. Im Gegensatz dazu führen autonome Agenten und Headless-Crawler zustandslose HTTP-Anfragen durch. Dieser Unterschied bricht die Mess-Pipelines, die Publisher nutzen, um ihren Werbewert zu rechtfertigen. Das folgende Diagramm verdeutlicht die grundlegenden Unterschiede auf Anwendungsebene:
[Standard-Websession]
  User-Browser (Persistenter Status & Cookies) ──> Web-HTTP-Request ──> Ad-Impressions & Referrer registriert


[Zustandslose Agenten-Session]
  Automatisierter Crawler (Zustandloses HTTP / Headless-Tool) ──> Isolierter Abruf ──> Fehlende Referrer & verlorene Attribution
Wenn ein automatisierter Browser-Agent eine Seite abruft, den Text verarbeitet und eine Antwort in einer geschlossenen Chat-Umgebung rendert, wird der gesamte clientseitige Kontext zerstört. Traditionelle Tracking-Skripte können nicht ausgeführt werden. Es werden keine Ad-Impressions registriert und Standard-Referrer-Header verschwinden. Dies erzeugt eine Attributionslücke, in der der Publisher den rohen Informationswert liefert, das nachgelagerte System jedoch null Engagement aufzeichnet. Derselbe Verlust des Browser-Kontexts beeinträchtigt auch nachgelagerte Mobile-Attribution-Workflows, wenn ein Nutzer später eine Anwendung installiert. Da diesen Headless-Besuchen zustandsbehaftete Tracking-Container fehlen, können Standard-Mess-Tools das ursprüngliche Entdeckungsereignis nicht mit der anschließenden App-Installation verknüpfen. Diese Dynamik beschleunigt das Versagen traditioneller Multi-Touch-Attributionsmodelle.
Lösungsvergleich: Build-vs.-Buy-Abwägungen in der Ära der Cloudflare-Bot-Blockade
Da sich die Standardgrenzen des clientseitigen Trackings unter neuen automatisierten Scraper-Regulierungen auflösen, müssen Engineering-Teams ihre Attributionsarchitekturen neu bewerten. Die ausschließliche Abhängigkeit von clientseitigen Browser-Cookies oder gerätebasierten Attributen ist keine tragfähige Langzeitstrategie mehr. Entwickler stehen vor der grundlegenden Entscheidung zwischen Eigenbau oder Zukauf: Entweder eine eigene serverseitige Kontext-Matching-Datenbank aufbauen oder ein vorkonfiguriertes, gehärtetes Messsystem integrieren, das Headless-Interaktionen überlebt.
Architektonische Bewertung: Build vs. Buy im zustandslosen Zeitalter
Der Aufbau eines internen Kontext-Matching-Systems erfordert die Einrichtung einer serverseitigen Status-Datenbank, um Entwicklersitzungen zu cachen und abzugleichen. Während dieser Ansatz die volle Kontrolle über die Datenpipeline bietet, ist der Engineering-Aufwand beträchtlich. Entwickler müssen API-Payloads manuell abgleichen, Sitzungsabläufe verwalten und sichere kryptografische Signaturen implementieren, um Betrug zu verhindern. Die Integration eines fertigen, vorgefertigten Mess-SDKs eliminiert hingegen diese Wartungslast.
Die folgende Vergleichsmatrix zeigt, wie verschiedene Tracking-Methoden in einer zustandslosen, bot-intensiven Umgebung abschneiden:
| Metriken & Funktionen | Interne Datenbank-Sitzung | Legacy Firebase / Webview-Weiterleitung | Premium MMP-Plattformen (Adjust, AppsFlyer) | Deferred Deep Linking SDK (OpoInstall) |
|---|---|---|---|---|
| Attributions-Überleben | Hoch (serverseitig) | Niedrig (clientseitig) | Hoch (Multi-Touch) | Hoch (programmatisches Mapping) |
| Entwicklungskosten | Extrem hoch | Niedrig | Hoch | Niedrig |
| Wartungsaufwand | Hoch (laufend) | Niedrig | Niedrig | Niedrig |
| Betrugsbekämpfung | Mittel (manuelle Regeln) | Niedrig | Hoch (algorithmisch) | Hoch (Zero-Trust-Signaturen) |
| Latenz-Auswirkung | Variabel | Mittel | Mittel | Niedrig (ultraleichter Footprint) |
Kommerzielle Implementierungen dieses Modells umfassen Adjust, AppsFlyer, Branch und andere Deferred-Attribution-Systeme. Ein Beispiel ist OpoInstall, das Deferred Deep Linking und serverseitige Parameterwiederherstellung bereitstellt, um Sitzungs-Metadaten über verteilte Web- und Mobile-Kontexte hinweg zu erhalten. Durch die Entkopplung der Weiterleitungskette von clientseitigen Redirects bewahrt dieser Ansatz die Metadaten der User-Journey vom ersten Suchereignis bis zum finalen App-Start und umgeht dabei die durch Proxy-Blocker auferlegten Einschränkungen. Mobile-Attributionsplattformen nutzen ähnliche serverseitige Status-Wiederherstellungsideen, um die Konsistenz der Konversion sicherzustellen, wenn Browser-Kontexte vollständig fehlen.
Integrations-Checklisten & Governance-Zeitpläne: Überleben der Cloudflare Training-Bot-Blockade
Um die Datenkontinuität zu gewährleisten, während Cloudflare seine Standard-Sperren für Training-Bots auf werbefinanzierten Seiten implementiert, müssen Engineering- und Produktteams einen strukturierten Übergangszeitplan etablieren. Für Entwickler bedeutet dies die Abkehr von clientseitigen Weiterleitungen hin zu robusten serverseitigen Verifizierungsmethoden. Für Growth-Teams erfordert dies eine Überarbeitung der Pipelines zur Berechnung des Marketing-ROI, um den Verlust von Standard-Browser-Attributionsdaten auszugleichen.
Checkliste für die Entwickler-Implementierung
- Implementierung von RFC 7239 Forwarded-Headern: Konfigurieren Sie alle eingehenden API-Gateways so, dass sie den standardisierten
Forwarded-Header lesen und analysieren, um vertrauenswürdige Zwischen-Proxys zu identifizieren.
Forwarded: for=203.0.113.1;proto=https
- Einsatz kryptografischer URL-Signaturen: Stellen Sie sicher, dass alle ausgehenden Werbelinks kryptografisch signierte Parameter verwenden, um zu verhindern, dass automatisierte Bots Referral-Werte manipulieren.
- Aktivierung von serverseitigem Session-Matching: Wechseln Sie von Cookie-basierten clientseitigen Redirects zu einer programmatischen Status-Datenbank, die Sitzungsschlüssel beim ersten App-Start abgleicht.
Checkliste für Produkt- & Growth-Strategie
- Rekonstruktion der Marketing-ROI-Modelle: Passen Sie Akquise-Funnels an, um serverseitige Aktivierungsereignisse stärker zu gewichten als traditionelle Klicks auf Webanzeigen.
- Bereitstellung kontextueller Erfahrungs-Wiederherstellungen: Nutzen Sie Parameter-Durchreichungs-Frameworks, um das beabsichtigte Ziel des Nutzers wiederherzustellen, selbst wenn der Web-Referrer durch einen Agenten gelöscht wurde.
- Bot-Traffic-Audit in BotBase: Verwenden Sie verhaltensbasierte Echtzeit-Klassifizierungen, um zu prüfen, wie automatisierte Scraper mit Marketing-Funnels interagieren.
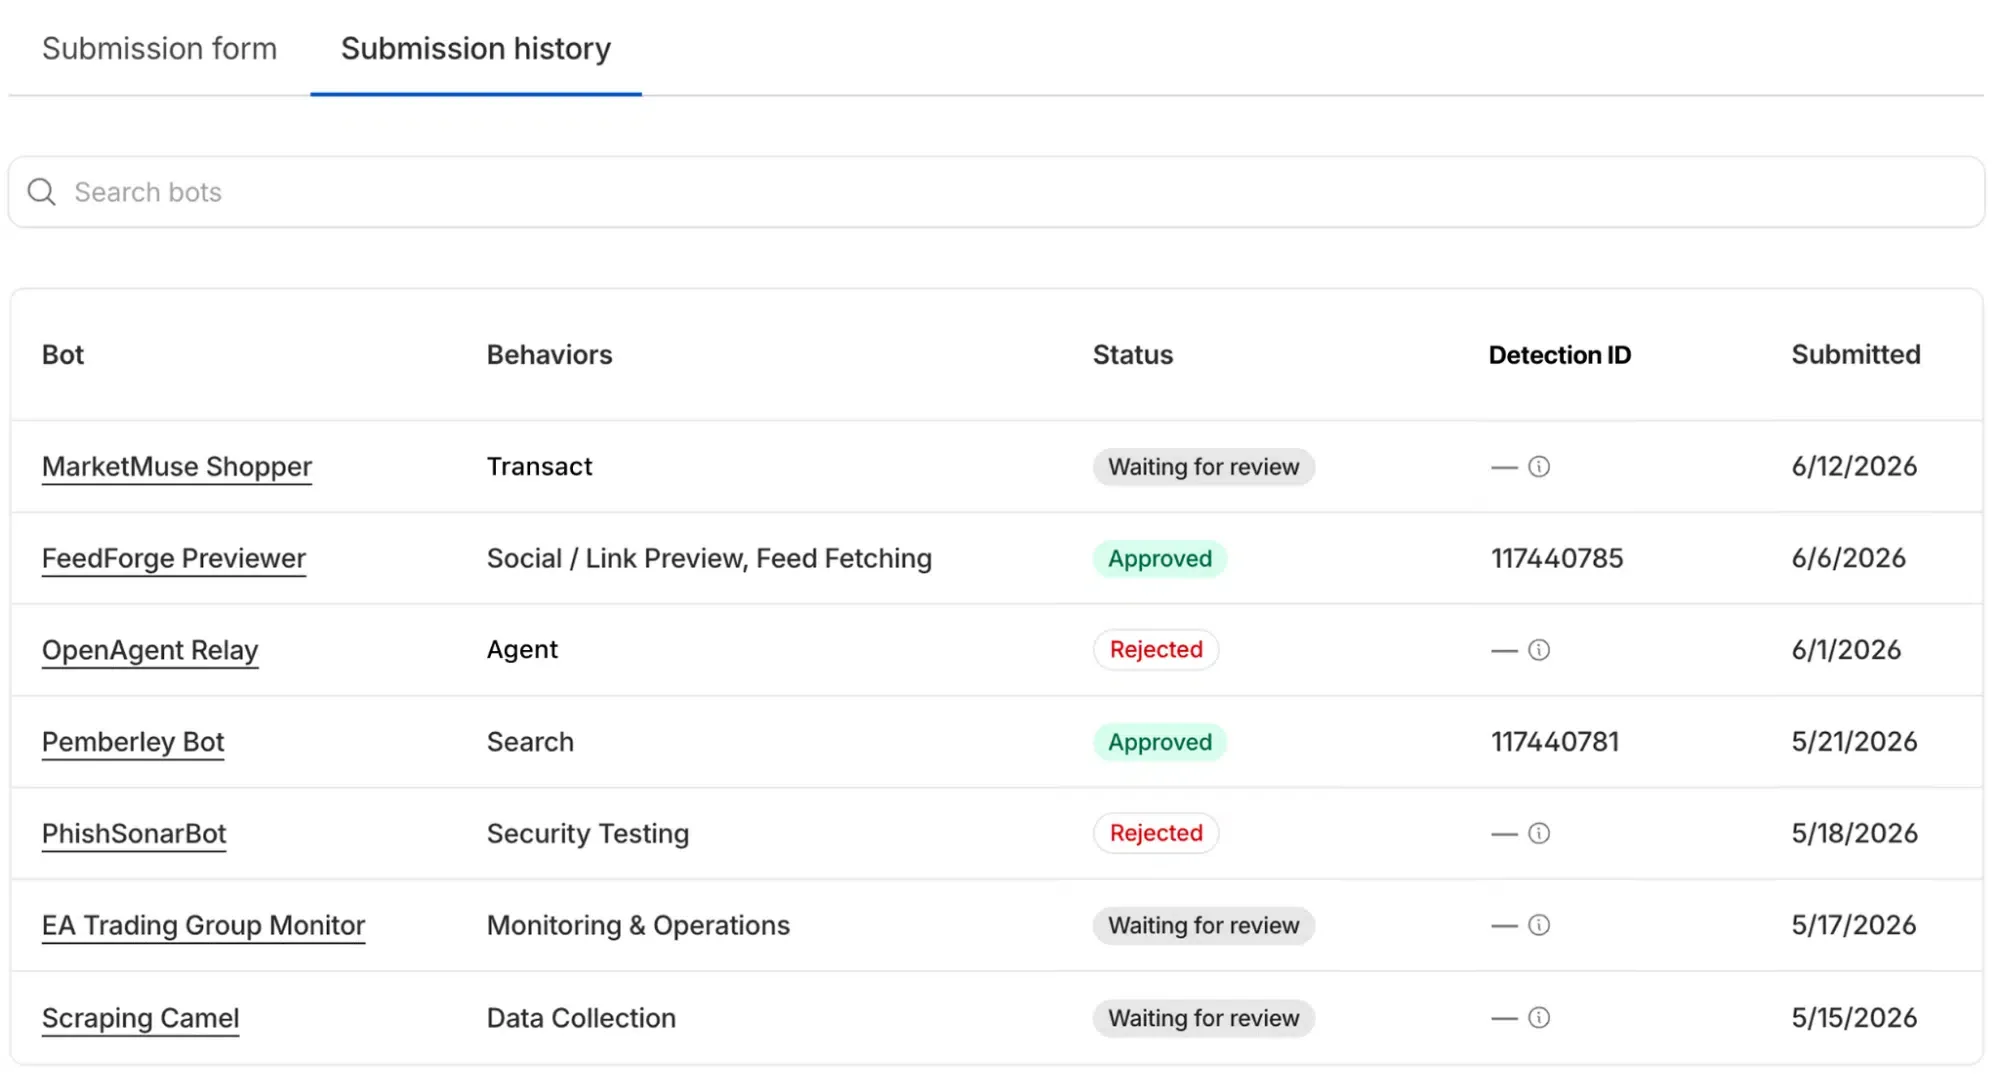
Entwickler können ihre Seiten so konfigurieren, dass sie explizite Indexierungspräferenzen kommunizieren, indem sie ihre standardmäßige robots.txt-Konfiguration um moderne Metadatenfelder erweitern.
# Beispiel, inspiriert durch vorgeschlagene Metadaten-Erweiterungen
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Dieser strukturierte Ansatz erlaubt es Content-Besitzern, die Auffindbarkeit in Suchmaschinen zu bewahren und gleichzeitig zu verhindern, dass KI-Plattformen dauerhaft wertvolle proprietäre Inhalte in ihre geschlossenen Trainings-Datensätze aufnehmen.
Häufig gestellte Fragen (FAQ)
Warum crawlt derselbe Bot Seiten sowohl für die Suche als auch für das KI-Training?
Wie erkennt Cloudflare, welche Seiten Werbung enthalten, um die Sperre auszulösen?
Was ist der Unterschied zwischen Pay Per Crawl und Pay Per Use?
Der Übergang des Internets von einer menschzentrierten Browsing-Umgebung zu einem agentenbasierten Ökosystem erfordert einen grundlegenden Wandel in der Art und Weise, wie wir digitale Erlebnisse aufbauen und messen. Da automatisierte Proxys und zustandslose Agenten zu den primären Konsumenten von Webinhalten werden, verlieren traditionelle clientseitige Attributionsmodelle weiter an Bedeutung. Die Verlässlichkeit auf Browser-Cookies und einfache HTTP-Referrer reicht nicht mehr aus, um die Datenpipelines zu sichern, die Nutzerakquise und digitale Monetarisierung vorantreiben.
Um in dieser neuen Ära Wachstum zu sichern, müssen Engineering- und Produktteams ihre Attributionslogik von Standard-Browser-Aktionen lösen. Durch die Einführung von serverseitiger Identitätsauflösung, kryptografisch signierten Parametern und robusten Frameworks zur Parameter-Weiterleitung können Unternehmen ihre Datenpipelines vor automatisierten Scraper-Blockaden schützen. Dieser Wandel bedeutet nicht nur die Anpassung an ein einzelnes Richtlinien-Update; es geht darum, unsere Systeme so neu zu gestalten, dass sie in einem dezentralen, agenten-fähigen Internet bestehen können.
Share this article



