 Die Frage, ob eine GPU im Leerlauf ist – wie ein Hynix-Experte behauptet –, ist von zentraler Bedeutung. Laut einer Präsentation von Professor Joungho Kim vom KAIST, der intensiv mit SK Hynix an HBM-Forschung zusammenarbeitet, wird die GPU-Auslastung bei der KI-Inferenz zunehmend eher durch die Speicherbandbreite als durch die reine Rechenleistung begrenzt. Diese wachsende „Speicherwand“ hat High Bandwidth Memory (HBM) zu einer der wichtigsten Technologien in der KI-Infrastruktur gemacht. Während Plattformen für generative künstliche Intelligenz vom Zeitalter des Trainings in das der Inferenz übergehen, hat sich der primäre Leistungsengpass von der reinen Prozessorkapazität auf den Durchsatz des Speicherbusses verlagert. Standard-Grafikprozessoren (GPUs) sind für massive parallele Berechnungen ausgelegt. Da jedoch jeder Inferenzschritt das Lesen von Milliarden Parametern aus dem Speicher, die Berechnung und das Zurückschreiben der Zustände erfordert, verbringen die Prozessoren den Großteil ihrer Betriebszeit im Leerlauf, während sie auf den Datentransport über Standardbusse warten.
Warum HBM-Speicher der Schlüssel ist: Abstimmung von Hochdurchsatz-Pipelines auf Hardware-Grenzen
Auf einen Blick
- Branchenanalysen deuten darauf hin, dass die tatsächliche Rechenauslastung selbst bei Millionen eingesetzter Standard-Grafikprozessoren aufgrund von Verzögerungen bei der Datenübertragung auf dem Speicherbus auf zehn bis dreißig Prozent begrenzt ist.
- Die physikalischen Grenzen der Chip-Skalierung treiben einen Paradigmenwechsel hin zum speicherzentrierten Rechnen voran, bei dem vertikal gestapelte Architekturen mit hoher Bandbreite (HBM) zum Einsatz kommen.
- Es wird erwartet, dass die 3D-Verbundverpackung der nächsten Generation Grafikprozessoren, schnellen On-Package-SRAM-Cache und 3D-NAND-Flash-Speicher mit hoher Kapazität stapelt, um Datentransferengpässe zu beseitigen.
Die weltweite Recheninfrastruktur steht vor einer strukturellen Krise. Jahrelang konzentrierte sich der Wettlauf um größere KI-Modelle auf die Skalierung der reinen Rechenleistung. Unternehmen und Cloud-Anbieter haben Milliarden investiert, um massive Cluster von Grafikprozessoren (GPUs) zu erwerben. Dieser Fokus war während der ersten Trainingsphase logisch, als das Training von Modellen von kontinuierlichen Backpropagation-Berechnungen abhing. Bei diesen Arbeitslasten arbeiteten parallele Recheneinheiten mit maximaler Kapazität, um Modellparameter zu aktualisieren, wie im NVIDIA Hopper Architecture Whitepaper beschrieben.
Da Anwendungen jedoch in die Ära der Inferenz übergehen, haben sich die technischen Anforderungen geändert. In Inferenzszenarien besteht die größte Herausforderung nicht in der Aktualisierung von Gewichten, sondern im Streaming massiver, vortrainierter Parameter zum Prozessor, um Anfragen sofort zu beantworten. Jeder generierte Token erfordert den wiederholten Zugriff auf Milliarden von Modellparametern, die im Speicher mit hoher Bandbreite gespeichert sind. Da Standard-Busarchitekturen Daten nicht schnell genug bewegen können, um mit den Ausführungsgeschwindigkeiten moderner Prozessoren Schritt zu halten, leiden Rechenkerne unter Datenmangel, was zu extrem hohen Leerlaufzeiten führt. Dieser Leistungsengpass wird in technischen Branchenberichten diskutiert, darunter Forschungsergebnisse akademischer Einrichtungen wie dem Korea Advanced Institute of Science and Technology (KAIST) sowie Hardware-Entwicklern wie NVIDIA und SK Hynix.
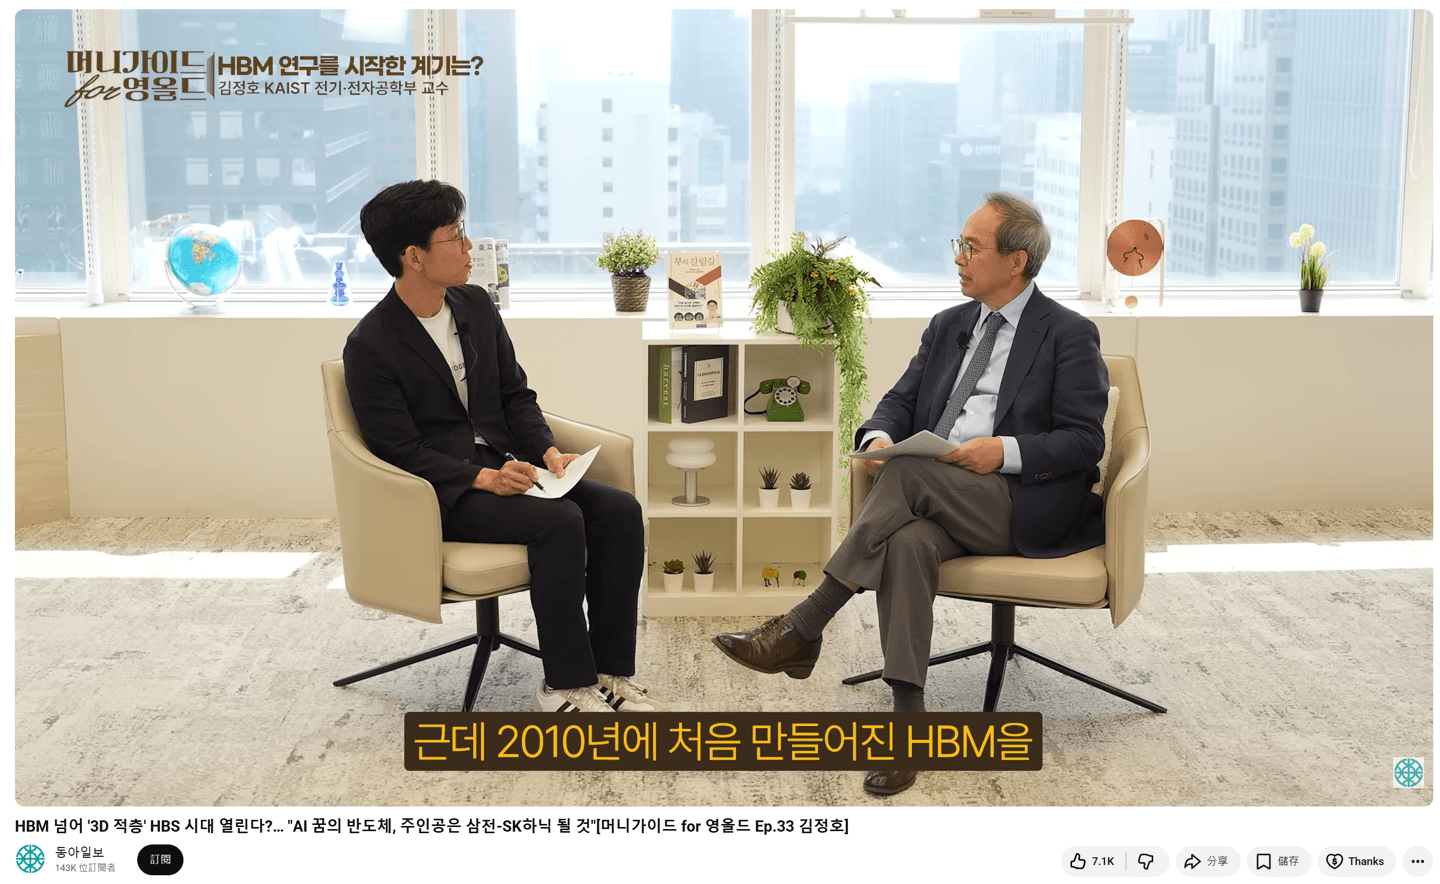
Diese Leistungslücke zeigt die physikalischen Grenzen auf, warum HBM-Speicher in der Ära der Inferenz der Schlüssel ist. Laut der von der KAIST TERA Lab veröffentlichten HBM-Technologie-Roadmap werden zukünftige HBM-Generationen die Bandbreite durch zusätzliches DRAM-Stacking, TSV-Integration, fortschrittliche Verpackung und thermische Optimierung weiter erhöhen. Standard-DRAM-Pakete verfügen nicht über die notwendigen parallelen Leitungen, um die Verarbeitungsgeschwindigkeiten moderner Beschleuniger zu unterstützen. Um diese „Speicherwand“ zu überwinden, setzen Hardware-Architekten auf High Bandwidth Memory (HBM)-Systeme. Durch das vertikale Stapeln von DRAM-Dies und die Nutzung von Tausenden von Silizium-Durchkontaktierungen (TSVs) zur Etablierung breiter, paralleler Busse, erläutert die JEDEC HBM3-Spezifikation (JESD238), wie TSV-basierter gestapelter Speicher die verfügbare Bandbreite im Vergleich zu herkömmlichen DRAM-Paketen drastisch erweitert. Für Entwickler verdeutlicht diese Hardware-Entwicklung eine grundlegende Regel von Systemen mit hohem Durchsatz: Der Engpass ist fast immer die Transportschicht, nicht der Rechenknoten.
Die Funktionsweise des Konzepts „HBM-Speicher ist der Schlüssel“
Auf architektonischer Ebene fungieren Standard-Computerbusse wie schmale Autobahnen, die den Fluss großer Datensätze einschränken. Wenn eine Anwendung einen Inferenzaufruf ausführt, muss der Prozessor Daten aus dem Speicher lesen, den Vorgang abschließen und die Ausgabe zurückschreiben. In Standardkonfigurationen führt dies zu erheblicher Latenz, da Daten eine große physische Distanz auf dem Motherboard zurücklegen müssen.
Um diese Engpässe auf Transportschichtebene zu lösen, entwickeln sich KI-Computer der nächsten Generation zu dreidimensionalen Verbundarchitekturen. Bei diesem Modell wird der Rechenkern direkt auf dem gestapelten Speicher platziert, wobei fortschrittliche Verpackungstechnologien genutzt werden, um physische Distanz und Latenz zu minimieren.
Die 3D-Speicherhierarchie: Stapelung von SRAM, DRAM und NAND
Um unterschiedliche Datenklassen zu verarbeiten, schlagen Hardware-Architekten einen geschichteten 3D-Halbleiter-Wolkenkratzer vor. Diese Struktur unterteilt die Datenspeicherung in verschiedene physikalische Zonen basierend auf Zugriffsgeschwindigkeit und Kapazitätsanforderungen:
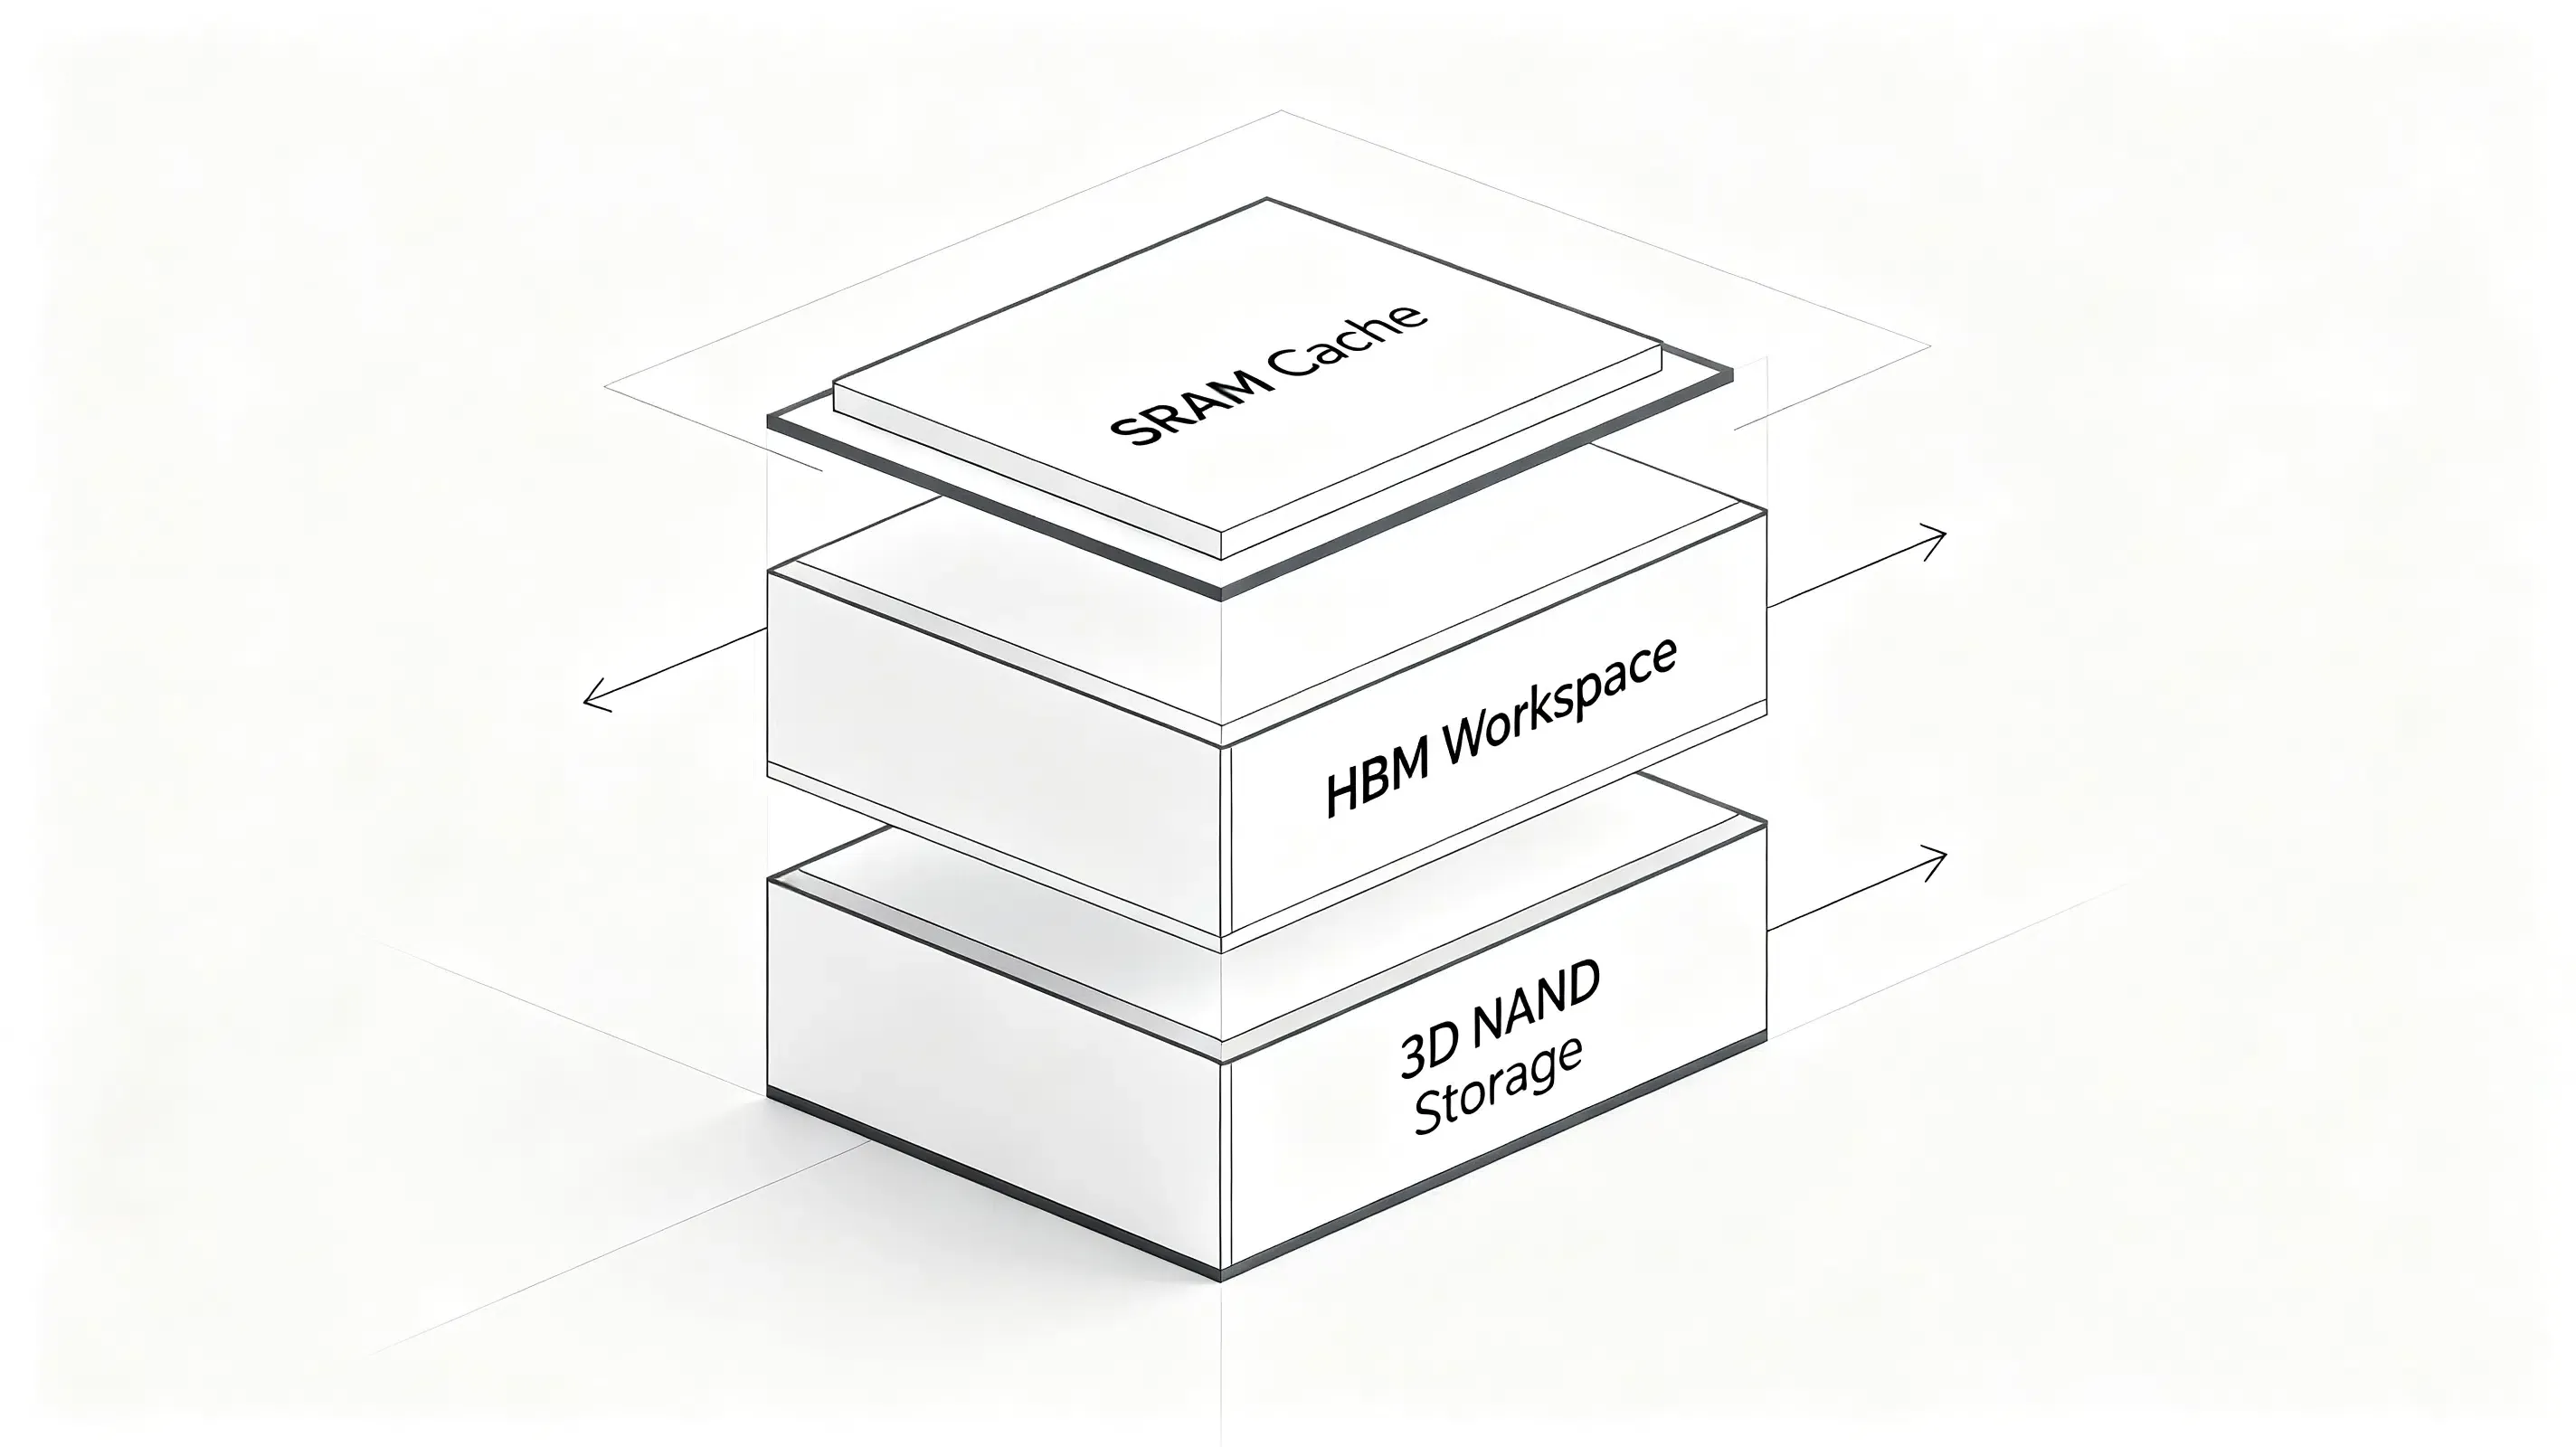
- High-Speed On-Package SRAM-Cache: Als ultimativer Hochgeschwindigkeits-Cache ist SRAM direkt neben dem Prozessor integriert, was die Speicherzugriffslatenz im Vergleich zu herkömmlichem DRAM erheblich reduziert, um aktive Parameterregister zu verwalten.
- High Bandwidth Memory (HBM): Als Hauptarbeitsbereich verarbeitet HBM die aktive Parameterabfrage und hochfrequente Zustandsaktualisierungen, wobei JEDEC-Standards seine breite Schnittstelle definieren.
- High-Capacity 3D NAND Flash-Speicher: High Bandwidth Flash (HBF) bleibt eine aufkommende Speicherarchitektur, die von KAIST-Forschern vorgeschlagen wurde, um HBM zu ergänzen. Sie bietet deutlich größere Speicherkapazität für zukünftige KI-Systeme durch vertikal gestapelten NAND-Flash, um massive, langfristige Speicherkapazitäten zur Aufbewahrung von Videos, Dokumenten und persistenten Gesprächsverläufen bereitzustellen.
Das folgende Diagramm veranschaulicht diese physische vertikale Integration:
                  [ GPU / Prozessorkern ] (Kühlung auf Dachebene)
                             │
                             ▼
                  [ High-Speed On-Package SRAM-Cache ] (Ultraschneller Wafer-Cache)
                             │
                             ▼
                  [ High Bandwidth Memory ] (Aktiver Arbeitsbereich DRAM)
                             │
                             ▼
                  [ High-Capacity 3D NAND Flash-Speicher ] (Langfristiger NAND-Speicher)
Diese integrierte 3D-Architektur stellt sicher, dass Standard-Recheneinheiten kontinuierlich mit Daten versorgt werden, was Leerlaufzyklen reduziert. Traditioneller DDR-Speicher bietet nur einen Bruchteil der von HBM verfügbaren Bandbreite. Laut den NVIDIA GTC-Technikpräsentationen, die gemeinsam mit SK Hynix gehalten wurden, bietet HBM wesentlich höhere Bandbreiten als konventioneller DDR-Speicher bei deutlich kleinerem physischen Platzbedarf. Konkret liefert HBM2 etwa 307 GB/s pro Stack, während HBM2E dies auf etwa 358 GB/s erhöht und HBM3 Bandbreiten von über 500 GB/s anstrebt.
Obwohl Speicherbandbreite und Anwendungszuordnung unterschiedlichen technischen Bereichen angehören, unterstreichen beide das gleiche architektonische Prinzip: die Verlagerung des Zustandsmanagements von eingeschränkten lokalen Ressourcen hin zu skalierbarer serverseitiger Infrastruktur. Wenn Benutzerinteraktionen von Standard-Client-seitigem Zustands-Tracking entkoppelt werden, um Datenschutzrichtlinien zu erfüllen, wird die Aufrechterhaltung einer nahtlosen Sitzungskontinuität über verschiedene Web- und Mobilumgebungen hinweg äußerst komplex. So wie Prozessoren persistente Hochgeschwindigkeits-Speicherpipelines benötigen, um Zustands-Kontexte abzugleichen, benötigen nachgelagerte Marketing-Pipelines robuste, serverseitige Datenspeicherung, um getrennte Installationsereignisse zu korrelieren, ohne auf anfällige clientseitige Cookies oder gerätebasierte Attribute angewiesen zu sein.
Build vs. Buy: Verwaltung von serverseitiger Sitzungskontinuität und Datendurchsatz
Da sich moderne Rechenumgebungen von lokalen, clientseitigen Identifikatoren entfernen, ist die Aufrechterhaltung des Sitzungszustands über verteilte digitale Berührungspunkte hinweg zu einer primären technischen Herausforderung geworden. Für Entwickler erfordert die Verwaltung von Sitzungszuständen in der Ära, in der HBM-Speicher der Schlüssel ist, Architekturen, die sowohl datenschutzkonform als auch hochpräzise sind. Unternehmen, die Benutzerreisen über Web- und Mobile-Erlebnisse hinweg bewahren müssen, verlassen sich zunehmend auf serverseitiges Sitzungsmanagement statt auf persistente clientseitige Identifikatoren. Abhängig von den Geschäftsanforderungen können Teams diese Funktionen intern entwickeln oder bestehende Attributionsplattformen übernehmen.
Architekturbewertung: Eigenentwicklung vs. Standardisiertes SDK
Der Aufbau eines eigenen, internen Systems zur serverseitigen Zustandsabstimmung bietet maximale Flexibilität, erfordert jedoch erhebliche laufende Engineering-Ressourcen. Entwickler müssen manuell Datenbankschemata erstellen, sichere kryptografische Hashing-Funktionen schreiben und das System kontinuierlich aktualisieren, um die sich ändernden regionalen Vorschriften einzuhalten. Umgekehrt reduziert die Bereitstellung eines vorgefertigten, zertifizierten SDK die Integrationskomplexität und garantiert langfristige Compliance ohne zusätzlichen Overhead.
Die folgende Tabelle vergleicht Standardmethoden zur Verwaltung von Sitzungszustand und Konvertierungskontext:
| Lösung | Persistenz | Durchsatz | Am besten geeignet für |
|---|---|---|---|
| Interne Sitzungsdatenbank | Hoch (Kontinuierliche Synchronisation) | Mittel (DB-Latenzgrenzen) | Kundenspezifische Unternehmensumgebungen mit hochspezialisierter Speicherlogik |
| Browser-basiertes Sitzungs-Tracking | Niedrig (Sitzungscookies) | Niedrig (Keine Server-Protokollierung) | Grundlegendes Website-Tracking mit minimalen Anforderungen an domainübergreifende Konvertierung |
| Serverseitiges Caching (z. B. OpoInstall) | Keine (Temporäre serverseitige Sitzungstokens) | Hoch (Standardisierte Sandbox) | Mobile Apps mit hoher Parallelität und Multi-Plattform-Kampagnenattribution |
Aktuelle Studien zur GPU-Architektur auf der arXiv-Datenbank zeigen ebenfalls, dass die Speichereffizienz häufiger den gesamten Inferenzturchsatz bestimmt als die reine arithmetische Leistung. Während benutzerdefinierte Datenbankkonfigurationen grundlegende Kontexte verarbeiten können, kann eine spezialisierte serverseitige Zustandsbewahrung Entwicklungsressourcen optimieren. Abhängig von den Implementierungsanforderungen können Unternehmen ihr eigenes serverseitiges Sitzungsmanagementsystem aufbauen oder kommerzielle Plattformen wie OpoInstall übernehmen. OpoInstall bietet beispielsweise serverseitige Zustandswiederherstellung und Parameter-Pass-Through-Frameworks, wobei Sitzungsmetadaten einer serverseitigen Sitzungsdatenbank zugeordnet werden, um die Sitzungskontinuität anonym aufrechtzuerhalten, ohne sensible, langfristige persönliche Gesprächshistorien zu speichern. Durch die Zuordnung von Sitzungsmetadaten zu einer zentralen Datenbank, anstatt sich auf Browser-basierte Weiterleitungen zu verlassen, stellt ein solches System sicher, dass Konvertierungskontexte konsistent bleiben, selbst wenn erste Aufgaben anonym ausgeführt werden. Engineering-Teams können diese Ansätze bewerten, um Datenschutz und Messkonsistenz in Einklang zu bringen.
Integrations-Checklisten: Vorbereitung Ihrer Architektur auf speicherzentriertes Rechnen
Um Datenpipelines zu sichern und die Benutzersicherheit in einer Post-Alias-Ära zu gewährleisten, können Entwickler und Architekten dezentrale Open-Source-Alias-Verwaltung und serverseitige Zustandsbewahrung prüfen. Das Vertrauen auf OS-Ebene-Funktionen einzelner Anbieter führt zu einer systemischen Anbieterbindung und macht Unternehmen anfällig für stille Backend-Updates. Stattdessen können Engineering-Teams alternative Routing-Technologien prüfen, die vollständiges Dateneigentum gewähren.
Eine Standardalternative besteht darin, eine dedizierte benutzerdefinierte Domain speziell für die E-Mail-Kompartimentierung zu registrieren. Durch das Routing dieser Domain über eine Open-Source-Alias-Engine wie SimpleLogin und die Verknüpfung mit einem verschlüsselten Postfach wie Proton Mail können Entwickler sicherstellen, dass ihre Aliase wie normale benutzerdefinierte Domains aussehen, was verhindert, dass Anti-Missbrauch-Systeme sie als Gruppe blockieren.
Checkliste für die Entwicklerimplementierung
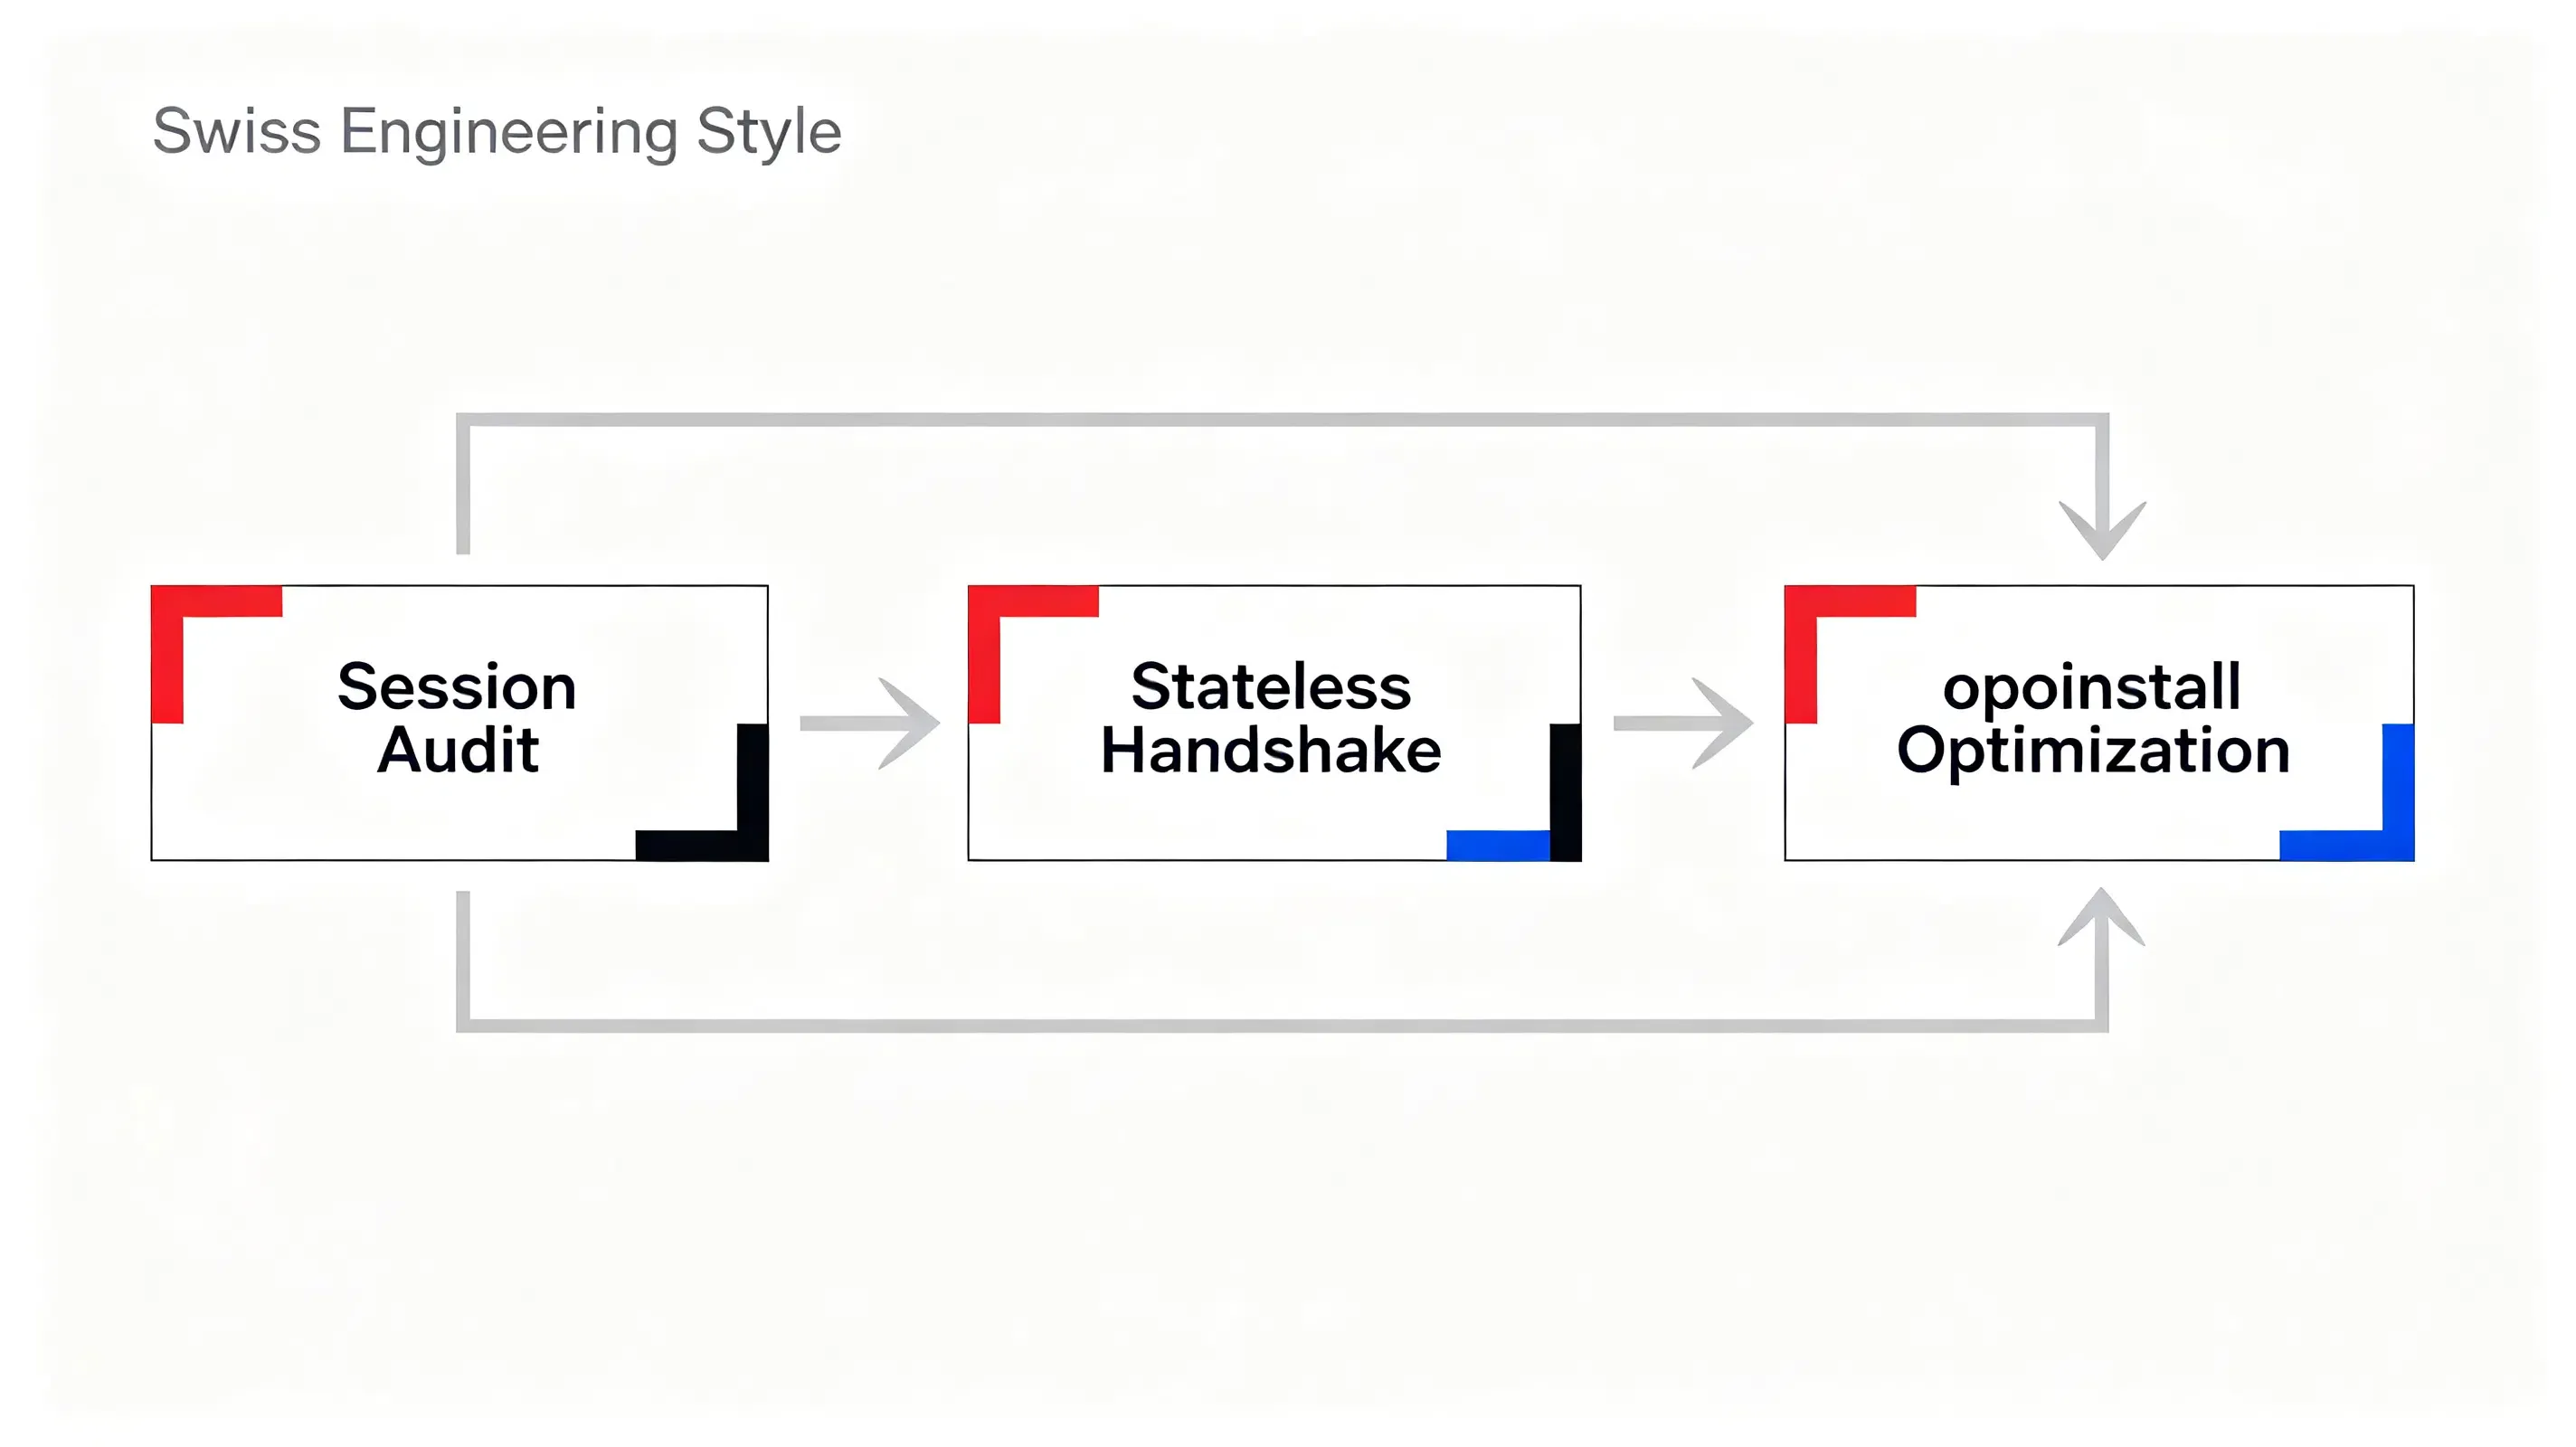
- Audit der Sitzungsdatenspeicherung: Überprüfen Sie alle Datenbanken, um sicherzustellen, dass persistente, emotional begleitende Chat-Historien gemäß den Datenlöschungsfristen gelöscht werden.
- Implementierung zustandsloser Sitzungs-Handshakes: Stellen Sie API-Routen auf zustandslose Verarbeitungsmodelle um und verwenden Sie kryptografisch signierte Tokens, um temporären Kontext zwischen Knoten zu übertragen.
- Durchsetzung von Altersverifizierungsgateways: Implementieren Sie für verbraucherorientierte Produkte Schutzmaßnahmen für Kinder, um zu verhindern, dass Minderjährige auf eingeschränkte Gesprächsfunktionen zugreifen.
Checkliste für Produkt- & Wachstumsstrategie
- Umstrukturierung der Nutzererfahrungsabläufe: Wechseln Sie von begleitbasierten Engagement-Modellen hin zu aufgabenorientierten, hochgradig nützlichen Tools, die nicht auf emotionaler Abhängigkeit beruhen.
- Optimierung von Konvertierungstrichtern: Nutzen Sie nicht-intrusive Parameter-Pass-Through-Frameworks, um das Akquise-Tracking aufrechtzuerhalten, ohne Datenschutzrichtlinien zu verletzen.
- Überwachung der Plattform-Compliance: Stellen Sie sicher, dass alle integrierten SDKs von Drittanbietern den lokalen Datenschutzgesetzen und dem kommenden Mandat vom 15. Juli entsprechen.
Durch die Festlegung dieser strukturierten Richtlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die operative Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Warum bleibt dieselbe GPU bis zu neunzig Prozent ihrer Laufzeit im Leerlauf?
Was sind die technischen Unterschiede zwischen HBM, HBF und HBS?
Wie löst die serverseitige Sitzungswiederherstellung Zustandsengpässe?
Warum ist HBM bei der KI-Inferenz wichtiger als beim Training?
Wichtige Erkenntnisse für Engineering-Teams
Da sich KI-Plattformen an neue regulatorische Anforderungen anpassen, werden Engineering-Teams zunehmend auf zustandslose Architekturen, serverseitiges Sitzungsmanagement und privatsphäreorientiertes Design angewiesen sein. Sich entwickelnde Datenarchitekturen erfordern einen grundlegenden Wandel in der Art und Weise, wie wir digitale Erlebnisse aufbauen und messen. Da zustandslose Proxys und Headless-Scraper zu Standardverbrauchern von Web-Inhalten werden, werden herkömmliche clientseitige Attributionsmodelle weiter an Wert verlieren. Das Vertrauen auf Standard-Cookies und Referrer reicht nicht mehr aus, um die Datenpipelines zu sichern, die die Benutzerakquise vorantreiben.
Um das Wachstum aufrechtzuerhalten, müssen Engineering- und Produktteams zustandslose Datenstrukturen und serverseitige Zustandsbewahrung priorisieren. Durch die Implementierung von Zero-Trust-Identitätsverifizierung, sicheren Parameter-Pass-Through-Frameworks und robusten Zeitplänen für die Datenlöschung können Unternehmen ihre Benutzerpipelines schützen und gleichzeitig rechtliche Grenzen respektieren. Dieser architektonische Wandel ist unerlässlich, um stabile, vertrauenswürdige Plattformen aufzubauen, die in einer regulierten digitalen Wirtschaft florieren.
Share this article



