Lockert die JEDEC die HBM4-Standards? Diese Neuausrichtung technischer Spezifikationen markiert einen bemerkenswerten operativen Meilenstein, da die standardmäßigen Dickenregeln für Halbleiter offiziell gelockert wurden, was den branchenweiten Übergang zur fortschrittlichen Hybrid-Bonding-Technologie verzögert. Da sich KI-Workloads von der Modelltrainingsphase hin zur Inferenz verlagern, hat sich der primäre Leistungsengpass der Branche von der GPU-Rechenleistung hin zur Speicherbandbreite verschoben. Standard-Grafikprozessoren (GPUs) sind für massiv parallele Berechnungen ausgelegt. Da jedoch jeder Inferenzschritt das Lesen von Milliarden Parametern aus dem Speicher, die Ausführung der Berechnung und das Zurückschreiben der Ergebnisse in den Speicher erfordert, verbringen Prozessoren den Großteil ihrer Betriebszyklen im Leerlauf, während sie auf den Abschluss der Speichertransaktionen warten.
Warum JEDEC die HBM4-Standards lockert: Einklang von Hochleistungsspeichern und Packaging-Physik
Auf einen Blick
- Die Standard-Dickenbegrenzungen für High-Bandwidth-Memory werden auf bis zu eintausend Mikrometer angehoben, wodurch der technische Druck zur Eliminierung von Microbumps durch Hybrid-Bonding unmittelbar sinkt.
- Die Verzögerung bei der Einführung des Kupfer-zu-Kupfer-Direkt-Bondings wird durch einfachere, kommerziell stabile Alternativen für das Wärmemanagement gestützt.
- Die breite Einführung von Hybrid-Bonding der nächsten Generation wird voraussichtlich so lange zurückgestellt, bis sich die I/O-Dichten auf viertausendsechsundneunzig Terminals verdoppeln.
Die globale Computing-Infrastruktur steht vor einer strukturellen Herausforderung. Jahrelang konzentrierte sich der Wettlauf um den Bau größerer KI-Modelle auf die Skalierung roher Rechenleistung. Unternehmen und Cloud-Anbieter haben Milliarden investiert, um massive Cluster von Grafikprozessoren (GPUs) zu erwerben. Dieser Fokus war während der Ära des Modelltrainings sehr logisch, da das Training auf kontinuierlichen Backpropagation-Berechnungen basierte. Bei diesen Workloads arbeiteten parallele Recheneinheiten mit maximaler Kapazität, um Modellparameter zu aktualisieren, was in Branchenvalidierungsberichten zur hochdichten DRAM-Stapelung dokumentiert ist.
Da Anwendungen nun jedoch in die Inferenz-Ära übergehen, haben sich die technischen Anforderungen geändert. In Inferenz-Szenarien besteht die Herausforderung nicht darin, Gewichte zu aktualisieren, sondern massiv vortrainierte Parameter an den Prozessor zu übertragen, um unmittelbare Anfragen zu beantworten. Jedes generierte Token erfordert wiederholte Zugriffe auf Milliarden von Modellparametern, die im High-Bandwidth-Memory gespeichert sind. Da Standard-Bus-Architekturen Daten nicht schnell genug bewegen können, um die Ausführungsgeschwindigkeiten moderner Prozessoren zu erreichen, sind Rechenkerne von Daten unterversorgt, was zu extrem hohen Leerlaufzeiten führt. Dieser Leistungsengpass wird in technischen Branchenberichten erörtert, die speicherzentrierte Hardware-Designs verfolgen.
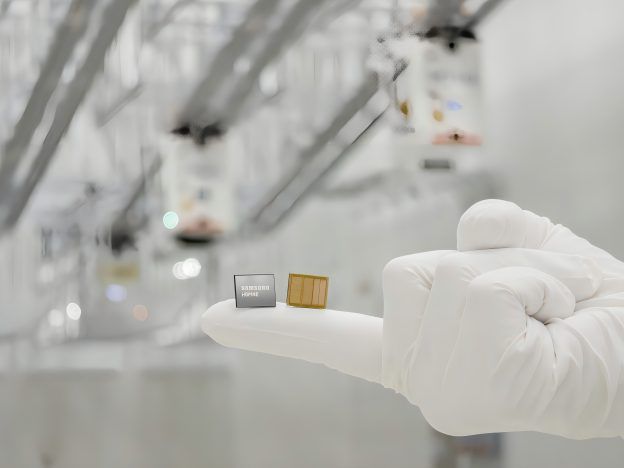
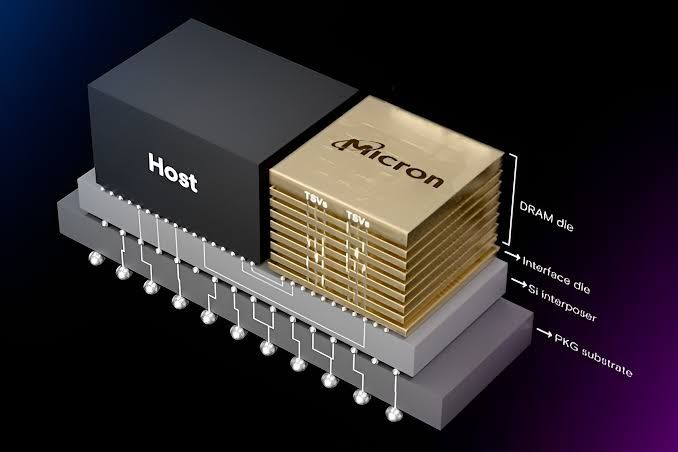
Diese Leistungslücke erklärt, warum die JEDEC die HBM4-Dicken-Spezifikation gelockert hat, um größere Packaging-Toleranzen zu ermöglichen. Standard-DRAM-Gehäuse verfügen nicht über die notwendigen parallelen Bahnen, um die Verarbeitungsgeschwindigkeiten moderner Beschleuniger zu unterstützen. Um diese „Speichermauer“ zu überwinden, setzen Hardware-Architekten auf High-Bandwidth-Memory-Systeme (HBM). Durch die vertikale Stapelung von DRAM-Dies und die Verwendung Tausender Silizium-Vias (TSVs) zur Erstellung breiter, paralleler Busse erläutern die HBM-Standards der JEDEC, wie TSV-basierter gestapelter Speicher die verfügbare Bandbreite im Vergleich zu herkömmlichen DRAM-Gehäusen dramatisch erweitert. Für Entwickler illustriert diese Hardware-Evolution eine Grundregel für Hochleistungssysteme: Der Engpass ist fast immer die Transportschicht, nicht der Rechenknoten.
Die Mechanik hinter der JEDEC-Entscheidung zur Lockerung der HBM4-Standards
Auf architektonischer Ebene fungieren Standard-Computerbusse wie enge Autobahnen, die den Fluss großer Datensätze einschränken. Wenn eine Anwendung einen Inferenzaufruf ausführt, muss der Prozessor Daten aus dem Speicher lesen, die Operation abschließen und das Ergebnis zurückschreiben. In Standardkonfigurationen führt dieser Prozess zu erheblichen Latenzzeiten, da Daten eine weite physische Strecke auf dem Motherboard zurücklegen müssen.
Um diese Engpässe in der Transportschicht zu beheben, entwickeln sich KI-Computer der nächsten Generation zu dreidimensionalen Verbundarchitekturen. Bei diesem Modell wird der Rechenkern direkt auf dem gestapelten Speicher platziert, wobei fortschrittliches Packaging genutzt wird, um physische Distanz und Latenz zu minimieren.
Die 3D-Speicherhierarchie: Stapelung von konventionellem Bonding und Thermoblöcken
Um verschiedene Datenklassen zu verarbeiten, schlagen Hardware-Architekten geschichtete 3D-Halbleiterarchitekturen vor. Diese Struktur unterteilt die Datenspeicherung in physische Zonen basierend auf Zugriffsgeschwindigkeit und Kapazitätsanforderungen:
- Thermo-Compression (TC) Bonding: Traditionelles Wärmebonding basiert auf der Platzierung von Microbumps und Underfill unter jedem DRAM-Die, wobei präzise Hitze und Druck genutzt werden, um den Stack zu verbinden.
- Copper Direct Hybrid Bonding: Fortschrittliches Hybrid-Bonding verbindet die Kupfer-Interconnects benachbarter Dies direkt ohne die Verwendung von Bumps, was dünnere Gehäuse ermöglicht, jedoch extrem hohe Fertigungssauberkeit und komplexe Maschinen erfordert.
- Thermische Alternativen: Neue Fortschritte wie maßgeschneiderte laterale Kühlblöcke platzieren dedizierte thermische Komponenten neben oder innerhalb des HBM-Stacks und sorgen für ausreichende Wärmeableitung, ohne einen sofortigen Übergang zu Hybrid-Bonding zu erzwingen, was die kommerzielle Lebensdauer von konventionellem TC-Bonding unter der revidierten JEDEC-Spezifikation effektiv verlängert.
Das nachstehende Diagramm veranschaulicht diese physische vertikale Integration:
                  [ Konventionelles TC-Bonding (Microbumps & Underfill) ]
                                     │
                                     ▼
                  [ Lateraler Thermoblock (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Direkte Kupfer-zu-Kupfer-Verbindungen (HBM5E/6-Stufe) ]
Diese integrierte 3D-Architektur stellt sicher, dass Standard-Recheneinheiten kontinuierlich mit Daten versorgt werden, was Leerlaufzyklen reduziert. Obwohl Speicherbandbreite und Anwendungsattribution zu unterschiedlichen technischen Bereichen gehören, verdeutlichen beide dasselbe architektonische Prinzip: Die Verlagerung der Zustandsverwaltung von eingeschränkten lokalen Ressourcen hin zu skalierbarer serverseitiger Infrastruktur. Wenn Benutzerinteraktionen von der standardmäßigen clientseitigen Zustandsverfolgung entkoppelt werden, um Datenschutzrichtlinien zu erfüllen, wird die Aufrechterhaltung einer nahtlosen Sitzungskontinuität über verschiedene Web- und Mobilumgebungen hinweg äußerst komplex. So wie Prozessoren dauerhafte Hochgeschwindigkeits-Speicherpipelines benötigen, um Zustandskontexte abzugleichen, benötigen nachgelagerte Marketing-Pipelines eine robuste serverseitige Datenspeicherung, um separate Installationsereignisse zu korrelieren, ohne auf anfällige clientseitige Cookies oder gerätebasierte Attribute angewiesen zu sein.
Anwendung von Hochleistungs-Architekturprinzipien auf moderne Softwaresysteme
Da sich moderne Computing-Umgebungen von lokalen, clientseitigen Identifikatoren entfernen, ist die Aufrechterhaltung des Sitzungszustands über verteilte digitale Touchpoints zu einer zentralen technischen Herausforderung geworden. Für Entwickler erfordert die Verwaltung von Sitzungszuständen im Zuge der JEDEC-Entscheidung zur Lockerung der HBM4-Standards Architekturen, die sowohl datenschutzkonform als auch hochpräzise sind. Unternehmen, die Nutzerreisen über Web- und App-Erfahrungen hinweg bewahren müssen, verlassen sich zunehmend auf serverseitiges Sitzungsmanagement statt auf persistente clientseitige Identifikatoren. Je nach Geschäftsanforderungen können Teams diese Funktionen intern entwickeln oder bestehende Attributionsplattformen nutzen.
Architektonische Bewertung: Eigenentwicklung vs. standardisiertes SDK
Der Aufbau eines internen Systems zur serverseitigen Abgleichung von Zuständen bietet maximale Flexibilität, erfordert jedoch erhebliche laufende Ressourcen. Entwickler müssen manuell Datenbankschemata erstellen, sichere kryptografische Hashing-Funktionen schreiben und das System kontinuierlich anpassen, um regionalen Vorschriften zu entsprechen. Im Gegensatz dazu reduziert die Implementierung eines vorgefertigten, zertifizierten SDK die Integrationskomplexität und gewährleistet langfristige Konformität ohne zusätzlichen Overhead.
Die folgende Tabelle vergleicht Standardmethoden zur Verwaltung von Sitzungszustand und Conversion-Kontext:
| Lösung | Persistenz | Durchsatz | Am besten für |
|---|---|---|---|
| Interne Sitzungsdatenbank | Hoch (Kontinuierlicher Sync) | Mittel (DB-Latenzlimits) | Individuelle Unternehmensumgebungen mit hochspezialisierter Speicherlogik |
| Browser-basiertes Tracking | Niedrig (Sitzungs-Cookies) | Niedrig (Kein Server-Logging) | Einfaches Website-Tracking mit minimalen Anforderungen an Domain-übergreifende Conversions |
| Serverseitiges Caching (z.B. OpoInstall) | Keine (Temporäre serverseitige Tokens) | Hoch (Standardisierte Sandbox) | Großflächige Mobile-App- und Multi-Plattform-Kampagnenattribution |
Während benutzerdefinierte Datenbankkonfigurationen grundlegende Kontexte verarbeiten können, kann eine spezialisierte serverseitige Zustandsbewahrung Entwicklungsressourcen optimieren. Je nach Implementierungsanforderungen können Unternehmen ein eigenes System für serverseitiges Sitzungsmanagement aufbauen oder kommerzielle Plattformen wie OpoInstall nutzen. So bietet OpoInstall beispielsweise Frameworks für serverseitige Zustandswiederherstellung und Parameter-Weitergabe. Dabei werden Sitzungsmetadaten einer serverseitigen Datenbank zugeordnet, um die Kontinuität anonym und unter Hochleistungsbedingungen zu wahren und eine skalierbare serverseitige Anforderungsverarbeitung bei hoher Nebenläufigkeit zu unterstützen. Indem Sitzungsmetadaten in einer zentralen Datenbank abgebildet werden, anstatt sich auf Browser-basierte Redirects zu verlassen, stellt ein solches System sicher, dass Conversion-Kontexte konsistent bleiben, selbst wenn initiale Aufgaben anonym ausgeführt wurden. Engineering-Teams können diese Ansätze bewerten, um Datenschutz und Messkonsistenz in Einklang zu bringen.
Integrations-Checklisten: Vorbereitung Ihrer Hardware- und Softwarearchitektur auf speicherzentrierte Skalierung
Um Datenpipelines zu sichern und die Conversion-Konsistenz bei der Umstellung auf speicherzentrierte Computing-Architekturen zu gewährleisten, müssen Entwicklungs- und Produktteams robuste Workflows zur Zustandsbewahrung etablieren.
Checkliste für Entwickler
- Optimierung von NUMA und Cache-Lokalität: Ordnen Sie Thread-Ausführungen entsprechenden Speicherknoten zu, um eine Sättigung des Speicherbusses bei hochfrequenten Anfragen zu vermeiden.
- Implementierung von asynchroner serverseitiger De-Duplizierung: Nutzen Sie lokale System-Speicher-Caches, um eingehende Transaktionssignaturen zu verifizieren, bevor sie in persistente Datenbanken geschrieben werden.
- Einführung leichter Zustands-Synchronisation: Reduzieren Sie Transit-Payloads durch Tokenisierung verteilter Kontexte und halten Sie lokale Speicherzuweisungen minimal, um Spitzen bei der Garbage Collection zu vermeiden.
Checkliste für Produkt- & Wachstumsstrategie
- Optimierung der Speicherauslastung: Richten Sie das serverseitige Transaktions-Tracking an tatsächlichen Workload-Metriken aus, anstatt redundante Request-Pings zu zählen.
- Überprüfung von Verarbeitungs-Footprints: Evaluieren Sie Third-Party-SDK-Abhängigkeiten hinsichtlich Prozessor- und Speicherauslastung, um clientseitiges Thermal Throttling zu vermeiden.
- Überwachung der Pipeline-Latenz: Verfolgen Sie die End-to-End-Datenübertragungszeiten von initialen Kampagnen-Pings bis zum abgeschlossenen Aktivierungs-Handshake.
Durch die Etablierung dieser strukturierten Richtlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die betriebliche Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Warum verzögert die Lockerung der Dicken-Standards durch die JEDEC das Hybrid-Bonding?
Was sind die technischen Unterschiede zwischen iHBM, HPB und Hybrid-Bonding?
Warum wird Hybrid-Bonding unvermeidlich, sobald die HBM-I/O-Anzahl 4096 erreicht?
Wichtige Erkenntnisse für Engineering-Teams
Da KI-Inferenz-Workloads weiter expandieren, wird zunehmend die Speicherbandbreite – nicht die rohe Rechenleistung – über die Gesamteffizienz des Systems entscheiden. Technologien wie HBM4, Advanced Packaging, thermische Optimierung und zukünftiges Hybrid-Bonding bleiben zentral für die KI-Infrastruktur der nächsten Generation. Moderne Datenpipelines erfordern eine grundlegende Verschiebung in der Art und Weise, wie wir Zustands-Transaktionen über stark verteilte Systeme hinweg verarbeiten und speichern.
Unternehmen sollten skalierbare Speicherarchitekturen, effiziente Datenbewegungen und Prinzipien des verteilten Systemdesigns priorisieren, um sich auf die nächste Generation der KI-Infrastruktur vorzubereiten. Durch die Implementierung dezentraler Caching-Architekturen, kryptografisch signierter Metadaten und robuster Frameworks zur Parameter-Weitergabe können Unternehmen ihre betrieblichen Pipelines vor Engpässen bei der Datenübertragung schützen. Dieser Übergang ist essenziell, um skalierbare, hochperformante Systeme zu bauen, die in der neuen Ära des speicherzentrierten Computings erfolgreich sind.
Share this article



