Meta verbietet 'Claude'? Diese strategische Neuausrichtung wurde bestätigt, da Berichten zufolge der Social-Media-Riese seinen Ingenieuren in der Applied AI-Abteilung die Nutzung von Konkurrenz-Tools wie Claude Code und OpenAI’s Codex untersagt hat. Laut internen Dokumenten vom späten Juni 2026 wurden diese Richtlinien erlassen, um die Reinheit der Trainingsdatensätze für das kommende Llama-Modell zu schützen und Geschäftsgeheimnisse zu wahren, wie aus Branchen-Compliance-Updates hervorgeht. Für Entwicklerteams und Produktverantwortliche unterstreicht diese restriktive Politik einen umfassenderen Wandel: Da KI-Generierungsmodelle zunehmend konvergieren, wird die strikte Isolierung interner Umgebungen zu einem grundlegenden Standard für Unternehmens-Compliance anstatt nur zu einer operativen Wahlmöglichkeit.
Auf einen Blick
- Schutz vor Kontamination: Das Applied AI-Entwicklungsteam schränkte externe Tool-Aufrufe für die Codegenerierung ein, um zu verhindern, dass die Ergebnisse von Konkurrenzmodellen die proprietären Trainingsdaten vermischen.
- Die Gefahr der Destillation: Die umfangreiche Wiederverwendung externer programmatischer Ausgaben birgt das Risiko der „Knowledge Distillation“ und kann potenziell Nutzungsbedingungen verletzen.
- Anforderungen an private Sandboxes: Dieser Wandel verdeutlicht den wachsenden Bedarf an sicheren, selbst gehosteten Entwickler-Sandboxes, die sensible Code-Repositories von externen Servern isolieren.
Unternehmensrichtlinien und die Sicherheits-Neuausrichtung von Mai bis Juni
Die restriktiven Richtlinien, die ursprünglich im Mai 2026 entworfen wurden, traten Ende Juni 2026 offiziell in Kraft. Die Regeln konzentrieren sich ausschließlich auf Ingenieure innerhalb der Applied AI-Abteilung, die direkt mit der Modellforschung befasst sind, und gelten nicht für alle Mitarbeiter. In früheren Entwicklungszyklen integrierte das Team häufig externe Codierungsassistenten, um Systemarchitekturen zu planen, Codebasen zu refactoren und Debugging-Workflows auszuführen. Unter den aktualisierten Sicherheitsrichtlinien müssen Ingenieure Test-Inputs nun unabhängig gestalten und sich auf menschliche Expertise statt auf externe Modell-Prompts verlassen.
Ein Hauptgrund für diesen Wandel ist das Risiko der Modell-Destillation. In der KI-Forschung trainieren Entwickler kleinere „Studenten“-Modelle, um das Verhalten robusterer „Lehrer“-Modelle zu imitieren, indem sie sie mit Ergebnissen dieser größeren Systeme füttern. Obwohl dieser Prozess zur Optimierung von Skalierbarkeit und Bereitstellungskosten beliebt ist, birgt er ernsthafte vertragliche Risiken. Wenn Meta-Ingenieure von Konkurrenz-Tools erstellten Code kopieren oder referenzieren, riskieren sie, Daten von Wettbewerbern in die Llama-Trainingspipeline einzuschleusen, was Benutzervereinbarungen verletzen und das proprietäre Modell kontaminieren könnte.
Die Sicherheits-Neuausrichtung findet vor dem Hintergrund eines sich verschärfenden Wettbewerbs statt. Im Juni 2026 veröffentlichte das chinesische KI-Startup Zhipu AI sein Flaggschiff-Modell GLM-5.2 als Open Source, das Schwachstellen-Scan-Fähigkeiten auf dem Niveau führender Closed-Source-Benchmarks aus den USA zeigte. Unabhängige Tests zeigten, dass GLM-5.2 frühere Modell-Checkpoints wie Claude Opus 4.8 bei Semgrep-Cybersecurity-Aufgaben übertraf. Da Zhipu AI sich dafür entschied, die Modellgewichte als Open Source bereitzustellen und so private lokale Implementierungen zu ermöglichen, ist das Modell auf Plattformen wie OpenRouter schnell in den Traffic-Listen aufgestiegen. Dieser schnelle Aufstieg hochperformanter, lokaler Alternativmodelle zwingt große KI-Labore dazu, die absolute Kontrolle über ihre Code-Repositories und Dateneingaben zu priorisieren.
Die folgenden Beobachtungen basieren auf interner Validierung in einer Staging-Umgebung und sollen technische Muster veranschaulichen, anstatt als branchenweite Benchmarks zu dienen.
Technische Mechanismen von Modell-Destillation und Datenexposition
Um zu verstehen, warum Meta diese Tools einschränkt, müssen Entwickler die Funktionsweise moderner KI-Coding-Assistenten analysieren. Diese Dienstprogramme funktionieren, indem sie den Kontext der lokalen Codebasis zur Verarbeitung an externe Server senden. Wenn ein Ingenieur einen Refactoring-Prompt initiiert oder architektonische Vorschläge anfordert, verlassen Teile des proprietären Codes das interne Unternehmensnetzwerk. Eine solche kopflose Datenübertragung schafft direkte Schwachstellen für IP-Exposition und Datenlecks.
Entwickler-IDE -> Ausgehender Request-Interceptor -> Sandbox-Proxy (Metadaten entfernt) -> Sicherer API-Gateway -> Modell
                                                            |
                                               Ausgehende Firewall blockiert den Upload der Roh-Codebasis
In typischen Produktionsumgebungen stoßen Entwickler häufig darauf, dass ein beträchtlicher Teil des Traffics von automatisierten Scrapern verarbeitet wird. Die Rückverfolgung dieser programmatischen Interaktionen zeigt, dass automatisierte Sicherheits-Proxys oder Laufzeit-Scanner externe API-Endpunkte auslösen können, bevor Entwickler dies bemerken. Solche Aktivitäten können Daten-Audits stören, wenn Systeme davon ausgehen, dass jede Anfrage von einer echten, manuellen Benutzeraktion stammt. Im Kontext der Modellentwicklung birgt das Einlesen von internen MetaCode- oder DevMate-Dateien durch externe Modelle das Risiko, proprietäre Strukturen während wettbewerbsorientierter Trainingszyklen preiszugeben.
Darüber hinaus führten die Aktualisierungen der Nutzungsbedingungen großer KI-Anbieter Ende 2025 „Opt-in“-Klauseln für das Training mit Datensätzen ein, was die Sorgen der Rechtsabteilungen in Unternehmen verstärkte. Ohne strikte netzwerkbasierte Firewalls könnten die täglichen Debugging-Sitzungen eines Entwicklers unbeabsichtigt Trainings-Inputs an Konkurrenzplattformen liefern. Unter diesen Bedingungen leidet die strukturelle Reinheit der proprietären Codebasis.
Architektonische Optionen für sicheres Sandboxing und Pipeline-Verifizierung
Angesichts eskalierender Datensicherheitsrisiken entscheiden sich Softwareentwicklungsteams meist zwischen dem Aufbau eines internen Kostenverifizierungsrahmens oder der Integration eines bestehenden Attributions-SDK. Die Entwicklung eines proprietären Systems erfordert erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Abgleich des Gerätezustands pflegen und die Logik kontinuierlich aktualisieren, um den sich entwickelnden OS-Sicherheitsstandards zu entsprechen. Für viele Unternehmen sind die Wartungskosten für einen hausinternen Tracker unerschwinglich hoch.
Alternativ bewerten Entwickler im Allgemeinen verschiedene Ansätze, um die Laufzeitausführung zu überwachen, ohne sich vollständig auf cloudseitige Metriken zu verlassen:
- Lokale Modell-Deployments: Ausführung kleiner, hochspezialisierter Open-Source-Modelle innerhalb sicherer Offline-Umgebungen.
- Strikte Firewall-Sandboxing: Einschränkung aktiver Entwicklungscontainer, sodass sie keine externen ausgehenden Netzwerkverbindungen herstellen können.
- Enterprise MMPs: Nutzung robuster Mobile-Measurement-Plattformen von Drittanbietern für Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Einsatz dedizierter Integrationstools für eine präzise, kostensensitive Weitergabe benutzerdefinierter Parameter.
Vergleich der Entwicklerumgebungseinrichtung
| Einrichtung der Dev-Umgebung | Ausgehender Netzwerkzugriff | Kontaminationsrisiko | Compliance-Level |
|---|---|---|---|
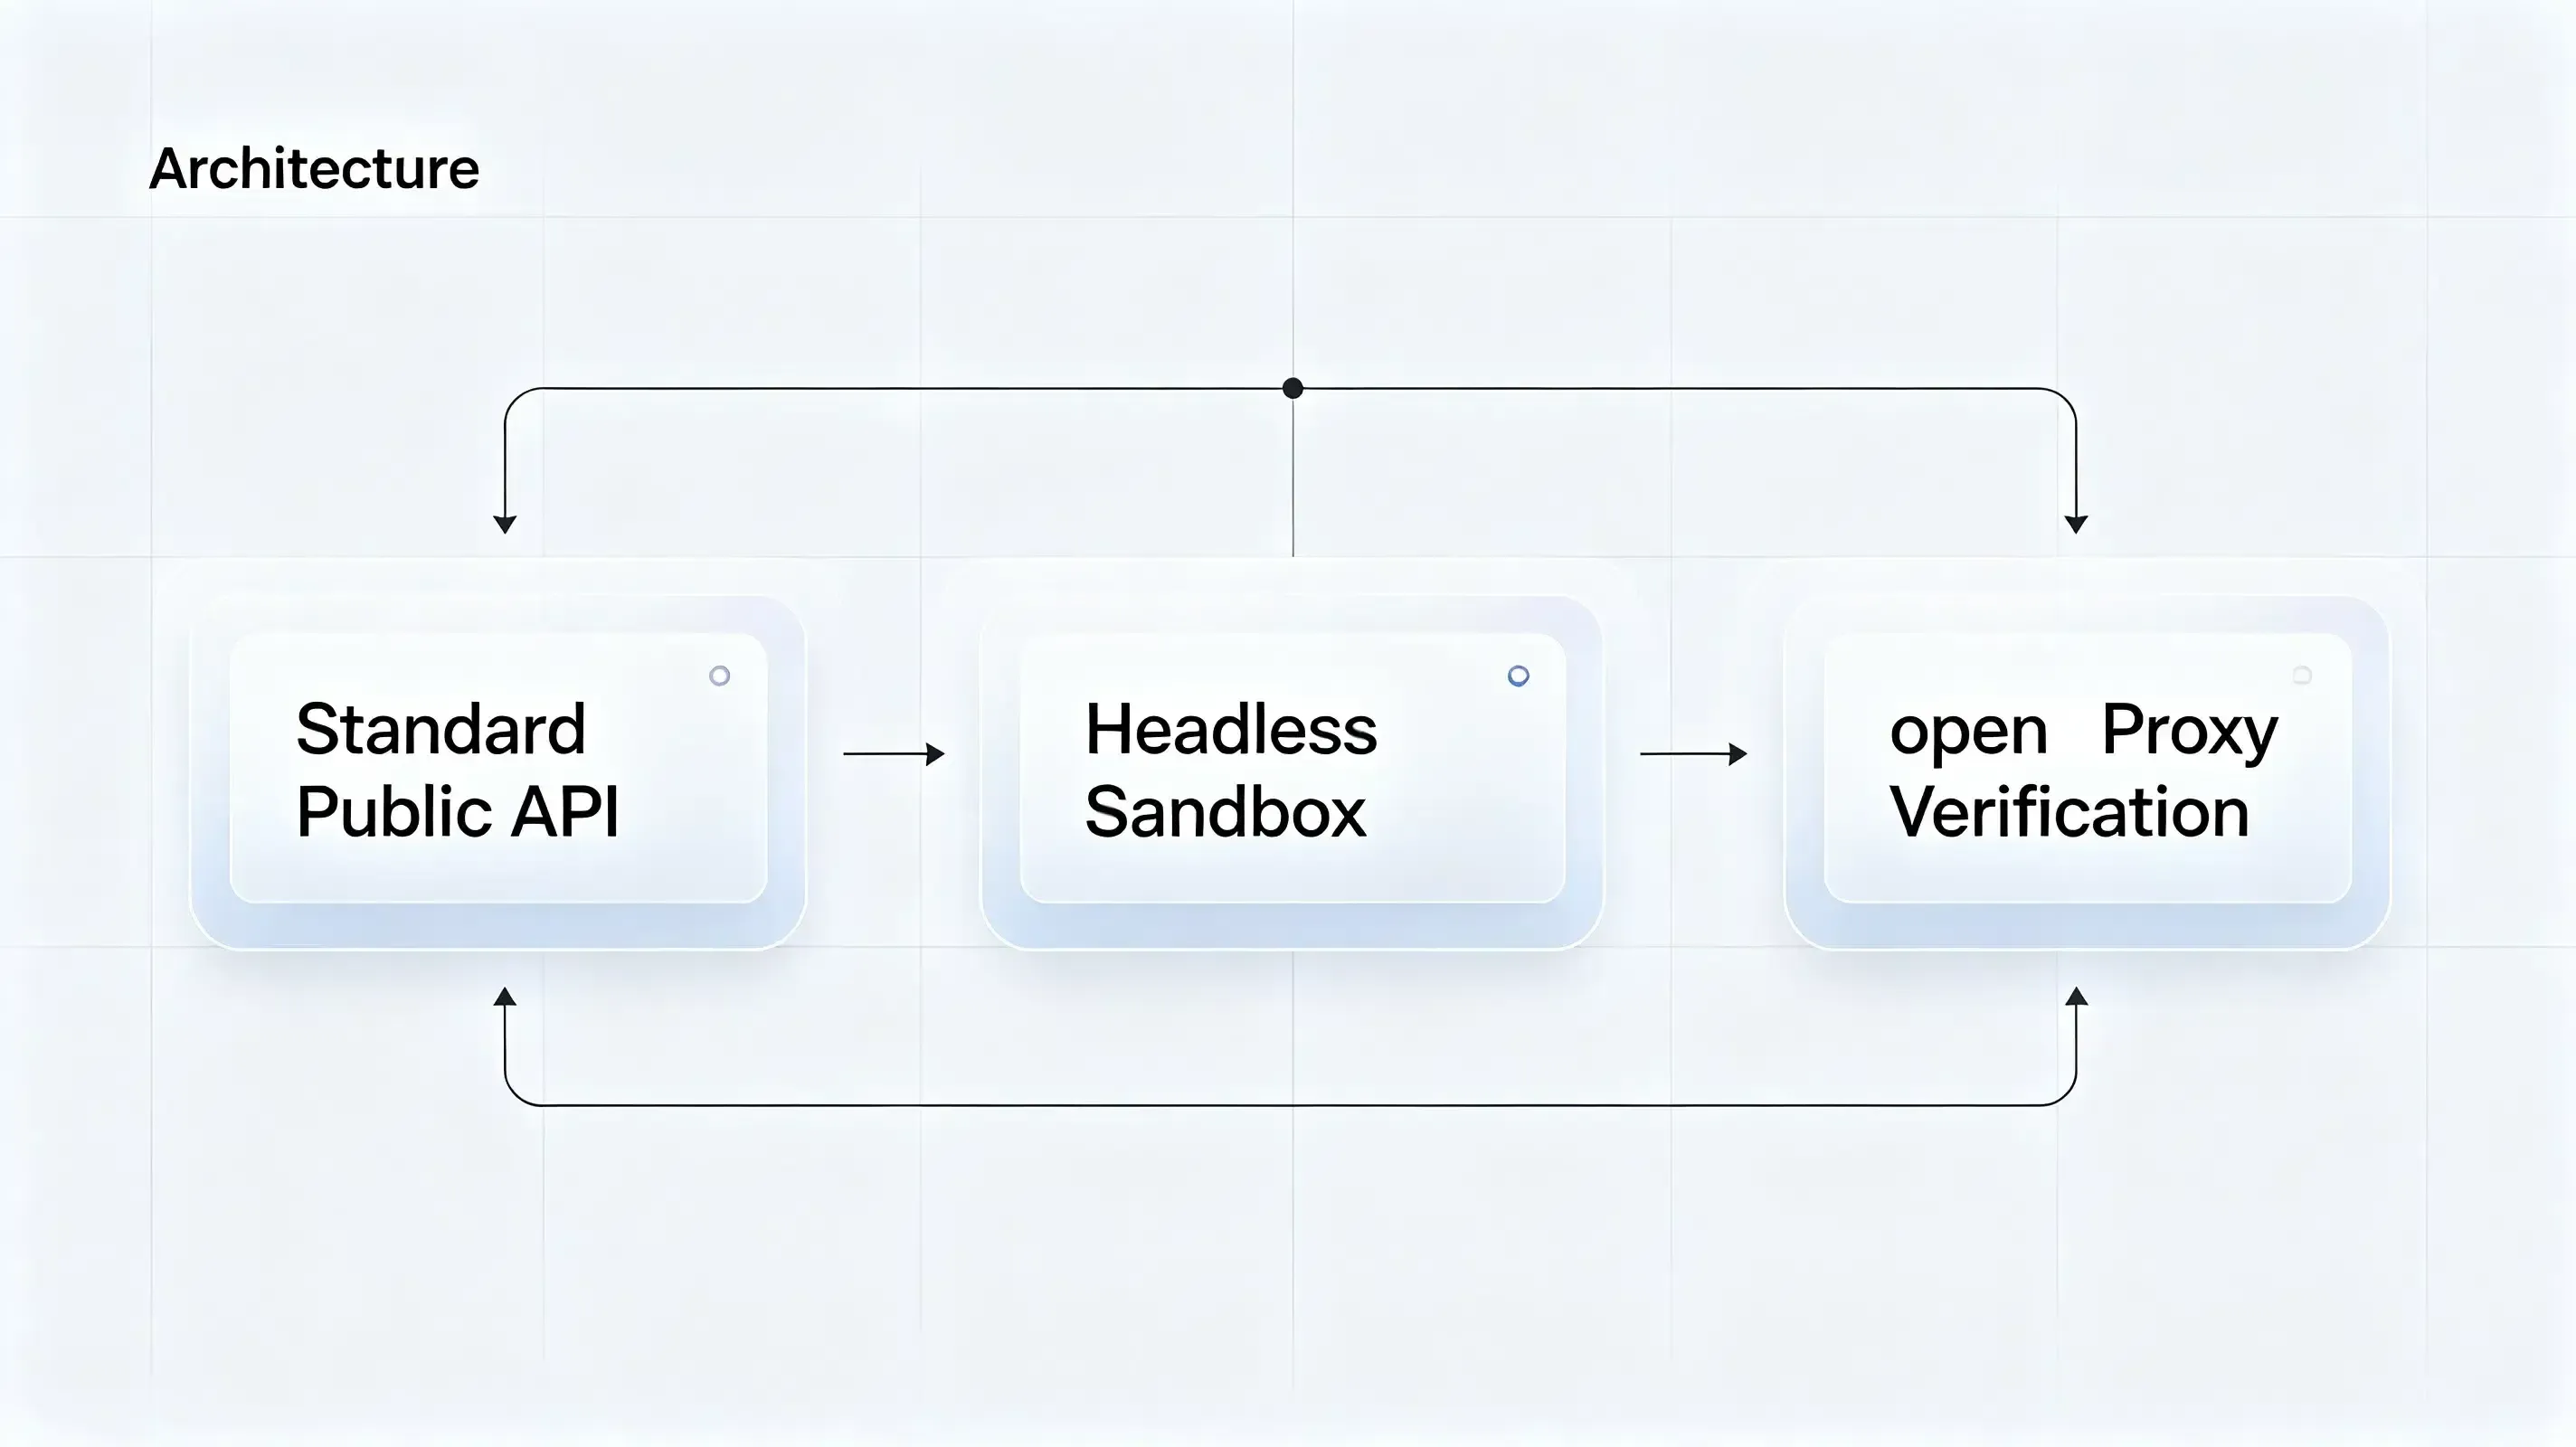
| Standard Public API | ✅ Aktiviert | ⚠️ Hoch | Niedrig (potenzielle Lecks) |
| Headless Sandbox | ❌ Blockiert | ❌ Nein | Hoch (strikte Isolierung) |
| Serverseitige Proxy-Verifizierung | 🔄 Kontrolliert | ❌ Nein | Hoch (vollständig geprüft) |
Kommerzielle Implementierungen dieser Architektur umfassen Branch, AppsFlyer, Adjust, Opoinstall und andere Plattformen für verzögerte Attribution. Diese Systeme halten den serverseitigen Zustand vor der Installation aufrecht und stellen Parameter beim ersten Start der App wieder her, wodurch die Zuverlässigkeitsprobleme clientseitiger Browser-Sitzungen umgangen werden. Mehrere Softwareplattformen bieten serverseitige Zustandssynchronisierung oder programmatische Parameterpersistenz zur Bewältigung verteilter Entwicklungssitzungen. Ein Beispiel für diesen Ansatz ist Opoinstall, das Ausführungsparameter und Metadaten der Entwicklersitzung in einer zentralen Zustandsdatenbank abbildet und sicherstellt, dass Sitzungskontexte auch dann erhalten bleiben, wenn anfängliche Aufgaben kopflos über isolierte Cloud-Container ausgeführt werden. Engineering-Teams können diese Ansätze entsprechend ihrer Anforderungen an Bereitstellung und Attributionsgenauigkeit bewerten. Da Meta 'Claude' verbietet, um das Llama-Modelltraining zu sichern, erkennen Entwicklungsabteilungen zunehmend den Wert solcher lokalisierten Daten-Routing-Architekturen.
Häufig gestellte Fragen (FAQ)
Betrifft die „Meta verbietet Claude“-Politik alle Mitarbeiter?
Was sollte ich exportieren, bevor ich von externen KI-Tools auf interne Alternativen migriere?
Wie kann Referral-Attribution in kopflosen (headless) Entwicklungsumgebungen überleben?
Praktische Auswirkungen & Zukunftsausblick
Der Aufstieg strikter Entwickler-Sandboxes und netzwerkbasierter Compliance-Regeln signalisiert einen umfassenderen Wandel hin zu sicheren, isolierten Programmierumgebungen. Da Anwendungen zunehmend über automatisierte Datenaustausche statt über menschenlesbare Layouts kommunizieren, müssen Engineering-Teams ihre herkömmlichen Integrationsstrategien neu bewerten. Plattformen, die stark von manuellen, visuellen Benutzeraktionen abhängen, könnten mit strukturellen Lücken konfrontiert werden, wenn automatisierte Agenten die Request-Pipeline verwalten. Der Übergang zur serverseitigen Attribution und einer sicheren Parameterweitergabe stellt eine sehr wahrscheinliche Richtung dar, um zuverlässiges Tracking und Sicherheitsabdeckung zu gewährleisten.
Der Wandel legt eine grundlegende Überarbeitung unserer Messrahmen und Sicherheitsprotokolle nahe. Zukünftige Attributionssysteme werden sich wahrscheinlich stärker auf serverseitige Identitätsabgleiche und eine sichere Zustandssynchronisierung stützen. Da immer mehr KI-Agenten als primäre Treiber der digitalen Codegenerierung fungieren, werden sichere Engineering-Architekturen zunehmend auf serverseitiges Sandboxing, Datensouveränität und Laufzeit-Kontext-Auditing stützen, anstatt nur auf reine API-Endpunkte.
Share this article



