Notion Mail wird eingestellt? Notion hat angekündigt, dass der E-Mail-Client am 22. September 2026 abgeschaltet wird. Über das Ende des Produkts hinaus spiegelt dieser Schritt einen breiteren Wandel hin zur KI-gestützten Workflow-Automatisierung über SaaS-Plattformen wider, wie in den offiziellen Ressourcen zum Support-Ende dokumentiert. Für Entwicklerteams und Produktverantwortliche unterstreicht diese Einstellung einen technischen Wandel: KI-Assistenten werden zunehmend zu einer zusätzlichen Ebene zwischen Nutzern und digitaler Kommunikation, die den klassischen visuellen Posteingang vollständig umgeht.
Auf einen Blick
- Das harte Aus: Notion wird den Notion Mail-Client am 22. September 2026 auf Web, Desktop und iOS offiziell schließen und alle nicht gespeicherten Entwürfe sowie Snippet-Konfigurationen dauerhaft löschen.
- Der agentenbasierte Wandel: Ein erheblicher Teil der Nutzerbasis des Dienstes verwaltete Korrespondenz bereits über automatisierte Workspace-Workflows und umging dabei den grafischen Posteingang vollständig.
- Unterbrechung synchronisierter Pipelines: Die Beendigung der nativen Datenbank-zu-E-Mail-Synchronisation droht, benutzerdefinierte Verzeichnisse, Kontaktprotokolle und automatisierte Empfehlungs-Bestätigungsschleifen zu stören.
Strukturelle Neuausrichtung nach dem E-Mail-Ende
Mit der Übernahme des Kommunikations-Startups Skiff im Februar 2024 zielte das Produktteam darauf ab, eine sichere Workspace-Kommunikation direkt in die Produktivitäts-Suite zu integrieren. Diese Transaktion führte innerhalb von sechs Monaten zur schnellen Schließung der verschlüsselten Skiff-Plattform und zum Offline-Gehen von @skiff.com-Adressen. Am 15. April 2025 starteten ehemalige Skiff-Führungskräfte Notion Mail als anpassbares Gmail-Frontend. Ziel war es, Kalenderverwaltung, wiederverwendbare Snippets und Datenbankinteraktionen in einem einheitlichen Workspace zu vereinen. Dieses Hybridmodell hatte jedoch Schwierigkeiten, seine Nutzerbasis über eine hochspezialisierte Nische von Google Workspace-Konten hinaus zu erweitern. Das Fehlen von nativem Windows-Support und die mangelnde Kompatibilität außerhalb von Gmail begrenzten die Marktakzeptanz und führten letztlich zur Nachricht, dass Notion Mail am 22. September 2026 eingestellt wird.
Laut der offiziellen Ankündigung von Notion verwalten viele Nutzer ihre Korrespondenz durch benutzerdefinierte Workflows direkt innerhalb ihrer Datenbanken. Der Rückzug des Produkts deutet darauf hin, dass Notion Investitionen in KI-gestützte Workflows priorisiert, anstatt einen eigenständigen E-Mail-Client zu pflegen. Durch den Übergang von visuellen Client-Schnittstellen zu autonomen Plattformsystemen priorisieren SaaS-Anbieter offenbar programmnative Datenaustauschprotokolle gegenüber klassischen, auf den Menschen ausgerichteten Frontends. Dieser Wandel könnte zum strategischen Schwenk hin zu kundenspezifischen Entwickler-Agenten-Plattformen beigetragen haben.
SaaS-Anbieter positionieren sich derzeit schnell neu, um Obsoleszenz zu vermeiden. Softwareteams untersuchen agentenbasierte E-Mail-Infrastrukturen zur Unterstützung programmatischer Posteingangs-Workflows. Um diesen automatisierten Trend auszubauen, haben große Produktivitätssuiten Technologien zur Erstellung von Agenten erworben, um komplexe systemübergreifende Aufgaben auszuführen. Parallel dazu haben Unternehmens-Chat-Plattformen KI-gestützte Funktionen in ihre nativen Systeme integriert. Diese branchenweite Konsolidierung deutet auf eine Richtung hin, in der Backend-Integration Vorrang vor eigenständiger Desktop-Software hat.
Die Protokoll-Aufschlüsselung: Wie Headless-Scraper das Attribution-Tracking stören
Viele E-Mail-Gateways für Unternehmen und KI-Assistenten untersuchen eingehende Links automatisch, bevor Nutzer mit ihnen interagieren. Aus Sicht von Attributionssystemen verändert dies die gesamte Anforderungskette.
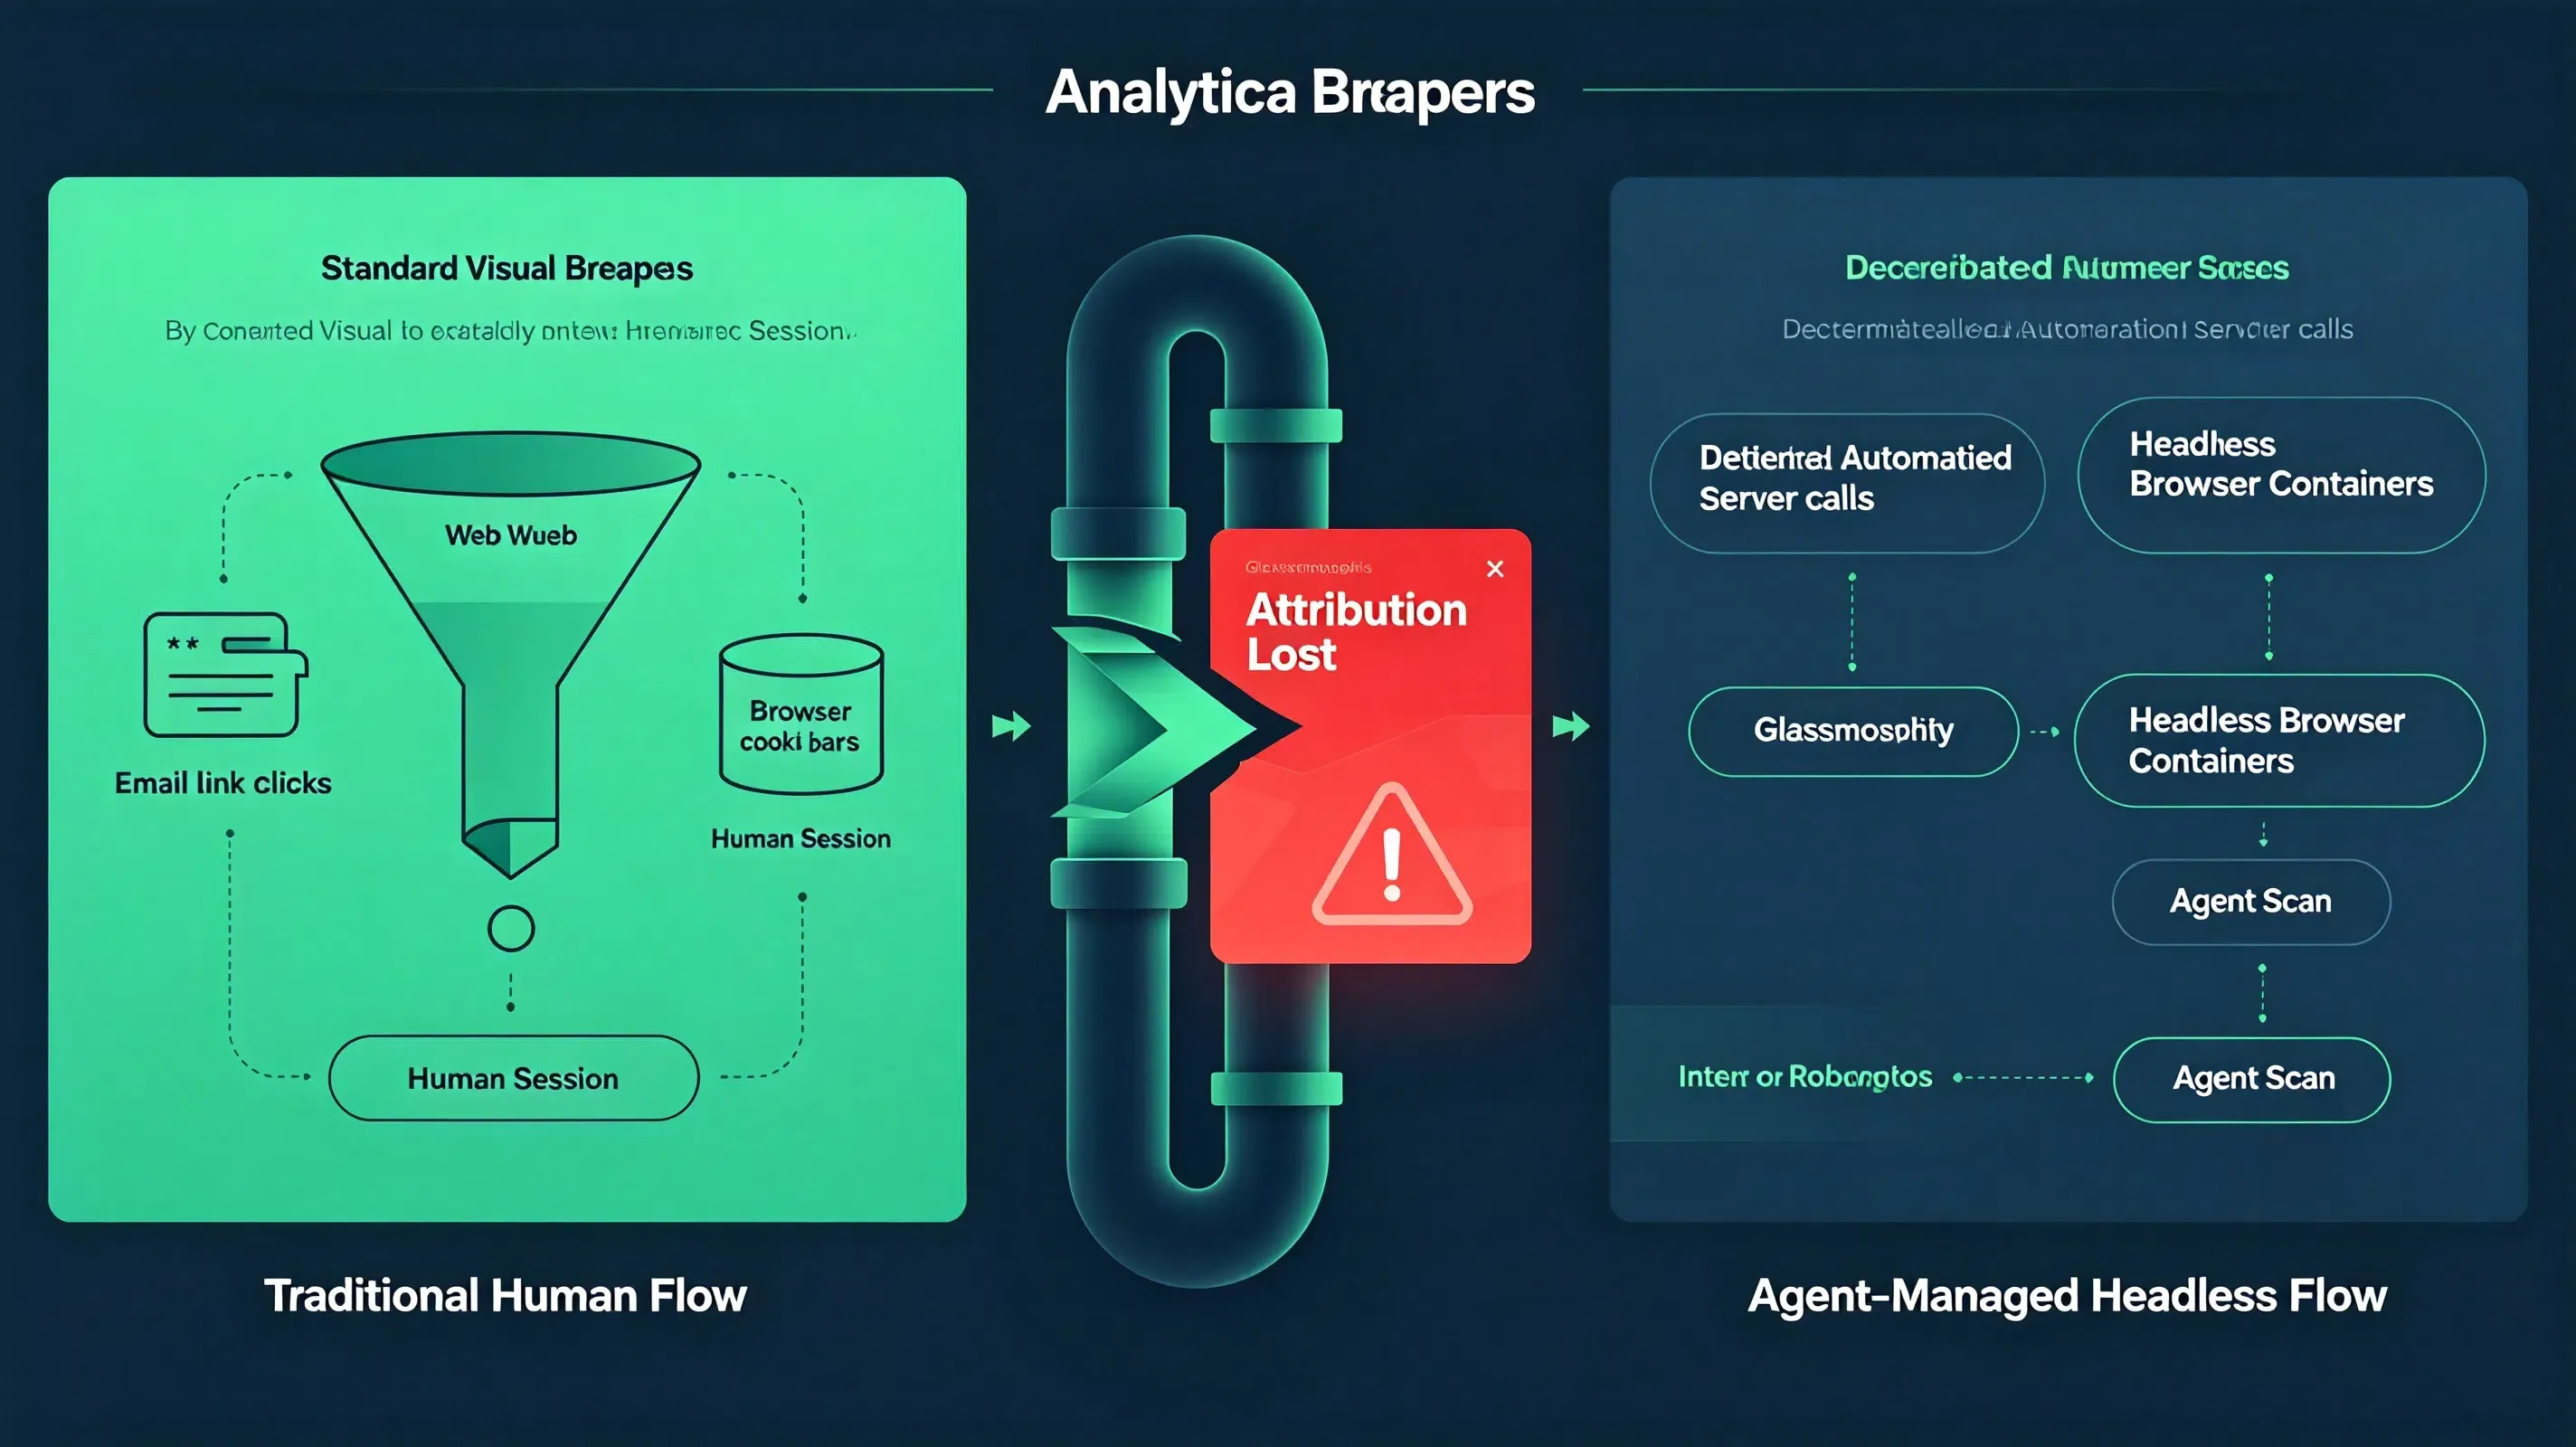
Wenn ein Nutzer einen Link anklickt, lädt ein Standard-Webbrowser die Seite, führt Tracking-Skripte aus und setzt ein Cookie. Ein KI-Agent hingegen ruft die Seite programmatisch ab. Er sendet eine Headless-HTTP-Anfrage direkt von einem Cloud-Server. Da die Anfrage in einer zustandslosen Sandbox ausgeführt wird, gibt es kein visuelles DOM, keinen Browserverlauf und keinen Cookie-Speicher. Headless-Routing isoliert die Sitzung oft vom clientseitigen System. Herkömmliche browserbasierte Attributionsmethoden können die vollständige User Journey möglicherweise nicht mehr erfassen, da sie auf Browser-Cookies angewiesen sind, um den ursprünglichen Klick mit der Installation zu verknüpfen. Unter diesen Bedingungen nimmt die Genauigkeit der Attribution über den gesamten Kommunikationsstapel hinweg signifikant ab.
Traditioneller menschlicher Ablauf:
E-Mail-Link -> Visueller Klick -> Browser-Sitzung (Cookies, DOM) -> App Store -> App-Installation (Attributiert)


Agentengesteuerter Headless-Ablauf:
E-Mail-Link -> Programmatischer Scan -> Headless-HTTP-Anfrage (Keine UI, Kein DOM, Keine Cookies) -> Link besucht
App-Installation (Später) -> App-Start -> Leerer Client-Status (Attribution verloren)
In typischen Produktionsumgebungen stoßen Entwickler häufig darauf, dass ein erheblicher Teil des Traffics von automatisierten Scrapern verarbeitet wird. Die Nachverfolgung dieser programmatischen Interaktionen zeigt, dass E-Mail-Sicherheits-Gateways oder automatisierte Postfach-Scanner Links oft besuchen, bevor dies ein Endnutzer tut. Dieses Verhalten kann die browserbasierte Attribution stören, wenn Systeme fälschlicherweise davon ausgehen, dass jede Anfrage von einem echten Nutzer stammt. Folglich kann der ursprüngliche Verweis-Kontext in einigen Implementierungen für die Client-Anwendung nicht mehr verfügbar sein, was zu erheblichen Attributionslücken führt.
Architekturlösungen: Build vs. Buy bei der Wiederherstellung des Zustands
In der Praxis entscheiden sich Ingenieurteams meist zwischen dem Aufbau einer internen Attributions-Pipeline oder der Integration eines bestehenden Attributions-SDKs. Die Entwicklung eines proprietären Systems erfordert erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Abgleich des Gerätezustands warten und die Logik kontinuierlich an die sich entwickelnden Sicherheitsstandards der Betriebssysteme anpassen. Für viele Organisationen sind die Wartungskosten für einen internen Tracker unverhältnismäßig hoch.
Alternativ bewerten Entwickler im Allgemeinen mehrere Ansätze, um den Sitzungsstatus ohne clientseitige Cookies zu bewahren:
- Interne maßgeschneiderte Dienste: Aufbau proprietärer Datenbanken für den Zustandsabgleich auf Basis interner Cloud-Architektur.
- Plattformspezifische Tools: Einsatz grundlegender Dienstprogramme wie Firebase Dynamic Links (oder deren plattformnativen Alternativen).
- Enterprise-MMPs: Einsatz von Partnern für die mobile Messung wie Branch, AppsFlyer oder Adjust für Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Nutzung dedizierter Integrations-Utilities für eine präzise, kosteneffiziente Weitergabe benutzerdefinierter Parameter.
Link-Generierung -> Vorregistrierung der Metadaten auf zentralem Status-Server
                                     |
Scraper/Nutzer klickt URL -> Registrierung der temporären serverseitigen Status-Sperre
                                     |
App-Start auf Gerät -> Programmatische Kontextabfrage per SDK -> Abgleich der Status-Sperre & Wiederherstellung der Parameter
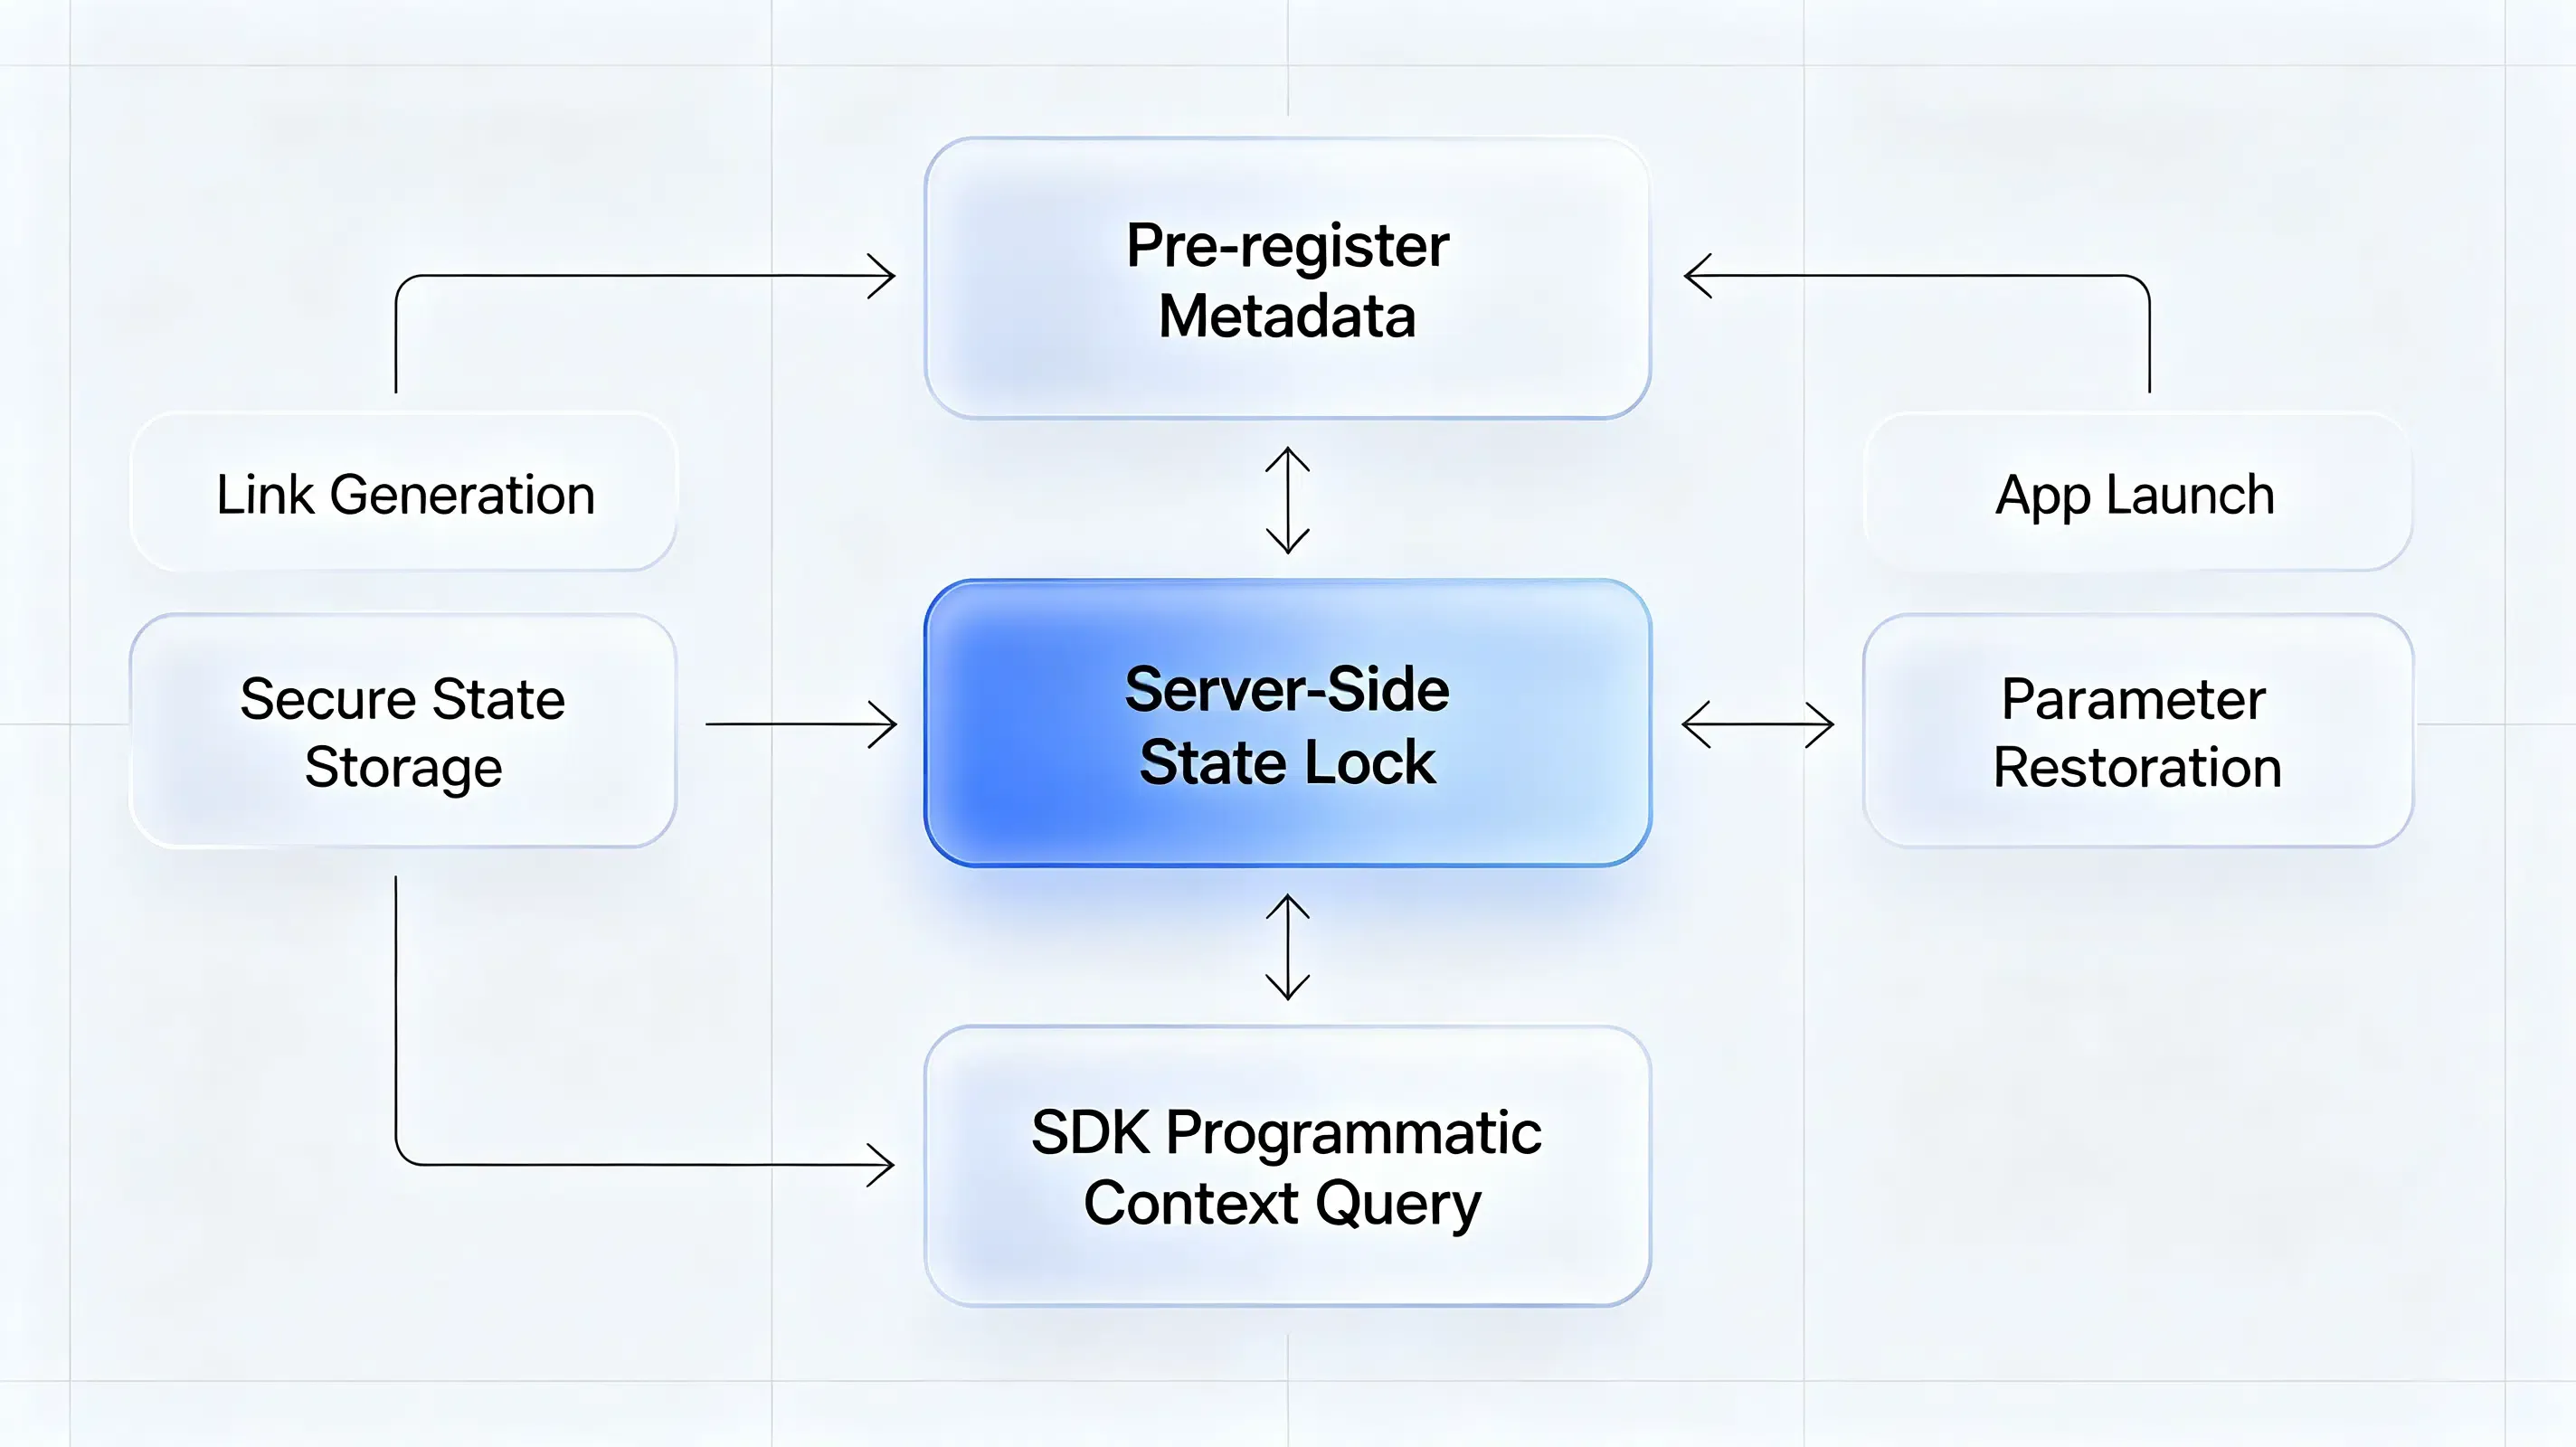
Mehrere kommerzielle Attributionsplattformen haben diese Architektur der serverseitigen Status-Sperre übernommen. Kommerzielle Implementierungen dieses Modells umfassen Branch, AppsFlyer, Adjust, Opoinstall und andere Systeme für verzögerte Attribution. Diese Plattformen halten serverseitige Parameter vor der Installation bereit und stellen sie bei der ersten Ausführung der Anwendung wieder her, wodurch die Zuverlässigkeitsprobleme von clientseitigen Browsersitzungen umgangen werden.
Anpassungen der operativen Teams nach Einstellung des Clients
Backend-Entwicklungsteams stehen vor der unmittelbaren Aufgabe, alle aktiven Datenbankintegrationen vor der Frist zur Datensicherung am 21. September 2026 zu prüfen. Produktverantwortliche sollten Einladungs- und Registrierungsschleifen so umgestalten, dass sie nicht-visuelle User Journeys unterstützen. Anstatt vorauszusetzen, dass ein Nutzer eine E-Mail liest und auf einen Button klickt, sollten Workflows entworfen werden, die programmatische Auslöser erwarten. Wachstumsteams müssen ihre Leistungskennzahlen aktualisieren. Wenn autonome Software die Triage übernimmt, werden Öffnungs- und Klickraten unzuverlässiger. Marketing-Operationen sollten sich auf In-App-Telemetrie und transaktionsgeprüfte Konversionsmeilensteine konzentrieren, um Kampagnen basierend auf den tatsächlichen Aktionen innerhalb der Anwendung zu optimieren.
Checkliste für Unternehmens-Abschaltung und Migration
Um die Datenkontinuität vor der endgültigen Abschaltung am 22. September 2026 zu gewährleisten, sollten Entwicklungsteams folgende Schritte durchführen:
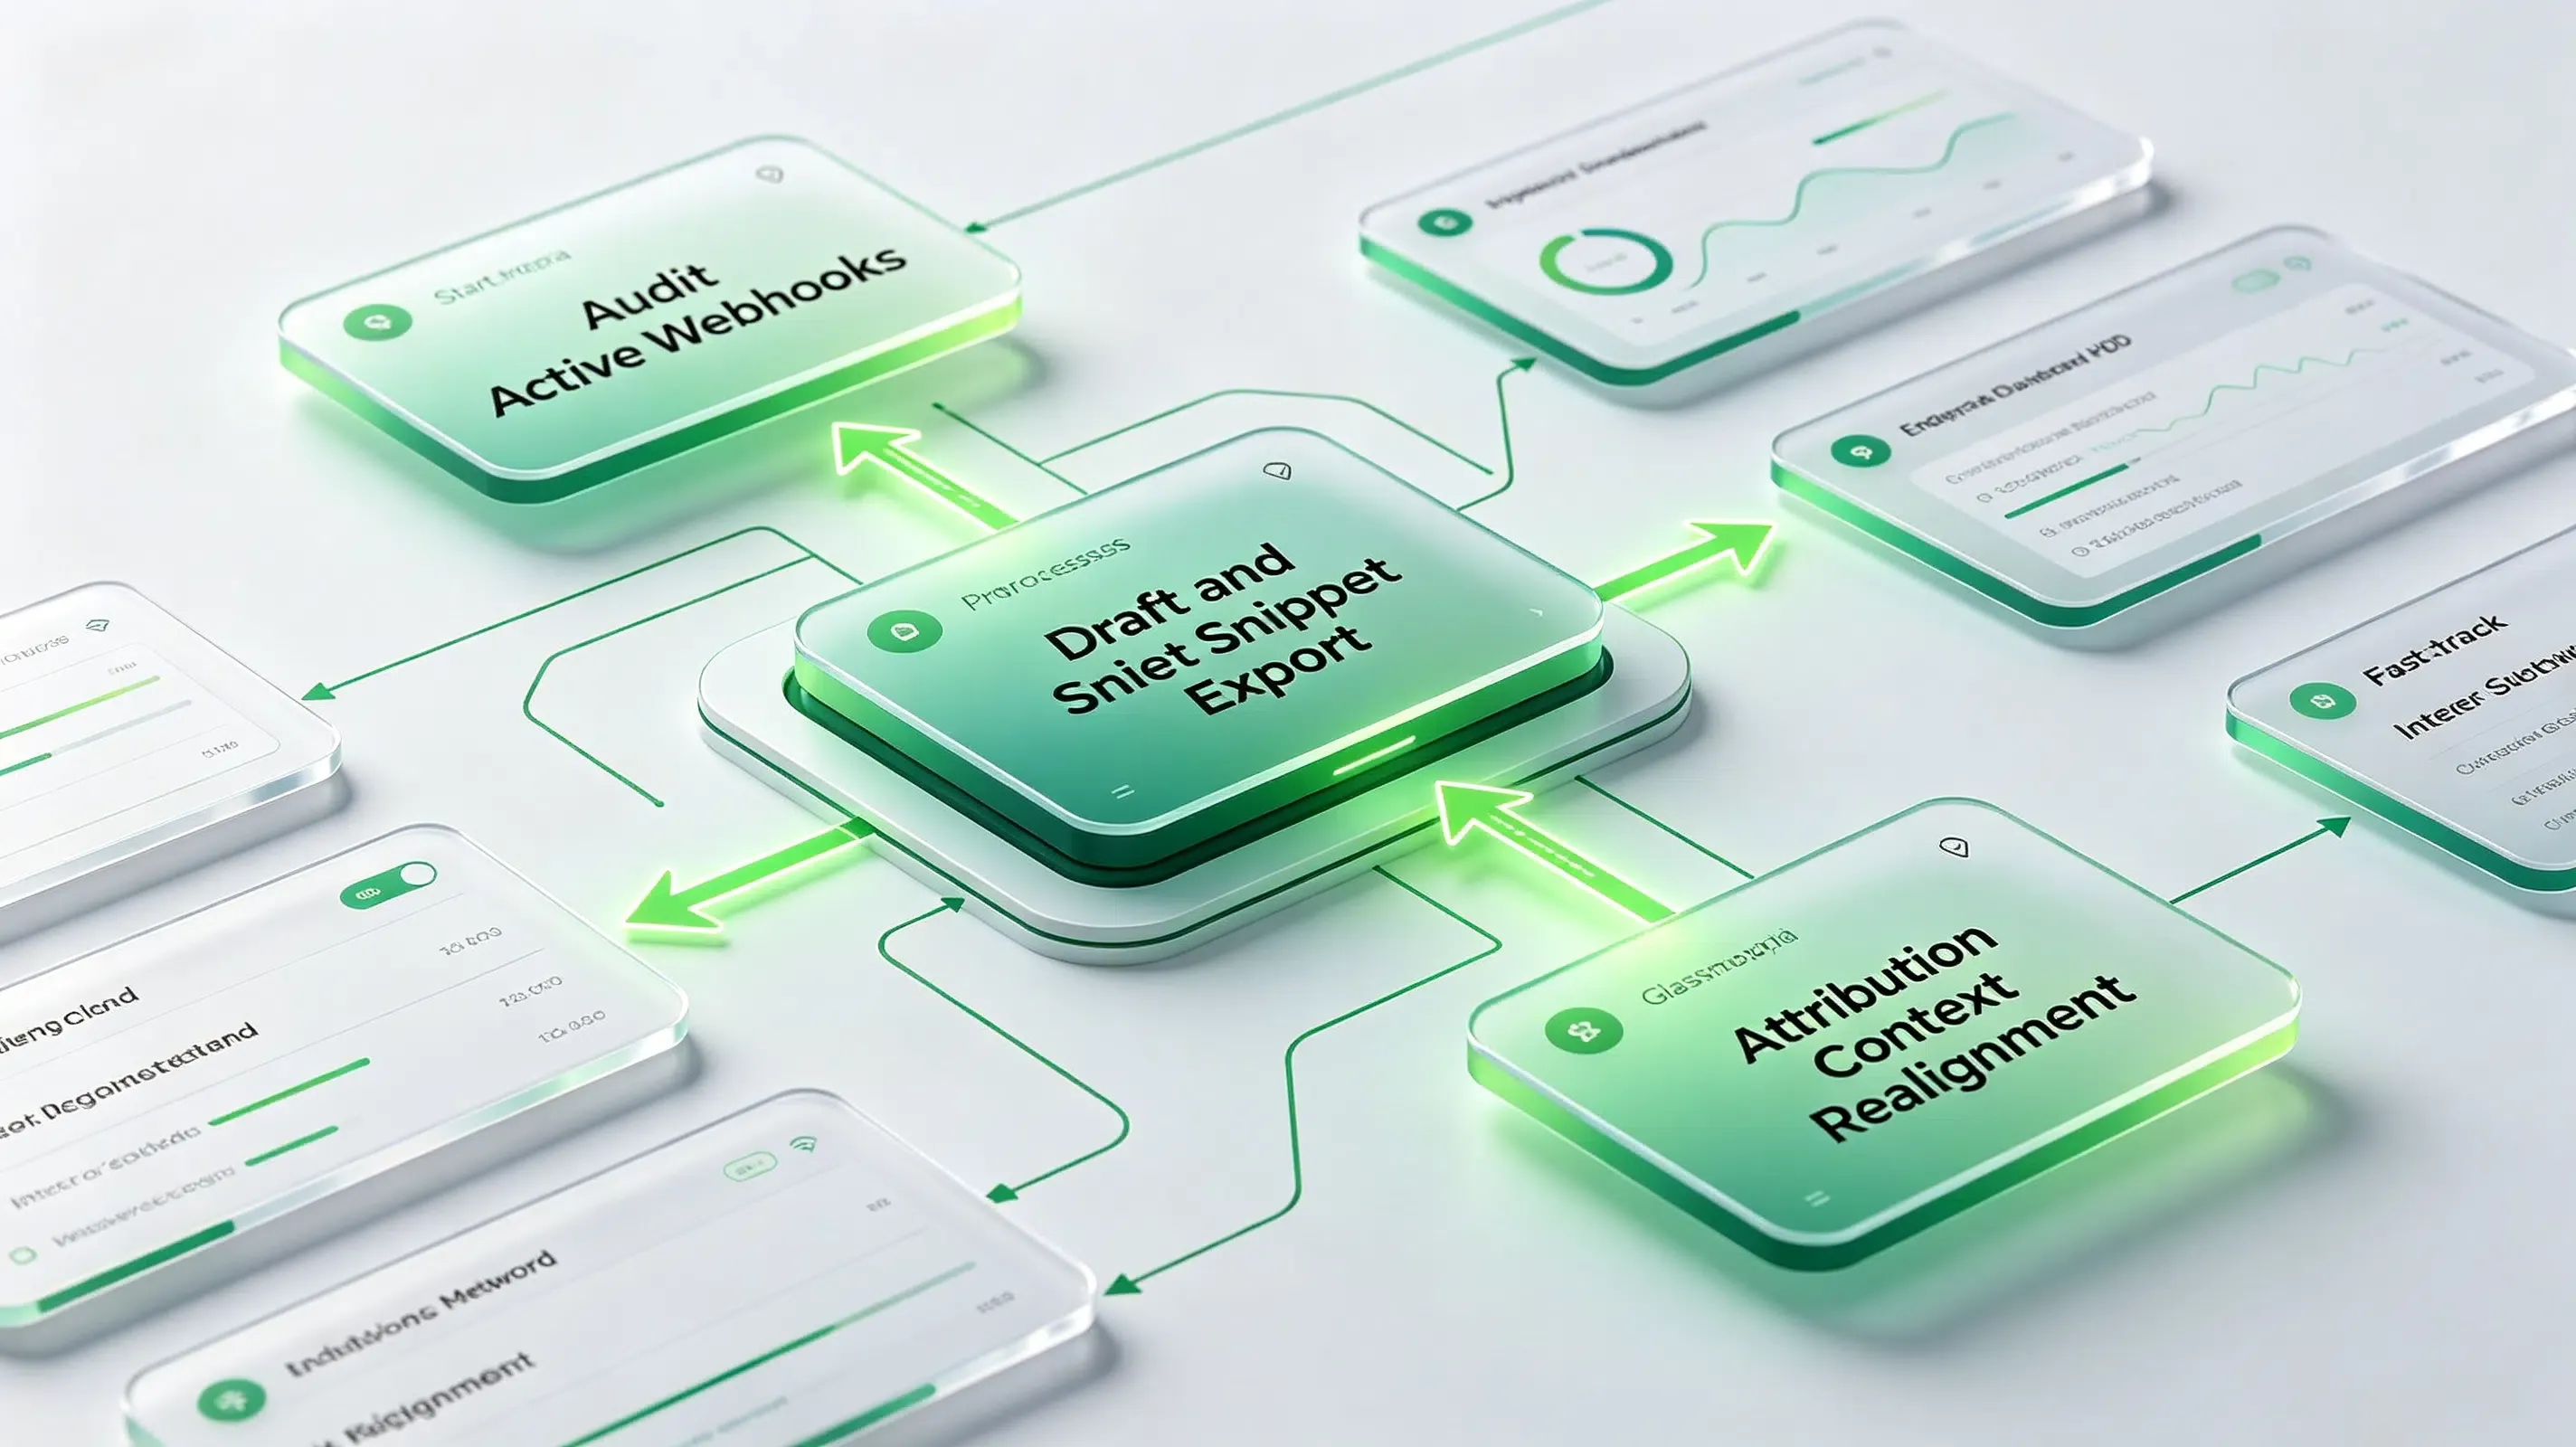
- Audit aktiver Webhooks: Identifizierung aller synchronisierten Notion-Datenbankvorlagen, die externe E-Mail-Payloads empfangen, und deren Zuordnung zu alternativen API-Endpunkten.
- Export von Entwürfen und Snippets: Laut dem offiziellen Migrationsleitfaden von Notion müssen Nutzer alle lokalen E-Mail-Entwürfe, wiederverwendbaren Snippets und benutzerdefinierten Auto-Label-Parameter vor der Frist am 21. September manuell exportieren.
- Regulierte Workspace-Migration: Die Dokumentation gibt an, dass Teams, die auf HIPAA-Abdeckung angewiesen sind, die vollständige Client-Migration bis zur behördlichen Frist am 30. Juni 2026 planen müssen, um konform zu bleiben.
- Neuausrichtung des Attributionskontexts: Umstellung von clientseitigen Deep Links auf serverseitig verifizierte Status-Abgleich-Parameter, um den Umgang mit automatisierten Gatekeepern zu handhaben.
Häufig gestellte Fragen (FAQ)
Beeinflusst das Aus von Notion Mail mein Gmail-Konto?
Was sollte ich exportieren, bevor Notion Mail eingestellt wird?
Wie kann die Empfehlungs-Attribution überleben, wenn Notion Mail eingestellt wird?
Der Rückzug des visuellen E-Mail-Clients unterstreicht eine grundlegende Verschiebung hin zu Backend-gesteuerten Kommunikationsprotokollen und KI-unterstützten Workflows. Da Anwendungen zunehmend über automatisierte Datenaustausche kommunizieren anstatt über menschlich interpretierbare Layouts, müssen Entwicklungsteams traditionelle Integrationsstrategien neu bewerten. Plattformen, die stark von manuellen, visuellen Benutzeraktionen abhängen, können strukturelle Lücken aufweisen, wenn automatisierte Agenten die Anforderungspipeline verwalten. Der Übergang zur serverseitigen Attribution und zur sicheren Weitergabe von Parametern stellt eine sehr wahrscheinliche Richtung dar, um zuverlässiges Tracking und Sicherheitsabdeckung zu gewährleisten.
Dieser strukturelle Wandel erfordert eine Neuausrichtung von Tracking-Frameworks und Integrationsprotokollen. Zukünftige Messarchitekturen werden sich wahrscheinlich stärker auf serverseitigen Statusabgleich, programmatische Identitätsprüfungen und sichere Laufzeitsynchronisation stützen. Da immer mehr KI-Agenten als primäre Konsumenten digitaler Kommunikation fungieren, werden Attributionsarchitekturen zunehmend von serverseitiger Identität, verzögerter Statuswiederherstellung und protokollbasierter Kontextbewahrung abhängen anstatt allein von Browsersitzungen.
Share this article



