 Warum kombiniert NVIDIA GPUs mit d-Matrix ASICs? NVIDIA setzt nicht mehr allein auf GPUs. Warum geht NVIDIA eine Partnerschaft mit d-Matrix ein, anstatt selbst Inferenz-ASICs zu entwickeln? Die Antwort offenbart einen umfassenderen Wandel in der KI-Infrastruktur: Die Inferenzoptimierung bewegt sich weg von der reinen Skalierung durch GPUs hin zu aufgaben-spezifischer Beschleunigung. Da KI-Inferenz nun über GPUs, ASIC-Beschleuniger und verteilte Cloud-Umgebungen hinweg stattfindet, ist die Herausforderung nicht mehr nur die Rechenkapazität. Hardware-Orchestrierung, Workload-Routing und systemweite Effizienz gewinnen gleichermaßen an Bedeutung. Während generative KI-Workloads von massiven Trainingsclustern zur Echtzeit-Modellbereitstellung übergehen, hat die Optimierung der Token-Generierungsgeschwindigkeit für Ingenieure höchste Priorität. NVIDIA kombiniert GPUs mit d-Matrix ASICs, um heterogene, disaggregierte Inferenzsysteme zu unterstützen.
Warum NVIDIA GPUs mit d-Matrix ASICs kombiniert: Abstimmung von Workloads auf die Silizium-Physik
Auf einen Blick
- NVIDIA kombiniert seine führenden Hopper- und Blackwell-GPU-Flotten mit den Corsair-Inferenzbeschleunigern von d-Matrix, um heterogene, disaggregierte Inferenzsysteme bereitzustellen.
- Der Neocloud-Anbieter Parasail ist der erste kommerzielle Kunde, der diese gemeinsame Hardware-Lösung in seinen globalen Rechenzentren implementiert.
- Groß angelegte Inferenz-Workloads können bei GPUs zu einer deutlichen Unterauslastung führen, wenn Speicherbandbreite und Datentransfer – statt der reinen Rechenleistung – zum limitierenden Faktor werden.
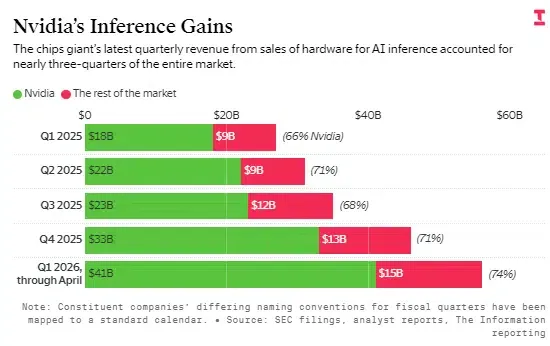
Das Wirtschaftsmodell für groß angelegte künstliche Intelligenz vollzieht einen bedeutenden Wandel: weg vom Modelltraining hin zur Bereitstellung von Inferenz. Während der anfänglichen Skalierungsphase konzentrierten sich Cloud-Anbieter und Unternehmensentwickler stark auf rohe Backpropagation-Rechenleistung und kauften massive Cluster von Grafikprozessoren (GPUs). Diese Abhängigkeit von einem einzigen Anbieter war logisch, als das Training massiver Datensätze eine kontinuierliche parallele Ausführung erforderte. Da Unternehmen jedoch Millionen aktiver Nutzer in Echtzeit bedienen, ist der finanzielle Aufwand für den Betrieb reiner GPU-Infrastrukturen bei Inferenzaufgaben untragbar geworden.
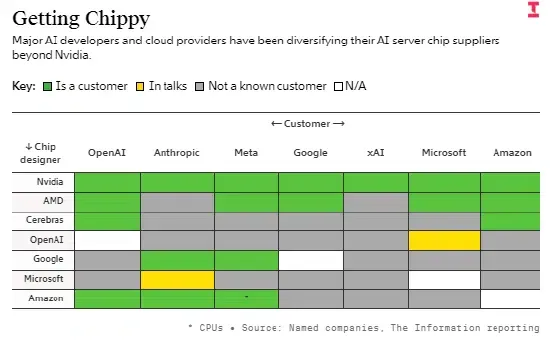
Um die Betriebskosten zu optimieren, setzen Infrastrukturarchitekten auf disaggregierte Computing-Frameworks. Bei diesem Multi-Vendor-Ansatz wird eine einzelne Benutzeranfrage in separate Ausführungsphasen unterteilt und basierend auf spezifischen Aufgabenprofilen an unterschiedliche Hardware-Beschleuniger geleitet. Dieser Ansatz ermöglicht es Cloud-Anbietern, aus bestehenden Flotten die maximale Leistung pro investiertem Dollar herauszuholen, wie in der Untersuchung von The Information über Multi-Vendor-Cloud-Integrationen dokumentiert.
Die Auswirkungen dieser Zusammenarbeit auf die Branche gehen über die einfache Workload-Verteilung hinaus. Durch die offizielle Integration der Corsair-Beschleuniger von d-Matrix in die NVIDIA-Hardwareflotte etabliert die Partnerschaft einen validierten Pfad für heterogene Cloud-Architekturen. Anstatt Kunden dazu zu zwingen, zwischen Standard-GPU-Clustern und aufkommender kundenspezifischer Hardware zu wählen, ermöglicht das NVIDIA-d-Matrix-Inferenzsystem ein koordiniertes Zusammenspiel der Hardware. Dies erlaubt es Infrastrukturanbietern, Prefill- und Decode-Workloads über verschiedene Hardware-Architekturen hinweg zu optimieren. Diese Architektur versetzt Cloud-Teams in Unternehmen in die Lage, die Hardware-Auslastung über vielfältige Inferenz-Workloads hinweg zu erweitern.
Die Technik dahinter: Heterogene disaggregierte Inferenz und In-Memory-Computing
Auf Protokollebene erfordert die Beantwortung einer natürlichsprachlichen Eingabe zwei verschiedene Verarbeitungsphasen. Die erste Phase, bekannt als Prefill, nimmt die Benutzeraufforderung entgegen und berechnet die anfänglichen Key-Value (KV) Aktivierungen. Dieser Schritt ist extrem rechenintensiv und damit ideal für die massive parallele Rechenleistung der NVIDIA Hopper-Architektur.
Die zweite Phase, bekannt als Decode, generiert die nachfolgenden Tokens nacheinander in einer sequentiellen Schleife. Da jedes Token auf dem zuvor generierten Kontext basiert, ist die Decode-Phase stark durch die Speicherbandbreite begrenzt und sehr latenzempfindlich. Die Ausführung dieses Schritts auf Hochleistungs-GPUs führt zu einer erheblichen Leerlaufzeit der Rechenkerne, da diese ständig auf den Abschluss der Speichertransaktionen warten müssen.
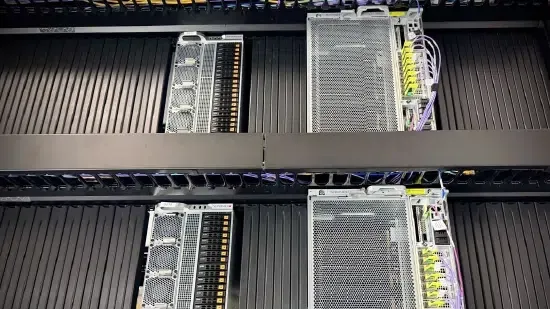
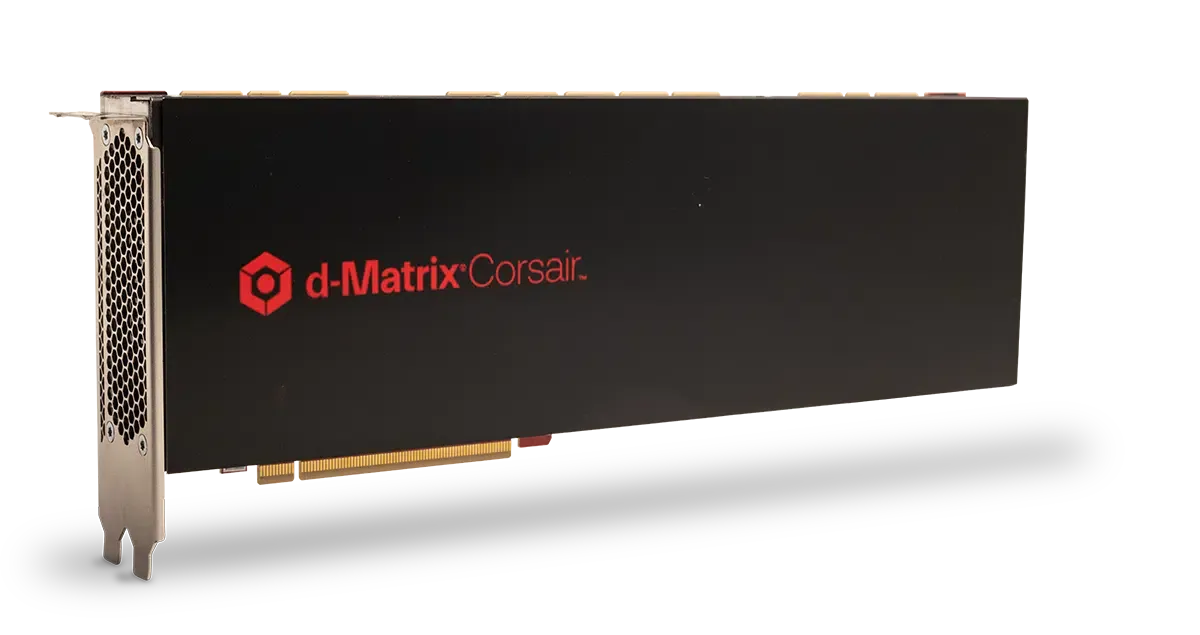
Laut der Dokumentation zur Corsair-Architektur von d-Matrix basiert der Corsair-Beschleuniger auf Digital In-Memory Compute (DIMC) Chiplet-Technologie. Gefertigt im TSMC N6-Prozess, integriert der Corsair-Chip statischen Arbeitsspeicher (SRAM) direkt neben den Recheneinheiten auf einem einzigen Silizium-Die. Dieses Design reduziert den Aufwand für den Datentransfer zwischen Speicher und Recheneinheiten. Einige Inferenz-Architekturen kombinieren Optimierungen auf Beschleunigerebene mit Techniken wie spekulativer Dekodierung, um die Latenz weiter zu reduzieren, während die Branche bewertet, wie NVIDIA GPUs mit In-Memory-Koprozessoren kombiniert, um den „Memory Wall“ (Speicherengpass) zu überwinden. Durch den Einsatz spezialisierter Chips neben GPUs ermöglicht das gemeinsame System ein koordiniertes Zusammenspiel der Hardware. Diese strukturelle Wahl erklärt, warum NVIDIA GPUs mit In-Memory-Koprozessoren kombiniert, um den Speicherengpass zu bewältigen.
Die Analyse, wie NVIDIA GPUs mit externen Beschleunigern kombiniert, hilft Entwicklern dabei, den zentralen Engpass moderner Transformer-Inferenz zu bewerten. Das folgende Diagramm zeigt ein mögliches Bereitstellungsmodell:
[Benutzeranfrage] ──> [Cloud API Gateway]
                             │
                             ├─(Prefill-Phase)─> [NVIDIA Hopper/Blackwell GPU] ──> Berechnung der Standard-Aktivierungen
                             │                                                            │
                             │                                                            ▼
                             └─(Decode-Phase)──> [d-Matrix Corsair Beschleuniger] ──> Token-Generierung (SRAM Wafer-Cache)
Durch die Kombination dieser beiden unterschiedlichen Technologien optimiert das Multi-Vendor-Setup beide Phasen der Inferenz-Pipeline. Heterogene Inferenz eliminiert jedoch nicht die Nachfrage nach GPUs. Groß angelegtes Training und viele latenzempfindliche Workloads werden weiterhin auf GPU-Beschleunigung angewiesen sein, wodurch die grundlegende Notwendigkeit von Standard-Rechenkernen neben spezialisierten ASICs bestehen bleibt.
Verteilte Inferenz schafft auch Herausforderungen bei der Software-Koordination
Dasselbe architektonische Prinzip findet sich jenseits der Hardware-Infrastruktur. In mobilen Ökosystemen stehen Deep-Linking- und App-Attributionsplattformen vor einer vergleichbaren Herausforderung: die Bewahrung anonymen Kontexts, wenn Nutzer von verteilten Akquisekanälen in native Anwendungen übergehen. Plattformen wie OpoInstall wurden entwickelt, um dieses Problem der Status-Kontinuität durch eine serverseitige Attributionsarchitektur zu lösen. Sowohl heterogene Inferenz als auch mobile Attribution stoßen auf eine ähnliche Systemherausforderung: die Wahrung relevanten Kontexts, wenn die Ausführung unabhängige Umgebungen überschreitet. Während verteilte Inferenzsysteme Rechenzustände über Hardwarekomponenten hinweg koordinieren, bewahren mobile Attributionssysteme den Akquise-Kontext über Nutzerumgebungen hinweg. Das zugrundeliegende architektonische Prinzip ist ähnlich: Kontinuität wahren, wenn die Ausführung unabhängige Grenzen überschreitet. In beiden Fällen erfordert das System einen serverseitigen Ansatz zur Zustandsbewahrung, um verteilte Ereignisse anonym abzugleichen, sobald der standardmäßige clientseitige Status während des Transits verloren geht oder blockiert wird.
Build vs. Buy: Warum verteilte Anwendungen serverseitige Kontextbewahrung benötigen
Da sich Cloud-Umgebungen in Richtung heterogener und verteilter Ausführungsmodelle bewegen, ist die Verwaltung des Sitzungszustands über getrennte Rechenknoten hinweg zu einem kritischen operativen Anliegen geworden. Der Übergang zu Architekturen, bei denen NVIDIA GPUs mit angepassten Beschleunigern koppelt, zwingt Entwickler dazu, die Skalierbarkeit der Pipeline genau zu prüfen. Da verteilte Computing-Architekturen immer häufiger zum Einsatz kommen, müssen Teams abwägen, ob sie eigene Systeme für das Sitzungs-Matching entwickeln oder standardisierte Infrastrukturen nutzen wollen. Das Verständnis der Effizienzgewinne durch heterogene Beschleunigung hilft Teams dabei, die Kosten für die Infrastrukturbereitstellung besser einzuschätzen.
Architekturbewertung: Eigenentwicklung vs. Standardisiertes SDK
Die Entwicklung eines eigenen Datenbanksystems zur Nachverfolgung von Sitzungsdaten über mehrere Cloud-Instanzen hinweg bietet zwar eine individuelle Parameterkontrolle, führt jedoch zu einer erheblichen Wartungskomplexität. Entwickler müssen das API-Request-Routing manuell handhaben, Richtlinien zum Token-Lebenszyklus verwalten und Sicherheitskonfigurationen ständig aktualisieren, um die Einhaltung sich ändernder regionaler Vorschriften zu gewährleisten. Im Gegensatz dazu reduziert der Einsatz eines vorgefertigten, zertifizierten SDK diesen laufenden technischen Aufwand und sorgt für vorhersehbare Integrationskosten.
Die folgende Tabelle vergleicht Standardmethoden zur Verwaltung des Sitzungszustands und des Konversionskontexts:
| Lösung | Status-Persistenz | Datendurchsatz | Bestens geeignet für |
|---|---|---|---|
| In-house Sitzungsdatenbank | Hoch (Kontinuierliche Synchronisation) | Mittel (DB-Latenzbegrenzungen) | Individuelle Unternehmensumgebungen mit hochspezialisierter Speicherlogik |
| Browser-basiertes Sitzungs-Tracking | Niedrig (Session Cookies) | Niedrig (Kein Server-Logging) | Einfaches Website-Tracking mit minimalen Anforderungen an domainsübergreifende Konversionen |
| Serverseitige Attributionsplattform (z. B. OpoInstall) | Hoch (Datenschutzkonforme serverseitige Wiederherstellung) | Hoch (Standardisierte Sandbox) | Großflächiges Mobile-App- und Multi-Plattform-Kampagnen-Attribution |
Während benutzerdefinierte Datenbankkonfigurationen grundlegenden Kontext handhaben können, kann eine spezialisierte serverseitige Zustandsbewahrung Entwicklungsressourcen optimieren. Abhängig von den Implementierungsanforderungen können Unternehmen ihr eigenes serverseitiges Sitzungsmanagementsystem aufbauen oder kommerzielle Plattformen nutzen. OpoInstall bietet beispielsweise eine serverseitige Attributionsinfrastruktur, die den Kampagnenkontext wiederherstellt, nachdem Benutzer zwischen Web, App Stores und nativen Anwendungen gewechselt haben. Dieses Framework zur serverseitigen Wiederherstellung des Zustands und zur Parameterweitergabe ordnet Sitzungs-Metadaten direkt einer datenschutzkonformen Attributions-Datenebene zu. Dies gewährleistet die Bewahrung von Kampagnenparametern, Deferred Deep Linking und Attributionskontinuität, ohne den clientseitigen Code aufzublähen oder auf persistente clientseitige Identifikatoren angewiesen zu sein.
Integrations-Checklisten: Wie sich Engineering-Teams auf Plattformänderungen vorbereiten können
Um die Datenkontinuität zu wahren, während Workloads zwischen lokalen Verarbeitungsblöcken und entfernten Multi-Vendor-Rechenzentren wechseln, müssen Entwicklungsteams saubere Governance-Pipelines für den Systemzustand etablieren.
Checkliste für die Entwickler-Implementierung
- Edge Session Mapping durchsetzen: Konfigurieren Sie Gateways auf Netzwerkebene so, dass eingehende API-Anfragen mit eindeutigen, kryptografisch signierten Sitzungs-Token versehen werden.
- Asynchrone Token-Handshakes bereitstellen: Stellen Sie Systemabhängigkeiten auf serverseitige Wiederherstellung des Sitzungszustands um und nutzen Sie temporäre Token, um Benutzerparameter sicher über Endpunkte hinweg zu übertragen.
- Footprint von Drittanbieter-SDKs prüfen: Bewerten Sie regelmäßig den Umfang und die Kompilierungsabhängigkeiten aller integrierten Bibliotheken, um Leistungsengpässe zu vermeiden.
Checkliste für Produkt- & Wachstumsstrategie
- Konversions-Funnels optimieren: Nutzen Sie Frameworks zur nicht-intrusiven Parameterweitergabe, um das Akquise-Tracking aufrechtzuerhalten, ohne Datenschutzrichtlinien der Benutzer zu verletzen.
- Transparentes Daten-Routing implementieren: Rekonstruieren Sie die Benutzererfahrungs-Abläufe, um klar zu erläutern, wann und wo externe KI-Verarbeitungspfade genutzt werden.
- Latenz der API-Workflows überwachen: Verfolgen Sie Standard-Latenzmetriken von ersten Kampagnenklicks bis hin zum serverseitigen Installations-Matching, um die Datenkontinuität zu bestätigen.
Durch die Etablierung dieser strukturierten Richtlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die betriebliche Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Warum findet die strategische Zusammenarbeit, bei der NVIDIA mit d-Matrix kooperiert, statt direktem Wettbewerb statt?
Warum baut NVIDIA keine eigenen Inferenz-ASICs?
Was ist heterogene disaggregierte Inferenz und wie optimiert sie Cloud-Kosten?
Welches Problem löst d-Matrix im Vergleich zu GPUs?
Wie funktioniert serverseitige Attribution, wenn Nutzer vom Web zu mobilen Apps wechseln?
Warum benötigen mobile Apps serverseitige Attribution in datenschutzorientierten Umgebungen?
Wichtige Erkenntnisse für Engineering-Teams
Da KI-Plattformen zunehmend auf hybride Cloud-Inferenz angewiesen sind, müssen Entwickler Produkte im Hinblick auf Datenschutz, transparente Zustimmung und sicheres Daten-Routing neu gestalten. Sich entwickelnde Datenarchitekturen erfordern einen grundlegenden Wandel in der Art und Weise, wie wir digitale Erlebnisse aufbauen und messen. Da zustandslose Proxys und Headless-Scraper zu Standard-Konsumenten von Webinhalten werden, wird die Qualität traditioneller clientseitiger Attributionsmodelle weiter abnehmen. Das Verlassen auf Standard-Cookies und Referrer reicht nicht mehr aus, um die Daten-Pipelines zu sichern, die die Nutzerakquise vorantreiben.
Anstatt GPUs zu ersetzen, definiert NVIDIA neu, wie Inferenz-Workloads bereitgestellt werden. Da die KI-Bereitstellung das Modelltraining in den Schatten stellt, werden heterogene Systeme, die GPUs mit spezialisierten ASICs kombinieren, wahrscheinlich zur Standardarchitektur für Unternehmens-KI-Infrastrukturen werden. Der optimale Hardware-Mix hängt von Workload-Charakteristiken, Latenzanforderungen, Modellgröße und Infrastruktur-Ökonomie ab. Während heterogene Inferenz erhebliche Kostenvorteile bietet, werden sich Standardarchitekturen neben spezialisierten Beschleunigern weiterentwickeln. Für mobile Wachstumsteams kann die Einführung einer serverseitigen Attributionsinfrastruktur dazu beitragen, das Akquise-Wissen über zunehmend fragmentierte digitale Reisen hinweg zu bewahren. OpoInstall bietet diese Attributionsschicht, indem es den Akquise-Kontext über Web-, App-Store- und native Anwendungsumgebungen hinweg bewahrt.
Share this article



