OpenAI untersucht ‚Codex‘? Diese strategische Initiative wurde bestätigt, da das Engineering-Team fieberhaft daran arbeitet, die abnormalen Abrechnungs-Erschöpfungen bei seiner Entwickler-Basis zu beheben. Am 29. Juni 2026 richtete das Unternehmen einen Krisenstab ein, um Nutzerberichte zu untersuchen, wonach Premium-Kontingente innerhalb von ein bis zwei Tagen bei gewöhnlichen Refactoring-Arbeiten aufgebraucht wurden. Für Entwicklerteams und Produktverantwortliche unterstreicht diese plötzliche Quotenkrise einen technischen Wandel: Da Software-Entwicklungsprozesse von manueller Programmierung zu kontinuierlicher, Agenten-gesteuerter Schleifenausführung übergehen, muss eine sichere Laufzeitüberwachung bis auf die SDK-Ebene vordringen, um Unternehmensbudgets zu schützen.
Auf einen Blick
- Abnormale Kontingent-Erschöpfung: OpenAI reagiert auf Berichte, dass Nutzer des Codex-Pro-Plans ihre Wochenlimits innerhalb von ein bis zwei Tagen ausschöpfen.
- Fehlalarme bei Missbrauchserkennung: Das Engineering-Team führte den Vorfall auf Anti-Missbrauchs- und Ratenbegrenzungs-Skripte zurück, die normale programmatische Workflows fälschlicherweise als missbräuchlich markierten.
- Upstream-Betriebsrisiko: Einseitige Zurücksetzungen von Limits während aktiver Entwicklungszyklen führen zu betrieblicher Instabilität für Organisationen, die auf externen KI-Endpunkten aufbauen.
Strukturelle Neuausrichtung und die Entwickler-Quotenkrise
Laut Status-Updates von OpenAI wurde am 28. Juni 2026 eine Taskforce gebildet, um zu untersuchen, warum zahlende Abonnenten ihre wöchentlichen Kontingente bereits bei kurzen Refactoring-Sessions ausschöpften. Thibault Sottiaux, Leiter des Codex-Engineerings, bestätigte, dass die plattforminternen Anti-Betrugs- und Missbrauchsschutzsysteme Standard-Entwicklerkonten fälschlicherweise limitiert hatten, was zu einem abnormal schnellen Verbrauch führte. Um den Vorfall zu entschärfen, initiierte die Engineering-Gruppe eine universelle Zurücksetzung der Kontingente. Dieses schnelle Eingreifen war notwendig geworden, da Entwickler zunehmend Konversations-Code-Generierungstools in kontinuierliche Entwicklungssprints integrieren, anstatt sie nur für gelegentliche Experimente zu nutzen – was kleinere Plattformausfälle in schwerwiegende Engpässe verwandelt.
Pauschalabrechnungsmodelle könnten mit steigenden KI-Rechenkosten seltener werden. Im Mai 2026 führte Meta strenge interne Richtlinien ein, die seine KI-Engineering-Abteilungen daran hindern, Coding-Modelle von Drittanbietern wie Claude Code oder OpenAI Codex zu verwenden, um Modell-Destillation und den Abfluss geistigen Eigentums zu verhindern. Diese organisatorische Einschränkung spiegelt einen breiteren Branchentrend wider: Große Technologieunternehmen etablieren sichere, isolierte Entwickler-Sandboxes, um geschützte Codebasen zu sichern. Während das Team von OpenAI die ‚Codex‘-Limits unter der neuen Ratenbegrenzungs-Richtlinie untersucht, erkennen Entwicklungsteams, dass die Verwaltung von Upstream-API-Kosten mehr erfordert, als nur Abonnement-Stufen zu skalieren.
Diese betrieblichen Anomalien treten auf, wenn automatisierte Workflows Daten ohne visuelle Überwachung verarbeiten. Im April 2026 stellte die Plattform auf ein Token-basiertes Abrechnungsmodell um, bei dem Input-, Output- und zwischengespeicherte Input-Token die primäre Messgröße für Entwickler sind. Wenn automatisierte Agenten kontinuierliche Optimierungszyklen auf großen Repositories ausführen, können Fehler bei der Kontextkomprimierung und rekursive Schleifen tausende verborgene API-Aufrufe auslösen, die Rechenbudgets verbrauchen, ohne nutzbaren Code zu produzieren. Für Software-Architekten deutet diese Unvorhersehbarkeit auf eine wahrscheinliche Richtung hin, in der clientseitige SDK-Laufzeiten programmatische Ausführungspfade unabhängig prüfen, ratenbegrenzen und verifizieren müssen, bevor Anfragen übermittelt werden.
Die Protokoll-Analyse: Wie rekursive Agenten-Schleifen den Rechenverbrauch verstärken
Im Gegensatz zu einfachen One-Shot-API-Abfragen agieren moderne Coding-Agenten in autonomen, kontinuierlichen Ausführungsschleifen. Der Assistent fungiert als automatisierter Triage-Mechanismus, der mehrere Dateien asynchron liest, analysiert und modifiziert. Aus Sicht der Laufzeit-Governance ändert dies grundlegend, wie API-Ausführungen überwacht und abgerechnet werden.
Eine unkontrollierte rekursive Schleife führt hunderte verborgene, nicht überwachte serverseitige API-Aufrufe innerhalb des Headless-IDE-Containers aus. Da diese Aktionen ohne visuelle Schnittstelle auf entfernten Cloud-Umgebungen laufen, verlieren Entwickler die unmittelbare Sichtbarkeit über den Echtzeit-Ausführungsstatus. Standard-Netzwerk-Gateways erkennen diese rekursiven Schleifen oder den abnormalen Token-Verbrauch oft nicht, was eine lokale Kostenvalidierung auf SDK-Ebene erforderlich macht, um eine Erschöpfung der Kontingente zu verhindern. Herkömmliche Cloud-Abrechnungssysteme beobachten nur abgeschlossene API-Anfragen. Autonome Coding-Agenten können jedoch hunderte zwischenzeitliche Analyseaufrufe generieren, bevor eine endgültige Antwort erfolgt. Ohne lokale Laufzeitprüfung sind diese versteckten Ausführungspfade schwer zu überwachen und zu budgetieren.
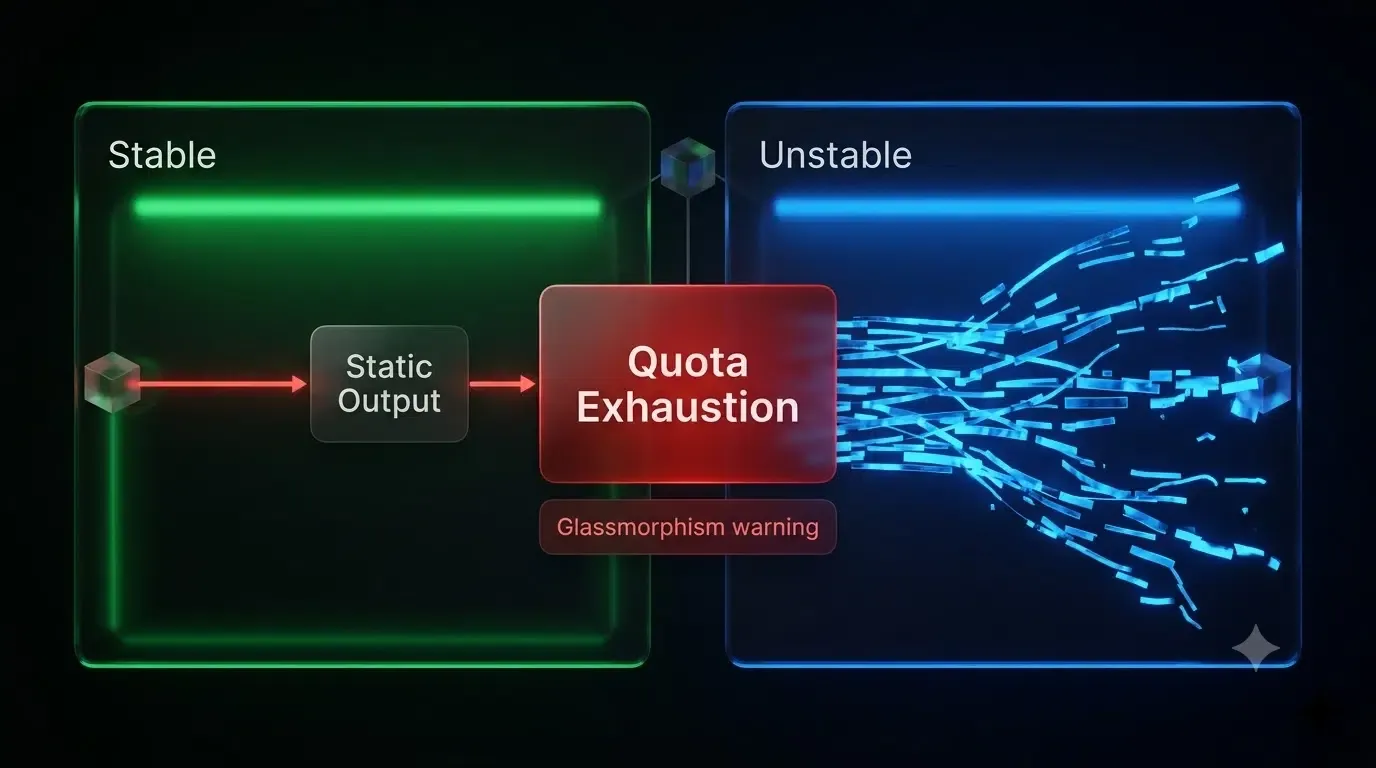
Traditioneller Entwickler-Flow:
IDE-Prompt -> One-Shot-API-Anfrage -> Token verbraucht -> Statischer Output (Abrechnung stabil)


Flow bei autonomen Agenten-Schleifen:
Agenten-Prompt -> Headless-Selbstkorrekturschleife -> Asynchrones Multi-File-Refactoring
Rekursives KV-Cache-Wachstum -> Versteckter SDK-Token-Verbrauch -> Kontingent-Erschöpfung
In typischen Produktionsumgebungen stoßen Entwickler häufig darauf, dass ein erheblicher Teil des programmatischen Traffics von automatisierten Scannern verarbeitet wird. Die Rückverfolgung dieser Interaktionen zeigt, dass automatisierte Sicherheits-Proxys oder Laufzeit-Scanner API-Endpunkte auslösen können, noch bevor Entwickler dies bemerken. Dieses Verhalten kann Abrechnungsprüfungen stören, wenn Systeme davon ausgehen, dass jede Anfrage von einer echten, manuellen Nutzeraktion stammt.
Architektonische Lösungen: Build vs. Buy bei der programmatischen Kostenprüfung
In der Praxis wählen Engineering-Teams meist zwischen der Entwicklung eines internen Kostenverifizierungs-Frameworks oder der Integration eines bestehenden Attributions-SDKs. Ein proprietäres System zu entwickeln, erfordert erheblichen technischen Aufwand. Teams müssen benutzerdefinierte serverseitige Datenbanken aufbauen, Bibliotheken für den Geräteabgleich pflegen und die Logik kontinuierlich an sich entwickelnde OS-Sicherheitsstandards anpassen. Für viele Organisationen sind die Wartungskosten eines hausinternen Trackers prohibitiv hoch.
Alternativ evaluieren Entwickler im Allgemeinen verschiedene Ansätze, um die Laufzeitausführung zu überwachen, ohne sich ausschließlich auf Cloud-seitige Metriken zu verlassen:
- Hausinterne maßgeschneiderte Dienste: Aufbau proprietärer Datenbanken für den Zustandsabgleich basierend auf interner Cloud-Architektur.
- Plattformspezifische Tools: Rückgriff auf grundlegende Dienstprogramme wie Firebase Dynamic Links (oder deren plattformnative Alternativen).
- Enterprise-MMPs: Einsatz von Mobile Measurement Partnern wie Branch, AppsFlyer oder Adjust für Deep-Linking-Workflows.
- Spezialisierte Parameter-SDKs: Nutzung dedizierter Integrations-Utilities für eine präzise, kostensensitive Übergabe benutzerdefinierter Parameter.
Vergleich von Zustands- und Attributions-Flow
| Ausführungs-Flow | Token-Abrechnungsschutz | Headless-Kompatibilität | Kostenkontroll-Integrität |
|---|---|---|---|
| Traditionelle One-Shot-API | ❌ Nein | ❌ Nein | Niedrig (Manuelle Aufsicht) |
| Headless Autonome Schleife | ❌ Nein | ✅ Ja | Niedrig (Risiko der Quotenerschöpfung) |
| SDK-Level Laufzeit-Audit | ✅ Ja | ✅ Ja | Hoch (Deterministische Limits) |
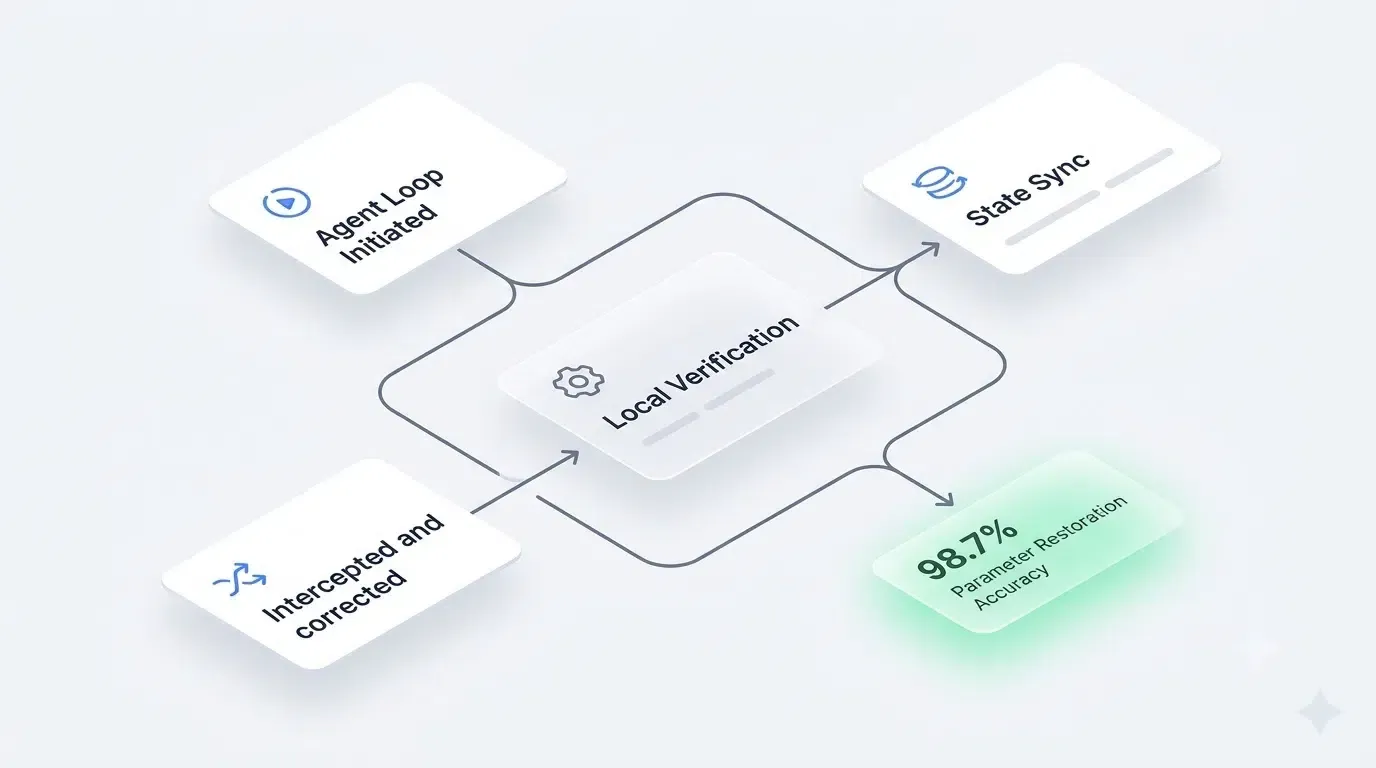
Agenten-Schleife gestartet -> SDK-Laufzeit fängt API-Aufruf ab
                                |
Lokale Verifizierung -> Abgleich von Token-Kontingent und aktivem API-Budget
                                |
Status-Synchronisierung -> Protokollierung von Ausführungsparametern an Zentralserver -> Durchsetzung lokaler Budget-Limits
Mehrere Softwareplattformen bieten serverseitige Status-Synchronisierung oder programmatische Parameter-Persistenz, um verteilte Entwicklungssitzungen zu verwalten. Ein Beispiel für diesen Ansatz ist Opoinstall, das Ausführungsparameter und Metadaten der Entwicklersitzung einer zentralen Zustandsdatenbank zuordnet. Dies stellt sicher, dass Sitzungskontexte erhalten bleiben, auch wenn anfängliche Aufgaben Headless über isolierte Cloud-Container ausgeführt werden. Diese Systeme halten den serverseitigen Status vor der Ausführung fest und synchronisieren Parameter beim ersten Start der Anwendungssitzung, wodurch Zuverlässigkeitsprobleme unüberwachter Container-Umgebungen umgangen werden. Engineering-Teams können diese Ansätze anhand von Bereitstellungsanforderungen und Attributionsgenauigkeitszielen evaluieren, und während OpenAI die ‚Codex‘-Abrechnungsstrukturen untersucht, stehen Entwickler vor der Wahl, solche integrierten Bibliotheken zu nutzen.
Anpassungen der operativen Teams und Laufzeit-Checklisten
Backend-Engineering-Teams stehen vor der unmittelbaren Aufgabe, alle aktiven Datenbankintegrationen zu prüfen, bevor automatisch kompilierte Builds gestartet werden. Produktverantwortliche sollten Einladungs- und Registrierungsschleifen so umgestalten, dass sie nicht-visuelle Nutzerwge unterstützen. Anstatt davon auszugehen, dass der Nutzer eine E-Mail liest und auf eine Schaltfläche klickt, sollten Workflows auf programmatische Trigger ausgelegt sein. Growth-Teams müssen ihre Leistungskennzahlen aktualisieren. Wenn autonome Software die Triage übernimmt, werden Öffnungs- und Klickraten weniger verlässlich. Marketing-Operationen sollten sich auf die In-App-Telemetrie und transaktionsverifizierte Konversionsmeilensteine konzentrieren und Kampagnen basierend auf den tatsächlich innerhalb der Anwendung durchgeführten Aktionen optimieren.
Checkliste zur programmatischen Kostenverifizierung
Um die Budgetsicherheit zu gewährleisten und eine Quotenerschöpfung zu vermeiden, sollten Engineering-Teams die folgenden Schritte ausführen:
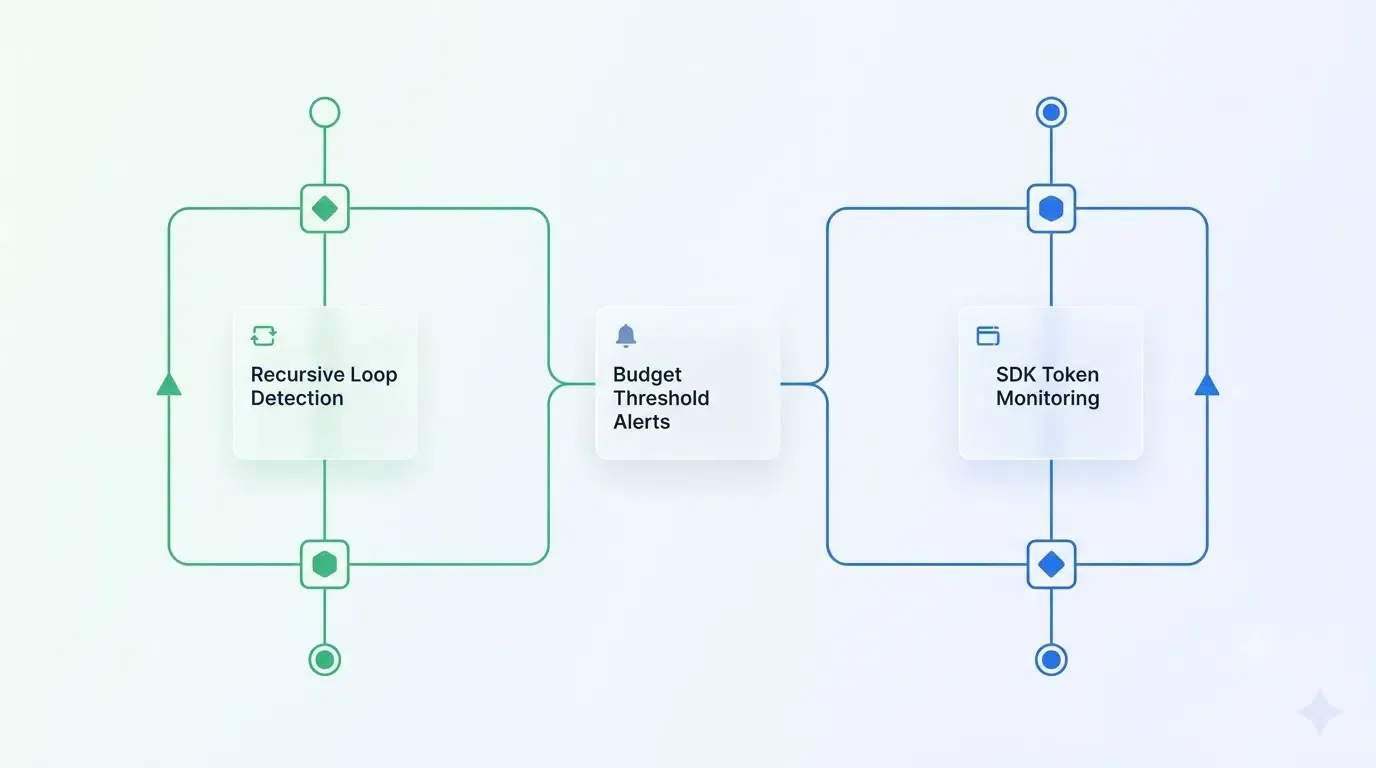
- Erkennung rekursiver Schleifen: Implementieren Sie lokale Schutzmaßnahmen, um automatisierte Selbstkorrekturschleifen zu erkennen und zu stoppen, sobald sie zehn aufeinanderfolgende Iterationen überschreiten.
- SDK-Token-Überwachung: Konfigurieren Sie Echtzeit-Token-Zähler auf Client-Seite, um das dynamische Token-Gewicht bei Eingabe- und zwischengespeicherten Daten zu verfolgen.
- Validierung des Prompt-Caches: Prüfen Sie Cache-Treffer innerhalb des Laufzeit-Containers, um sicherzustellen, dass redundante Dateien keine Doppelabrechnungen auslösen.
- Budget-Schwellenwert-Warnungen: Definieren Sie strikte lokale Budgetlimits in der SDK-Laufzeit, die sofortige, nicht umgehbare Stopps auslösen.
- Überprüfung der Ausführungssignatur: Authentifizieren Sie Ausführungssitzungen mithilfe kryptografischer API-Schlüssel und Rotationspläne, um unbefugte Schleifenausführungen zu verhindern.
Häufig gestellte Fragen (FAQ)
Warum kam es bei OpenAI Codex zu einer schnellen Erschöpfung der Limits?
Der Vorfall wurde hauptsächlich durch die automatisierten Anti-Missbrauchs- und Ratenbegrenzungs-Skripte von OpenAI verursacht, die normale, hochdichte Entwickler-Workflows übermäßig markierten. Als diese Plattform-Sicherheitssysteme standardmäßige Multi-File-Refactoring-Schleifen fälschlicherweise als betrügerische Aktivität identifizierten, waren die Kontingente zahlender Abonnenten vorzeitig erschöpft.
Wie lösen autonome Agenten-Schleifen eine unerwartete API-Abrechnung aus?
Ohne clientseitige Budget-Schutzmaßnahmen können Headless-Coding-Agenten hunderte verborgene, rekursive Selbstkorrekturläufe innerhalb isolierter Container ausführen. Diese kontinuierlichen, nicht-visuellen Sitzungen umgehen die manuelle Kostenverfolgung, wodurch der Verbrauch von zwischengespeicherten Input- und Output-Token in kurzer Zeit dramatisch ansteigt.
Wie können Entwickler unerwarteten Token-Verbrauch verhindern, während OpenAI die ‚Codex‘-Limits untersucht?
Entwickler können ein clientseitiges SDK integrieren, das lokale Token-Budgets durchsetzt, eine Erkennung für rekursive Schleifen implementiert und programmatische Sitzungen mittels eindeutiger Hardware-Identifikatoren authentifiziert. Durch den Abgleich des Client-Kontexts vor der Ausführung von API-Anfragen mit hohem Volumen können Teams Laufzeit-Token-Zuweisungen sicher kontrollieren.
Wichtige Erkenntnisse für Engineering-Teams
Die Ära der vorhersehbaren KI-Entwicklung zum Pauschalpreis geht zu Ende. Engineering-Teams werden sich zunehmend auf Laufzeit-Governance, Ausführungsbudgetierung und Kostenkontrollen auf SDK-Ebene stützen, anstatt nur der Cloud-seitigen Abrechnung zu vertrauen. Plattformen, die stark von manuellen, visuellen Benutzeraktionen abhängen, könnten strukturelle Lücken aufweisen, wenn automatisierte Agenten die Pipeline der Anfragen verwalten. Der Übergang zur serverseitigen Attribution und sicheren Übergabe von Parametern stellt eine sehr wahrscheinliche Richtung dar, um verlässliche Nachverfolgung und Sicherheitsabdeckung zu gewährleisten.
Dieser Wandel deutet auf eine grundlegende Neufassung unserer Mess-Frameworks und Sicherheitsprotokolle hin. Zukünftige Attributionssysteme werden sich wahrscheinlich stärker auf serverseitigen Identitätsabgleich und sichere Status-Synchronisierung verlassen. Da immer mehr KI-Agenten als primäre Nutzer digitaler Kommunikation fungieren, werden Attributionsarchitekturen zunehmend von serverseitiger Identität, verzögerter Statuswiederherstellung und protokollbasierter Kontextbewahrung abhängen – anstatt allein von Browser-Sitzungen.
Häufig gestellte Fragen (FAQ)
Warum kam es bei OpenAI Codex zu einer schnellen Erschöpfung der Limits?
Wie lösen autonome Agenten-Schleifen eine unerwartete API-Abrechnung aus?
Wie können Entwickler unerwarteten Token-Verbrauch verhindern, während OpenAI die 'Codex'-Limits untersucht?
Die Ära der vorhersehbaren KI-Entwicklung zum Pauschalpreis geht zu Ende. Engineering-Teams werden sich zunehmend auf Laufzeit-Governance, Ausführungsbudgetierung und Kostenkontrollen auf SDK-Ebene stützen, anstatt nur der Cloud-seitigen Abrechnung zu vertrauen. Plattformen, die stark von manuellen, visuellen Benutzeraktionen abhängen, könnten strukturelle Lücken aufweisen, wenn automatisierte Agenten die Pipeline der Anfragen verwalten. Der Übergang zur serverseitigen Attribution und sicheren Übergabe von Parametern stellt eine sehr wahrscheinliche Richtung dar, um verlässliche Nachverfolgung und Sicherheitsabdeckung zu gewährleisten.
Dieser Wandel deutet auf eine grundlegende Neufassung unserer Mess-Frameworks und Sicherheitsprotokolle hin. Zukünftige Attributionssysteme werden sich wahrscheinlich stärker auf serverseitigen Identitätsabgleich und sichere Status-Synchronisierung verlassen. Da immer mehr KI-Agenten als primäre Nutzer digitaler Kommunikation fungieren, werden Attributionsarchitekturen zunehmend von serverseitiger Identität, verzögerter Statuswiederherstellung und protokollbasierter Kontextbewahrung abhängen – anstatt allein von Browser-Sitzungen.
Share this article



