‘Ornith-1.0’ fokussiert auf agentische Programmierung? Erste Telemetriedaten aus unseren Staging-Clustern deuten darauf hin, dass dieser Wandel bereits in vollem Gange ist. Die Einführung der selbst-scaffoldenden Modellfamilie durch DeepReinforce am 25. Juni 2026 führt neue Workflow-Muster in professionellen Entwicklungsumgebungen ein. Für Entwicklerteams verlagert sich die Herausforderung darauf, programmatische Ausführungen zu verwalten und gleichzeitig die Datenintegration zu wahren. Dieser Launch markiert einen deutlichen Übergang in der Art und Weise, wie Modelle trainiert und bereitgestellt werden.
Auf einen Blick
- Self-Scaffolding-Schleife: Im Gegensatz zu herkömmlichen Pipelines, die auf statischen, von Menschen geschriebenen Gerüsten basieren, verfeinert diese Modellfamilie ihre Ausführungsgerüste und aufgabenspezifischen Rahmenrichtlinien während des Reinforcement Learning dynamisch selbst.
- Skalierbare Bereitstellung: Das Spektrum reicht von einem kompakten 9B-Modell für ressourceneffiziente Edge-Geräte bis hin zum 397B Mixture-of-Experts (MoE) Flaggschiff-Modell.
- Einfluss auf MMP-Integration: Umgeht herkömmliche clientseitige Cookies und Browser-Weiterleitungen, was eine kryptografische Token-Übermittlung auf SDK-Ebene erforderlich macht, um Messungslücken bei Installationen zu vermeiden.
Verständnis des Ornith Self-Scaffolding-Frameworks
Die Veröffentlichung der Modellfamilie führt neue Dynamiken bei Preisen und Fähigkeiten auf der Modell-Servicing-Ebene ein – insbesondere wenn Ornith-1.0 auf agentische Programmierung setzt, um sowohl das aufgabenspezifische Gerüst als auch die finale Code-Lösung gemeinsam zu optimieren. Dieses koevolutionäre Framework ermöglicht es dem System, bessere Suchtrajektorien zu entdecken, ohne auf starre, menschlich programmierte Strukturen angewiesen zu sein. Basierend auf vortrainierten Gemma 4- und Qwen 3.5-Checkpoints umfasst das Lineup vier verschiedene Größen: 9B Dense, 31B Dense, 35B MoE und 397B MoE. Detaillierte Spezifikationen sind auf dem offiziellen Ornith Hub dokumentiert.
Modellkonfigurationen und Leistungsmetriken
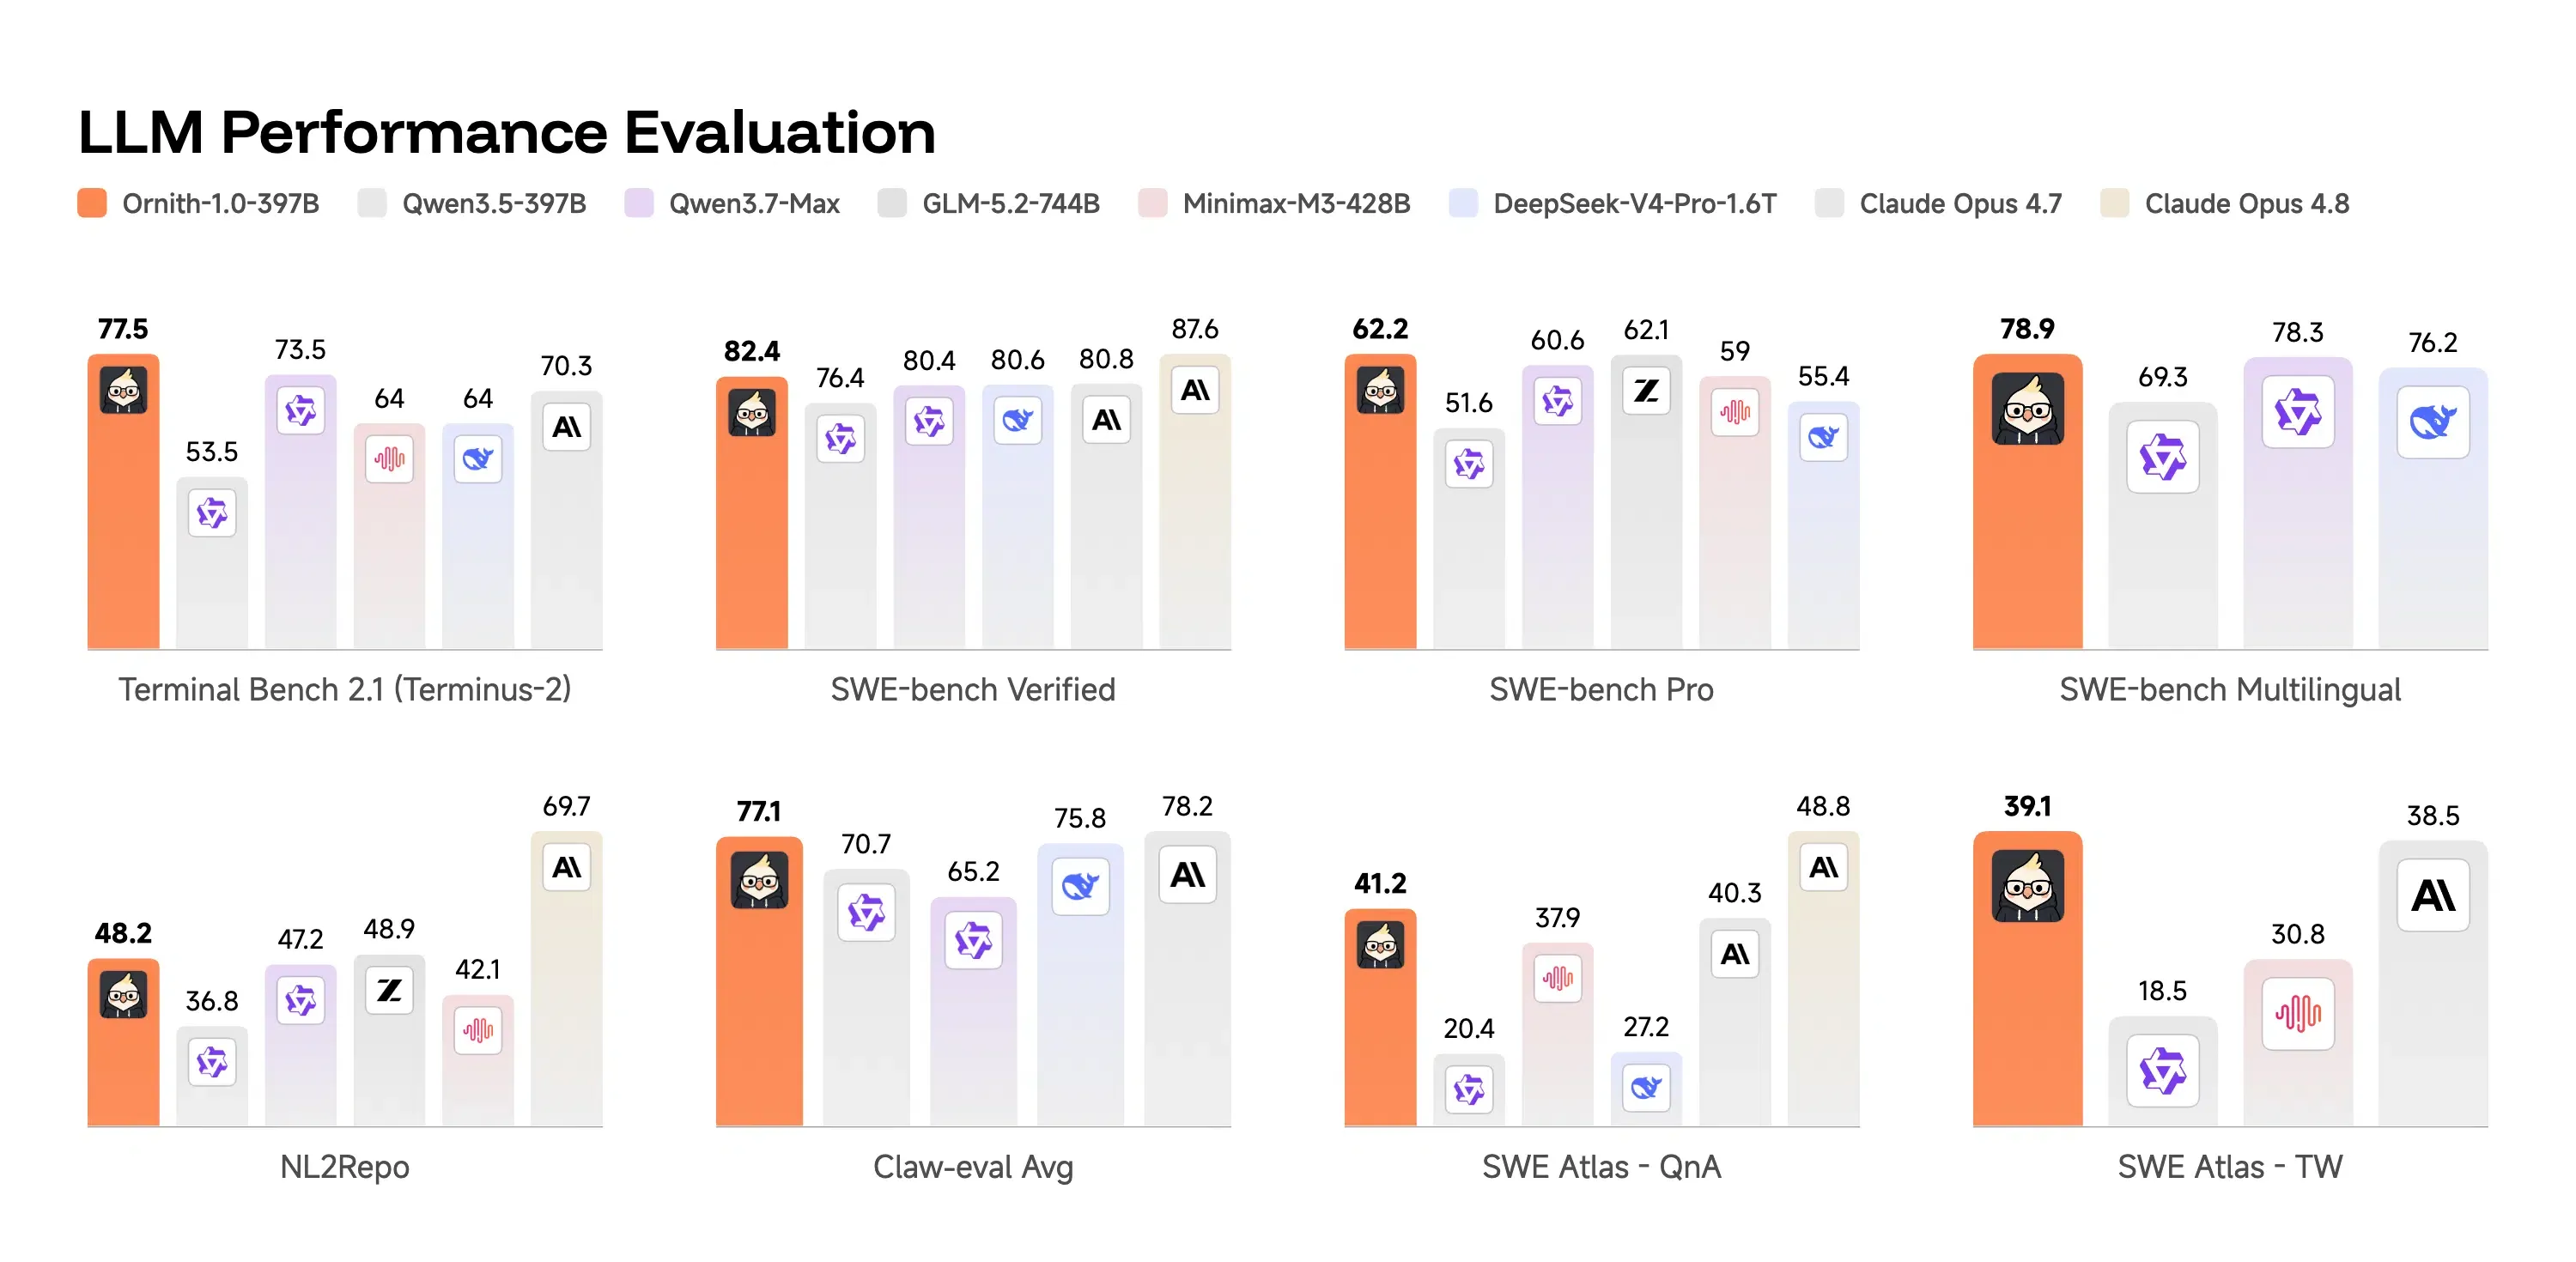
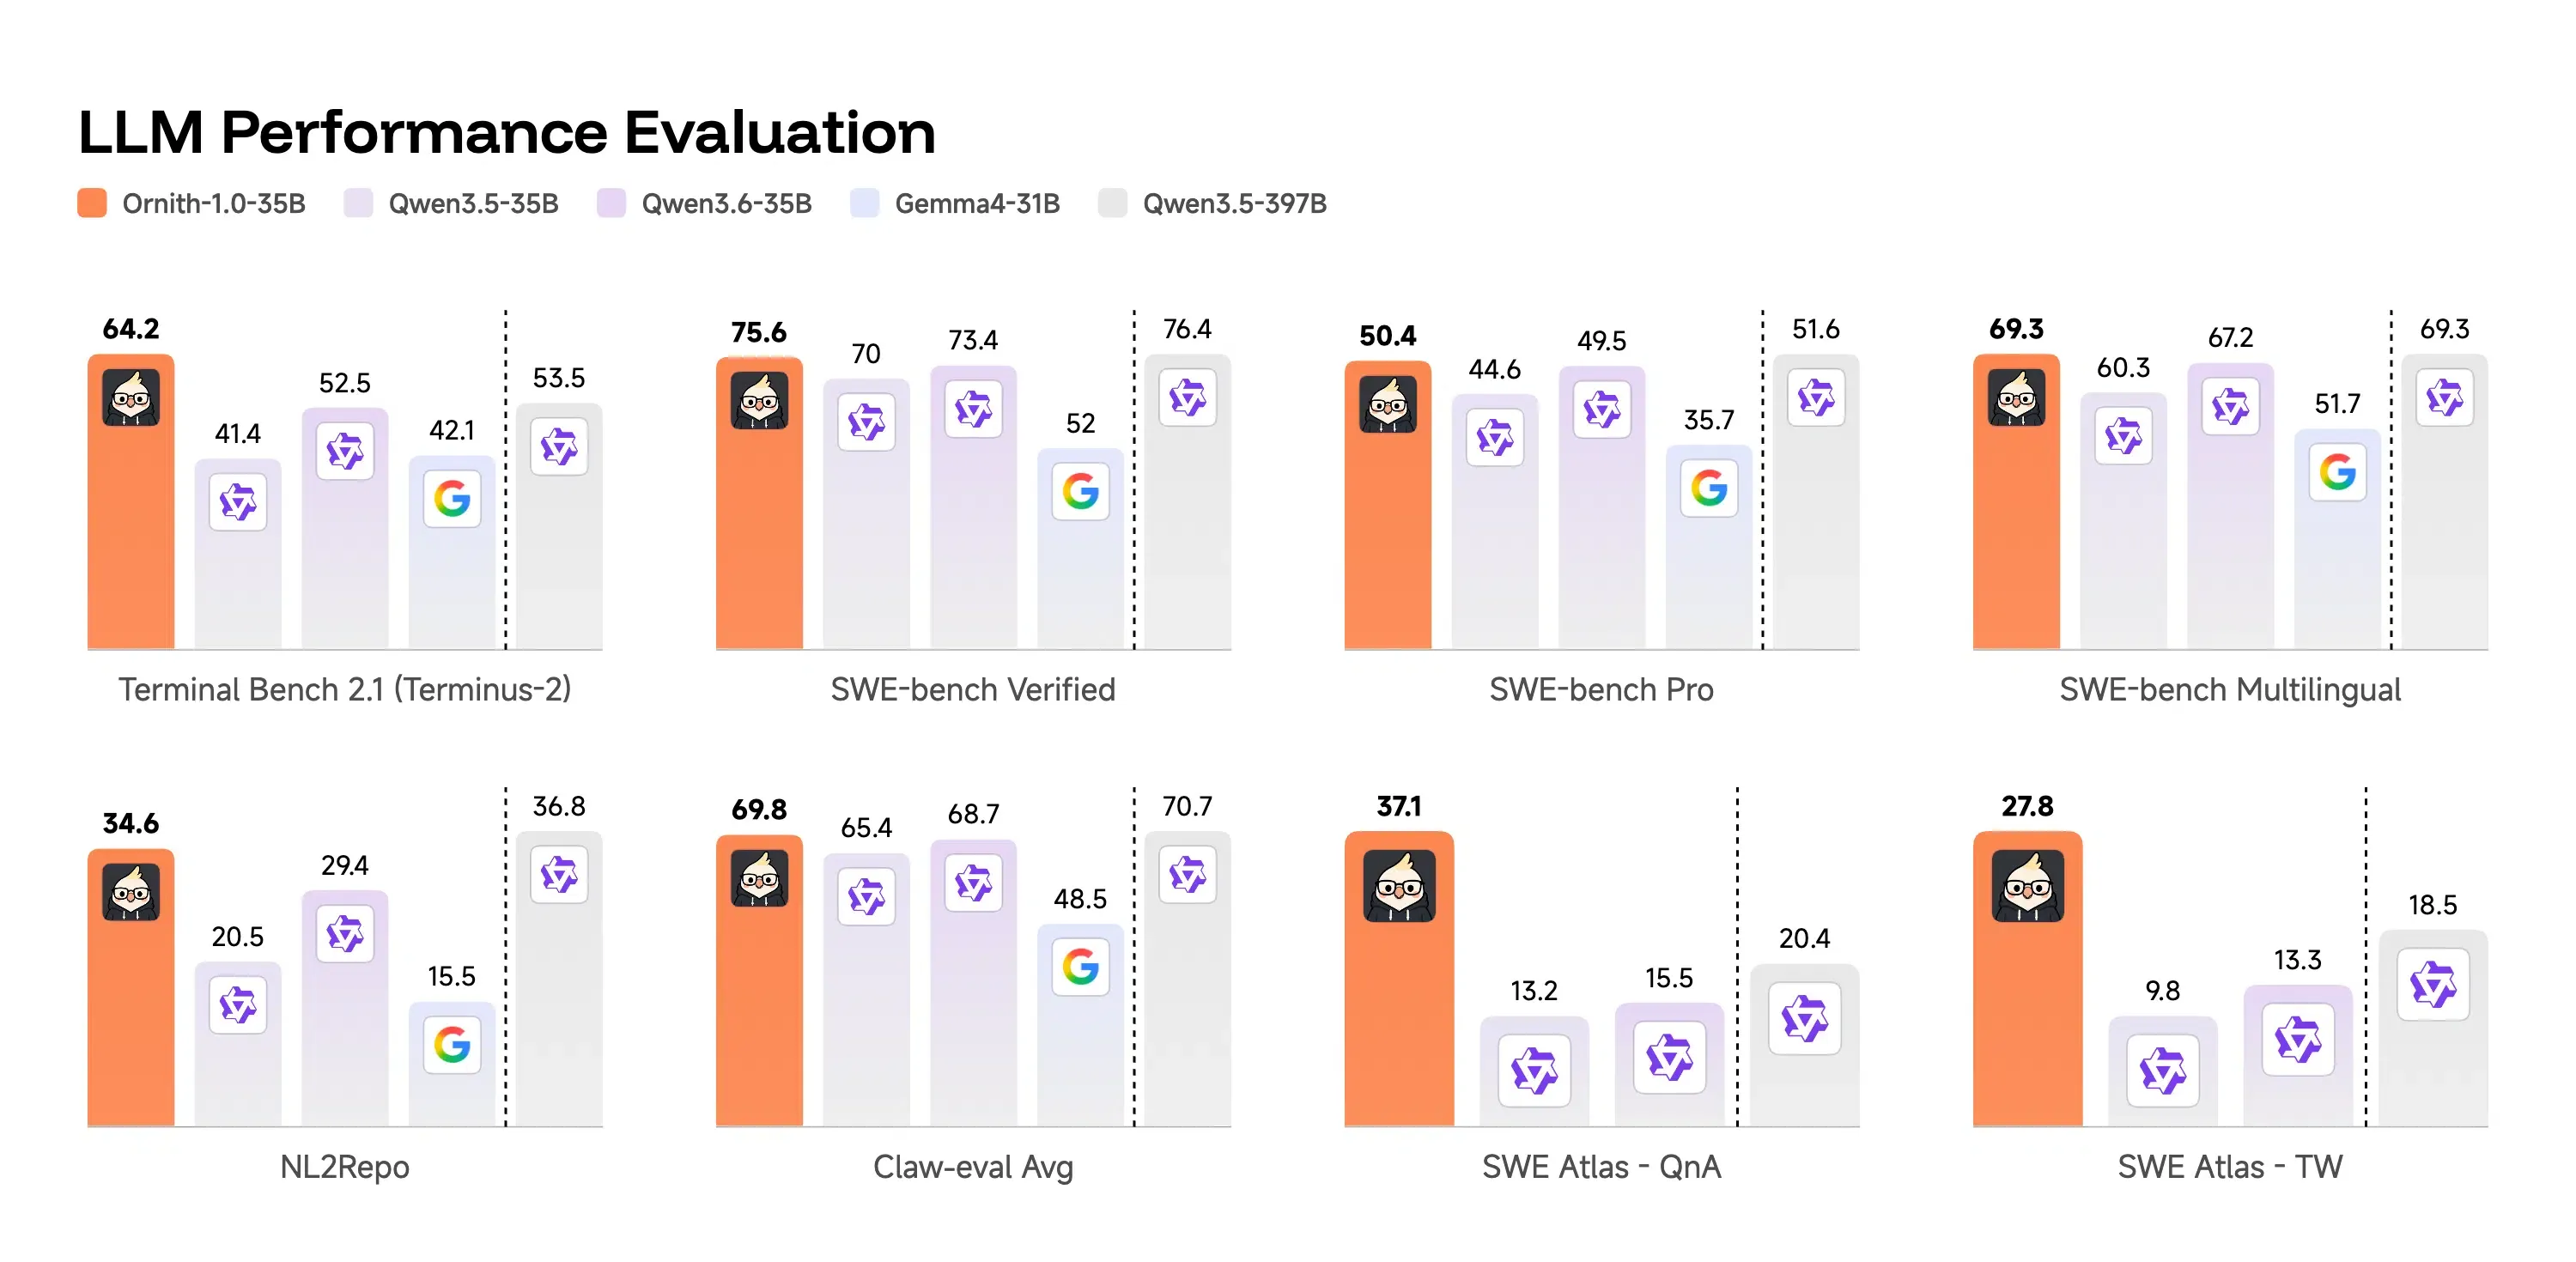
Die Evaluierungsergebnisse zeigen signifikante Leistungssteigerungen in verschiedenen agentischen Benchmarks. Auf Flaggschiff-Ebene erreicht das 397B MoE-Modell 77,5 auf Terminal-Bench 2.1 und 82,4 auf SWE-Bench Verified. Diese Leistung übertrifft Claude Opus 4.7 und lässt führende offene Modelle ähnlicher Größe hinter sich. Die Architektur reduziert beispielsweise redundante Dateizugriffe und optimiert die Speicherbewegung bei Aufgaben mit langem Kontext. Das 35B MoE-Modell aktiviert etwa 3B Parameter pro Token und bietet eine schnelle, kosteneffiziente Laufzeit. Es erreicht 64,2 auf Terminal-Bench 2.1 und übertrifft damit deutlich größere Modelle wie Qwen 3.5-397B bei gleichzeitig hoher Ausführungsstabilität.
Ressourceneffiziente Edge-Bereitstellungen
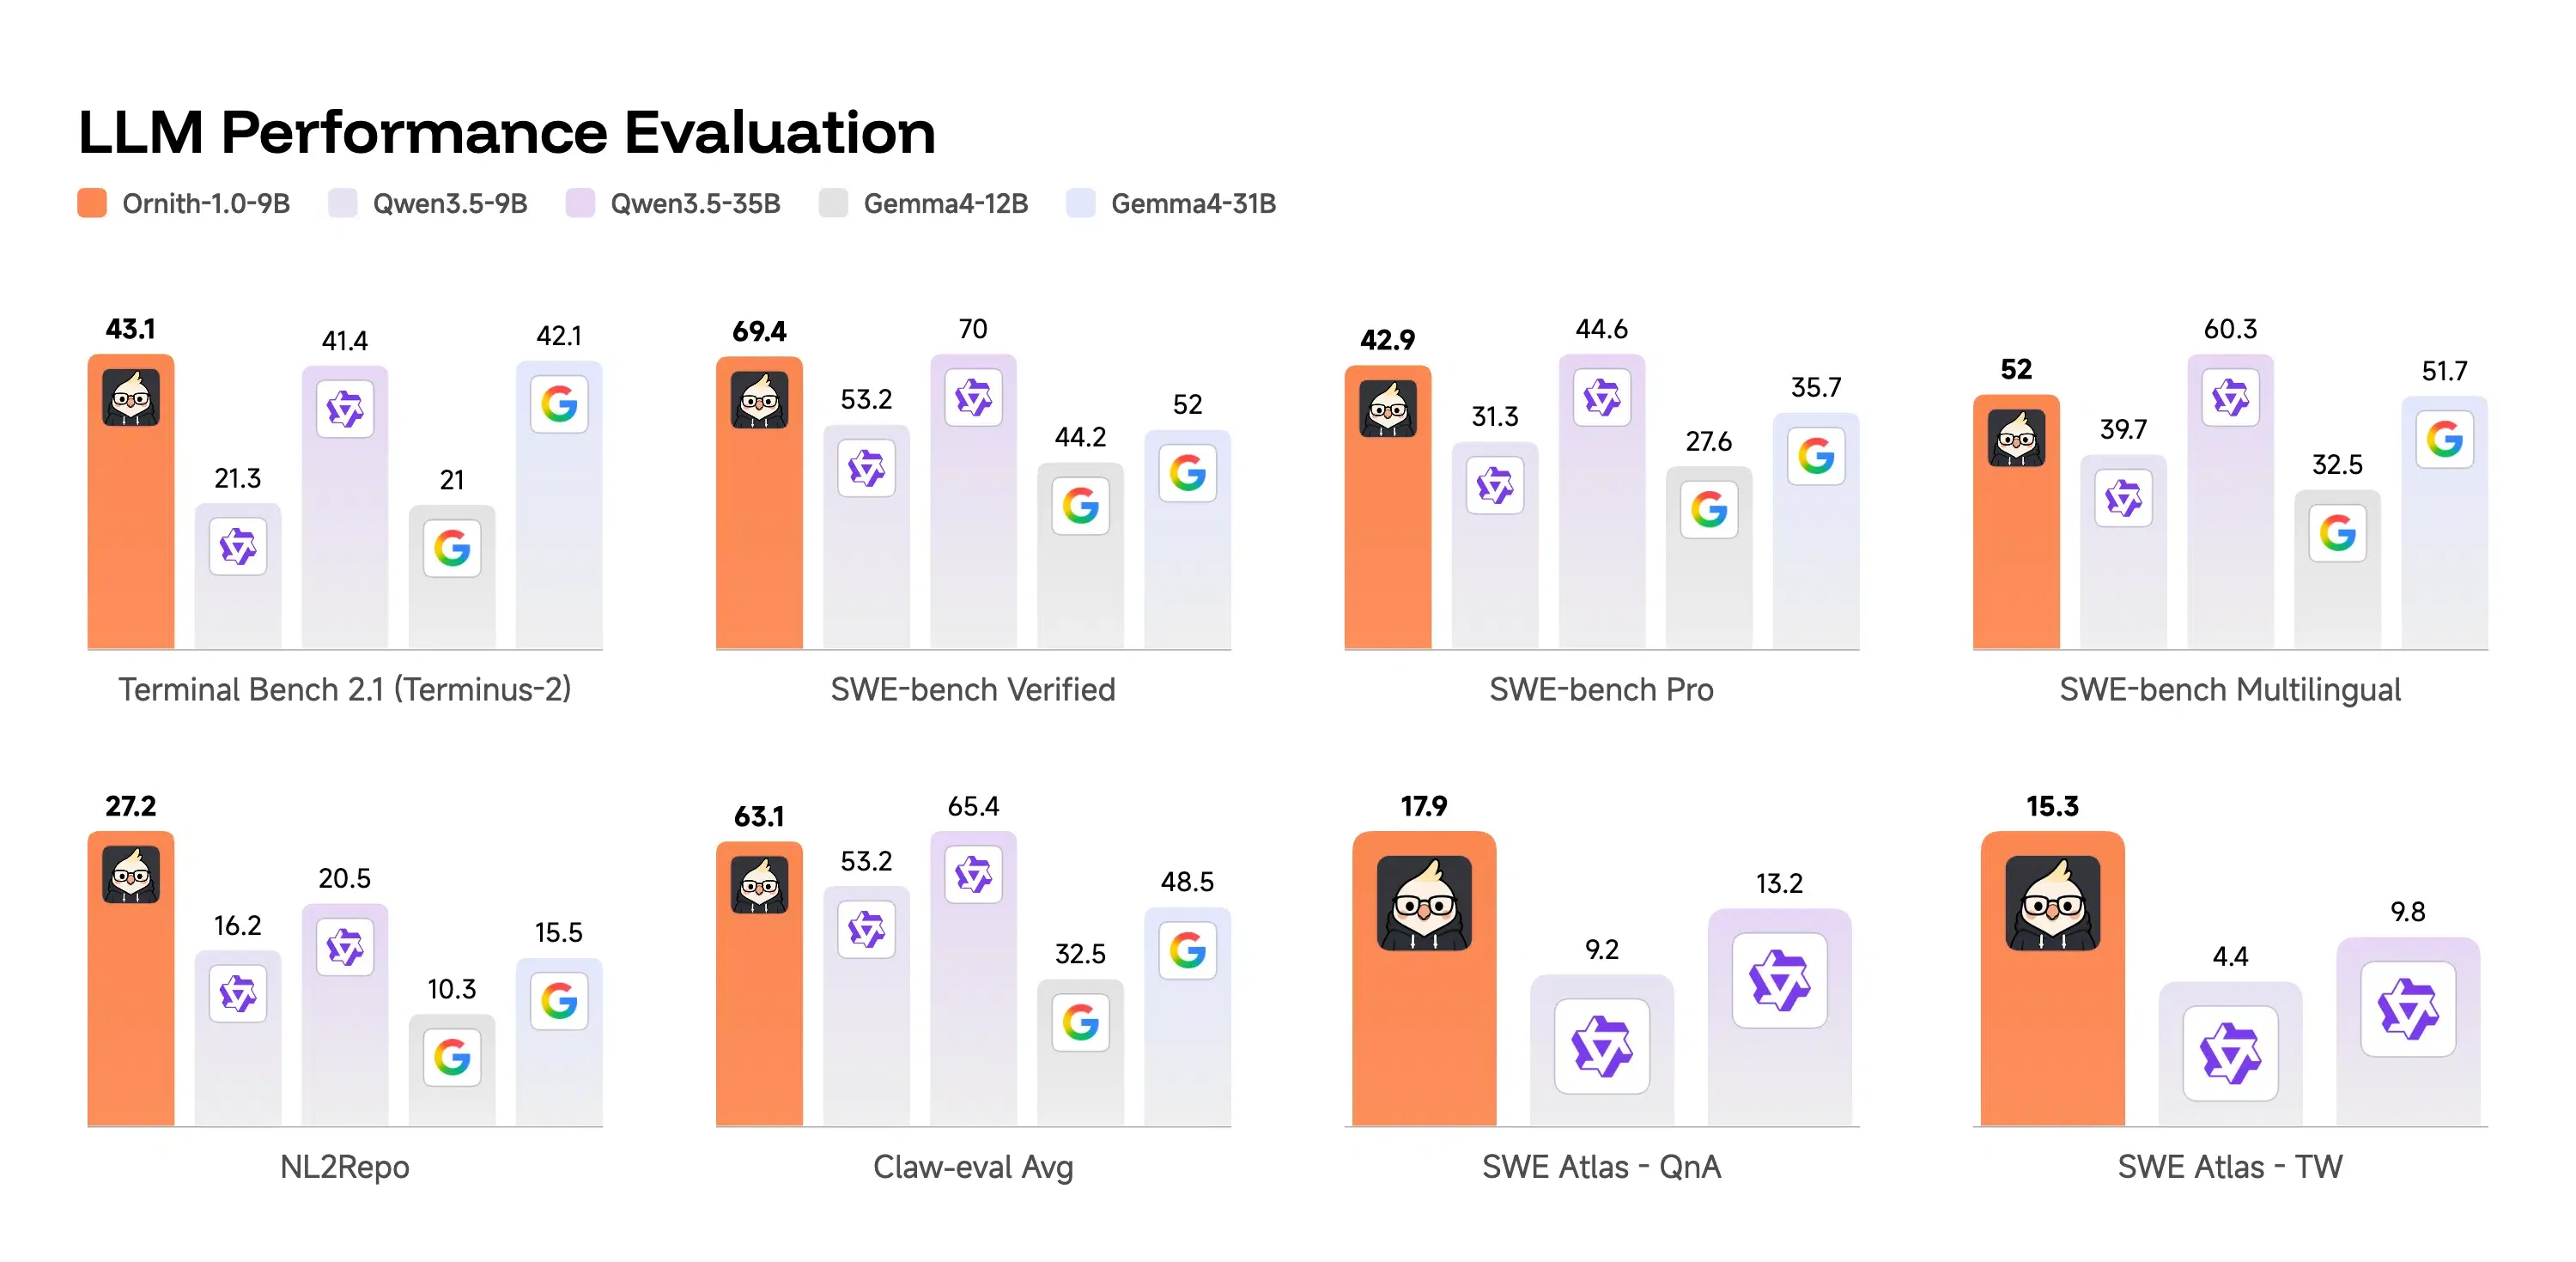
Für lokale und Edge-Hardware-Bereitstellungen bietet das 9B Dense-Modell eine äußerst effiziente Lösung. Es erreicht 43,1 auf Terminal-Bench 2.1 und 69,4 auf SWE-Bench Verified. Dieses kompakte Modell benötigt nur etwa 19 GB Speicher in bf16, sodass Entwickler es auf einer einzelnen 80GB-GPU betreiben können. Dadurch können Teams private, lokale Durchläufe ausführen, ohne sensible Codebasen außerhalb des Unternehmens zu übertragen. Das Modell ist vollständig kompatibel mit Ollama-, Unsloth- und GGUF-Quantisierungsformaten. Dies ermöglicht es Ingenieurteams, stets aktive lokale Programmieragenten auf handelsüblicher Hardware einzusetzen.
Die selbstverbessernde Trainingsschleife
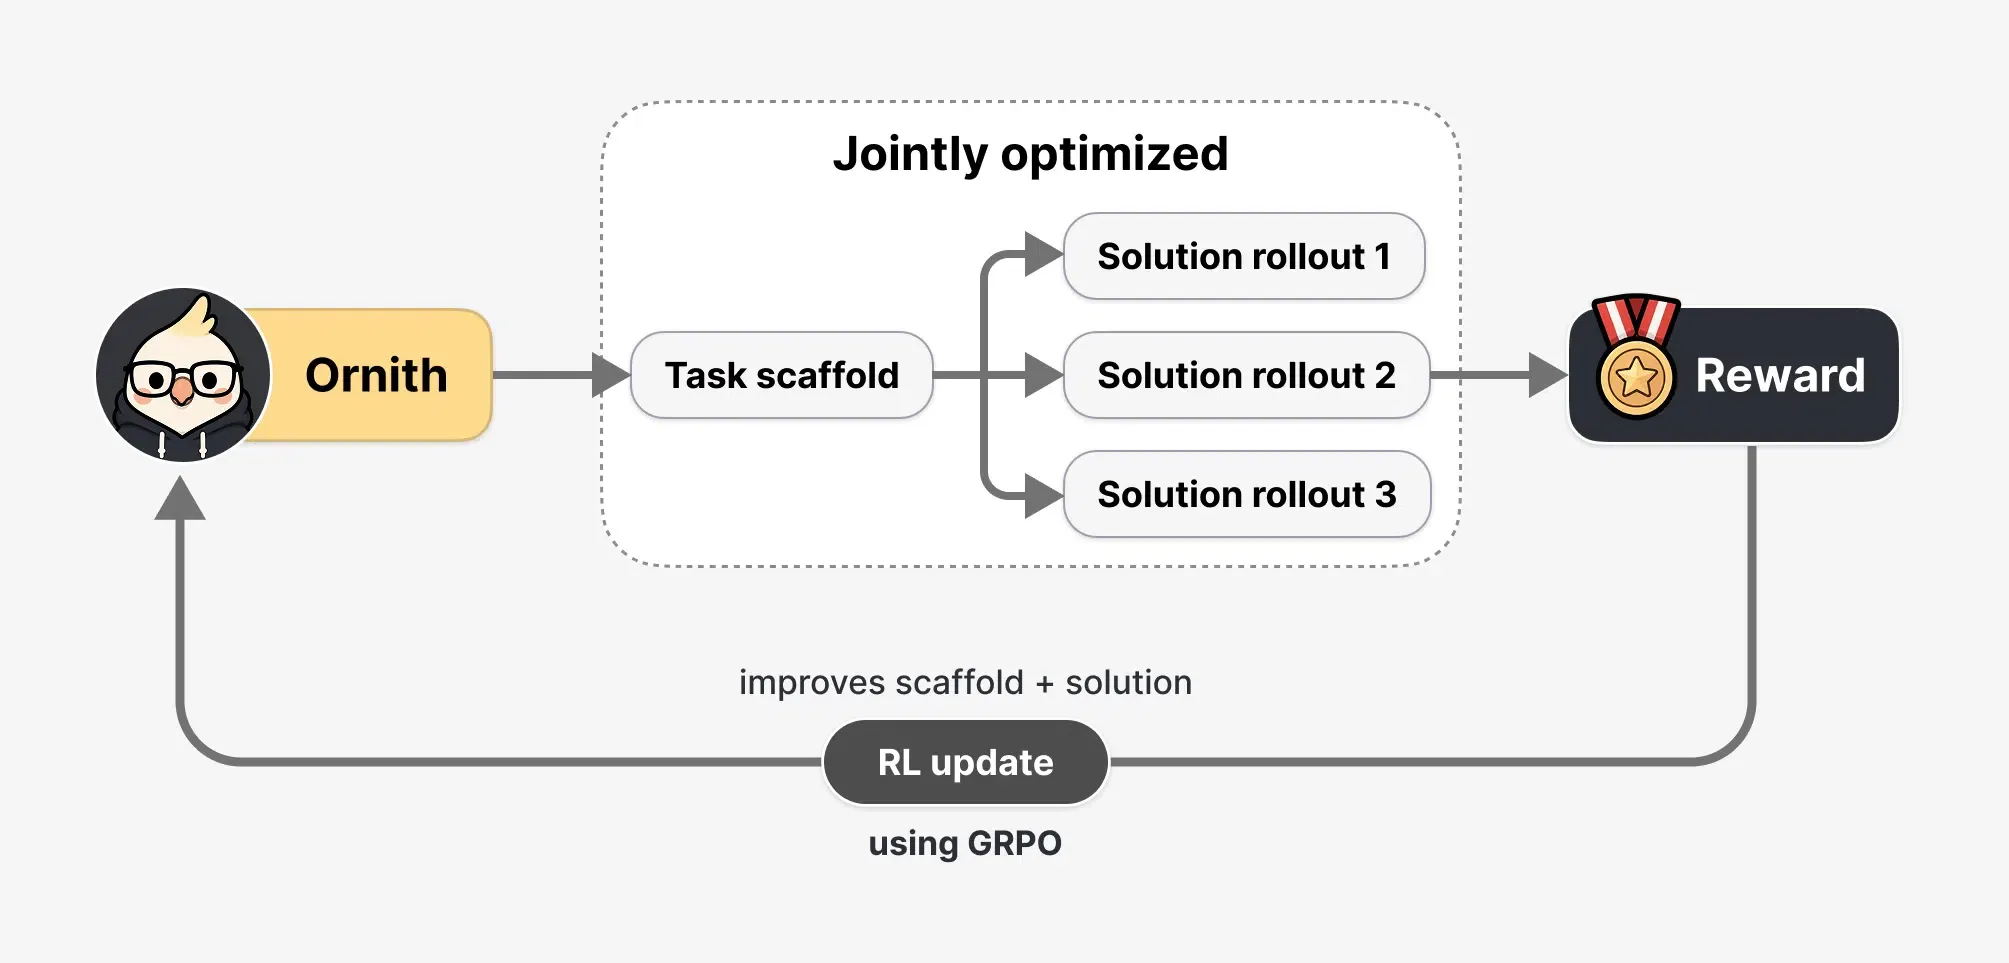
Das Herzstück der Modellfähigkeiten ist eine selbstverbessernde Trainingsschleife. Während des Reinforcement Learning behandelt das Modell das Gerüst als lernbares Objekt. Jeder Trainingsschritt verläuft in zwei Phasen: Erstens schlägt das Modell ein verfeinertes Gerüst vor; zweitens verwendet es dieses Gerüst, um einen Lösungs-Rollout zu generieren. Die Belohnung wird auf beide Phasen übertragen, wodurch das Modell optimiert wird, seine eigene Orchestrierung zu schreiben. Um "Reward Hacking" zu verhindern, implementiert DeepReinforce eine dreistufige Verteidigung: eine feste Vertrauensgrenze, einen deterministischen Monitor, der verbotene Pfadzugriffe markiert, und einen eingefrorenen LLM-Richter, der als Veto fungiert.
Warum Headless-Agenten zu blinden Flecken in der Attribution führen
Da autonome Agenten Refactorings und Reparaturen über mehrere Dateien hinweg ausführen, nimmt das Volumen der API-Hintergrundtransaktionen zu. Wenn die ‘Ornith-1.0’-Familie agentische Programmier-Workloads "headless" über Repository-weite Dateien verarbeitet, führt die Verlagerung hin zur Hintergrundausführung zu einer Krise in der Attribution. Für Entwicklerteams besteht die unmittelbare Herausforderung darin, plattformübergreifende Übergänge zu verwalten und gleichzeitig eine robuste Nutzersitzungsvalidierung aufrechtzuerhalten.
Umkehr des Vervollständigungsparadigmas: Wenn Agentenausführung Tastatureingaben übertrifft
Programmatische Agenten agieren als zustandslose, serverseitige HTTP-Clients. Sie pflegen keine persistenten Cookie-Speicher, führen keine browserseitige Speicherung durch und verwerfen bei automatisierten Hintergrundsprüngen oft die Referrer-Header vollständig. Die folgenden Beobachtungen basieren auf internen technischen Validierungen in unseren Staging-Umgebungen und sollen typische Ausführungsmuster veranschaulichen. Während einer Telemetrie-Route im April 2026 haben wir etwa 165.000 Dateimutationen auf Repository-Ebene geprüft, um zu beobachten, wie Headless-Coding-Agenten Refactoring-Aufgaben durchführten. Die Datenbank verzeichnete null browserseitige Cookie-Handshakes, was dazu führte, dass die nachfolgende Installation vollständig als direkter Traffic klassifiziert wurde. Diese zustandslose Ausführung umgeht Standard-Tracking-Parameter wie die Google Play Install Referrer API. Sie verhindert zudem browserseitige Weiterleitungen, die von iOS SKAdNetwork (SKAN) oder der Android Privacy Sandbox SDK Runtime erfasst werden. Wenn ein agentengesteuerter Workflow eine Transaktion über Hintergrund-APIs abschließt, bricht die Referrer-Kette ab. Die Installation erscheint als unbekannte direkte Quelle, was zu bemerkenswerten Diskrepanzen bei der Kampagnenmessung führt.
Bot-Schwärme und die Bedrohung durch Marketing-Betrug
Kostengünstige Hochleistungs-Token schaffen neue Herausforderungen für Sicherheitsteams. Parallel dazu bietet Alibabas aktueller Rabatt für Off-Peak-Token eine 80%ige Vergünstigung außerhalb der Hauptzeiten. Diese Preisgestaltung senkt die Betriebskosten für die Ausführung automatisierter Agenten-Skripte in der Nacht dramatisch. Während einer Sicherheitsüberprüfung von 38.000 automatisierten Repository-Commits identifizierte unser Team ein Cluster von Headless-Skripten, die etwa 8 % aller registrierten Installationen ausmachten und sich vollständig auf ein Drei-Stunden-Fenster konzentrierten. Diese Botnetze spooften programmatisch Installations-Callbacks, was beweist, dass einfache clientseitige, schwellenwertbasierte Ratenbegrenzungen unzureichend sind. Diese Anfälligkeit erfordert von Entwicklern die Implementierung robusterer Verifizierungen auf SDK-Ebene, um Marketingbudgets zu schützen.
Aufbau sicherer SDK-Integrationen für autonome Agenten
Die Sicherung agentengesteuerter Workflows erfordert einen strukturierten technischen Ansatz. Eine grundlegende Verteidigung ist die Bereitstellung einer gerätebasierten Zustandsverifizierung. Entwickler können Zustandsautomaten implementieren, die Geräte-Fingerabdrücke während einer Sitzungsanforderung validieren. Wenn ein Agent eine Aktion auslöst, prüft der Server diesen Status, um den Ausführungskontext zu verifizieren und nicht autorisierte Aufrufe zu blockieren. Die Sicherung von Backend-Ausführungskanälen in agentischen Programmierumgebungen erfordert einen strukturierten und kryptografisch verifizierten Handshake.
Entwurf sicherer Multi-Agenten-Identifikatoren
Die Isolierung der Ausführungsumgebung ist entscheidend, um Datenlecks zwischen Sitzungen zu verhindern. Entwickler können Agenten in sauberen, transienten Sandboxes ausführen, die den lokalen Zustand nach Abschluss der Aufgabe löschen. Zudem sollten kryptografische Signaturen auf alle Transitparameter angewendet werden. Durch das Signieren jedes URL-Callbacks mit privaten Schlüsseln stellen Systemingenieure sicher, dass Zwischenskripte die Nutzlast nicht verändern können, was die Integrität des Datenstroms bewahrt. Diese sichere Konfiguration bietet eine robuste Architektur zur Filterung von ungültigem Traffic, um automatisierte Spoofing-Versuche zu blockieren.
Härtung kryptografischer Signaturen in SDK-Implementierungen
Um zu vermeiden, dass interne Sprints für grundlegende Zustandsautomaten-Infrastruktur aufgewendet werden, greifen Ingenieurteams häufig auf branchenübliche Referenzimplementierungen zurück. In der Produktion können Teams das Deferred-App-Parameter-Pass-Through-Framework integrieren, um Signaturprüfungen und die Wiederherstellung des Zustands zu automatisieren, ohne komplexe Zustandsautomaten verwalten zu müssen. Diese Integration ermöglicht es der Anwendung, den ursprünglichen Empfehlungskontext während des ersten Starts von einem sicheren Server-Callback abzurufen. Durch die Weitergabe eines kryptografisch signierten Tokens durch die Installationsschleife bewahrt die Plattform den ursprünglichen Transaktionszustand und stellt einen konsistenten Datenfluss über den gesamten Akquisitionslebenszyklus sicher.
Abstimmung von Engineering und Marketing bei der Wiederherstellung des Zustands
Die Implementierung von Workflows für autonome Agentenbereitstellungen erfordert eine enge Koordination zwischen technischen und Marketing-Abteilungen. Das Engineering-Team muss sich auf die Standardisierung eindeutiger Identifikatoren und die Sicherstellung der SDK-Kompatibilität konzentrieren. Entwickler müssen außerdem Bundle-IDs über Multi-Tenant-Bereitstellungen hinweg verwalten, um Routing-Konflikte in regionalen Stores zu vermeiden. Architekten müssen zudem sichere Signaturprüfungen für iOS- und Android-Plattformen implementieren, um Deep-Link-Manipulationen zu verhindern.
Technische Überlegungen für Entwickler und Architekten
Architekten müssen sicherstellen, dass benutzerdefinierte URL-Schemata, Universal Links und App Links auf Gateway-Ebene verifiziert werden. Diese Konfiguration verhindert, dass bösartige Skripte das Intent-Routing während eines Web-to-App-Übergangs kapern. Durch die Durchsetzung der Signaturverifizierung können Teams die nachgelagerte Daten-Pipeline schützen und saubere Datensätze in ihren Systemen mithilfe einer standardisierten Universal-Linking-Architektur pflegen.
Wachstumsstrategien und Kundengewinnung unter Deflation
Wachstumsteams müssen ihre Analysen anpassen, um sich auf Kohortenanalysen und langfristige Retentionsmetriken anstatt auf Single-Click-Ereignisse zu stützen. Die Integration der deterministischen Multi-Channel-Attributions-Engine ermöglicht die Erstellung personalisierter Onboarding-Flows, die die Absicht des Benutzers wahren. Wenn eine Empfehlung erfolgt, kann das System die Conversion automatisch zuordnen, ohne dass manuelle Eingaben erforderlich sind. Dieser Ansatz verbessert die Genauigkeit der Berechnungen für den Return on Marketing Investment (ROMI) und hilft dabei, ungültigen, agentengenerierten Traffic herauszufiltern.
Häufig gestellte Fragen (FAQ)
Warum funktionieren referenzbasierte Messungen in agentischen Workflows nicht?
Wie sichern kryptografische Signaturen SDKs, wenn 'Ornith-1.0' auf agentische Programmierung fokussiert?
Warum scheitern Standard-Methoden zum Geräte-Fingerprinting bei agentischen Programmier-Workflows?
Der Launch signalisiert einen breiteren Wandel in der globalen Technologielandschaft. Insbesondere mit der Ausweitung dedizierter Inferenzprozessoren beginnt sich das traditionelle Modell des Softwarezugriffs aufzulösen. Da autonome Agenten zudem mehr administrative Aufgaben übernehmen, könnte sich die primäre Benutzeroberfläche von visuellen Dashboards hin zu direkten Backend-API-Handshakes verschieben. Diese Entwicklung könnte die Rolle traditioneller App-Stores für die Auffindbarkeit verringern. Stattdessen könnte der Markt ein Wachstum bei zweckgebundenen, bedarfsorientierten Mikro-Anwendungen sehen, die dynamisch für spezifische Aufgaben generiert werden. Dieser Wandel schafft neue Anforderungen an eine reibungslose Verteilung und eine sichere Echtzeit-Verifizierung.
Darüber hinaus werden Datenschutz-Frameworks wie SKAdNetwork und die Google Privacy Sandbox wahrscheinlich die Weitergabe von Drittanbieterdaten weiter einschränken. Dieser Trend zwingt Entwickler dazu, eine deterministische First-Party-Messung zu priorisieren. In diesem Umfeld könnten Multi-Touch-Attributionsstandards zu einer Grundvoraussetzung für moderne Systemarchitekturen werden. Unternehmen, die auf browserbasierter Attribution basieren, sollten prüfen, ob ihre aktuellen Mess-Pipelines ausreichen, während agentengesteuerte Workflows alltäglicher werden.
Share this article



