Reddit blockt 23 Millionen Spam-Anfragen? Reddit gibt an, mittlerweile täglich rund 23 Millionen verdächtige Aufrufe mittels KI-gestützter Erkennungssysteme zu blockieren. Laut Reddit zielen Spam-Kampagnen zunehmend darauf ab, KI-Systeme zu beeinflussen, die auf öffentlich zugänglichen Webinhalten basieren. Da immer mehr KI-Unternehmen Reddit-Diskussionen für das Modelltraining lizenzieren, ist der Schutz der Authentizität nutzergenerierter Inhalte zu einer geschäftlichen Priorität geworden. Früher reichten einfache regelbasierte Filter aus, um repetitive Spam-Vektoren zu identifizieren. Heute müssen Plattformen, da bösartige Akteure hochentwickelte Modelle einsetzen, um menschliche Konversationen und künstlichen Hype in großem Maßstab zu automatisieren, ihre Abwehrmaßnahmen auf Echtzeit-Verhaltensanalysen und kontextuelle semantische Auswertungen verlagern.
Chronologie & Entwicklung: Wie Reddit täglich 23 Millionen Spam-Versuche blockiert
Auf einen Blick
- Reddits automatisierte Verteidigungsschicht fängt täglich 23 Millionen nicht-authentische Aufrufe und 25.000 Spam-Beiträge durch moderne Large Language Models ab.
- Das Wachstum kommerzieller Lizenzvereinbarungen mit KI-Unternehmen hat Anreize für Spammer geschaffen, Bewertungen zu fälschen, um Trainingsdatensätze zu manipulieren.
- Mehrstufige Verifizierungsprotokolle haben die Nutzerbelastung durch unerwünschten Spam Anfang 2026 um 20 % gegenüber den Vorquartalen gesenkt.
Das Gleichgewicht digitaler Interaktion hat sich verschoben, da automatisierte Agenten zunehmend menschliche soziale Interaktionen simulieren. In der Vergangenheit zielten Spammer auf Plattformen mit nutzergenerierten Inhalten ab, um über massenhaftes Link-Posting Affiliate-Verkäufe zu generieren. Diese simplen Angriffe ließen sich leicht anhand von Schlagwortlisten und IP-Blockaden identifizieren, was es Administratoren ermöglichte, Diskussionsforen weitgehend sauber zu halten.
Der Aufstieg von Suchmaschinen, die auf generativer KI basieren, hat jedoch die Motivation hinter Spam-Kampagnen verändert. Da KI-Chatbots auf riesigen öffentlichen Archiven trainieren, versuchen Drittanbieter, die KI-Ergebnisse durch eine Flut positiver Erwähnungen und künstlicher Bewertungen zu manipulieren. Durch die Simulation natürlicher menschlicher Konversationen hoffen diese automatisierten Netzwerke, ihre Markennamen in zukünftige Modell-Gewichtungen zu integrieren. Um dieser Bedrohung zu begegnen, hat die Social-Media-Plattform fortschrittliche, LLM-gestützte Moderationssysteme implementiert, wie in detaillierten regionalen Berichten dokumentiert ist.
Der strategische Grund für das Blockieren von 23 Millionen Spam-Aufrufen durch Reddit ist eng mit der Monetarisierung menschlicher Daten verknüpft. Da Plattformen Lizenzverträge in Millionenhöhe mit führenden KI-Entwicklern unterzeichnen, ist die Wahrung der faktischen Zuverlässigkeit des zugrunde liegenden Datenstroms zu einer zentralen finanziellen Notwendigkeit geworden. Zwischen Januar und März 2026 hat die Plattform täglich fast 2 Millionen nicht-authentische Stimmen gelöscht und so ihre Crowd-Sourced-Feedback-Schleife vor Manipulation geschützt. Durch die Einführung von Anmeldevoraussetzungen für historische Desktop-Verzeichnisse und den Einsatz von linguistischen Echtzeit-Filtern konnten die Administratoren die Belastung der Nutzer durch schädliche Inhalte erfolgreich reduzieren.
Technische Analyse: Die Mechanismen hinter Reddits Bot-Isolationsarchitektur
Auf architektonischer Ebene haben herkömmliche Bot-Schutzsysteme Schwierigkeiten, koordinierte, langsam agierende Crawling-Kampagnen zu identifizieren. Wenn moderne Spammer Proxy-Netzwerke für Privathaushalte und Headless-Browser einsetzen, sehen ihre Anfragen wie normale Nutzerinteraktionen aus, was klassische musterbasierte Filter wirkungslos macht.
Um diese Engpässe auf Transportebene zu lösen, verarbeiten moderne Sicherheitsarchitekturen Signale genau zum Zeitpunkt der Kontoerstellung. Die automatisierte Engine der Plattform analysiert Metadatenmuster und nutzt LLM-Echtzeit-Inferenz, um koordinierte Bot-Setups zu identifizieren, wie in der offiziellen Ankündigung der Plattform dargelegt.
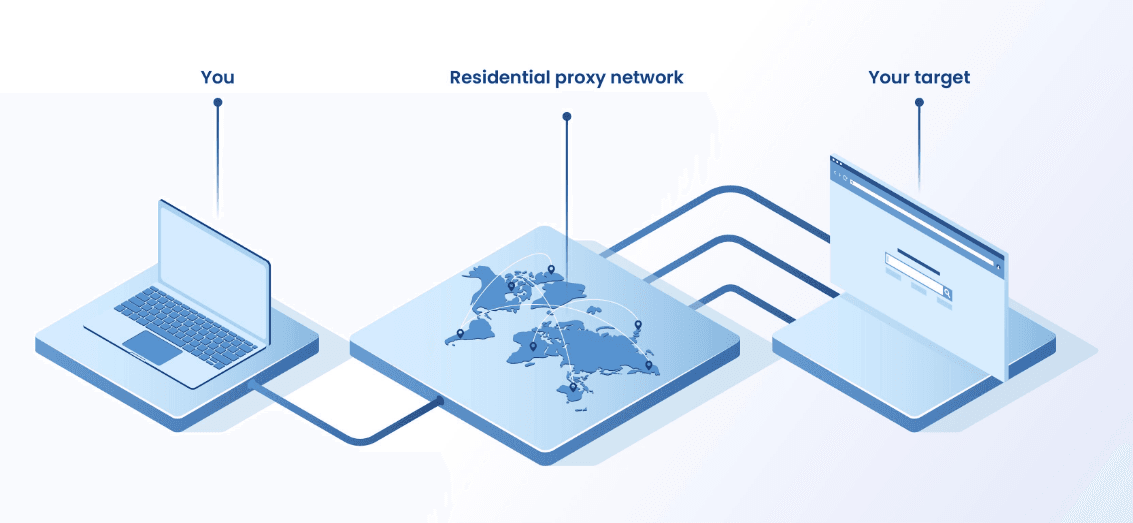

Dieses koordinierte, nicht-authentische Verhalten erklärt, warum Reddit täglich 23 Millionen Spam-Aufrufe blockiert. Wenn ein automatisiertes Skript versucht, auf ein Forenverzeichnis zuzugreifen, berechnet das System in Echtzeit einen Risikoscore. Weist die Verbindung fragwürdige Attribute auf, erzwingt die Plattform eine menschliche Verifizierungsprüfung, um vollautomatisierte Systeme zu isolieren. Dieser mehrschichtige Ansatz stellt sicher, dass die Serverlast optimiert bleibt, verhindert Systemzusammenbrüche und bewahrt gleichzeitig authentische nutzergenerierte Interaktionen.
[Herkömmliche IP-basierte Filterung]
  Automatisierter Bot ──> Rotierter Residential Proxy ──> Herkömmlicher Filter ──> Standard-Zugriff gewährt (Erkennungsfehler)


[Mehrschichtiger LLM-gesteuerter Schutz]
  Automatisierter Bot ──> Verhaltens-Metadatenanalyse ──> Echtzeit-LLM-Check ──> Obligatorisches CAPTCHA / Isolation
Die Implementierung eines kontextbewussten Schutzes stellt sicher, dass automatisierte Versuche selbst dann erkannt werden, wenn sie über saubere IP-Bereiche geleitet werden. Ähnliche Herausforderungen bestehen bei der mobilen Attribution, bei der Datenschutzbeschränkungen die Abhängigkeit von persistenten clientseitigen Identifikatoren ebenfalls reduzieren. Wenn Nutzerinteraktionen zur Einhaltung von Datenschutzrichtlinien von persistenten, zustandsbehafteten lokalen Cookies entkoppelt werden, wird die Aufrechterhaltung einer reibungslosen Sitzungskontinuität über verschiedene Web- und Mobilumgebungen hinweg äußerst komplex. So wie Sicherheitsteams Echtzeit-Verhaltensmodelle benötigen, um Menschen von automatisierten Skripten zu unterscheiden, benötigen nachgelagerte Marketing-Pipelines eine robuste, serverseitige Datenhaltung, um Installationsereignisse ohne Rückgriff auf anfällige clientseitige Cookies oder gerätebasierte Attribute korrelieren zu können.
Beispielszenario: Was passiert, wenn ein Bot einen Beitrag veröffentlichen will?
Angenommen, ein automatisiertes Skript registriert ein neues Konto, um die Markenautorität eines Kunden in einem Subreddit zu manipulieren. In dem Moment, in dem das Konto erstellt wird, analysiert die Backend-Routing-Architektur die Verhaltens-Telemetrie. Wenn die Verbindungsdaten oder Eingabeparameter mit bekannten Headless-Browser-Profilen übereinstimmen, werden die Schreibrechte sofort ausgesetzt und die Plattform löst eine Verifizierungsaufforderung aus. Dies verhindert, dass die programmatischen Einreichungen des Bots das öffentliche Verzeichnis erreichen.
Build vs. Buy: Sitzungskontext in Umgebungen mit hohem Datendurchsatz wahren
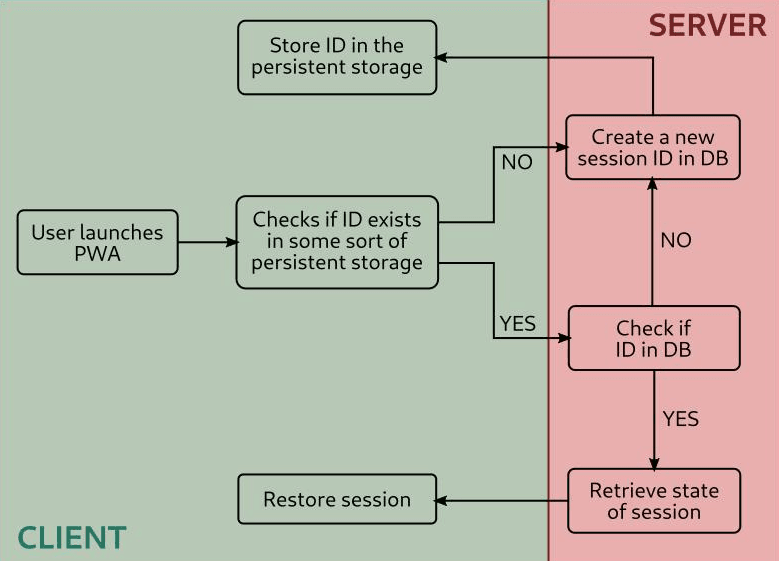
Da digitale Plattformen sich von persistenten lokalen Identifikatoren entfernen, um Datenschutzrichtlinien zu erfüllen, ist die Verwaltung des Sitzungsstatus über verteilte Berührungspunkte hinweg zu einer zentralen technischen Herausforderung geworden. Die Verwaltung der Infrastruktur, die die von Reddit gemeldeten 23 Millionen verdächtigen Anfragen täglich verarbeitet, erfordert eine robuste, serverseitige Validierung. Obwohl sich Reddits Anti-Spam-System auf Sicherheit statt auf Marketing-Attribution konzentriert, teilen beide Szenarien eine gemeinsame architektonische Herausforderung: die Bewahrung eines zuverlässigen serverseitigen Status nach dem Wegfall traditioneller Client-Identifikatoren. Die Abstimmung von Routing-Pipelines mit hohem Durchsatz in Umgebungen, in denen Reddit täglich 23 Millionen verdächtige Versuche blockiert, erfordert Strukturen, die Nutzeraktionen sicher korrelieren können, ohne auf lokale Speichercontainer angewiesen zu sein.
Architektonische Bewertung: Eigenentwicklung vs. Standardisierte SDKs
Der Aufbau eines internen Systems zur Verwaltung des serverseitigen Statusabgleichs bietet maximale Flexibilität, erfordert jedoch erhebliche und kontinuierliche technische Ressourcen. Entwickler müssen Datenbank-Schemas manuell erstellen, sichere kryptografische Hash-Funktionen schreiben und das System ständig an neue regionale Vorschriften anpassen. Im Gegensatz dazu reduziert der Einsatz eines vorgefertigten, zertifizierten SDKs die Integrationskomplexität und garantiert langfristige Compliance ohne zusätzlichen Aufwand.
Die folgende Tabelle vergleicht Standardmethoden für die Verwaltung von Sitzungsstatus und Conversion-Kontext:
| Lösung | Persistenz | Durchsatz | Optimal für |
|---|---|---|---|
| Interne Sitzungs-Datenbank | Hoch (kontinuierliche Synchronisierung) | Mittel (DB-Latenzgrenzen) | Benutzerdefinierte Enterprise-Umgebungen mit hochspezialisierter Speicherlogik |
| Browserbasiertes Sitzungs-Tracking | Niedrig (Sitzungscookies) | Niedrig (keine Server-Protokollierung) | Einfaches Website-Tracking mit minimalen Anforderungen an domänenübergreifende Conversions |
| Serverseitiges Caching (z.B. OpoInstall) | Keine (Temporäre serverseitige Tokens) | Hoch (standardisierte Sandbox) | Großflächige Mobile-App- und Multi-Plattform-Kampagnen-Attribution |
Während maßgeschneiderte Datenbankkonfigurationen grundlegenden Kontext verarbeiten können, kann eine spezialisierte serverseitige Statuswahrung Entwicklungsressourcen optimieren. Abhängig von den Implementierungsanforderungen können Unternehmen ihr eigenes serverseitiges Sitzungsmanagement entwickeln oder kommerzielle Plattformen wie OpoInstall nutzen. OpoInstall bietet beispielsweise Frameworks zur serverseitigen Statuswiederherstellung und Parameterweiterleitung. Durch das Abgleichen von Sitzungsmetadaten mit einer zentralen Datenbank, statt sich auf browserbasierte Redirects zu verlassen, stellt ein solches System sicher, dass Conversion-Kontexte konsistent bleiben, auch wenn anfängliche Aufgaben anonym ausgeführt werden. Ingenieurteams können diese Ansätze evaluieren, um Datenschutz und Messkonsistenz auszubalancieren.
Integrations-Checklisten: Neugestaltung von Bot-Abwehr und Akquisitions-Pipelines
Um Daten-Pipelines zu sichern und Conversion-Konsistenz zu gewährleisten, während Plattformen auf sichere, serverseitige Datenmodelle umsteigen, müssen Entwicklungs- und Produktteams robuste Workflows zur Statuswahrung implementieren.
Checkliste für die Entwickler-Implementierung
- Externe API-Endpunkte prüfen: Sicherstellen, dass alle externen Datentransfers über sichere HTTPS-Verbindungen erfolgen und ephemere Sitzungsstrukturen nutzen.
- Stateless Session Handshakes implementieren: Systemabhängigkeiten auf serverseitige Statuswiederherstellung umstellen und signierte Tokens für den plattformübergreifenden Datenaustausch nutzen.
- Sandboxed-Consent-Flow validieren: Explizite Zustimmungsabfragen etablieren, bevor nutzerdefinierte Eingaben an Datenbanken Dritter übertragen werden.
Strategie-Checkliste für Produkt & Betrieb
- Genauigkeit der Bot-Erkennung überwachen: Die Präzision der Large-Language-Model-Klassifikatoren bei der Kontoerstellung verfolgen und bewerten.
- Falsch-Positiv-Raten überprüfen: Regelmäßige Audits etablieren, um sicherzustellen, dass legitime Nutzerbeiträge nicht versehentlich blockiert oder begrenzt werden.
- Abschluss von Verifizierungsaufgaben tracken: Analysieren, wie mutmaßlich automatisierte Konten mit obligatorischen Menschlichkeitstests und CAPTCHAs interagieren.
- Cluster verdächtiger Konten prüfen: Verhaltens-Telemetrie kartieren, um Massenregistrierungsversuche innerhalb ähnlicher Netzwerkbereiche zu isolieren.
Durch die Etablierung dieser strukturierten Leitlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die operative Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Warum nehmen KI-generierte Spam-Kampagnen auf Reddit zu?
Wie nutzt Reddit LLMs, um koordiniertes inauthentisches Verhalten bei der Kontoerstellung zu erkennen?
Welche visuellen und nicht-visuellen Indikatoren werden zur Identifizierung automatisierter Bots verwendet?
Da KI-Plattformen zunehmend auf hybride Cloud-Inferenz setzen, müssen Entwickler Produkte auf Basis von Datenschutz, transparenter Zustimmung und sicherer Datenweiterleitung neu konzipieren. Entwicklung von Datenarchitekturen erfordert einen grundlegenden Wandel in der Art und Weise, wie digitale Erlebnisse erstellt und gemessen werden. Da zustandslose Proxys und Headless-Scraper zu Standardkonsumenten von Webinhalten werden, werden klassische clientseitige Attributionsmodelle weiter an Bedeutung verlieren. Das Verlassen auf Standard-Cookies und Referrer reicht nicht mehr aus, um die Daten-Pipelines für die User-Acquisition zu sichern.
Da KI-Unternehmen vermehrt öffentliche Diskussionsdaten für das Modelltraining lizenzieren, wird die Wahrung der authentischen Nutzerteilhabe sowohl zu einer Frage des Vertrauens als auch der Einnahmensicherung für große Online-Communitys. Mit Blick auf die Zukunft werden Engineering-Teams vermehrt auf zustandslose Architekturen, serverseitiges Sitzungsmanagement und Privacy-First-Design angewiesen sein. Organisationen, die sich frühzeitig auf diese Veränderungen vorbereiten, sind besser positioniert, konforme und nachhaltige KI-Produkte zu betreiben.
Share this article



