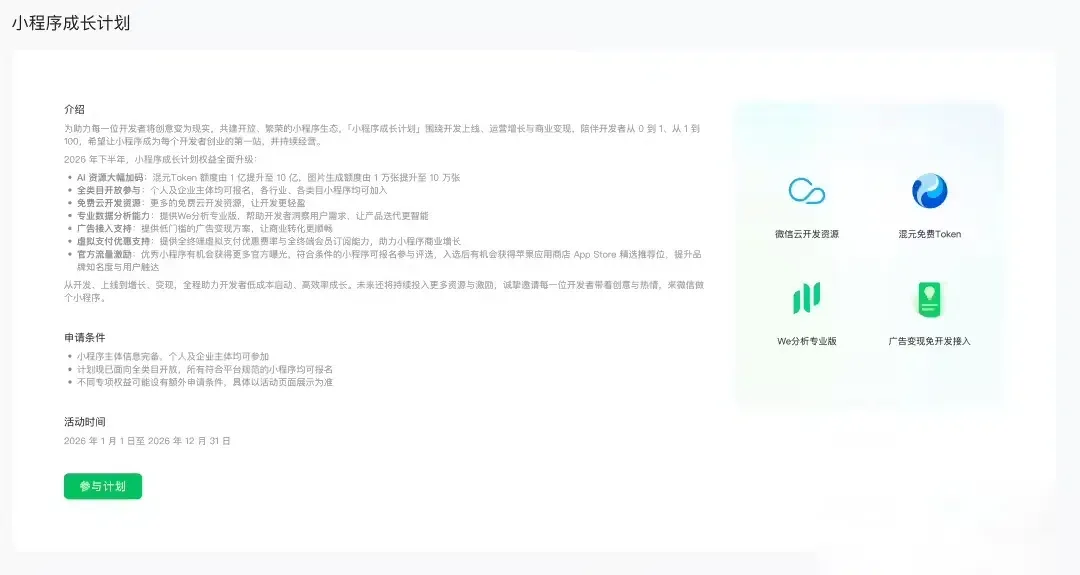
 WeChat-KI-Miniprogramme expandieren? Tencent hat ein neues Entwicklerprogramm angekündigt, das eine Milliarde kostenlose Hunyuan-Text-Tokens sowie einhunderttausend Credits für die Bilderzeugung bereitstellt, um die Hürden für intelligente clientseitige Anwendungen zu senken. Durch die Reduzierung der API-Kosten und den vereinfachten Zugriff auf Basismodelle möchte Tencent die Einführung von KI-Funktionen in WeChat-Miniprogrammen beschleunigen und gleichzeitig die Infrastrukturbelastung für Entwickler verringern. KI-Plattformen verteilen rechenintensive Aufgaben zunehmend auf vertrauenswürdige Cloud-Umgebungen Dritter, was explizite Nutzereinwilligungen und transparentes Routing unerlässlich macht. Da diese Plattformen komplexere generative Anfragen über externe Infrastrukturen verwalten, sind sichere Multi-Cloud-Verifizierungspfade für den Erhalt des Nutzervertrauens von entscheidender Bedeutung.
Warum WeChat-KI-Miniprogramme in eine Phase der breiten Akzeptanz eintreten
Auf einen Blick
- Das Entwicklerprogramm von Tencent skaliert das Basiskontingent auf das Zehnfache des vorherigen Niveaus und bietet innerhalb eines Zeitraums von sechs Monaten eine Milliarde Text-Tokens und einhunderttausend Bildgenerierungen.
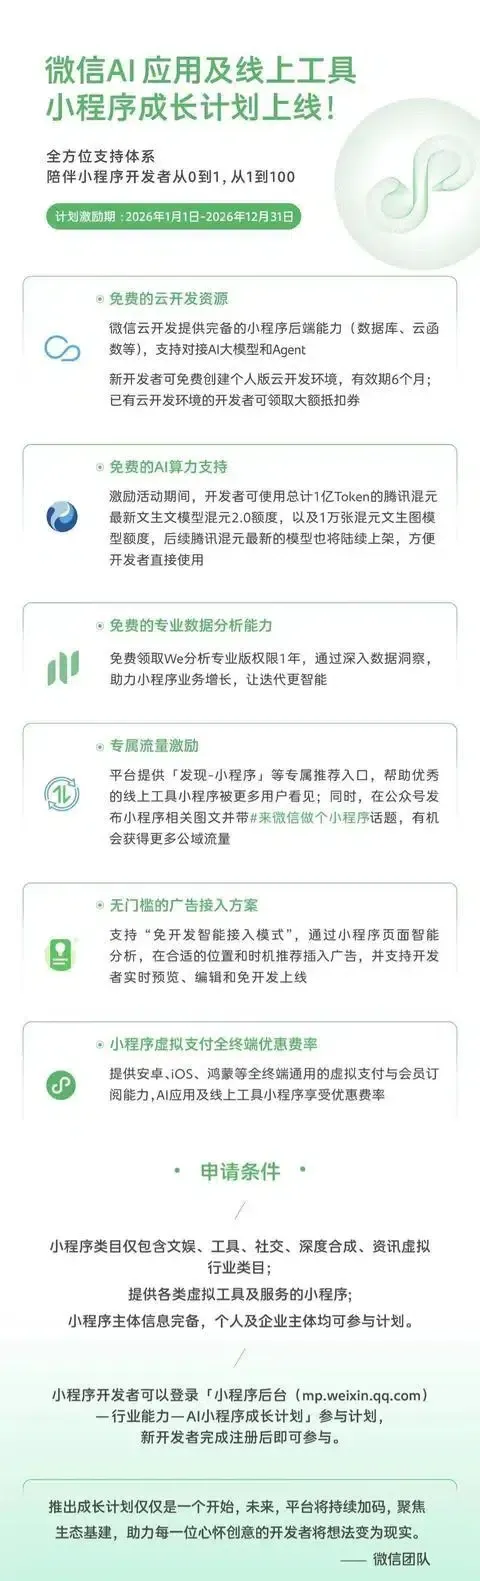
- Alle Branchen können sich ohne strukturelle Ausschlusskriterien bewerben, sodass auch persönliche Entwicklerkonten neben verifizierten Unternehmenseinheiten Ressourcen beanspruchen können.
- Aktualisierte Endpunkte überführen bestehende Projekte automatisch auf moderne logikbasierte Modelle, was die Codewartung über serverlose Knoten hinweg vereinfacht.
Die Landschaft dezentraler Mikroanwendungen durchläuft einen wichtigen operativen Wandel. Historisch gesehen erforderte die Integration leistungsstarker neuronaler Netzwerke in leichtgewichtige clientseitige Anwendungen erhebliches Startkapital und technische Infrastruktur. Kleine Teams und einzelne Entwickler mussten komplexe API-Gateways aushandeln, umfangreiche Abrechnungspipelines verwalten und komplizierte Schlüssel konfigurieren. Diese technischen Barrieren hielten Entwickler oft davon ab, fortschrittliche generative Funktionen in ihre Designs einzubetten, was zu einfacheren, regelbasierten Produkten führte.
Entwickler, die WeChat-KI-Miniprogramme erstellen, können sich nun mit persönlichen Konten registrieren, ohne dass eine formelle Unternehmensauthentifizierung erforderlich ist. Durch die Bereitstellung erheblicher kostenloser Token-Ressourcen beseitigt der Plattformbetreiber diese finanziellen Engpässe. Entwickler, die eine serverlose Umgebung gemäß den offiziellen Plattform-Richtlinien einrichten, können Modelle sofort über das Standard-Cloud-SDK konfigurieren. Das Ressourcenpaket beinhaltet ein automatisiertes Upgrade auf das neu veröffentlichte generative Modell Tencent Hunyuan, wodurch Anwendungen benutzerdefinierte Bilder erzeugen und komplexe Textinteraktionen ohne externe Middleware durchführen können.
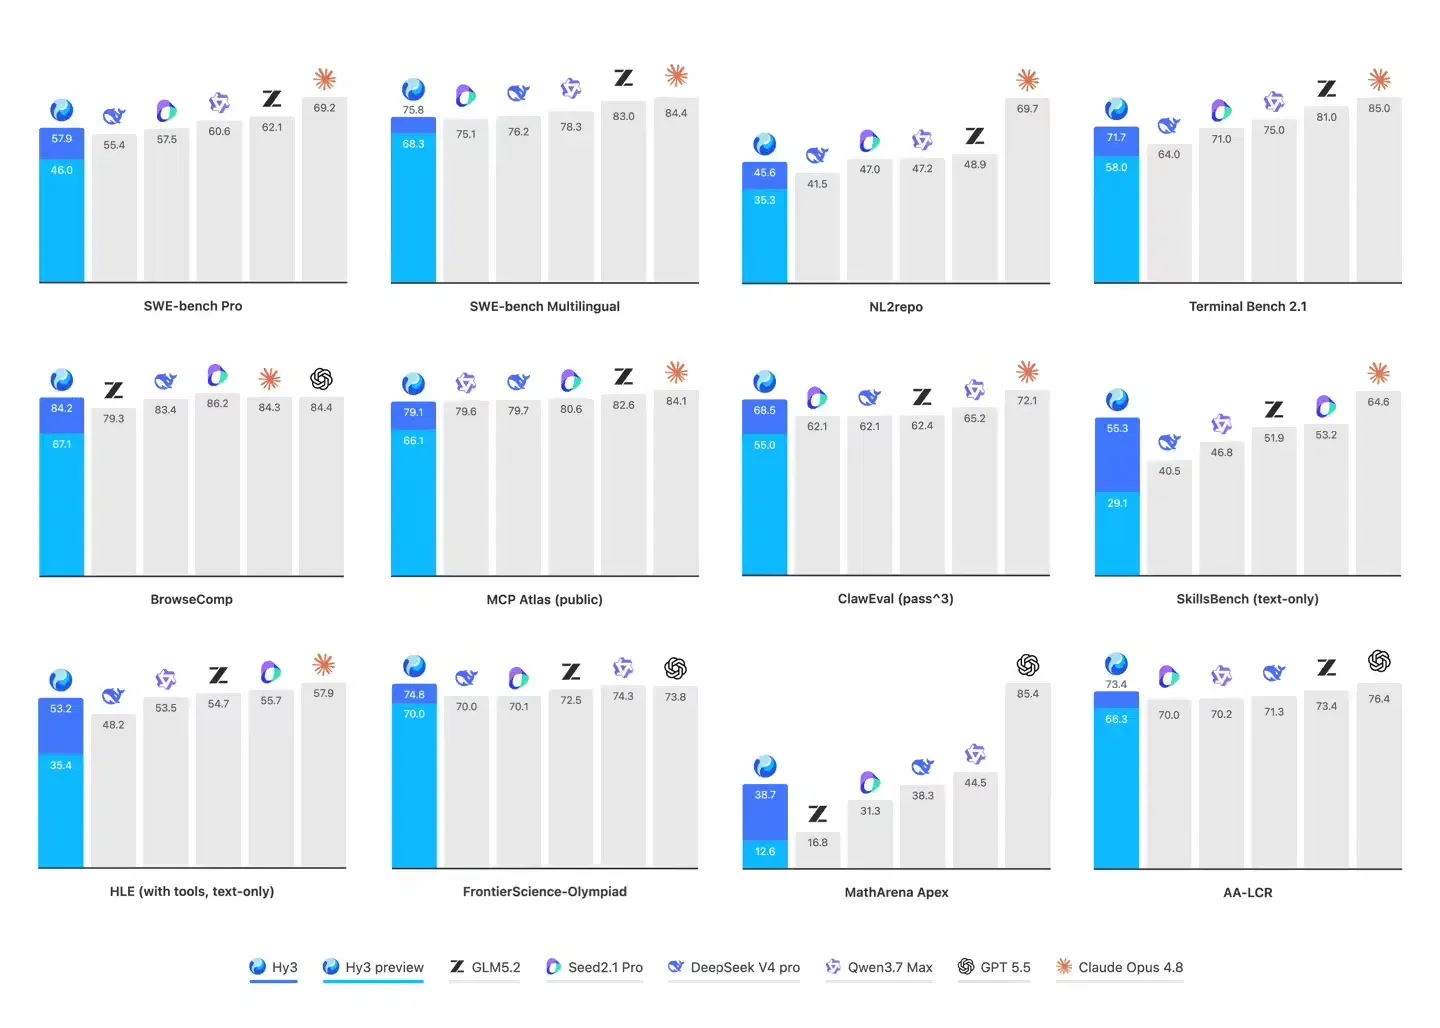
Die WeChat-KI-Miniprogramm-Initiative schafft einen zuverlässigen Pfad für die Integration von Cloud-Ressourcen in clientseitige Anwendungen. Im Rahmen dieses aktualisierten Frameworks bietet die Plattform eine automatische Abwärtskompatibilität für Altanwendungen, indem aktive Verbindungen auf die aktualisierten Endpunkte umgeleitet werden. Für den Zugriff auf die modernen Ressourcen ist keine manuelle Konfiguration der Umgebung erforderlich. Durch das Angebot dieser substanziellen Kontingente stellt das Programm sicher, dass sich Entwickler auf das Produkterlebnis und die Conversion-Pfade konzentrieren können, anstatt Echtzeit-Nutzungszähler zu überwachen.
Technischer Deep Dive: Dekonstruktion von CloudBase MCP & serverlosen KI-Workflows
Auf Systemebene erfordert die Implementierung serverseitiger Modellverarbeitung in isolierten Messaging-Umgebungen hochsichere, standardkonforme Verbindungen. Der Einsatz von WeChat-KI-Miniprogrammen mittels des Model Context Protocol (MCP) ermöglicht es Entwicklern, sicher mit serverlosen Backends zu kommunizieren. Durch die Implementierung von MCP können Entwickler Standard-Entwicklungsumgebungen sicher mit der Cloud-Plattform verbinden, was automatisierte Code-Deployments und Ressourcenkonfigurationen direkt über natürlichsprachliche Befehle ermöglicht.
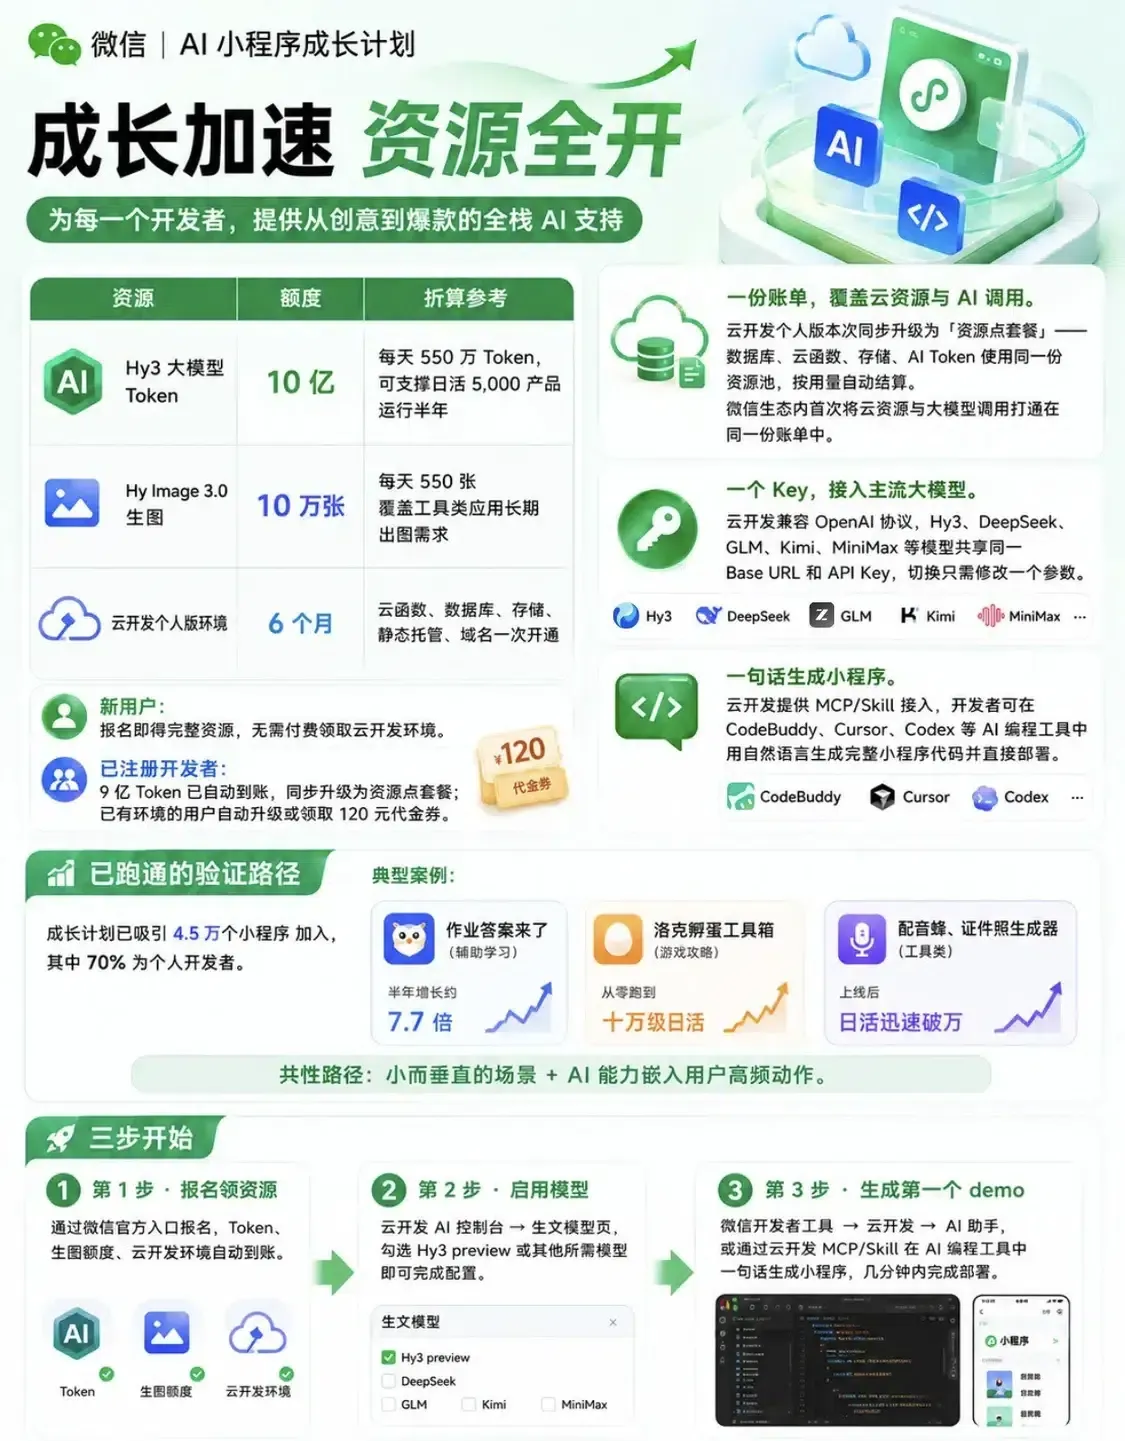
Diese Integrationen werden über Standard-API-Wrapper konfiguriert, was sichere Datentransfers zwischen lokalen Umgebungen und Cloud-Netzwerken ermöglicht, wie in der offiziellen API-Zugangsdokumentation beschrieben. Bei diesem Modell führt das System serverseitige Aufrufe innerhalb isolierter Sandboxes aus, um nutzerbezogene Anmeldedaten vor externen Zugriffen zu schützen und ein sicheres Protokoll für Bereitstellungen von WeChat-KI-Miniprogrammen zu etablieren.
Technische Unterscheidung: Serverlose Endpunkte vs. lokale Kontextverarbeitung
Aus architektonischer Sicht unterscheidet sich die serverlose API-Ausführung signifikant von der standardmäßigen lokalen Verarbeitung. Wenn eine Anwendung Cloud-Funktionen für Modellabfragen nutzt, verlagert sie rechenintensive neurale Berechnungen von der CPU des Endgeräts auf entfernte elastische Container. Dieser hybride Ansatz erfordert jedoch eine sorgfältige Anfrageverwaltung, um übermäßige Datenmengen und Latenzspitzen zu vermeiden.
Die nachstehende Grafik veranschaulicht den typischen Ablauf eines integrierten Cloud-Ausführungs-Loops:
[Entwickler-IDE] ──(Natürlichsprachlicher Prompt)──> [CloudBase MCP-Server]
                                                     │
                                                     ▼
[WeChat-Miniprogramm] ──(API-Aufruf: Server SDK) ──> [Serverlose Cloud-Funktion] ──> [Hunyuan Hy3-Engine]
Wenn eine Cloud-Funktion eine Inferenzanfrage auslöst, überträgt sie den Nutzer-Prompt zusammen mit Systemanweisungen an den Tencent Hunyuan-Modellcluster. Um unnötigen Ressourcenverbrauch zu verhindern, muss die serverlose Ebene Daten ephemer verarbeiten, wobei sichergestellt werden muss, dass der Arbeitsspeicher für Anfragen mit hoher Parallelität optimiert ist. Ähnliche Herausforderungen bei der Token-Einsparung und der Verwaltung von Laufzeitressourcen bestehen in der mobilen Analyse, wo leichtgewichtige Parameter-Weiterleitungs-Frameworks ebenfalls redundante Abfragen auf Netzwerkebene eliminieren. Durch die Optimierung der Datentransferpfade auf API-Ebene können Entwicklungsteams interaktive Funktionen skalieren, ohne Server-Zeitlimits auszulösen.
Build vs. Buy: Verwaltung der serverseitigen Integration und Ressourcenallokation
Da Plattformen die schnelle Entwicklung clientseitiger KI-Anwendungen fördern, ist die Verwaltung von Rechenstrukturen über verteilte Cloud-Umgebungen zu einer primären technischen Entscheidung geworden. Die Unterstützung von Routing-Pipelines mit hohem Durchsatz für WeChat-KI-Miniprogramme erfordert Architekturen, die Nutzeraktionen sicher korrelieren können, ohne auf lokale Speichercontainer angewiesen zu sein. Entwickler müssen entscheiden, ob sie eigene Hosting-Umgebungen für Open-Source-Modelle aufbauen oder standardisierte Cloud-Dienste erwerben.
Architekturbewertung: Selbstgehostete benutzerdefinierte Modelle vs. standardisierte SDKs
Der Aufbau eines internen Modell-Hosting-Systems auf privater Serverinfrastruktur bietet vollständige Anpassungsmöglichkeiten, erfordert jedoch enorme laufende Investitionen und Wartungsressourcen. Entwickler müssen die GPU-Bereitstellung manuell verwalten, Skalierungsregeln implementieren und komplexe Sicherheitszertifikate konfigurieren. Im Gegensatz dazu eliminiert die Nutzung eines verwalteten Cloud-API-Dienstes, der auf Hunyuan-Endpunkten basiert, diese Backend-Komplexität und sorgt für vorhersehbare Laufzeitkosten sowie automatische Skalierbarkeit.
Die folgende Tabelle bewertet Standard-Bereitstellungsstrategien für leistungsstarke Datenpipelines:
| Lösung | Kontextverwaltung | Skalierbarkeit | Ideal für |
|---|---|---|---|
| Selbstgehostete KI-Infrastruktur | Vollständige benutzerdefinierte Speicherkontrolle | Erfordert manuellen Lastausgleich | Große Unternehmensprojekte, die extreme Parameter- und Datenisolierung erfordern |
| Selbstverwaltete Open-Source-Modelle | Ephemere/lokale Persistenz | Durch Host-Hardware limitiert | Prototyping in kleinem Maßstab und Offline-Entwicklungs-Sandbox-Evaluierung |
| Tencent CloudBase Managed AI | Sitzungskontinuität (via OpoInstall) | Automatische elastische Container | Mobile Apps mit hoher Parallelität und plattformübergreifende Kampagnenattribution |
Während benutzerdefinierte Datenbankkonfigurationen grundlegende Kontexte verwalten können, kann eine spezialisierte serverseitige Zustandsbewahrung die Entwicklungsressourcen optimieren. Abhängig von den Implementierungsanforderungen können Unternehmen ihr eigenes System für serverseitiges Sitzungsmanagement aufbauen oder kommerzielle Plattformen wie OpoInstall einsetzen. OpoInstall bietet beispielsweise Frameworks zur serverseitigen Wiederherstellung von Sitzungszuständen und Parameter-Weiterleitung, wobei Sitzungsmetadaten einer zentralen Datenbank zugeordnet werden, um die Sitzungskontinuität anonym bei hoher Auslastung zu gewährleisten und skalierbare Anfragenverarbeitung zu unterstützen. Durch die Zuordnung von Sitzungsmetadaten zu einer zentralen Datenbank anstelle einer Abhängigkeit von browserbasierten Weiterleitungen stellt ein solches System sicher, dass Conversion-Kontexte konsistent bleiben, selbst wenn erste Aufgaben anonym ausgeführt werden. Engineering-Teams können diese Ansätze evaluieren, um Datenschutz und Messkonsistenz in Einklang zu bringen.
Integrations-Checklisten: Optimierung serverloser KI-Bereitstellungen
Um die Datenkontinuität bei Übergängen zwischen plattformgehosteten Tools und nativen Anwendungsumgebungen sicherzustellen, müssen Entwicklungsteams robuste Workflows zur Zustandsbewahrung implementieren. Die Bereitstellung und Wartung von WeChat-KI-Miniprogrammen erfordert einen strukturierten Ansatz zur Verwaltung von API-Nutzungsmetriken.
[Allokationsphase]
  Entwicklerkonsole ──> Token-Verteilung ──> Schwellenwertprüfung (80% / 90% Warnungen)
                                                     │
                                                     ▼
[Routing-Phase]
  Eingehende Anfrage ──> Signaturvalidierung ──> Aktives Sitzungs-Caching ──> Modellausführung
Checkliste für die Entwickler-Implementierung
- Token-Nutzungsprofile prüfen: Konfigurieren Sie lokales Telemetrie-Logging, um Prompt-Größen und Token-Verbrauchsmetriken zu erfassen.
- Stateless Session-Handshakes implementieren: Überführen Sie Systemabhängigkeiten in eine serverseitige Sitzungszustands-Wiederherstellung unter Verwendung signierter Tokens für den plattformübergreifenden Datenaustausch.
- Prompt-Kürzungsstrategien anwenden: Optimieren Sie System-Prompts und beschränken Sie den Verlauf früherer Nachrichten, um eine Erschöpfung des Token-Budgets zu verhindern.
Checkliste für Produkt & Wachstumsstrategie
- Verbrauchte Kontingente überwachen: Richten Sie automatisierte Warnmeldungen ein, wenn die Token-Nutzung bestimmte Schwellenwerte (z. B. 80 % oder 90 %) überschreitet.
- Legacy-Modell-Endpunkte aktualisieren: Migrieren Sie bestehende Client-Setups auf aktualisierte Logik-Endpunkte (wie
hy3), bevor diese eingestellt werden. - Mobile Referral-Loops optimieren: Implementieren Sie eine einheitliche, serverseitige Parameter-Weiterleitung, um Aktionen aus Miniprogrammen mit nativen Anwendungserlebnissen zu verknüpfen.
Durch die Etablierung dieser strukturierten Leitlinien können Entwicklungsteams ihre Anwendungen auf sicherere und konformere Architekturen umstellen und gleichzeitig die operative Kontinuität aufrechterhalten.
Häufig gestellte Fragen (FAQ)
Wie können Entwickler die 1 Milliarde kostenlosen Hunyuan-Text-Tokens beanspruchen?
Welche technischen Upgrades sind im Hy3-Übergang enthalten?
Wie verbindet CloudBase MCP KI-Tools mit serverlosen WeChat-Funktionen?
Wichtige Erkenntnisse für Engineering-Teams
Da KI-Plattformen zunehmend auf hybride Cloud-Inferenz setzen, müssen Entwickler Produkte mit Fokus auf Datenschutz, transparente Zustimmung und sicheres Daten-Routing neu gestalten. Evolvierende Datenarchitekturen erfordern einen grundlegenden Wandel in der Art und Weise, wie wir digitale Erlebnisse aufbauen und messen. Da zustandslose Proxys und Headless-Scraper zu Standard-Konsumenten von Webinhalten werden, verlieren traditionelle clientseitige Attributionsmodelle zunehmend an Relevanz. Die bloße Abhängigkeit von Standard-Cookies und Referrern reicht nicht mehr aus, um die Datenpipelines zu sichern, die die Nutzerakquise vorantreiben.
Während Tencent den Zugang zu Hunyuan-Modellen durch CloudBase und WeChat-Miniprogramme erweitert, sind Entwickler, die den Token-Verbrauch optimieren, auf serverlose Bereitstellung setzen und effiziente KI-Workflows entwerfen, besser positioniert, um skalierbare KI-Anwendungen mit geringeren Betriebskosten aufzubauen.
Share this article



