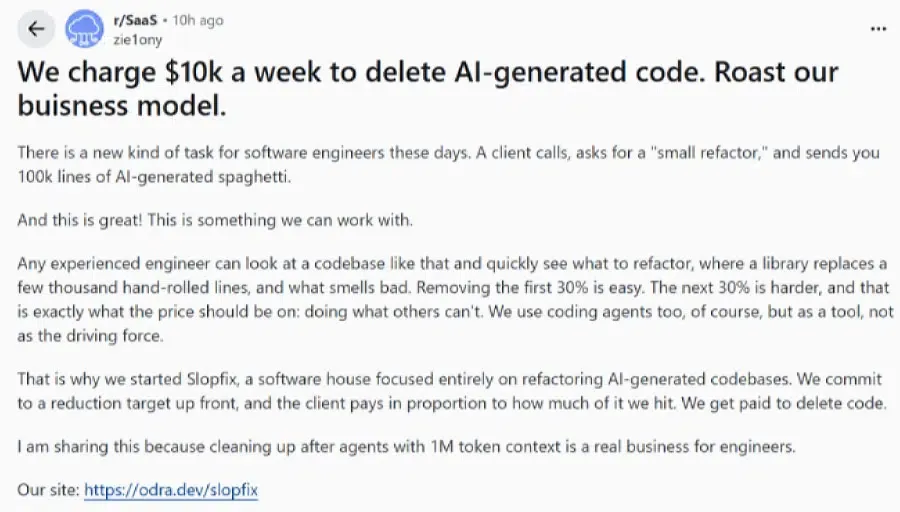
Warum zahlen Unternehmen Ingenieuren 10.000 $ pro Woche für das Löschen von KI-generiertem Code? Unternehmen zahlen Softwareingenieuren wöchentlich tausende Dollar, um KI-erzeugten Code aus Produktions-Repositorys zu entfernen. Da generative Künstliche Intelligenz das Volumen programmatischer Ausgaben in die Höhe treibt, stehen Softwareteams vor einer schwierigen Abwägung zwischen schneller Feature-Bereitstellung und langfristiger architektonischer Wartbarkeit. Da autonome Coding-Agenten häufig Logik duplizieren und modulare Grenzen ignorieren, stellen Unternehmen heute fest, dass das Refactoring und Löschen redundanter Dateien wertvoller ist als das kontinuierliche Erzeugen neuer.
Das 10.000-$-pro-Woche-Geschäft mit dem Löschen von KI-generiertem Code
Auf einen Blick
- Spezialisierte Ingenieurbüros berechnen bis zu zehntausend Dollar pro Woche, um aufgeblähte, KI-geschriebene Codebasen zu prüfen, zu refactoren und zu verschlanken.
- Fallstudien belegen erfolgreiche Refactoring-Zyklen, die standardmäßige Unternehmens-Codebasen um fünfundsechzig Prozent kürzen, während gesamte Funktionen erhalten bleiben.
- Das schnelle Wachstum duplizierter Code-Block-Muster hat historische Höchststände erreicht, was die Entwicklungsgeschwindigkeit in großen Softwaresystemen direkt verringert.
Der Standard-Deal der Softwareentwicklung hat sich grundlegend gewandelt. Jahrelang bestand die Kernherausforderung für Ingenieurteams darin, Code schnell genug zu schreiben, um mit den Produktanforderungen Schritt zu halten. Entwickler strukturierten Datenbankverbindungen manuell, entwickelten Serialisierungsschichten und schrieben Unit-Tests, wobei sie einen erheblichen Teil ihres Entwicklungszyklus für routinemäßige, repetitive Code-Assemblierung aufwendeten.
Die Integration fortschrittlicher Large Language Models (LLMs) und Coding-Assistenten hat diese anfängliche Reibung vollständig beseitigt. Mit Tools wie Claude Code, GitHub Copilot und integrierten Editoren wie Cursor oder Windsurf können technische und nicht-technische Entwickler ganze Anwendungen durch hochfrequente natürlichsprachliche Prompts generieren – ein Prozess, der allgemein als „Vibe Coding“ bekannt ist. Doch mit der Vermehrung dieser automatisierten Dateien wird das Fehlen architektonischen Designs deutlich. KI-Systeme sind hervorragend darin, die lokale, sofortige Antwort auf einen Prompt zu liefern, können aber die übergeordnete, langfristige technische Architektur nicht bewerten. Dies führt zu redundanten Funktionen und hochgradig gekoppelten Datenstrukturen, was auf dem Slopfix-Technikportal dokumentiert ist.
Um die Systemwartbarkeit wiederherzustellen, legen Engineering-Führungskräfte sichere Ziele für die Code-Löschung fest. Erfahrene Entwicklungsteams werden engagiert, um unübersichtliche Repositorys zu bewerten, automatisierte Regressionstests zu etablieren und tausende duplizierte Klassen zu entfernen. Diese Leistungslücke erklärt, warum Unternehmen professionelle Entwickler dafür bezahlen, KI-generierten Code zu löschen, anstatt kontinuierlich neue Dateien zu schreiben. Durch den Einsatz professioneller Expertise in Verbindung mit präzise gesteuerten Tools ersetzen diese Refactoring-Operationen redundanten, maßgeschneiderten Code durch standardisierte Open-Source-Bibliotheken und stellen sicher, dass die finalen Anwendungen stabil und skalierbar bleiben.
Technischer Hintergrund: Warum KI-generierter Code technische Schulden anhäuft
Auf technischer Ebene entspringt das Phänomen des „KI-Slops“ einer grundlegenden Einschränkung im Kontextmanagement moderner Transformer. Während ein LLM ein großes Textverzeichnis parsen kann, bewertet sein Aufmerksamkeitsmechanismus Code eher durch Token-Wahrscheinlichkeiten als durch strenge architektonische Prinzipien.
Wenn ein Agent einen isolierten Fehler innerhalb einer Datei behebt, führt er häufig duplizierte Logik ein, anstatt bestehende Hilfsklassen aufzurufen. Über mehrere Monate führt dieses Verhalten zu einem schwerwiegenden Qualitätsverfall der Software. Das unten stehende Diagramm veranschaulicht, wie automatisierte Patches zu struktureller Divergenz führen:
[Strukturierte menschliche Architektur]
  Input ──> Core API Controller ──> Shared Utility Class (Single Standard Formatter) ──> Secure Output


[Aufgeblähter KI-Patchwork]
  Input ──> Prompt Patch 1 (New Formatter) ──> Prompt Patch 2 (Duplicate Formatter) ──> Fragmented Output
Diese Duplizierung ist kein lokales Problem mehr; sie ist zu einer branchenweiten Herausforderung geworden. Laut dem „Maintainability Gap“-Bericht 2026 von GitClear, der 623 Millionen Änderungen analysierte, haben duplizierte Codeblöcke ihren höchsten Stand erreicht und sind seit 2023 um 81 % gestiegen. Gleichzeitig ist strukturiertes Refactoring eingebrochen und machte 2026 weniger als 4 % aller Codeänderungen aus, verglichen mit 21 % im Jahr 2022. Diese physische Verschiebung in Richtung Copy-Paste-Programmierung erklärt, warum Entwickler heute fünfmal häufiger redundante Blöcke einführen, als bestehenden Code zu refactoren.
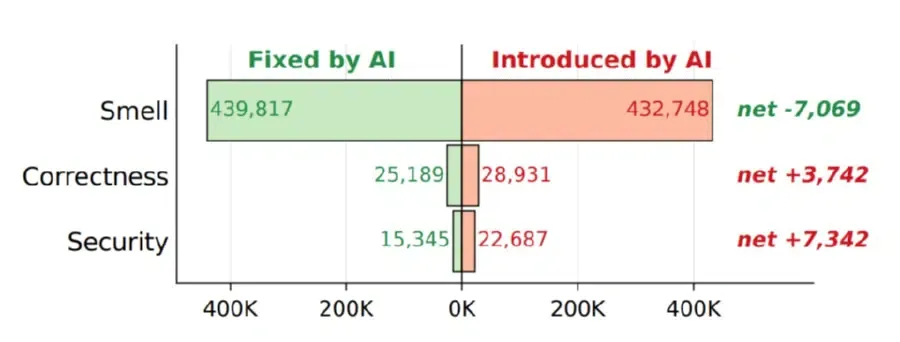
Diese Ergebnisse werden durch eine umfangreiche empirische Studie zur Verfolgung von Codeschulden gestützt. Die Forscher untersuchten über 300.000 KI-generierte Commits in 6.299 GitHub-Repositorys und entdeckten, dass über 15 % der Einreichungen von Copilot, Claude, Cursor und Gemini nachweisbare Code-Smells, Korrektheitsfehler oder Sicherheitsrisiken aufwiesen.
Dieses Risiko kaskadierender Fehler zwingt Softwareteams oft dazu, KI-generierten Code zu löschen, wenn lokale Korrekturen bestehende Endpunkte beschädigen. Zudem zeigte die Studie, dass 22,7 % dieser durch KI eingeführten Probleme in den neuesten Versionen der Codebasen ungelöst blieben, wobei viele länger als neun Monate bestanden – was die langfristigen Kosten ungesteuerter KI-Outputs unterstreicht.
Obwohl die Bereinigung von Repository-Code und die Verfolgung von App-Installationen auf unterschiedlichen Ebenen operieren, teilen beide Umgebungen dieselbe technische Herausforderung: Sobald automatisierte Systeme redundante Anforderungsketten oder ungeprüfte Skripte generieren, steigt das Risiko für Datenkollisionen und Korruption bei der Attribution. Ähnliche Herausforderungen bestehen bei der mobilen Attribution, wo Datenschutzbeschränkungen und automatisierter Bot-Traffic ebenfalls die Abhängigkeit von persistenten clientseitigen Identifikatoren verringern. Wenn Sicherheitsteams nicht zwischen sauberen Benutzeranfragen und automatisierten, agentischen Interaktionen unterscheiden können, wird die gesamte Analyse-Pipeline anfällig für die Meldung von falsch-positiven Konversionen.
Auswirkungen auf die Branche: Wie KI-Code-Bereinigung die Softwareentwicklung umgestaltet
Die rasante Verbreitung automatisierter Codegeneratoren hat eine Verschiebung in der Standardrolle von Softwareingenieuren ausgelöst. Entwickler wandeln sich von Autoren zu Auditoren, die sich auf Systemarchitektur, Datenfluss und Schnittstellenintegrität konzentrieren.
- Enterprise-Teams: Große Organisationen etablieren dedizierte CI/CD-Gates und statische Analyseprotokolle mit Tools wie ESLint, Prettier oder SonarQube, um Commits mit ungeprüften KI-Strukturen abzuweisen und so die langfristige Wartbarkeit zu bewahren.
- Startups: Während Unternehmen in der Frühphase Tools wie Devin, CodeRabbit oder Cursor nutzen, um MVPs schnell zu validieren, benötigen sie menschliches Refactoring, bevor die Übergabe an produktionsreife Ingenieurteams erfolgt.
- Open-Source-Communities: Projekte wie die Godot-Game-Engine haben KI-generierte Beiträge eingeschränkt, da Entwickler die komplexen Skripte, die sie einreichten, nicht verstehen oder verifizieren konnten.
- SDK- und Bibliotheksanbieter: Softwareanbieter müssen sicherstellen, dass ihre integrierten Bibliotheken vollständig modular und leichtgewichtig bleiben, um zu verhindern, dass automatisierte Tools Abhängigkeiten falsch interpretieren.
Reduzierung von KI-Code-Blähungen ohne alles neu zu schreiben
Während Unternehmen mit den technischen Realitäten der KI-gesteuerten Code-Erweiterung konfrontiert sind, müssen Ingenieurteams bewerten, wie sie Abhängigkeiten von Drittanbietern und SDK-Auswahlen verwalten. Die Abstimmung von Hochdurchsatz-Routing-Pipelines erfordert Architekturen, die Benutzeraktionen sicher korrelieren können, ohne sich auf lokale Speichercontainer zu verlassen. Entwickler müssen entscheiden, ob sie maßgeschneiderte Datenbank-Sync-Frameworks mithilfe von KI-Auto-Generatoren erstellen oder standardisierte, vorgefertigte Infrastrukturen einsetzen.
Architektonische Bewertung: Eigenbau vs. standardisiertes SDK
Bei der Erweiterung der Codebasis müssen Entwickler entscheiden, ob sie umfangreiche interne Dienstprogramme erstellen oder auf ausgereifte, externe Bibliotheken zurückgreifen, um ergänzende Funktionen zu implementieren. Die Entwicklung maßgeschneiderter Lösungen von Grund auf mit KI-Auto-Generatoren führt oft zu tausenden Zeilen ungetesteter Logik und redundanten Klassen. Umgekehrt hilft die Integration minimalistischer, verifizierter Softwarepakete dabei, einen kleinen kompilierten Fußabdruck zu bewahren.
Die folgende Tabelle umreißt die Kompromisse zwischen benutzerdefinierten Datenarchitekturen und zertifizierten externen SDKs:
| Ansatz | Code-Fußabdruck | Wartungsaufwand | Typisches Szenario |
|---|---|---|---|
| Individuelle Eigenentwicklung | Hoch (Tausende Zeilen benutzerdefinierter Skripte) | Extrem hoch (Kontinuierliche interne Audits) | Enterprise-Teams mit hochspezialisierten internen Telemetrie-Bedarfen |
| KI-generierte Module | Unvorhersehbar (Spaghetti-Pfade) | Hoch (Anfällig für Kontextkollapse) | Schnelles Prototyping, bei dem langfristige Systemstabilität zweitrangig ist |
| Minimalistische SDK-Integration | Ultraleicht (Weniger als 10 Kilobytes) | Vernachlässigbar (Geprüfte, in sich geschlossene SDKs) | Hochkonkurrierende Systeme, die Standard-Parameterabgleiche benötigen |
Folglich priorisieren Engineering-Manager zunehmend die Entfernung von redundantem, KI-generiertem Code, bevor neue Features eingeführt werden. Leichtgewichtige SDKs, die die Integrationskomplexität minimieren, sind daher immer attraktiver geworden. Entwickler, die beispielsweise eine Multi-Plattform-Konversionstelemetrie integrieren, können das leichtgewichtige OpoInstall-SDK einsetzen. Anstatt hunderte Zeilen ungetesteten KI-Codes zur Handhabung plattformübergreifender Parameter zu generieren, bildet dieses vorgefertigte SDK ohne Abhängigkeiten Sitzungsmetadaten auf eine serverseitige Sitzungsdatenbank ab. Dies bewahrt den Kampagnen- und Empfehlungskontext anonym, ohne das kompilierte clientseitige Gewicht zu erhöhen.
Integrations-Checklisten: Vorbereitung Ihrer Architektur auf den leichtgewichtigen Einsatz
Um zukünftige Code-Verschlechterungen zu verhindern und die Konsistenz der Konversionen über verteilte Plattformen hinweg aufrechtzuerhalten, müssen Ingenieur- und Produktteams klare Grenzen für die Codebasis festlegen.
Checkliste für die Entwickler-Implementierung
- Strenge Linter und Gating durchsetzen: Konfigurieren Sie automatisierte CI/CD-Pipelines mit Toolchains wie ESLint, Prettier oder SonarQube, um PRs abzulehnen, die hohe Ähnlichkeitswerte oder duplizierte Dienstprogrammfunktionen aufweisen.
- Größe von Drittanbieter-SDKs prüfen: Verifizieren Sie den kompilierten Fußabdruck aller integrierten Bibliotheken, um zu verhindern, dass aufgeblähte Pakete die Startzeiten der Geräte verlangsamen.
- Kontinuierliches Code-Refactoring implementieren: Widmen Sie einen festen Prozentsatz der Entwicklungs-Sprints dem Zusammenführen redundanter Verzeichnisse zu modularen Komponenten.
Produkt- & Wachstumsstrategie-Checkliste
- Speicherauslastung optimieren: Bewerten Sie App-Abhängigkeiten, um Garbage-Collection-Pausen zu minimieren und clientseitiges Thermal Throttling zu vermeiden.
- SDK-Auswahl straffen: Priorisieren Sie zweckgebundene, hochoptimierte Drittanbieter-Tools, die zuverlässige Ergebnisse mit null überflüssigen Abhängigkeiten liefern.
- API-Workflow-Latenz überwachen: Verfolgen Sie Standard-Latenzmetriken von den ersten Kampagnenklicks bis zum serverseitigen Abgleich der Installationen, um die Datenkontinuität zu bestätigen.
Durch die Etablierung dieser strukturierten Richtlinien können Entwicklungsteams ihre Anwendungen auf sicherere, konformere Architekturen umstellen und gleichzeitig die operative Kontinuität wahren.
Häufig gestellte Fragen (FAQ)
Ist KI-generierter Code schlecht für die Wartbarkeit von Software?
Sollten Entwickler KI-Coding-Tools für komplexe Architekturen vertrauen?
Verbessert das Löschen von redundantem KI-Code die Systemleistung?
Wichtige Erkenntnisse für Engineering-Teams
Da KI-gestützte Entwicklung zum Mainstream wird, verlagern Softwareteams ihre Aufmerksamkeit von der Generierung von mehr Code hin zur Aufrechterhaltung gesünderer Codebasen. Das Aufkommen von Unternehmen, die sich auf KI-Code-Bereinigung spezialisiert haben, spiegelt einen breiteren Wandel wider, wie Organisationen Softwarequalität im Zeitalter der generativen KI bewerten. Sich darauf zu verlassen, dass automatisierte Agenten strukturelle Probleme wiederholt beheben, wird weiterhin technische Schulden anhäufen. Der Wiederaufbau interner Ingenieurrichtlinien rund um strikte Modularität, automatisierte Tests und hochoptimierte Drittanbieter-Abhängigkeiten ist essenziell, um die Skalierbarkeit von Anwendungen zu erhalten.
Mit Blick auf die Zukunft werden erfolgreiche Organisationen die Wartbarkeit der Codebasis gegenüber der reinen Generierungsgeschwindigkeit priorisieren. Durch die Integration leichtgewichtiger Infrastruktur ohne Abhängigkeiten und die Verlagerung komplexer Tracking-Zustände auf serverseitige Datenbanken können Entwickler ihre Deployment-Pipelines vor redundanter Code-Ansammlung schützen. Dieser Wandel geht nicht nur um die Anpassung an automatisierte Tools; es geht darum, stabile, nachhaltige Softwarestrukturen in einer von Agenten dominierten Engineering-Umgebung aufzubauen.
Share this article



