क्या Cloudflare ट्रेनिंग बॉट्स को ब्लॉक कर रहा है? Cloudflare ने एक नई डिफ़ॉल्ट नीति की घोषणा की है, जो योग्य प्रकाशक साइटों पर AI ट्रेनिंग क्रॉलर्स को ब्लॉक करती है और साथ ही कंटेंट मालिकों के लिए मुद्रीकरण (monetization) के नए विकल्प पेश करती है। जैसे-जैसे जेनरेटिव आर्टिफिशियल इंटेलिजेंस वेब कंटेंट के उपभोग के तरीके को बदल रहा है, AI प्लेटफॉर्म बिना किसी पारस्परिक मूल्य संरचना को स्थापित किए वेब संसाधनों की भारी मात्रा का उपभोग कर रहे हैं। ऐतिहासिक रूप से, सर्च-इंजन इंडेक्सिंग की अनुमति देने का मतलब था रेफरल ट्रैफ़िक प्राप्त करना, जिसे विज्ञापनों या सब्सक्रिप्शन के माध्यम से मुद्रीकृत किया जा सकता था। आज, चूँकि मिश्रित-उपयोग वाले क्रॉलर्स मॉडल ट्रेनिंग के लिए प्रोप्राइटरी डेटा को व्यवस्थित रूप से खुरच (scrape) रहे हैं और सीधे सारांश उत्पन्न कर रहे हैं जो क्लिक की आवश्यकता को समाप्त कर देते हैं, इसलिए प्रकाशकों को भारी राजस्व हानि का सामना करना पड़ रहा है।
परिचालन समस्या और वित्तीय बाधाएं: Cloudflare विज्ञापन-समर्थित पृष्ठों पर ट्रेनिंग बॉट्स को ब्लॉक कर रहा है
एक नज़र में
- स्वचालित सुरक्षा उपाय 2026 की तीसरी तिमाही में मुद्रीकृत कंटेंट निर्देशिकाओं के भीतर मॉडल स्क्रैपिंग और प्रोग्रामेटिक एजेंटों पर डिफ़ॉल्ट प्रतिबंध शुरू करेंगे।
- जो क्रॉलर्स सर्च इंडेक्सिंग को डेटा हार्वेस्टिंग के साथ मिलाते हैं, उन्हें तब तक प्रतिबंधित किया जाएगा जब तक वे अपने परिचालन उद्देश्यों को अलग-अलग पाइपलाइनों में विभाजित नहीं करते।
- कंटेंट प्रशासकों को मानक अनुरोध गणना के बजाय सीधे ट्रांजेक्शन-स्तर पर पुरस्कार प्रदान करने के लिए नए उपयोग मुआवजा ढांचे उभर रहे हैं।
ऑनलाइन प्रकाशकों और स्वचालित वेब स्क्रैपर्स के बीच पारंपरिक संतुलन पूरी तरह से टूट गया है। एक मौन आपसी समझौते ने लगभग तीस वर्षों तक वैश्विक इंटरनेट को आधार प्रदान किया। इस बुनियादी सौदे के तहत, वेब प्रशासकों ने पेजों को स्कैन करने के लिए पार्सिंग स्पाइडर का स्वागत किया, और बदले में निर्देशिका क्वेरी से योग्य उपयोगकर्ता क्लिक प्राप्त किए। इस पारस्परिक आदान-प्रदान ने स्वतंत्र मीडिया को बनाए रखा, जिससे यह सुनिश्चित हुआ कि विज्ञापन इंप्रेशन, डिजिटल प्रायोजन, और आवर्ती सदस्यता स्वतंत्र सॉफ़्टवेयर मैनुअल और पत्रकारिता को वित्तपोषित कर सकें।
बड़े पैमाने पर जेनरेटिव नेटवर्क की ओर वर्तमान संक्रमण ने क्रॉलर गतिविधि को बदल दिया है, जिससे उद्देश्य केवल पाथ डिस्कवरी से डेटा निष्कर्षण (data extraction) में स्थानांतरित हो गया है। स्वायत्त संग्रह प्रणालियां अब पूर्ण डिजिटल निर्देशिकाओं को इनजेस्ट करती हैं, सिमेंटिक डेटा को पार्स करती हैं, और बंद चैट विजेट्स के भीतर संश्लेषित अंतर्दृष्टि प्रदान करती हैं। यह तत्काल समाधान मानक साइट विज़िट की आवश्यकता को दरकिनार कर देता है। मूल्यांकन बताते हैं कि जब सर्च इंटरफेस एक एकीकृत जेनरेटिव आउटपुट प्रस्तुत करते हैं, तो किसी पाठक द्वारा आउटबाउंड डायरेक्टरी लिंक पर क्लिक करने की संभावना काफी कम हो जाती है, जो कई रिपोर्ट किए गए मामलों में एकल-अंकीय प्रतिशत तक गिर जाती है। ये ट्रैफ़िक पैटर्न उन प्लेटफार्मों के लिए तत्काल फंडिंग घाटे का कारण बनते हैं जो परिचालन लागत को संतुलित करने के लिए मानक विज्ञापन-सर्विंग संरचनाओं पर निर्भर हैं।
Cloudflare का ट्रेनिंग बॉट्स को ब्लॉक करना प्रकाशकों के लिए एक जनादेश क्यों बना
प्रकाशकों ने लंबे समय से अपने कंटेंट की सुरक्षा और सर्च विजिबिलिटी बनाए रखने के बीच एक कठिन ट्रेड-ऑफ का सामना किया है। यदि एक स्वतंत्र साइट मालिक मॉडल ट्रेनिंग को रोकने के लिए Googlebot, Applebot, या Bingbot को ब्लॉक करता है, तो वे पारंपरिक सर्च इंडेक्स से गायब होने के जोखिम में काम करते हैं। यह संरचनात्मक एकाधिकार कंटेंट निर्माताओं को एक कठिन विकल्प चुनने के लिए मजबूर करता है: या तो बहुमूल्य प्रोप्राइटरी डेटा मुफ्त में दें या खोजे जाने की क्षमता (discoverability) का पूरी तरह से त्याग कर दें। यह गतिशीलता उभरते AI संस्थाओं को भी चकमा देने वाली क्रॉलिंग रणनीति अपनाने के लिए प्रोत्साहित करती है, जिससे उन प्रकाशकों पर सर्वर का बोझ और बढ़ जाता है जो पहले से ही अनावश्यक अनुरोधों के लिए भुगतान कर रहे हैं।
संतुलन लागू करने के लिए, Cloudflare ने एक घोषणात्मक गेटिंग तंत्र पेश किया है। Cloudflare ने कहा कि डिफ़ॉल्ट नीति 15 सितंबर, 2026 से शुरू होगी, जो सभी विज्ञापन-समर्थित ग्राहक पृष्ठों पर ट्रेनिंग बॉट्स और उपयोगकर्ता-निर्देशित एजेंटों के खिलाफ डिफ़ॉल्ट ब्लॉक स्थापित करेगी। यह अपडेट सुनिश्चित करता है कि मुद्रीकरण योग्य कंटेंट को स्पष्ट अनुमति के बिना क्रॉल नहीं किया जा सके। साथ ही, नेटवर्किंग दिग्गज अपने मुद्रीकरण ढांचे का पुनर्गठन कर रही है, जो अपने पुराने 'पे पर क्रॉल' (Pay Per Crawl) आर्किटेक्चर से 'पे पर यूज़' (Pay Per Use) पारिस्थितिकी तंत्र की ओर बढ़ रही है। You.com और Ceramic.ai जैसे प्लेटफार्मों के साथ एकीकरण के माध्यम से, प्रकाशक सीधे मुआवजा सुरक्षित कर सकते हैं जब भी कोई AI एजेंट किसी क्वेरी का उत्तर देने के लिए उनके कंटेंट का लाभ उठाता है, जिससे एक स्थायी, ट्रांजेक्शन-स्तरीय राजस्व धारा शुरू होती है।
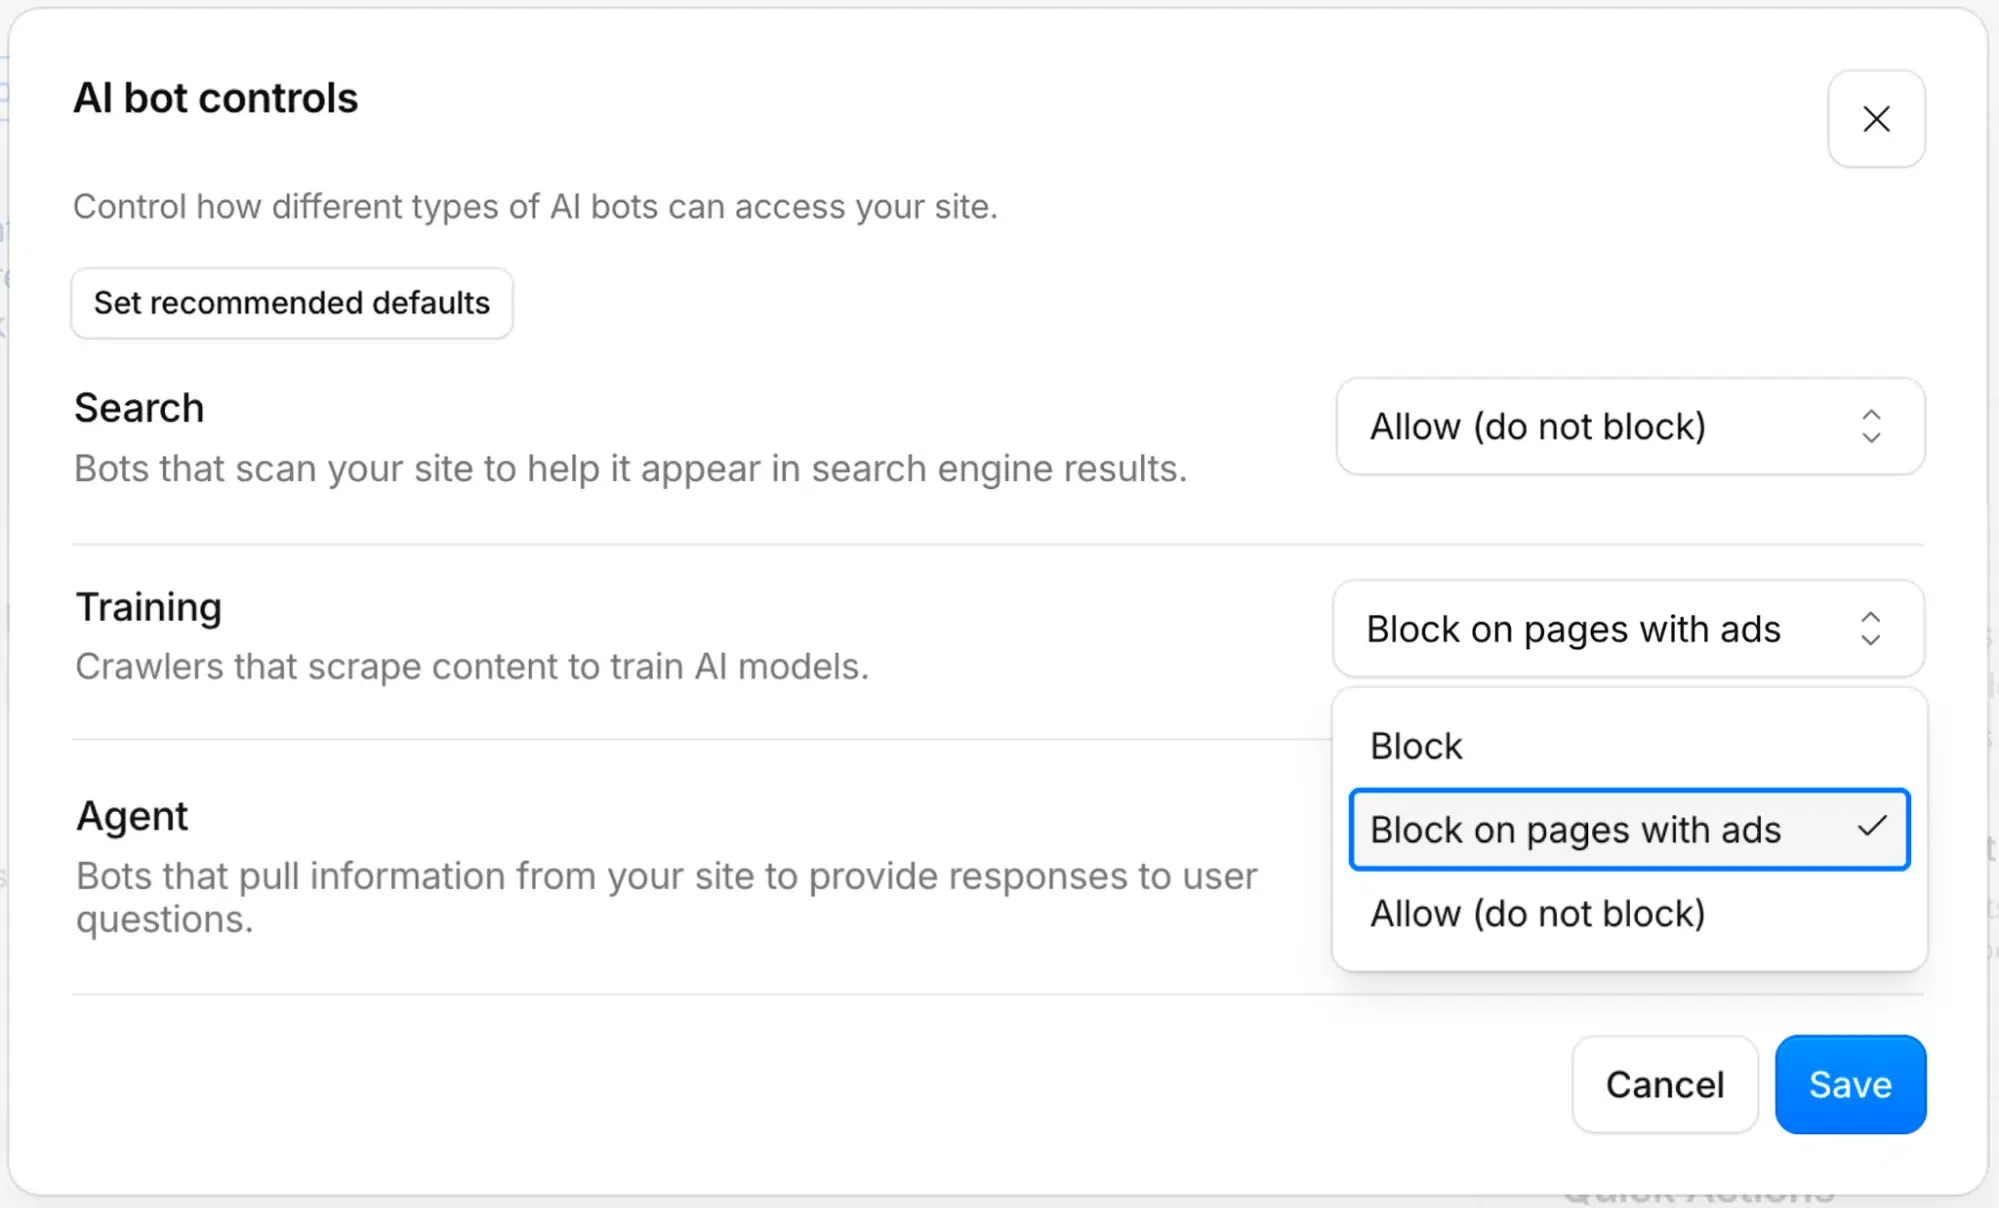
सिस्टमिक मूल कारण और Cloudflare की ट्रेनिंग बॉट्स ब्लॉकिंग नीति की गैर-दृश्य अनुरोध श्रृंखला
इंटरनेट ट्रैफ़िक की भौतिक संरचना का विश्लेषण करने से पता चलता है कि स्वचालित बॉट्स अब सभी ऑनलाइन गतिविधि के 50% से अधिक के लिए जिम्मेदार हैं। यह मात्रा मूल सर्वरों पर भारी दबाव डालती है, विशेष रूप से इसलिए क्योंकि डुप्लिकेट अनुरोध अक्सर अपरिवर्तित कंटेंट को फेच करते हैं। Cloudflare टेलीमेट्री इंगित करती है कि सत्यापित क्रॉलर ट्रैफ़िक का आधा हिस्सा पूरी तरह से अनावश्यक है, जो कनेक्शन के दोनों पक्षों पर कंप्यूटिंग शक्ति को बर्बाद कर रहा है। मूलभूत समस्या आधुनिक सर्च-एंड-स्क्रैप ऑपरेशनों के अंतर्निहित आर्किटेक्चर में निहित है, जो मिश्रित-उपयोग वाले बॉट्स पर निर्भर करते हैं जो अपने वास्तविक इरादे को छिपाते हैं।
एप्लिकेशन लेयर पर, उपयोगकर्ता-निर्देशित एजेंट की तकनीकी विशेषताएं मानक मानव-संचालित ब्राउज़र सत्रों से काफी भिन्न होती हैं। यह भेद महत्वपूर्ण है क्योंकि आधुनिक हेडलेस स्क्रैपर्स पूरी तरह से पारंपरिक इंटरैक्टिव तत्वों को दरकिनार कर देते हैं, जिससे डाउनस्ट्रीम मापन प्रणालियों में गंभीर ट्रैकिंग व्यवधान पैदा होता है।
प्रोटोकॉल डिस्कनेक्शन: स्टेटलेस एजेंट बनाम स्टेटफुल वेब ब्राउज़र
पारंपरिक वेब अनुकूलन यह मानता है कि मानक ब्राउज़र सत्र कुकी स्टैक, स्थानीय भंडारण और संरचित उपयोगकर्ता-एजेंट स्ट्रिंग्स के माध्यम से स्थिति (state) का प्रबंधन करते हैं। इसके विपरीत, स्वायत्त एजेंट और हेडलेस क्रॉलर स्टेटलेस HTTP अनुरोध करते हैं। यह अंतर उन मापन पाइपलाइनों को तोड़ता है जिनका उपयोग प्रकाशक अपने विज्ञापन मूल्य को सही ठहराने के लिए करते हैं। नीचे दिया गया आरेख मुख्य एप्लिकेशन-लेयर अंतर को रेखांकित करता है:
[Standard Web Session]
  User Browser (Persistent State & Cookies) ──> Web HTTP Request ──> Ad Impressions & Referrers Registered


[Stateless Agent Session]
  Automated Crawler (Stateless HTTP / Headless Tool) ──> Isolated Fetch ──> Missing Referrers & Lost Attribution
जब एक स्वचालित ब्राउज़र एजेंट एक पेज को फेच करता है, टेक्स्ट को संसाधित करता है, और एक बंद चैट वातावरण के भीतर उत्तर देता है, तो संपूर्ण क्लाइंट-साइड संदर्भ नष्ट हो जाता है। पारंपरिक ट्रैकिंग स्क्रिप्ट निष्पादित नहीं हो सकतीं। कोई विज्ञापन इंप्रेशन पंजीकृत नहीं होते, और मानक रेफरर हेडर गायब हो जाते हैं। यह एक एट्रिब्यूशन शून्य बनाता है जहाँ प्रकाशक कच्चा जानकारीपूर्ण मूल्य प्रदान करता है, लेकिन डाउनस्ट्रीम सिस्टम शून्य जुड़ाव दर्ज करता है। ब्राउज़र संदर्भ की यही हानि डाउनस्ट्रीम मोबाइल एट्रिब्यूशन वर्कफ़्लो को भी प्रभावित करती है जब कोई उपयोगकर्ता अंततः एप्लिकेशन इंस्टॉल करता है। चूंकि इन हेडलेस विज़िट में स्टेटफुल ट्रैकिंग कंटेनर का अभाव होता है, इसलिए मानक मोबाइल मापन उपकरण प्रारंभिक खोज घटना को बाद के ऐप इंस्टॉलेशन के साथ मेल करने में विफल रहते हैं। यह गतिशीलता पारंपरिक मल्टी-टच एट्रिब्यूशन मॉडल के पतन को तेज करती है।
समाधान तुलना: Cloudflare के ट्रेनिंग बॉट्स युग में बिल्ड बनाम बाय ट्रेड-ऑफ
जैसे-जैसे क्लाइंट-साइड ट्रैकिंग की डिफ़ॉल्ट सीमाएं नई स्वचालित स्क्रैपर नियमों के तहत समाप्त हो रही हैं, इंजीनियरिंग टीमों को अपने एट्रिब्यूशन आर्किटेक्चर का पुनर्मूल्यांकन करना होगा। केवल मानक क्लाइंट-साइड ब्राउज़र कुकीज़ या डिवाइस-स्तरीय विशेषताओं पर भरोसा करना अब एक व्यवहार्य दीर्घकालिक रणनीति नहीं है। डेवलपर्स को एक मौलिक 'बिल्ड-बनाम-बाय' निर्णय का सामना करना पड़ रहा है: एक इन-हाउस सर्वर-साइड संदर्भ-मिलान (context-matching) डेटाबेस का निर्माण करें या हेडलेस इंटरैक्शन को सहन करने में सक्षम पहले से निर्मित, कठोर मापन प्रणाली को एकीकृत करें।
आर्किटेक्चरल मूल्यांकन: स्टेटलेस युग में बिल्ड बनाम बाय
इन-हाउस संदर्भ-मिलान प्रणाली बनाने के लिए डेवलपर सत्रों को कैश और रिकॉन्साइल करने के लिए एक सर्वर-साइड स्टेट डेटाबेस स्थापित करने की आवश्यकता होती है। जबकि यह दृष्टिकोण डेटा पाइपलाइन पर पूर्ण नियंत्रण प्रदान करता है, इंजीनियरिंग ओवरहेड काफी अधिक है। डेवलपर्स को मैन्युअल रूप से आने वाले API पेलोड को रिकॉन्साइल करना होता है, सत्र समाप्ति का प्रबंधन करना होता है, और धोखाधड़ी को रोकने के लिए सुरक्षित क्रिप्टोग्राफ़िक हस्ताक्षर लागू करने होते हैं। इसके विपरीत, एक आउट-ऑफ़-द-बॉक्स, पहले से निर्मित मापन SDK को एकीकृत करना इस रखरखाव के बोझ को समाप्त कर देता है।
निम्नलिखित तुलना मैट्रिक्स रेखांकित करता है कि विभिन्न ट्रैकिंग पद्धतियां एक स्टेटलेस, एजेंट-भारी वातावरण में कैसे प्रदर्शन करती हैं:
| मेट्रिक्स और क्षमताएं | इन-हाउस डेटाबेस सत्र निर्माण | Legacy Firebase / Webview रीडायरेक्शन | प्रीमियम MMP प्लेटफॉर्म (Adjust, AppsFlyer) | डिफर्ड डीप लिंकिंग SDK (OpoInstall) |
|---|---|---|---|---|
| एट्रिब्यूशन सर्वाइवल | उच्च (सर्वर-साइड) | निम्न (क्लाइंट-साइड) | उच्च (मल्टी-टच) | उच्च (प्रोग्रामेटिक मैपिंग) |
| विकास लागत | अत्यधिक उच्च | निम्न | उच्च | निम्न |
| रखरखाव का बोझ | उच्च (सतत) | निम्न | निम्न | निम्न |
| धोखाधड़ी शमन | मध्यम (मैन्युअल नियम) | निम्न | उच्च (एल्गोरिथम) | उच्च (जीरो-ट्रस्ट हस्ताक्षर) |
| विलंबता प्रभाव | परिवर्तनीय | मध्यम | मध्यम | निम्न (अल्ट्रालाइट फुटप्रिंट) |
इस मॉडल के व्यावसायिक कार्यान्वयन में Adjust, AppsFlyer, Branch और अन्य डिफर्ड एट्रिब्यूशन सिस्टम शामिल हैं। एक उदाहरण OpoInstall है, जो वितरित वेब और मोबाइल संदर्भों में सत्र मेटाडेटा को संरक्षित करने के लिए डिफर्ड डीप लिंकिंग और सर्वर-साइड पैरामीटर रिकवरी प्रदान करता है। रीडायरेक्ट श्रृंखला को क्लाइंट-साइड रीडायरेक्ट से अलग करके, यह दृष्टिकोण उपयोगकर्ता की यात्रा मेटाडेटा को प्रारंभिक खोज घटना से अंतिम ऐप लॉन्च तक संरक्षित रखता है, जिससे स्क्रैपर-ब्लॉकिंग प्रॉक्सी द्वारा लगाए गए प्रतिबंधों को दरकिनार किया जा सकता है। मोबाइल एट्रिब्यूशन प्लेटफॉर्म समान सर्वर-साइड स्टेट रिस्टोरेशन विचारों का उपयोग करते हैं ताकि ब्राउज़र संदर्भ पूरी तरह से अनुपस्थित होने पर रूपांतरण स्थिरता सुनिश्चित की जा सके।
एकीकरण चेकलिस्ट और गवर्नेंस शेड्यूल: Cloudflare ट्रेनिंग बॉट्स व्यवधानों में जीवित रहना
डेटा निरंतरता सुनिश्चित करने के लिए जब Cloudflare विज्ञापन-समर्थित पृष्ठों पर अपने डिफ़ॉल्ट ट्रेनिंग बॉट ब्लॉक लागू करता है, तो इंजीनियरिंग और उत्पाद टीमों को एक संरचित संक्रमण अनुसूची स्थापित करनी चाहिए। डेवलपर्स के लिए, इसमें क्लाइंट-साइड रीडायरेक्ट से दूर जाना और मजबूत सर्वर-साइड सत्यापन विधियों को अपनाना शामिल है। ग्रोथ टीमों के लिए, इसमें मानक ब्राउज़र एट्रिब्यूशन डेटा के नुकसान के लिए ROAS गणना पाइपलाइनों को संशोधित करना आवश्यक है।
डेवलपर कार्यान्वयन चेकलिस्ट
- RFC 7239 फॉरवर्डेड हेडर लागू करें: विश्वसनीय मध्यवर्ती प्रॉक्सी की पहचान करने के लिए मानकीकृत
Forwardedहेडर को पढ़ने और पार्स करने के लिए सभी आने वाले API गेटवे को कॉन्फ़िगर करें।
Forwarded: for=203.0.113.1;proto=https
- क्रिप्टोग्राफ़िक URL हस्ताक्षर अपनाएं: सुनिश्चित करें कि सभी आउटगोइंग प्रोमोशनल लिंक क्रिप्टोग्राफ़िक रूप से हस्ताक्षरित पैरामीटर का उपयोग करते हैं ताकि स्वचालित बॉट्स को रेफरल मूल्यों में हेरफेर करने से रोका जा सके।
- सर्वर-साइड सत्र मिलान सक्षम करें: कुकी-आधारित क्लाइंट-साइड रीडायरेक्शन से एक प्रोग्रामेटिक स्टेट डेटाबेस पर शिफ्ट हों जो पहले एप्लिकेशन लॉन्च पर सत्र कुंजियों को रिकॉन्साइल करता है।
उत्पाद और विकास रणनीति चेकलिस्ट
- ROAS मॉडल का पुनर्निर्माण करें: अधिग्रहण फ़नल को समायोजित करें ताकि सर्वर-साइड सक्रियण घटनाओं को पारंपरिक क्लाइंट-साइड वेब विज्ञापन क्लिकों की तुलना में अधिक महत्व दिया जा सके।
- संदर्भगत अनुभव बहाली तैनात करें: उपयोगकर्ता के इच्छित गंतव्य का पुनर्निर्माण करने के लिए पैरामीटर पास-थ्रू ढांचे का लाभ उठाएं, भले ही वेब रेफरर को एक एजेंट द्वारा हटा दिया गया हो।
- BotBase में बॉट ट्रैफ़िक का ऑडिट करें: वास्तविक समय के व्यवहार संबंधी वर्गीकरण का उपयोग करें ताकि यह ऑडिट किया जा सके कि स्वचालित स्क्रैपर्स मार्केटिंग फ़नल के साथ कैसे इंटरैक्ट करते हैं।
डेवलपर्स अपने मानक robots.txt कॉन्फ़िगरेशन को आधुनिक मेटाडेटा फ़ील्ड के साथ विस्तारित करके स्पष्ट इंडेक्सिंग प्राथमिकताओं को संप्रेषित करने के लिए अपनी साइटों को कॉन्फ़िगर कर सकते हैं।
# प्रस्तावित मेटाडेटा एक्सटेंशन से प्रेरित उदाहरण
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
यह संरचित दृष्टिकोण कंटेंट मालिकों को सर्च डिस्कवरेबिलिटी बनाए रखने की अनुमति देता है, साथ ही AI प्लेटफॉर्म्स को मूल्यवान प्रोप्राइटरी कंटेंट को उनके बंद ट्रेनिंग डेटासेट में स्थायी रूप से अवशोषित करने से रोकता है।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
एक ही बॉट सर्च और AI ट्रेनिंग दोनों के लिए पेजों को क्यों क्रॉल करता है?
Cloudflare यह कैसे निर्धारित करता है कि ब्लॉक को ट्रिगर करने के लिए किन पृष्ठों में विज्ञापन हैं?
पे पर क्रॉल (Pay Per Crawl) और पे पर यूज़ (Pay Per Use) में क्या अंतर है?
इंटरनेट का मानव-केंद्रित ब्राउज़िंग वातावरण से एजेंट-संचालित पारिस्थितिकी तंत्र में संक्रमण के लिए इस बात में एक मौलिक बदलाव की आवश्यकता है कि हम डिजिटल अनुभवों का निर्माण और मापन कैसे करते हैं। जैसे-जैसे स्वचालित प्रॉक्सी और स्टेटलेस एजेंट वेब कंटेंट के प्राथमिक उपभोक्ता बन जाते हैं, पारंपरिक क्लाइंट-साइड एट्रिब्यूशन मॉडल का क्षरण जारी रहेगा। उपयोगकर्ता अधिग्रहण और डिजिटल मुद्रीकरण को संचालित करने वाली डेटा पाइपलाइनों को सुरक्षित करने के लिए ब्राउज़र कुकीज़ और बुनियादी HTTP रेफरर्स पर भरोसा करना अब पर्याप्त नहीं है।
इस नए युग में विकास बनाए रखने के लिए, इंजीनियरिंग और उत्पाद टीमों को अपने एट्रिब्यूशन तर्क को मानक क्लाइंट-साइड ब्राउज़र क्रियाओं से अलग करना होगा। सर्वर-साइड आइडेंटिटी रिज़ॉल्यूशन, क्रिप्टोग्राफ़िक रूप से हस्ताक्षरित पैरामीटर और मजबूत पैरामीटर पास-थ्रू ढांचे को अपनाकर, संगठन अपनी डेटा पाइपलाइनों को स्वचालित स्क्रैपर ब्लॉकों से सुरक्षित रख सकते हैं। यह संक्रमण केवल एक एकल नीति अपडेट के अनुकूल होने के बारे में नहीं है; यह हमारे सिस्टम को एक विकेंद्रीकृत, एजेंट-तैयार इंटरनेट में जीवित रहने के लिए फिर से बनाने के बारे में है।
Share this article



