 Hynix विशेषज्ञ का यह दावा कि 'GPU Idle क्यों रहता है? और इसमें HBM मेमोरी की मुख्य भूमिका क्यों है', अत्यंत महत्वपूर्ण है। KAIST के प्रोफेसर जोंगहो किम, जिन्होंने HBM अनुसंधान पर SK Hynix के साथ व्यापक रूप से सहयोग किया है, की एक प्रस्तुति के अनुसार, AI इन्फरेंस के दौरान GPU का उपयोग कच्ची कंप्यूटिंग शक्ति के बजाय मेमोरी बैंडविड्थ द्वारा अधिक सीमित है। इस बढ़ती 'मेमोरी वॉल' ने हाई बैंडविड्थ मेमोरी (HBM) को AI इंफ्रास्ट्रक्चर की सबसे महत्वपूर्ण तकनीकों में से एक बना दिया है। जैसे-जैसे जेनरेटिव आर्टिफिशियल इंटेलिजेंस प्लेटफॉर्म प्रशिक्षण (training) युग से इन्फरेंस (inference) युग की ओर बढ़ रहे हैं, प्रदर्शन की मुख्य बाधा प्रोसेसर की क्षमता से हटकर मेमोरी बस के थ्रूपुट पर आ गई है। स्टैंडर्ड ग्राफिक्स प्रोसेसिंग यूनिट्स (GPUs) को भारी समानांतर गणनाओं (parallel computations) को संभालने के लिए डिज़ाइन किया गया है। हालाँकि, चूंकि प्रत्येक इन्फरेंस चरण में मेमोरी से अरबों पैरामीटर पढ़ने, गणना करने और स्टेट्स को वापस लिखने की आवश्यकता होती है, इसलिए प्रोसेसर अपना अधिकांश समय डेटा के लिए स्टैंडर्ड बसों में यात्रा करने की प्रतीक्षा करते हुए 'Idle' बिताते हैं।
HBM मेमोरी क्यों महत्वपूर्ण है: हार्डवेयर सीमाओं के साथ हाई-थ्रूपुट पाइपलाइनों का संरेखण
एक नज़र में
- उद्योग विश्लेषण बताता है कि लाखों स्टैंडर्ड ग्राफिक्स प्रोसेसिंग यूनिट्स के उपयोग के बावजूद, मेमोरी बस ट्रांसफर में देरी के कारण वास्तविक कंप्यूट उपयोग केवल दस से तीस प्रतिशत तक सीमित है।
- चिप स्केलिंग की भौतिक सीमाएं मेमोरी-केंद्रित कंप्यूटिंग की ओर एक बदलाव ला रही हैं, जिसमें वर्टिकली स्टैक्ड हाई-बैंडविड्थ मेमोरी (HBM) आर्किटेक्चर का उपयोग किया जा रहा है।
- अगली पीढ़ी की 3D कंपोजिट पैकेजिंग से डेटा ट्रांसफर बाधाओं को हल करने के लिए ग्राफिक्स प्रोसेसिंग यूनिट्स, हाई-स्पीड ऑन-पैकेज SRAM कैश, और हाई-कैपेसिटी 3D NAND फ्लैश स्टोरेज को स्टैक करने की उम्मीद है।
वैश्विक कंप्यूटिंग इंफ्रास्ट्रक्चर एक संरचनात्मक संकट का सामना कर रहा है। कई वर्षों से, बड़े AI मॉडल बनाने की दौड़ में कच्चे कंप्यूटिंग पावर को बढ़ाने पर ध्यान केंद्रित किया गया है। उद्यमों और क्लाउड प्रदाताओं ने ग्राफिक्स प्रोसेसिंग यूनिट्स (GPUs) के विशाल क्लस्टर हासिल करने के लिए अरबों डॉलर का निवेश किया है। प्रारंभिक प्रशिक्षण युग के दौरान यह ध्यान अत्यधिक तार्किक था, जब मॉडल का प्रशिक्षण निरंतर बैकप्रोपैगेशन गणनाओं पर निर्भर था। उन वर्कलोड के तहत, समानांतर कंप्यूटिंग इकाइयां अधिकतम क्षमता पर काम करती थीं, जैसा कि NVIDIA हॉपर आर्किटेक्चर व्हाइटपेपर में विस्तार से बताया गया है।
हालाँकि, जैसे-जैसे एप्लिकेशन इन्फरेंस युग की ओर बढ़ रहे हैं, इंजीनियरिंग की आवश्यकताएं बदल गई हैं। इन्फरेंस परिदृश्यों में, मुख्य चुनौती वेट्स (weights) को अपडेट करना नहीं है, बल्कि तत्काल प्रश्नों के उत्तर देने के लिए प्रोसेसर तक विशाल, पूर्व-प्रशिक्षित पैरामीटर्स को स्ट्रीम करना है। प्रत्येक उत्पन्न टोकन के लिए हाई-बैंडविड्थ मेमोरी में संग्रहीत अरबों मॉडल पैरामीटर्स तक बार-बार पहुंच की आवश्यकता होती है। चूंकि स्टैंडर्ड बस आर्किटेक्चर प्रोसेसर की गति से मेल खाने के लिए डेटा को पर्याप्त तेज़ी से स्थानांतरित नहीं कर सकते, इसलिए कंप्यूटिंग कोर डेटा की कमी महसूस करते हैं, जिसके परिणामस्वरूप अत्यधिक उच्च आइडल रेट्स (idle rates) मिलते हैं। इस प्रदर्शन बाधा पर कोरिया एडवांस्ड इंस्टीट्यूट ऑफ साइंस एंड टेक्नोलॉजी (KAIST) जैसे शैक्षणिक निकायों और NVIDIA तथा SK Hynix जैसे हार्डवेयर डेवलपर्स द्वारा प्रकाशित तकनीकी उद्योग रिपोर्टों में चर्चा की गई है।
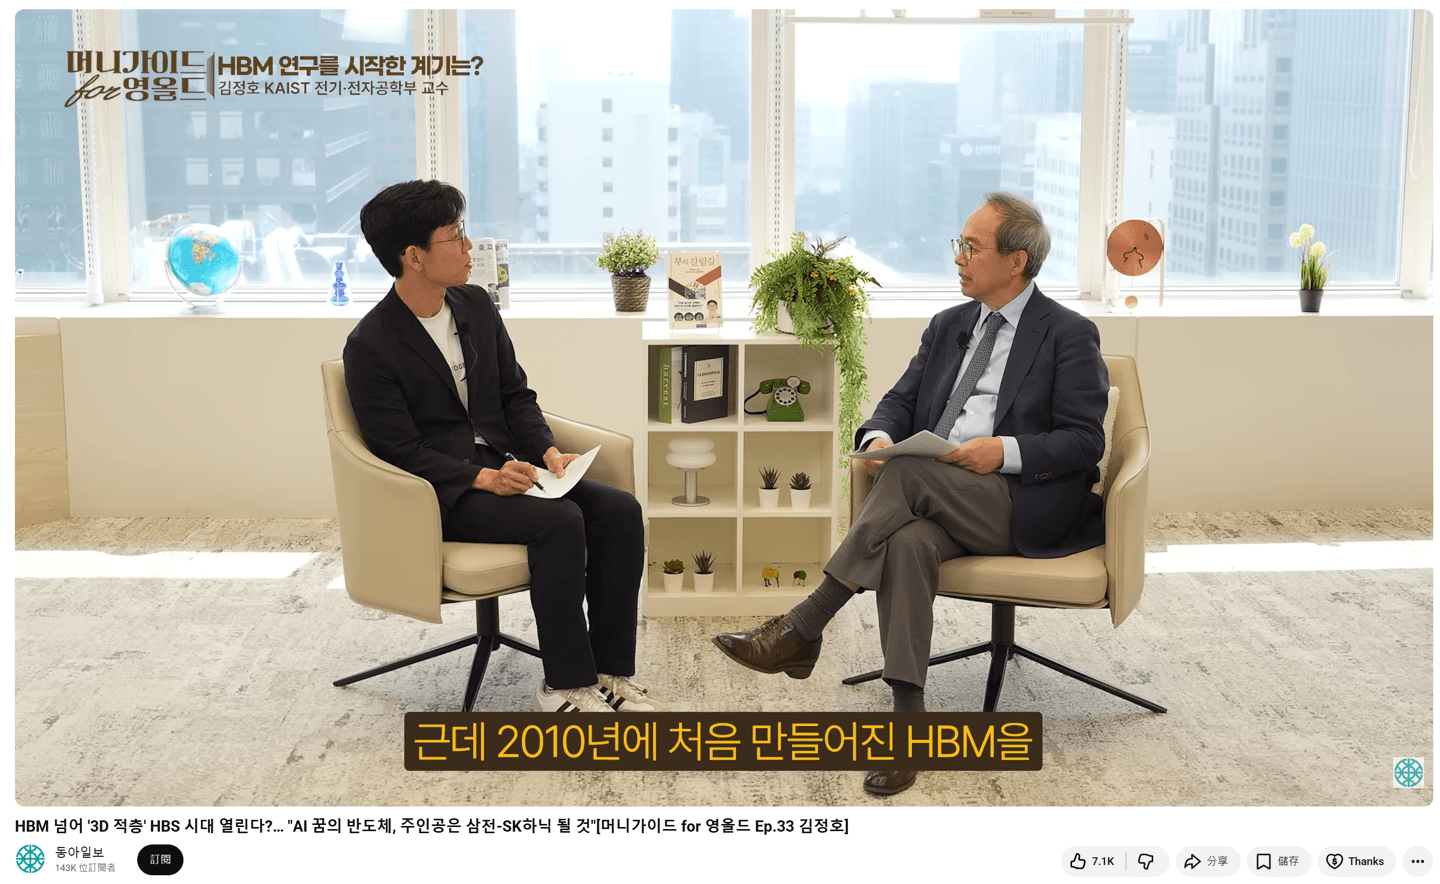
यह प्रदर्शन अंतर उन भौतिक बाधाओं को प्रदर्शित करता है जो बताती हैं कि इन्फरेंस युग में HBM मेमोरी क्यों महत्वपूर्ण है। KAIST TERA लैब द्वारा प्रकाशित HBM तकनीकी रोडमैप के अनुसार, भविष्य की HBM पीढ़ियां अतिरिक्त DRAM स्टैकिंग, TSV एकीकरण, उन्नत पैकेजिंग और थर्मल अनुकूलन के माध्यम से बैंडविड्थ बढ़ाना जारी रखेंगी। स्टैंडर्ड DRAM पैकेज में आधुनिक एक्सेलेरेटर की प्रोसेसिंग गति का समर्थन करने के लिए आवश्यक समानांतर लेन की कमी होती है। इस 'मेमोरी वॉल' को पार करने के लिए, हार्डवेयर आर्किटेक्ट्स ने हाई-बैंडविड्थ मेमोरी (HBM) सिस्टम की ओर रुख किया है। DRAM डाइस को वर्टिकली स्टैक करके और चौड़ी, समानांतर बसें स्थापित करने के लिए हजारों सिलिकॉन वायस (TSVs) का उपयोग करके, JEDEC HBM3 विनिर्देश (JESD238) बताता है कि कैसे TSV-आधारित स्टैक्ड मेमोरी पारंपरिक DRAM पैकेज की तुलना में उपलब्ध बैंडविड्थ का नाटकीय रूप से विस्तार करती है। डेवलपर्स के लिए, यह हार्डवेयर विकास हाई-थ्रूपुट सिस्टम के एक मौलिक नियम को दर्शाता है: बाधा लगभग हमेशा ट्रांसपोर्ट लेयर होती है, न कि कंप्यूटेशन नोड।
HBM मेमोरी क्यों महत्वपूर्ण है: इसके पीछे की कार्यप्रणाली
आर्किटेक्चरल स्तर पर, स्टैंडर्ड कंप्यूटर बसें संकीर्ण राजमार्गों की तरह काम करती हैं, जो उच्च-मात्रा वाले डेटासेट के प्रवाह को प्रतिबंधित करती हैं। जब कोई एप्लिकेशन इन्फरेंस कॉल निष्पादित करती है, तो प्रोसेसर को मेमोरी से डेटा पढ़ना होता है, ऑपरेशन पूरा करना होता है, और आउटपुट वापस लिखना होता है। स्टैंडर्ड कॉन्फ़िगरेशन में, यह प्रक्रिया गंभीर विलंबता (latency) पैदा करती है क्योंकि डेटा को मदरबोर्ड पर एक बड़ी भौतिक दूरी तय करनी पड़ती है।
इन ट्रांसपोर्ट-लेयर बाधाओं को हल करने के लिए, अगली पीढ़ी के AI कंप्यूटर थ्री-डायमेंशनल कंपोजिट आर्किटेक्चर में विकसित हो रहे हैं। इस मॉडल के तहत, कंप्यूटिंग कोर को सीधे स्टैक्ड मेमोरी के ऊपर रखा जाता है, जो भौतिक दूरी और विलंबता को कम करने के लिए उन्नत पैकेजिंग का उपयोग करता है।
3D मेमोरी पदानुक्रम: SRAM, DRAM, और NAND को स्टैक करना
विभिन्न प्रकार के डेटा को संभालने के लिए, हार्डवेयर आर्किटेक्ट्स एक स्तरित 3D सेमीकंडक्टर गगनचुंबी संरचना प्रस्तावित कर रहे हैं। यह संरचना डेटा एक्सेस की गति और क्षमता आवश्यकताओं के आधार पर डेटा स्टोरेज को अलग-अलग भौतिक क्षेत्रों में विभाजित करती है:
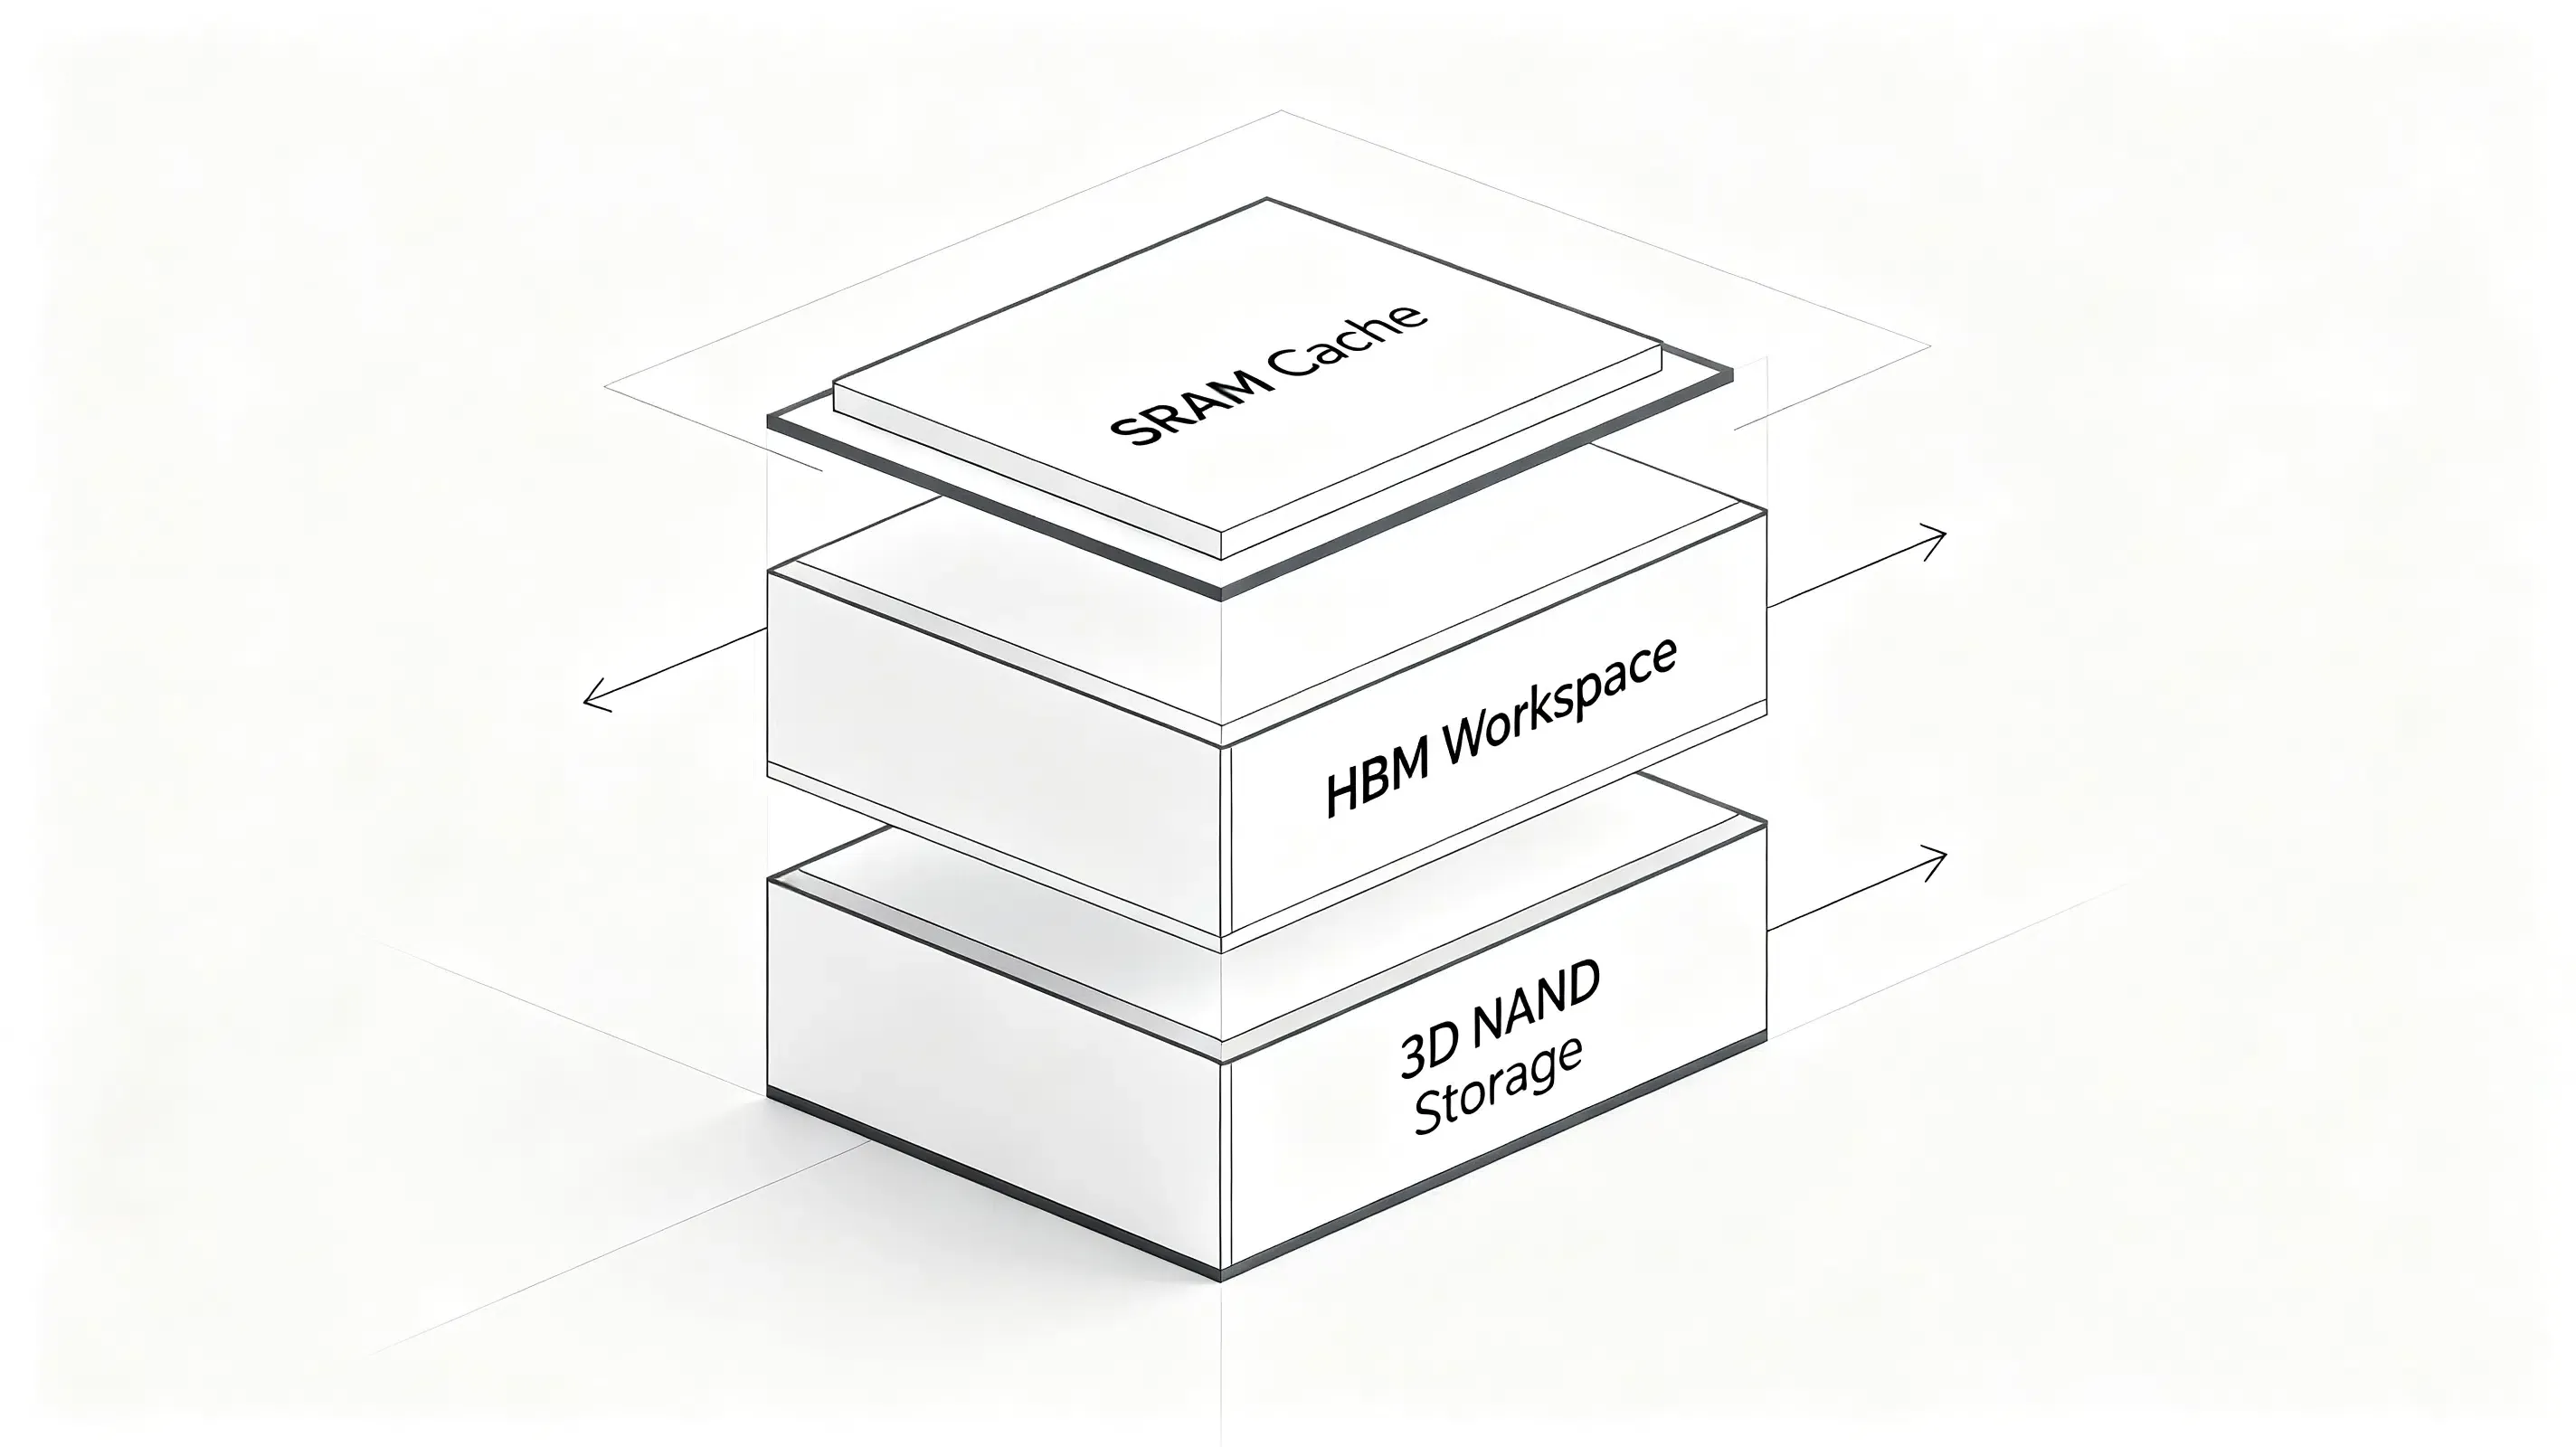
- हाई-स्पीड ऑन-पैकेज SRAM कैश: अंतिम हाई-स्पीड कैश के रूप में कार्य करते हुए, SRAM को सीधे प्रोसेसर के साथ एकीकृत किया जाता है, जो सक्रिय पैरामीटर रजिस्टरों को संभालने के लिए पारंपरिक DRAM की तुलना में मेमोरी एक्सेस विलंबता को काफी कम कर देता है।
- हाई-बैंडविड्थ मेमोरी (HBM): मुख्य सक्रिय वर्कस्पेस के रूप में कार्य करते हुए, HBM सक्रिय पैरामीटर पुनर्प्राप्ति और उच्च-आवृत्ति स्टेट अपडेट को संभालती है, जिसके व्यापक इंटरफ़ेस को JEDEC मानकों द्वारा परिभाषित किया गया है।
- हाई-कैपेसिटी 3D NAND फ्लैश स्टोरेज: हाई बैंडविड्थ फ्लैश (HBF) एक उभरती हुई स्टोरेज आर्किटेक्चर है जिसे KAIST शोधकर्ताओं द्वारा HBM के पूरक के रूप में प्रस्तावित किया गया है। यह भविष्य के AI सिस्टम के लिए काफी बड़ी स्टोरेज क्षमता प्रदान करती है, जो वीडियो, दस्तावेज़ों और स्थायी संवादात्मक यादों को संरक्षित करने के लिए विशाल, दीर्घकालिक भंडारण क्षमता प्रदान करने हेतु वर्टिकली स्टैक्ड NAND फ्लैश का उपयोग करती है।
नीचे दिया गया आरेख इस भौतिक वर्टिकल एकीकरण को दर्शाता है:
                  [ GPU / प्रोसेसर कोर ] (रूफ-लेवल कूलिंग)
                             │
                             ▼
                  [ हाई-स्पीड ऑन-पैकेज SRAM कैश ] (अल्ट्रा-फास्ट वेफर कैश)
                             │
                             ▼
                  [ हाई-बैंडविड्थ मेमोरी ] (सक्रिय वर्कस्पेस DRAM)
                             │
                             ▼
                  [ हाई-कैपेसिटी 3D NAND फ्लैश स्टोरेज ] (दीर्घकालिक NAND स्टोरेज)
यह एकीकृत 3D आर्किटेक्चर यह सुनिश्चित करता है कि स्टैंडर्ड कंप्यूटिंग इकाइयों को लगातार डेटा की आपूर्ति की जाए, जिससे आइडल साइकल कम हो सकें। पारंपरिक DDR मेमोरी HBM से उपलब्ध बैंडविड्थ का केवल एक अंश प्रदान करती है। SK Hynix के साथ संयुक्त रूप से दी गई NVIDIA GTC तकनीकी प्रस्तुतियों के अनुसार, HBM काफी छोटे भौतिक पदचिह्न (footprint) पर कब्जा करते हुए पारंपरिक DDR मेमोरी की तुलना में काफी अधिक बैंडविड्थ प्रदान करती है। विशेष रूप से, HBM2 प्रति स्टैक लगभग 307 GB/s प्रदान करती है, जबकि HBM2E इसे लगभग 358 GB/s तक बढ़ाती है, और HBM3 500 GB/s से अधिक बैंडविड्थ को लक्षित करती है।
हालाँकि मेमोरी बैंडविड्थ और एप्लिकेशन एट्रिब्यूशन अलग-अलग इंजीनियरिंग क्षेत्रों से संबंधित हैं, लेकिन दोनों एक ही आर्किटेक्चरल सिद्धांत को उजागर करते हैं: स्टेट मैनेजमेंट को सीमित स्थानीय संसाधनों से हटाकर स्केलेबल सर्वर-साइड इंफ्रास्ट्रक्चर की ओर ले जाना। जब गोपनीयता दिशानिर्देशों को पूरा करने के लिए उपयोगकर्ता इंटरैक्शन को स्टैंडर्ड क्लाइंट-साइड स्टेट ट्रैकिंग से अलग कर दिया जाता है, तो विभिन्न वेब और मोबाइल वातावरणों में निर्बाध सत्र निरंतरता (session continuity) बनाए रखना अत्यधिक जटिल हो जाता है। जिस तरह प्रोसेसर को स्टेट कॉन्टेक्स्ट से मेल खाने के लिए निरंतर, हाई-स्पीड मेमोरी पाइपलाइनों की आवश्यकता होती है, उसी तरह डाउनस्ट्रीम मार्केटिंग पाइपलाइनों को कमजोर क्लाइंट-साइड कुकीज़ या डिवाइस-स्तरीय विशेषताओं पर निर्भर हुए बिना अलग-अलग इंस्टॉलेशन इवेंट्स को सहसंबंधित करने के लिए मजबूत, सर्वर-साइड डेटा संरक्षण की आवश्यकता होती है।
बिल्ड बनाम बाय: सर्वर-साइड सत्र निरंतरता और डेटा थ्रूपुट का प्रबंधन
जैसे-जैसे आधुनिक कंप्यूटिंग वातावरण स्थानीय, क्लाइंट-साइड पहचानकर्ताओं से दूर जा रहे हैं, वितरित डिजिटल टचपॉइंट्स में सत्र स्थिति (session state) को बनाए रखना एक प्राथमिक इंजीनियरिंग चुनौती बन गया है। डेवलपर्स के लिए, HBM मेमोरी के युग में सत्र स्थितियों का प्रबंधन करने के लिए ऐसे आर्किटेक्चर की आवश्यकता होती है जो डेटा गोपनीयता कानूनों के अनुरूप हों और अत्यधिक सटीक हों। जो संगठन वेब और मोबाइल अनुभवों में उपयोगकर्ता यात्राओं को संरक्षित करना चाहते हैं, वे स्थायी क्लाइंट-साइड पहचानकर्ताओं के बजाय सर्वर-साइड सत्र प्रबंधन पर निर्भर हो रहे हैं। व्यावसायिक आवश्यकताओं के आधार पर, टीमें इन क्षमताओं का निर्माण आंतरिक रूप से कर सकती हैं या मौजूदा एट्रिब्यूशन प्लेटफॉर्म को अपना सकती हैं।
आर्किटेक्चरल मूल्यांकन: कस्टम बिल्ड बनाम मानकीकृत SDK
सर्वर-साइड स्टेट मैचिंग को प्रबंधित करने के लिए एक कस्टम, इन-हाउस सिस्टम का निर्माण अधिकतम लचीलापन प्रदान करता है लेकिन इसके लिए महत्वपूर्ण निरंतर इंजीनियरिंग संसाधनों की आवश्यकता होती है। डेवलपर्स को मैन्युअल रूप से डेटाबेस स्कीमा का निर्माण करना पड़ता है, सुरक्षित क्रिप्टोग्राफिक हैशिंग फ़ंक्शन लिखने पड़ते हैं, और बदलते क्षेत्रीय नियमों का पालन करने के लिए सिस्टम को लगातार अपडेट करना पड़ता है। इसके विपरीत, एक पूर्व-निर्मित, प्रमाणित SDK को तैनात करने से एकीकरण की जटिलता कम हो जाती है और बिना किसी अतिरिक्त ओवरहेड के दीर्घकालिक अनुपालन की गारंटी मिलती है।
नीचे दी गई तालिका सत्र स्थिति और रूपांतरण संदर्भ (conversion context) के प्रबंधन के लिए मानक कार्यप्रणालियों की तुलना करती है:
| समाधान | स्थायित्व | थ्रूपुट | किसके लिए सर्वोत्तम |
|---|---|---|---|
| इन-हाउस सत्र डेटाबेस | उच्च (निरंतर सिंक) | मध्यम (DB लेटेंसी सीमाएं) | अत्यधिक विशिष्ट स्टोरेज लॉजिक वाले कस्टम एंटरप्राइज़ वातावरण |
| ब्राउज़र-आधारित सत्र ट्रैकिंग | निम्न (सत्र कुकीज़) | निम्न (कोई सर्वर लॉगिंग नहीं) | न्यूनतम क्रॉस-डोमेन रूपांतरण आवश्यकताओं के साथ बुनियादी वेबसाइट ट्रैकिंग |
| सर्वर-साइड कैशिंग (जैसे OpoInstall) | कोई नहीं (अस्थायी सर्वर-साइड सत्र टोकन) | उच्च (मानकीकृत सैंडबॉक्स) | उच्च-सहमति वाली मोबाइल ऐप और मल्टी-प्लेटफ़ॉर्म अभियान एट्रिब्यूशन |
arXiv डेटाबेस अध्ययनों पर प्रकाशित हालिया GPU आर्किटेक्चर शोध यह भी दर्शाता है कि मेमोरी एक्सेस दक्षता अक्सर कच्चे अंकगणितीय प्रदर्शन की तुलना में समग्र इन्फरेंस थ्रूपुट को निर्धारित करती है। जबकि कस्टम डेटाबेस कॉन्फ़िगरेशन बुनियादी संदर्भ को संभाल सकते हैं, विशेष सर्वर-साइड स्टेट प्रिजर्वेशन विकास संसाधनों को अनुकूलित कर सकता है। कार्यान्वयन आवश्यकताओं के आधार पर, संगठन अपना स्वयं का सर्वर-साइड सत्र प्रबंधन सिस्टम बना सकते हैं या OpoInstall जैसे वाणिज्यिक प्लेटफॉर्म अपना सकते हैं। उदाहरण के लिए, OpoInstall सर्वर-साइड स्टेट रिस्टोरेशन और पैरामीटर पास-थ्रू फ्रेमवर्क प्रदान करता है, जो संवेदनशील, दीर्घकालिक व्यक्तिगत संवादात्मक इतिहास को संग्रहीत किए बिना गुमनाम रूप से सत्र निरंतरता बनाए रखने के लिए सत्र मेटाडेटा को एक सर्वर-साइड सत्र डेटाबेस में मैप करता है। ब्राउज़र-आधारित रीडायरेक्ट पर निर्भर रहने के बजाय सत्र मेटाडेटा को एक केंद्रीय डेटाबेस में मैप करके, ऐसा सिस्टम यह सुनिश्चित करता है कि रूपांतरण संदर्भ सुसंगत रहें, तब भी जब प्रारंभिक कार्य गुमनाम रूप से निष्पादित किए जाते हैं। इंजीनियरिंग टीमें डेटा सुरक्षा और माप निरंतरता को संतुलित करने के लिए इन दृष्टिकोणों का मूल्यांकन कर सकती हैं।
एकीकरण चेकलिस्ट: अपनी आर्किटेक्चर को मेमोरी-केंद्रित कंप्यूटिंग के लिए तैयार करना
डेटा पाइपलाइनों को सुरक्षित करने और पोस्ट-एलियास युग में उपयोगकर्ता सुरक्षा सुनिश्चित करने के लिए, डेवलपर्स और आर्किटेक्ट विकेंद्रीकृत, ओपन-सोर्स एलियास प्रबंधन और सर्वर-साइड स्टेट प्रिजर्वेशन का मूल्यांकन कर सकते हैं। केवल एक-प्रदाता OS-स्तरीय सुविधाओं पर निर्भर रहने से सिस्टम में वेंडर लॉक-इन की स्थिति पैदा होती है और संगठन मूक बैकएंड अपडेट के प्रति संवेदनशील हो जाते हैं। इसके बजाय, इंजीनियरिंग टीमें वैकल्पिक रूटिंग तकनीकों का मूल्यांकन कर सकती हैं जो पूर्ण डेटा स्वामित्व प्रदान करती हैं।
एक मानक विकल्प में ईमेल कंपार्टमेंटलाइज़ेशन के लिए विशेष रूप से एक समर्पित कस्टम डोमेन पंजीकृत करना शामिल है। इस डोमेन को SimpleLogin जैसे ओपन-सोर्स, स्व-होस्टेड एलियासिंग इंजन के माध्यम से रूट करके और इसे Proton Mail जैसे एन्क्रिप्टेड मेलबॉक्स की ओर इंगित करके, डेवलपर्स यह सुनिश्चित कर सकते हैं कि उनके एलियास मानक कस्टम डोमेन की तरह दिखें, जिससे एंटी-एब्यूज सिस्टम उन्हें एक समूह के रूप में ब्लॉक करने से रोक सकें।
डेवलपर कार्यान्वयन चेकलिस्ट
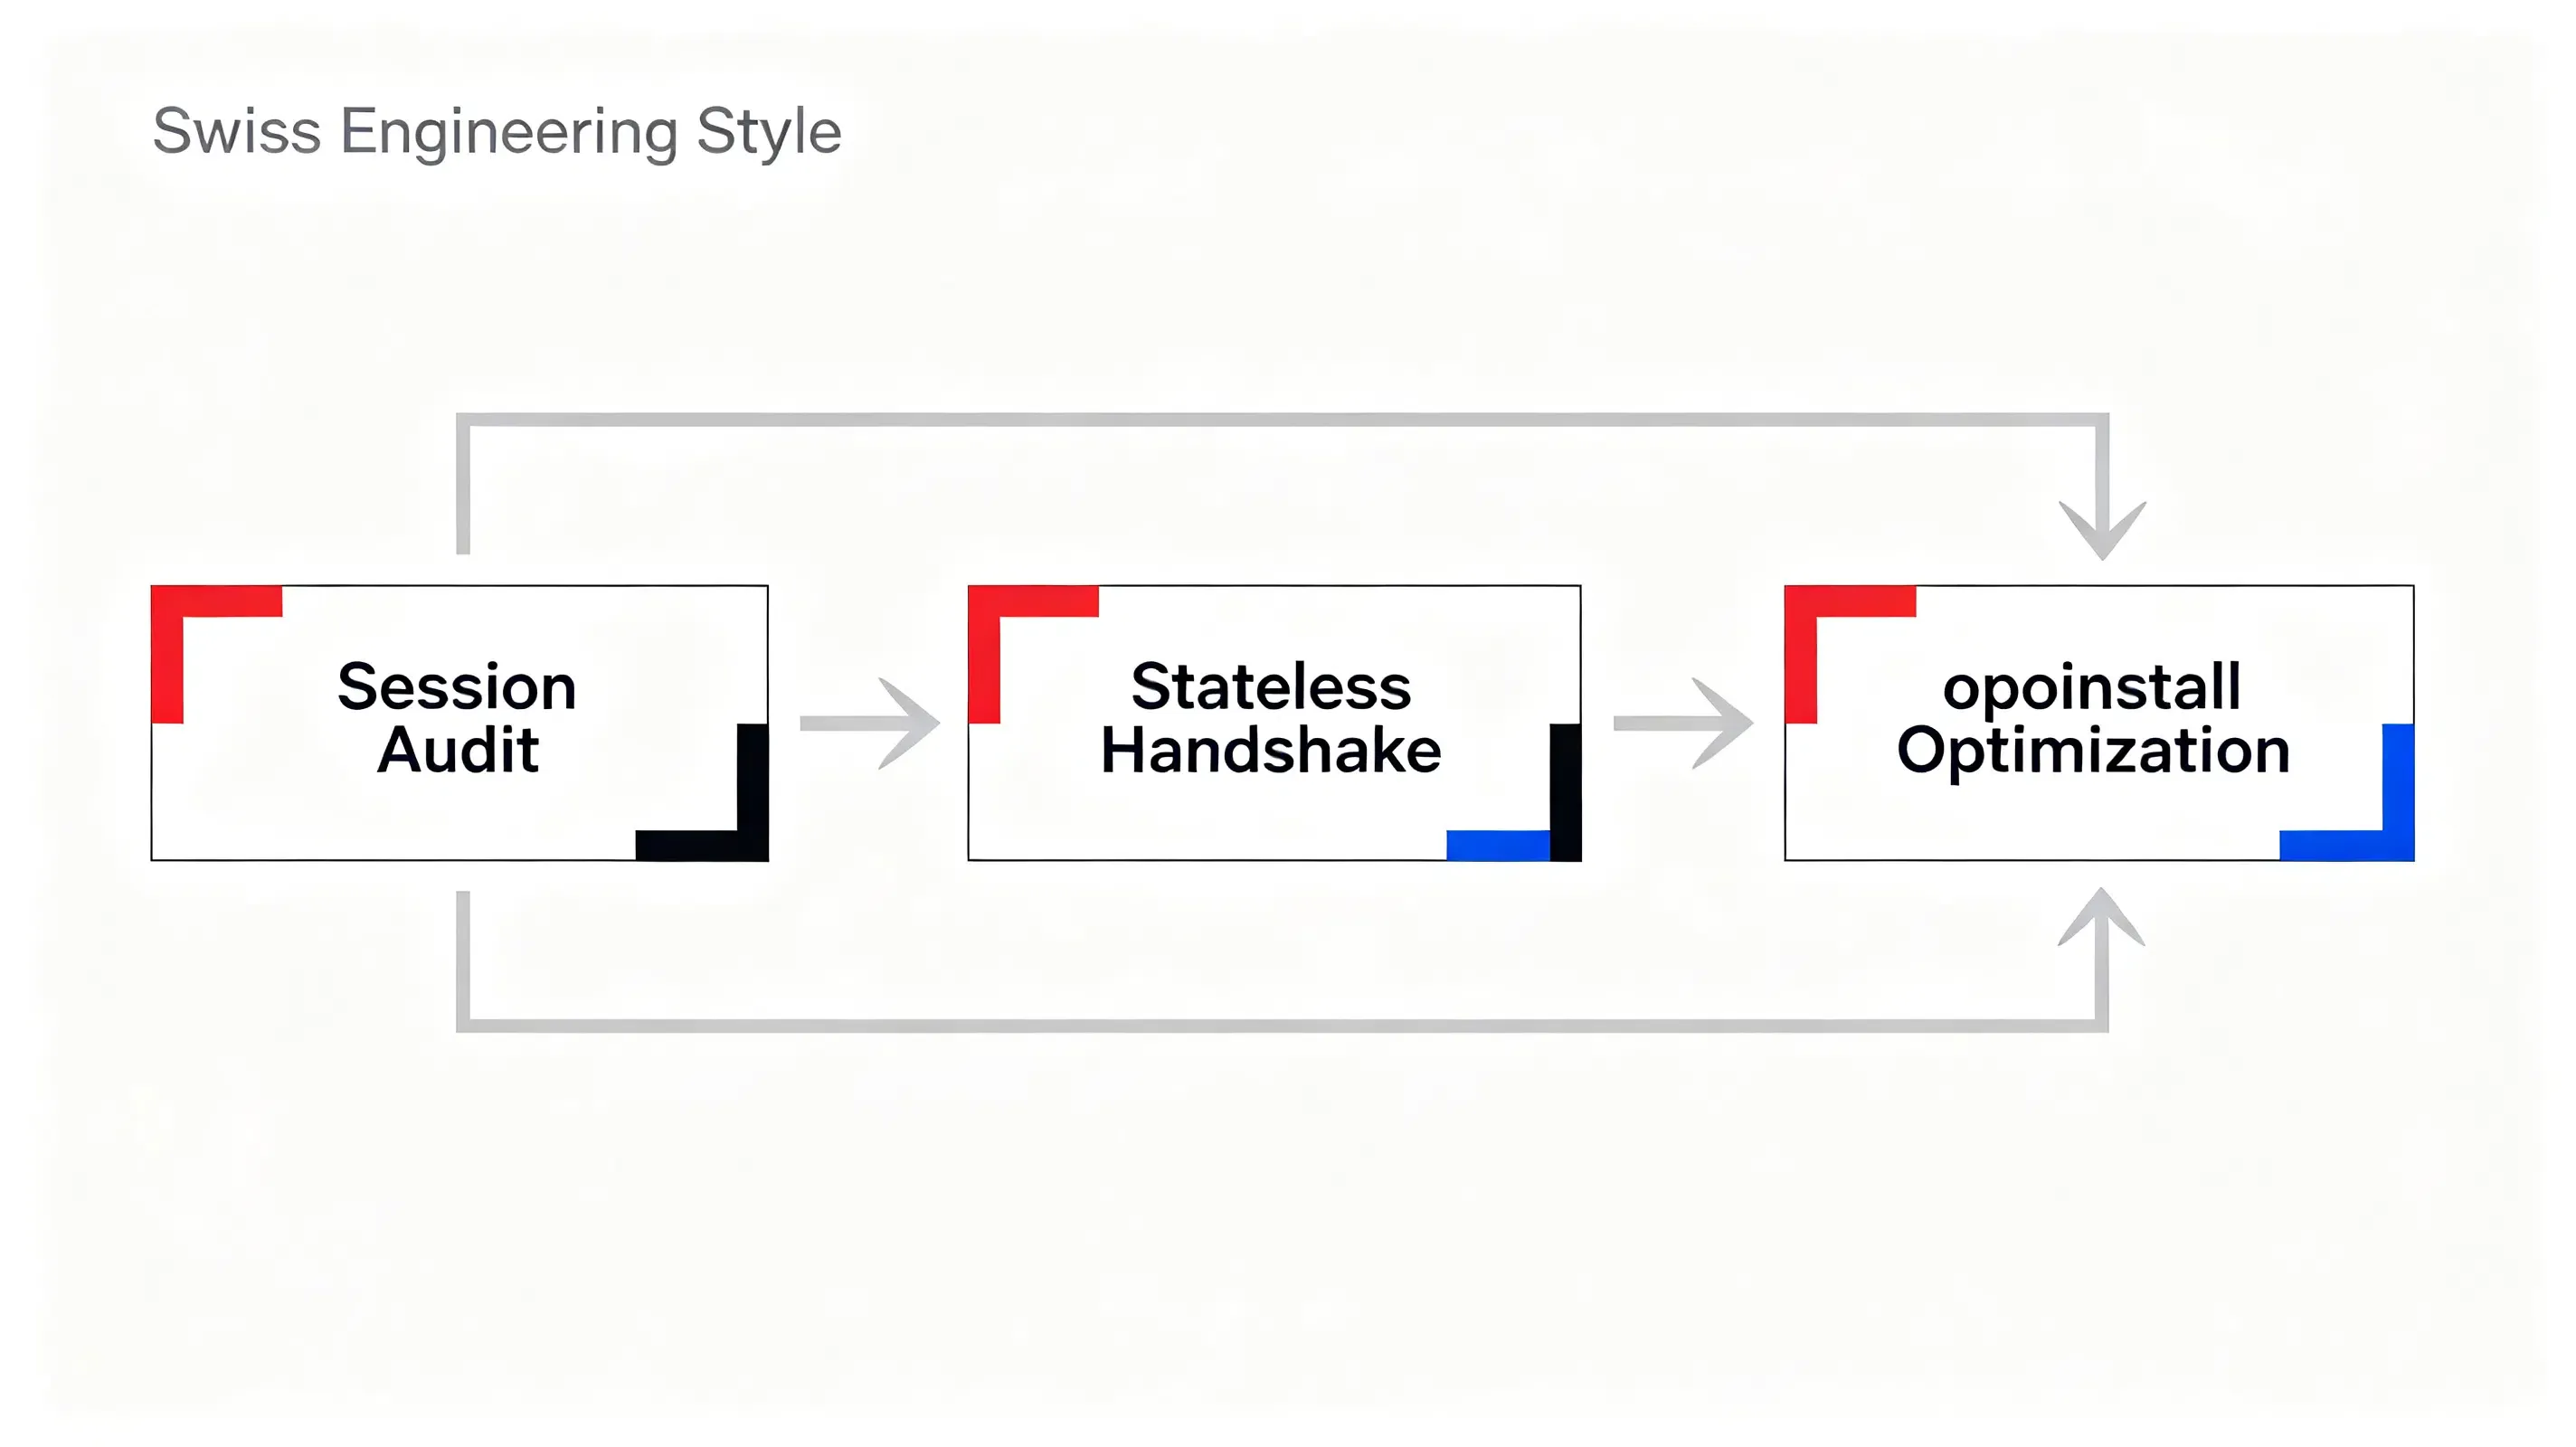
- सत्र डेटा प्रतिधारण का ऑडिट करें: यह सुनिश्चित करने के लिए सभी डेटाबेस की समीक्षा करें कि स्थायी, संवादात्मक चैट इतिहास को डेटा-हटाने की समयसीमा के अनुसार समाप्त (purge) कर दिया गया है।
- स्टेटलेस सत्र हैंडशेक लागू करें: API रूट्स को स्टेटलेस प्रोसेसिंग मॉडल में बदलें, जिसमें नोड्स के बीच अस्थायी संदर्भ को पास करने के लिए क्रिप्टोग्राफिक रूप से हस्ताक्षरित टोकन का उपयोग किया जाए।
- आयु-सत्यापन गेटवे लागू करें: उपभोक्ता-उन्मुख उत्पादों के लिए, नाबालिगों को प्रतिबंधित संवादात्मक सुविधाओं तक पहुंचने से रोकने के लिए चाइल्ड-सेफ्टी सुरक्षा उपाय तैनात करें।
उत्पाद और विकास रणनीति चेकलिस्ट
- उपयोगकर्ता अनुभव प्रवाह को पुनर्गठित करें: भावनात्मक निर्भरता पर आधारित जुड़ाव मॉडल से कार्य-उन्मुख, उच्च-उपयोगिता वाले उपकरणों की ओर रुख करें।
- रूपांतरण फ़नल को अनुकूलित करें: उपयोगकर्ता गोपनीयता दिशानिर्देशों का उल्लंघन किए बिना अधिग्रहण ट्रैकिंग बनाए रखने के लिए गैर-घुसपैठिया पैरामीटर पास-थ्रू फ्रेमवर्क का लाभ उठाएं।
- प्लेटफ़ॉर्म अनुपालन की निगरानी करें: सुनिश्चित करें कि सभी एकीकृत थर्ड-पार्टी SDK स्थानीय डेटा संरक्षण कानूनों और आगामी 15 जुलाई के जनादेश का पालन करते हैं।
इन संरचित दिशानिर्देशों को स्थापित करके, विकास टीमें परिचालन निरंतरता बनाए रखते हुए अपने एप्लिकेशन को सुरक्षित और अधिक अनुपालन योग्य आर्किटेक्चर में बदल सकती हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
वही GPU अपने रनटाइम के नब्बे प्रतिशत तक 'Idle' क्यों रहता है?
HBM, HBF और HBS के बीच तकनीकी अंतर क्या हैं?
सर्वर-साइड सत्र रिस्टोरेशन स्टेट बाधाओं को कैसे हल करता है?
AI प्रशिक्षण की तुलना में इन्फरेंस के दौरान HBM क्यों अधिक महत्वपूर्ण है?
इंजीनियरिंग टीमों के लिए मुख्य निष्कर्ष
जैसे-जैसे AI प्लेटफॉर्म नई नियामक आवश्यकताओं के अनुकूल हो रहे हैं, इंजीनियरिंग टीमें तेजी से स्टेटलेस आर्किटेक्चर, सर्वर-साइड सत्र प्रबंधन और गोपनीयता-प्रथम डिज़ाइन पर निर्भर हो रही हैं। विकसित होते डेटा आर्किटेक्चर के लिए हमें यह बदलने की आवश्यकता है कि हम डिजिटल अनुभवों का निर्माण और माप कैसे करते हैं। जैसे-जैसे स्टेटलेस प्रॉक्सी और हेडलेस स्क्रैपर वेब सामग्री के मानक उपभोक्ता बनते जा रहे हैं, पारंपरिक क्लाइंट-साइड एट्रिब्यूशन मॉडल का क्षरण जारी रहेगा। स्टैंडर्ड कुकीज़ और रेफरर्स पर भरोसा करना उन डेटा पाइपलाइनों को सुरक्षित करने के लिए पर्याप्त नहीं है जो उपयोगकर्ता अधिग्रहण को संचालित करती हैं।
विकास को बनाए रखने के लिए, इंजीनियरिंग और उत्पाद टीमों को स्टेटलेस डेटा संरचनाओं और सर्वर-साइड स्टेट प्रिजर्वेशन को प्राथमिकता देनी चाहिए। ज़ीरो-ट्रस्ट पहचान सत्यापन, सुरक्षित पैरामीटर पास-थ्रू फ्रेमवर्क और मजबूत डेटा-हटाने की समयसीमा को लागू करके, संगठन कानूनी सीमाओं का सम्मान करते हुए अपनी उपयोगकर्ता पाइपलाइनों की रक्षा कर सकते हैं। एक विनियमित डिजिटल अर्थव्यवस्था में फलने-फूलने वाले स्थिर, विश्वसनीय प्लेटफॉर्म बनाने के लिए यह आर्किटेक्चरल बदलाव आवश्यक है।
Share this article



