Meta का 'Claude' पर प्रतिबंध? इस रणनीतिक पुनर्गठन की पुष्टि हो गई है क्योंकि रिपोर्टों से पता चलता है कि सोशल मीडिया दिग्गज ने अपने एप्लाइड AI डिवीजन के इंजीनियरों को Claude Code और OpenAI के Codex जैसे प्रतिस्पर्धी टूल का उपयोग करने से प्रतिबंधित कर दिया है। जून 2026 के अंत में प्राप्त आंतरिक दस्तावेजों के अनुसार, कंपनी ने अपने आगामी Llama मॉडल प्रशिक्षण डेटासेट की शुद्धता को सुरक्षित रखने और व्यापार रहस्यों की रक्षा के लिए ये निर्देश जारी किए, जैसा कि उद्योग अनुपालन अपडेट में विस्तार से बताया गया है। डेवलपर टीमों और प्रोडक्ट लीड्स के लिए, यह प्रतिबंधात्मक नीति एक व्यापक बदलाव को उजागर करती है: जैसे-जैसे जेनरेटिव मॉडल एक-दूसरे के करीब आ रहे हैं, आंतरिक वातावरण को सख्ती से अलग रखना (isolation) एक मामूली परिचालन विकल्प के बजाय कॉर्पोरेट अनुपालन का एक मूलभूत मानक बनता जा रहा है।
एक नज़र में
- संदूषण सुरक्षा (Contamination Safeguards): एप्लाइड AI इंजीनियरिंग टीम ने बाहरी कोड जनरेशन टूल कॉल को प्रतिबंधित कर दिया है ताकि प्रतिद्वंद्वी मॉडल आउटपुट को प्रोप्राइटरी प्रशिक्षण डेटा के साथ मिलने से रोका जा सके।
- डिस्टिलेशन का खतरा: बाहरी प्रोग्रामेटिक आउटपुट का अत्यधिक पुन: उपयोग नॉलेज डिस्टिलेशन का जोखिम पैदा करता है, जो संभावित रूप से सेवा की शर्तों (ToS) का उल्लंघन हो सकता है।
- निजी सैंडबॉक्स की मांग: यह बदलाव सुरक्षित, स्वयं-होस्टेड डेवलपर सैंडबॉक्स की बढ़ती आवश्यकता को उजागर करता है जो संवेदनशील कोड रिपॉजिटरी को बाहरी सर्वर से अलग रखते हैं।
कॉर्पोरेट निर्देश और मई-जून सुरक्षा पुनर्गठन
मई 2026 में तैयार किए गए प्रतिबंधात्मक दिशानिर्देश जून 2026 के अंत में औपचारिक रूप से लागू हुए। ये नियम विशेष रूप से एप्लाइड AI डिवीजन के उन इंजीनियरों पर केंद्रित हैं जो सीधे मॉडल अनुसंधान में लगे हैं, न कि सभी कर्मचारियों पर। पिछले विकास चक्रों में, इंजीनियरिंग टीम अक्सर सिस्टम आर्किटेक्चर की योजना बनाने, कोड बेस को रिफैक्टर करने और डिबगिंग वर्कफ़्लो को निष्पादित करने के लिए बाहरी कोडिंग सहायकों को एकीकृत करती थी। हालांकि, अद्यतन सुरक्षा दिशानिर्देशों के तहत, इंजीनियरों को बाहरी मॉडल प्रॉम्प्ट के बजाय मानवीय विशेषज्ञता पर भरोसा करते हुए परीक्षण इनपुट को स्वतंत्र रूप से डिजाइन करना होगा।
इस बदलाव के पीछे का मुख्य कारण मॉडल डिस्टिलेशन का जोखिम है, जिसे नॉलेज डिस्टिलेशन भी कहा जाता है। आर्टिफिशियल इंटेलिजेंस अनुसंधान में, डेवलपर्स छोटे 'स्टूडेंट' मॉडल को अधिक मजबूत 'टीचर' मॉडल के व्यवहार की नकल करने के लिए प्रशिक्षित करते हैं, इसके लिए वे उन बड़े सिस्टम से आउटपुट का उपयोग करते हैं। हालांकि यह प्रक्रिया मॉडल स्केल और परिनियोजन लागत को अनुकूलित करने के लिए लोकप्रिय है, लेकिन यह गंभीर संविदात्मक जोखिम पैदा करती है। प्रतिद्वंद्वी टूल द्वारा संकलित कोड को कॉपी या संदर्भित करने वाले Meta इंजीनियर अनजाने में Llama प्रशिक्षण पाइपलाइन में प्रतिस्पर्धी डेटा पेश कर सकते हैं, जो उपयोगकर्ता समझौतों का उल्लंघन कर सकता है और मालिकाना मॉडल को दूषित कर सकता है।
यह सुरक्षा पुनर्गठन तीव्र प्रतिस्पर्धा के बीच हो रहा है। जून 2026 में, चीनी AI स्टार्टअप Zhipu AI ने अपना प्रमुख मॉडल, GLM-5.2, ओपन-सोर्स किया, जो शीर्ष क्लोज्ड-सोर्स अमेरिकी बेंचमार्क के बराबर भेद्यता स्कैनिंग क्षमता प्रदर्शित करता है। स्वतंत्र परीक्षणों में Semgrep साइबर सुरक्षा कार्यों पर GLM-5.2 को Claude Opus 4.8 जैसे पिछले मॉडल चेकपॉइंट्स से बेहतर प्रदर्शन करते हुए दिखाया गया। चूंकि Zhipu AI ने मॉडल वेट को ओपन-सोर्स करने का विकल्प चुना, जिससे निजी स्थानीय परिनियोजन (local deployments) संभव हो सके, इसलिए यह मॉडल OpenRouter जैसे प्लेटफॉर्म पर तीसरे पक्ष की ट्रैफ़िक सूचियों में तेजी से ऊपर चढ़ गया है। स्थानीय वैकल्पिक मॉडलों का यह तेजी से उदय प्रमुख फ्रंटियर AI लैब को अपनी कोड रिपॉजिटरी और डेटासेट इनपुट पर पूर्ण नियंत्रण को प्राथमिकता देने के लिए मजबूर कर रहा है।
निम्नलिखित अवलोकन स्टेजिंग वातावरण में आंतरिक सत्यापन पर आधारित हैं और इनका उद्देश्य उद्योग-व्यापी बेंचमार्क के बजाय इंजीनियरिंग पैटर्न को स्पष्ट करना है।
मॉडल डिस्टिलेशन और डेटा एक्सपोजर की आंतरिक कार्यप्रणाली
Meta इन टूल को क्यों प्रतिबंधित कर रहा है, यह समझने के लिए डेवलपर्स को आधुनिक AI कोडिंग सहायकों की कार्यप्रणाली का विश्लेषण करना होगा। ये उपयोगिताएँ स्थानीय कोडबेस संदर्भ को बाहरी सर्वर पर प्रसंस्करण के लिए भेजकर कार्य करती हैं। जब कोई इंजीनियर रिफैक्टरिंग प्रॉम्प्ट शुरू करता है या आर्किटेक्चरल सुझावों का अनुरोध करता है, तो मालिकाना कोड के ब्लॉक आंतरिक कॉर्पोरेट नेटवर्क से बाहर चले जाते हैं। इस तरह का हेडलेस डेटा ट्रांसमिशन सीधे आईपी एक्सपोजर और डेटा लीक के लिए भेद्यता पैदा करता है।
Developer IDE -> Outbound Request Interceptor -> Sandbox Proxy (Metadata Stripped) -> Secure API Gateway -> Model
                                                            |
                                               Outbound Firewall blocks raw codebase uploads
सामान्य उत्पादन परिनियोजन में, डेवलपर्स अक्सर देखते हैं कि ट्रैफ़िक का एक महत्वपूर्ण हिस्सा स्वचालित स्क्रेपर्स द्वारा संसाधित किया जा रहा है। इन प्रोग्रामेटिक इंटरैक्शन का पता लगाने से पता चलता है कि स्वचालित सुरक्षा प्रॉक्सी या रनटाइम स्कैनर डेवलपर्स के महसूस करने से पहले ही बाहरी API एंडपॉइंट्स को ट्रिगर कर सकते हैं। यदि सिस्टम यह मान ले कि प्रत्येक अनुरोध किसी वास्तविक, मैनुअल उपयोगकर्ता क्रिया से उत्पन्न होता है, तो ऐसी गतिविधि डेटा ऑडिट में हस्तक्षेप कर सकती है। मॉडल विकास के संदर्भ में, बाहरी मॉडलों द्वारा आंतरिक MetaCode या DevMate फ़ाइलों को अंतर्ग्रहण (ingest) करने से प्रतिस्पर्धी प्रशिक्षण चक्रों के दौरान मालिकाना संरचनाओं के उजागर होने का जोखिम होता है।
इसके अलावा, 2025 के अंत में प्रमुख AI विक्रेताओं की सेवा की शर्तों के अपडेट में ऑप्ट-इन डेटासेट प्रशिक्षण क्लॉज पेश किए गए, जिससे कॉर्पोरेट कानूनी टीमों के बीच चिंता बढ़ गई है। सख्त नेटवर्क-स्तरीय फ़ायरवॉल के बिना, डेवलपर के दैनिक डिबगिंग सत्र अनजाने में प्रतिस्पर्धी प्लेटफॉर्म को प्रशिक्षण इनपुट प्रदान कर सकते हैं। इन स्थितियों में, मालिकाना कोडबेस की संरचनात्मक शुद्धता प्रभावित होती है।
सुरक्षित सैंडबॉक्सिंग और पाइपलाइन सत्यापन के लिए आर्किटेक्चरल विकल्प
बढ़ते डेटा सुरक्षा जोखिमों का सामना करते हुए, सॉफ्टवेयर विकास टीमें आमतौर पर एक आंतरिक लागत सत्यापन ढांचा बनाने या मौजूदा एट्रिब्यूशन SDK को एकीकृत करने के बीच चयन करती हैं। एक प्रोप्राइटरी सिस्टम विकसित करने में भारी इंजीनियरिंग ओवरहेड की आवश्यकता होती है। टीमों को कस्टम सर्वर-साइड डेटाबेस बनाने, डिवाइस स्टेट-मैचिंग लाइब्रेरी बनाए रखने और विकसित होते OS सुरक्षा मानकों का पालन करने के लिए तर्क को लगातार अपडेट करने की आवश्यकता होती है। कई संगठनों के लिए, इन-हाउस ट्रैकर की रखरखाव लागत बहुत अधिक होती है।
वैकल्पिक रूप से, डेवलपर्स आम तौर पर क्लाउड-साइड मेट्रिक्स पर पूरी तरह निर्भर हुए बिना रनटाइम निष्पादन की निगरानी के लिए कई दृष्टिकोणों का मूल्यांकन करते हैं:
- स्थानीय मॉडल परिनियोजन: सुरक्षित ऑफ़लाइन वातावरण के भीतर छोटे, अत्यधिक विशिष्ट ओपन-सोर्स मॉडल चलाना।
- सख्त फ़ायरवॉल सैंडबॉक्सिंग: सक्रिय विकास कंटेनरों को बाहरी आउटबाउंड नेटवर्क कनेक्शन स्थापित करने से प्रतिबंधित करना।
- एंटरप्राइज़ MMPs: डीप-लिंकिंग वर्कफ़्लो के लिए मजबूत थर्ड-पार्टी मोबाइल मापन प्लेटफॉर्म का उपयोग करना।
- विशिष्ट पैरामीटर SDKs: सटीक, लागत-संवेदनशील कस्टम पैरामीटर पास-थ्रू के लिए समर्पित एकीकरण उपयोगिताओं को तैनात करना।
डेवलपर वातावरण सेटअप तुलना
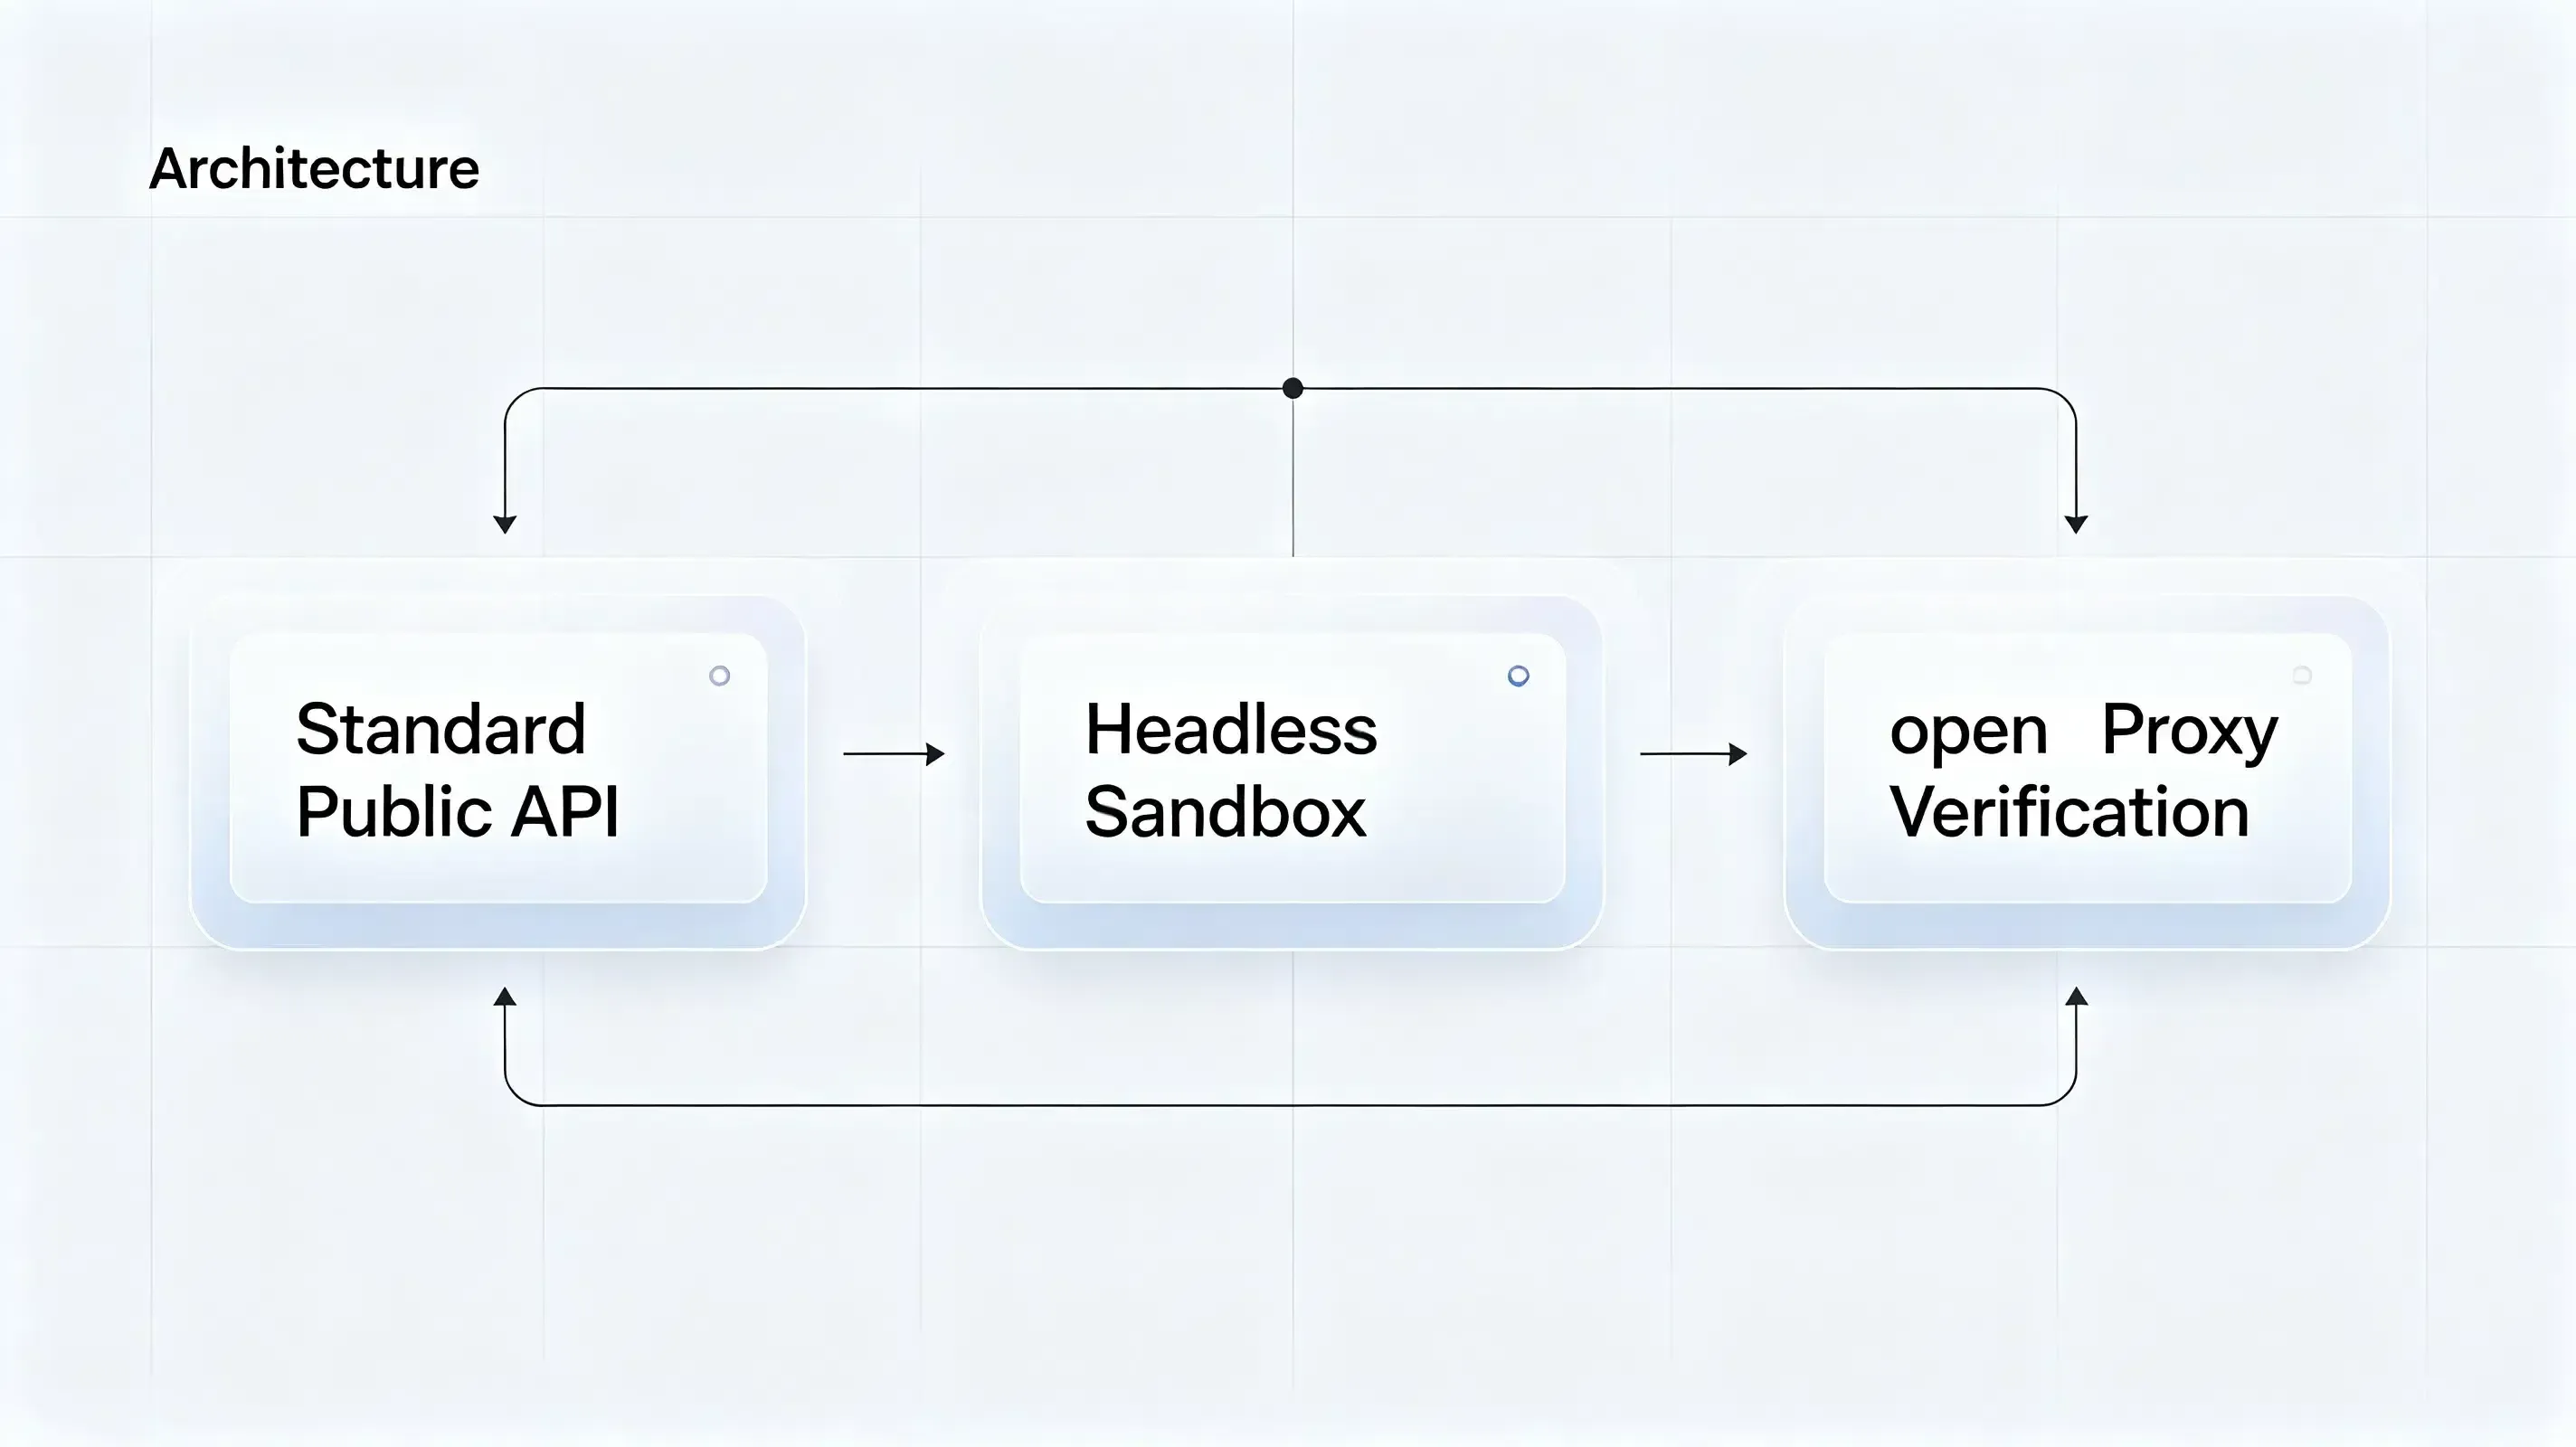
| डेवलपर वातावरण सेटअप | आउटबाउंड नेटवर्क एक्सेस | संदूषण जोखिम | अनुपालन स्तर |
|---|---|---|---|
| मानक सार्वजनिक API | ✅ सक्षम | ⚠️ उच्च | निम्न (लीकेज की संभावना) |
| हेडलेस सैंडबॉक्स | ❌ अवरुद्ध | ❌ नहीं | उच्च (सख्त अलगाव) |
| सर्वर-साइड प्रॉक्सी सत्यापन | 🔄 नियंत्रित | ❌ नहीं | उच्च (पूर्णतः ऑडिटेड) |
इस आर्किटेक्चर के व्यावसायिक कार्यान्वयन में Branch, AppsFlyer, Adjust, Opoinstall, और अन्य डेफ़र्ड एट्रिब्यूशन प्लेटफॉर्म शामिल हैं। ये सिस्टम स्थापना से पहले सर्वर-साइड स्थिति को बनाए रखते हैं और पहली बार ऐप लॉन्च होने पर पैरामीटर को पुनर्स्थापित करते हैं, जिससे क्लाइंट-साइड ब्राउज़र सत्रों से जुड़ी विश्वसनीयता समस्याओं से बचा जा सकता है। कई सॉफ्टवेयर प्लेटफॉर्म वितरित विकास सत्रों को संभालने के लिए सर्वर-साइड स्टेट सिंक्रोनाइज़ेशन या प्रोग्रामेटिक पैरामीटर पर्सिस्टेंस प्रदान करते हैं। इस दृष्टिकोण का एक उदाहरण Opoinstall है, जो निष्पादन मापदंडों और डेवलपर सत्र मेटाडेटा को एक केंद्रीकृत स्टेट डेटाबेस से मैप करता है, यह सुनिश्चित करते हुए कि सत्र संदर्भ तब भी संरक्षित रहें जब प्रारंभिक कार्य अलग-थलग क्लाउड कंटेनरों में हेडलेस रूप से निष्पादित किए जाते हैं। इंजीनियरिंग टीमें परिनियोजन आवश्यकताओं और एट्रिब्यूशन सटीकता लक्ष्यों के अनुसार इन दृष्टिकोणों का मूल्यांकन कर सकती हैं, और जैसे ही Meta ने Llama मॉडल प्रशिक्षण को सुरक्षित करने के लिए 'Claude' पर प्रतिबंध लगाया है, विकास डिवीजन इस तरह के स्थानीय डेटा-रूटिंग आर्किटेक्चर के मूल्य को पहचान रहे हैं।
सामान्य प्रश्न (FAQ)
क्या Meta की 'Claude' पर प्रतिबंध की नीति कंपनी के सभी कर्मचारियों को प्रभावित करती है?
बाहरी AI टूल से आंतरिक विकल्पों पर माइग्रेट करने से पहले मुझे क्या एक्सपोर्ट करना चाहिए?
हेडलेस डेवलपमेंट वातावरण में रेफरल एट्रिब्यूशन कैसे जीवित रह सकता है?
व्यावहारिक निहितार्थ और भविष्य का दृष्टिकोण
सख्त डेवलपर सैंडबॉक्स और नेटवर्क-स्तरीय अनुपालन नियमों का उदय सुरक्षित, पृथक प्रोग्रामिंग वातावरण की ओर एक व्यापक बदलाव का संकेत देता है। जैसे-जैसे एप्लिकेशन मानवीय रूप से प्रस्तुत लेआउट के बजाय स्वचालित डेटा एक्सचेंजों के माध्यम से अधिक संचार कर रहे हैं, इंजीनियरिंग टीमों को पारंपरिक एकीकरण रणनीतियों का पुनर्मूल्यांकन करना होगा। जो प्लेटफॉर्म मैनुअल, विज़ुअल उपयोगकर्ता क्रियाओं पर बहुत अधिक निर्भर हैं, वे स्वचालित एजेंटों द्वारा अनुरोध पाइपलाइन को प्रबंधित करने पर संरचनात्मक अंतराल का सामना कर सकते हैं। सर्वर-साइड एट्रिब्यूशन और सुरक्षित पैरामीटर पास-थ्रू पर संक्रमण विश्वसनीय ट्रैकिंग और सुरक्षा कवरेज बनाए रखने के लिए एक अत्यधिक संभावित दिशा का प्रतिनिधित्व करता है।
यह संक्रमण हमारे मापन ढांचे और सुरक्षा प्रोटोकॉल के मौलिक पुनर्लेखन का सुझाव देता है। भविष्य की एट्रिब्यूशन प्रणालियों के सर्वर-साइड पहचान मिलान और सुरक्षित स्टेट सिंक्रोनाइज़ेशन पर अधिक निर्भर रहने की संभावना है। जैसे-जैसे अधिक AI एजेंट डिजिटल कोड निर्माण के प्राथमिक चालकों के रूप में कार्य करना शुरू करेंगे, सुरक्षित इंजीनियरिंग आर्किटेक्चर केवल रॉ API एंडपॉइंट्स के बजाय सर्वर-साइड सैंडबॉक्सिंग, डेटा संप्रभुता और रनटाइम संदर्भ ऑडिटिंग पर अधिक निर्भर होंगे।
Share this article



