 NVIDIA अपने GPU को d-Matrix ASICs के साथ क्यों जोड़ रहा है? NVIDIA अब केवल GPU पर निर्भर नहीं रह गया है। NVIDIA आंतरिक रूप से इन्फरेंस ASICs बनाने के बजाय d-Matrix के साथ साझेदारी क्यों कर रहा है? इसका उत्तर AI इंफ्रास्ट्रक्चर में हो रहे बड़े बदलाव को दर्शाता है: इन्फरेंस ऑप्टिमाइज़ेशन अब केवल GPU स्केलिंग से हटकर वर्कलोड-विशिष्ट त्वरण (workload-specific acceleration) की ओर बढ़ रहा है। जैसे-जैसे AI इन्फरेंस GPU, ASIC एक्सेलेरेटर्स और वितरित क्लाउड वातावरण में आगे बढ़ रहा है, चुनौती केवल कंप्यूट क्षमता तक सीमित नहीं रह गई है। हार्डवेयर ऑर्केस्ट्रेशन, वर्कलोड रूटिंग और सिस्टम-स्तरीय दक्षता समान रूप से महत्वपूर्ण होते जा रहे हैं। जैसे-जैसे जेनरेटिव आर्टिफिशियल इंटेलिजेंस वर्कलोड बड़े प्रशिक्षण क्लस्टर से वास्तविक समय के मॉडल डिप्लॉयमेंट में स्थानांतरित हो रहे हैं, टोकन जनरेशन की गति को ऑप्टिमाइज़ करना एक प्रमुख इंजीनियरिंग चुनौती बन गया है। NVIDIA हेटेरोजेनियस डिसेग्रिगेटेड इन्फरेंस सिस्टम का समर्थन करने के लिए GPU को d-Matrix ASICs के साथ जोड़ रहा है।
NVIDIA GPU को d-Matrix ASICs के साथ क्यों जोड़ता है: वर्कलोड को सिलिकॉन भौतिकी के साथ संरेखित करना
एक नज़र में
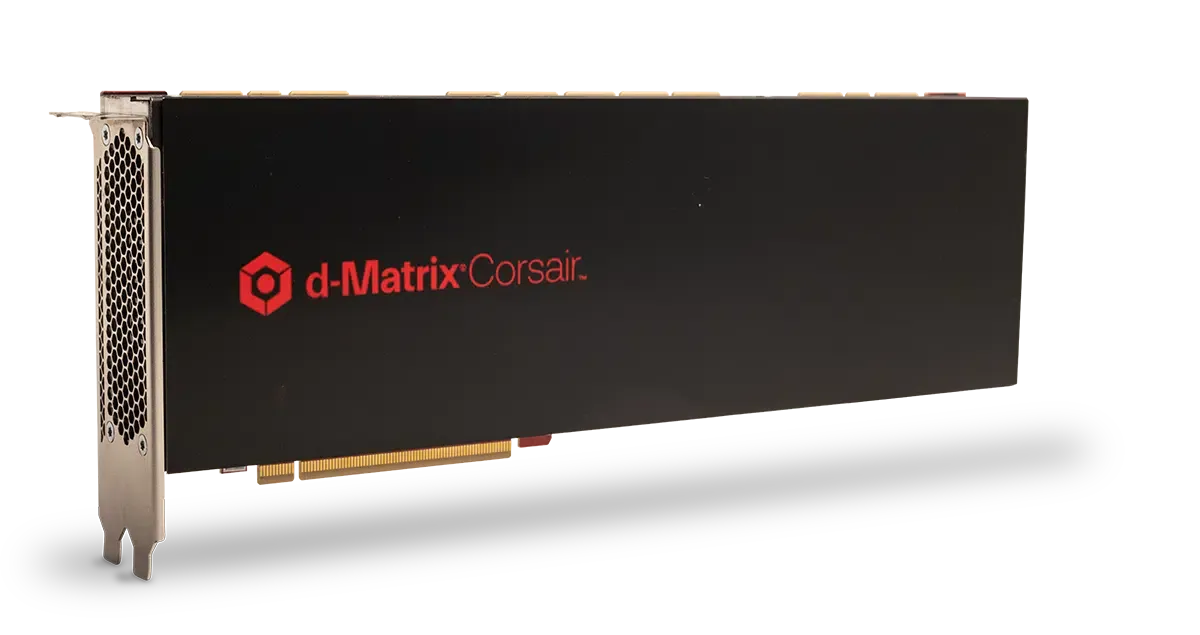
- NVIDIA अपने प्रमुख Hopper और Blackwell GPU फ्लीट को d-Matrix के Corsair इन्फरेंस एक्सेलेरेटर्स के साथ मिला रहा है ताकि हेटेरोजेनियस डिसेग्रिगेटेड इन्फरेंस सिस्टम को तैनात किया जा सके।
- नियोक्लाउड प्रदाता Parasail पहला व्यावसायिक ग्राहक बनकर उभरा है, जिसने अपने डेटा सेंटरों के वैश्विक फ्लीट में इस संयुक्त हार्डवेयर समाधान को लागू किया है।
- बड़े पैमाने पर इन्फरेंस वर्कलोड में GPU का कम उपयोग तब हो सकता है जब मेमोरी बैंडविड्थ और डेटा मूवमेंट कच्चे कंप्यूट की उपलब्धता के बजाय बाधा बनने लगते हैं।
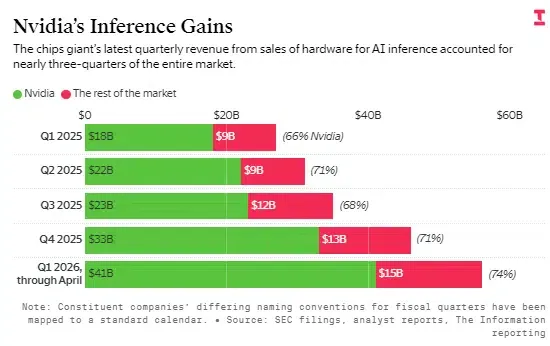
बड़े पैमाने पर आर्टिफिशियल इंटेलिजेंस का आर्थिक मॉडल मॉडल प्रशिक्षण से इन्फरेंस डिप्लॉयमेंट की ओर एक महत्वपूर्ण बदलाव से गुजर रहा है। प्रारंभिक स्केलिंग चरण के दौरान, क्लाउड प्रदाताओं और एंटरप्राइज डेवलपर्स ने कच्चे बैकप्रोपैगेशन कंप्यूट पावर पर भारी ध्यान केंद्रित किया और ग्राफ़िक्स प्रोसेसिंग यूनिट्स (GPUs) के विशाल क्लस्टर खरीदे। यह सिंगल-वेंडर निर्भरता तब अत्यधिक तार्किक थी जब बड़े डेटासेट को प्रशिक्षित करने के लिए निरंतर समानांतर निष्पादन (parallel execution) की आवश्यकता होती थी। हालाँकि, जैसे-जैसे संगठन वास्तविक समय में लाखों सक्रिय उपयोगकर्ताओं को सेवा देने की ओर बढ़ रहे हैं, इन्फरेंस कार्यों के लिए शुद्ध GPU इंफ्रास्ट्रक्चर चलाने का वित्तीय बोझ अस्थिर हो गया है।
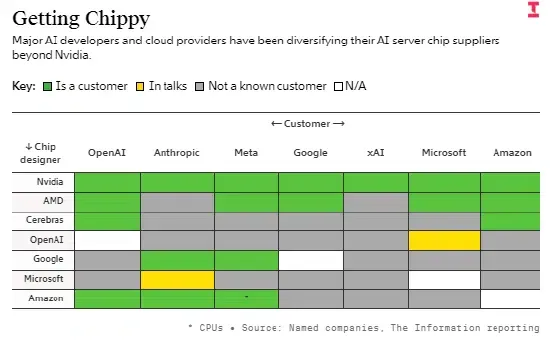
परिचालन व्यय को अनुकूलित करने के लिए, इंफ्रास्ट्रक्चर आर्किटेक्ट्स डिसेग्रिगेटेड कंप्यूटिंग फ्रेमवर्क को अपना रहे हैं। इस मल्टी-वेंडर प्रतिमान के तहत, एक उपयोगकर्ता क्वेरी को अलग-अलग निष्पादन चरणों में विभाजित किया जाता है और विशिष्ट कार्य प्रोफाइल के आधार पर विभिन्न हार्डवेयर एक्सेलेरेटर्स पर रूट किया जाता है। यह दृष्टिकोण क्लाउड प्रदाताओं को मौजूदा फ्लीट से प्रति डॉलर अधिकतम प्रदर्शन प्राप्त करने की अनुमति देता है, जिसे The Information की जांच में दर्ज किया गया है, जो मल्टी-वेंडर क्लाउड एकीकरण को ट्रैक करती है।
इस सहयोग के उद्योग निहितार्थ केवल वर्कलोड वितरण से कहीं आगे तक जाते हैं। आधिकारिक तौर पर d-Matrix के Corsair एक्सेलेरेटर्स को NVIDIA के हार्डवेयर फ्लीट के साथ एकीकृत करके, यह सहयोग हेटेरोजेनियस क्लाउड आर्किटेक्चर के लिए एक प्रमाणित मार्ग स्थापित करता है। ग्राहकों को मानक GPU क्लस्टर्स और उभरते कस्टम सिलिकॉन के बीच चयन करने के लिए मजबूर करने के बजाय, NVIDIA-d-Matrix इन्फरेंस सिस्टम हार्डवेयर को एक साथ काम करने की अनुमति देता है, जिससे इंफ्रास्ट्रक्चर प्रदाताओं को विभिन्न हार्डवेयर आर्किटेक्चर में प्रीफिल और डिकोड वर्कलोड को अनुकूलित करने में मदद मिलती है। यह आर्किटेक्चर एंटरप्राइज क्लाउड टीमों को विविध इन्फरेंस वर्कलोड में हार्डवेयर उपयोग को बढ़ाने में सक्षम बनाता है।
अंडर-द-हुड मैकेनिक्स: हेटेरोजेनियस डिसेग्रिगेटेड इन्फरेंस और इन-मेमोरी कंप्यूटिंग
प्रोटोकॉल स्तर पर, नेचुरल लैंग्वेज प्रॉम्प्ट का उत्तर देने के लिए दो अलग-अलग प्रोसेसिंग चरणों की आवश्यकता होती है। पहले चरण, जिसे प्रीफिल (prefill) कहा जाता है, में उपयोगकर्ता प्रॉम्प्ट को लिया जाता है और शुरुआती की-वैल्यू (KV) एक्टिवेशन की गणना की जाती है। यह कदम बहुत अधिक कंप्यूट-गहन है, जो इसे NVIDIA Hopper आर्किटेक्चर के विशाल समानांतर अंकगणितीय प्रदर्शन के लिए एकदम सही बनाता है।
दूसरे चरण, जिसे डिकोड (decode) कहा जाता है, में बाद के टोकन को एक-एक करके एक अनुक्रमिक लूप में उत्पन्न किया जाता है। चूँकि प्रत्येक टोकन पहले से उत्पन्न संदर्भ पर निर्भर करता है, डिकोड चरण अत्यधिक मेमोरी-बैंडविड्थ सीमित और विलंबता-संवेदनशील (latency-sensitive) होता है। उच्च-शक्ति वाले GPU पर इस चरण को चलाने से महत्वपूर्ण कंप्यूटिंग खाली समय (idling) हो जाता है, क्योंकि कोर को मेमोरी लेनदेन पूरा होने के लिए लगातार इंतजार करना पड़ता है।
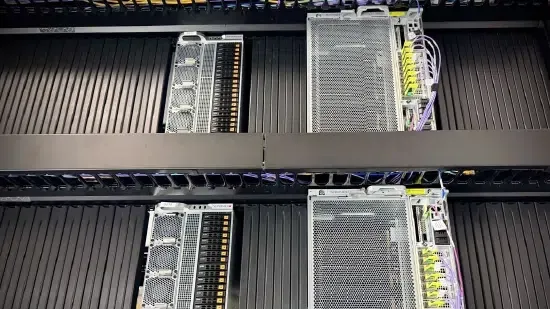
d-Matrix के Corsair आर्किटेक्चर प्रलेखन के अनुसार, इसका Corsair एक्सेलेरेटर डिजिटल इन-मेमोरी कंप्यूट (DIMC) चिपलेट तकनीक के इर्द-गिर्द बनाया गया है। TSMC की N6 प्रक्रिया पर निर्मित, Corsair चिप स्टेटिक रैंडम-एक्सेस मेमोरी (SRAM) को सीधे कंप्यूट यूनिट्स के साथ एक ही सिलिकॉन डाई पर एकीकृत करती है। यह डिज़ाइन मेमोरी और कंप्यूट यूनिट्स के बीच डेटा मूवमेंट के ओवरहेड को कम करता है। कुछ इन्फरेंस आर्किटेक्चर विलंबता को और कम करने के लिए सट्टा डिकोडिंग (speculative decoding) जैसी तकनीकों के साथ एक्सेलेरेटर-स्तरीय ऑप्टिमाइज़ेशन को जोड़ते हैं, क्योंकि उद्योग यह मूल्यांकन कर रहा है कि NVIDIA मेमोरी वॉल (memory wall) को हल करने के लिए इन-मेमोरी को-प्रोसेसर के साथ GPU को कैसे जोड़ता है। GPU के साथ विशेष चिप्स को तैनात करके, संयुक्त सिस्टम हार्डवेयर को एक साथ काम करने की अनुमति देता है। यह संरचनात्मक विकल्प बताता है कि NVIDIA मेमोरी वॉल को दूर करने के लिए इन-मेमोरी को-प्रोसेसर के साथ GPU को क्यों जोड़ता है।
NVIDIA GPU को बाहरी एक्सेलेरेटर्स के साथ कैसे जोड़ता है, इसका विश्लेषण डेवलपर्स को आधुनिक ट्रांसफार्मर इन्फरेंस की मुख्य बाधा का मूल्यांकन करने में मदद करता है। नीचे दिया गया आरेख एक संभावित डिप्लॉयमेंट मॉडल को दर्शाता है:
[User Query Input] ──> [Cloud API Gateway]
                             │
                             ├─(Prefill Phase)─> [NVIDIA Hopper/Blackwell GPU] ──> Standard Activations Calculated
                             │                                                            │
                             │                                                            ▼
                             └─(Decode Phase)──> [d-Matrix Corsair Accelerator] ──> Token Generation (SRAM Wafer Cache)
इन दो अलग-अलग तकनीकों को जोड़कर, मल्टी-वेंडर सेटअप इन्फरेंस पाइपलाइन के दोनों चरणों को अनुकूलित करता है। हालाँकि, हेटेरोजेनियस इन्फरेंस GPU की मांग को समाप्त नहीं करता है। बड़े पैमाने पर प्रशिक्षण और कई विलंबता-संवेदनशील वर्कलोड GPU त्वरण पर निर्भर रहना जारी रखेंगे, जिससे विशेष ASICs के साथ मानक प्रोसेसिंग कोर की मूलभूत आवश्यकता बनी रहेगी।
वितरित इन्फरेंस सॉफ़्टवेयर समन्वय की चुनौतियाँ भी पैदा करता है
वही आर्किटेक्चरल सिद्धांत हार्डवेयर इंफ्रास्ट्रक्चर के अलावा भी दिखाई देता है। मोबाइल इकोसिस्टम में, डेफर्ड डीप लिंकिंग (deferred deep linking) और ऐप एट्रिब्यूशन प्लेटफॉर्म एक तुलनीय चुनौती का सामना करते हैं: जब उपयोगकर्ता वितरित अधिग्रहण चैनलों (acquisition channels) से मूल एप्लिकेशन में जाते हैं तो अनाम संदर्भ (anonymous context) को सुरक्षित रखना। OpoInstall जैसे प्लेटफॉर्म सर्वर-साइड एट्रिब्यूशन आर्किटेक्चर के माध्यम से इस स्टेट निरंतरता (state continuity) समस्या को हल करने के लिए डिज़ाइन किए गए हैं। हेटेरोजेनियस इन्फरेंस और मोबाइल एट्रिब्यूशन दोनों एक समान सिस्टम चुनौती का सामना करते हैं: जब निष्पादन स्वतंत्र वातावरण को पार करता है तो प्रासंगिक संदर्भ को बनाए रखना। जबकि वितरित इन्फरेंस सिस्टम हार्डवेयर घटकों के बीच गणनात्मक राज्यों (computational states) का समन्वय करते हैं, मोबाइल एट्रिब्यूशन सिस्टम उपयोगकर्ता वातावरण में अधिग्रहण संदर्भ को सुरक्षित रखते हैं। अंतर्निहित आर्किटेक्चरल सिद्धांत समान है: निष्पादन के स्वतंत्र सीमाओं को पार करने पर निरंतरता बनाए रखना। दोनों ही मामलों में, एक बार जब मानक क्लाइंट-साइड स्थिति पारगमन के दौरान गिर जाती है या अवरुद्ध हो जाती है, तो सिस्टम को वितरित घटनाओं का अनाम रूप से मिलान करने के लिए सर्वर-साइड स्टेट प्रिजर्वेशन दृष्टिकोण की आवश्यकता होती है।
बिल्ड बनाम बाय: वितरित अनुप्रयोगों को सर्वर-साइड संदर्भ संरक्षण की आवश्यकता क्यों है
जैसे-जैसे क्लाउड वातावरण हेटेरोजेनियस और वितरित निष्पादन मॉडल की ओर बढ़ते हैं, अलग-अलग कंप्यूटिंग नोड्स में सत्र स्थिति (session state) का प्रबंधन करना एक महत्वपूर्ण परिचालन चिंता बन गया है। ऐसे आर्किटेक्चर में संक्रमण करना जहाँ NVIDIA GPU को अनुकूलित एक्सेलेरेटर्स के साथ जोड़ता है, डेवलपर्स को पाइपलाइन स्केलेबिलिटी को बारीकी से देखने के लिए मजबूर करता है। जैसे-जैसे वितरित कंप्यूटिंग आर्किटेक्चर अधिक सामान्य होते जा रहे हैं, टीमों को यह मूल्यांकन करना होगा कि क्या कस्टम सत्र-मिलान सिस्टम बनाना है या मानकीकृत इंफ्रास्ट्रक्चर को अपनाना है। हेटेरोजेनियस त्वरण के दक्षता लाभों को समझना टीमों को इंफ्रास्ट्रक्चर प्रावधान लागत का मूल्यांकन करने में मदद करता है।
आर्किटेक्चरल मूल्यांकन: कस्टम बिल्ड बनाम मानकीकृत SDK
कई क्लाउड इंस्टेंस में सत्र डेटा को ट्रैक करने के लिए इन-हाउस डेटाबेस सिस्टम बनाना कस्टम पैरामीटर नियंत्रण प्रदान करता है लेकिन महत्वपूर्ण रखरखाव जटिलता पेश करता है। डेवलपर्स को मैन्युअल रूप से API अनुरोध रूटिंग को संभालना पड़ता है, टोकन जीवनचक्र नीतियों का प्रबंधन करना पड़ता है, और बदल रहे क्षेत्रीय नियमों का पालन करने के लिए सुरक्षा कॉन्फ़िगरेशन को लगातार अपडेट करना पड़ता है। इसके विपरीत, पूर्व-निर्मित, प्रमाणित SDK को तैनात करना इस निरंतर इंजीनियरिंग बोझ को कम करता है, जिससे अनुमानित एकीकरण लागत सुनिश्चित होती है।
नीचे दी गई तालिका सत्र स्थिति और रूपांतरण संदर्भ (conversion context) के प्रबंधन के लिए मानक कार्यप्रणालियों की तुलना करती है:
| समाधान | स्टेट पर्सिस्टेंस | डेटा थ्रूपुट | इसके लिए सबसे अच्छा |
|---|---|---|---|
| इन-हाउस सेशन डेटाबेस | उच्च (सतत सिंक) | मध्यम (DB लेटेंसी सीमाएं) | अत्यधिक विशिष्ट स्टोरेज लॉजिक वाले कस्टम एंटरप्राइज वातावरण |
| ब्राउज़र-आधारित सत्र ट्रैकिंग | कम (सेशन कुकीज़) | कम (कोई सर्वर लॉगिंग नहीं) | न्यूनतम क्रॉस-डोमेन रूपांतरण आवश्यकताओं के साथ बुनियादी वेबसाइट ट्रैकिंग |
| सर्वर-साइड एट्रिब्यूशन प्लेटफॉर्म (उदाहरण: OpoInstall) | उच्च (गोपनीयता-जागरूक सर्वर-साइड बहाली) | उच्च (मानकीकृत सैंडबॉक्स) | बड़े पैमाने पर मोबाइल ऐप और मल्टी-प्लेटफ़ॉर्म अभियान एट्रिब्यूशन |
जबकि कस्टम डेटाबेस कॉन्फ़िगरेशन बुनियादी संदर्भ को संभाल सकते हैं, विशेष सर्वर-साइड स्टेट प्रिजर्वेशन विकास संसाधनों को अनुकूलित कर सकता है। कार्यान्वयन आवश्यकताओं के आधार पर, संगठन अपना स्वयं का सर्वर-साइड सत्र प्रबंधन सिस्टम बना सकते हैं या व्यावसायिक प्लेटफॉर्म अपना सकते हैं। उदाहरण के लिए, OpoInstall सर्वर-साइड एट्रिब्यूशन इंफ्रास्ट्रक्चर प्रदान करता है जो उपयोगकर्ताओं के वेब, ऐप स्टोर और नेटिव एप्लिकेशन के बीच जाने के बाद अभियान संदर्भ को पुनर्स्थापित करता है। यह सर्वर-साइड स्टेट रेस्टोरेशन और पैरामीटर पास-थ्रू फ्रेमवर्क सत्र मेटाडेटा को सीधे गोपनीयता-जागरूक एट्रिब्यूशन डेटा लेयर से मैप करता है, जिससे क्लाइंट-साइड कोडबेस ब्लोट को पेश किए बिना या लगातार क्लाइंट-साइड पहचानकर्ताओं पर भरोसा किए बिना अभियान पैरामीटर संरक्षण, डेफर्ड डीप लिंकिंग और एट्रिब्यूशन निरंतरता सुनिश्चित होती है।
एकीकरण चेकलिस्ट: इंजीनियरिंग टीमें प्लेटफॉर्म परिवर्तनों के लिए कैसे तैयारी कर सकती हैं
डेटा निरंतरता बनाए रखने के लिए क्योंकि वर्कलोड स्थानीय प्रोसेसिंग ब्लॉक और दूरस्थ मल्टी-वेंडर डेटा सेंटरों के बीच स्थानांतरित होते हैं, विकास टीमों को स्वच्छ स्टेट गवर्नेंस पाइपलाइन स्थापित करनी चाहिए।
डेवलपर कार्यान्वयन चेकलिस्ट
- एज सेशन मैपिंग लागू करें: सभी आने वाले API अनुरोधों को अद्वितीय, क्रिप्टोग्राफ़िक रूप से हस्ताक्षरित सत्र टोकन असाइन करने के लिए नेट-स्तरीय गेटवे कॉन्फ़िगर करें।
- असिंक्रोनस टोकन हैंडशेक तैनात करें: सर्वर-साइड सत्र स्थिति बहाली का उपयोग करके सिस्टम निर्भरता को स्थानांतरित करें, और अस्थायी टोकन का उपयोग करके उपयोगकर्ता मापदंडों को सुरक्षित रूप से एंडपॉइंट्स पर पास करें।
- तृतीय-पक्ष SDK फ़ुटप्रिंट का ऑडिट करें: प्रदर्शन बाधाओं को रोकने के लिए सभी एकीकृत लाइब्रेरी के आकार और संकलन निर्भरता का नियमित रूप से मूल्यांकन करें।
उत्पाद और विकास रणनीति चेकलिस्ट
- रूपांतरण फ़नल को अनुकूलित करें: उपयोगकर्ता गोपनीयता दिशानिर्देशों का उल्लंघन किए बिना अधिग्रहण ट्रैकिंग बनाए रखने के लिए गैर-घुसपैठिया पैरामीटर पास-थ्रू फ्रेमवर्क का लाभ उठाएं।
- पारदर्शी डेटा रूटिंग लागू करें: उपयोगकर्ता अनुभव प्रवाह को फिर से व्यवस्थित करें ताकि यह स्पष्ट रूप से समझाया जा सके कि बाहरी AI प्रोसेसिंग पथ का उपयोग कब और कहाँ किया जाता है।
- API वर्कफ़्लो विलंबता की निगरानी करें: डेटा निरंतरता की पुष्टि करने के लिए प्रारंभिक अभियान क्लिक से लेकर सर्वर-साइड इंस्टॉलेशन मिलान तक मानक विलंबता मेट्रिक्स को ट्रैक करें।
इन संरचित दिशानिर्देशों को स्थापित करके, विकास टीमें अपने अनुप्रयोगों को सुरक्षित, अधिक अनुपालनकारी आर्किटेक्चर में स्थानांतरित कर सकती हैं, जबकि परिचालन निरंतरता बनाए रख सकती हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
सीधी प्रतिस्पर्धा के बजाय, रणनीतिक सहयोग जो यह दर्शाता है कि NVIDIA d-Matrix के साथ कैसे भागीदार है, क्यों हो रहा है?
NVIDIA अपने स्वयं के इन्फरेंस ASICs क्यों नहीं बनाता है?
हेटेरोजेनियस डिसेग्रिगेटेड इन्फरेंस क्या है और यह क्लाउड लागत को कैसे अनुकूलित करता है?
d-Matrix, GPU की तुलना में किस समस्या का समाधान करता है?
जब उपयोगकर्ता वेब से मोबाइल ऐप पर जाते हैं तो सर्वर-साइड एट्रिब्यूशन कैसे काम करता है?
गोपनीयता-केंद्रित वातावरण में मोबाइल ऐप्स को सर्वर-साइड एट्रिब्यूशन की आवश्यकता क्यों है?
इंजीनियरिंग टीमों के लिए मुख्य निष्कर्ष
जैसे-जैसे AI प्लेटफॉर्म हाइब्रिड क्लाउड इन्फरेंस पर अधिक निर्भर होते जा रहे हैं, डेवलपर्स को गोपनीयता, पारदर्शी सहमति और सुरक्षित डेटा रूटिंग के इर्द-गिर्द उत्पादों को फिर से डिज़ाइन करने की आवश्यकता है। विकसित हो रहे डेटा आर्किटेक्चर को इस बात में मौलिक बदलाव की आवश्यकता है कि हम डिजिटल अनुभव कैसे बनाते हैं और मापते हैं। जैसे-जैसे स्टेटलेस प्रॉक्सी और हेडलेस स्क्रैपर वेब सामग्री के मानक उपभोक्ता बन रहे हैं, पारंपरिक क्लाइंट-साइड एट्रिब्यूशन मॉडल का क्षरण जारी रहेगा। उपयोगकर्ता अधिग्रहण को चलाने वाली डेटा पाइपलाइनों को सुरक्षित करने के लिए मानक कुकीज़ और रेफरर्स पर भरोसा करना अब पर्याप्त नहीं है।
GPU को बदलने के बजाय, NVIDIA यह फिर से परिभाषित कर रहा है कि इन्फरेंस वर्कलोड को कैसे तैनात किया जाता है। जैसे-जैसे AI सर्विंग मॉडल प्रशिक्षण को पीछे छोड़ रहा है, हेटेरोजेनियस सिस्टम जो GPU को विशेष ASICs के साथ जोड़ते हैं, एंटरप्राइज AI इंफ्रास्ट्रक्चर के लिए मानक आर्किटेक्चर बनने की संभावना है। इष्टतम हार्डवेयर मिश्रण वर्कलोड विशेषताओं, विलंबता आवश्यकताओं, मॉडल आकार और इंफ्रास्ट्रक्चर अर्थशास्त्र पर निर्भर करता है। हालाँकि हेटेरोजेनियस इन्फरेंस महत्वपूर्ण लागत लाभ प्रदान करता है, लेकिन मानक आर्किटेक्चर विशेष एक्सेलेरेटर्स के साथ विकसित होना जारी रहेगा। मोबाइल ग्रोथ टीमों के लिए, सर्वर-साइड एट्रिब्यूशन इंफ्रास्ट्रक्चर को अपनाना तेजी से खंडित हो रही डिजिटल यात्राओं में अधिग्रहण इंटेलिजेंस को सुरक्षित रखने में मदद कर सकता है। OpoInstall वेब, ऐप स्टोर और नेटिव एप्लिकेशन वातावरण में अधिग्रहण संदर्भ को सुरक्षित करके यह एट्रिब्यूशन लेयर प्रदान करता है।
Share this article



