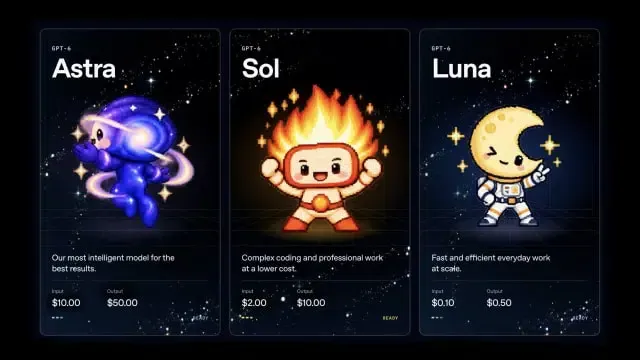
क्या OpenAI ने Sol API की लागत आधी कर दी है? OpenAI ने आधिकारिक तौर पर 22 सितंबर, 2026 को GPT-6 Sol और GPT-6 Luna की व्यावसायिक उपलब्धता की घोषणा की, जिससे मानक एंडपॉइंट्स पर पिछले GPT-5.6 प्रचार मूल्य निर्धारण की तुलना में API टोकन दरों में 50% या उससे अधिक की कमी आई है। 272K इनपुट टोकन तक के प्रॉम्प्ट की मानक प्रोसेसिंग के लिए, GPT-6 Sol की कीमत $2.00 प्रति मिलियन इनपुट टोकन और $10.00 प्रति मिलियन आउटपुट टोकन है, जबकि छोटा GPT-6 Luna मॉडल प्रति मिलियन टोकन पर $0.10 इनपुट और $0.50 आउटपुट पर उपलब्ध है। जब OpenAI मानक डेवलपर टियर में Sol API की लागत आधी कर देता है, तो संरचनात्मक कंप्यूट अपस्फीति जनरेटिव सॉफ्टवेयर की परिचालन बाधाओं को बदल देती है। कम यूनिट मूल्य निर्धारण से रिकर्सिव एजेंटिक लूप, बैकग्राउंड बैच एक्सट्रैक्शन और स्वायत्त बहु-चरणीय वर्कर बड़े पैमाने पर आर्थिक रूप से व्यवहार्य हो जाते हैं। हालाँकि, सिस्टम आर्किटेक्ट्स, विश्वसनीयता इंजीनियरों और बैकएंड डेवलपर्स के लिए, कम वित्तीय घर्षण डाउनस्ट्रीम स्केलेबिलिटी चुनौतियों को सामने लाता है, जिससे इंजीनियरिंग का ध्यान टोकन बजट से हटकर रेट-सीमा सीमाओं, समवर्ती सीमाओं, टेलीमेट्री पाइपलाइनों और बैकप्रेशर बाधाओं पर केंद्रित हो जाता है।
परिचालन संबंधी समस्या और वित्तीय बाधाएँ
उत्पादन उद्यम LLM अपनाने के शुरुआती चरणों के दौरान, नाममात्र टोकन शुल्क ने एक अनौपचारिक वास्तुकला गवर्नर के रूप में काम किया। उच्च अनुमान लागत के कारण विकास टीमों को मॉडल इनवेकेशन को अलग-अलग, उपयोगकर्ता-शुरुआत लेनदेन के रूप में मानना पड़ा। मासिक प्रदाता बिल पूर्वानुमानित बने रहें यह सुनिश्चित करने के लिए एप्लिकेशन मानव-इन-द-लूप अनुमोदन, सीमित संवादात्मक इतिहास और कड़ाई से थ्रॉटल किए गए शेड्यूल किए गए वर्कर पर बहुत अधिक निर्भर थे। स्थायी मध्यम-स्तरीय मॉडल कटौती का परिचय इन ऐतिहासिक ट्रेड-ऑफ को चुनौती देता है, जिससे सिस्टम इंजीनियरिंग चिंताएं मॉडल मूल्य निर्धारण से बैकएंड बुनियादी ढांचा लचीलापन की ओर स्थानांतरित हो जाती हैं।
एक नजर में
- बेसलाइन मूल्य में कमी: 22 सितंबर, 2026 को, OpenAI ने 272K टोकन तक के प्रॉम्प्ट पर मानक प्रोसेसिंग के लिए GPT-6 Sol को $2.00 इनपुट / $10.00 आउटपुट और GPT-6 Luna को $0.10 इनपुट / $0.50 आउटपुट प्रति मिलियन टोकन पर पेश किया, जो GPT-5.6 प्रचार API मूल्य निर्धारण की तुलना में 50% या अधिक नाममात्र कमी का प्रतिनिधित्व करता है।
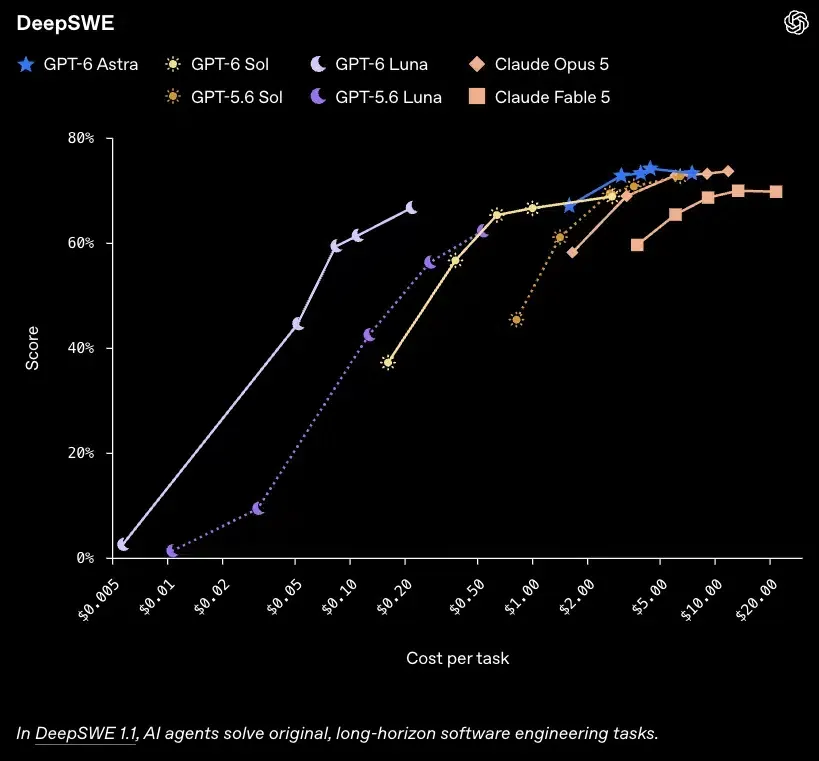
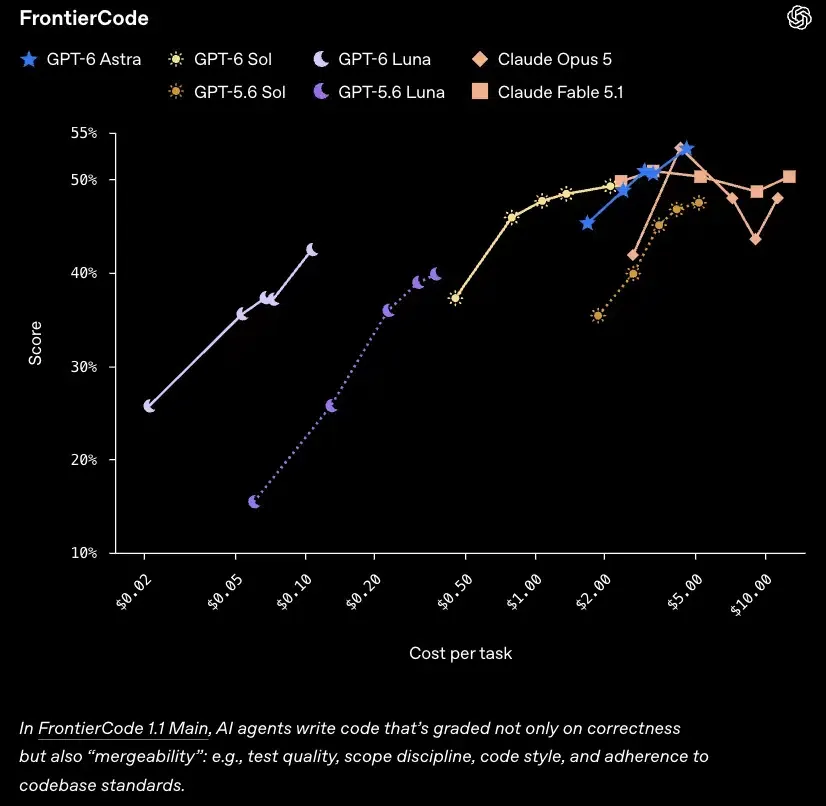
- टास्क-लेवल बेंचमार्क इकोनॉमिक्स: AutomationBench 1.0.6 पर, OpenAI रिपोर्ट करता है कि xhigh रीज़निंग प्रयास पर कॉन्फ़िगर किया गया GPT-6 Sol $0.27 प्रति प्रयास किए गए कार्य की औसत रिपोर्ट की गई लागत पर 33.2% वर्कफ़्लो स्कोर प्राप्त करता है, जिससे डेवलपर मूल्यांकन कच्चे टोकन मूल्य निर्धारण से कार्य की प्रति प्रयास इकाई लागत पर स्थानांतरित हो जाता है।
- प्रॉम्प्ट कैशिंग गतिशीलता: प्लेटफ़ॉर्म कैश किए गए इनपुट-टोकन रीड्स (बेस इनपुट-टोकन दर के 0.1× पर बिल किया गया) पर स्वचालित 90% छूट प्रदान करता है, जबकि शुरुआती कैश राइट्स को बिना कैश किए गए इनपुट-टोकन दर के 1.25× पर बिल किया जाता है, जिसके लिए गतिशील बहु-चरणीय रन में उच्च कैश हिट दरों को बनाए रखने के लिए सावधानीपूर्वक प्रीफ़िक्स सामान्यीकरण की आवश्यकता होती है।
आधिकारिक OpenAI डेवलपर API मूल्य निर्धारण संदर्भ और OpenAI सामुदायिक घोषणा में विस्तृत रूप से बताया गया है कि ये मूल्य निर्धारण संरचनाएँ निम्न-स्तरीय अनुमान पाइपलाइनों और KV कैशिंग प्रणालियों में निरंतर सुधारों से उपजी हैं। हालाँकि, जब स्वचालित कार्य अनुक्रमों को निष्पादित करने की लागत काफी कम हो जाती है, तो इंजीनियरिंग टीमें अपने बैकग्राउंड कार्यों के दायरे का विस्तार करती हैं। वह आर्थिक तल जिसने पहले बैकग्राउंड वर्कर को निरंतर पोलिंग, स्वचालित कोड समीक्षा पास, या बहु-चरणीय दस्तावेज़ निष्कर्षण पाइपलाइनों को चलाने से हतोत्साहित किया था, अब कम हो गया है।
पूरे बाजार में, कई फाउंडेशन-मॉडल प्रदाताओं ने डेवलपर टियर में API की कीमतों को कम या पुनर्गठित किया है। एंथ्रोपिक ने एंथ्रोपिक क्लाउड ओपस 5.5 प्लेटफ़ॉर्म विनिर्देश पर अद्यतन विशिष्टताओं के साथ क्लाउड ओपस 5.5 जारी किया, जिसमें 4 मिलियन इनपुट टोकन के लिए $4, 1 मिलियन कैश किए गए इनपुट रीड के लिए $0.20, और 1 मिलियन आउटपुट टोकन के लिए $20 का उद्धरण दिया गया है, जो कोड रिफैक्टरिंग बेंचमार्क पर कम टोकन खपत को उजागर करता है। साथ ही, गूगल ने डेवलपर्स के लिए Google AI पर प्रलेखित जेमिनी 3.8 फ्लैश के लिए अपनी प्रचारक परिचयात्मक मूल्य निर्धारण को बनाए रखा है, और Xiaomi के MiMo-V2.6-Pro जैसी ओपन-वेट रिलीज़ अनुमत सॉफ्टवेयर लाइसेंस के तहत स्व-होस्टिंग टीमों को आक्रामक टोकन-लागत विकल्प प्रदान करती हैं।
जब मॉडल की लागत गिरती है, तो विकास का व्यवहार बदल जाता है। इंजीनियरिंग टीमें गहरे रिकर्सिव लूप्स को तैनात करती हैं, सिस्टम प्रॉम्प्ट में व्यापक उद्यम दस्तावेज़ीकरण को इंजेक्ट करती हैं, और जटिल कार्य ग्राफ़ में स्वचालित पुनः प्रयास तर्क को कॉन्फ़िगर करती हैं। API परत पर जो लागत राहत के रूप में शुरू होता है, वह आंतरिक सेवाओं तक विलंबता और ट्रैफ़िक स्पाइक्स को स्थानांतरित कर सकता है। यदि कोई ऑर्केस्ट्रा वर्कर किसी एकल उपयोगकर्ता लेनदेन के लिए दर्जनों अनुक्रमिक या समानांतर मॉडल कॉल जारी करता है, तो आंतरिक डेटाबेस पूल, सहायक भंडारण क्लस्टर, टेलीमेट्री पाइपलाइन और दर सीमित करने वालों को परिणामी भार को अवशोषित करना होगा।
प्रणालीगत मूल कारण और गैर-दृश्य अनुरोध श्रृंखलाएँ
जब क्लाइंट एप्लिकेशन इंटरैक्टिव चैट इंटरफेस से गैर-दृश्य पृष्ठभूमि स्वचालन में परिवर्तित होते हैं, तो अपस्ट्रीम अनुरोध प्रोफाइल नाटकीय रूप से बदल जाते हैं। एक एकल व्यावसायिक घटना एक स्वायत्त पाइपलाइन को ट्रिगर कर सकती है जो स्कीमा का निरीक्षण करती है, पर्यावरण चर का मूल्यांकन करती है, बाहरी टूल को कॉल करती है, और कई निरंतर पास में आउटपुट को सत्यापित करती है।
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
रिकर्सिव एजेंट निष्पादन और समवर्ती गुणन
पारंपरिक इंटरैक्टिव वेब प्रणालियों में, अनुरोध मात्रा मानव अंतःक्रिया लय को दर्शाती है। प्रत्येक HTTP धागा आमतौर पर मानव सोचने के समय से बंधी कम समग्र फैन-आउट और पेसिंग के साथ एक स्पष्ट उपयोगकर्ता इंटरफ़ेस से मेल खाता है। क्लाइंट रनटाइम एक पेलोड भेजता है, प्रतिक्रिया की प्रतीक्षा करता है, और बाद की बातचीत शुरू करने से पहले रुकता है।
वैचारिक अनुरोध प्रोफ़ाइल तुलना: इंटरैक्टिव बनाम एजेंटिक
| आर्किटेक्चरल मेट्रिक | इंटरैक्टिव यूजर फ्लो | ऑटोनॉमस एजेंट लूप |
|---|---|---|
| समवर्ती मॉडल | मानव-गति अनुरोध फैन-आउट आमतौर पर कम होता है | 1 अंतर्ग्रहण घटना = N श्रृंखलाबद्ध चाइल्ड कॉल |
| निष्पादन समय | उपयोगकर्ता की प्रतिक्रिया और सोचने के समय द्वारा गति निर्धारित | नीति सीमाएं हस्तक्षेप करने तक स्वचालित रूप से आगे बढ़ती हैं |
| संदर्भ अमान्यीकरण | प्रति सत्र ताज़ा पेलोड | कैश किए गए संदर्भ पर बहुत अधिक निर्भर करता है |
| त्रुटि प्रबंधन | त्रुटि पर उपयोगकर्ता पुनः प्रयास | स्वचालित प्रोग्रामेटिक पुनः प्रयास |
| सिस्टम बॉटलनेक्स | फ्रंटएंड गेटवे बैंडविड्थ | आंतरिक डेटाबेस पूल सीमाएं |
| विफलता कैस्केड | एक सत्र तक सीमित | कतार संतृप्ति को ट्रिगर कर सकता है |
जब सिस्टम स्वायत्त एजेंटों को एकीकृत करते हैं, तो यह पेसिंग अलग हो जाती है। एक ट्रिगर की गई घटना स्वचालित कॉल का एक निर्बाध क्रम उत्पन्न कर सकती है। यदि कोई एजेंट किसी क्षणिक त्रुटि या विकृत टूल आउटपुट का सामना करता है, तो सरल पुनः प्रयास तर्क बैकएंड सेवाओं के विरुद्ध अनुरोधों के तीव्र विस्फोट उत्पन्न कर सकता है। चूँकि कम टोकन लागत लंबे निष्पादन रनों को किफायती बनाती है, स्वचालित वर्कफ़्लो एक फ्लैट सक्रिय उपयोगकर्ता आधार के साथ भी पृष्ठभूमि अनुरोध मात्रा को महत्वपूर्ण रूप से बढ़ा सकते हैं।
प्रॉम्प्ट कैश मैकेनिक्स: KV पुनः उपयोग, राइट ओवरहेड्स और प्रीफ़िक्स स्थिरता
OpenAI ने Sol और Luna रिलीज़ को अपने प्रॉम्प्ट कैशिंग सबसिस्टम में ऑप्टिमाइज़ेशन के साथ जोड़ा है। जैसा कि OpenAI प्रॉम्प्ट कैशिंग विनिर्देश में प्रलेखित है, कैश किए गए प्रीफ़िक्स से मेल खाने वाले इनपुट टोकन रीड मूल्य निर्धारण पर 90% की छूट प्राप्त करते हैं। प्रॉम्प्ट कैशिंग सामान्य प्रयोजन नेटवर्क-पेलोड संपीड़न तंत्र के रूप में कार्य करने के बजाय मुख्य रूप से मॉडल-साइड रीकंप्यूटेशन को कम करता है। मानक स्टेटलेस इंटरैक्शन में, क्लाइंट एप्लिकेशन अनुरोध संदर्भ प्रसारित करता है, और प्रदाता मिलान वाले प्रीफ़िक्स के लिए KV टेन्सर की पुनर्गणना को छोड़ देता है, जिससे पहले-टोकन विलंबता और इनपुट बिलिंग का समय काफी कम हो जाता है।
महत्वपूर्ण रूप से, सर्वर-साइड कैश में शुरुआती प्रीफ़िक्स लिखने पर बिना कैश किए गए इनपुट-टोकन दर के 1.25× पर बिल किया जाता है। लागत दक्षता को अधिकतम करने के लिए कई प्रश्नों में प्रीफ़िक्स स्थिरता बनाए रखने की आवश्यकता होती है।
चयनित सार्वजनिक API सूची मूल्य — प्रदाताओं के बीच सीधे तुलनीय नहीं
| मॉडल पहचानकर्ता | इनपुट ($/1M Tok) | आउटपुट ($/1M Tok) | कैश रीड नीति |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | 90% छूट (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | 90% छूट (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | डायनामिक टियरड प्राइसिंग |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M रीड (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | कैश पर 90% तक |
| Google Gemini 3.8 Flash | $0.75 (इंट्रो) | $3.75 (इंट्रो) | $0.075/1M कैश रीड |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M कैश रीड |
नोट: मानक दरें छोटे संदर्भ टियर (OpenAI के लिए 272K इनपुट टोकन तक के प्रॉम्प्ट) पर लागू होती हैं। प्रदाता विभिन्न कैश-राइट ओवरहेड्स, संदर्भ सीमाएं और समय-बद्ध प्रचार शर्तें लागू करते हैं।
प्रीफ़िक्स संरक्षण के लिए API कॉन्फ़िगरेशन विकल्पों को सावधानीपूर्वक संभालने की आवश्यकता होती है। OpenAI के API आर्किटेक्चर में, रीज़निंग प्रयास मापदंडों को सीधे बदलने या टूल परिभाषा सरणी को बदलने से रेंडर किया गया प्रॉम्प्ट प्रीफ़िक्स बदल जाएगा और पहले से कैश की गई अवस्थाएं अमान्य हो जाएंगी।
मल्टी-टर्न सत्रों के दौरान कैश किए गए संदर्भ को संरक्षित करने के लिए, डेवलपर्स को टूल स्कीमा और बेसलाइन निर्देशों को एक सुसंगत क्रम में रखना होगा। यदि रनटाइम समायोजन की आवश्यकता है, तो डेवलपर्स को संरचित सत्र नियंत्रणों (जैसे configuration_update) के माध्यम से मापदंडों को अपडेट करना चाहिए या सीधे टूल परिभाषा सरणी को संशोधित करने के बजाय tool_choice या allowed_tools का उपयोग करके टूल निष्पादन को टॉगल करना चाहिए।
जब कैश मिस होता है, तो अपस्ट्रीम प्रदाता 90% रीड छूट के बिना इनपुट अनुक्रम को पुनर्संस्कृत करता है। पैमाने पर, यह अनुमान विलंबता और समय ਸਮਾप्ति दबाव को बढ़ा सकता है। बहु-चरण कार्य निष्पादन के लिए, लागत मूल्यांकन सरल टोकन गुणकों से पूर्ण कार्य व्यय की ओर बढ़ता है, जैसा कि GPT-6 Sol और Luna बेंचमार्क पर वेंचरबीट रिपोर्टिंग में देखा गया है, जहाँ GPT-6 Sol ने AutomationBench 1.0.6 पर $0.27 प्रति प्रयास कार्य पर 33.2% स्कोर प्राप्त किया।
telemetry आर्किटेक्चर: अनुपालन ऑडिट से परिचालन मीट्रिक को अलग करना
स्वचालित LLM अनुरोधों में वृद्धि बैकएंड ऑब्जर्वेबिलिटी और अनुपालन पाइपलाइनों पर महत्वपूर्ण दबाव डालती है। उच्च-समवर्ती एजेंट वर्कफ़्लो के लिए परिचालन टेलीमेट्री और कानूनी ऑडिट ट्रेल्स के बीच स्पष्ट वास्तुशिल्प पृथक्करण की आवश्यकता होती है।
एंटरप्राइज़ अनुपालन नीतियों को अक्सर सत्र मेटाडेटा, टूल निष्पादन प्रमाण और लेनदेन रिकॉर्ड रिकॉर्ड करने की आवश्यकता होती है। परिचालन टेलीमेट्री और अनुपालन डेटा को समान रूप से मानने से गंभीर इंजीनियरिंग ट्रेड-ऑफ पैदा होते हैं:
- अनुपालन और सुरक्षा ऑडिट चैनल: स्पष्ट पुनः प्रयास, दृढ़ता और विफलता हैंडलिंग के साथ एक बार लिखने योग्य, एक्सेस-नियंत्रित ऑडिट स्टोर में टिकाऊ, रीप्लेबल डिलीवरी प्रदान करनी चाहिए। पेलोड को व्यक्तिगत रूप से पहचान योग्य जानकारी (PII) और गुप्त कुंजियों को व्यवस्थित रूप से सैनिटाइज करते हुए संरचित मेटाडेटा, कॉलर पहचान और क्रिप्टोग्राफिक स्थिति को कैप्चर करना चाहिए। उच्च भार के तहत, इन पाइपलाइनों को रिकॉर्ड को त्यागने के बजाय बैकप्रेशर लागू करना चाहिए या कार्यों को टिकाऊ रूप से कतारबद्ध करना चाहिए।
- परिचालन टेलीमेट्री चैनल: टोकन गिनती, प्रॉम्प्ट कैश हिट अनुपात और अपस्ट्रीम प्रतिक्रिया विलंबता जैसे प्रदर्शन मेट्रिक को ट्रैक करें। चूँकि इन ट्रेस का उपयोग वास्तविक समय की निगरानी और डिबगिंग के लिए किया जाता है, इसलिए इन्हें बाध्य, ह्रासमान ड्रॉप बफर के माध्यम से संसाधित किया जा सकता है। यदि डाउनस्ट्रीम कलेक्टर धीमे हो जाते हैं, तो एप्लिकेशन कोर सेवा उपलब्धता को बनाए रखने के लिए अतिरिक्त परिचालन टेलीमेट्री को सुरक्षित रूप से शेड कर सकता है।
जब बाहरी प्रदाता HTTP 429 दर-सीमा त्रुटियां लौटाते हैं, तो खराब कॉन्फ़िगर किए गए पुनः प्रयास नीतियां गंभीर परिचालन समस्याएं पैदा कर सकती हैं। यादृच्छिक जिथर के बिना तत्काल पुनः प्रयास या सिंक्रनाइज़ घातीय बैकोफ रूटीन पुनः प्रयास तरंगें बना सकते हैं जो मध्यवर्ती माइक्रोसेवाओं के माध्यम से कैस्केड कर सकती हैं, थ्रेड पूल और डेटाबेस कनेक्शन का उपभोग कर सकती हैं।
समाधान तुलना: बिल्ड बनाम बाय ट्रेड-ऑफ
कम अनुमान लागत के परिणामस्वरूप होने वाले परिचालन भार को प्रबंधित करने के लिए संगठनों को अपने AI गेटवे और प्रॉक्सी आर्किटेक्चर का मूल्यांकन करने की आवश्यकता होती है। टीमों को यह तय करना होगा कि इन-हाउस कस्टम रूटिंग, रेट-लिमिटिंग और टेलीमेट्री प्रॉक्सी विकसित करें या विशेष तृतीय-पक्ष बुनियादी ढांचे को तैनात करें।
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
कस्टम इन-हाउस लचीलापन पाइपलाइन
कस्टम बुनियादी ढांचे का विकास इंजीनियरिंग टीमों को नेटवर्किंग नीतियों, डेटा सैनिटाइजेशन और रूटिंग रणनीतियों पर पूरा नियंत्रण देता है। संगठन अपनी सटीक आंतरिक माइक्रोसेवा टोपोलॉजी के अनुरूप एज प्रॉक्सी बना सकते हैं।
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
हालाँकि, आंतरिक विकास के लिए निरंतर इंजीनियरिंग रखरखाव की आवश्यकता होती है। टीमों को प्रदाता API अपडेट के अनुसार मैन्युअल रूप से अनुकूलन करना होगा, कई विक्रेताओं में विकसित होने वाली दर सीमाओं को संभालना होगा, और वितरित टेलीमेट्री कतारों का प्रबंधन करना होगा। यह रखरखाव ओवरहेड आंतरिक डेवलपर संसाधनों को मुख्य उत्पाद सुविधाओं से दूर कर सकता है।
कमर्शियल गेटवे और इंफ्रास्ट्रक्चर टूलिंग
इन क्षमताओं को शुरू से बनाने से बचने के लिए, कई उद्यम प्रबंधित API प्रॉक्सी, LLM गेटवे और एज कंट्रोल प्लेन तैनात करते हैं। कुछ प्रबंधित गेटवे प्रदाता-जागरूक दर-सीमा समन्वय, ऑब्जर्वेबिलिटी, नीति नियंत्रण और कैश-जागरूक रूटिंग प्रदान करते हैं; सटीक क्षमताएं विक्रेता के अनुसार भिन्न होती हैं, और प्रीफ़िक्स ऑप्टिमाइज़ेशन के लिए अक्सर अभी भी एप्लिकेशन-स्तरीय अनुरोध अनुशासन की आवश्यकता होती है।
वाणिज्यिक प्लेटफ़ॉर्म इंजीनियरिंग टीमों को प्रति वातावरण लागत कोटा लागू करने, मॉडल परिवारों में स्वचालित फ़ॉलबैक रूटिंग को कॉन्फ़िगर करने, और अनुरोध मेटाडेटा को लॉग करने से पहले संवेदनशील ग्राहक जानकारी को हटाने की अनुमति देते हैं। उद्देश्य-निर्मित गेटवे समवर्ती स्पाइक्स का प्रबंधन करते हैं, ऑडिट API खपत के रुझान करते हैं, और जटिल एप्लिकेशन वातावरण में डाउनस्ट्रीम माइक्रोसेवाओं की रक्षा करते हैं।
निर्णय मैट्रिक्स: इन-हाउस पाइपलाइन बनाम प्रबंधित प्लेटफ़ॉर्म
| मूल्यांकन मानदंड | इन-हाउस रेजिलिएंसी टूलिंग | मैनेज्ड रूटिंग इन्फ्रास्ट्रक्चर |
|---|---|---|
| अपफ्रंट देव प्रयास | उच्च (3-6 इंजीनियरिंग सप्ताह) | कम (मानक API के माध्यम से एकीकृत होता है) |
| प्रोटोकॉल रखरखाव | निरंतर टीम की जिम्मेदारी | विक्रेता अपडेट द्वारा संभाला जाता है |
| परिचालन नियंत्रण | पूर्ण स्टैक दृश्यता | विक्रेता इंटरफ़ेस द्वारा सीमित |
| प्रॉम्प्ट कैश ट्यूनिंग | कस्टम प्रॉक्सी की आवश्यकता है | विक्रेता-निर्भर; आमतौर पर एप्लिकेशन सहयोग की आवश्यकता होती है |
| टेलीमेट्री आइसोलेशन | कस्टम कतार प्रबंधन | विक्रेता-निर्भर |
| वित्तीय लागत प्रोफ़ाइल | इंजीनियरिंग पेरोल ओवरहेड | आवर्ती SaaS / उपयोग शुल्क |
एकीकरण चेकलिस्ट और शासन अनुसूची
GPT-6 Sol और Luna मूल्य में कमी के बाद अपने मॉडल के उपयोग को बढ़ाने वाले संगठन प्रणालीगत ओवरलोड को रोकने के लिए इस परिचालन ढांचे का उपयोग कर सकते हैं:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
टेलीमेट्री पाइपलाइन कॉन्फ़िगरेशन
ऑब्जर्वेबिलिटी सिस्टम को वास्तविक समय के अनुरोध पथों से प्रॉम्प्ट लॉगिंग को अलग करना चाहिए। उच्च-आवृत्ति एजेंट वर्कफ़्लो को संसाधित करते समय, अनुप्रयोगों को मेमोरी-बाउंड असमकालिक कतारों में टेलीमेट्री मेटाडेटा लिखना चाहिए, जिससे डाउनस्ट्रीम टेलीमेट्री कलेक्टर धीमे होने पर I/O स्टॉल को रोका जा सके।
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
अक्सर पूछे जाने वाले प्रश्न (FAQ)
GPT-6 Sol और Luna के लिए आधिकारिक API दरें क्या हैं?
प्रॉम्प्ट कैशिंग लंबी बातचीत पर लागत कैसे कम करती है?
सस्ते टोकन बैकएंड परिचालन जोखिम को क्यों बढ़ाते हैं?
इंजीनियरिंग टीमों के लिए मुख्य बातें
GPT-6 Sol और Luna का लॉन्च एक व्यापक प्रवृत्ति को गति देता है: सीमावर्ती बुद्धिमत्ता सस्ती और अधिक सुलभ हो रही है। जैसे-जैसे यूनिट टोकन की लागत तेजी से गिरती है, वित्तीय बाधाएं सॉफ्टवेयर आर्किटेक्चर के लिए एक प्रभावी नियंत्रण तंत्र नहीं रह जाती हैं।
जैसे-जैसे संगठन उच्च-आवृत्ति एजेंटों और बहु-स्तरीय मॉडल टोपोलॉजी को अपनाते हैं, परिचालन इंजीनियरिंग उद्यम की सफलता के लिए महत्वपूर्ण हो जाती है। टीमों को केवल नाममात्र टोकन कीमतों या बेंचमार्क स्कोर द्वारा मॉडल का मूल्यांकन करने से आगे बढ़ना चाहिए। दीर्घकालिक विश्वसनीयता इस बात पर निर्भर करेगी कि सिस्टम कितनी प्रभावी ढंग से समवर्तीता का प्रबंधन करते हैं, कैश पुन उपयोग के लिए प्रॉम्प्ट संदर्भों को संरेखित करते हैं, अपस्ट्रीम दर सीमाओं को सुचारू रूप से संभालते हैं, और महत्वपूर्ण एप्लिकेशन पथों से टेलीमेट्री को अलग करते हैं। लचीला बुनियादी ढांचा बनाने वाले संगठन एप्लिकेशन अपटाइम या सिस्टम स्थिरता का त्याग किए बिना अपने स्वचालित एजेंट वर्कफ़्लो को सफलतापूर्वक स्केल करेंगे।
प्राथमिक स्रोत और संदर्भ प्रलेखन
-
OpenAI डेवलपर API मूल्य निर्धारण संदर्भ: आधिकारिक डेवलपर दर कार्ड, संदर्भ विंडो बाधाएं (≤272K मानक सीमा), और GPT-6 Sol, Luna और Astra के लिए कैश रीड/राइट मूल्य निर्धारण अनुसूचियां।
-
OpenAI सामुदायिक घोषणा: GPT-5.6 प्रचार टियर और मील का पत्थर रोलआउट विवरण के सापेक्ष 50% बेसलाइन मूल्य में कमी की पुष्टि करने वाला सार्वजनिक खुलासा।
-
OpenAI प्रॉम्प्ट कैशिंग विनिर्देश: सर्वर-साइड की-वैल्यू प्रीफ़िक्स पुन उपयोग, कैश राइट ओवरहेड्स और कॉन्फ़िगरेशन अमान्यीकरण नियमों पर वास्तुशिल्प प्रलेखन।
-
एंथ्रोपिक क्लाउड ओपस 5.5 प्लेटफ़ॉर्म विनिर्देश: $4 इनपुट / $20 आउटपुट / $0.20 कैश रीड टोकन दरों और बेंचमार्क प्रदर्शन की पुष्टि करने वाली आधिकारिक रिलीज़ विनिर्देश।
-
एंथ्रोपिक क्लाउड सोनेट 5 अवलोकन: आधिकारिक डेवलपर दर कार्ड और प्रॉम्प्ट कैशिंग दक्षता मेट्रिक ($2 इनपुट / $10 आउटपुट / 90% तक कैश छूट)।
-
डेवलपर्स दर कार्ड के लिए Google AI: जेमिनी 3.8 फ्लैश के लिए डेवलपर दर कार्ड और परिचयात्मक मूल्य निर्धारण नीतियों का अवलोकन।
-
Xiaomi MiMo आधिकारिक API मूल्य निर्धारण और दर अनुसूची: MiMo-V2.6-Pro अनुमान के लिए कैनोनिकल विदेशी पे-एज़-यू-गो टोकन दरें ($0.435 इनपुट / $0.87 आउटपुट / $0.0036 कैश हिट)।
-
GPT-6 Sol और Luna बेंचमार्क पर वेंचरबीट रिपोर्टिंग: रिलीज़ अर्थशास्त्र, स्थायी मूल्य निर्धारण गारंटी, और AutomationBench 1.0.6 कार्य लागत के आंकड़ों ($0.27 प्रति प्रयास कार्य) का कवरेज।
Share this article



