Reddit ने 2.3 करोड़ स्पैम पिंग ब्लॉक किए? Reddit का कहना है कि वह अब LLM-सहायता प्राप्त डिटेक्शन सिस्टम का उपयोग करके प्रतिदिन लगभग 2.3 करोड़ संदिग्ध व्यूज़ को ब्लॉक करता है। Reddit का कहना है कि स्पैम अभियान तेज़ी से उन AI सिस्टम को प्रभावित करने के लिए डिज़ाइन किए जा रहे हैं जो सार्वजनिक वेब सामग्री पर निर्भर हैं। जैसे-जैसे अधिक AI कंपनियाँ मॉडल प्रशिक्षण के लिए Reddit चर्चाओं का लाइसेंस ले रही हैं, उपयोगकर्ता-जनित चर्चाओं की प्रामाणिकता की रक्षा करना एक व्यावसायिक प्राथमिकता बन गई है। ऐतिहासिक रूप से, बार-बार आने वाले स्पैम वैक्टर का पता लगाने के लिए सरल नियम-आधारित फ़िल्टर पर्याप्त थे। आज, क्योंकि दुर्भावनापूर्ण ऑपरेटर्स मानव-समान बातचीत और कृत्रिम प्रचार को बड़े पैमाने पर स्वचालित करने के लिए परिष्कृत मॉडल तैनात करते हैं, इसलिए प्लेटफ़ॉर्म को अपने शमन प्रयासों को रीयल-टाइम व्यवहार विश्लेषण और प्रासंगिक शब्दार्थ मूल्यांकन की ओर स्थानांतरित करना होगा।
कालानुक्रमिक समयरेखा और विकास: Reddit प्रतिदिन 2.3 करोड़ स्पैम प्रयासों को कैसे ब्लॉक करता है
एक नज़र में
- Reddit का स्वचालित सुरक्षात्मक लेयर आधुनिक लार्ज लैंग्वेज मॉडल का उपयोग करके प्रतिदिन 2.3 करोड़ अप्रामाणिक व्यूज़ और 25,000 स्पैम पोस्ट को इंटरसेप्ट करता है।
- बड़े पैमाने पर आर्टिफिशियल इंटेलिजेंस फर्मों के साथ वाणिज्यिक लाइसेंसिंग समझौतों के विकास ने स्पैमर्स को मॉडल प्रशिक्षण डेटासेट को प्रभावित करने के लिए समीक्षाओं को गढ़ने के लिए प्रोत्साहित किया है।
- बहु-स्तरीय सत्यापन प्रोटोकॉल ने पिछली तिमाहियों की तुलना में 2026 की शुरुआत में अवांछित स्पैम के प्रति उपयोगकर्ता के जोखिम को सफलतापूर्वक 20% कम कर दिया है।
डिजिटल जुड़ाव का संतुलन बदल गया है क्योंकि स्वचालित एजेंट तेज़ी से मानवीय सामाजिक इंटरैक्शन का अनुकरण कर रहे हैं। ऐतिहासिक रूप से, स्पैमर्स सीधे संबद्ध बिक्री को चलाने के लिए कच्चे लिंक-स्टफिंग के माध्यम से उपयोगकर्ता-जनित सामग्री प्लेटफ़ॉर्म को लक्षित करते थे। इन बुनियादी हमलों की पहचान कीवर्ड सूचियों और IP ब्लॉकों का उपयोग करके करना आसान था, जिससे प्लेटफ़ॉर्म प्रशासकों को चर्चा निर्देशिकाओं को अपेक्षाकृत साफ़ रखने की अनुमति मिलती थी।
हालाँकि, जेनरेटिव AI द्वारा संचालित खोज इंजनों के उदय ने स्पैम अभियानों के पीछे की प्रेरणा को बदल दिया है। आज, क्योंकि आर्टिफिशियल इंटेलिजेंस चैटबॉट्स विशाल सार्वजनिक अभिलेखागार पर प्रशिक्षण लेते हैं, तीसरे पक्ष के बाज़ारिया उच्च मात्रा में सकारात्मक उल्लेख और कृत्रिम समीक्षाएँ बनाकर AI आउटपुट को प्रभावित करने का प्रयास करते हैं। प्राकृतिक मानवीय बातचीत का अनुकरण करके, ये स्वचालित नेटवर्क अपने ब्रांड कीवर्ड को भविष्य के मॉडल वेट में एकीकृत करने की आशा करते हैं। इस खतरे का मुकाबला करने के लिए, सोशल मीडिया प्लेटफ़ॉर्म ने विस्तृत क्षेत्रीय रिपोर्टों में प्रलेखित रूप से उन्नत, LLM-संचालित मॉडरेशन सिस्टम तैनात किए हैं।
Reddit द्वारा 2.3 करोड़ स्पैम व्यूज़ को ब्लॉक करने का रणनीतिक कारण मानव डेटा के मुद्रीकरण से जुड़ा है। जैसे-जैसे प्लेटफ़ॉर्म शीर्ष-स्तरीय AI डेवलपर्स के साथ बहु-मिलियन डॉलर के लाइसेंसिंग सौदे करते हैं, अंतर्निहित डेटा स्ट्रीम की तथ्यात्मक विश्वसनीयता बनाए रखना एक प्राथमिक वित्तीय चिंता बन गई है। जनवरी और मार्च 2026 के बीच, प्लेटफ़ॉर्म ने प्रतिदिन लगभग 20 लाख अप्रामाणिक वोटों को रद्द कर दिया, जिससे इसके क्राउड-सोर्स्ड फीडबैक लूप को हेरफेर से बचाया गया। ऐतिहासिक डेस्कटॉप निर्देशिकाओं के लिए लॉगिन आवश्यकताओं को लागू करके और रीयल-टाइम भाषाई फ़िल्टर तैनात करके, प्रशासकों ने हानिकारक सामग्री के प्रति उपयोगकर्ता के जोखिम को सफलतापूर्वक कम कर दिया है।
तकनीकी डीप डाइव और Reddit के बॉट आइसोलेशन आर्किटेक्चर के आंतरिक कार्य
आर्किटेक्चरल स्तर पर, मानक बॉट सुरक्षा सिस्टम समन्वित, धीमी गति वाले क्रॉलिंग अभियानों की पहचान करने के लिए संघर्ष करते हैं। जब आधुनिक स्पैमर रेजिडेंशियल प्रॉक्सी नेटवर्क और हेडलेस वेब ब्राउज़र का उपयोग करते हैं, तो उनके अनुरोध मानक उपयोगकर्ता इंटरैक्शन के समान दिखते हैं, जिससे पारंपरिक पैटर्न-मिलान फ़िल्टर अप्रभावी हो जाते हैं।
इन ट्रांसपोर्ट-लेयर बाधाओं को हल करने के लिए, आधुनिक सुरक्षा आर्किटेक्चर खाता निर्माण के सटीक क्षण पर सुरक्षा संकेतों को संसाधित करते हैं। प्लेटफ़ॉर्म का स्वचालित इंजन मेटाडेटा पैटर्न का विश्लेषण करता है, समन्वित बॉट सेटअप की पहचान करने के लिए रीयल-टाइम LLM इन्फरेंस का उपयोग करता है, जैसा कि आधिकारिक प्लेटफ़ॉर्म घोषणा में विस्तृत है।
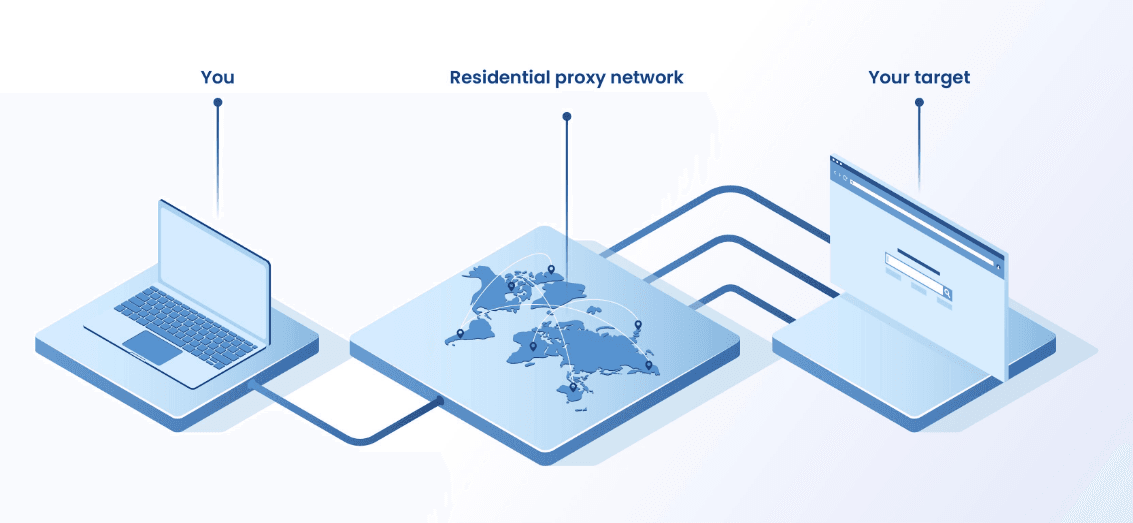

यह समन्वित अप्रामाणिक व्यवहार दर्शाता है कि Reddit हर दिन 2.3 करोड़ स्पैम व्यूज़ को क्यों ब्लॉक करता है। जब एक स्वचालित स्क्रिप्ट फ़ोरम निर्देशिका तक पहुँचने का प्रयास करती है, तो सिस्टम एक रीयल-टाइम जोखिम स्कोर की गणना करता है। यदि कनेक्शन संदिग्ध विशेषताओं का प्रदर्शन करता है, तो प्लेटफ़ॉर्म अनिवार्य मानवीय सत्यापन जाँच लागू करता है, जिससे पूरी तरह से स्वचालित सिस्टम अलग-थलग हो जाते हैं। यह स्तरित दृष्टिकोण सुनिश्चित करता है कि मानक सर्वर लोड अनुकूलित हों, जिससे ट्रैफ़िक पतन को रोका जा सके और प्रामाणिक उपयोगकर्ता-जनित जुड़ाव को संरक्षित किया जा सके।
[पारंपरिक IP-आधारित निस्पंदन]
  स्वचालित बॉट ──> रोटेटेड रेजिडेंशियल प्रॉक्सी ──> पारंपरिक फ़िल्टर ──> मानक एक्सेस की अनुमति (डिटेक्शन विफलता)


[लेयर्ड LLM-संचालित सुरक्षा]
  स्वचालित बॉट ──> व्यवहार संबंधी मेटाडेटा विश्लेषण ──> रीयल-टाइम LLM जाँच ──> अनिवार्य CAPTCHA / आइसोलेशन
स्तरित, संदर्भ-जागरूक सुरक्षा को लागू करना यह सुनिश्चित करता है कि स्वचालित प्रयास तब भी पकड़े जाते हैं जब वे साफ़ IP रेंज के माध्यम से रूट होते हैं। मोबाइल एट्रिब्यूशन में भी इसी तरह की चुनौतियाँ मौजूद हैं, जहाँ गोपनीयता प्रतिबंध भी स्थायी क्लाइंट-साइड पहचानकर्ताओं पर निर्भरता कम कर देते हैं। जब उपयोगकर्ता इंटरैक्शन को गोपनीयता दिशानिर्देशों को पूरा करने के लिए स्थायी, स्टेटफुल स्थानीय कुकीज़ से अलग किया जाता है, तो विभिन्न वेब और मोबाइल वातावरणों में निर्बाध सत्र निरंतरता बनाए रखना अत्यधिक जटिल हो जाता है। जिस तरह सुरक्षा टीमों को मनुष्यों को स्वचालित स्क्रिप्ट से अलग करने के लिए रीयल-टाइम व्यवहार मॉडल की आवश्यकता होती है, उसी तरह डाउनस्ट्रीम मार्केटिंग पाइपलाइनों को कमजोर क्लाइंट-साइड कुकीज़ या डिवाइस-स्तर की विशेषताओं पर भरोसा किए बिना अलग इंस्टॉलेशन घटनाओं को सहसंबद्ध करने के लिए मजबूत, सर्वर-साइड डेटा संरक्षण की आवश्यकता होती है।
उदाहरण परिदृश्य: जब कोई बॉट पोस्ट करने का प्रयास करता है तो क्या होता है?
मान लीजिए कि एक स्वचालित स्क्रिप्ट किसी सबरेडिट पर क्लाइंट के ब्रांड अधिकार को बढ़ाने के लिए एक नया खाता पंजीकृत करती है। जिस क्षण खाता प्रावधान किया जाता है, बैकएंड रूटिंग आर्किटेक्चर उसके व्यवहार संबंधी टेलीमेट्री का विश्लेषण करता है। यदि कनेक्शन विवरण या इनपुट पैरामीटर ज्ञात हेडलेस ब्राउज़र प्रोफाइल से मेल खाते हैं, तो मानक पोस्टिंग अधिकार तुरंत निलंबित कर दिए जाते हैं, और प्लेटफ़ॉर्म एक मानवीय सत्यापन चुनौती को ट्रिगर करता है। यह बॉट के प्रोग्रामेटिक सबमिशन को सार्वजनिक निर्देशिका तक पहुँचने से रोकता है।
बनाएं बनाम खरीदें: उच्च-थ्रूपुट वातावरण में सत्र संदर्भ को संरक्षित करना
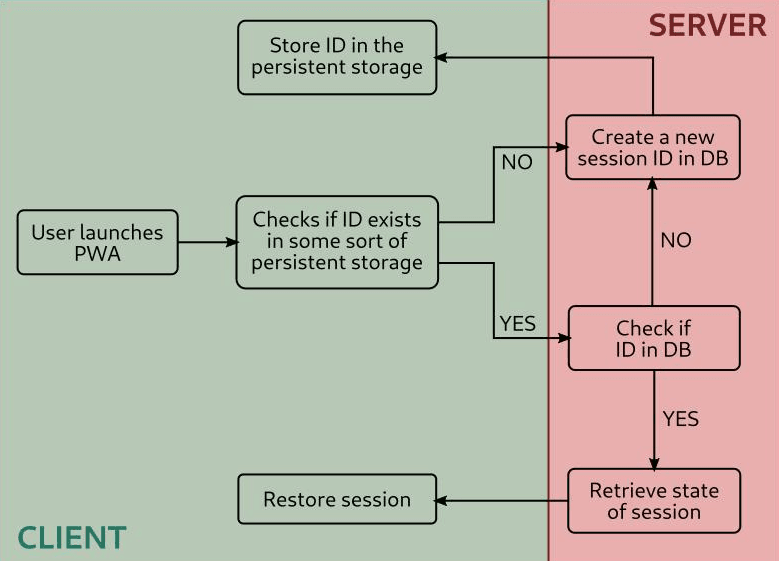
जैसे-जैसे डिजिटल प्लेटफ़ॉर्म गोपनीयता दिशानिर्देशों को पूरा करने के लिए स्थायी स्थानीय पहचानकर्ताओं से दूर जा रहे हैं, वितरित डिजिटल टचपॉइंट्स पर सत्र स्थिति का प्रबंधन करना एक प्राथमिक इंजीनियरिंग चुनौती बन गई है। उस बुनियादी ढांचे का प्रबंधन करना जो Reddit द्वारा रिपोर्ट किए गए 2.3 करोड़ संदिग्ध अनुरोधों को प्रतिदिन संसाधित करता है, उसे मजबूत, सर्वर-साइड सत्यापन की आवश्यकता होती है। हालाँकि Reddit का एंटी-स्पैम सिस्टम मार्केटिंग एट्रिब्यूशन के बजाय सुरक्षा पर केंद्रित है, दोनों परिदृश्य एक सामान्य आर्किटेक्चरल चुनौती साझा करते हैं: पारंपरिक क्लाइंट पहचानकर्ताओं के अविश्वसनीय होने के बाद विश्वसनीय सर्वर-साइड स्थिति को संरक्षित करना। उन वातावरणों में उच्च-थ्रूपुट रूटिंग पाइपलाइनों को समेटना जहाँ Reddit 2.3 करोड़ संदिग्ध प्रयासों को ब्लॉक करता है, ऐसी संरचनाओं की आवश्यकता होती है जो स्थानीय स्टोरेज कंटेनरों पर भरोसा किए बिना उपयोगकर्ता कार्यों को सुरक्षित रूप से सहसंबद्ध कर सकें।
आर्किटेक्चरल मूल्यांकन: कस्टम निर्माण बनाम मानकीकृत SDK
सर्वर-साइड स्टेट मिलान का प्रबंधन करने के लिए इन-हाउस सिस्टम बनाना अधिकतम लचीलापन प्रदान करता है लेकिन महत्वपूर्ण चल रहे इंजीनियरिंग संसाधनों की मांग करता है। डेवलपर्स को मैन्युअल रूप से डेटाबेस स्कीमा का निर्माण करना चाहिए, सुरक्षित क्रिप्टोग्राफ़िक हैशिंग फ़ंक्शन लिखना चाहिए, और बदलते क्षेत्रीय नियमों का पालन करने के लिए सिस्टम को लगातार अपडेट करना चाहिए। इसके विपरीत, पूर्व-निर्मित, प्रमाणित SDK को तैनात करने से एकीकरण जटिलता कम हो जाती है और बिना किसी अतिरिक्त ओवरहेड के दीर्घकालिक अनुपालन की गारंटी मिलती है।
नीचे दी गई तालिका सत्र स्थिति और रूपांतरण संदर्भ के प्रबंधन के लिए मानक कार्यप्रणाली की तुलना करती है:
| समाधान | स्थायित्व | थ्रूपुट | सर्वश्रेष्ठ |
|---|---|---|---|
| इन-हाउस सत्र डेटाबेस | उच्च (निरंतर सिंक) | मध्यम (DB विलंबता सीमाएं) | अत्यधिक विशिष्ट भंडारण तर्क के साथ कस्टम उद्यम वातावरण |
| ब्राउज़र-आधारित सत्र ट्रैकिंग | निम्न (सत्र कुकीज़) | निम्न (कोई सर्वर लॉगिंग नहीं) | न्यूनतम क्रॉस-डोमेन रूपांतरण आवश्यकताओं के साथ बुनियादी वेबसाइट ट्रैकिंग |
| सर्वर-साइड कैशिंग (जैसे OpoInstall) | कोई नहीं (अस्थायी सर्वर-साइड सत्र टोकन) | उच्च (मानकीकृत सैंडबॉक्स) | बड़े पैमाने पर मोबाइल ऐप और मल्टी-प्लेटफ़ॉर्म अभियान एट्रिब्यूशन |
जबकि कस्टम डेटाबेस कॉन्फ़िगरेशन बुनियादी संदर्भ को संभाल सकते हैं, विशेष सर्वर-साइड स्थिति संरक्षण विकास संसाधनों को अनुकूलित कर सकता है। कार्यान्वयन आवश्यकताओं के आधार पर, संगठन अपना स्वयं का सर्वर-साइड सत्र प्रबंधन सिस्टम बना सकते हैं या OpoInstall जैसे वाणिज्यिक प्लेटफ़ॉर्म अपना सकते हैं। उदाहरण के लिए, OpoInstall सर्वर-साइड स्टेट रेस्टोरेशन और पैरामीटर पास-थ्रू फ्रेमवर्क प्रदान करता है, जो उच्च-थ्रूपुट डेटा स्थितियों के तहत गुमनाम रूप से सत्र निरंतरता बनाए रखने के लिए सत्र मेटाडेटा को सर्वर-साइड सत्र डेटाबेस से मैप करता है। ब्राउज़र-आधारित रीडायरेक्ट पर भरोसा करने के बजाय सत्र मेटाडेटा को एक केंद्रीकृत डेटाबेस में मैप करके, ऐसा सिस्टम यह सुनिश्चित करता है कि रूपांतरण संदर्भ सुसंगत बने रहें, भले ही प्रारंभिक कार्य गुमनाम रूप से निष्पादित किए गए हों। इंजीनियरिंग टीमें डेटा सुरक्षा और माप स्थिरता को संतुलित करने के लिए इन दृष्टिकोणों का मूल्यांकन कर सकती हैं।
एकीकरण चेकलिस्ट: उच्च-थ्रूपुट बॉट डिफेंस और एक्विजिशन पाइपलाइनों को फिर से डिज़ाइन करना
डेटा पाइपलाइनों को सुरक्षित करने और रूपांतरण स्थिरता सुनिश्चित करने के लिए जब प्लेटफ़ॉर्म सुरक्षित, सर्वर-साइड डेटा मॉडल में परिवर्तित होते हैं, तो इंजीनियरिंग और उत्पाद टीमों को मजबूत स्थिति संरक्षण कार्यप्रवाह अपनाना चाहिए।
डेवलपर कार्यान्वयन चेकलिस्ट
- बाहरी API एंडपॉइंट्स का ऑडिट करें: सुनिश्चित करें कि सभी बाहरी डेटा ट्रांज़िशन सुरक्षित HTTPS कनेक्शन के माध्यम से रूट किए गए हैं और अल्पकालिक सत्र संरचनाओं का उपयोग करते हैं।
- स्टेटलेस सत्र हैंडशेक लागू करें: सिस्टम निर्भरता को सर्वर-साइड सत्र स्थिति बहाली में स्थानांतरित करें, जो प्लेटफार्मों में डेटा पास करने के लिए हस्ताक्षरित टोकन का उपयोग करते हैं।
- सैंडबॉक्स्ड सहमति प्रवाह को मान्य करें: उपयोगकर्ता-दर्ज किए गए प्रॉम्प्ट को तीसरे पक्ष के डेटाबेस में स्थानांतरित करने से पहले स्पष्ट अनुमति प्रॉम्प्ट स्थापित करें।
उत्पाद और परिचालन रणनीति चेकलिस्ट
- बॉट डिटेक्शन सटीकता की निगरानी करें: खाता निर्माण पर लार्ज लैंग्वेज मॉडल क्लासिफायर की सटीकता को ट्रैक और मूल्यांकन करें।
- गलत-सकारात्मक दरों की समीक्षा करें: यह सुनिश्चित करने के लिए नियमित ऑडिट स्थापित करें कि वैध उपयोगकर्ता योगदान अनजाने में ब्लॉक या दर-सीमित न हों।
- सत्यापन चुनौती पूर्णता को ट्रैक करें: विश्लेषण करें कि संदिग्ध स्वचालित खाते अनिवार्य मानवता परीक्षणों और CAPTCHAs के साथ कैसे इंटरैक्ट करते हैं।
- संदिग्ध खाता क्लस्टर का ऑडिट करें: समान नेटवर्क रेंज में थोक पंजीकरण प्रयासों को अलग करने के लिए व्यवहार संबंधी टेलीमेट्री को मैप करें।
इन संरचित दिशानिर्देशों को स्थापित करके, विकास टीमें अपने अनुप्रयोगों को सुरक्षित, अधिक अनुपालन वाले आर्किटेक्चर में स्थानांतरित कर सकती हैं, जबकि परिचालन निरंतरता बनाए रखती हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
Reddit पर AI-जनित स्पैम अभियान क्यों बढ़ रहे हैं?
Reddit खाता निर्माण पर समन्वित अप्रामाणिक व्यवहार का पता लगाने के लिए LLM का उपयोग कैसे करता है?
स्वचालित बॉट्स की पहचान करने के लिए उपयोग किए जाने वाले दृश्य और गैर-दृश्य संकेतक क्या हैं?
जैसे-जैसे AI प्लेटफ़ॉर्म हाइब्रिड क्लाउड इन्फरेंस पर तेज़ी से निर्भर होते जा रहे हैं, डेवलपर्स को गोपनीयता, पारदर्शी सहमति और सुरक्षित डेटा रूटिंग के इर्द-गिर्द उत्पादों को फिर से डिज़ाइन करने की आवश्यकता है। विकसित होते डेटा आर्किटेक्चर को डिजिटल अनुभवों के निर्माण और माप के तरीके में एक मौलिक बदलाव की आवश्यकता है। जैसे-जैसे स्टेटलेस प्रॉक्सी और हेडलेस स्क्रैपर वेब सामग्री के मानक उपभोक्ता बनते जा रहे हैं, पारंपरिक क्लाइंट-साइड एट्रिब्यूशन मॉडल का क्षरण जारी रहेगा। उपयोगकर्ता एक्विजिशन को चलाने वाली डेटा पाइपलाइनों को सुरक्षित करने के लिए केवल मानक कुकीज़ और रेफ़रर्स पर भरोसा करना पर्याप्त नहीं है।
जैसे-जैसे AI कंपनियाँ मॉडल प्रशिक्षण के लिए सार्वजनिक चर्चा डेटा को लाइसेंस दे रही हैं, प्रामाणिक उपयोगकर्ता भागीदारी को बनाए रखना बड़े ऑनलाइन समुदायों के लिए विश्वास और राजस्व दोनों की प्राथमिकता बनती जा रही है। भविष्य को देखते हुए, इंजीनियरिंग टीमें स्टेटलेस आर्किटेक्चर, सर्वर-साइड सत्र प्रबंधन और गोपनीयता-प्रथम डिज़ाइन पर अधिक निर्भर करेंगी। जो संगठन इन परिवर्तनों के लिए जल्दी तैयारी करेंगे, वे अनुपालनशील और टिकाऊ AI उत्पादों को बनाए रखने के लिए बेहतर स्थिति में होंगे।
Share this article



