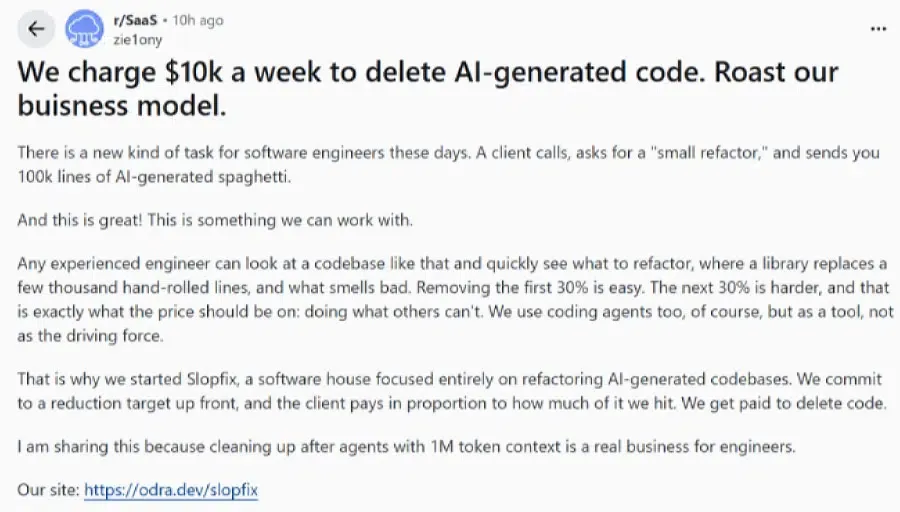
कंपनियां AI द्वारा जेनरेट किए गए कोड को हटाने के लिए इंजीनियरों को $10,000 प्रति सप्ताह क्यों दे रही हैं? कंपनियां अब सॉफ्टवेयर इंजीनियरों को प्रोडक्शन रिपॉजिटरी से AI-जेनरेटेड कोड हटाने के लिए प्रति सप्ताह हजारों डॉलर का भुगतान कर रही हैं। जैसे-जैसे जेनरेटिव आर्टिफिशियल इंटेलिजेंस का प्रोग्रामेटिक आउटपुट बढ़ रहा है, सॉफ्टवेयर टीमें तेजी से फीचर्स डिलीवर करने और लंबे समय तक आर्किटेक्चर को बनाए रखने के बीच एक कठिन चुनौती का सामना कर रही हैं। आज, चूंकि ऑटोनॉमस कोडिंग एजेंट अक्सर लॉजिक को डुप्लीकेट करते हैं और मॉड्यूलर सीमाओं को नजरअंदाज कर देते हैं, इसलिए संगठन यह समझ रहे हैं कि अनावश्यक फाइलों को रिफैक्टर और डिलीट करना, नए कोड को लगातार जेनरेट करने से कहीं अधिक मूल्यवान है।
AI जेनरेटेड कोड को डिलीट करने का $10,000-प्रति-सप्ताह का व्यवसाय
एक नज़र में
- विशिष्ट इंजीनियरिंग एजेंसियां AI द्वारा लिखे गए भारी-भरकम कोडबेस का ऑडिट, रिफैक्टर और उसे हल्का करने के लिए प्रति सप्ताह दस हजार डॉलर तक चार्ज कर रही हैं।
- केस स्टडीज सफल रिफैक्टरिंग लूप्स को प्रदर्शित करती हैं जो मानक कॉर्पोरेट कोड बेस को पैंसठ प्रतिशत तक छोटा करती हैं, जबकि सभी फीचर्स बरकरार रहते हैं।
- डुप्लिकेटेड कोड ब्लॉक पैटर्न का तेजी से बढ़ना ऐतिहासिक स्तर पर पहुंच गया है, जो प्रमुख सॉफ्टवेयर सिस्टम में डेवलपमेंट की गति को सीधे तौर पर कम कर रहा है।
सॉफ्टवेयर डेवलपमेंट का मानक समझौता एक बड़े बदलाव से गुजरा है। वर्षों तक, इंजीनियरिंग टीमों के लिए मुख्य चुनौती उत्पाद की आवश्यकताओं के साथ तालमेल बिठाने के लिए पर्याप्त तेजी से कोड लिखना था। डेवलपर्स मैन्युअल रूप से डेटाबेस कनेक्शन तैयार करते थे, सीरियलाइजेशन लेयर्स बनाते थे, और यूनिट टेस्ट लिखते थे, जिससे उनके डेवलपमेंट चक्र का एक महत्वपूर्ण हिस्सा नियमित और दोहराव वाले कोड असेंबली में खर्च होता था।
उन्नत लार्ज लैंग्वेज मॉडल (LLMs) और कोडिंग असिस्टेंट्स के एकीकरण ने इस शुरुआती घर्षण को पूरी तरह से समाप्त कर दिया है। Claude Code, GitHub Copilot जैसे टूल्स और Cursor या Windsurf जैसे एकीकृत एडिटर्स का उपयोग करके, तकनीकी और गैर-तकनीकी बिल्डर्स हाई-फ्रीक्वेंसी नेचुरल लैंग्वेज प्रॉम्प्ट के माध्यम से पूरे एप्लिकेशन जेनरेट कर सकते हैं, जिसे अक्सर "वाइब कोडिंग" (Vibe Coding) कहा जाता है। हालांकि, जैसे-जैसे ये ऑटोमेटेड फाइलें गुणात्मक रूप से बढ़ती हैं, आर्किटेक्चरल डिजाइन की कमी स्पष्ट रूप से सामने आती है। AI सिस्टम किसी प्रॉम्प्ट द्वारा अनुरोधित स्थानीय, तत्काल प्रतिक्रिया उत्पन्न करने में उत्कृष्ट हैं, लेकिन वे व्यापक, दीर्घकालिक तकनीकी आर्किटेक्चर का मूल्यांकन नहीं कर सकते। इससे अनावश्यक फंक्शन्स और अत्यधिक जुड़ी हुई डेटा संरचनाएं पैदा होती हैं, जिसे Slopfix तकनीकी पोर्टल पर प्रलेखित किया गया है।
सिस्टम की मेंटेनबिलिटी को बहाल करने के लिए, इंजीनियरिंग लीडर्स सुरक्षित कोड-डिलीशन लक्ष्य निर्धारित कर रहे हैं। अनुभवी डेवलपमेंट टीमों को अस्वच्छ रिपॉजिटरी का मूल्यांकन करने, स्वचालित रिग्रेशन चेक स्थापित करने और हजारों डुप्लिकेट क्लास को हटाने के लिए नियुक्त किया जा रहा है। यह परफॉरमेंस गैप बताता है कि क्यों संगठन नई फाइलें लिखना जारी रखने के बजाय प्रोफेशनल डेवलपर्स को AI जेनरेटेड कोड हटाने के लिए भुगतान कर रहे हैं। कड़े नियंत्रित टूल्स के साथ मिलकर प्रोफेशनल विशेषज्ञता का उपयोग करके, ये रिफैक्टरिंग ऑपरेशन अनावश्यक बेस्पोक (bespoke) कोड को मानकीकृत, ओपन-सोर्स लाइब्रेरी के साथ बदल देते हैं, जिससे यह सुनिश्चित होता है कि अंतिम एप्लिकेशन स्थिर और स्केलेबल बने रहें।
अंडर-द-हुड मैकेनिक्स: AI-जेनरेटेड कोड टेक्निकल डेट (Technical Debt) क्यों बनाता है
तकनीकी स्तर पर, "AI स्लोप" (AI slop) की घटना आधुनिक ट्रांसफॉर्मर्स के संदर्भ प्रबंधन (context management) की एक मौलिक सीमा से उत्पन्न होती है। हालांकि एक LLM एक बड़ी टेक्स्ट डायरेक्टरी को पार्स कर सकता है, लेकिन इसका अटेंशन मैकेनिज्म सख्त आर्किटेक्चरल सिद्धांतों के बजाय टोकन प्रायिकता (token probability) के माध्यम से कोड का मूल्यांकन करता है।
जब कोई एजेंट किसी फाइल के अंदर एक अलग बग को हल करता है, तो वह अक्सर मौजूदा यूटिलिटी क्लासेस को कॉल करने के बजाय डुप्लिकेट लॉजिक पेश करता है। कई महीनों में, यह व्यवहार गंभीर सॉफ्टवेयर गिरावट का कारण बनता है। नीचे दिया गया आरेख यह दर्शाता है कि कैसे ऑटोमेटेड पैच स्ट्रक्चरल विचलन (structural divergence) का कारण बनते हैं:
[संरचित मानव आर्किटेक्चर]
  इनपुट ──> कोर API कंट्रोलर ──> साझा यूटिलिटी क्लास (एकल मानक फॉर्मेट) ──> सुरक्षित आउटपुट


[भारी AI पैचवर्क]
  इनपुट ──> प्रॉम्प्ट पैच 1 (नया फॉर्मेट) ──> प्रॉम्प्ट पैच 2 (डुप्लिकेट फॉर्मेट) ──> खंडित आउटपुट
यह दोहराव अब केवल एक स्थानीय समस्या नहीं है; यह एक उद्योग-व्यापी चुनौती बन गई है। GitClear की 2026 की 'मेंटेनबिलिटी गैप' रिपोर्ट के अनुसार, जिसने 623 मिलियन परिवर्तनों का विश्लेषण किया, डुप्लिकेटेड कोड ब्लॉक अपने उच्चतम रिकॉर्ड स्तर पर पहुंच गए हैं, जो 2023 के बाद से 81% बढ़ गए हैं। इस बीच, स्ट्रक्चर्ड रिफैक्टरिंग में भारी गिरावट आई है, जो 2026 में कुल कोड परिवर्तनों का 4% से भी कम रह गया है, जबकि 2022 में यह 21% था। कॉपी-पेस्ट प्रोग्रामिंग की ओर यह शारीरिक बदलाव बताता है कि क्यों डेवलपर्स अब मौजूदा कोड को रिफैक्टर करने की तुलना में अनावश्यक ब्लॉक पेश करने की संभावना पांच गुना अधिक रखते हैं।
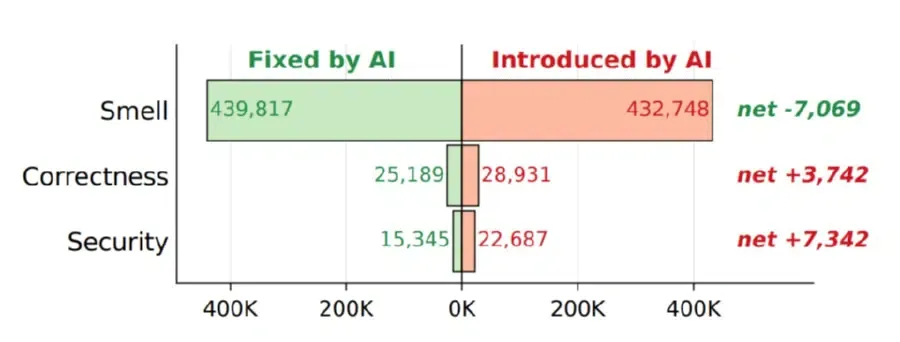
ये निष्कर्ष बड़े पैमाने पर किए गए एक अनुभवजन्य अध्ययन द्वारा और भी पुष्ट होते हैं, जो कोड डेट को ट्रैक करता है। शोधकर्ताओं ने 6,299 GitHub रिपॉजिटरी में 300,000 से अधिक AI-जेनरेटेड कमिट्स की जांच की, जिसमें पाया गया कि Copilot, Claude, Cursor और Gemini से 15% से अधिक सबमिशन में कोड स्मेल, करेक्टिवनेस एरर या सुरक्षा जोखिम थे।
कैस्केडिंग विफलता का यह जोखिम अक्सर सॉफ्टवेयर टीमों को AI जेनरेटेड कोड हटाने के लिए मजबूर करता है जब स्थानीय सुधार मौजूदा एंडपॉइंट्स को तोड़ देते हैं। इसके अलावा, अध्ययन से पता चला है कि इन AI-प्रेरित मुद्दों का 22.7% हिस्सा कोडबेस के नवीनतम संस्करणों में भी अनसुलझा रहा, जिनमें से कई नौ महीने से अधिक समय तक बने रहे, जो अनियंत्रित AI आउटपुट की दीर्घकालिक लागत को उजागर करता है।
हालांकि रिपॉजिटरी कोड क्लीनअप और मोबाइल इंस्टॉल ट्रैकिंग अलग-अलग परतों पर काम करते हैं, लेकिन दोनों वातावरण एक ही तकनीकी चुनौती साझा करते हैं: एक बार जब ऑटोमेटेड सिस्टम अनावश्यक रिक्वेस्ट चेन या अनवेरिफाइड स्क्रिप्ट जेनरेट करते हैं, तो डेटा टक्कर (collision) और एट्रिब्यूशन भ्रष्टाचार (corruption) का जोखिम बढ़ जाता है। मोबाइल एट्रिब्यूशन में भी ऐसी ही चुनौतियां मौजूद हैं, जहां गोपनीयता प्रतिबंध और ऑटोमेटेड बॉट ट्रैफ़िक भी लगातार क्लाइंट-साइड पहचानकर्ताओं पर निर्भरता को कम करते हैं। यदि सुरक्षा टीमें स्वच्छ उपयोगकर्ता अनुरोधों और ऑटोमेटेड, एजेंटिक इंटरैक्शन के बीच अंतर नहीं कर सकती हैं, तो पूरी एनालिटिक्स पाइपलाइन फॉल्स-पॉजिटिव कन्वर्जन की रिपोर्ट करने के प्रति संवेदनशील हो जाती है।
उद्योग प्रभाव: AI कोड क्लीनअप सॉफ्टवेयर इंजीनियरिंग को कैसे नया आकार दे रहा है
ऑटोमेटेड कोड जेनरेटर्स के तेजी से प्रसार ने सॉफ्टवेयर इंजीनियरों की मानक भूमिका में एक बदलाव लाया है। डेवलपर्स अब लेखक से बदलकर ऑडिटर बन रहे हैं, जो सिस्टम आर्किटेक्चर, डेटा प्रवाह और इंटरफ़ेस अखंडता पर ध्यान केंद्रित कर रहे हैं।
- एंटरप्राइज टीमें: बड़े संगठन समर्पित CI/CD गेट्स और ESLint, Prettier, या SonarQube जैसे टूल्स के साथ स्टेटिक एनालिसिस प्रोटोकॉल स्थापित कर रहे हैं ताकि अनवेरिफाइड AI संरचनाओं वाले कमिट्स को अस्वीकार किया जा सके और दीर्घकालिक मेंटेनबिलिटी को सुरक्षित रखा जा सके।
- स्टार्टअप्स: हालांकि शुरुआती चरण के उपक्रम Devin, CodeRabbit या Cursor जैसे टूल्स का उपयोग करके तेजी से MVP को मान्य करते हैं, लेकिन उन्हें प्रोडक्शन-ग्रेड इंजीनियरिंग टीमों को हैंडओवर करने से पहले मानव रिफैक्टरिंग की आवश्यकता होती है।
- ओपन सोर्स कम्युनिटीज: Godot गेम इंजन जैसी परियोजनाओं ने AI-जेनरेटेड योगदानों को प्रतिबंधित कर दिया है क्योंकि डेवलपर्स उनके द्वारा सबमिट की गई जटिल स्क्रिप्ट को समझ या सत्यापित नहीं कर सके।
- SDK और लाइब्रेरी वेंडर्स: सॉफ्टवेयर वेंडर्स को यह सुनिश्चित करना होगा कि उनकी एकीकृत लाइब्रेरी पूरी तरह से मॉड्यूलर और हल्की रहें ताकि ऑटोमेटेड टूल्स को निर्भरताओं की गलत व्याख्या करने से रोका जा सके।
सब कुछ फिर से लिखे बिना AI कोड ब्लोट को कम करना
जैसे-जैसे संगठन AI-संचालित कोड विस्तार की तकनीकी वास्तविकताओं का सामना कर रहे हैं, इंजीनियरिंग टीमों को यह मूल्यांकन करना होगा कि वे थर्ड-पार्टी निर्भरताओं और SDK चयन का प्रबंधन कैसे करते हैं। हाई-थ्रूपुट रूटिंग पाइपलाइनों को सामंजस्यपूर्ण बनाने के लिए ऐसे आर्किटेक्चर की आवश्यकता होती है जो स्थानीय स्टोरेज कंटेनरों पर निर्भर रहे बिना उपयोगकर्ता कार्यों को सुरक्षित रूप से कोरिलेट (correlate) कर सकें। डेवलपर्स को यह तय करना होगा कि क्या वे AI ऑटो-जेनरेटर्स का उपयोग करके विशेष, कस्टम-टेलर डेटाबेस सिंक फ्रेमवर्क बनाएं या मानकीकृत, पूर्व-निर्मित इंफ्रास्ट्रक्चर तैनात करें।
आर्किटेक्चरल मूल्यांकन: कस्टम बिल्ड बनाम मानकीकृत SDK
जब कोडबेस विस्तार का सामना करना पड़ता है, तो डेवलपर्स को यह तय करना होगा कि वे व्यापक इन-हाउस यूटिलिटीज बनाएं या पूरक कार्यों को लागू करने के लिए परिपक्व, बाहरी लाइब्रेरी का लाभ उठाएं। AI ऑटो-जेनरेटर्स का उपयोग करके स्क्रैच से बेस्पोक समाधान विकसित करना अक्सर हजारों लाइनों का अपरीक्षित लॉजिक और अनावश्यक क्लास पेश करता है। इसके विपरीत, न्यूनतम, सत्यापित सॉफ्टवेयर पैकेज को एकीकृत करने से एक छोटा संकलित फुटप्रिंट (compiled footprint) बनाए रखने में मदद मिलती है।
नीचे दी गई तालिका कस्टम डेटा आर्किटेक्चर और प्रमाणित बाहरी SDK के बीच ट्रेड-ऑफ़ को रेखांकित करती है:
| दृष्टिकोण | कोड फुटप्रिंट | रखरखाव का ओवरहेड | सामान्य परिदृश्य |
|---|---|---|---|
| बेस्पोक इन-हाउस डेवलपमेंट | अधिक (हजारों लाइन की कस्टम स्क्रिप्टिंग) | अत्यधिक (निरंतर आंतरिक ऑडिट) | अत्यधिक विशिष्ट आंतरिक टेलीमेट्री जरूरतों वाली एंटरप्राइज टीमें |
| AI-जेनरेटेड मॉड्यूल्स | अप्रत्याशित (स्पैगेटी पाथ) | अधिक (संदर्भ पतन के प्रति संवेदनशील) | तेजी से प्रोटोटाइपिंग जहां दीर्घकालिक सिस्टम स्थिरता गौण है |
| न्यूनतम SDK एकीकरण | अल्ट्रालाइट (10 किलोबाइट से कम) | नगण्य (ऑडिटेड, सेल्फ-कंटेंड SDKs) | उच्च-समवर्ती सिस्टम जिन्हें मानक पैरामीटर मिलान की आवश्यकता है |
परिणामस्वरूप, इंजीनियरिंग प्रबंधक नए फीचर्स शुरू करने से पहले अनावश्यक AI-जेनरेटेड कोड को हटाने को प्राथमिकता दे रहे हैं। हल्के SDK जो एकीकरण जटिलता को कम करते हैं, इसलिए तेजी से आकर्षक हो गए हैं। उदाहरण के लिए, मल्टी-प्लेटफ़ॉर्म कन्वर्जन टेलीमेट्री को एकीकृत करने वाले डेवलपर्स हल्के OpoInstall SDK को तैनात कर सकते हैं। क्रॉस-प्लेटफ़ॉर्म मापदंडों को संभालने के लिए सैकड़ों लाइनों का अपरीक्षित AI कोड जेनरेट करने के बजाय, यह पूर्व-निर्मित, जीरो-डिपेंडेंसी SDK सेशन मेटाडेटा को सर्वर-साइड सेशन डेटाबेस में मैप करता है। यह क्लाइंट-साइड वजन बढ़ाए बिना अभियान और रेफरल संदर्भ को गुमनाम रूप से बनाए रखता है।
एकीकरण चेकलिस्ट: हल्के डिप्लॉयमेंट के लिए अपने आर्किटेक्चर को तैयार करना
भविष्य में कोड खराब होने से रोकने और वितरित प्लेटफार्मों पर कन्वर्जन कंसिस्टेंसी बनाए रखने के लिए, इंजीनियरिंग और उत्पाद टीमों को स्वच्छ कोडबेस सीमाएं स्थापित करनी चाहिए।
डेवलपर कार्यान्वयन चेकलिस्ट
- सख्त लिंटर्स और गेटिंग लागू करें: ESLint, Prettier, या SonarQube जैसे टूलचेन के साथ स्वचालित CI/CD पाइपलाइन कॉन्फ़िगर करें ताकि उन PRs को अस्वीकार किया जा सके जो उच्च समानता स्कोर या डुप्लिकेट यूटिलिटी फंक्शन्स प्रदर्शित करते हैं।
- थर्ड-पार्टी SDK आकार का ऑडिट करें: सभी एकीकृत लाइब्रेरी के संकलित फुटप्रिंट को सत्यापित करें ताकि भारी पैकेज को डिवाइस स्टार्ट समय को धीमा करने से रोका जा सके।
- निरंतर कोड रिफैक्टरिंग लागू करें: डेवलपमेंट स्प्रिंट का एक निश्चित प्रतिशत अनावश्यक डायरेक्टरीज को मॉड्यूलर घटकों में समेटने के लिए समर्पित करें।
उत्पाद और विकास रणनीति चेकलिस्ट
- मेमोरी उपयोग को अनुकूलित करें: गार्बेज कलेक्शन पॉज़ को कम करने और क्लाइंट-साइड थर्मल थ्रॉटलिंग से बचने के लिए ऐप निर्भरताओं का मूल्यांकन करें।
- SDK चयन को सुव्यवस्थित करें: एकल-उद्देश्य, अत्यधिक अनुकूलित थर्ड-पार्टी टूल्स को प्राथमिकता दें जो शून्य बाहरी निर्भरताओं के साथ विश्वसनीय परिणाम देते हैं।
- API वर्कफ़्लो लेटेंसी की निगरानी करें: डेटा निरंतरता की पुष्टि करने के लिए प्रारंभिक अभियान क्लिक से लेकर सर्वर-साइड इंस्टॉलेशन मिलान तक मानक लेटेंसी मेट्रिक्स को ट्रैक करें।
इन संरचित दिशानिर्देशों को स्थापित करके, डेवलपमेंट टीमें परिचालन निरंतरता बनाए रखते हुए अपने एप्लिकेशन को सुरक्षित, अधिक अनुपालन वाले आर्किटेक्चर में स्थानांतरित कर सकती हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
क्या AI-जेनरेट किया गया कोड सॉफ्टवेयर मेंटेनबिलिटी के लिए बुरा है?
क्या डेवलपर्स को जटिल आर्किटेक्चर के लिए AI कोडिंग टूल्स पर भरोसा करना चाहिए?
क्या अनावश्यक AI कोड को हटाने से सिस्टम का प्रदर्शन बेहतर होता है?
इंजीनियरिंग टीमों के लिए मुख्य निष्कर्ष
जैसे-जैसे AI-सहायता प्राप्त डेवलपमेंट मुख्यधारा बन रहा है, सॉफ्टवेयर टीमें अधिक कोड जेनरेट करने के बजाय स्वस्थ कोडबेस बनाए रखने पर अपना ध्यान केंद्रित कर रही हैं। AI कोड क्लीनअप में विशेषज्ञता वाले व्यवसायों का उदय उस व्यापक बदलाव को दर्शाता है कि कैसे संगठन जेनरेटिव AI के युग में सॉफ्टवेयर गुणवत्ता का मूल्यांकन करते हैं। संरचनात्मक समस्याओं को बार-बार पैच करने के लिए ऑटोमेटेड एजेंटों पर निर्भर रहना तकनीकी ऋण (technical debt) को जमा करता रहेगा। सख्त मॉड्यूलरिटी, स्वचालित परीक्षण और अत्यधिक अनुकूलित थर्ड-पार्टी निर्भरताओं के आसपास आंतरिक इंजीनियरिंग दिशानिर्देशों को फिर से बनाना एप्लिकेशन स्केलेबिलिटी बनाए रखने के लिए आवश्यक है।
भविष्य को देखते हुए, सफल संगठन कोडबेस की मेंटेनबिलिटी को कच्ची जनरेशन गति से ऊपर प्राथमिकता देंगे। हल्के, जीरो-डिपेंडेंसी इंफ्रास्ट्रक्चर को एकीकृत करके और जटिल ट्रैकिंग स्टेट्स को सर्वर-साइड डेटाबेस में स्थानांतरित करके, डेवलपर्स अपनी डिप्लॉयमेंट पाइपलाइन को अनावश्यक कोड क्रीप (code creep) से बचा सकते हैं। यह संक्रमण केवल ऑटोमेटेड टूल्स के अनुकूल होने के बारे में नहीं है; यह एक एजेंट-भारी इंजीनियरिंग वातावरण में स्थिर, टिकाऊ सॉफ्टवेयर संरचनाएं बनाने के बारे में है।
Share this article



