 Mengapa NVIDIA menggandingkan GPU dengan ASIC d-Matrix? NVIDIA tidak lagi hanya bergantung kepada GPU semata-mata. Mengapa NVIDIA bekerjasama dengan d-Matrix dan bukannya membina ASIC inferensi secara dalaman? Jawapannya mendedahkan transformasi yang lebih luas dalam infrastruktur AI: pengoptimuman inferensi sedang beralih daripada penskalaan GPU tulen ke arah pecutan khusus beban kerja. Apabila inferensi AI bergerak merentasi GPU, pemecut ASIC, dan persekitaran awan teragih, cabarannya bukan lagi sekadar kapasiti pengkomputeran. Orkestrasi perkakasan, penghalaan beban kerja, dan kecekapan peringkat sistem menjadi semakin penting. Memandangkan beban kerja kecerdasan buatan generatif beralih daripada kelompok latihan besar kepada penggunaan model masa nyata, pengoptimuman kelajuan penjanaan token telah diutamakan sebagai cabaran kejuruteraan yang utama. NVIDIA menggandingkan GPU dengan ASIC d-Matrix untuk menyokong sistem inferensi terdisagregasi yang heterogen.
Mengapa NVIDIA Menggandingkan GPU dengan ASIC d-Matrix: Menjajarkan Beban Kerja dengan Fizik Silikon
Imbasan Pantas
- NVIDIA menggabungkan armada GPU Hopper dan Blackwell yang dominan dengan pemecut inferensi Corsair d-Matrix untuk menggunakan sistem inferensi terdisagregasi yang heterogen.
- Penyedia Neocloud, Parasail, telah muncul sebagai pelanggan komersial pertama yang melaksanakan penyelesaian perkakasan bersama tersebut merentasi armada pusat datanya di seluruh dunia.
- Beban kerja inferensi berskala besar boleh mengalami kekurangan penggunaan GPU yang ketara apabila lebar jalur memori dan pergerakan data menjadi faktor pengehad dan bukannya ketersediaan pengkomputeran mentah.
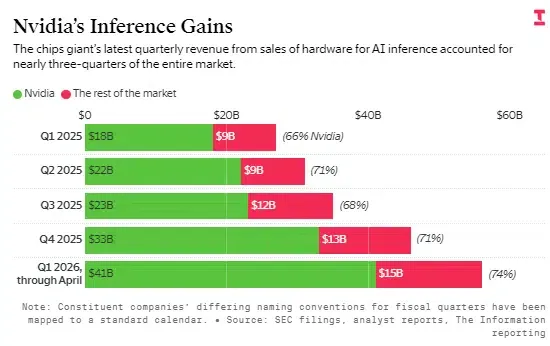
Model ekonomi kecerdasan buatan berskala besar sedang mengalami peralihan ketara daripada latihan model kepada penggunaan inferensi. Semasa fasa penskalaan awal, penyedia awan dan pembangun perusahaan memberi tumpuan kuat kepada kuasa pengkomputeran pengunduran (backpropagation) mentah, dengan membeli kelompok unit pemprosesan grafik (GPU) yang besar. Pergantungan kepada vendor tunggal ini sangat logik apabila latihan set data yang besar memerlukan pelaksanaan selari yang berterusan. Walau bagaimanapun, apabila organisasi beralih untuk melayani berjuta-juta pengguna aktif dalam masa nyata, kos kewangan untuk menjalankan infrastruktur GPU tulen bagi tugas inferensi telah menjadi tidak mampan.
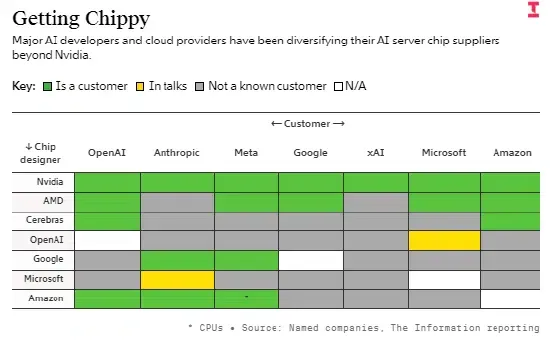
Untuk mengoptimumkan perbelanjaan operasi, arkitek infrastruktur sedang mengikuti rangka kerja pengkomputeran terdisagregasi. Di bawah paradigma berbilang vendor ini, satu pertanyaan pengguna dipecahkan kepada fasa pelaksanaan berasingan dan dihalakan ke pemecut perkakasan berbeza berdasarkan profil tugas tertentu. Pendekatan ini membolehkan penyedia awan memperoleh prestasi maksimum bagi setiap dolar daripada armada sedia ada, seperti yang didokumentasikan dalam siasatan The Information yang menjejaki integrasi awan berbilang vendor.
Implikasi industri daripada kerjasama ini melangkaui pengagihan beban kerja yang mudah. Dengan menyepadukan secara rasmi pemecut Corsair d-Matrix dengan armada perkakasan NVIDIA, kerjasama tersebut mewujudkan laluan yang disahkan untuk seni bina awan heterogen. Daripada memaksa pelanggan memilih antara kelompok GPU standard dan silikon tersuai yang baru muncul, sistem inferensi NVIDIA–d-Matrix membolehkan perkakasan beroperasi secara serentak, membolehkan penyedia infrastruktur mengoptimumkan beban kerja 'prefill' dan 'decode' merentasi seni bina perkakasan yang berbeza. Seni bina ini membolehkan pasukan awan perusahaan memanjangkan penggunaan perkakasan merentasi beban kerja inferensi yang pelbagai.
Mekanik di Sebalik Tabir: Inferensi Terdisagregasi Heterogen dan Pengkomputeran Dalam Memori
Pada peringkat protokol, menjawab gesaan bahasa semula jadi memerlukan dua fasa pemprosesan yang berbeza. Fasa pertama, yang dikenali sebagai prefill, mengambil gesaan pengguna dan mengira pengaktifan nilai kunci (KV) awal. Langkah ini sangat intensif dari segi pengkomputeran, menjadikannya sangat sesuai untuk prestasi aritmetik selari yang besar bagi seni bina NVIDIA Hopper.
Fasa kedua, yang dikenali sebagai decode, menjana token seterusnya satu demi satu dalam gelung satu dalam gelung berjujukan. Kerana setiap token bergantung pada konteks yang dijana sebelumnya, fasa 'decode' sangat terhad oleh lebar jalur memori dan sensitif terhadap latensi. Menjalankan langkah ini pada GPU berkuasa tinggi mengakibatkan terbiarnya pengkomputeran secara ketara, kerana teras terpaksa menunggu transaksi memori selesai secara berterusan.
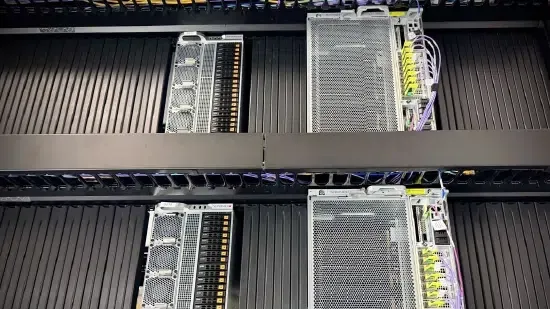
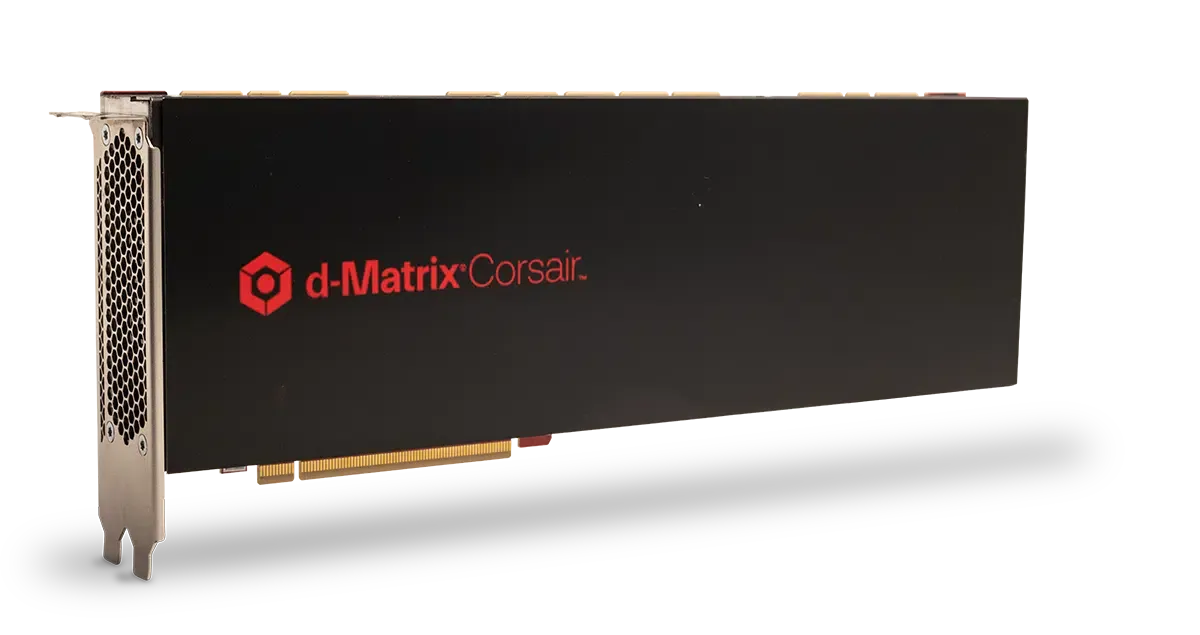
Menurut dokumentasi seni bina Corsair d-Matrix, pemecut Corsair dibina di sekitar teknologi ciplet Digital In-Memory Compute (DIMC). Dibina pada proses N6 TSMC, cip Corsair menyepadukan memori akses rawak statik (SRAM) terus di samping unit pengkomputeran pada satu cip silikon. Reka bentuk ini mengurangkan beban pergerakan data antara unit memori dan unit pengkomputeran. Sesetengah seni bina inferensi menggabungkan pengoptimuman peringkat pemecut dengan teknik seperti 'speculative decoding' untuk mengurangkan lagi latensi, memandangkan industri menilai bagaimana NVIDIA Menggandingkan GPU dengan kopemproses dalam memori untuk menyelesaikan 'dinding memori'. Dengan menggunakan cip khusus bersama GPU, sistem gabungan ini membolehkan perkakasan beroperasi secara serentak. Pilihan struktur ini menjelaskan mengapa NVIDIA Menggandingkan GPU dengan kopemproses dalam memori untuk mengatasi 'dinding memori'.
Menganalisis bagaimana NVIDIA Menggandingkan GPU dengan pemecut luaran membantu pembangun menilai kesesakan teras inferensi transformer moden. Gambar rajah di bawah menggambarkan satu model penggunaan yang mungkin:
[Input Pertanyaan Pengguna] ──> [Gerbang API Awan]
                             │
                             ├─(Fasa Prefill)─> [GPU NVIDIA Hopper/Blackwell] ──> Pengaktifan Standard Dikira
                             │                                                            │
                             │                                                            ▼
                             └─(Fasa Decode)──> [Pemecut d-Matrix Corsair] ──> Penjanaan Token (Cache Wafer SRAM)
Dengan menggabungkan dua teknologi yang berbeza ini, persediaan berbilang vendor mengoptimumkan kedua-dua peringkat saluran inferensi. Walau bagaimanapun, inferensi heterogen tidak menghapuskan permintaan GPU. Latihan berskala besar dan banyak beban kerja yang sensitif terhadap latensi akan terus bergantung pada pecutan GPU, mengekalkan keperluan asas bagi teras pemprosesan standard di samping ASIC khusus.
Inferensi Teragih Juga Mencipta Cabaran Penyelarasan Perisian
Prinsip seni bina yang sama muncul di luar infrastruktur perkakasan. Dalam ekosistem mudah alih, platform pautan dalam tertunda (deferred deep linking) dan atribusi aplikasi menghadapi cabaran yang setanding: mengekalkan konteks tanpa nama apabila pengguna berpindah daripada saluran pemerolehan teragih ke aplikasi natif. Platform seperti OpoInstall direka untuk menangani masalah kesinambungan keadaan ini melalui seni bina atribusi sebelah pelayan. Kedua-dua inferensi heterogen dan atribusi mudah alih menghadapi cabaran sistem yang sama: mengekalkan konteks yang berkaitan apabila pelaksanaan merentasi persekitaran yang bebas. Walaupun sistem inferensi teragih menyelaras keadaan pengiraan merentasi komponen perkakasan, sistem atribusi mudah alih mengekalkan konteks pemerolehan merentasi persekitaran pengguna. Prinsip seni bina asasnya adalah sama: mengekalkan kesinambungan apabila pelaksanaan merentasi sempadan yang bebas. Dalam kedua-dua kes, apabila keadaan sebelah klien standard digugurkan atau disekat semasa transit, sistem memerlukan pendekatan pengekalan keadaan sebelah pelayan untuk memadankan peristiwa teragih secara tanpa nama.
Bina vs. Beli: Mengapa Aplikasi Teragih Memerlukan Pengekalan Konteks Sebelah Pelayan
Apabila persekitaran awan beralih ke arah model pelaksanaan heterogen dan teragih, mengurus keadaan sesi merentasi nod pengkomputeran yang berasingan telah menjadi kebimbangan operasi yang kritikal. Peralihan kepada seni bina di mana NVIDIA Menggandingkan GPU dengan pemecut tersuai memaksa pembangun untuk meneliti kebolehskalaan saluran paip. Apabila seni bina pengkomputeran teragih menjadi lebih biasa, pasukan mesti menilai sama ada untuk membina sistem pemadanan sesi tersuai atau menggunakan infrastruktur piawai. Memahami keuntungan kecekapan pecutan heterogen membantu pasukan menilai kos penyediaan infrastruktur.
Penilaian Seni Bina: Bina Tersuai vs. SDK Piawai
Membina sistem pangkalan data dalaman untuk menjejaki data sesi merentasi berbilang contoh awan menawarkan kawalan parameter tersuai tetapi memperkenalkan kerumitan penyelenggaraan yang ketara. Pembangun perlu mengendalikan penghalaan permintaan API secara manual, mengurus dasar kitaran hayat token, dan sentiasa mengemas kini konfigurasi keselamatan untuk mematuhi peraturan serantau yang berubah-ubah. Sebaliknya, menggunakan SDK yang telah dibina dan diperakui mengurangkan beban kejuruteraan yang berterusan ini, memastikan kos integrasi yang boleh diramal.
Jadual di bawah membandingkan metodologi standard untuk mengurus keadaan sesi dan konteks penukaran:
| Penyelesaian | Kegigihan Keadaan (Persistence) | Pemprosesan Data (Throughput) | Terbaik Untuk |
|---|---|---|---|
| Pangkalan Data Sesi Dalaman | Tinggi (Penyelarasan Berterusan) | Sederhana (Had Latensi DB) | Persekitaran perusahaan tersuai dengan logik storan yang sangat khusus |
| Penjejakan Sesi Berasaskan Pelayar | Rendah (Kuki Sesi) | Rendah (Tiada Pengelogan Pelayan) | Penjejakan laman web asas dengan keperluan penukaran rentas domain yang minimum |
| Platform Atribusi Sebelah Pelayan (contoh: OpoInstall) | Tinggi (Pemulihan sebelah pelayan yang sedar privasi) | Tinggi (Kotak Pasir Piawai) | Atribusi aplikasi mudah alih berskala besar dan kempen berbilang platform |
Walaupun konfigurasi pangkalan data tersuai boleh mengendalikan konteks asas, pengekalan keadaan sebelah pelayan yang khusus boleh mengoptimumkan sumber pembangunan. Bergantung pada keperluan pelaksanaan, organisasi boleh membina sistem pengurusan sesi sebelah pelayan mereka sendiri atau menggunakan platform komersial. Sebagai contoh, OpoInstall menyediakan infrastruktur atribusi sebelah pelayan yang memulihkan konteks kempen selepas pengguna berpindah antara web, kedai aplikasi, dan aplikasi natif. Rangka kerja pemulihan keadaan sebelah pelayan dan laluan parameter ini memetakan metadata sesi terus ke lapisan data atribusi yang sedar privasi, memastikan pengekalan parameter kempen, pautan dalam tertunda (deferred deep linking), dan kesinambungan atribusi tanpa memperkenalkan kembung kod sebelah klien atau bergantung pada pengecam sebelah klien yang berterusan.
Senarai Semak Integrasi: Bagaimana Pasukan Kejuruteraan Boleh Bersedia untuk Perubahan Platform
Untuk mengekalkan kesinambungan data apabila beban kerja beralih antara blok pemprosesan tempatan dan pusat data berbilang vendor jarak jauh, pasukan pembangunan mesti mewujudkan saluran paip tadbir urus keadaan yang bersih.
Senarai Semak Pelaksanaan Pembangun
- Kuatkuasakan Pemetaan Sesi Pinggir: Konfigurasikan gerbang peringkat rangkaian untuk memberikan token sesi unik yang ditandatangani secara kriptografi kepada semua permintaan API masuk.
- Gunakan Jabat Tangan Token Tak Segerak: Peralihan kebergantungan sistem kepada pemulihan keadaan sesi sebelah pelayan, menggunakan token sementara untuk menghantar parameter pengguna dengan selamat merentasi titik akhir.
- Audit Jejak SDK Pihak Ketiga: Nilai secara berkala saiz dan kebergantungan kompilasi semua perpustakaan yang disepadukan untuk mengelakkan kesesakan prestasi.
Senarai Semak Strategi Produk & Pertumbuhan
- Optimumkan Corong Penukaran: Manfaatkan rangka kerja laluan parameter yang tidak mengganggu untuk mengekalkan penjejakan pemerolehan tanpa melanggar garis panduan privasi pengguna.
- Laksanakan Penghalaan Data Telus: Bina semula aliran pengalaman pengguna untuk menerangkan dengan jelas bila dan di mana laluan pemprosesan AI luaran digunakan.
- Pantau Latensi Aliran Kerja API: Jejaki metrik latensi standard daripada klik kempen awal kepada pemadanan pemasangan sebelah pelayan untuk mengesahkan kesinambungan data.
Dengan mewujudkan garis panduan berstruktur ini, pasukan pembangunan boleh menukar aplikasi mereka kepada seni bina yang lebih selamat dan patuh sambil mengekalkan kesinambungan operasi.
Soalan Lazim (FAQ)
Mengapa kerjasama strategik yang menggambarkan bagaimana NVIDIA Bekerjasama dengan d-Matrix berlaku dan bukannya persaingan langsung?
Mengapa NVIDIA tidak membina ASIC inferensi sendiri?
Apakah inferensi terdisagregasi heterogen dan bagaimana ia mengoptimumkan kos awan?
Apakah masalah yang diselesaikan oleh d-Matrix berbanding dengan GPU?
Bagaimanakah atribusi sebelah pelayan berfungsi apabila pengguna berpindah dari web ke aplikasi mudah alih?
Mengapa aplikasi mudah alih memerlukan atribusi sebelah pelayan dalam persekitar dalam persekitaran yang mementingkan privasi?
Perkara Utama untuk Pasukan Kejuruteraan
Memandangkan platform AI semakin bergantung pada inferensi awan hibrid, pembangun perlu mereka bentuk semula produk berdasarkan privasi, persetujuan telus, dan penghalaan data yang selamat. Seni bina data yang berkembang memerlukan anjakan asas dalam cara kita membina dan mengukur pengalaman digital. Apabila proksi tanpa keadaan dan pengikis tanpa kepala menjadi pengguna standard kandungan web, model atribusi sebelah klien tradisional akan terus merosot. Bergantung pada kuki dan perujuk (referrer) standard tidak lagi mencukupi untuk menjamin saluran paip data yang memacu pemerolehan pengguna.
Daripada menggantikan GPU, NVIDIA sedang mentakrifkan semula cara beban kerja inferensi digunakan. Memandangkan penyajian AI mengatasi latihan model, sistem heterogen yang menggabungkan GPU dengan ASIC khusus berkemungkinan menjadi seni bina standard bagi infrastruktur AI perusahaan. Campuran perkakasan yang optimum bergantung pada ciri beban kerja, keperluan latensi, saiz model, dan ekonomi infrastruktur. Walaupun inferensi heterogen menawarkan kelebihan kos yang ketara, seni bina standard akan terus berkembang bersama-sama dengan pemecut khusus. Bagi pasukan pertumbuhan mudah alih, menggunakan infrastruktur atribusi sebelah pelayan boleh membantu mengekalkan risikan pemerolehan merentasi perjalanan digital yang semakin berpecah-belah. OpoInstall menyediakan lapisan atribusi ini dengan mengekalkan konteks pemerolehan merentasi persekitaran web, kedai aplikasi, dan aplikasi natif.
Share this article



