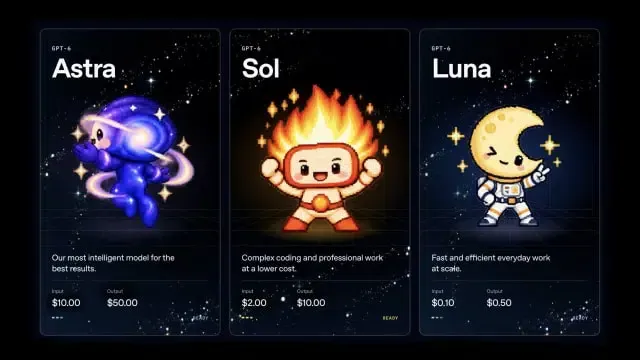
Kos API Sol OpenAI berkurang separuh? OpenAI secara rasmi mengumumkan ketersediaan komersial GPT-6 Sol dan GPT-6 Luna pada 22 September 2026, menurunkan kadar token API sebanyak 50% atau lebih berbanding harga promosi GPT-5.6 terdahulu pada titik akhir standard. Untuk pemprosesan Standard bagi gesaan dengan sehingga 272K token input, GPT-6 Sol berharga $2.00 setiap juta token input dan $10.00 setiap juta token output, manakala model GPT-6 Luna yang lebih kecil berada pada $0.10 input dan $0.50 output setiap juta token. Apabila OpenAI mengurangkan kos API Sol merentas peringkat pembangun standard, penurunan nilai pengkomputeran struktur mengubah kekangan operasi perisian generatif. Harga seunit yang lebih rendah menjadikan gelung ejen rekursif, pendorongan kelompok latar belakang, and pekerja berbilang langkah autonomi berdaya maju dari segi ekonomi secara skala. Walau bagaimanapun, bagi jurutera sistem, jurutera kebolehpercayaan, dan pembangun bahagian belakang, geseran kewangan yang dikurangkan mendedahkan cabaran kebolehskalaan hiliran, mengalihkan fokus kejuruteraan daripada bajet token kepada sempadan had kadar, had serentak, saluran paip telemetri, dan kesesakan tekanan balik.
Masalah Operasi & Kekangan Kewangan
Sepanjang fasa awal penggunaan LLM perusahaan pengeluaran, yuran token nominal bertindak sebagai pengawal selia seni bina tidak rasmi. Kos inferens yang tinggi memaksa pasukan pembangunan menguruskan pemanggilan model sebagai transaksi diskret yang dimulakan oleh pengguna. Aplikasi sangat bergantung pada kelulusan manusia dalam gelung, sejarah perbualan terikat, dan pekerja berjadual yang dihadkan dengan ketat untuk memastikan bil pembekal bulanan kekal boleh diramal. Pengenalan pengurangan model peringkat pertengahan kekal mencabar pertukaran sejarah ini, mengalihkan kebimbangan kejuruteraan sistem daripada harga model kepada daya tahan infrastruktur bahagian belakang.
Sekilas Pandang
- Pengurangan Harga Asas: Pada 22 September 2026, OpenAI memperkenalkan GPT-6 Sol pada $2.00 input / $10.00 output dan GPT-6 Luna pada $0.10 input / $0.50 output setiap juta token untuk pemprosesan Standard pada gesaan sehingga 272K token, mewakili pengurangan nominal sebanyak 50% atau lebih berbanding harga API promosi GPT-5.6.
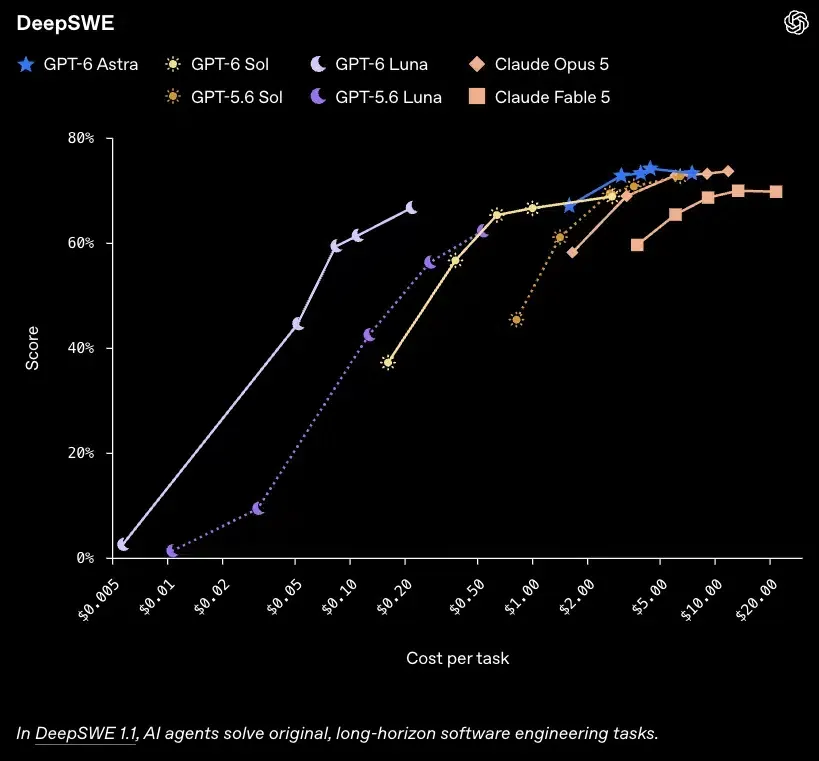
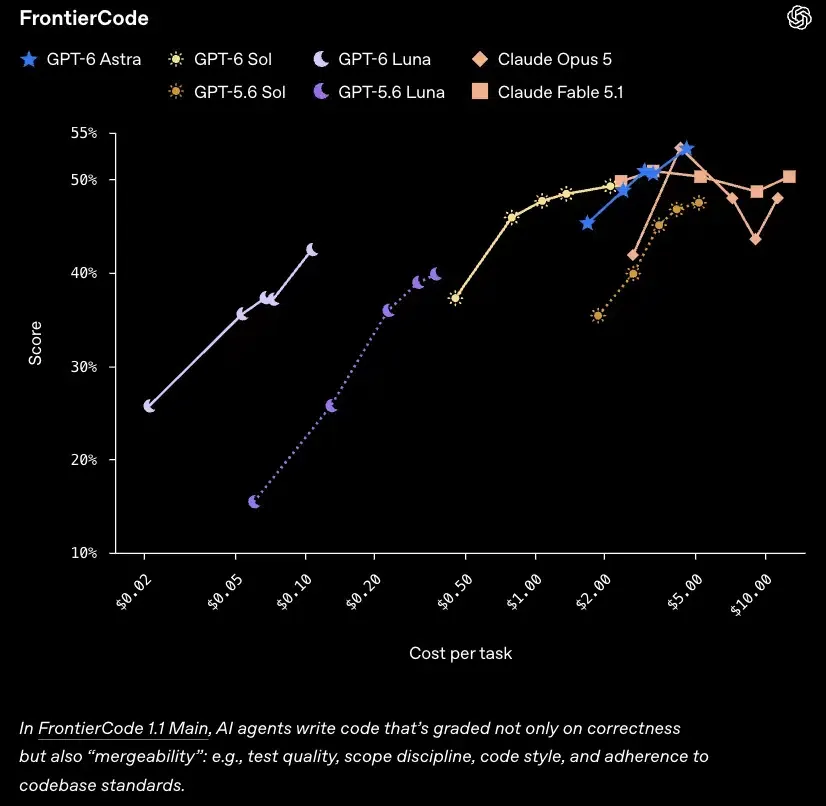
- Ekonomi Penanda Aras Peringkat Tugas: Pada AutomationBench 1.0.6, OpenAI melaporkan bahawa GPT-6 Sol yang dikonfigurasikan pada usaha penaakulan xhigh mencapai skor aliran kerja 33.2% pada purata kos yang dilaporkan sebanyak $0.27 setiap tugas yang dicuba, mengalihkan penilaian pembangun daripada harga token mentah kepada kos setiap unit kerja yang dicuba.
- Dinamik Penstoran Gesaan: Platform ini menyampaikan diskaun automatik sebanyak 90% pada bacaan token input yang disimpan dalam cache (bil pada kadar token input asas 0.1×), manakala penulisan cache awal dibilkan pada kadar token input 1.25× yang tidak disimpan dalam cache, memerlukan penormalan awalan yang teliti untuk mengekalkan kadar hit cache yang tinggi merentas jangkaan berbilang langkah dinamik.
Seperti yang diperincikan merentas Rujukan Harga API Pembangun OpenAI rasmi dan Pengumuman Komuniti OpenAI, struktur harga ini terhasil daripada penambahbaikan berterusan merentas saluran paip inferens peringkat rendah dan sistem penstoran KV. Walau bagaimanapun, apabila kos melaksanakan urutan tugas automatik jatuh dengan ketara, pasukan kejuruteraan memperluaskan skop tugas latar belakang mereka. Lantai ekonomi yang sebelum ini menghalang pekerja latar belakang daripada menjalankan pengundian berterusan, lulus semakan kod automatik, atau saluran pengekstrakan dokumen berbilang peringkat telah diturunkan.
Merentas pasaran, pelbagai pembekal model asas telah menurunkan atau menstruktur semula harga API merentas peringkat pembangun. Anthropic mengeluarkan Claude Opus 5.5 di samping spesifikasi kemas kini pada Spesifikasi Platform Anthropic Claude Opus 5.5, memetik $4 setiap juta token input, $0.20 setiap juta bacaan input yang disimpan dalam cache, dan $20 setiap juta token output, menyoroti penggunaan token yang dikurangkan pada penanda aras pemfaktoran semula kod. Pada masa yang sama, Google mengekalkan harga pengenalan promosi untuk Gemini 3.8 Flash yang didokumenkan pada Google AI untuk Pembangun, dan keluaran berat terbuka seperti MiMo-V2.6-Pro Xiaomi menyediakan pasukan hos sendiri dengan pilihan kos token yang agresif di bawah lesen perisian yang permisif.
Apabila kos model turun, gelagat pembangunan berubah. Pasukan kejuruteraan menggelungkan rekursif yang lebih mendalam, menyuntik dokumentasi perusahaan menyeluruh ke dalam gesaan sistem, dan mengkonfigurasi logik cubaan semula automatik merentas graf tugas yang kompleks. Apa yang bermula sebagai kelegaan kos pada lapisan API boleh mengalihkan latensi dan lonjakan trafik kepada perkhidmatan dalaman. Jika pekerja orkestrasi mengeluarkan berdozen panggilan model berurutan atau selari untuk satu transaksi pengguna, kolam pangkalan data dalaman, kelompok storan tambahan, saluran paip telemetri, dan pengehad kadar mesti menyerap beban yang terhasil.
Punca Akar Sistemik & Rantaian Permintaan Bukan Visual
Apabila aplikasi pelanggan beralih daripada antara muka sembang interaktif kepada automasi latar belakang bukan visual, profil permintaan huluan berubah secara drastik. Satu peristiwa perniagaan tunggal boleh mencetuskan saluran paip autonomi yang memeriksa skema, menilai pembolehubah persekitaran, memanggil alat luaran, dan mengesahkan output merentas berbilang laluan berterusan.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Pelaksanaan Ejen Rekursif dan Pendaraban Keserentakan
Dalam sistem web interaktif tradisional, volum permintaan mencerminkan irama interaksi manusia. Setiap utas HTTP lazimnya dipetakan kepada interaksi pengguna yang jelas, dengan kipas keluar keseluruhan yang lebih rendah dan rentak yang dibatasi oleh masa berfikir manusia. Masa runkit pelanggan menghantar muatan, menunggu tindak balas, dan berhenti sebentar sebelum memulakan interaksi seterusnya.
Perbandingan Profil Permintaan Konseptual: Interaktif vs. Ejen
| Metrik Seni Bina | Aliran Pengguna Interaktif | Gelung Ejen Autonomi |
|---|---|---|
| Model Keserentakan | Kipas keluar permintaan berpacedkan manusia biasanya lebih rendah | 1 Peristiwa Pengambilan = N Panggilan Kanak-kanak Berantai |
| Masa Pelaksanaan | Dipercepatkan oleh tindak balas pengguna dan masa berfikir | Terus berjalan secara automatik sehingga had polisi campur tangan |
| Ketidaksahihan Konteks | Muatan segar setiap sesi | Sangat bergantung pada konteks yang disimpan dalam cache |
| Pengendalian Ralat | Pengguna mencuba semula apabila berlaku ralat | Cubaan semula atur cara automatik |
| Kesesakan Sistem | Lebar jalur gerbang bahagian hadapan | Had kolam pangkalan data dalaman |
| Kerosakan Berturut-turut | Terpencil kepada satu sesi | Boleh mencetuskan ketepuan baris gilir |
Apabila sistem mengintegrasikan ejen autonomi, rentak ini terlerai. Satu peristiwa yang dicetuskan boleh menghasilkan urutan panggilan automatik yang tidak terganggu. Jika ejen menghadapi ralat sementara atau output alat yang cacat, logik cubaan semula naif boleh menghasilkan letusan permintaan pantas terhadap perkhidmatan bahagian belakang. Kerana kos token yang dikurangkan menjadikan jangka pelaksanaan yang lebih panjang mampu milik, aliran kerja automatik boleh menskalakan volum permintaan latar belakang dengan ketara, walaupun dengan asas pengguna aktif yang rata.
Mekanik Penstoran Gesaan: Penggunaan Semula KV, Overhed Penulisan, dan Kestabilan Awalan
OpenAI menggandingkan keluaran Sol dan Luna dengan pengoptimuman merentas sub-sistem penstoran gesaannya. Seperti yang didokumenkan dalam Spesifikasi Penstoran Gesaan OpenAI, token input yang sepadan dengan awalan yang disimpan dalam cache menerima diskaun 90% pada harga bacaan. Penstoran gesaan terutamanya mengurangkan pengiraan semula sebelah model berbanding berfungsi sebagai mekanisme pemampatan muatan rangkaian tujuan am. Dalam interaksi tanpa keadaan standard, aplikasi pelanggan menghantar konteks permintaan, dan pembekal melangkau pengiraan semula tensor KV untuk awalan yang sepadan, dengan ketara mengurangkan latensi masa ke token pertama dan pengebilan input.
Secara krusial, penulisan awalan awal ke dalam cache sebelah pelayan dibilkan pada kadar token input 1.25× yang tidak disimpan dalam cache. Memaksimumkan kecekapan kos memerlukan mengekalkan kestabilan awalan merentas berbilang pertanyaan.
Senarai Harga API Awam Terpilih — Tidak Boleh Dibuat Perbandingan Terus Merentas Pembekal
| Pengecam Model | Input ($/1M Tok) | Output ($/1M Tok) | Polisi Baca Cache |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | Diskaun 90% (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | Diskaun 90% (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | Harga Bertingkat Dinamik |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M Baca (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | Sehingga 90% pada cache |
| Google Gemini 3.8 Flash | $0.75 (Pengenalan) | $3.75 (Pengenalan) | $0.075/1M Baca Disimpan dalam Cache |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M Baca Disimpan dalam Cache |
Nota: Kadar standard terpakai pada peringkat konteks pendek (gesaan sehingga 272K token input untuk OpenAI). Pembekal mengenakan overhed penulisan cache yang berbeza, had konteks, dan terma promosi terikat masa.
Pemeliharaan awalan memerlukan pengendalian pilihan konfigurasi API yang teliti. Dalam seni bina API OpenAI, penukaran parameter usaha penaakulan secara terus atau pengubahan tatasusunan takrifan alat akan mengubah awalan gesaan yang dipaparkan dan membatalkan keadaan cache yang lebih awal.
Untuk mengekalkan konteks yang disimpan dalam cache semasa sesi berbilang giliran, pembangun mesti memastikan skema alat dan arahan asas dalam susunan yang konsisten. Jika pelarasan masa runkit diperlukan, pembangun harus mengemas kini parameter melalui kawalan sesi berstruktur (seperti configuration_update) atau menogol pelaksanaan alat menggunakan tool_choice atau allowed_tools daripada mengubah tatasusunan takrifan alat secara terus.
Apabila ralat cache berlaku, pembekal huluan memproses semula urutan input tanpa diskaun bacaan 90%. Pada skala, ini boleh meningkatkan latensi inferens dan tekanan masa tamat. Untuk pelaksanaan tugas berbilang langkah, penilaian kos beralih daripada pengali token ringkas kepada perbelanjaan tugas yang disiapkan, seperti yang dilihat dalam Laporan VentureBeat Mengenai Penanda Aras GPT-6 Sol dan Luna, di mana GPT-6 Sol mencapai skor 33.2% pada AutomationBench 1.0.6 pada purata $0.27 setiap tugas yang dicuba.
Seni Bina Telemetri: Memisahkan Metrik Operasi daripada Audit Pematuhan
Lonjakan permintaan LLM automatik memberikan tekanan yang ketara pada kebolehhatian bahagian belakang dan saluran paip pematuhan. Aliran kerja ejen keserentakan tinggi memerlukan pengasingan seni bina yang jelas antara telemetri operasi dan jejak audit undang-undang.
Polisi pematuhan perusahaan selalunya memerlukan rakaman metadata sesi, bukti pelaksanaan alat, dan rekod transaksi. Melakukan telemetri operasi dan data pematuhan secara identik mewujudkan pertukaran kejuruteraan yang serius:
- Saluran Audit Pematuhan dan Keselamatan: Mesti menyediakan penghantaran yang tahan lasak dan boleh dimainkan semula dengan cubaan semula eksplisit, ketekunan, dan pengendalian kegagalan ke dalam stor audit tulis sekali, terkawal akses. Muatan harus menangkap metadata berstruktur, identiti pemanggil, dan keadaan kriptografi sambil membersihkan maklumat kenal pasti peribadi (PII) dan kunci rahsia secara sistematik. Di bawah beban tinggi, saluran paip ini mesti mengenakan tekanan balik atau meletakkan tugas dalam baris gilir secara tahan lasak berbanding melupuskan rekod.
- Saluran Telemetri Operasi: Menjejaki metrik prestasi seperti kiraan token, nisbah hit cache gesaan, and latensi tindak balas huluan. Kerana jejak ini digunakan untuk pemantauan masa nyata dan nyahpepijat, ia boleh diproses melalui penampan titisan kehilangan yang terikat. Jika pengumpul hiliran menjadi perlahan, aplikasi boleh melenyapkan telemetri operasi berlebihan dengan selamat untuk mengekalkan ketersediaan teras perkhidmatan.
Apabila pembekal luaran mengembalikan ralat had kadar HTTP 429, polisi cubaan semula yang dikonfigurasikan dengan buruk boleh menyebabkan isu operasi yang teruk. Cubaan semula segera atau rutin backoff eksponen disegerakkan tanpa jitter rawak mewujudkan gelombang cubaan semula yang boleh mengalir melalui mikroperkhidmatan pertengahan, menggunakan kolam utas dan sambungan pangkalan data.
Perbandingan Penyelesaian: Pertukaran Bina vs. Beli
Menguruskan beban operasi akibat kos inferens yang lebih rendah memerlukan organisasi menilai pintu masuk AI dan seni bina proksi mereka. Pasukan mesti memutuskan sama ada untuk membangunkan penghalaan tersuai, pengehadan kadar, dan proksi telemetri secara dalaman atau melabur dalam infrastruktur pihak ketiga yang khusus.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Saluran Paip Daya Tahan Dalaman Tersuai
Membangunkan infrastruktur tersuai memberikan pasukan kejuruteraan kawalan penuh ke atas polisi rangkaian, pembersihan data, and strategi penghalaan. Organisasi boleh membina proksi pinggir yang disesuaikan dengan topologi mikroperkhidmatan dalaman mereka yang tepat.
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Walau bagaimanapun, pembangunan dalaman memerlukan penyelenggaraan kejuruteraan yang berterusan. Pasukan mesti menyesuaikan diri secara manual dengan kemas kini API pembekal, mengendalikan had kadar yang berkembang merentas berbilang vendor, dan menguruskan baris gilir telemetri yang agihan. Overhed penyelenggaraan ini boleh mengalihkan sumber pembangun dalaman daripada ciri produk teras.
Pintu Masuk Komersial dan Alatan Infrastruktur
Untuk mengelakkan pembinaan keupayaan ini dari awal, banyak perusahaan menggunakan proksi API terurus, pintu masuk LLM, and satah kawalan pinggir. Beberapa pintu masuk terurus menyediakan penyelarasan had kadar sedar pembekal, kebolehhatian, kawalan polisi, dan penghalaan sedar cache; keupayaan tepat berbeza mengikut vendor, dan pengoptimuman awalan selalunya masih memerlukan disiplin permintaan peringkat aplikasi.
Platform komersial membolehkan pasukan kejuruteraan menguatkuasakan kuota kos setiap persekitaran, mengkonfigurasi penghalaan sandaran automatik merentas keluarga model, dan melucutkan maklumat pelanggan sensitif sebelum merekodkan metadata permintaan. Pintu masuk yang dibina khas menguruskan lonjakan keserentakan, mengaudit trend penggunaan API, dan melindungi mikroperkhidmatan hiliran merentas persekitaran aplikasi yang kompleks.
Matriks Keputusan: Saluran Paip Dalaman vs. Platform Terurus
| Kriteria Penilaian | Alatan Daya Tahan Dalaman | Infrastruktur Penghalaan Terurus |
|---|---|---|
| Usaha Pembinaan Awal | Tinggi (3-6 minggu kejuruteraan) | Rendah (Bersepadu melalui API standard) |
| Penyelenggaraan Protokol | Tanggungjawab pasukan berterusan | Dikendalikan oleh kemas kini vendor |
| Kawalan Operasi | Keterlihatan timbunan penuh | Terhad oleh antara muka vendor |
| Penalaan Penstoran Gesaan | Memerlukan proksi tersuai | Bergantung pada vendor; biasanya memerlukan kerjasama aplikasi |
| Pengasingan Telemetri | Pengurusan baris gilir tersuai | Bergantung pada vendor |
| Profil Kos Kewangan | Overhed gaji kejuruteraan | Yuran SaaS / penggunaan berulang |
Senarai Semak Integrasi & Jadual Tadbir Urus
Organisasi yang meningkatkan penggunaan model mereka berikutan pengurangan harga GPT-6 Sol dan Luna boleh menggunakan kerangka kerja operasi ini untuk mengelakkan beban berlebihan sistemik:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit aplikasi pelanggan untuk mengenal pasti gelung panggilan model rekursif tanpa had |
| [ ] Tetapkan had masa tamat yang ketat dan undur cubaan semula bukan linear dengan jitter rawak |
| [ ] Laksanakan pengehad kadar baldi token tempatan dan pinggir mendahului panggilan huluan |
| [ ] Susun struktur gesaan untuk memaksimumkan penggunaan semula awalan penstoran gesaan |
| [ ] Asingkan telemetri operasi kehilangan daripada jejak audit yang tahan lasak dan boleh dimainkan semula |
| [ ] Tambah pensampelan masa runkit untuk melucutkan badan gesaan mentah daripada jejak frekuensi tinggi |
| [ ] Pantau trend status HTTP 429 dan tetapkan pencetus tekanan balik automatik         |
| [ ] Konfigurasikan amaran kos dan pemutus litar untuk menangkap pekerjaan automatik lari |
+-----------------------------------------------------------------------------------------+
Konfigurasi Saluran Paip Telemetri
Sistem kebolehhatian mesti memisahkan pembalakan gesaan daripada laluan permintaan masa nyata. Apabila memproses beban kerja ejen frekuensi tinggi, aplikasi harus menulis metadata telemetri kepada baris gilir asynchronous terikat memori, menghalang kelembapan I/O jika pengumpul telemetri hiliran menjadi perlahan.
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Soalan Lazim (FAQ)
Apakah kadar API rasmi untuk GPT-6 Sol dan Luna?
Bagaimanakah penstoran gesaan mengurangkan kos pada perbualan yang panjang?
Mengapakah token yang lebih murah meningkatkan risiko operasi bahagian belakang?
Pengambilan Utama untuk Pasukan Kejuruteraan
Pelancaran GPT-6 Sol dan Luna mempercepatkan trend yang lebih luas: kecerdasan sempadan menjadi lebih murah dan lebih mudah diakses. Apabila kos seunit token jatuh mendadak, kekangan kewangan berhenti menjadi mekanisme kawalan yang berkesan untuk seni bina perisian.
Semakin organisasi menerima pakai ejen frekuensi tinggi dan topologi model berbilang peringkat, kejuruteraan operasi menjadi kritikal kepada kejayaan perusahaan. Pasukan mesti melangkaui penilaian model semata-mata mengikut harga token nominal atau skor penanda aras. Kebolehpercayaan jangka panjang akan bergantung pada keberkesanan sistem menguruskan keserentakan, menyelaraskan konteks gesaan untuk penggunaan semula cache, mengendalikan had kadar huluan dengan lancar, dan memisahkan telemetri daripada laluan aplikasi kritikal. Organisasi yang membina infrastruktur tahan lasak akan berjaya menskalakan aliran kerja ejen automatik mereka tanpa mengorbankan masa aktif aplikasi atau kestabilan sistem.
Sumber Utama & Dokumentasi Rujukan
-
Rujukan Harga API Pembangun OpenAI: Kad kadar pembangun rasmi, kekangan tingkap konteks (≤272K ambang standard), dan jadual harga baca/tulis cache untuk GPT-6 Sol, Luna, dan Astra.
-
Pengumuman Komuniti OpenAI: Pendedahan awam yang mengesahkan pengurangan harga asas 50% berbanding peringkat promosi GPT-5.6 dan butiran pelancaran pencapaian.
-
Spesifikasi Penstoran Gesaan OpenAI: Dokumentasi seni bina mengenai penggunaan semula awalan Nilai-Kunci sebelah pelayan, overhed penulisan cache, dan peraturan ketidaksahihan konfigurasi.
-
Spesifikasi Platform Anthropic Claude Opus 5.5: Spesifikasi keluaran rasmi yang mengesahkan kadar token $4 input / $20 output / $0.20 baca cache dan prestasi penanda aras.
-
Gambaran Keseluruhan Anthropic Claude Sonnet 5: Kad kadar pembangun rasmi dan metrik kecekapan penstoran gesaan ($2 input / $10 output / sehingga 90% diskaun cache).
-
Kad Kadar Google AI untuk Pembangun: Gambaran keseluruhan kad kadar pembangun dan polisi harga pengenalan untuk Gemini 3.8 Flash.
-
Harga API Rasmi & Jadual Kadar Xiaomi MiMo: Kadar token bayar semasa anda pergi luar negara kanon untuk inferens MiMo-V2.6-Pro ($0.435 input / $0.87 output / $0.0036 hit cache).
-
Laporan VentureBeat Mengenai Penanda Aras GPT-6 Sol dan Luna: Liputan ekonomi keluaran, jaminan harga kekal, dan angka kos tugas AutomationBench 1.0.6 ($0.27 setiap tugas yang dicuba).
Share this article



