OpenAI dan Google Sokong Pilihan Keluar Latihan AI Bersama? OpenAI, Google, and Microsoft mengumumkan rancangan pada 30 Oktober 2026, untuk menghormati token polisi tunggal dan bersama dalam robots.txt yang membolehkan pengendali tapak web menyatakan keutamaan latihan model AI generatif merentas pelbagai pembekal secara serentak. Mekanisme yang dicadangkan ini berasal daripada Draf Internet individu yang diserahkan kepada kumpulan kerja IETF AI Preferences oleh jurutera Anthropic, Kevin Kelley. Walaupun inisiatif ini menawarkan penerbit kaedah yang diselaraskan untuk mengisytiharkan pilihan keluar latihan menggunakan sintaks Allow dan Disallow standard, garis masa pelaksanaan tetap berperingkat hingga 2027, dan setiap platform utama merancang untuk mentafsir serta mengaplikasikan isyarat tersebut secara berbeza merentas latihan model dan pembumian perbualan langsung.
Penjajaran Semula Industri Teras: Makmal AI Utama Menyelaras Standard Robots.txt
Sekilas Pandang
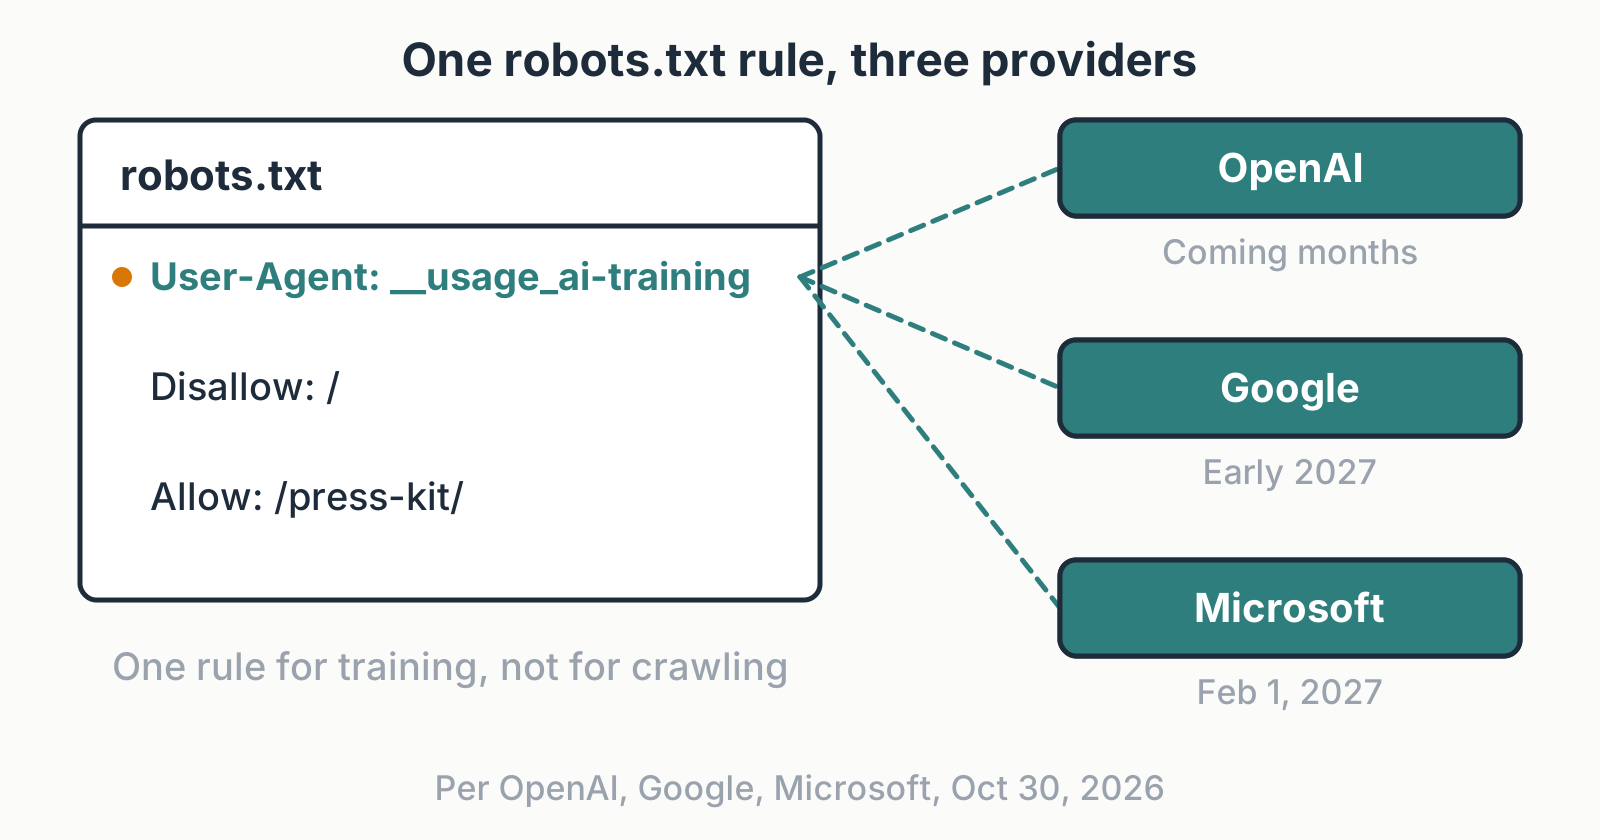
- OpenAI, Google dan Microsoft mengumumkan rancangan terkoordinasi pada 30 Oktober 2026 untuk mengiktiraf token polisi robots.txt bersama,
__usage_ai-training, bagi menguruskan keutamaan latihan model generatif. - Isyarat tersebut dicskan dalam Draf Internet IETF individu yang dikarang oleh jurutera Anthropic, Kevin Kelley, menetapkan sintaks yang diseragamkan tanpa mewakili standard RFC IETF rasmi atau dimuktamadkan.
- Jadual penggunaan platform jauh bezanya: Anthropic telah memulakan kerja kejuruteraan dalaman, OpenAI mensasarkan pelancaran pada bulan-bulan akan datang, Microsoft bermula pada 1 Februari 2027, dan Google mengunjurkan sokongan pada 2027.
Selama hampir tiga puluh tahun, Protokol Pengecualian Robot mentadbir cara crawler web automatik berinteraksi dengan kandungan dalam talian awam. Pentadbir tapak web meletakkan fail teks biasa robots.txt ringkas dalam direktori akar mereka, mentakrifkan ejen pengguna enjin carian yang mempunyai kebenaran untuk mengambil laluan URL tertentu. Protokol ini beroperasi atas perjanjian perdagangan asas: penerbit tapak web membenarkan crawler mengindeks kandungan mereka sebagai balasan untuk kebolehjumpaan, trafik rujukan keluar, dan pendedahan jenama pada halaman hasil enjin carian.
Peningkatan pesat kecerdasan buatan generatif mengganggu model ekonomi tersebut. Pengikis automatik yang dikerahkan oleh makmal AI sempadan mula menelan domain web untuk melatih model asas, selalunya meringkaskan kandungan asal secara terus dalam antara muka jawapan tanpa menyampaikan klik rujukan kepada penerbit. Pemilik kandungan yang ingin menghalang harta intelek mereka daripada ditelan terpaksa menyelenggara senarai ejen pengguna proprietari yang berpecah-belah dan kompleks, termasuk GPTBot, ClaudeBot, dan Google-Extended. Overhed pentadbiran ini meningkatkan risiko operasi bagi ralat konfigurasi atau penyahindeksan carian secara tidak sengaja apabila menguruskan pelbagai arahan crawler secara serentak.

Kemunculan pilihan keluar latihan AI bersama menandakan anjakan ketara daripada penyekatan vendor yang berpecah-belah kepada tadbir urus protokol secara koperatif. Dengan menyelaraskan sokongan di sekitar token polisi bersama, pembekal AI utama bertujuan menurunkan halangan teknikal bagi pencipta kandungan yang ingin menetapkan sempadan yang jelas mengenai latihan model generatif. Menurut pengumuman rasmi Google Search Central, peraturan tunggal ini membolehkan pentadbir tapak web mengisytiharkan pendirian latihan AI generatif mereka dalam satu langkah, berbanding menjejak dan mengkonfigurasi arahan berbeza bagi setiap crawler AI komersial individu yang memasuki pasaran.
Mekanik Senibina di Sebalik Tabir: Cara Token __usage_ai-training Berfungsi
Senibina teknikal di sebalik isyarat keutamaan bersama dinyatakan dalam Draf Internet IETF mengenai Isyarat Keutamaan Latihan Boleh Dibaca Mesin. Yang penting, draf tersebut tidak memperkenalkan arahan baharu atau mengubah tatabahasa asas Protokol Pengecualian Robot yang ditakrifkan dalam RFC 9309. Sebaliknya, ia menggunakan semula rekod User-Agent standard dengan menetapkan token polisi rizab: __usage_ai-training.
Untuk mengkonfigurasi pilihan keluar, pentadbir web mencipta blok peraturan biasa yang menetapkan token polisi ini sebagai ejen pengguna, diikuti oleh peraturan Disallow dan Allow standard. Contoh di bawah menggambarkan cara pemilik tapak web menyatakan pilihan keluar merentas semua direktori tapak sambil mengekalkan pengecualian untuk bahan promosi awam:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Takrifan semantik bagi maksud "latihan AI" d锚kalkan dalam spesifikasi perbendaharaan kata asas kumpulan kerja IETF. Di bawah kerangka ini, latihan ditakrifkan secara ketat sebagai menggunakan kandungan web yang dikikis untuk mengubah suai atau menyetem halus berat dan parameter yang dipelajari bagi model kecerdasan buatan generatif. Operasi pengiraan bukan generatif, seperti pengelasan dokumen standard, kedudukan indeks carian, pembetulan ejaan, dan penapisan spam, dikecualikan secara jelas daripada takrifan ini.
Sempadan Protokol: Merangkak lwn. Latihan lwn. Pembumian
Memahami had operasi token yang dicadangkan ini memerlukan pengasingan peringkat berbeza bagi pengambilan data automatik:
[Kandungan Web Awam]
       │
       ▼
[1. Merangkak / Ambil HTTP] ──> Ditadbir oleh Ejen Pengguna crawler tertentu (cth., GPTBot, Bingbot)
       │                    *__usage_ai-training TIDAK MENTADBIR tingkah laku pengambilan HTTP*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. Kegunaan Latihan Model]              [3. Pembumian Langsung / RAG]
   *__usage_ai-training: Disallow*          *Ditadbir oleh tag halaman & tetapan vendor*
   Menyatakan keutamaan menentang latihan   Membekalkan konteks web masa nyata kepada model AI
       │                                        │
       ▼                                        ▼
   Penguatkuasaan bergantung kepada         Kriteria kelayakan ditetapkan oleh
   pembekal AI yang mengambil bahagian      polisi platform individu
Pasukan teknikal mesti menilai empat sempadan struktur yang wujud dalam spesifikasi draf ini:
- Isyarat Mentadbir Latihan, Bukan Merangkak: Token polisi bukanlah arahan untuk tingkah laku merangkak rangkaian. Crawler AI yang menemui
Disallow: /di bawah__usage_ai-trainingmasih dibenarkan mengambil dokumen HTML melalui HTTP. Ia sekadar diarahkan agar tidak memasukkan teks yang diambil itu ke dalam saluran paip latihan model. Untuk menghalang bot daripada meminta URL tersebut sepenuhnya, pentadbir mesti terus menyekat nama identiti khusus crawler tersebut. - Peraturan Kad Liar Tidak Berpakai: Sekatan kad liar am, seperti
User-Agent: *diikuti olehDisallow: /, tidak sepadan dengan token polisi. Draf tersebut memberi mandat bahawa pembekal AI yang mengambil bahagian tidak boleh mentafsir kumpulan kad liar universal sebagai ungkapan keutamaan latihan AI. Jika sesuatu fail meninggalkan token__usage_ai-trainingyang eksplisit, standard tersebut mentafsirkan tapak sebagai tidak menyatakan sebarang keutamaan latihan. - Tiada Nyahbelajar Model Retrospektif: Mengemas kini fail
robots.txttapak web beroperasi ke hadapan dari semasa ke semasa. Ia menyediakan isyarat untuk kitaran merangkak dan latihan masa depan tetapi tidak memaksa makmal AI untuk membersihkan data yang telah disepadankan ke dalam set data latihan bersejarah atau memadam berat daripada model asas sedia ada. - Penyelarasan Sukarela Berbanding Penguatkuasaan Teknikal: Isyarat tersebut menyatakan keutamaan penerbit; ia tidak menyediakan penguatkuasaan teknikal terhadap pengguna data yang tidak mengambil bahagian atau tidak mematuhi peraturan. Di bawah prinsip RFC 9309, robots.txt kekal sebagai mekanisme penasihat koperatif dan bukannya tembok api kawalan capaian.
Perbezaan Pelaksanaan Pembekal dan Jadual Migrasi
Walaupun Google, Microsoft, and OpenAI telah mengumumkan rancangan untuk menyokong isyarat bersama ini, pelaksanaan teknikal dan jadual pelancaran mereka jauh bezanya. Setiap pembekal mendekati keseimbangan antara pengindeksan enjin carian, latihan model generatif, dan penjanaan ditambah perolehan perbualan (RAG) melalui infrastruktur produk mereka sendiri.
Matriks di bawah membandingkan komitmen platform yang disahkan, peraturan tafsiran, dan jadual migrasi:
| Platform | Status Disahkan & Garis Masa | Tafsiran Token Polisi | Pengendalian Pembumian & Perolehan | Migrasi Tag Lama & Pengecualian |
|---|---|---|---|---|
| Sokongan diumumkan; dirancang untuk 2027 (tarikh tepat akan ditentukan) | Ditafsirkan sebagai Google-Extended: Disallow apabila tiada peraturan Google-Extended eksplisit wujud |
Pemetaan lalai menjejaskan pembumian Aplikasi Gemini; peraturan eksplisit mengetepikan | Arahan Google-Extended sedia ada kekal sah sepenuhnya; pengindeksan carian tidak terjejas |
|
| Microsoft | Komitmen disahkan; mula menghormati pada 1 Februari 2027 | Diiktiraf sebagai pilihan keluar latihan semasa merangkak web | Diasingkan daripada latihan; diuruskan secara berasingan melalui tag peringkat halaman | Menamatkan NoArchive/NoCache untuk AI pada 1 Mac 2027; tetapan Bing Webmaster Tools sementara dibuka 15 Dis |
| OpenAI | Komited kepada pelaksanaan dalam bulan-bulan akan datang | Sokongan langsung dalam saluran paip pengambilan data | Dinilai bersama arahan GPTBot |
Konfigurasi GPTBot sedia ada kekal aktif dan boleh dikuatkuasakan |
| Anthropic | Draf dikarang oleh pekerja; pembangunan dilaporkan pada senarai kumpulan kerja | Sokongan yang dihasratkan merentas perkhidmatan; garis masa bilik berita rasmi akan ditentukan | Dinilai bersama arahan ClaudeBot |
Kawalan crawler ClaudeBot sedia ada terus beroperasi |
Google merancang untuk mentafsir pilihan keluar latihan AI bersama sebagai larangan Google-Extended apabila tiada peraturan Google-Extended eksplisit hadir. Oleh kerana Google-Extended juga mentadbir kelayakan untuk pembumian dalam Aplikasi Gemini, pemetaan lalai ini boleh menjejaskan sama ada kandungan penerbit tersedia untuk pengalaman tersebut. Peraturan Google-Extended yang eksplisit diutamakan berbanding isyarat bersama dalam pelaksanaan Google, tetapi penerbit tidak seharusnya menganggap bahawa kawalan semasa Google menawarkan pilihan keluar bebas untuk latihan model dan pembumian Aplikasi Gemini. Kandungan yang dibenarkan di bawah Google-Extended mungkin layak untuk pembumian Gemini, tanpa sebarang jaminan kemasukan atau petikan.
Sebaliknya, Microsoft Bing menganggap latihan model dan pembumian masa nyata sebagai konsep senibina yang berbeza, seperti yang diperincikan dalam kemas kini rasmi Bing Webmaster. Microsoft membolehkan penerbit memilih keluar daripada latihan model generatif sambil terus membenarkan pembumian langsung dalam jawapan Copilot. Tapak yang menguruskan keutamaan ini boleh mengisytiharkan sekatan latihan dalam robots.txt atau melalui tag meta HTML peringkat halaman dan pengepala HTTP, yang mengetepikan robots.txt untuk URL individu. Pembumian dikawal melalui keutamaan peringkat halaman, termasuk pilihan DisallowExtended yang membenarkan pembumian dalam alat Microsoft sendiri (seperti Copilot) sambil mengecualikan perkhidmatan pihak ketiga yang dikuasakan oleh API pembumian Microsoft. Tambahan pula, Microsoft sedang menghentikan pergantungan sejarahnya pada tag NoArchive dan NoCache untuk kawalan AI; tapak yang bergantung pada tag tersebut mesti beralih kepada pilihan baharu sebelum tarikh akhir 1 Mac 2027. Tetapan pembumian Bing Webmaster Tools sementara hanya tersedia untuk tapak yang menggunakan NoArchive atau NoCache setakat 15 Disember 2026. Ia kekal berkesan sehingga Microsoft merangkak semula halaman tersebut dan menemui keutamaan baharu, atau sehingga 30 September 2027, mana yang terdahulu.
Senarai Semak Kejuruteraan: Mengaudit Keutamaan Web untuk Web Agen
Melaksanakan isyarat keutamaan latihan AI bersama memerlukan koordinasi antara senibina sistem, operasi kandungan, dan pasukan tadbir urus undang-undang. Pemimpin kejuruteraan mesti memastikan konfigurasi pelayan mencerminkan polisi organisasi dengan tepat tanpa mengganggu penemuan enjin carian secara tidak sengaja.
Senarai Semak Pelaksanaan Pentadbir Web dan Sistem
- Audit Manifest Robots Semasa: Semak fail
robots.txtsedia ada untuk mengkatalogkan arahan khusus vendor, mengesahkan sama ada peraturan untukGPTBot,ClaudeBot, atauGoogle-Extendedbercanggah dengan polisi latihan organisasi. - Laksanakan Token Polisi Rizab: Laksanakan blok
User-Agent: __usage_ai-traininguntuk menyatakan sempadan latihan global merentas pembekal AI yang mengambil bahagian dalam format bersatu. - Kekalkan Laluan Pengecualian Terperinci: Jika aset awam—seperti siaran akhbar, kit media, atau dokumentasi pembangun terbuka—dikhaskan untuk penggunaan model, isytiharkan pengecualian
Allow:yang eksplisit di bawah arahan larangan. - Asingkan Penyekatan Pengambilan daripada Tadbir Urus Latihan: Jika objektif utama adalah mengurangkan beban pelayan asal atau menghalang pengikisan yang tidak dibenarkan, konfigurasikan pengehadan kadar berasaskan IP, cabaran bot CDN, dan sekatan ejen pengguna crawler yang eksplisit.
Senarai Semak Tadbir Urus dan Pematuhan
- Semak Jadual Migrasi Pembumian Microsoft: Untuk tapak yang menggunakan
NoArchiveatauNoCacheuntuk mengawal output Bing Copilot, bersedia untuk beralih kepada tag peringkat halaman baharu sebelum tarikh akhir penguatkuasaan Microsoft pada 1 Mac 2027. - Nilai Pertukaran Penemuan Carian: Untuk platform yang menilai keterlihatan dalam enjin jawapan perbualan, kenali cara pemetaan lalai khusus vendor (seperti sandaran Google kepada
Google-Extended) menjejaskan kelayakan perolehan masa nyata. - Jejak Kemas Kini Kumpulan Kerja IETF: Pantau kemajuan
draft-kelley-aipref-training-preference-signaldalam kumpulan kerja IETF AIPREF untuk mengambil kira potensi kemas kini sintaks sebelum tarikh luput berjadualnya pada Mei 2027.
Share this article