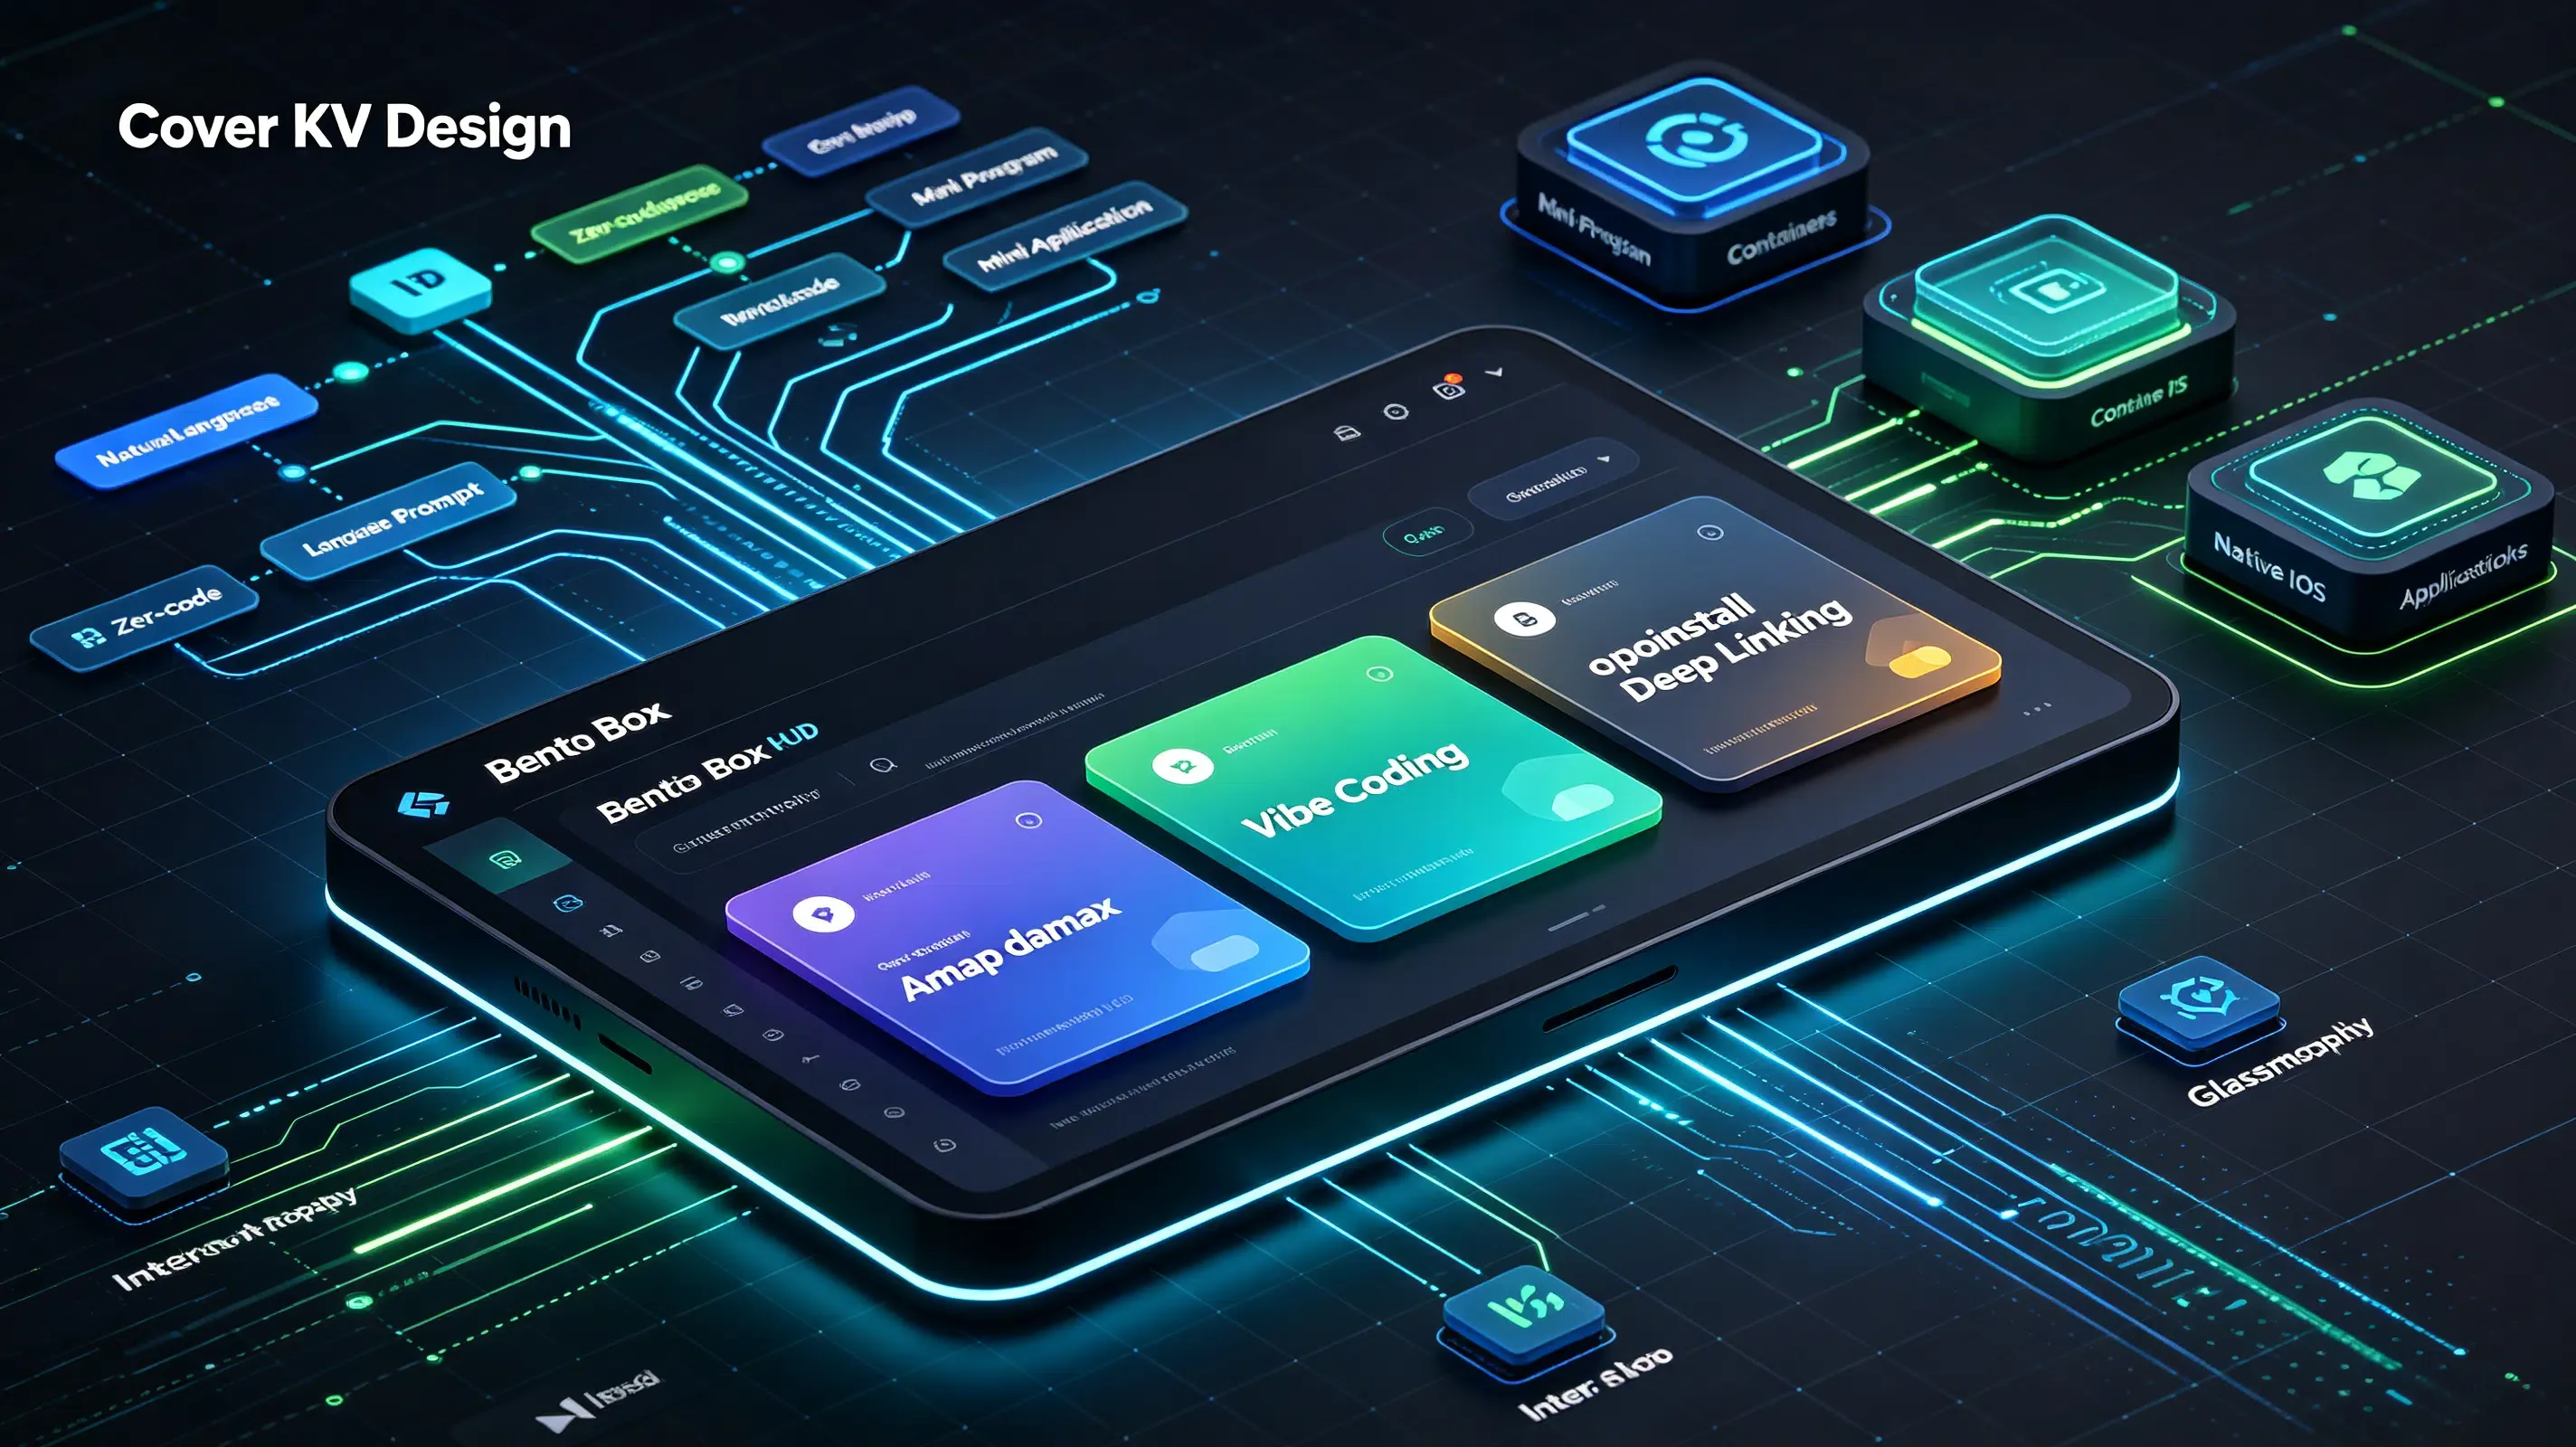
 Amap เปิดตัว ‘damax’? ความคิดริเริ่มเชิงกลยุทธ์นี้ได้รับการพิสูจน์แล้วว่า ยักษ์ใหญ่ด้านแผนที่กำลังเข้าสู่พื้นที่การสร้างแอปด้วย AI แบบ low-code เพื่อเปลี่ยนกระบวนการสร้างแอปให้เป็นอัตโนมัติ เมื่อวันที่ 29 มิถุนายน 2026 มีรายละเอียดเกี่ยวกับ ‘damax’ (หรือ ‘袋马’) เครื่องมือ Vibe Coding ที่ออกแบบมาเพื่อคอมไพล์ WeChat mini-programs และแอปพลิเคชัน iOS แบบ Native โดยตรงจากคำสั่งภาษาธรรมชาติ สำหรับทีมพัฒนาและผู้จัดการผลิตภัณฑ์ โมเดลการสร้างแอปที่รวดเร็วนี้เน้นย้ำถึงการเปลี่ยนผ่านทางเทคโนโลยี: ผู้ช่วย AI กำลังทำหน้าที่เป็น middleware ในการจัดการคำสั่งระหว่างผู้ใช้งานและแอปพลิเคชันมากขึ้น ซึ่งช่วยลดความจำเป็นในการตั้งค่าการพัฒนาด้วยตนเอง
สรุปประเด็นสำคัญ
- การสร้างที่รวดเร็ว: เอ็นจิ้น ‘damax’ ทำหน้าที่เปลี่ยนคำสั่งภาษาธรรมชาติให้เป็น WeChat mini-programs และไฟล์ติดตั้ง iOS แบบ Native โดยอัตโนมัติ ช่วยลดระยะเวลาในการเปิดตัวผลิตภัณฑ์ได้อย่างมาก
- กลุ่มเป้าหมาย: ระบบนี้รองรับเจ้าของธุรกิจขนาดเล็ก นักพัฒนาอิสระ และทีมขนาดเล็กที่ไม่มีแผนกวิศวกรรมซอฟต์แวร์โดยเฉพาะ
- บริบทที่กระจัดกระจาย: การเพิ่มขึ้นของแอปที่สร้างโดยอัตโนมัติทำให้เกิดความท้าทายใหม่ๆ ในการติดตามผล (Tracking), การกู้คืนเซสชัน (Session restoration) และการคงอยู่ของ deep link ข้ามแพลตฟอร์มที่แตกต่างกัน
การปรับเปลี่ยนโครงสร้างและพื้นที่การทำงานแบบ Low-Code Generative
Beijing Amap Yuntu Technology Co., Ltd. เป็นผู้พัฒนาและดำเนินการเครื่องมือ ‘damax’ ใหม่นี้ การเปิดตัวครั้งนี้ทำให้ Amap เข้าสู่ตลาดการสร้างแอปด้วย AI โดยตรง เพื่อแข่งขันกับแพลตฟอร์มที่มีชื่อเสียง เช่น Tusi ของ Tencent, Miada ของ Baidu, Qoder ของ Alibaba และ Trae ของ ByteDance รายงานการติดตามอุตสาหกรรมล่าสุดระบุว่ามีการส่งแอปใหม่เพิ่มขึ้น ซึ่งตอกย้ำว่าการเขียนโปรแกรมด้วย AI กำลังลดกำแพงการเข้าถึงเทคโนโลยี แทนที่จะแสดงแค่ภาพร่างตัวอย่าง ระบบนี้ยังคอมไพล์ซอฟต์แวร์ iOS และ WeChat mini-programs ที่ทำงานได้จริง นอกจากนี้ยังสร้าง QR code สำหรับอุปกรณ์จริงเพื่อให้สามารถเรียกใช้งานและทดสอบใน WeChat ได้ทันที ช่วยให้ผู้สร้างที่ไม่มีพื้นฐานด้านเทคนิคสามารถเรียกใช้และปรับแต่งโปรเจกต์ได้แบบเรียลไทม์
การเลิกใช้ขั้นตอนการพัฒนาแบบดั้งเดิมมีแนวโน้มที่จะเกิดขึ้นในขณะที่ระบบ zero-code เหล่านี้ได้รับความนิยม การผสานรวมเครื่องมือเขียนโค้ดผ่านบทสนทนาเข้ากับระบบ SaaS แสดงให้เห็นว่าองค์กรเทคโนโลยีขนาดใหญ่กำลังให้ความสำคัญกับเวิร์กโฟลว์อัตโนมัติมากกว่าการดูแลซอฟต์แวร์แบบเดิม ดังนั้น เมื่อ Amap เปิดตัว ‘damax’ สำหรับการทดสอบภายใน จึงถือเป็นการจุดชนวนการเปลี่ยนผ่านสู่โปรโตคอลการแลกเปลี่ยนข้อมูลแบบเนทีฟ งานวิจัยในอุตสาหกรรมชี้ให้เห็นว่าเวิร์กโฟลว์ที่ได้รับความช่วยเหลือจาก AI สามารถสร้างการกำหนดค่าหน้าจอที่ซับซ้อนจากคำสั่งง่ายๆ ซึ่งพิสูจน์ได้ว่าการสร้างเลย์เอาต์ภาพด้วยตนเองกำลังกลายเป็นอุปสรรคสำคัญในการพัฒนาซอฟต์แวร์องค์กรสมัยใหม่
ผู้ให้บริการ SaaS กำลังปรับตัวอย่างรวดเร็วเพื่อไม่ให้ล้าสมัย ทีมซอฟต์แวร์กำลังสำรวจโครงสร้างพื้นฐานอีเมลแบบ agentic เพื่อรองรับเวิร์กโฟลว์การจัดการกล่องข้อความแบบโปรแกรมมิ่ง เพื่อขยายแนวโน้มอัตโนมัตินี้ ชุดซอฟต์แวร์เพิ่มประสิทธิภาพการทำงานชั้นนำได้เข้าซื้อเทคโนโลยีสร้าง AI agent เพื่อทำงานข้ามระบบที่ซับซ้อน ในขณะเดียวกัน แพลตฟอร์มแชทสำหรับองค์กรก็ได้นำความสามารถของ AI เข้ามาใช้ในระบบของตน การรวมตัวในอุตสาหกรรมนี้บ่งชี้ถึงทิศทางที่การผสานรวมหลังบ้าน (Backend integration) จะมีความสำคัญมากกว่าซอฟต์แวร์เดสก์ท็อปแบบเดี่ยว
การแยกโปรโตคอล: วิธีที่ Headless Scrapers รบกวนระบบ Attribution
เกตเวย์อีเมลขององค์กรและผู้ช่วย AI หลายแห่งจะตรวจสอบลิงก์ที่ได้รับโดยอัตโนมัติก่อนที่ผู้ใช้จะคลิก ในมุมมองของระบบ Attribution สิ่งนี้เปลี่ยนแปลงห่วงโซ่การร้องขอทั้งหมด
เมื่อผู้ใช้ทั่วไปคลิกลิงก์ เว็บเบราว์เซอร์มาตรฐานจะโหลดหน้าเพจ ดำเนินการสคริปต์การติดตาม และเขียนคุกกี้ ในทางกลับกัน AI agent จะดึงหน้าเพจผ่านโปรแกรม ซึ่งส่งคำขอ HTTP แบบ headless โดยตรงจากเซิร์ฟเวอร์ระบบคลาวด์ เนื่องจากคำขอดังกล่าวทำงานภายในแซนด์บ็อกซ์ที่ไม่มีสถานะ จึงไม่มี DOM ไม่มีประวัติเบราว์เซอร์ และไม่มีคุกกี้ การทำงานแบบ headless มักจะแยกเซสชันออกจากระบบฝั่งไคลเอ็นต์ วิธีการ Attribution แบบดั้งเดิมที่อาศัยเบราว์เซอร์อาจไม่สามารถจับเส้นทางของผู้ใช้ได้ครบถ้วนเนื่องจากต้องพึ่งพาคุกกี้ในการเชื่อมโยงการคลิกครั้งแรกกับการติดตั้ง ภายใต้สภาวะนี้ ความแม่นยำในการระบุแหล่งที่มาจึงลดลงอย่างมาก
เส้นทางของผู้ใช้ทั่วไป (Traditional Human Flow):
อีเมล -> คลิกผ่านเบราว์เซอร์ -> เซสชันเบราว์เซอร์ (คุกกี้, DOM) -> App Store -> ติดตั้งแอป (บันทึกสำเร็จ)


เส้นทางแบบ Headless (Agent-Managed Flow):
อีเมล -> การสแกนอัตโนมัติ -> คำขอ HTTP แบบ Headless (ไม่มี UI, ไม่มี DOM, ไม่มีคุกกี้) -> เยี่ยมชมลิงก์
ติดตั้งแอป (ในภายหลัง) -> เปิดแอป -> สถานะไคลเอ็นต์ว่างเปล่า (ข้อมูล Attribution สูญหาย)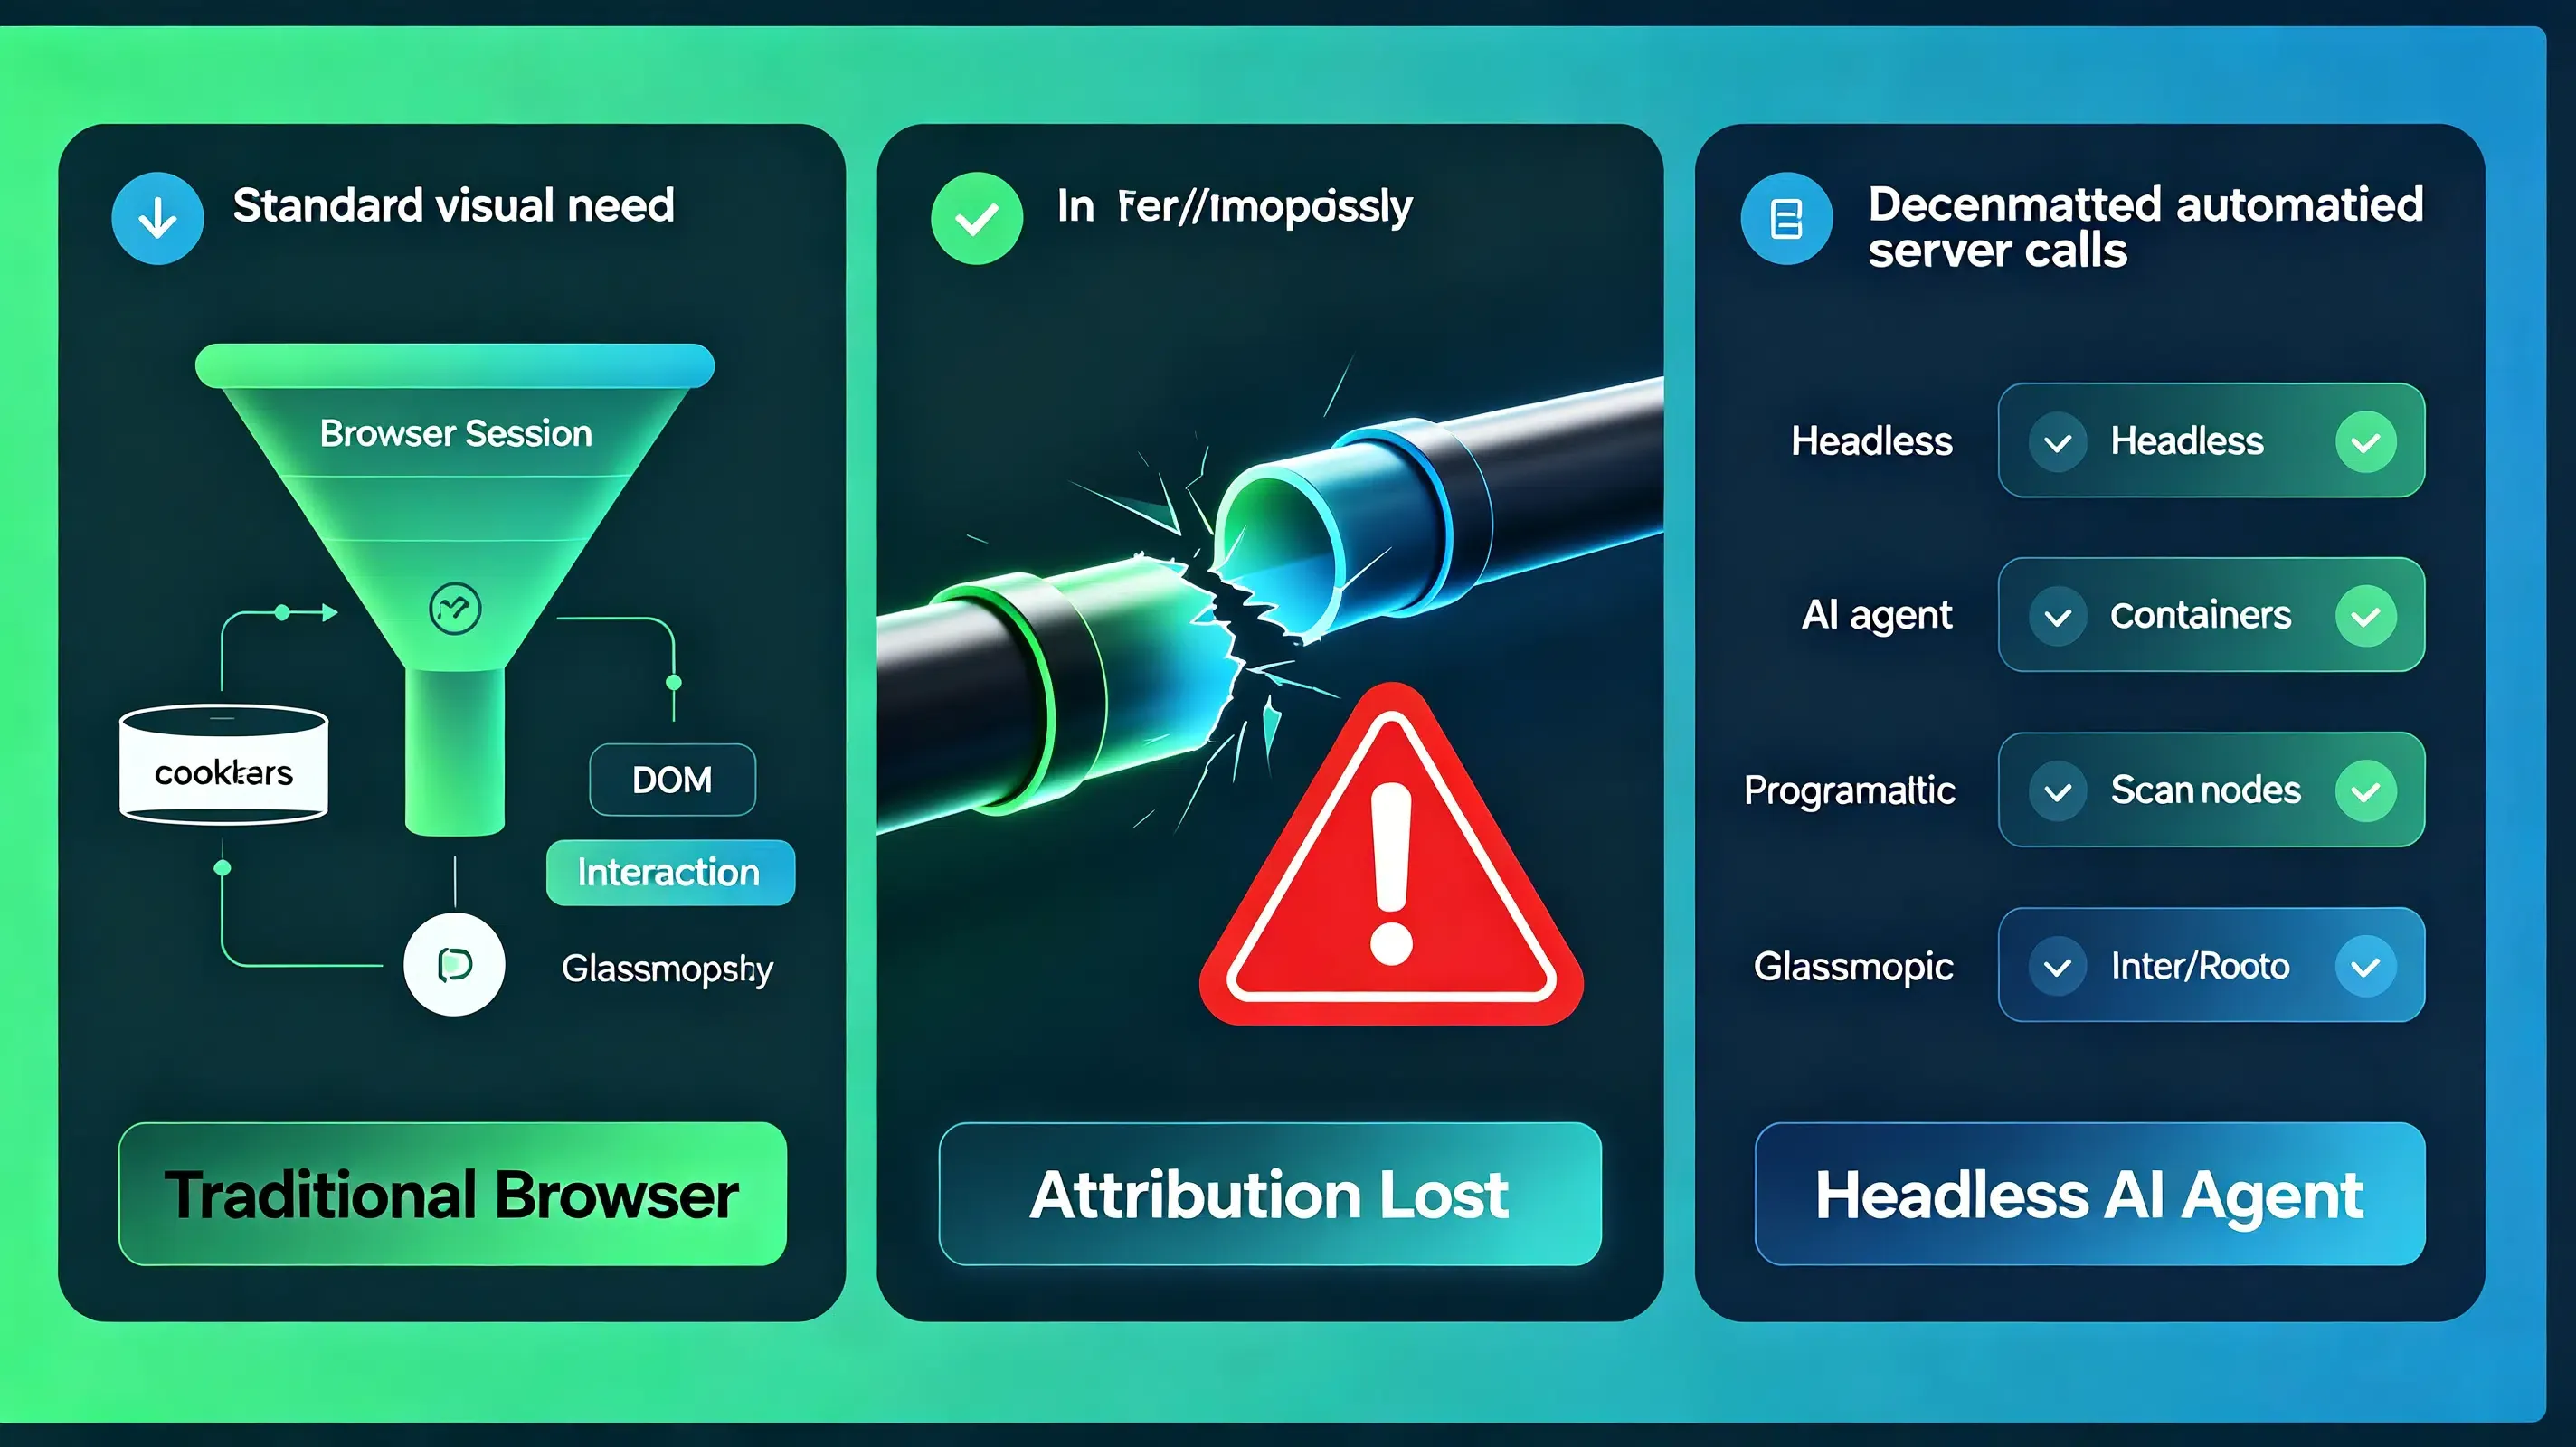
ในการใช้งานจริง นักพัฒนามักพบว่าปริมาณการเข้าชมจำนวนมากถูกประมวลผลโดยสคริปต์อัตโนมัติ การตรวจสอบการโต้ตอบเหล่านี้เผยให้เห็นว่าเกตเวย์ความปลอดภัยของอีเมลหรือตัวสแกนอัตโนมัติอาจเข้าถึงลิงก์ก่อนที่ผู้ใช้จริงจะเข้ามา ซึ่งพฤติกรรมนี้อาจรบกวนระบบ Attribution แบบเบราว์เซอร์หากระบบสันนิษฐานว่าทุกคำขอมาจากผู้ใช้จริง ส่งผลให้ในบางกรณี บริบทการอ้างอิงเดิม (Referral context) อาจไม่สามารถส่งต่อไปยังแอปพลิเคชันปลายทางได้ ทำให้เกิดช่องว่างในการวัดผลอย่างมีนัยสำคัญ
โซลูชันทางสถาปัตยกรรม: สร้างเองหรือซื้อโซลูชันสำหรับการกู้คืนสถานะ
ในทางปฏิบัติ ทีมวิศวกรเลือกระหว่างการสร้างระบบ Attribution ภายในหรือการใช้ SDK ที่มีอยู่ การสร้างระบบเองต้องใช้ทรัพยากรวิศวกรรมมหาศาล ทีมต้องสร้างฐานข้อมูลฝั่งเซิร์ฟเวอร์ จัดการไลบรารีจับคู่สถานะอุปกรณ์ และอัปเดตตรรกะเพื่อให้สอดคล้องกับมาตรฐานความปลอดภัยของ OS อย่างต่อเนื่อง สำหรับหลายองค์กร ค่าใช้จ่ายในการดูแลระบบติดตามเองนั้นสูงเกินไป
อีกทางเลือกหนึ่ง นักพัฒนามักประเมินแนวทางในการคงสถานะเซสชันโดยไม่ต้องใช้คุกกี้ฝั่งไคลเอ็นต์:
- ระบบภายในองค์กร: สร้างฐานข้อมูลจับคู่สถานะบนโครงสร้างพื้นฐานคลาวด์ภายใน
- เครื่องมือเฉพาะแพลตฟอร์ม: พึ่งพายูทิลิตี้พื้นฐาน เช่น Firebase Dynamic Links (หรือทางเลือกอื่นของแพลตฟอร์ม)
- Enterprise MMPs: ใช้งาน Mobile Measurement Partners เช่น Branch, AppsFlyer หรือ Adjust สำหรับเวิร์กโฟลว์ deep-linking
- SDK เฉพาะทาง: ใช้งานยูทิลิตี้การผสานรวมที่ออกแบบมาเพื่อการส่งผ่านพารามิเตอร์แบบปรับแต่งที่แม่นยำและคุ้มค่า
ตารางเปรียบเทียบสถานะและเส้นทาง Attribution
| เส้นทางการโต้ตอบ | คุกกี้ฝั่งไคลเอ็นต์ | ความเข้ากันได้กับ Headless | ความสมบูรณ์ของ Attribution |
|---|---|---|---|
| การเข้าชมผ่านเบราว์เซอร์ปกติ | ✅ มี | ❌ ไม่มี | สูง (เซสชันฝั่งไคลเอ็นต์) |
| การตรวจสอบผ่าน AI Agent | ❌ ไม่มี | ✅ มี | ต่ำ (สูญเสียข้อมูลบริบท) |
| การล็อกสถานะฝั่งเซิร์ฟเวอร์ | ❌ ไม่มี | ✅ มี | สูง (ดึงข้อมูลแบบอะซิงโครนัส) |
สร้างลิงก์ -> ลงทะเบียนข้อมูล Metadata ไว้ที่เซิร์ฟเวอร์สถานะส่วนกลาง
                                     |
สแกนเนอร์/ผู้ใช้คลิก URL -> ลงทะเบียนการล็อกสถานะชั่วคราวฝั่งเซิร์ฟเวอร์
                                     |
เปิดแอปบนอุปกรณ์ -> SDK ดึงบริบทจากเซิร์ฟเวอร์ -> จับคู่สถานะและกู้คืนพารามิเตอร์
โซลูชันเชิงพาณิชย์ของสถาปัตยกรรมนี้รวมถึง Branch, AppsFlyer, Adjust, Opoinstall และแพลตฟอร์ม Attribution อื่นๆ ระบบเหล่านี้จะคงสถานะไว้ที่ฝั่งเซิร์ฟเวอร์ก่อนการติดตั้ง และกู้คืนพารามิเตอร์เมื่อแอปเปิดขึ้นครั้งแรก ซึ่งข้ามปัญหาความไม่น่าเชื่อถือที่เกี่ยวข้องกับเซสชันเบราว์เซอร์ฝั่งไคลเอ็นต์ไปได้เลย SDK ของ Opoinstall ทำหน้าที่จับคู่พารามิเตอร์การอ้างอิงกับฐานข้อมูลกู้คืนสถานะแบบรวมศูนย์อย่างปลอดภัย ทำให้มั่นใจได้ว่าบริบทการอ้างอิงจะยังคงอยู่แม้การโต้ตอบครั้งแรกจะเกิดขึ้นผ่านธุรกรรมแบบ headless และในขณะที่ Amap เปิดตัว ‘damax’ นักพัฒนาก็ต่างประเมินสถาปัตยกรรมเหล่านี้เพื่อปกป้องท่อส่งข้อมูล Attribution ของตน
การปรับตัวของทีมปฏิบัติการและรายการตรวจสอบการผสานรวม
ทีมวิศวกรรมหลังบ้านต้องเผชิญกับภารกิจเร่งด่วนในการตรวจสอบการเชื่อมต่อฐานข้อมูลทั้งหมดก่อนเปิดตัวแอปที่คอมไพล์โดยอัตโนมัติ ผู้จัดการผลิตภัณฑ์ควรออกแบบขั้นตอนการเชิญและการลงทะเบียนใหม่เพื่อรองรับเส้นทางผู้ใช้ที่ไม่เป็นภาพ แทนที่จะคาดหวังให้ผู้ใช้คลิกปุ่มในอีเมล ทีมผลิตภัณฑ์ควรออกแบบเวิร์กโฟลว์ที่รองรับทริกเกอร์แบบอัตโนมัติ ทีม Growth ต้องอัปเดตตัวชี้วัดประสิทธิภาพ เมื่อซอฟต์แวร์อัตโนมัติเข้ามาดูแลการคัดกรอง อัตราการเปิด (Open rates) และอัตราการคลิก (Click-through rates) อาจเชื่อถือได้น้อยลง ทีมการตลาดควรเน้นไปที่ข้อมูลการใช้งานในแอป (In-app telemetry) และเหตุการณ์การเปลี่ยนผ่านที่ตรวจสอบได้ เพื่อเพิ่มประสิทธิภาพแคมเปญตามการกระทำที่เกิดขึ้นจริงในแอปพลิเคชัน
รายการตรวจสอบการผสานรวมแอปพลิเคชัน Generative
เพื่อให้แน่ใจว่าข้อมูลมีความต่อเนื่องและเชื่อถือได้ก่อนเปิดตัวแอปพลิเคชันที่สร้างใหม่ ทีมวิศวกรรมควรดำเนินการตามขั้นตอนต่อไปนี้:
- ตรวจสอบเส้นทางบริบท: ตรวจสอบว่า AI คอมไพล์พารามิเตอร์ URL ที่กำหนดเองอย่างไรเพื่อให้แน่ใจว่า deep-link จะทำงานได้
- การรักษาบริบทแบบ Headless: จับคู่ HTTP headers อื่นๆ เพื่อบันทึกพารามิเตอร์การอ้างอิงระหว่างการสแกน QR code และการใช้งาน mini-program
- การทดสอบ Telemetry Sandbox: ตรวจสอบให้แน่ใจว่าการรายงานข้อมูลในท้องถิ่นไม่กระตุ้นการเตือนการฉ้อโกงในสภาพแวดล้อม Sandbox
- การตรวจสอบการกำหนดเส้นทางข้ามแพลตฟอร์ม: ปรับ Universal Links ให้เข้ากับสคีมาของ WeChat mini-program เพื่อป้องกันปัญหาติดขัดของผู้ใช้ระหว่างการใช้งานข้ามหน้าจอ
ในการโยกย้ายระบบตามปกติ นักพัฒนามักพบว่าปริมาณการเข้าชมบางส่วนถูกประมวลผลโดยสคริปต์อัตโนมัติ การตรวจสอบพบว่าบริบทการอ้างอิงมักจะถูกลบออก ซึ่งยืนยันว่าเฟรมเวิร์กการติดตามแบบดั้งเดิมมีความน่าเชื่อถือน้อยลงในการตั้งค่าระบบอัตโนมัติ
คำถามที่พบบ่อย (FAQ)
'damax' ของ Amap มีผลต่อ App Store ที่มีอยู่หรือไม่?
แอปอัตโนมัติอยู่รอดได้อย่างไรหากไม่มีสภาพแวดล้อมนักพัฒนาในเครื่อง?
ระบบ Attribution ของการอ้างอิงจะอยู่รอดได้อย่างไรเมื่อแอปใหม่ถูกสร้างผ่านโปรแกรม?
การเลิกใช้ขั้นตอนการพัฒนาแอปพลิเคชันแบบดั้งเดิมที่เน้นภาพเป็นหลัก เน้นย้ำถึงการเปลี่ยนแปลงพื้นฐานไปสู่โปรโตคอลการสื่อสารที่ขับเคลื่อนด้วยหลังบ้านและเวิร์กโฟลว์ที่ได้รับความช่วยเหลือจาก AI ในขณะที่แอปพลิเคชันสื่อสารผ่านการแลกเปลี่ยนข้อมูลอัตโนมัติมากขึ้น ทีมวิศวกรรมจำเป็นต้องประเมินกลยุทธ์การผสานรวมใหม่ แพลตฟอร์มที่ต้องพึ่งพาการกระทำของผู้ใช้ด้วยตนเองอาจเผชิญกับช่องว่างเชิงโครงสร้างเมื่อตัวแทนอัตโนมัติเข้ามาจัดการท่อส่งคำขอ การเปลี่ยนไปสู่การวัดผลฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ที่ปลอดภัยถือเป็นทิศทางที่จำเป็นสำหรับการรักษาความแม่นยำและความปลอดภัยในการติดตามผล
การเปลี่ยนผ่านนี้บ่งชี้ถึงการเขียนเฟรมเวิร์กการวัดผลและโปรโตคอลความปลอดภัยใหม่ ระบบ Attribution ในอนาคตน่าจะพึ่งพาการจับคู่ข้อมูลประจำตัวฝั่งเซิร์ฟเวอร์และการซิงค์สถานะที่ปลอดภัยมากขึ้น ในขณะที่ AI agent เริ่มทำหน้าที่เป็นผู้ใช้งานหลักในการสื่อสารดิจิทัล สถาปัตยกรรมการระบุแหล่งที่มาจะขึ้นอยู่กับการระบุตัวตนฝั่งเซิร์ฟเวอร์ การกู้คืนสถานะ และการรักษาบริบทในระดับโปรโตคอลมากกว่าแค่การพึ่งพาเซสชันเบราว์เซอร์เพียงอย่างเดียว
Share this article



