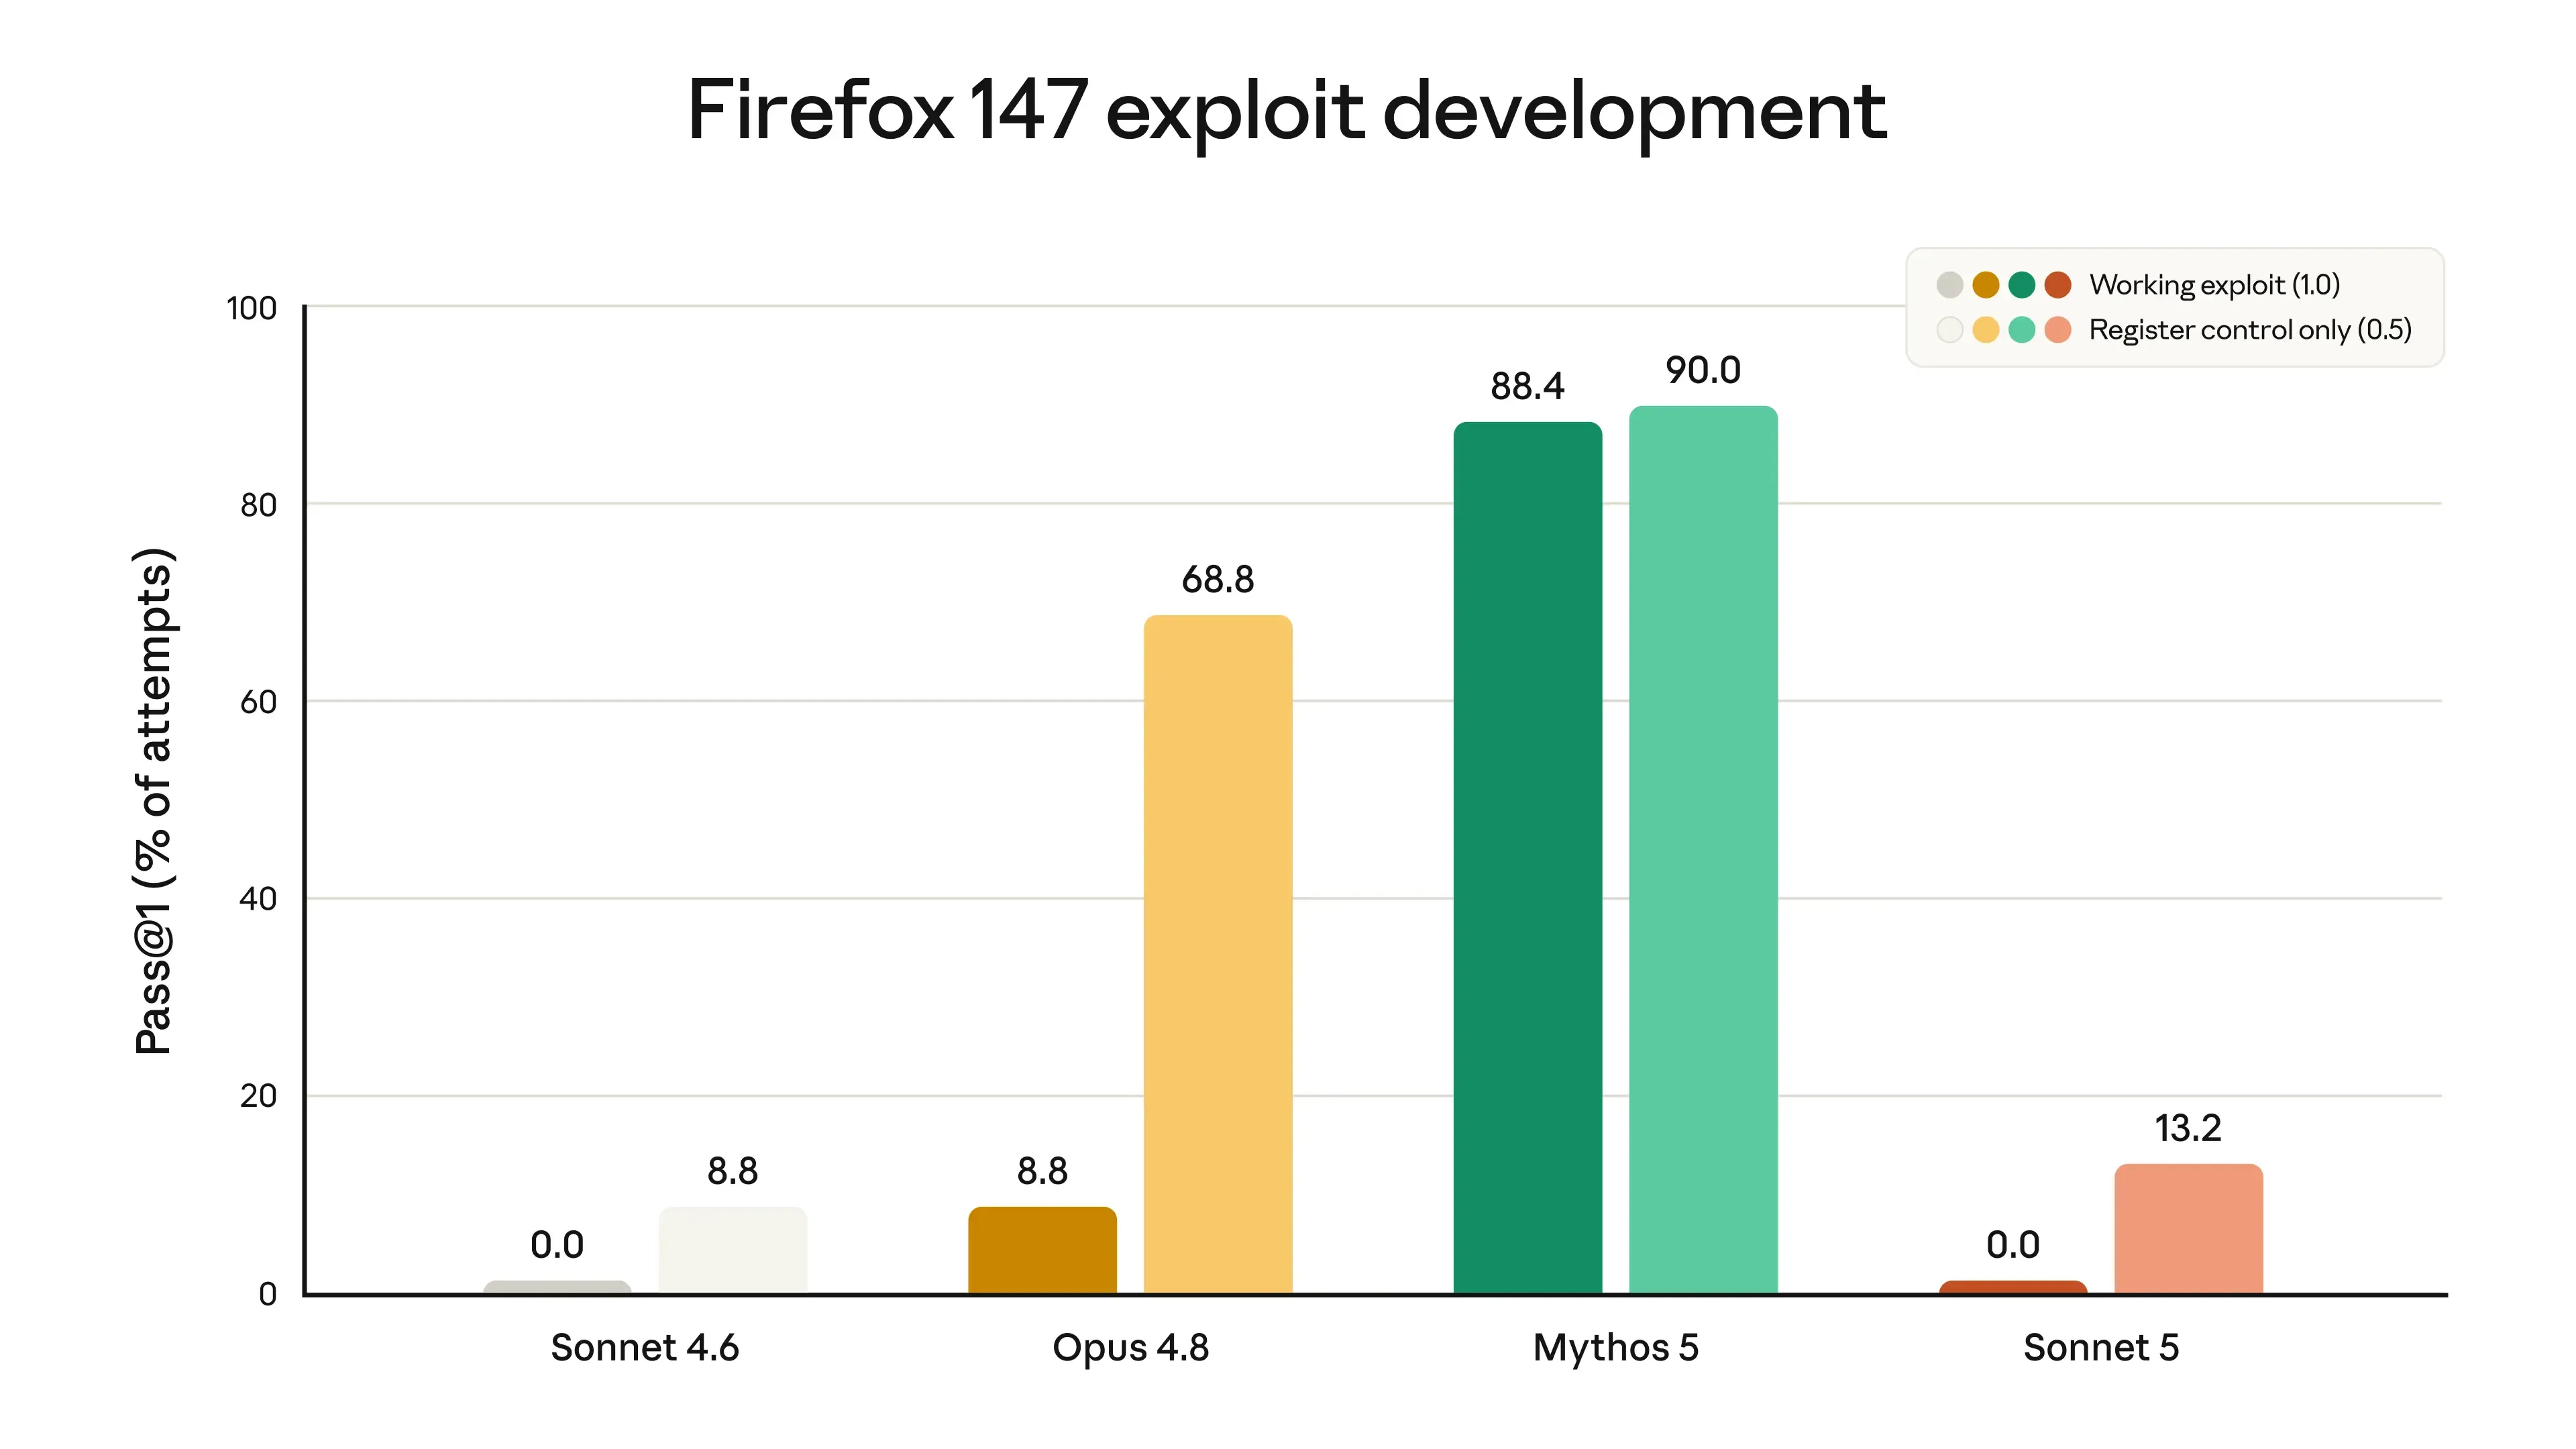
Anthropic เปิดตัว 'Sonnet 5'? Anthropic ได้ปล่อย Claude Sonnet 5 ออกมาเมื่อวันที่ 30 มิถุนายน โดยเข้ามาแทนที่ Claude Sonnet 4.6 ในทุกแพ็กเกจ ตามรายละเอียดที่ระบุไว้ใน ประกาศอย่างเป็นทางการของ Anthropic แม้ราคาตามรายการที่เผยแพร่จะถูกลง แต่ต้นทุนการใช้งานจริงขึ้นอยู่กับลักษณะของปริมาณงาน อัตราการเข้าถึงแคช (Cache Hit Rates) และรูปแบบข้อมูลขาเข้าเป็นสำคัญ เนื่องจากการเพิ่มขึ้นของโทเค็น (Token Inflation) จาก Tokenizer ที่อัปเดตใหม่ ค่าใช้จ่าย API ในการใช้งานจริงสำหรับชุดโค้ดที่มีโครงสร้างซับซ้อนจึงอาจสูงขึ้นอย่างมีนัยสำคัญ ส่งผลให้โมเดลใหม่นี้ไม่ได้ถูกกว่า Claude Opus 4.8 ในสถานการณ์การใช้งานจริงหลายรูปแบบ การเปิดตัวครั้งนี้ตอกย้ำถึงการเปลี่ยนแปลงที่กว้างขึ้นในการพัฒนาองค์กร AI: การประเมินโมเดลในปัจจุบันไม่ได้ดูเพียงแค่ประสิทธิภาพตามเกณฑ์มาตรฐาน (Benchmark) เท่านั้น แต่ยังต้องคำนึงถึงพฤติกรรมของ Tokenizer ประสิทธิภาพของแคช และต้นทุนรวมในการเป็นเจ้าของ (TCO) อีกด้วย
สรุปภาพรวม
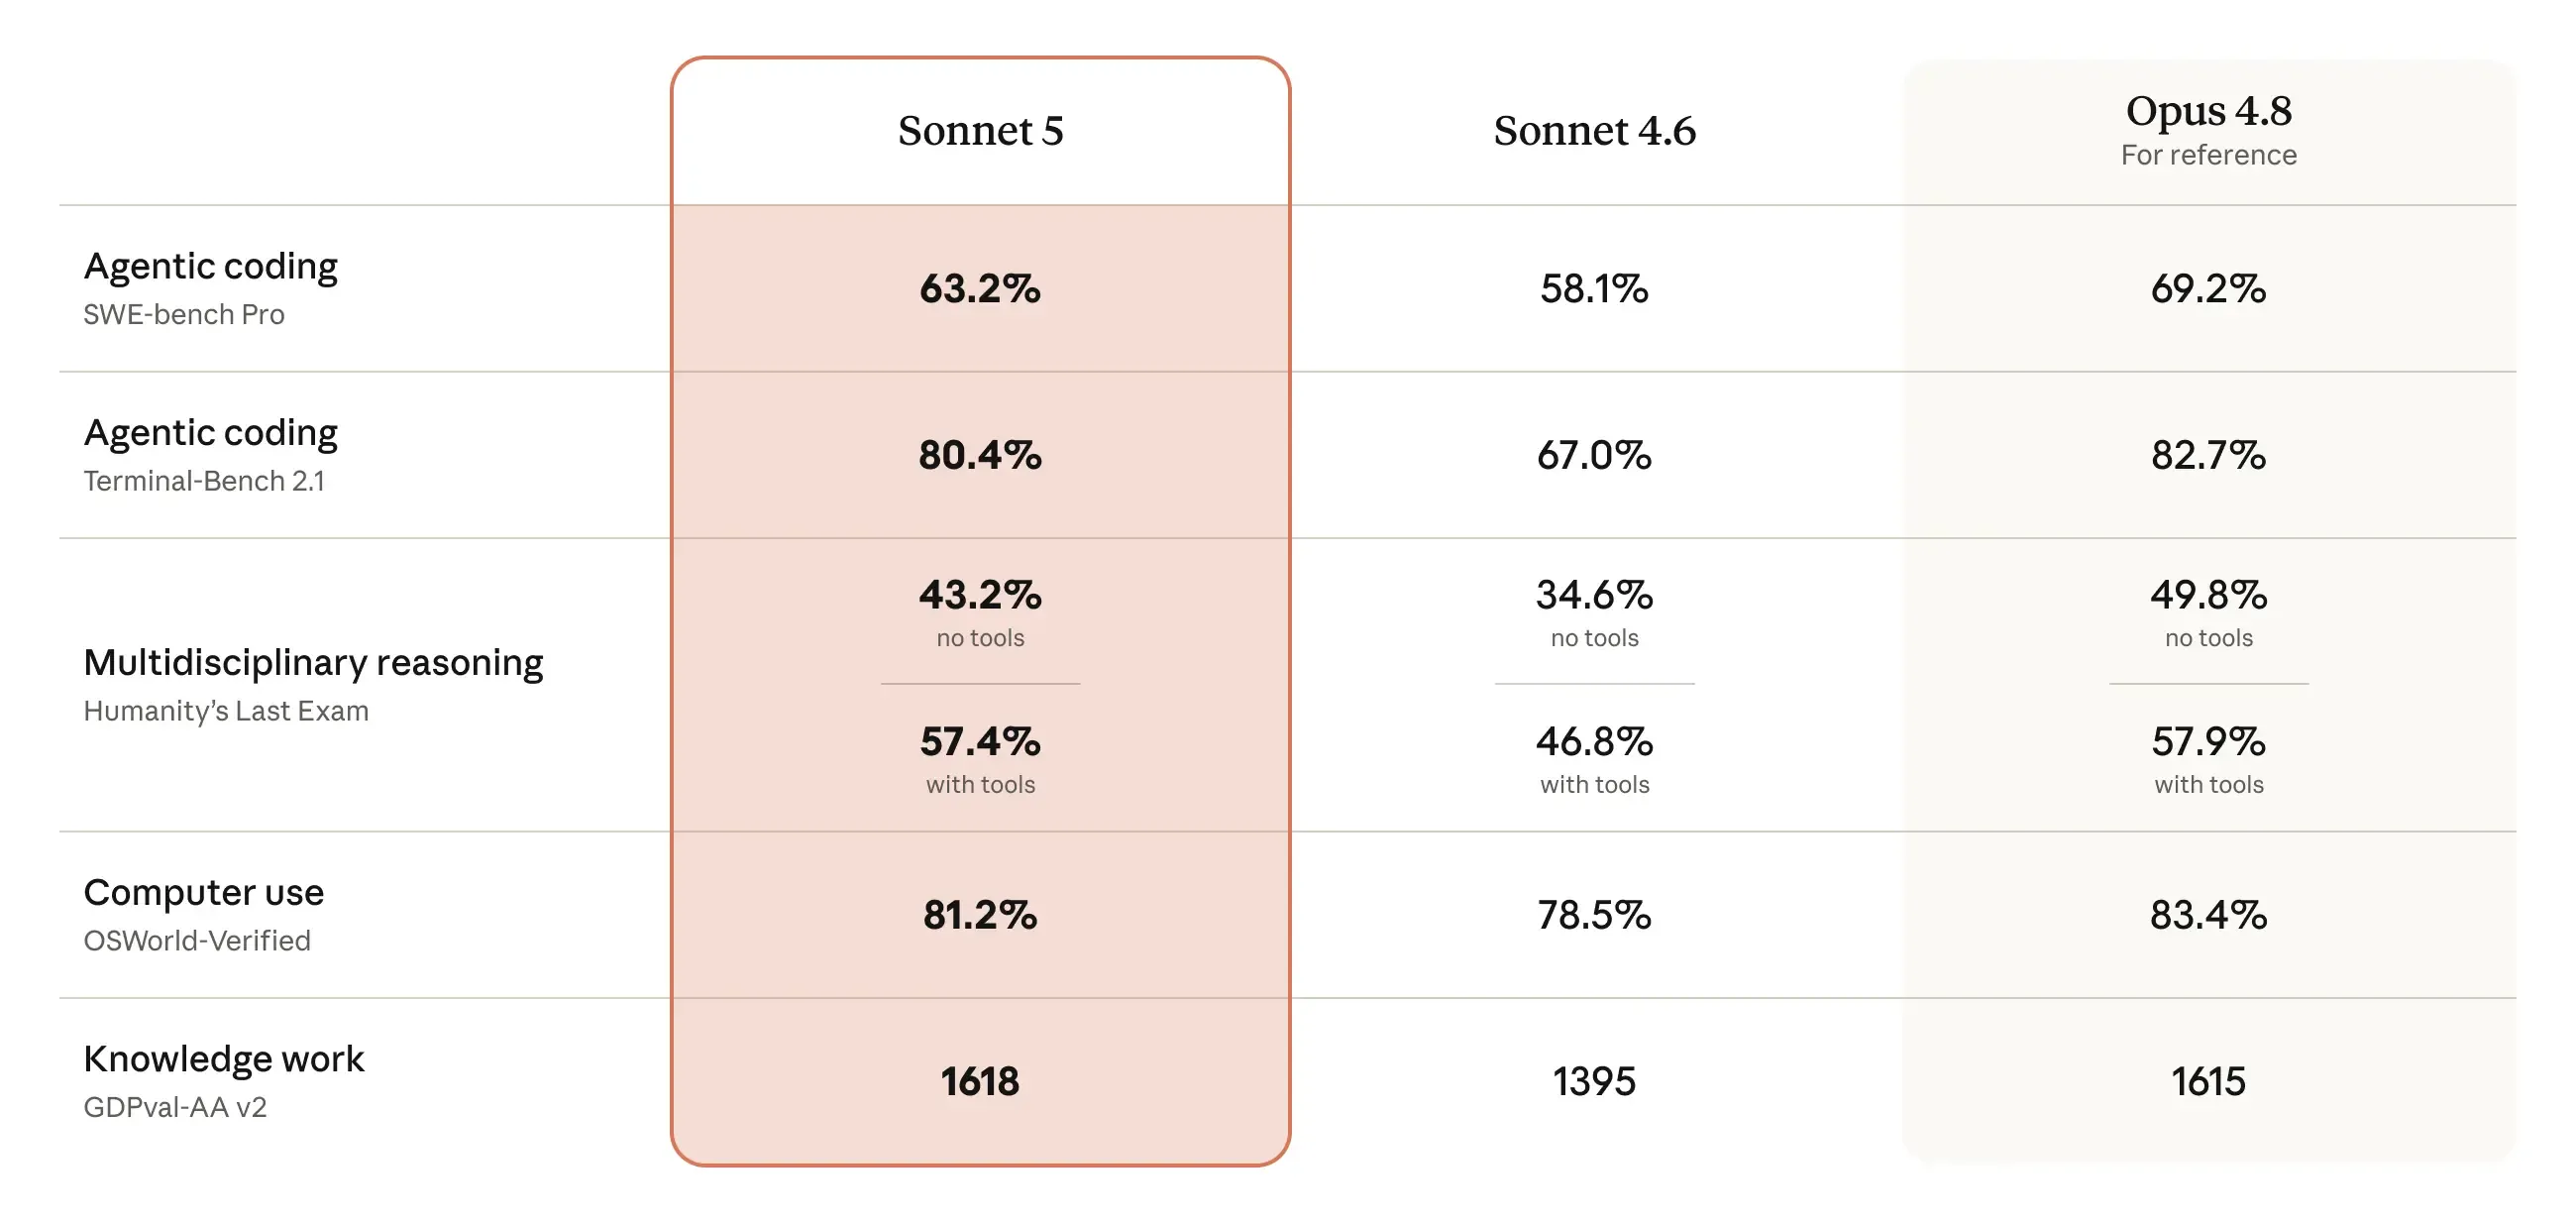
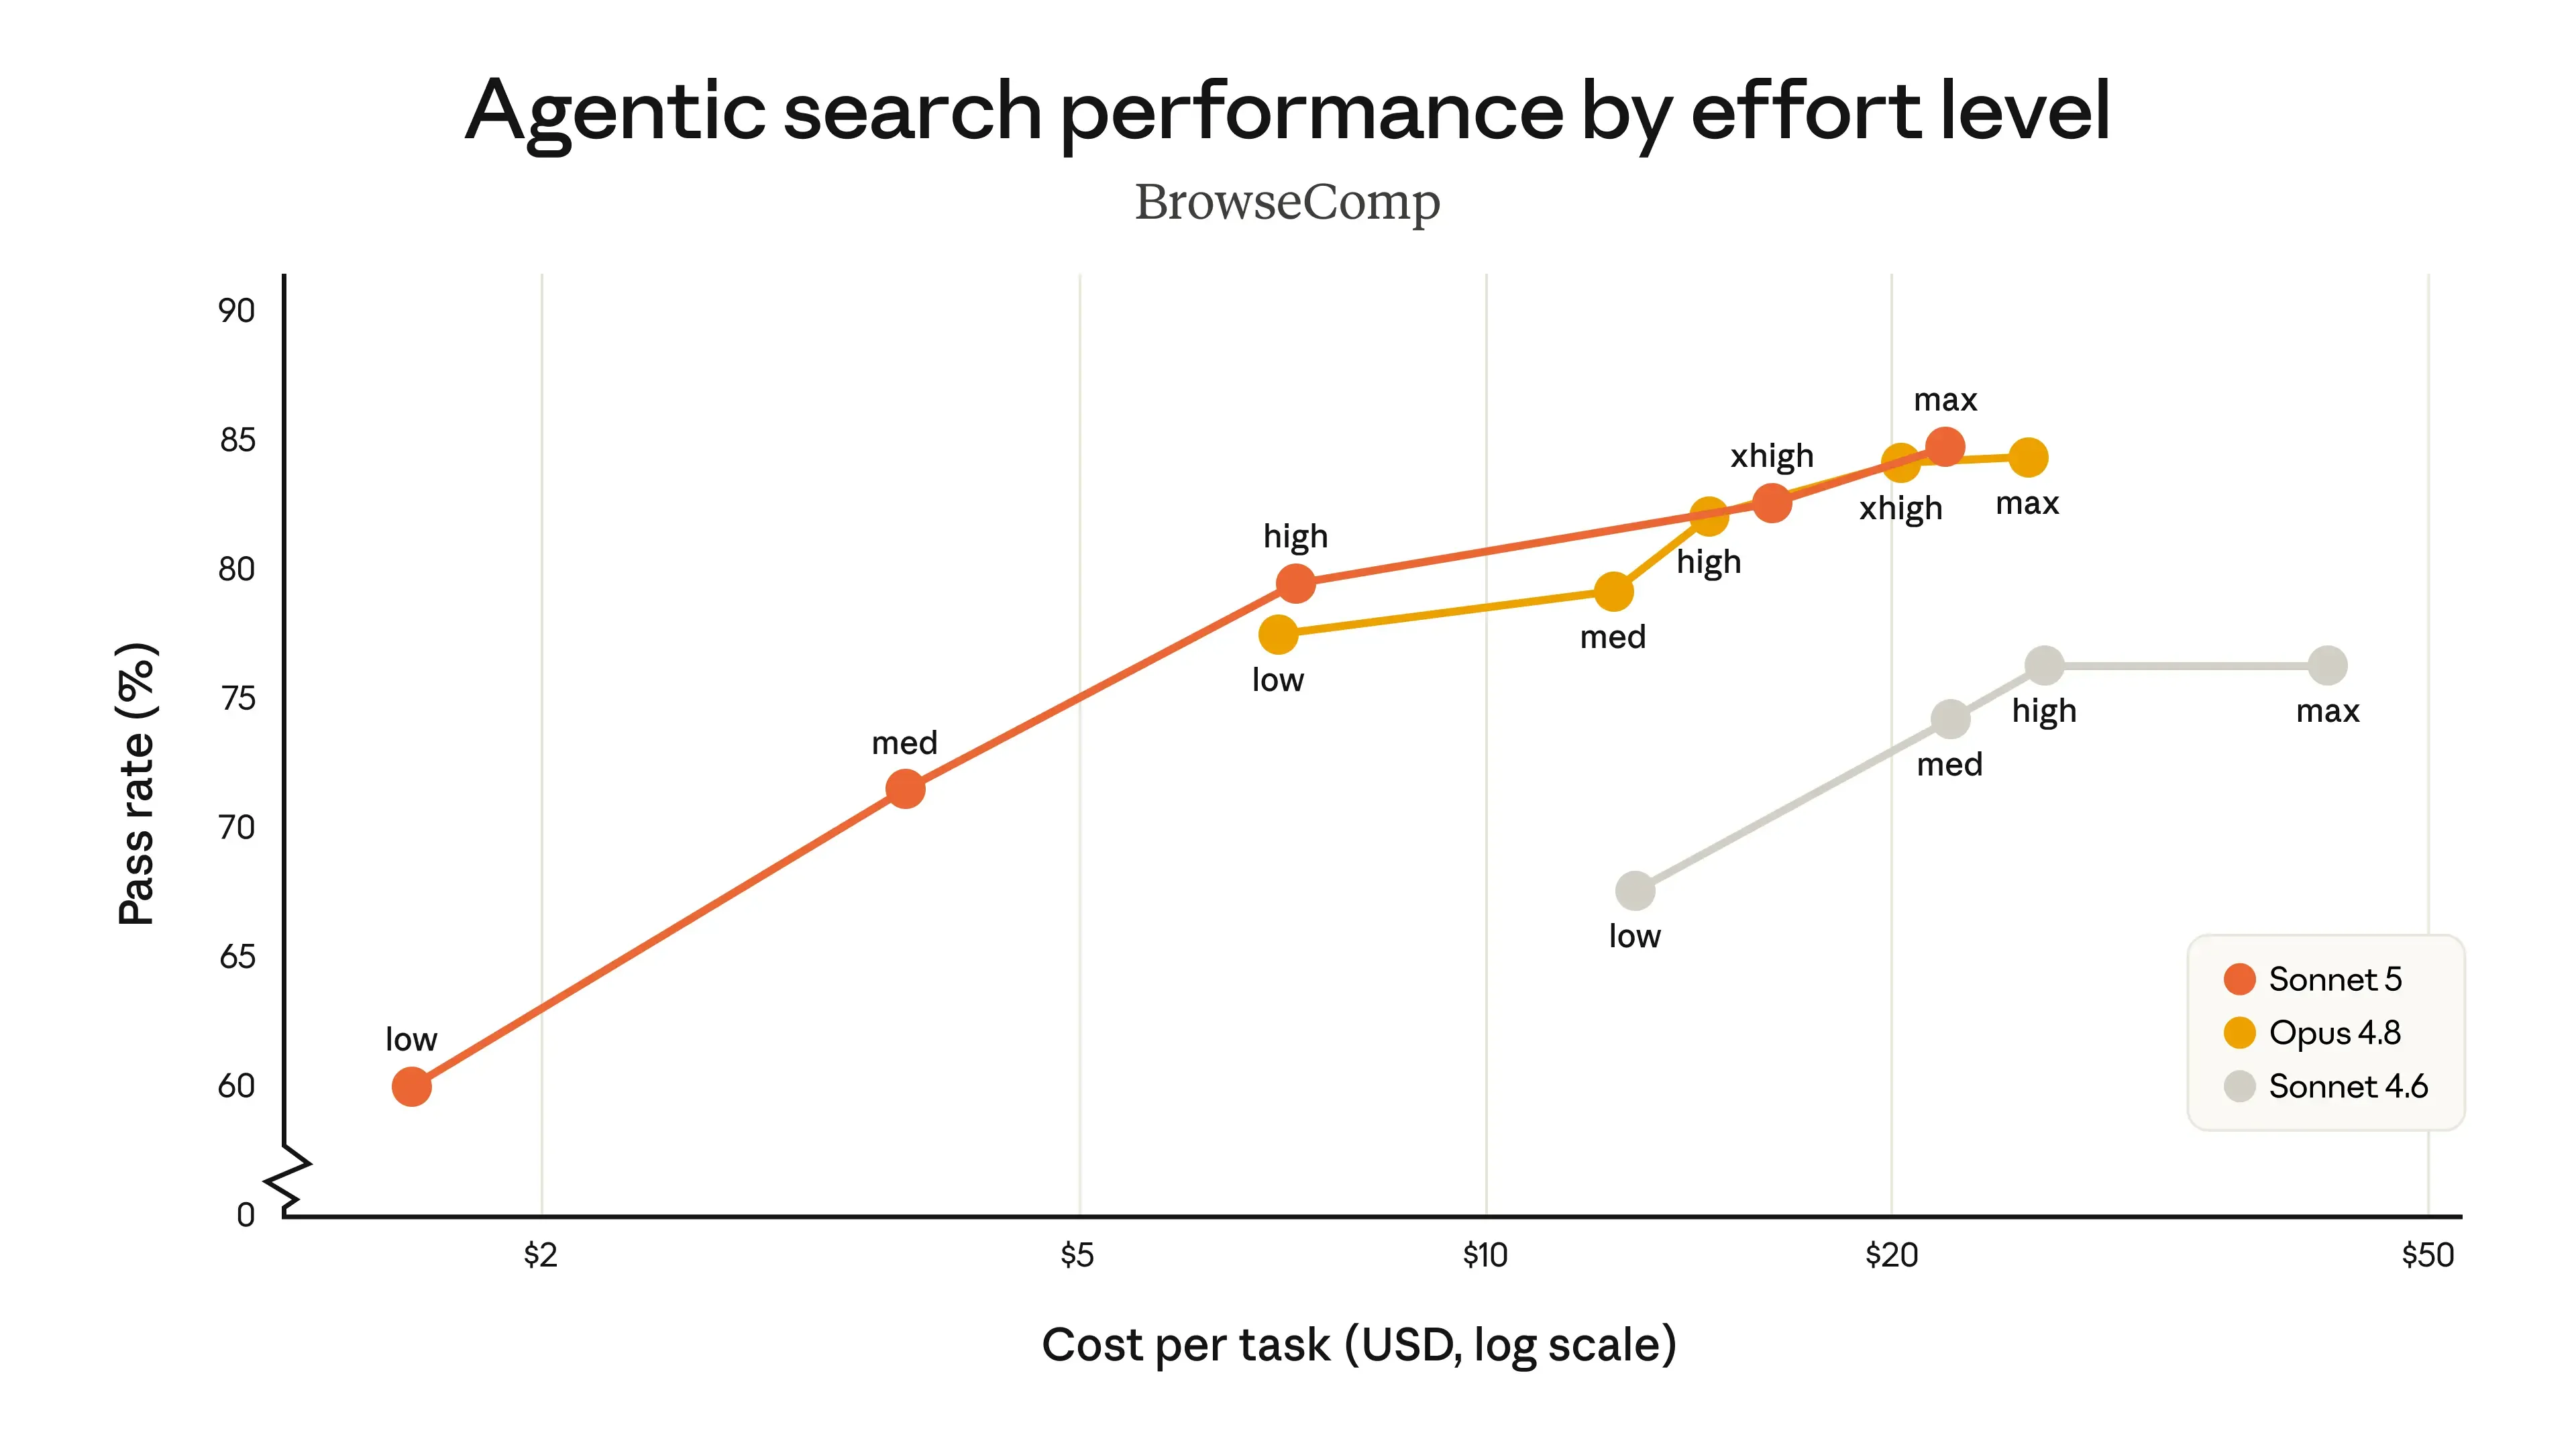
- ประสิทธิภาพใกล้เคียง Opus: Claude Sonnet 5 มอบประสิทธิภาพที่ใกล้เคียงกับ Claude Opus 4.8 แต่การประหยัดค่าใช้จ่าย API จริงอาจไม่มากเท่าที่ราคาตามรายการแนะนำ
- แนวโน้มการเพิ่มขึ้นของโทเค็น: ขึ้นอยู่กับประเภทของเนื้อหา Tokenizer ที่อัปเดตใหม่อาจสร้างจำนวนโทเค็นที่ถูกเรียกเก็บเงินเพิ่มขึ้นประมาณ 1.0 ถึง 1.35 เท่า สำหรับข้อมูลขาเข้าชุดเดียวกัน
- การปรับเปลี่ยนรูปแบบการเรียกเก็บเงิน SaaS: ด้วยภาระการประมวลผลที่มหาศาลจากการทำงานของ Agent อัตโนมัติ ผู้ให้บริการกำลังเปลี่ยนจากการจำกัดการใช้งานแบบเหมาจ่าย (Flat-rate) ไปสู่การเรียกเก็บเงินตามจำนวนโทเค็นที่ใช้งานจริงอย่างเคร่งครัด
ภาวะกลืนไม่เข้าคายไม่ออกด้านราคา: ทำไมราคา API ที่ประกาศถึงสวนทางกับอัตราการเพิ่มขึ้นของโทเค็น
ประกาศราคาเมื่อวันที่ 30 มิถุนายน 2026 ได้แนะนำราคาช่วงโปรโมชันที่ $2 ต่อล้านโทเค็นสำหรับข้อมูลขาเข้า และ $10 ต่อล้านโทเค็นสำหรับข้อมูลขาออกบนแพลตฟอร์ม Claude โดยอัตราส่งเสริมการขายนี้จะคงอยู่จนถึงวันที่ 31 สิงหาคม 2026 หลังจากนั้นจะปรับเป็นราคามาตรฐานที่ $3 ต่อล้านโทเค็นขาเข้า และ $15 ต่อล้านโทเค็นขาออก แม้ว่าราคาเหล่านี้จะดูต่ำกว่าอัตราของ Claude Opus 4.8 ที่ $5 สำหรับขาเข้าและ $25 สำหรับขาออก แต่ต้นทุนโครงการจริงมีความผันแปร โดย Tokenizer ที่ใช้ใน Claude Sonnet 5 ได้แปลงชุดอักขระข้อความเดียวกันเป็นจำนวนโทเค็นที่มากกว่ารุ่นก่อนหน้า 1.0 ถึง 1.35 เท่า ด้วยการปรับเปลี่ยนเชิงโครงสร้างนี้ กลไกการกำหนดราคามาตรฐานจึงเป็นการปรับเปลี่ยนในลักษณะที่ไม่มีการลดต้นทุน (Cost-neutral) มากกว่าจะเป็นการลดราคาโดยตรง
เพื่อให้เข้าใจว่าอัตราการเพิ่มของโทเค็นนี้ส่งผลกระทบต่องบประมาณองค์กรอย่างไร ลองพิจารณาสถานการณ์ต้นทุนในการประมวลผลโทเค็นขาเข้าดิบ 1 ล้านโทเค็น สมมติว่าชุดโค้ดเดียวกันถูกวัดได้ 1,000,000 โทเค็นภายใต้ Tokenizer ของ Claude Sonnet 4.6 และสำหรับ Claude Sonnet 5 หากอ้างอิงตัวคูณที่ 1.35 เท่า ตามที่ Anthropic ระบุ ชุดโค้ดเดียวกันนั้นอาจถูกตีค่าเป็นประมาณ 1,350,000 โทเค็น ที่อัตราโปรโมชัน $2.00 ต่อล้าน ต้นทุนจะเป็น $2.70 ซึ่งเป็นการประหยัดเพียง 10% อย่างไรก็ตาม เมื่อราคามาตรฐาน $3.00 ต่อล้านเริ่มมีผล ชุดโค้ดเดียวกันจะมีต้นทุนถึง $4.05 ซึ่งถือเป็นการเพิ่มขึ้นของต้นทุน 35% เมื่อเทียบกับโมเดลรุ่นก่อนหน้า และประหยัดไปเพียง 19% เมื่อเทียบกับ Claude Opus 4.8 แทนที่จะเป็นส่วนลด 40% ตามที่คาดหวัง
สถานการณ์ตัวอย่างด้านต้นทุน (ภาระงาน 1 ล้านโทเค็น)
| สถานการณ์การใช้งาน | ตัวคูณโทเค็น (ตัวอย่าง) | อัตราต่อล้านโทเค็นขาเข้า | ต้นทุนรวมต่อ 1 ล้านโทเค็นขาเข้า |
|---|---|---|---|
| Claude Sonnet 4.6 | 1.00x (อ้างอิง) | $3.00 (มาตรฐาน) | $3.00 |
| Claude Sonnet 5 (โปรโมชัน) | สูงสุด 1.35x | $2.00 (เปิดตัว) | $2.70 |
| Claude Sonnet 5 (มาตรฐาน) | สูงสุด 1.35x | $3.00 (มาตรฐาน) | $4.05 |
| Claude Sonnet 5 (+ แคช 90%) | 0.135x (แคชสำเร็จ 90%) | $3.00 (มาตรฐาน) | $0.77 |
| Claude Opus 4.8 | 1.00x (อ้างอิง) | $5.00 (มาตรฐาน) | $5.00 |
 กลไกเบื้องหลังของ Tokenizer: วิธีที่ KV Cache และความยาว Context เปลี่ยนแปลงการเรียกเก็บเงิน
ตาม Claude Sonnet 5 System Card ระบุว่า Claude Sonnet 5 ใช้ Tokenizer เวอร์ชันอัปเดต Anthropic ตั้งข้อสังเกตว่าข้อมูลขาเข้าชุดเดิมอาจถูกแปลงเป็นจำนวนโทเค็นที่มากกว่าเดิม 1.0 ถึง 1.35 เท่า ขึ้นอยู่กับประเภทของเนื้อหา ทำให้ราคาช่วงเปิดตัวที่ $2 ต่อล้านโทเค็นขาเข้าและ $10 ต่อล้านโทเค็นขาออกมีค่าเท่ากับจุดคุ้มทุน ในทางปฏิบัติ ข้อมูลที่มีโครงสร้าง เช่น ซอร์สโค้ด มาร์กดาวน์ หรือเอกสาร JSON อาจมีความแตกต่างของจำนวนโทเค็นมากกว่าข้อความภาษาธรรมชาติทั่วไป
เหตุผลหนึ่งที่เป็นไปได้คือ โค้ด มาร์กดาวน์ และ JSON มีความหนาแน่นของโครงสร้างไวยากรณ์มากกว่าภาษาทั่วไป Tokenizer ของ LLM รุ่นใหม่มักประมวลผลโครงสร้างเหล่านี้ต่างจากภาษาธรรมชาติ ซึ่งอาจเพิ่มจำนวนโทเค็นที่ต้องชำระเงินโดยรวม ทั้งนี้ Anthropic ไม่ได้เปิดเผยรายละเอียดเชิงลึกของ Tokenizer ใน Claude Sonnet 5 ทำให้กลไกที่แน่ชัดยังคงไม่เปิดเผย
ตัวอย่างประกอบ:

ข้อมูลขาเข้าชุดเดียวกัน
      │
      ├── Claude Sonnet 4.6 → 1,000,000 โทเค็น
      │
      └── Claude Sonnet 5   → สูงสุด 1,350,000 โทเค็น (ขึ้นอยู่กับประเภทเนื้อหา)
สำหรับแอปพลิเคชันที่มี Context ยาวๆ การใช้ Prompt Caching ยังคงเป็นกลไกสำคัญในการลดค่าใช้จ่าย API ระบบช่วยให้ผู้พัฒนามีความยืดหยุ่นในการแคชคำสั่งระบบ คลังข้อมูลอ้างอิงมาตรฐาน และเอกสารคงที่ขนาดใหญ่ ซึ่งช่วยลดต้นทุนขาเข้าได้สูงสุดถึง 90% ขึ้นอยู่กับอัตราการเข้าถึงแคช อย่างไรก็ตาม หากเกิด Cache Miss ในการรันโค้ดแบบไดนามิกหลายไฟล์ อาจส่งผลให้เกิดค่าใช้จ่ายส่วนเกินมหาศาลอย่างรวดเร็ว ในขณะที่หน้าต่าง Context ใช้งานจริงใกล้ถึงขีดจำกัด 1 ล้านโทเค็น การใช้โทเค็นทั้งขาเข้าและขาออกสะสมอาจพุ่งสูงขึ้นโดยไม่ให้ผลลัพธ์โค้ดที่นำไปใช้ได้จริง
การเพิ่มประสิทธิภาพ Token ภายในทีม กับการใช้โครงสร้างงบประมาณสำเร็จรูป
ในทางปฏิบัติ ทีมวิศวกรส่วนใหญ่มักต้องเลือกระหว่างการสร้างเฟรมเวิร์กตรวจสอบต้นทุนภายใน การปรับใช้ API เกตเวย์แบบโฮสต์เอง หรือการเลือกโซลูชัน SDK สำเร็จรูป การสร้างระบบเฉพาะขึ้นมาเองต้องใช้ภาระงานด้านวิศวกรรมมหาศาล ทีมงานต้องสร้างฐานข้อมูลฝั่งเซิร์ฟเวอร์ รักษาไลบรารีสถานะการดำเนินการ และอัปเดตตรรกะอย่างต่อเนื่องเพื่อให้เป็นไปตามมาตรฐานความปลอดภัยของ OS ที่เปลี่ยนแปลงอยู่เสมอ สำหรับหลายองค์กร ต้นทุนในการบำรุงรักษาเครื่องมือติดตามที่สร้างขึ้นเองนั้นสูงเกินไป
อีกทางเลือกหนึ่ง นักพัฒนามักประเมินแนวทางหลายอย่างในการตรวจสอบการดำเนินการรันไทม์โดยไม่พึ่งพาเมตริกของระบบคลาวด์เพียงอย่างเดียว:
- การปรับใช้โมเดลในเครื่อง (Local Models): การรันโมเดลโอเพนซอร์สขนาดเล็กที่มีความเชี่ยวชาญสูงภายในสภาพแวดล้อมที่ปลอดภัยและไม่มีการเชื่อมต่อเครือข่ายภายนอก
- การใช้ไฟร์วอลล์จำกัดพื้นที่อย่างเข้มงวด: การจำกัดคอนเทนเนอร์การพัฒนามิให้สร้างการเชื่อมต่อเครือข่ายขาออก
- แพลตฟอร์ม MMP ระดับองค์กร: การใช้แพลตฟอร์มการวัดผลทางมือถือจากบุคคลที่สามที่แข็งแกร่งสำหรับเวิร์กโฟลว์การทำ deep-linking
- SDK พารามิเตอร์เฉพาะทาง: การติดตั้งยูทิลิตี้การรวมระบบโดยเฉพาะเพื่อให้สามารถส่งผ่านพารามิเตอร์แบบกำหนดเองที่คำนึงถึงต้นทุนได้อย่างแม่นยำ
เปรียบเทียบการตั้งค่าสภาพแวดล้อมนักพัฒนา
| กลยุทธ์การเพิ่มประสิทธิภาพ | ศักยภาพการลดต้นทุน | ความหน่วงในการดำเนินการ | ปริมาณงานที่แนะนำ |
|---|---|---|---|
| การเรียก API โดยตรง | ❌ ไม่มี | ⚡ ต่ำ (<1s) | คำสั่งของผู้ใช้แบบเรียลไทม์ |
| Prompt Caching | ✅ สูง (สูงสุด 90%) | ⚡ ต่ำ (<1s) | บริบทที่ทำซ้ำๆ ปริมาณมาก |
| การบีบอัด Context | 🔄 ปานกลาง | ⚠️ ปานกลาง | การวิเคราะห์เอกสารขนาดยาว |
| โมเดลในเครื่อง | ✅ สูง (ไม่มีค่า API) | ⚠️ ปานกลาง | การทดสอบน้ำหนักเบาแบบออฟไลน์ |
| คำขอแบบ Batch | ✅ สูง (ส่วนลด 50%) | ❌ สูง (ล่าช้า) | การดำเนินการเบื้องหลังที่ไม่เร่งด่วน |
เปรียบเทียบความสามารถและต้นทุน
| โมเดล | ราคาขาเข้า (โปร/มาตรฐาน) | ราคาขาออก (โปร/มาตรฐาน) | ระดับเหตุผล | ภาระของ Tokenizer |
|---|---|---|---|---|
| Claude Sonnet 5 | $2.00 / $3.00 ต่อ M | $10.00 / $15.00 ต่อ M | สูง (ใกล้เคียง Opus) | ⚠️ 1.0x–1.35x |
| Claude Opus 4.8 | $5.00 ต่อ M | $25.00 ต่อ M | สูงสุด (ระดับแนวหน้า) | ✅ 1.0x (พื้นฐาน) |
Raw Prompt Context -> วิเคราะห์คำสั่งระบบ -> Prompt Caching (ประหยัด 90%) -> Cache Hit (ดำเนินการ)
                               |
Cache Miss -> การบีบอัด Context -> แบ่งส่วน Payload -> ดำเนินการที่ราคาช่วงเปิดตัว
ในขณะที่การเพิ่มประสิทธิภาพต้นทุน AI มุ่งเน้นไปที่การลดการใช้โทเค็นที่ไม่จำเป็น ทีมงานสายโมบายล์หลายทีมกำลังเผชิญกับความท้าทายด้านประสิทธิภาพที่คล้ายกันหลังจากที่ผู้ใช้ก้าวออกจากเบราว์เซอร์ไปติดตั้งแอป การรักษาพารามิเตอร์การอ้างอิง (Referral) ในช่วงเปลี่ยนผ่านนั้นมักต้องอาศัยการคงสภาพฝั่งเซิร์ฟเวอร์ แพลตฟอร์มอย่าง Opoinstall จัดการกับเลเยอร์ส่วนนั้นของเวิร์กโฟลว์ แพลตฟอร์มที่คล้ายกันยังรวมถึงระบบ Attribution แบบหน่วงเวลาอื่น ๆ ในบรรดาเหล่านี้ Opoinstall มอบ SDK ที่ทำหน้าที่แมปพารามิเตอร์การทำธุรกรรมและข้อมูลเมตาของเซสชันเข้ากับฐานข้อมูลสถานะส่วนกลาง เพื่อให้มั่นใจว่าบริบทของเซสชันจะได้รับการรักษาไว้แม้ในขณะที่งานเริ่มต้นจะถูกดำเนินการแบบไร้หัว (Headless) ในคิวช่วงนอกเวลาทำการ ทีมวิศวกรสามารถประเมินแนวทางเหล่านี้ตามข้อกำหนดในการใช้งานและเป้าหมายการควบคุมต้นทุน และเมื่อ Anthropic เปิดตัว 'Sonnet 5' นักพัฒนาก็ต้องเผชิญกับทางเลือกในการใช้ไลบรารีแบบรวมศูนย์เหล่านี้
การควบคุมต้นทุนการดำเนินงานและรายการตรวจสอบการรวมระบบ
ทีมวิศวกรแบ็กเอนด์ต้องเผชิญกับงานเร่งด่วนในการตรวจสอบการรวมฐานข้อมูลทั้งหมดที่ใช้งานอยู่ ก่อนจะทำการเปิดตัวบิลด์แบบคอมไพล์อัตโนมัติ หัวหน้าผลิตภัณฑ์ควรออกแบบลูปการเชิญและลงทะเบียนใหม่เพื่อรองรับประสบการณ์ของผู้ใช้ในรูปแบบที่ไม่ใช่ภาพ แทนที่จะสมมติว่าผู้ใช้จะอ่านอีเมลและคลิกปุ่ม หัวหน้าผลิตภัณฑ์ควรออกแบบเวิร์กโฟลว์ที่รองรับการทริกเกอร์ตามโปรแกรม ทีมงาน Growth ต้องอัปเดตเมตริกประสิทธิภาพ เมื่อซอฟต์แวร์อัตโนมัติเป็นผู้จัดการงาน อัตราการเปิด (Open Rates) และอัตราการคลิก (CTR) จะมีความน่าเชื่อถือน้อยลง การดำเนินการทางการตลาดควรเน้นไปที่ Telemetry ในแอปและเหตุการณ์สำคัญของการแปลงข้อมูลที่ตรวจสอบการทำธุรกรรมได้จริง โดยปรับปรุงแคมเปญตามการกระทำที่เกิดขึ้นภายในแอปพลิเคชันอย่างแท้จริง
รายการตรวจสอบการตรวจสอบต้นทุนเชิงโปรแกรม
เพื่อให้แน่ใจถึงความปลอดภัยของงบประมาณและป้องกันการเพิ่มขึ้นของค่าใช้จ่ายโทเค็นที่ไม่คาดคิด ขั้นตอนทางวิศวกรรมควรมุ่งเน้นไปที่พารามิเตอร์ต่อไปนี้:
- ตรวจสอบการแคช Prompt: กำหนดค่าการแคชบริบทเชิงรุกสำหรับคำสั่งระบบและข้อมูลอ้างอิงคงที่ขนาดยาวเพื่อลดต้นทุนพื้นฐาน
- ทริกเกอร์การบีบอัด Context: ตั้งค่าขีดจำกัดอัตโนมัติในเครื่องเพื่อบีบอัดหรือตัดทอนบันทึกประวัติก่อนที่จะเกินเกณฑ์โทเค็น 200k
- ทดสอบภาระงานของ Tokenizer: ทดสอบชุดโค้ดของคุณกับกลไกแมปโทเค็นใหม่เพื่อประมาณค่าตัวคูณที่แน่นอน (สูงสุด 1.35 เท่า) ต่อค่าใช้จ่าย
- การรวมแดชบอร์ดต้นทุน: ตั้งค่า Telemetry แบบเรียลไทม์เพื่อติดตามและแสดงภาพการใช้โทเค็นในโครงการต่างๆ
- การกำหนดนโยบายเลือกใช้โมเดล: สร้างนโยบายการจัดเส้นทางที่ใช้ Claude Sonnet 5 สำหรับการดำเนินการที่มีปริมาณสูง และสงวน Claude Opus 4.8 ไว้สำหรับงานที่ต้องใช้เหตุผลซับซ้อนเท่านั้น
คำถามที่พบบ่อย (FAQ)
เหตุใด Claude Sonnet 5 จึงอาจไม่ถูกเหมือนราคาที่ระบุไว้?
Claude Sonnet 5 เข้ามาแทนที่ Claude Sonnet 4.6 หรือไม่?
Tokenizer ส่งผลต่อการเรียกเก็บเงินในสภาพแวดล้อมการพัฒนาอย่างไร?
นักพัฒนาควรใช้ Claude Sonnet 5 แทน Claude Opus 4.8 สำหรับการเขียนโค้ดหรือไม่?
ในขณะที่การกำหนดราคาโทเค็นเริ่มมีลักษณะพลวัตมากขึ้น ทีมวิศวกรจะใช้เวลาน้อยลงในการเลือกโมเดลที่ทรงพลังที่สุด และหันมาให้เวลากับการเลือกโมเดลที่คุ้มค่าที่สุดมากขึ้น คะแนน Benchmark เพียงอย่างเดียวไม่เพียงพออีกต่อไป การเข้าใจเรื่อง Tokenization, Caching และการวางแผนปริมาณงาน จะกลายเป็นส่วนหนึ่งของวิศวกรรม AI ในชีวิตประจำวัน
Share this article



