Anthropic Sonnet 5.5 เร็วขึ้น 30%? Anthropic ได้เปิดตัว Claude Sonnet 5.5 อย่างเป็นทางการ โดยรายงานระบุว่าสามารถสร้างผลลัพธ์ได้เร็วขึ้นกว่า 30% และลดต้นทุนต่อการทำงานหนึ่งอย่างลงได้สูงสุดถึง 30% ในขณะที่แพลตฟอร์มปัญญาประดิษฐ์เชิงสร้างสรรค์กำลังเปลี่ยนผ่านจากโมเดลต้นแบบไปสู่ระบบการผลิตขนาดใหญ่ ทีมวิศวกรซอฟต์แวร์กำลังเผชิญกับความท้าทายในการควบคุมการใช้งานโทเค็นและเวลาในการประมวลผล (runtime latency) ในอดีต สถาปนิกไอทีระดับองค์กรมักเชื่อว่าการมีประสิทธิภาพการเขียนโค้ดระดับแนวหน้าจำเป็นต้องใช้โมเดลรุ่นท็อปที่มีราคาแพงที่สุดเท่านั้น แต่ในปัจจุบัน เนื่องจากสถาปัตยกรรมระดับกลางที่ได้รับการปรับแต่งมาอย่างดีสามารถแก้ไขปัญหาซอฟต์แวร์ที่ซับซ้อนได้โดยใช้ขั้นตอนการทำงานและการเรียกเครื่องมือ (tool calls) ที่น้อยลง ทำให้หลักเศรษฐศาสตร์พื้นฐานของเครื่องมือช่วยเหลือนักพัฒนาแบบอัตโนมัติเริ่มเปลี่ยนไปสู่การเน้นประสิทธิภาพในการทำงานจริงมากขึ้น
เศรษฐศาสตร์การผลิต: ทำไมต้นทุนการทำงานให้สำเร็จจึงสำคัญกว่าราคาต่อโทเค็น
ภาพรวมโดยย่อ
- Anthropic เปิดตัว Claude Sonnet 5.5 เมื่อวันที่ 28 กันยายน 2026 โดยมาพร้อมความเร็วในการสร้างผลลัพธ์ที่เพิ่มขึ้น 30% และลดต้นทุนต่อการทำงานลงสูงสุด 30%
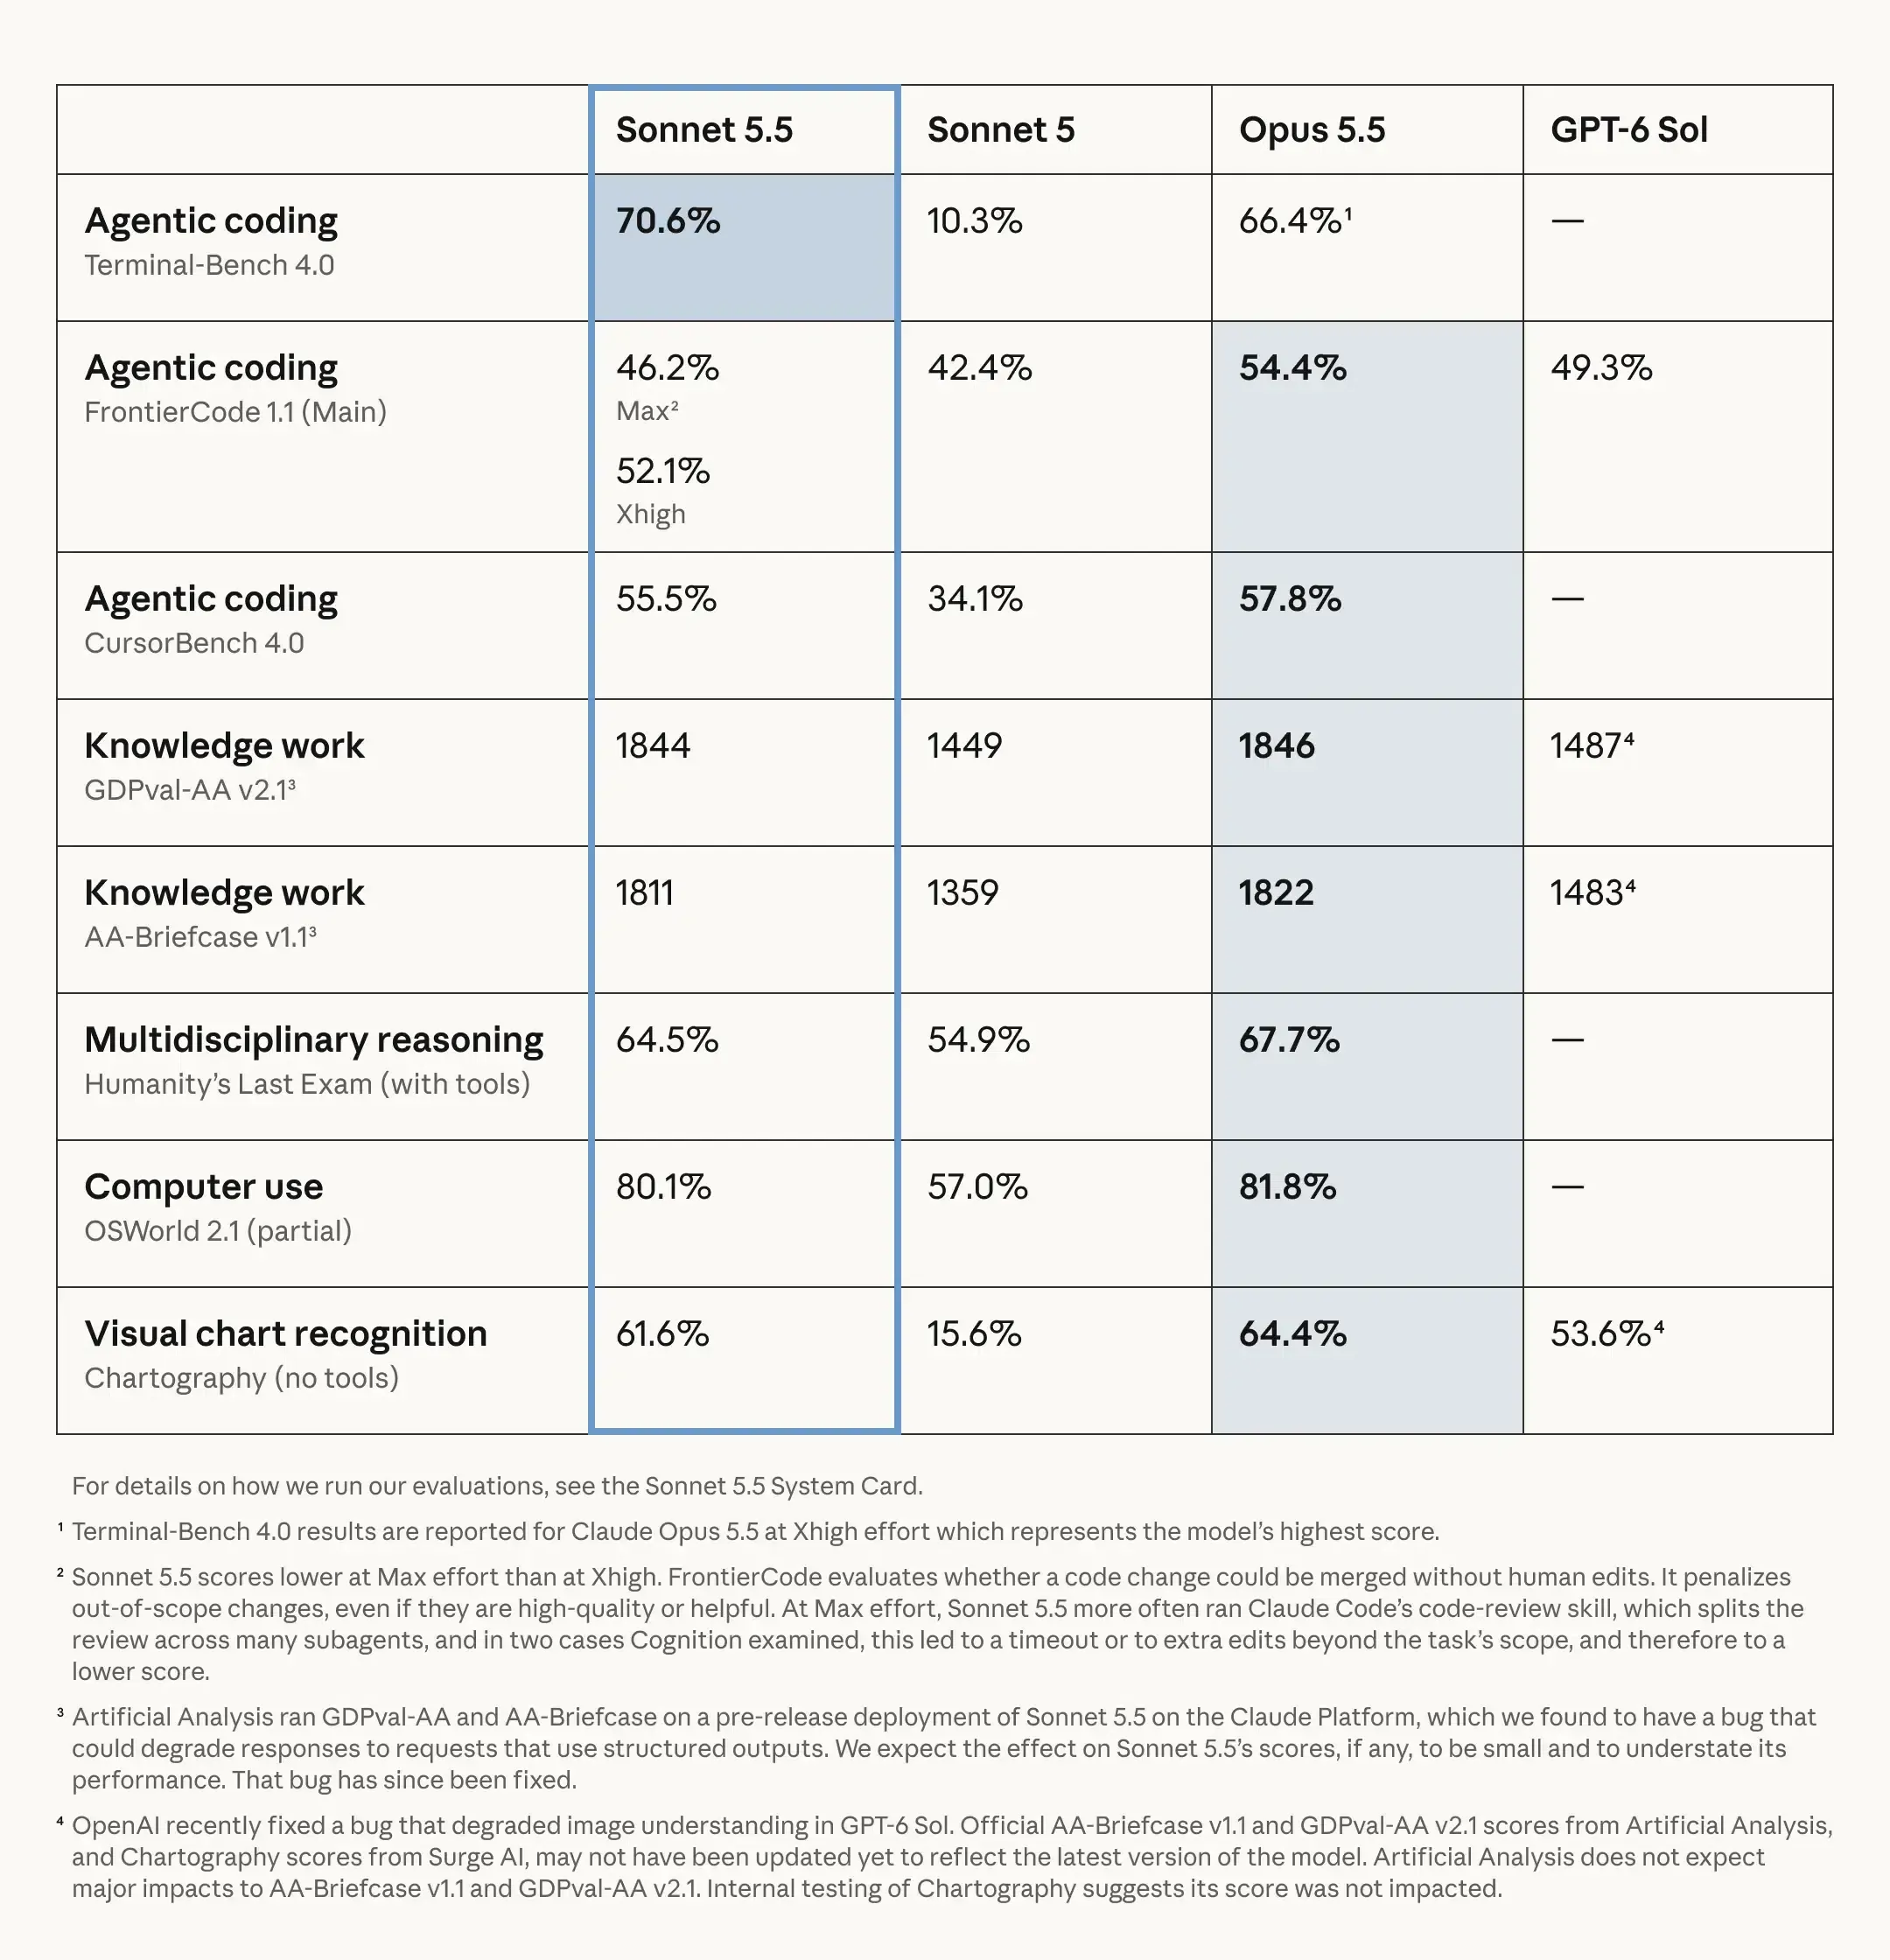
- ในการทดสอบประสิทธิภาพการเขียนโค้ดผ่านตัวแทนบน Terminal-Bench 4.0 รุ่น Sonnet 5.5 ทำคะแนนได้ 70.6% ซึ่งเหนือกว่ารุ่นเรือธงอย่าง Claude Opus 5.5 ที่ทำได้ 66.4% และรุ่น Sonnet 5 ที่ทำได้ 10.3%
- ราคาโทเค็นของ API ยังคงอยู่ที่ $2 ต่อล้านโทเค็นขาเข้า และ $10 ต่อล้านโทเค็นขาออก แต่สามารถลดต้นทุนรวมได้จริงเนื่องจากใช้ขั้นตอนการประมวลผลน้อยลงและการเรียกใช้เครื่องมือแบบกลุ่ม
ความคุ้มค่าเชิงพาณิชย์ในการปรับใช้ตัวแทนซอฟต์แวร์อัตโนมัติ (autonomous software engineering agents) มักประสบปัญหาด้านต้นทุนอย่างมากในอดีต การรันเครื่องมือสำหรับนักพัฒนาหลายขั้นตอนที่ต้องตรวจสอบซอร์สโค้ด รันคำสั่งเชลล์ และแก้ไขหน่วยทดสอบ (unit tests) ซ้ำๆ นั้นใช้ปริมาณโทเค็นมหาศาล แม้ว่าโมเดลระดับแนวหน้าจะมีขีดความสามารถในการใช้เหตุผลสูง แต่ค่าใช้จ่ายต่อโทเค็นที่สูงและ latency ในการสร้างผลลัพธ์ที่ยาวนานทำให้การรันระบบอย่างต่อเนื่องโดยไม่มีคนดูแลเป็นเรื่องที่มีต้นทุนสูงเกินไปสำหรับองค์กร
เมื่อประเมินโครงสร้างพื้นฐานสำหรับนักพัฒนา ราคา API เบื้องต้นมักบดบังต้นทุนที่แท้จริงในการทำงานให้สำเร็จ โมเดลที่มีราคาต่อโทเค็นถูกแต่ต้องวนลูปเรียกเครื่องมือซ้ำๆ หลายสิบครั้งสุดท้ายแล้วอาจมีต้นทุนสูงกว่าโมเดลที่แก้ไขปัญหาเสร็จสิ้นได้ในขั้นตอนที่น้อยกว่า ปรากฏการณ์นี้ถูกกล่าวถึงใน รายงานอุตสาหกรรมเกี่ยวกับ Sonnet 5.5 ซึ่งเน้นย้ำว่าต้นทุนการทำงานให้สำเร็จนั้นกำลังแยกตัวออกจากราคาต่อรายการของโทเค็นอย่างชัดเจน
Anthropic ได้ออกแบบ Claude Sonnet 5.5 มาเพื่อจัดการกับคอขวดทางปฏิบัติเหล่านี้โดยตรง ในขณะที่ยังคงราคา API พื้นฐานไว้ที่ $2 ต่อล้านโทเค็นขาเข้า และ $10 ต่อล้านโทเค็นขาออก โมเดลนี้ช่วยลดต้นทุนสุทธิต่องานลงได้สูงสุดถึง 30% โดยอาศัยขั้นตอนการประมวลผลที่น้อยลง รายงานการทดสอบของลูกค้าที่ Anthropic เผยแพร่แสดงให้เห็นถึงประสิทธิภาพที่ดีขึ้นในภาระงานจริง:
- Box รายงานว่า Sonnet 5.5 ทำงานเร็วขึ้น 2.4 เท่า ในขณะที่ใช้โทเค็นรวมน้อยลง 12% ในการตรวจสอบเอกสารซอร์สโค้ดและระบุจุดบกพร่อง (regressions)
- Zendesk สังเกตว่าตั๋วสนับสนุนลูกค้าได้รับการจัดการเร็วขึ้น 20% และมีความผิดพลาดในการตัดสินใจอัตโนมัติน้อยกว่าเมื่อเทียบกับโมเดลที่ใช้อยู่เดิม
- Slack แสดงให้เห็นว่าโมเดลนี้มีประสิทธิภาพเหนือกว่า Sonnet 5 ในการประเมินผลแบบออฟไลน์โดยไม่ต้องปรับจูนคำสั่ง (prompt) และใช้โทเค็นขาออกน้อยลงประมาณ 14%
- Lovable พบว่า Sonnet 5.5 ต้องการการเรียกใช้เครื่องมือลดลงประมาณหนึ่งในสาม และใช้การประมวลผลผ่านคำสั่งเชลล์น้อยลงครึ่งหนึ่งในระหว่างการรัน build แอปพลิเคชันอัตโนมัติ
- Base44 ยืนยันว่าโมเดลนี้ทำงาน build แอปพลิเคชันจนเสร็จสิ้นเฉลี่ยที่ 3.6 รอบ เปรียบเทียบกับ 7.7 รอบสำหรับรุ่น Opus 5
ผลลัพธ์เหล่านี้แสดงให้เห็นว่าประสิทธิภาพการทำงานส่งผลต่อผลิตภาพของนักพัฒนาอย่างไร การลดการเรียกใช้เครื่องมือที่ล้มเหลวและตัดขั้นตอนที่ซ้ำซ้อนออกไป ช่วยให้โมเดลระดับกลางกลายเป็นฐานที่ยั่งยืนสำหรับการทำระบบอัตโนมัติระดับองค์กรอย่างต่อเนื่อง
บทวิเคราะห์ทางเทคนิค: การประเมินผลการเขียนโค้ดและการทำงานของตัวแทนย่อย (Subagent)
การที่โมเดลระดับกลางมีประสิทธิภาพเหนือกว่ารุ่นเรือธงในบางงานสะท้อนถึงการเปลี่ยนแปลงในการปรับแต่งโมเดลหลังการฝึก (post-training) กฎการขยายขนาด (scaling laws) ในยุคแรกชี้ว่าจำนวนพารามิเตอร์เป็นปัจจัยหลักของความฉลาด แต่ภาระงานที่ซับซ้อน เช่น การนำทางในสภาพแวดล้อม terminal และการแก้ไขคลังโค้ดขนาดใหญ่ ขึ้นอยู่กับการจัดการบริบท การใช้เครื่องมืออย่างแม่นยำ และการควบคุมขอบเขตของงาน
โมเดลเรือธงอย่าง Opus 5.5 มีขีดความสามารถในการใช้เหตุผลที่สูงมาก เหมาะสำหรับงานตัดสินใจทางสถาปัตยกรรมที่มีความคลุมเครือ อย่างไรก็ตาม การใช้เหตุผลที่ลึกซึ้งเกินไปอาจทำให้เกิดภาระงานที่ซับซ้อนเกินความจำเป็นในงานที่มีขอบเขตชัดเจน ในการทดสอบ FrontierCode ทาง Anthropic ตั้งข้อสังเกตว่า Sonnet 5.5 ที่ทำงานในโหมด Max ได้คะแนนน้อยกว่าโหมด Xhigh เพราะมักเรียกใช้ทักษะการตรวจสอบโค้ดของ Claude Code บ่อยเกินไป ซึ่งแบ่งงานให้ตัวแทนย่อยหลายตัวจัดการ ทำให้เกิดปัญหา timeout หรือการแก้ไขที่ไม่ตรงจุดจนถูกหักคะแนน ในทางกลับกัน Sonnet 5.5 ที่ทำงานในโหมด standard นั้นเหมาะสมอย่างยิ่งกับงานที่ถูกจำกัดขอบเขตไว้ชัดเจน เนื่องจากสามารถแยกวิเคราะห์โครงสร้างคลังโค้ด ประเมินการเปลี่ยนแปลง และทำงานอยู่ในขอบเขตไฟล์ที่กำหนดได้อย่างรวดเร็ว
ความเท่าเทียมในมาตรฐานการทดสอบ: Terminal-Bench, CursorBench และ GDPval-AA
ผลการประเมินที่ Anthropic เผยแพร่แสดงให้เห็นว่า Sonnet 5.5 เทียบเท่าหรือสูงกว่ามาตรฐานระดับแนวหน้าในด้านเทคนิคต่างๆ บน Terminal-Bench 4.0 ซึ่งวัดทักษะการแก้ปัญหาบรรทัดคำสั่งหลายขั้นตอน Sonnet 5.5 ทำคะแนนได้ 70.6% สูงกว่า Opus 5.5 ที่ทำได้ 66.4% และ Sonnet 5 ที่ 10.3% ในส่วนของ CursorBench 4.0 ที่มาจากเซสชันการพัฒนาจริงใน Cursor นั้น Sonnet 5.5 ทำได้ 55.5% ตามหลัง Opus 5.5 (57.8%) เพียงเล็กน้อย ยิ่งไปกว่านั้นใน GDPval-AA v2.1 ที่วัดงานระดับมืออาชีพทั่วโลก Sonnet 5.5 ได้รับคะแนน Elo ที่ 1844 ซึ่งไล่เลี่ยกับ Opus 5.5 ที่ 1846
เพื่อให้เห็นภาพชัดเจนว่าโมเดลที่เพรียวบางช่วยปรับปรุงการทำงานอัตโนมัติอย่างไร ลองพิจารณาความแตกต่างของ workflow:
[Monolithic Flagship Agent Loop]
  User Prompt ──> Heavy Reasoning Chain ──> Sprawling Tool Calls (High Token Burn) ──> Risk of Over-editing & Timeouts

[Streamlined Mid-Tier Agent Loop]
  User Prompt ──> Scoped Intent Mapping ──> Batched Tool Calls ──> Fewer Execution Steps ──> Concise Patch Delivered
ลูปการทำงานที่คล่องตัวนี้ช่วยลดโอกาสที่บริบทจะคลาดเคลื่อน (context drift) และลดการวนลูปที่ไม่จำเป็น Anthropic รายงานว่าการสร้างผลลัพธ์เร็วขึ้น 30%+ ควบคู่ไปกับจำนวนขั้นตอนที่ลดลงเมื่อเทียบกับ Sonnet 5 โมเดลมีการจัดกลุ่มการเรียกใช้เครื่องมือ (batching) ทำให้ลด latency ของเครือข่ายระหว่างการรันตัวแทนกับสภาพแวดล้อมโฮสต์ได้สูงสุด
Sonnet 5.5 ยังนำโครงสร้างพื้นฐานด้านความปลอดภัยระดับ Tier-1 มาสู่กลุ่มโมเดลระดับกลางด้วย ถือเป็นรุ่น Sonnet รุ่นแรกที่เปิดตัวพร้อมระบบปกป้องความปลอดภัยทางไซเบอร์ที่เทียบเท่ากับ Opus 5.5 งานที่มีความเสี่ยงสูงจะถูกส่งต่อไปยังโมเดลรุ่นก่อนหน้าโดยอัตโนมัติ ในขณะที่นักพัฒนาที่ผ่านการรับรองจะได้รับสิทธิ์การใช้งานผ่านโปรแกรม Cyber Verification นอกจากนี้ระบบยังรวม classifiers ด้านความปลอดภัยที่ออกแบบมาเพื่อลดการดึงข้อมูลการใช้เหตุผลในระดับอุตสาหกรรม และรักษาความคิด (thinking) ให้อยู่ในขอบเขตบัญชีต้นทางเท่านั้น
กลยุทธ์ด้านสถาปัตยกรรม: การจัดสรรภาระงานระหว่างโมเดล Frontier และโมเดลระดับกลาง
ในขณะที่โมเดลรากฐาน (foundation models) แบ่งออกเป็นเครื่องมือใช้เหตุผลเชิงลึกและโมเดลสำหรับปฏิบัติงานที่คล่องตัว ผู้นำด้านวิศวกรรมต้องประเมินการจัดสรรโมเดลใหม่ในวงจรการพัฒนาซอฟต์แวร์ การใช้โมเดลเรือธงเพียงโมเดลเดียวตลอดไปป์ไลน์วิศวกรรมทำให้เกิดความล่าช้าและต้นทุนโดยไม่จำเป็น แทนที่จะเป็นเช่นนั้น โครงสร้างพื้นฐานสมัยใหม่หันมาใช้การเลือกโมเดลแบบไดนามิก (dynamic model routing) โดยจัดสรรงานตามความซับซ้อนเชิงโครงสร้าง
เมื่อวางระบบ Workflow ในการผลิต ทีมงานต้องชั่งน้ำหนักระหว่างความสามารถในการใช้เหตุผลเชิงลึกกับการแก้ไขงานที่ต้องการปริมาณงานสูง (high-throughput) แม้โมเดลเรือธงยังจำเป็นสำหรับงานวางแผนสถาปัตยกรรมในวงกว้าง แต่โมเดลระดับกลางสามารถรับมือกับงานเขียนโค้ดประจำวันส่วนใหญ่ได้ด้วยการตอบสนองที่เหนือกว่า
เมทริกซ์การตัดสินใจต่อไปนี้สรุปการจัดวางภาระงานให้สอดคล้องกับประเภทโมเดล:
| ประเภทภาระงาน | โมเดลหลักที่เลือก | โปรไฟล์ต้นทุน | โปรไฟล์ Latency | เหมาะสำหรับ |
|---|---|---|---|---|
| แก้ไขบั๊กประจำวัน & ตรวจทาน PR | Claude Sonnet 5.5 | ต่ำ ($2 / $10 ต่อ 1 ล้านโทเค็น) | เร็ว (สร้างผลลัพธ์เร็วขึ้น 30%+) | งานประจำที่ขอบเขตชัดเจนและ CI/CD ปริมาณมาก |
| สถาปัตยกรรมคลังโค้ด & การย้ายระบบ | Claude Opus 5.5 | สูง ($4 / $20 ต่อ 1 ล้านโทเค็น) | ปรับเปลี่ยนได้, ใช้เหตุผลเชิงลึก | การปรับโครงสร้างซอฟต์แวร์ที่ซับซ้อนและคลุมเครือ |
| การทำต้นแบบ & ออกแบบ UI | Claude Sonnet 5.5 | ต่ำ ($2 / $10 ต่อ 1 ล้านโทเค็น) | รวดเร็ว, ตอบสนองทันที | ออกแบบ User flows, สร้างไดอะแกรม, และ Frontend scaffolding |
| วิจัยความปลอดภัยไซเบอร์ขั้นสูง | โมเดล Claude ที่ผ่านการรับรองสิทธิ์ | ขึ้นอยู่กับโมเดลและระดับการเข้าถึง | การตรวจสอบหลายขั้นตอนอย่างละเอียด | งานวิจัยความปลอดภัยที่มีความเสี่ยงสูงภายใต้โปรแกรมรับรอง |
Anthropic จัดโครงสร้างความสามารถด้านความปลอดภัยไซเบอร์ผ่านระบบป้องกันหลายระดับ ในขณะที่การแก้ไขช่องโหว่ทั่วไปสามารถทำบน Sonnet 5.5 ได้ตามปกติ งานความปลอดภัยที่มีความเสี่ยงสูงจะถูกส่งไปยังโมเดลรุ่นก่อนหน้าโดยอัตโนมัติ สำหรับผู้เชี่ยวชาญที่ต้องการวิจัยความปลอดภัยขั้นสูง การเข้าถึงความสามารถที่กว้างขวางขึ้นผ่านรุ่น Sonnet 5.5, Opus 5.5 และ Mythos จะถูกจัดการผ่านโปรแกรม Cyber Verification
ด้วยการกำหนดกฎการเลือกโมเดลแบบไดนามิก องค์กรวิศวกรรมสามารถส่งงานตรวจทาน Pull Request, การสร้าง Unit Test, และการระบุจุดบั๊กไปที่ Sonnet 5.5 ได้ ซึ่งช่วยรักษาความสามารถของ Opus รุ่นเรือธงไว้สำหรับงานปรับโครงสร้างสถาปัตยกรรมที่ซับซ้อน ทำให้งบประมาณวิศวกรรมคาดการณ์ได้โดยไม่กระทบต่อความน่าเชื่อถือของซอฟต์แวร์
รายการตรวจสอบการบูรณาการ: การนำ Sonnet 5.5 มาใช้ในงาน CI/CD ขององค์กร
เมื่อองค์กรซอฟต์แวร์รวมโมเดลที่เร็วและประหยัดอย่าง Sonnet 5.5 เข้ากับไปป์ไลน์การผลิต ทีมวิศวกรต้องกำหนดแผนการกำกับดูแลที่เข้มงวด การสร้างผลกำไรสูงสุดต้องมาจากการปรับการตั้งค่า API ให้เข้ากับความซับซ้อนของงาน พร้อมป้องกันการหลุดกรอบของตัวแทนอัตโนมัติ
รายการตรวจสอบสำหรับนักพัฒนา
- ตั้งค่าระดับความพยายาม (Effort Levels) แบบไดนามิก: ใช้การตั้งค่าความพยายามของโมเดล (ค่าเริ่มต้นเป็น Medium ในแอป Claude และ Claude Code, และ High บน Claude Platform) เพื่อรักษาสมดุลระหว่างความลึกของการใช้เหตุผลและการใช้โทเค็น
- ใช้ Prompt Caching: ใช้การทำ Caching สำหรับคำสั่งระบบ (system prompts) และแผนผังคลังโค้ดเพื่อรับส่วนลด 90% สำหรับโทเค็นที่อ่านจากแคช ($0.20 ต่อล้านโทเค็น)
- ใช้การประมวลผลแบบ Batch Asynchronous: ส่งงานที่ไม่ต้องทำแบบเรียลไทม์ เช่น การตรวจสอบโค้ดอัตโนมัติและการย้ายข้อมูลจำนวนมาก ผ่าน Batch API เพื่อประหยัดค่าโทเค็นมาตรฐานได้ถึง 50%
- สร้างกลไกสำรอง (Fail-Safe): กำหนดตัวตัดวงจรโปรแกรมที่ยุติหรือเปลี่ยนเส้นทางคำขอโดยอัตโนมัติหากการเรียกใช้เครื่องมือเกินงบประมาณที่กำหนดไว้
รายการตรวจสอบด้านการกำกับดูแลและโครงสร้างพื้นฐาน
- ประเมินหน่วยเศรษฐศาสตร์ของสมาชิก: คำนวณต้นทุนการคำนวณส่วนเพิ่มต่อนักพัฒนาเพื่อพิจารณาว่าโมเดลระดับกลางช่วยให้สามารถเพิ่มโควตาการใช้งานหรือลดราคาค่าบริการได้หรือไม่
- ติดตามอัตราส่วนการวนลูป (Iteration Ratios): วัดจำนวนเฉลี่ยของการเรียกเครื่องมือที่ต้องใช้ในการแก้งาน; การลดจำนวนรอบลงจะช่วยปรับปรุงความพึงพอใจของนักพัฒนาได้โดยตรง
- กำหนดการประมวลผลภายในสหรัฐฯ เท่านั้นหากจำเป็น: สำหรับลูกค้าองค์กรที่มีข้อกำหนดด้านถิ่นที่อยู่ของข้อมูล ให้ตั้งค่าจุดประสงค์การใช้งานในสหรัฐฯ เท่านั้น (ราคา 1.1x ตามเงื่อนไของค์กร)
- ตรวจสอบสิทธิ์การไม่จัดเก็บข้อมูล: ยืนยันสถานะการไม่จัดเก็บข้อมูลกับผู้ให้บริการ API เพื่อให้มั่นใจเรื่องความสอดคล้องขององค์กร โดยควรทราบว่าคุณสมบัติเฉพาะบางอย่าง เช่น Prompt cache แบบต่อเนื่อง อาจมีเงื่อนไขการจัดเก็บข้อมูลที่แตกต่างกัน
ด้วยการปรับใช้แนวทางปฏิบัติเหล่านี้ องค์กรซอฟต์แวร์สามารถแปลงความเร็วเชิงอัลกอริทึมและประสิทธิภาพของโทเค็นให้เป็นความสำเร็จในการพัฒนาที่คาดการณ์ได้
คำถามที่พบบ่อย (FAQ)
ทำไม Sonnet 5.5 ถึงมีต้นทุนต่อการทำงานต่ำกว่า ทั้งที่ราคาต่อโทเค็นเท่ากับ Sonnet 5?
Claude Sonnet 5.5 สามารถใช้แทน Opus 5.5 สำหรับงานวิศวกรรมซอฟต์แวร์ได้หรือไม่?
Prompt caching ส่งผลต่อต้นทุนการดำเนินงานในโค้ดตัวแทน (coding agents) อย่างไร?
ข้อสรุปสำคัญสำหรับทีมวิศวกร
การเปิดตัว Claude Sonnet 5.5 สะท้อนถึงวิวัฒนาการของอุตสาหกรรมจากการขยายขนาดพารามิเตอร์โดยไม่มีข้อจำกัด ไปสู่การมุ่งเน้นประสิทธิภาพการทำงานเชิงปฏิบัติ แพลตฟอร์มวิศวกรรมซอฟต์แวร์ที่มีปริมาณงานสูงไม่จำเป็นต้องใช้กำลังการประมวลผลของโมเดลเรือธงในทุกขั้นตอนเสมอไป เมื่อโมเดลระดับกลางสามารถแก้ไขงานคลังโค้ดที่มีขอบเขตชัดเจนได้ด้วยรอบการทำงานที่น้อยลง การพัฒนาซอฟต์แวร์อัตโนมัติจะกลายเป็นสิ่งที่คุ้มค่ากว่าในการปรับใช้ในระดับสเกลขนาดใหญ่
การใช้ประโยชน์จากประสิทธิภาพเหล่านี้ต้องอาศัยการวางสถาปัตยกรรมที่มีวินัย เช่น การเลือกงานอย่างชาญฉลาดตามความซับซ้อน การบังคับใช้ขอบเขตการใช้เครื่องมือ และการใช้ Prompt caching อย่างเป็นระบบ ในขณะที่ผู้ให้บริการโมเดลรากฐานยังคงปรับปรุงประสิทธิภาพของโทเค็นไปพร้อมกับความสามารถในการใช้เหตุผล ทีมวิศวกรที่ออกแบบไปป์ไลน์แบบแยกส่วนและตรวจสอบต้นทุนได้ จะสามารถรักษา Workflow การผลิตที่ยั่งยืนและขยายตัวได้มากที่สุด
เอกสารอ้างอิง
-
Anthropic. แนะนำ Claude Sonnet 5.5.
-
Anthropic. ข้อมูลระบบ Claude Sonnet 5.5.
-
Anthropic. ราคา Claude API และถิ่นที่อยู่ของข้อมูล.
-
Anthropic. ข้อกำหนดการใช้งานเชิงพาณิชย์และนโยบายการจัดเก็บข้อมูล.
-
VentureBeat. Anthropic เปิดตัว Claude Sonnet 5.5 พร้อมลดต้นทุนต่องานลง 30%.
-
TechCrunch. Anthropic เปิดตัว Sonnet 5.5 ในฐานะคู่หูการทำงานที่ถูกลงและเร็วกว่าเดิมมาก.
-
9to5Mac. Anthropic อัปเกรด Claude ด้วยโมเดลใหม่ Sonnet 5.5 รายละเอียดที่นี่.
Share this article



