Cloudflare ปิดกั้น AI Training Bots? Cloudflare ได้ประกาศนโยบายเริ่มต้นฉบับใหม่ที่จะปิดกั้นโปรแกรมรวบรวมข้อมูลสำหรับการฝึกฝน AI บนเว็บไซต์ของผู้ผลิตเนื้อหาที่เข้าเกณฑ์ พร้อมเปิดตัวทางเลือกในการสร้างรายได้ใหม่สำหรับเจ้าของคอนเทนต์ ในขณะที่ Generative AI กำลังเปลี่ยนรูปแบบการบริโภคเนื้อหาบนเว็บ แพลตฟอร์ม AI เหล่านี้ยังคงดึงทรัพยากรเว็บไปใช้ในปริมาณมหาศาลโดยไม่มีโครงสร้างมูลค่าตอบแทนที่ชัดเจน ในอดีต การอนุญาตให้เครื่องมือค้นหาเข้ามาจัดทำดัชนี (Indexing) หมายถึงการได้รับทราฟฟิกอ้างอิงซึ่งสามารถนำไปสร้างรายได้ผ่านโฆษณาหรือการสมัครสมาชิก แต่ในปัจจุบัน เนื่องจากโปรแกรมรวบรวมข้อมูลแบบผสมผสานได้คัดลอกข้อมูลที่เป็นกรรมสิทธิ์ไปใช้ฝึกฝนโมเดลอย่างเป็นระบบ ขณะเดียวกันก็สร้างสรุปคำตอบโดยตรงที่ทำให้ผู้ใช้ไม่จำเป็นต้องคลิกเข้ามาที่เว็บ ผู้ผลิตเนื้อหาจึงได้รับผลกระทบจากรายได้ที่ลดลงอย่างรุนแรง
ปัญหาการดำเนินงานและอุปสรรคทางการเงิน: Cloudflare ปิดกั้นบอทฝึกฝน AI บนหน้าเว็บที่รองรับโฆษณา
ภาพรวมโดยย่อ
- ระบบป้องกันอัตโนมัติจะเริ่มการจำกัดการคัดลอกข้อมูลโดยโมเดลและเอเจนต์โปรแกรมต่างๆ บนไดเรกทอรีเนื้อหาที่สร้างรายได้ ตั้งแต่ไตรมาสที่ 3 ของปี 2026 เป็นต้นไป
- โปรแกรมรวบรวมข้อมูลที่รวมการจัดทำดัชนีการค้นหากับการเก็บเกี่ยวข้อมูลเข้าด้วยกัน จะถูกจำกัดเว้นแต่จะแยกวัตถุประสงค์การทำงานออกเป็นท่อข้อมูลที่ชัดเจน
- กำลังเกิดกรอบการสร้างผลตอบแทนจากยูทิลิตี้ใหม่ๆ เพื่อให้รางวัลในระดับธุรกรรมโดยตรงแก่ผู้ดูแลเนื้อหา แทนการนับจำนวนคำขอมาตรฐาน
สมดุลแบบดั้งเดิมระหว่างผู้เผยแพร่เนื้อหาออนไลน์และโปรแกรมดึงข้อมูลอัตโนมัติได้แตกสลายลงอย่างสิ้นเชิง ข้อตกลงร่วมกันโดยปริยายได้ยึดโยงอินเทอร์เน็ตทั่วโลกไว้เกือบ 30 ปี ภายใต้พื้นฐานนี้ ผู้ดูแลเว็บยินดีให้แมงมุมค้นหาเข้ามาสแกนหน้าเว็บเพื่อแลกกับการได้รับคลิกจากผู้ใช้ที่มีคุณภาพจากการค้นหา การแลกเปลี่ยนที่เป็นธรรมนี้ช่วยสนับสนุนสื่อที่พึ่งพาตนเองได้ ทำให้ยอดโฆษณา การสนับสนุนดิจิทัล และการสมัครสมาชิกแบบต่อเนื่องสามารถสร้างเงินทุนให้กับคู่มือซอฟต์แวร์อิสระและงานสื่อสารมวลชนได้
การเปลี่ยนผ่านสู่เครือข่าย Generative ขนาดใหญ่ในปัจจุบันได้ปรับโฉมกิจกรรมของโปรแกรมรวบรวมข้อมูล โดยเปลี่ยนจุดเน้นจากการค้นหาเส้นทางไปสู่การดึงข้อมูล ระบบเก็บรวบรวมอัตโนมัติเหล่านี้กำลังกลืนกินไดเรกทอรีดิจิทัลทั้งหมด วิเคราะห์ข้อมูลเชิงความหมาย และนำเสนอข้อมูลที่สังเคราะห์ขึ้นภายในวิดเจ็ตแชทแบบปิด การแก้ปัญหาที่รวดเร็วนี้ข้ามขั้นตอนการเยี่ยมชมเว็บไซต์ปกติไป ซึ่งการประเมินพบว่าเมื่ออินเทอร์เฟซการค้นหานำเสนอผลลัพธ์จาก AI แบบบูรณาการ โอกาสที่ผู้อ่านจะคลิกลิงก์ขาออกไปยังเว็บไซต์ต้นทางจะลดลงอย่างมากจนเหลือเพียงหลักเลขหลักเดียวในหลายกรณี รูปแบบทราฟฟิกเหล่านี้สร้างปัญหาขาดแคลนเงินทุนสำหรับแพลตฟอร์มที่ต้องพึ่งพาสร้างรายได้จากโฆษณาเพื่อชดเชยค่าใช้จ่ายในการดำเนินงาน
เหตุใด Cloudflare ถึงปิดกั้นบอทฝึกฝน AI กลายเป็นข้อกำหนดของผู้ผลิตเนื้อหา
ผู้เผยแพร่เนื้อหาต้องเผชิญกับข้อแลกเปลี่ยนที่ยากลำบากมานานระหว่างการปกป้องคอนเทนต์กับการรักษาความสามารถในการมองเห็นในผลการค้นหา หากเจ้าของเว็บไซต์อิสระบล็อก Googlebot, Applebot หรือ Bingbot เพื่อป้องกันการนำข้อมูลไปฝึกฝน AI พวกเขาอาจเสี่ยงต่อการหายไปจากดัชนีการค้นหาแบบดั้งเดิม การผูกขาดเชิงโครงสร้างนี้บีบให้ผู้สร้างเนื้อหาต้องเลือกว่าจะยอมเสียสละข้อมูลที่มีค่าให้ฟรีๆ หรือยอมสละการค้นพบตัวตนไปเลย พลวัตนี้ยังกระตุ้นให้หน่วยงาน AI เกิดใหม่หันมาใช้กลยุทธ์การดึงข้อมูลที่หลบเลี่ยง ซึ่งยิ่งเพิ่มภาระให้เซิร์ฟเวอร์ของผู้เผยแพร่เนื้อหาที่ต้องแบกรับค่าใช้จ่ายจากคำขอที่ซ้ำซ้อน
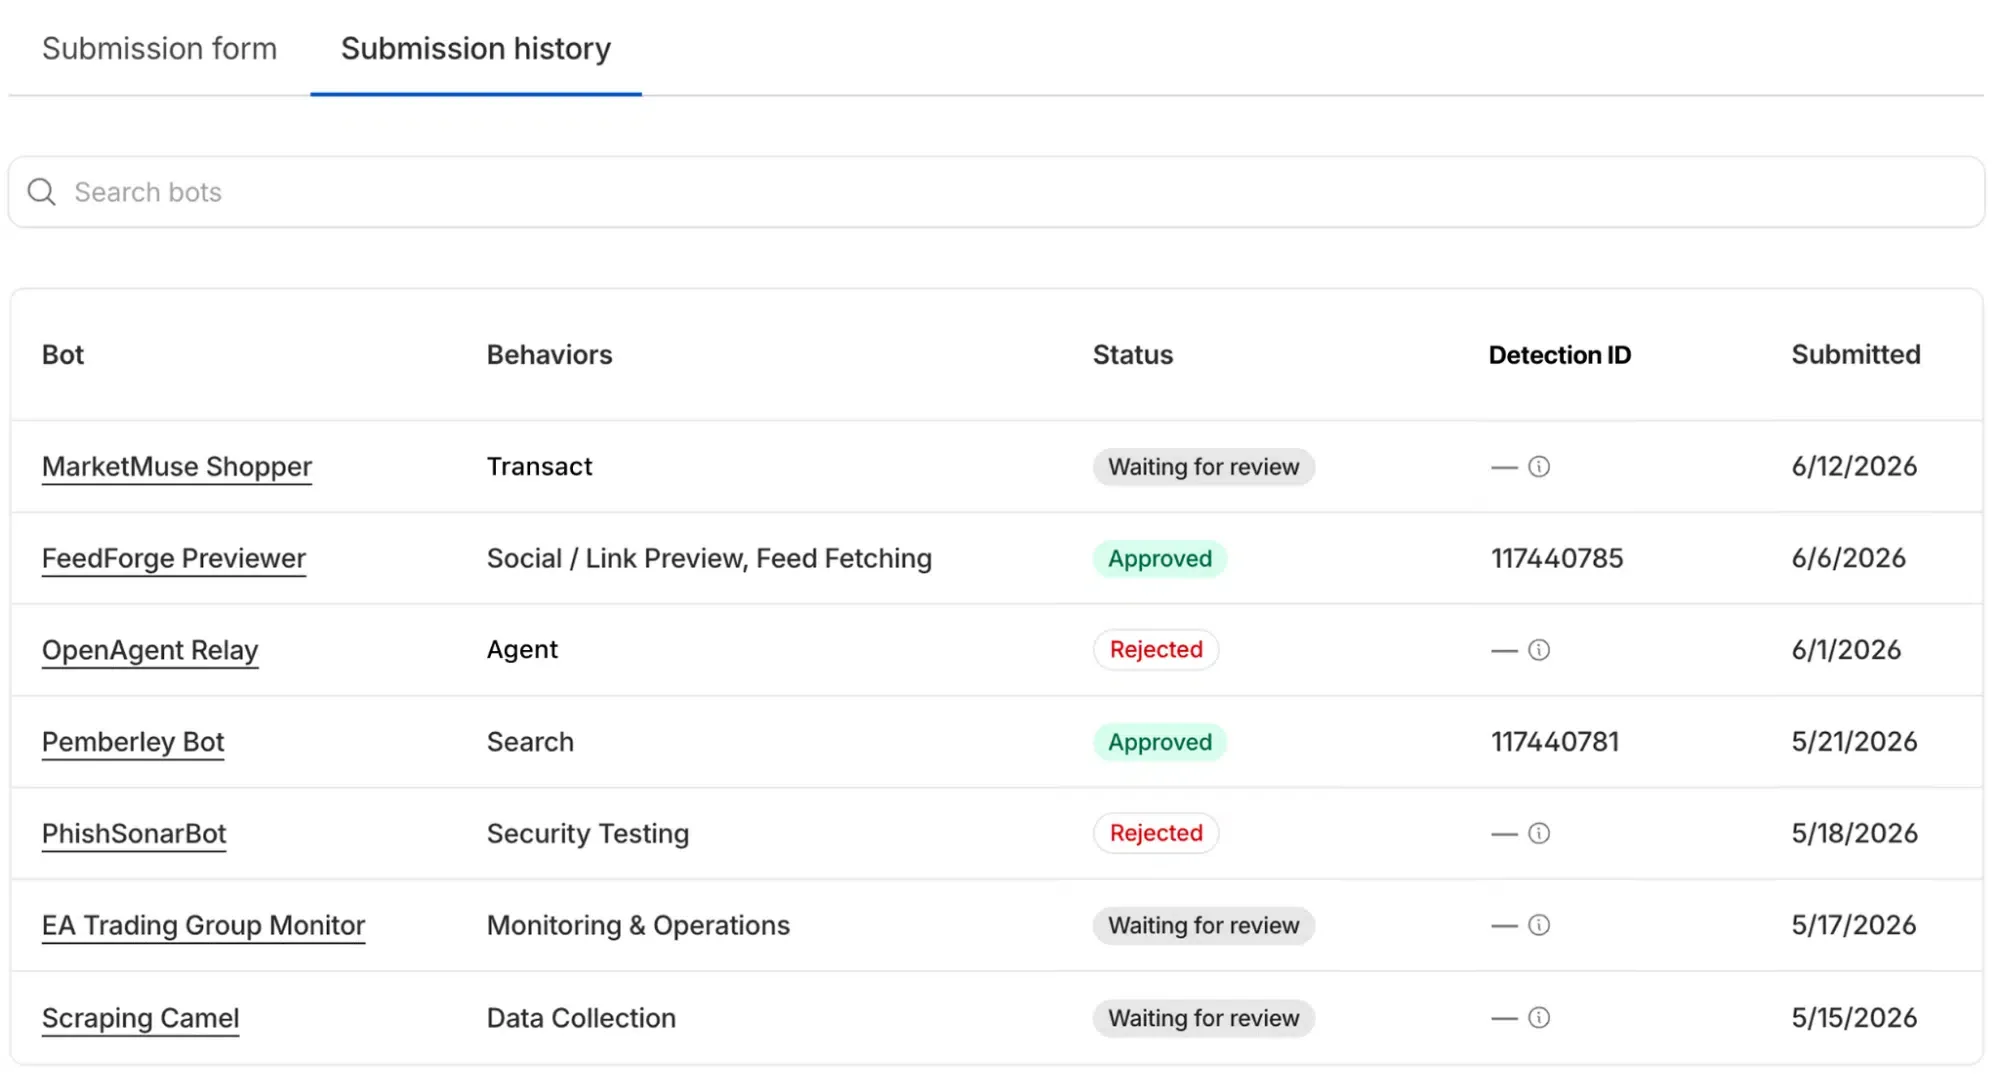
เพื่อรักษาสมดุล Cloudflare ได้เปิดตัวกลไกการควบคุมที่ชัดเจน Cloudflare กล่าวว่านโยบายเริ่มต้นนี้จะเริ่มดำเนินการในวันที่ 15 กันยายน 2026 โดยจะปิดกั้นบอทฝึกฝน AI และเอเจนต์ที่เน้นผู้ใช้ทั่วไปบนหน้าเว็บลูกค้าที่รองรับโฆษณาทั้งหมด การอัปเดตนี้ช่วยให้มั่นใจได้ว่าเนื้อหาที่สร้างรายได้จะไม่ถูกดึงข้อมูลโดยไม่ได้รับอนุญาตโดยตรง ในขณะเดียวกัน ยักษ์ใหญ่ด้านเครือข่ายกำลังปรับโครงสร้างกรอบการสร้างรายได้ จากสถาปัตยกรรม Pay Per Crawl แบบเดิม ไปสู่ระบบ Pay Per Use ที่เน้นผลลัพธ์ผ่านการเชื่อมต่อกับแพลตฟอร์มอย่าง You.com และ Ceramic.ai ผู้เผยแพร่เนื้อหาสามารถรับค่าตอบแทนโดยตรงทุกครั้งที่เอเจนต์ AI ใช้เนื้อหาของพวกเขาในการตอบคำถาม ซึ่งนำไปสู่การสร้างกระแสรายได้ที่ยั่งยืนในระดับธุรกรรม
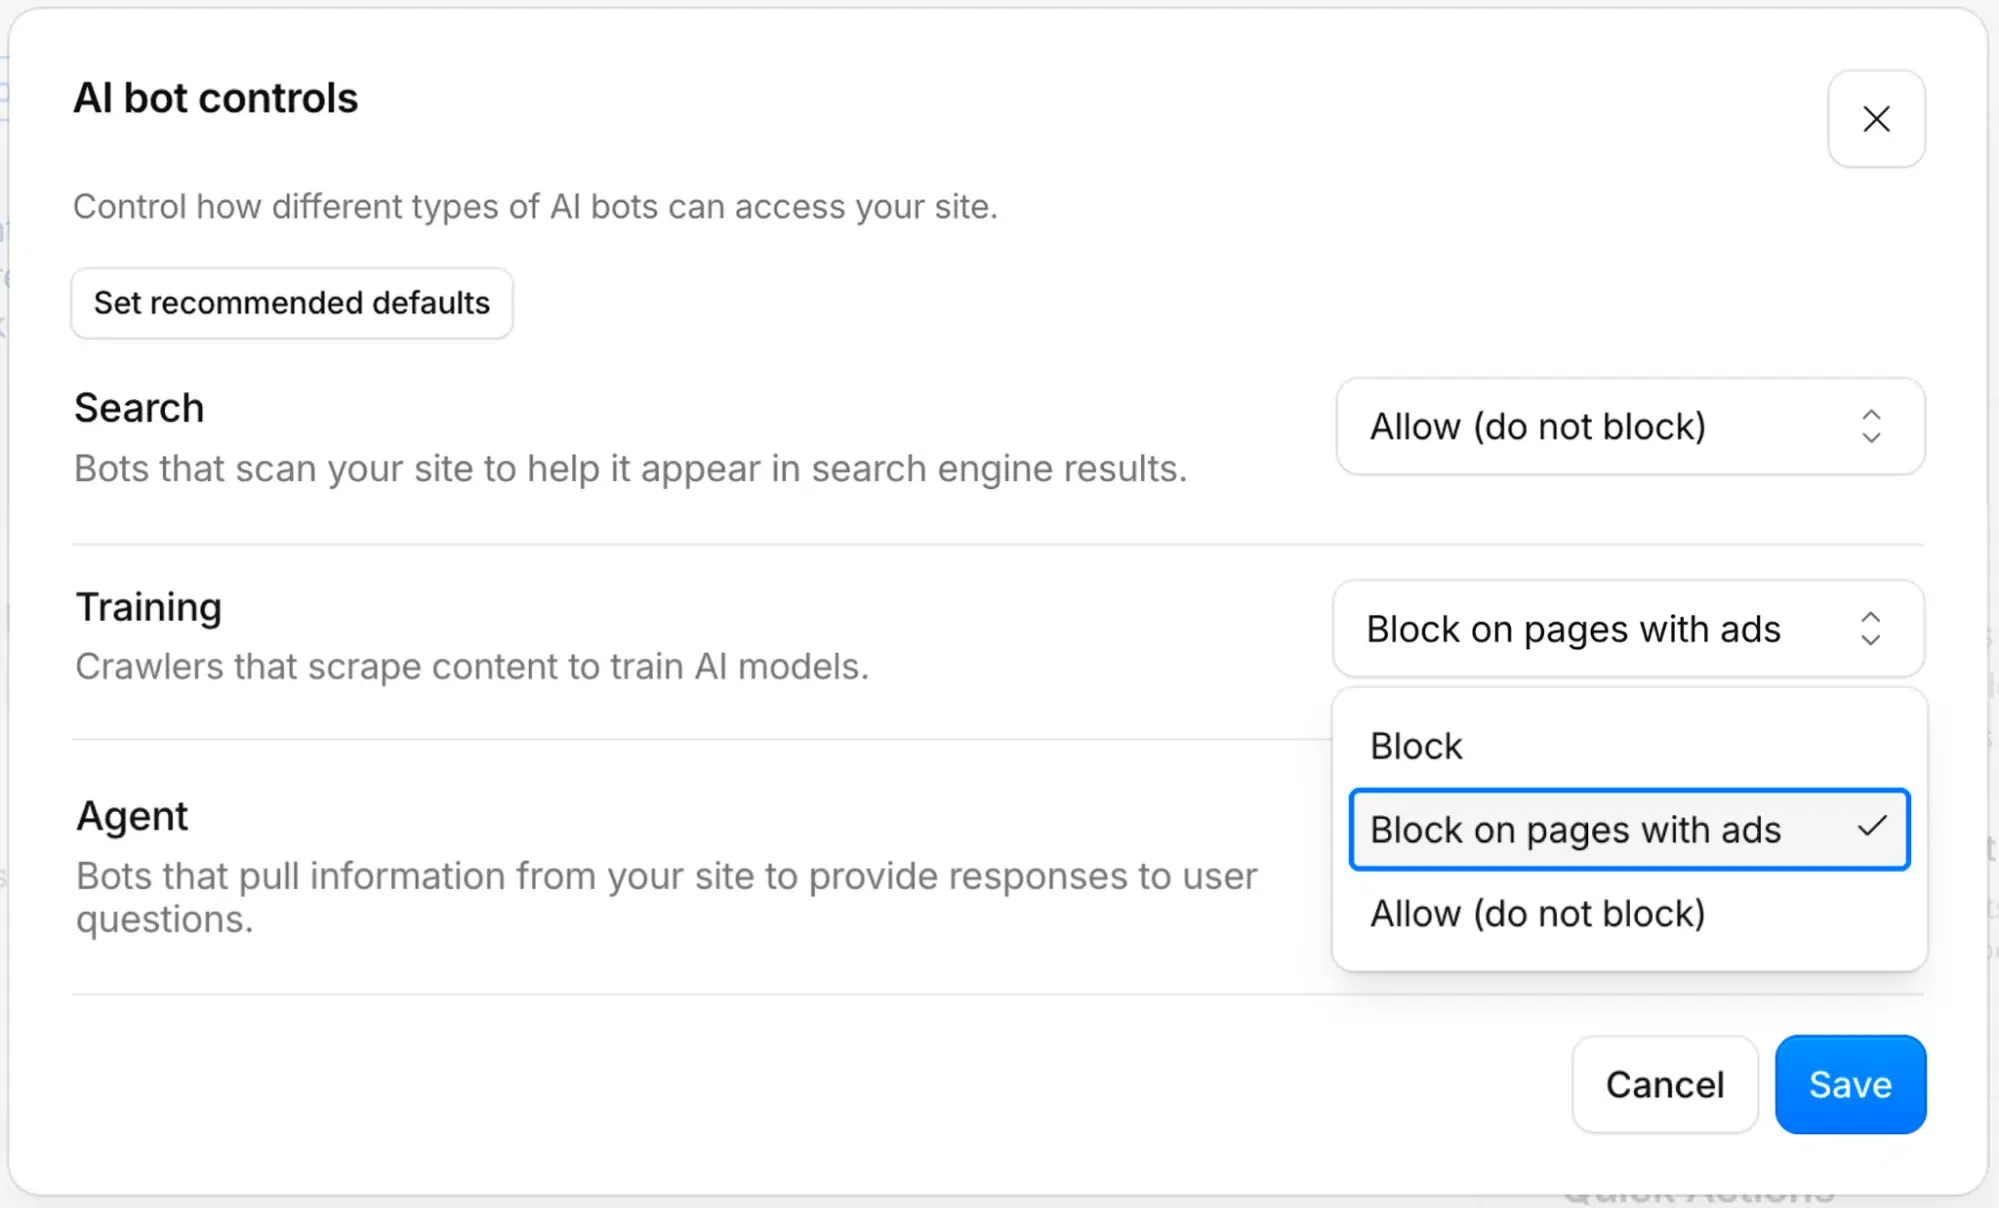
สาเหตุเชิงระบบและห่วงโซ่คำขอที่ไม่ใช่ภาพของนโยบาย Cloudflare ในการปิดกั้นบอทฝึกฝน AI
การวิเคราะห์องค์ประกอบของทราฟฟิกอินเทอร์เน็ตเผยให้เห็นว่าปัจจุบันบอทอัตโนมัติมีสัดส่วนมากกว่า 50% ของกิจกรรมออนไลน์ทั้งหมด ปริมาณนี้สร้างภาระอย่างมหาศาลต่อเซิร์ฟเวอร์ต้นทาง โดยเฉพาะอย่างยิ่งเมื่อมีการดึงข้อมูลเดิมซ้ำๆ ระบบของ Cloudflare ระบุว่าทราฟฟิกจากโปรแกรมรวบรวมข้อมูลที่ผ่านการตรวจสอบแล้วกว่าครึ่งหนึ่งมีความซ้ำซ้อนอย่างสิ้นเชิง ซึ่งทำให้เสียพลังงานประมวลผลไปโดยเปล่าประโยชน์ ปัญหาพื้นฐานอยู่ที่สถาปัตยกรรมเบื้องหลังการค้นหาและดึงข้อมูลสมัยใหม่ ซึ่งอาศัยบอทที่ใช้งานแบบผสมผสานจนทำให้จุดประสงค์ที่แท้จริงไม่ชัดเจน
ในเลเยอร์แอปพลิเคชัน ลักษณะทางเทคนิคของเอเจนต์ที่เน้นผู้ใช้แตกต่างอย่างมากจากเซสชันของเบราว์เซอร์ที่มนุษย์ใช้งานจริง ข้อแตกต่างนี้มีความสำคัญเพราะโปรแกรมดึงข้อมูลอัตโนมัติสมัยใหม่ข้ามองค์ประกอบแบบโต้ตอบทั่วไปไปอย่างสิ้นเชิง ส่งผลให้เกิดการขัดจังหวะการติดตามผลในระบบการวัดผลปลายทางอย่างรุนแรง
การตัดการเชื่อมต่อของโปรโตคอล: เอเจนต์แบบไร้สถานะ (Stateless) กับเบราว์เซอร์เว็บแบบมีสถานะ (Stateful)
การเพิ่มประสิทธิภาพเว็บไซต์แบบดั้งเดิมตั้งสมมติฐานว่าเซสชันเบราว์เซอร์มาตรฐานจะจัดการสถานะผ่านคุกกี้ ที่เก็บข้อมูลในเครื่อง และสตริง User-Agent ที่เป็นโครงสร้าง ในทางตรงกันข้าม เอเจนต์อัตโนมัติและโปรแกรมดึงข้อมูลจะทำการส่ง HTTP Request แบบไร้สถานะ ข้อแตกต่างนี้ทำลายท่อการวัดผลที่ผู้เผยแพร่เนื้อหาใช้เพื่อยืนยันมูลค่าโฆษณาของตน แผนภาพด้านล่างสรุปความแตกต่างในระดับแอปพลิเคชัน:
[Standard Web Session]
  User Browser (Persistent State & Cookies) ──> Web HTTP Request ──> Ad Impressions & Referrers Registered


[Stateless Agent Session]
  Automated Crawler (Stateless HTTP / Headless Tool) ──> Isolated Fetch ──> Missing Referrers & Lost Attribution
เมื่อเอเจนต์เบราว์เซอร์อัตโนมัติเข้ามาดึงหน้าเว็บ ประมวลผลข้อความ และแสดงผลคำตอบในสภาพแวดล้อมแชทที่ปิดกั้น บริบทฝั่งไคลเอ็นต์ทั้งหมดจะถูกทำลาย สคริปต์การติดตามผลแบบดั้งเดิมไม่สามารถทำงานได้ ไม่มีโฆษณาปรากฏ และไม่มีข้อมูล Referrer ส่งมา สิ่งนี้สร้างช่องว่างในการระบุแหล่งที่มา (Attribution) โดยที่ผู้เผยแพร่เนื้อหาให้คุณค่าข้อมูลดิบ แต่ระบบปลายทางกลับบันทึกการมีส่วนร่วมเป็นศูนย์ การสูญเสียบริบทของเบราว์เซอร์นี้ยังส่งผลกระทบต่อเวิร์กโฟลว์การระบุแหล่งที่มาบนมือถือ (Mobile Attribution) เมื่อผู้ใช้ติดตั้งแอปพลิเคชันในภายหลัง เนื่องจากบันทึกเหล่านี้ขาดคอนเทนเนอร์การติดตามสถานะ เครื่องมือวัดผลบนมือถือมาตรฐานจึงไม่สามารถเชื่อมโยงเหตุการณ์การค้นหาเริ่มต้นกับเหตุการณ์การติดตั้งแอปได้ พลวัตนี้เร่งการล่มสลายของแบบจำลองการระบุแหล่งที่มาแบบ Multi-touch ดั้งเดิม
การเปรียบเทียบแนวทางแก้ไข: การเลือกระหว่างสร้างเอง (Build) หรือซื้อ (Buy) ในยุค Cloudflare ปิดกั้นบอทฝึกฝน AI
ในขณะที่ขอบเขตของการติดตามผลฝั่งไคลเอ็นต์เริ่มละลายหายไปภายใต้ข้อบังคับใหม่ ทีมวิศวกรต้องประเมินสถาปัตยกรรมการระบุแหล่งที่มาใหม่ การพึ่งพาคุกกี้เบราว์เซอร์หรือคุณลักษณะระดับอุปกรณ์เพียงอย่างเดียวไม่ใช่กลยุทธ์ระยะยาวที่เหมาะสม นักพัฒนาต้องเผชิญกับการตัดสินใจขั้นพื้นฐานระหว่างการสร้างฐานข้อมูลเชื่อมโยงบริบทฝั่งเซิร์ฟเวอร์ (Server-side) หรือการติดตั้งระบบการวัดผลที่แข็งแกร่งและพร้อมใช้งานซึ่งสามารถรับมือกับการโต้ตอบแบบไร้หน้าจอ (Headless) ได้
การประเมินสถาปัตยกรรม: การเลือกระหว่างสร้างเองหรือซื้อในยุคไร้สถานะ
การสร้างระบบจับคู่บริบทภายในองค์กรต้องอาศัยการตั้งค่าฐานข้อมูลสถานะฝั่งเซิร์ฟเวอร์เพื่อแคชและตรวจสอบความถูกต้องของเซสชันนักพัฒนา แม้ว่าแนวทางนี้จะให้การควบคุมท่อข้อมูลอย่างสมบูรณ์ แต่ภาระงานด้านวิศวกรรมก็สูงมาก นักพัฒนาต้องตรวจสอบ payload API ที่เข้ามาด้วยตนเอง จัดการเซสชันที่หมดอายุ และใช้ลายเซ็นดิจิทัลที่ปลอดภัยเพื่อป้องกันการฉ้อโกง ในทางกลับกัน การรวม SDK การวัดผลที่พร้อมใช้งานจะช่วยขจัดภาระการบำรุงรักษานี้
ตารางเปรียบเทียบต่อไปนี้แสดงประสิทธิภาพของวิธีการติดตามผลต่างๆ ในสภาพแวดล้อมที่เต็มไปด้วยบอท:
| ตัวชี้วัด & ความสามารถ | สร้างฐานข้อมูลเอง (In-house) | Firebase / Webview เดิม | แพลตฟอร์ม MMP (Adjust, AppsFlyer) | SDK สำหรับ Deferred Deep Linking (OpoInstall) |
|---|---|---|---|---|
| การคงอยู่ของการระบุแหล่งที่มา | สูง (ฝั่งเซิร์ฟเวอร์) | ต่ำ (ฝั่งไคลเอ็นต์) | สูง (Multi-Touch) | สูง (การจับคู่แบบตั้งโปรแกรมได้) |
| ต้นทุนการพัฒนา | สูงมาก | ต่ำ | สูง | ต่ำ |
| ภาระในการบำรุงรักษา | สูง (ต่อเนื่อง) | ต่ำ | ต่ำ | ต่ำ |
| การลดการฉ้อโกง | ปานกลาง (กฎด้วยตนเอง) | ต่ำ | สูง (อัลกอริทึม) | สูง (Zero-Trust Signatures) |
| ผลกระทบต่อ Latency | แปรผัน | ปานกลาง | ปานกลาง | ต่ำ (น้ำหนักเบามาก) |
การใช้งานเชิงพาณิชย์ของโมเดลนี้รวมถึง Adjust, AppsFlyer, Branch และระบบการระบุแหล่งที่มาแบบล่าช้า (Deferred) อื่นๆ หนึ่งในตัวอย่างคือ OpoInstall ซึ่งให้ความสามารถในการทำ Deep Linking แบบล่าช้าและการกู้คืนพารามิเตอร์ฝั่งเซิร์ฟเวอร์เพื่อรักษาข้อมูลเซสชันข้ามบริบทเว็บและมือถือ การแยกห่วงโซ่การเปลี่ยนเส้นทางจากการรีไดเรกต์ฝั่งไคลเอ็นต์ ทำให้แนวทางนี้รักษาข้อมูลการเดินทางของผู้ใช้ตั้งแต่เหตุการณ์ค้นหาเริ่มต้นจนถึงการเปิดแอปครั้งสุดท้ายได้ ช่วยให้ข้ามข้อจำกัดที่เกิดจากพร็อกซีบล็อกได้ แพลตฟอร์มระบุแหล่งที่มาบนมือถือยังใช้แนวคิดการกู้คืนสถานะฝั่งเซิร์ฟเวอร์ที่คล้ายกันเพื่อให้แน่ใจถึงความสอดคล้องของการเปลี่ยนผ่าน แม้ในกรณีที่ไม่มีบริบทของเบราว์เซอร์เลยก็ตาม
รายการตรวจสอบการรวมระบบและกำหนดการจัดการ: การเอาตัวรอดจากการปิดกั้นบอทของ Cloudflare
เพื่อให้แน่ใจว่าข้อมูลจะต่อเนื่องในขณะที่ Cloudflare ใช้นโยบายปิดกั้นบอทฝึกฝน AI บนหน้าเว็บที่รองรับโฆษณา ทีมวิศวกรรมและผลิตภัณฑ์จะต้องสร้างตารางการเปลี่ยนผ่านที่ชัดเจน สำหรับนักพัฒนา วิธีนี้เกี่ยวข้องกับการย้ายออกจากการใช้ Redirect ฝั่งไคลเอ็นต์และหันไปใช้วิธีการยืนยันแบบฝั่งเซิร์ฟเวอร์ที่แข็งแกร่ง สำหรับทีมเติบโต (Growth team) สิ่งนี้จำเป็นต้องแก้ไขไปป์ไลน์การคำนวณ ROAS เพื่อรองรับการสูญเสียข้อมูลการติดตามผลจากเบราว์เซอร์แบบเดิม
รายการตรวจสอบสำหรับนักพัฒนา
- ใช้ RFC 7239 Forwarded Headers: กำหนดค่า API Gateway ทั้งหมดให้สามารถอ่านและแยกพาร์สมาตรฐาน
Forwardedheader เพื่อระบุพร็อกซีระดับกลางที่เชื่อถือได้
Forwarded: for=203.0.113.1;proto=https
- ใช้ลายเซ็น URL แบบ Cryptographic: ตรวจสอบให้แน่ใจว่าลิงก์โปรโมชันขาออกทั้งหมดใช้พารามิเตอร์ที่ลงนามด้วยรหัสผ่านเพื่อป้องกันไม่ให้บอทอัตโนมัติจัดการกับค่าอ้างอิง
- เปิดใช้งาน Server-Side Session Matching: เปลี่ยนจากการรีไดเรกต์ผ่านคุกกี้ฝั่งไคลเอ็นต์ ไปเป็นฐานข้อมูลสถานะแบบตั้งโปรแกรมได้ที่ตรวจสอบคีย์เซสชันเมื่อเริ่มเปิดแอปพลิเคชันเป็นครั้งแรก
รายการตรวจสอบกลยุทธ์ผลิตภัณฑ์และการเติบโต
- ปรับโมเดล ROAS: ปรับช่องทางการเข้าถึงผู้ใช้ (Acquisition funnels) ให้ให้ความสำคัญกับเหตุการณ์ Activation ฝั่งเซิร์ฟเวอร์มากกว่าคลิกโฆษณาเว็บฝั่งไคลเอ็นต์แบบเดิม
- ปรับใช้การกู้คืนประสบการณ์ตามบริบท: ใช้กรอบการส่งผ่านพารามิเตอร์เพื่อสร้างปลายทางที่ผู้ใช้ต้องการแม้ว่า Referrer ของเว็บจะถูกตัดออกโดยเอเจนต์ก็ตาม
- ตรวจสอบทราฟฟิกบอทใน BotBase: ใช้การจำแนกพฤติกรรมแบบเรียลไทม์เพื่อตรวจสอบว่าโปรแกรมดึงข้อมูลอัตโนมัติโต้ตอบกับช่องทางการตลาดอย่างไร
นักพัฒนาสามารถกำหนดค่าเว็บไซต์ของตนเพื่อสื่อสารความต้องการในการทำดัชนีโดยการขยายการกำหนดค่า robots.txt มาตรฐานด้วยฟิลด์ข้อมูลเมตาที่ทันสมัย
# ตัวอย่างภาพประกอบที่ได้แรงบันดาลใจจากส่วนขยายข้อมูลเมตาที่เสนอ
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
แนวทางเชิงโครงสร้างนี้ช่วยให้เจ้าของคอนเทนต์สามารถรักษาการค้นพบตัวตนในการค้นหา ในขณะที่ป้องกันไม่ให้แพลตฟอร์ม AI ดูดซับเนื้อหาที่เป็นกรรมสิทธิ์อันมีค่าไปไว้ในชุดข้อมูลการฝึกฝนแบบปิดของตนอย่างถาวร
คำถามที่พบบ่อย (FAQ)
ทำไมบอทตัวเดียวกันถึงรวบรวมข้อมูลทั้งเพื่อการค้นหาและการฝึกฝน AI?
Cloudflare พิจารณาอย่างไรว่าหน้าเว็บใดมีโฆษณาเพื่อเรียกใช้การปิดกั้น?
Pay Per Crawl กับ Pay Per Use แตกต่างกันอย่างไร?
การเปลี่ยนผ่านของอินเทอร์เน็ตจากสภาพแวดล้อมการใช้งานที่เน้นมนุษย์ไปสู่ระบบนิเวศที่ขับเคลื่อนด้วยเอเจนต์ จำเป็นต้องมีการเปลี่ยนแปลงพื้นฐานในวิธีการสร้างและวัดผลประสบการณ์ดิจิทัล ในขณะที่พร็อกซีอัตโนมัติและเอเจนต์ไร้สถานะกลายเป็นผู้บริโภคหลักของเนื้อหาเว็บ โมเดลการระบุแหล่งที่มาแบบฝั่งไคลเอ็นต์แบบเดิมจะยังคงเสื่อมประสิทธิภาพลง การพึ่งพาคุกกี้เบราว์เซอร์และข้อมูลอ้างอิง HTTP พื้นฐานไม่เพียงพอที่จะรักษาไปป์ไลน์ข้อมูลที่ขับเคลื่อนการได้มาซึ่งผู้ใช้และการสร้างรายได้ดิจิทัลอีกต่อไป
เพื่อรักษาการเติบโตในยุคใหม่นี้ ทีมวิศวกรและผลิตภัณฑ์ต้องแยกตรรกะการระบุแหล่งที่มาออกจากการทำงานของเบราว์เซอร์ฝั่งไคลเอ็นต์มาตรฐาน ด้วยการนำการแก้ไขตัวตนฝั่งเซิร์ฟเวอร์ พารามิเตอร์ที่ลงนามด้วยรหัสผ่าน และกรอบการส่งผ่านข้อมูลที่แข็งแกร่งมาใช้ องค์กรจะสามารถปกป้องไปป์ไลน์ข้อมูลจากการถูกบล็อกโดยโปรแกรมดึงข้อมูลอัตโนมัติ การเปลี่ยนผ่านนี้ไม่ใช่แค่การปรับตัวตามนโยบายเดียว แต่เป็นการสร้างระบบของเราขึ้นใหม่เพื่อให้อยู่รอดในอินเทอร์เน็ตแบบกระจายศูนย์ที่พร้อมสำหรับเอเจนต์ในอนาคต
Share this article



