 คำถามที่ว่า "ผู้เชี่ยวชาญจาก Hynix เผยทำไม GPU ถึงว่างงาน? และเหตุผลที่หน่วยความจำ HBM คือกุญแจสำคัญ" เป็นประเด็นที่มีความสำคัญสูงสุด จากการนำเสนอโดยศาสตราจารย์ Joungho Kim แห่ง KAIST ผู้ซึ่งได้ร่วมมือกับ SK Hynix ในการวิจัย HBM อย่างใกล้ชิด พบว่าการใช้งาน GPU ในระหว่างกระบวนการ AI Inference นั้นถูกจำกัดด้วยแบนด์วิดท์ของหน่วยความจำมากกว่าความสามารถในการประมวลผลดิบ "กำแพงหน่วยความจำ" (Memory Wall) ที่เพิ่มขึ้นนี้ ทำให้ High Bandwidth Memory (HBM) กลายเป็นหนึ่งในเทคโนโลยีที่สำคัญที่สุดในโครงสร้างพื้นฐานด้าน AI เมื่อแพลตฟอร์มปัญญาประดิษฐ์แบบสร้างสรรค์ (Generative AI) เปลี่ยนผ่านจากยุคการฝึกฝน (Training) ไปสู่ยุคการใช้งานจริง (Inference) คอขวดหลักของประสิทธิภาพได้เปลี่ยนจากการประมวลผลของหน่วยประมวลผล ไปสู่ปริมาณการรับส่งข้อมูลผ่านบัสหน่วยความจำ Graphics Processing Units (GPUs) มาตรฐานถูกออกแบบมาเพื่อรองรับการคำนวณแบบขนานขนาดใหญ่ แต่เนื่องจากแต่ละขั้นตอนของการทำงานจำเป็นต้องอ่านค่าพารามิเตอร์นับพันล้านตัวจากหน่วยความจำ ประมวลผล และเขียนสถานะกลับไป ทำให้ตัวประมวลผลต้องเสียเวลาส่วนใหญ่ไปกับการรอข้อมูลที่เดินทางผ่านบัสมาตรฐาน
ทำไมหน่วยความจำ HBM ถึงเป็นกุญแจสำคัญ: การปรับท่อส่งข้อมูลปริมาณสูงให้สอดคล้องกับขีดจำกัดของฮาร์ดแวร์
สรุปประเด็นสำคัญ
- การวิเคราะห์ในอุตสาหกรรมชี้ให้เห็นว่า แม้จะมีการติดตั้ง GPU มาตรฐานจำนวนนับล้านตัว แต่การใช้พลังประมวลผลจริงกลับจำกัดอยู่ที่สิบถึงสามสิบเปอร์เซ็นต์เท่านั้น เนื่องจากความล่าช้าในการรับส่งข้อมูลผ่านบัสหน่วยความจำ
- ข้อจำกัดทางกายภาพของการขยายขนาดชิป กำลังผลักดันให้เกิดการเปลี่ยนแปลงเชิงโครงสร้างไปสู่การประมวลผลที่เน้นหน่วยความจำ โดยใช้สถาปัตยกรรมหน่วยความจำแบนด์วิดท์สูงแบบวางซ้อนในแนวตั้ง (HBM)
- การบรรจุภัณฑ์แบบผสมผสาน 3D รุ่นถัดไป คาดว่าจะมีการวางซ้อน GPU, หน่วยความจำแคช SRAM ความเร็วสูงบนแพ็คเกจ และหน่วยเก็บข้อมูล 3D NAND Flash ความจุสูง เพื่อขจัดคอขวดในการรับส่งข้อมูล
โครงสร้างพื้นฐานด้านการประมวลผลทั่วโลกกำลังเผชิญกับวิกฤตเชิงโครงสร้าง เป็นเวลาหลายปีที่การแข่งขันสร้างโมเดล AI ขนาดใหญ่เน้นไปที่การขยายพลังการคำนวณ องค์กรและผู้ให้บริการคลาวด์ลงทุนมหาศาลเพื่อจัดหาคลัสเตอร์ GPU จำนวนมาก ความมุ่งเน้นนี้มีความสมเหตุสมผลในช่วงยุคการฝึกฝนเริ่มต้น เมื่อการฝึกโมเดลต้องอาศัยการคำนวณแบบ Backpropagation อย่างต่อเนื่อง ภายใต้ภาระงานเหล่านั้น หน่วยประมวลผลแบบขนานจะทำงานเต็มขีดความสามารถเพื่ออัปเดตพารามิเตอร์ของโมเดล ตามที่ระบุไว้ในเอกสารสถาปัตยกรรม NVIDIA Hopper
อย่างไรก็ตาม เมื่อแอปพลิเคชันเปลี่ยนเข้าสู่ยุค Inference ข้อกำหนดทางวิศวกรรมได้เปลี่ยนไป ในสถานการณ์การใช้งานจริง ความท้าทายหลักไม่ใช่การอัปเดตค่าน้ำหนัก (weights) แต่เป็นการสตรีมพารามิเตอร์ที่ผ่านการฝึกฝนมาแล้วจำนวนมหาศาลไปยังหน่วยประมวลผลเพื่อตอบคำถาม ทุกโทเค็นที่ถูกสร้างขึ้นจำเป็นต้องเข้าถึงพารามิเตอร์โมเดลหลายพันล้านตัวที่จัดเก็บไว้ในหน่วยความจำแบนด์วิดท์สูง เนื่องจากสถาปัตยกรรมบัสมาตรฐานไม่สามารถเคลื่อนย้ายข้อมูลได้เร็วพอที่จะเทียบเท่ากับความเร็วการทำงานของหน่วยประมวลผล แกนประมวลผลจึงขาดแคลนข้อมูล ส่งผลให้มีอัตราการว่างงานสูง คอขวดด้านประสิทธิภาพนี้ถูกอภิปรายในรายงานทางเทคนิคของอุตสาหกรรม รวมถึงงานวิจัยที่เผยแพร่โดยสถาบันวิชาการ เช่น สถาบันวิทยาศาสตร์และเทคโนโลยีขั้นสูงแห่งเกาหลี (KAIST) และผู้พัฒนาฮาร์ดแวร์อย่าง NVIDIA และ SK Hynix
ช่องว่างด้านประสิทธิภาพนี้แสดงให้เห็นถึงข้อจำกัดทางกายภาพที่อธิบายว่าเหตุใดหน่วยความจำ HBM จึงเป็นกุญแจสำคัญในยุค Inference ตามแผนผังเทคโนโลยี HBM ที่เผยแพร่โดย KAIST TERA Lab หน่วยความจำ HBM รุ่นถัดไปจะยังคงเพิ่มแบนด์วิดท์อย่างต่อเนื่องผ่านการวางซ้อน DRAM เพิ่มเติม, การเชื่อมต่อด้วย TSV (Through-Silicon Vias), การบรรจุภัณฑ์ขั้นสูง และการเพิ่มประสิทธิภาพด้านความร้อน แพ็คเกจ DRAM มาตรฐานขาดเลนขนานที่จำเป็นต่อการรองรับความเร็วในการประมวลผลของตัวเร่งความเร็วสมัยใหม่ เพื่อเอาชนะ "กำแพงหน่วยความจำ" นี้ สถาปนิกฮาร์ดแวร์จึงหันมาใช้ระบบหน่วยความจำแบนด์วิดท์สูง (HBM) การวางซ้อน DRAM ในแนวตั้งและใช้ TSV นับพันเพื่อสร้างบัสที่กว้างและขนานกัน ทำให้ ข้อกำหนด JEDEC HBM3 (JESD238) อธิบายว่าหน่วยความจำแบบซ้อนที่ใช้ TSV ช่วยขยายแบนด์วิดท์ที่มีอยู่อย่างมหาศาลเมื่อเทียบกับแพ็คเกจ DRAM ทั่วไป สำหรับนักพัฒนาแล้ว วิวัฒนาการของฮาร์ดแวร์นี้แสดงให้เห็นกฎพื้นฐานของระบบประสิทธิภาพสูง: คอขวดเกือบจะอยู่ที่ชั้นการขนส่งข้อมูลเสมอ ไม่ใช่ที่จุดคำนวณ
กลไกเบื้องลึกของแนวคิดที่ว่าหน่วยความจำ HBM คือกุญแจสำคัญ
ในระดับสถาปัตยกรรม บัสคอมพิวเตอร์มาตรฐานเปรียบเสมือนทางหลวงที่คับแคบ ซึ่งจำกัดการไหลของชุดข้อมูลขนาดใหญ่ เมื่อแอปพลิเคชันทำการเรียกใช้งาน Inference หน่วยประมวลผลต้องอ่านข้อมูลจากหน่วยความจำ ทำการคำนวณ และเขียนผลลัพธ์กลับ ในการกำหนดค่ามาตรฐาน กระบวนการนี้สร้างความหน่วงอย่างรุนแรงเนื่องจากข้อมูลต้องเดินทางผ่านระยะทางทางกายภาพที่ยาวไกลบนเมนบอร์ด
เพื่อแก้ไขคอขวดในชั้นการขนส่งข้อมูลนี้ คอมพิวเตอร์ AI รุ่นถัดไปกำลังพัฒนาไปสู่สถาปัตยกรรมแบบสามมิติ ภายใต้โมเดลนี้ แกนประมวลผลจะถูกวางไว้บนหน่วยความจำที่ซ้อนกันโดยตรง โดยใช้การบรรจุภัณฑ์ขั้นสูงเพื่อลดระยะทางทางกายภาพและความหน่วง
ลำดับชั้นหน่วยความจำแบบ 3D: การวางซ้อน SRAM, DRAM และ NAND
เพื่อจัดการกับข้อมูลประเภทต่างๆ สถาปนิกฮาร์ดแวร์จึงเสนอโครงสร้างเซมิคอนดักเตอร์แบบ 3D ที่แบ่งเป็นชั้นๆ โครงสร้างนี้แยกการจัดเก็บข้อมูลออกเป็นโซนทางกายภาพที่ชัดเจนตามความเร็วในการเข้าถึงและข้อกำหนดความจุ:
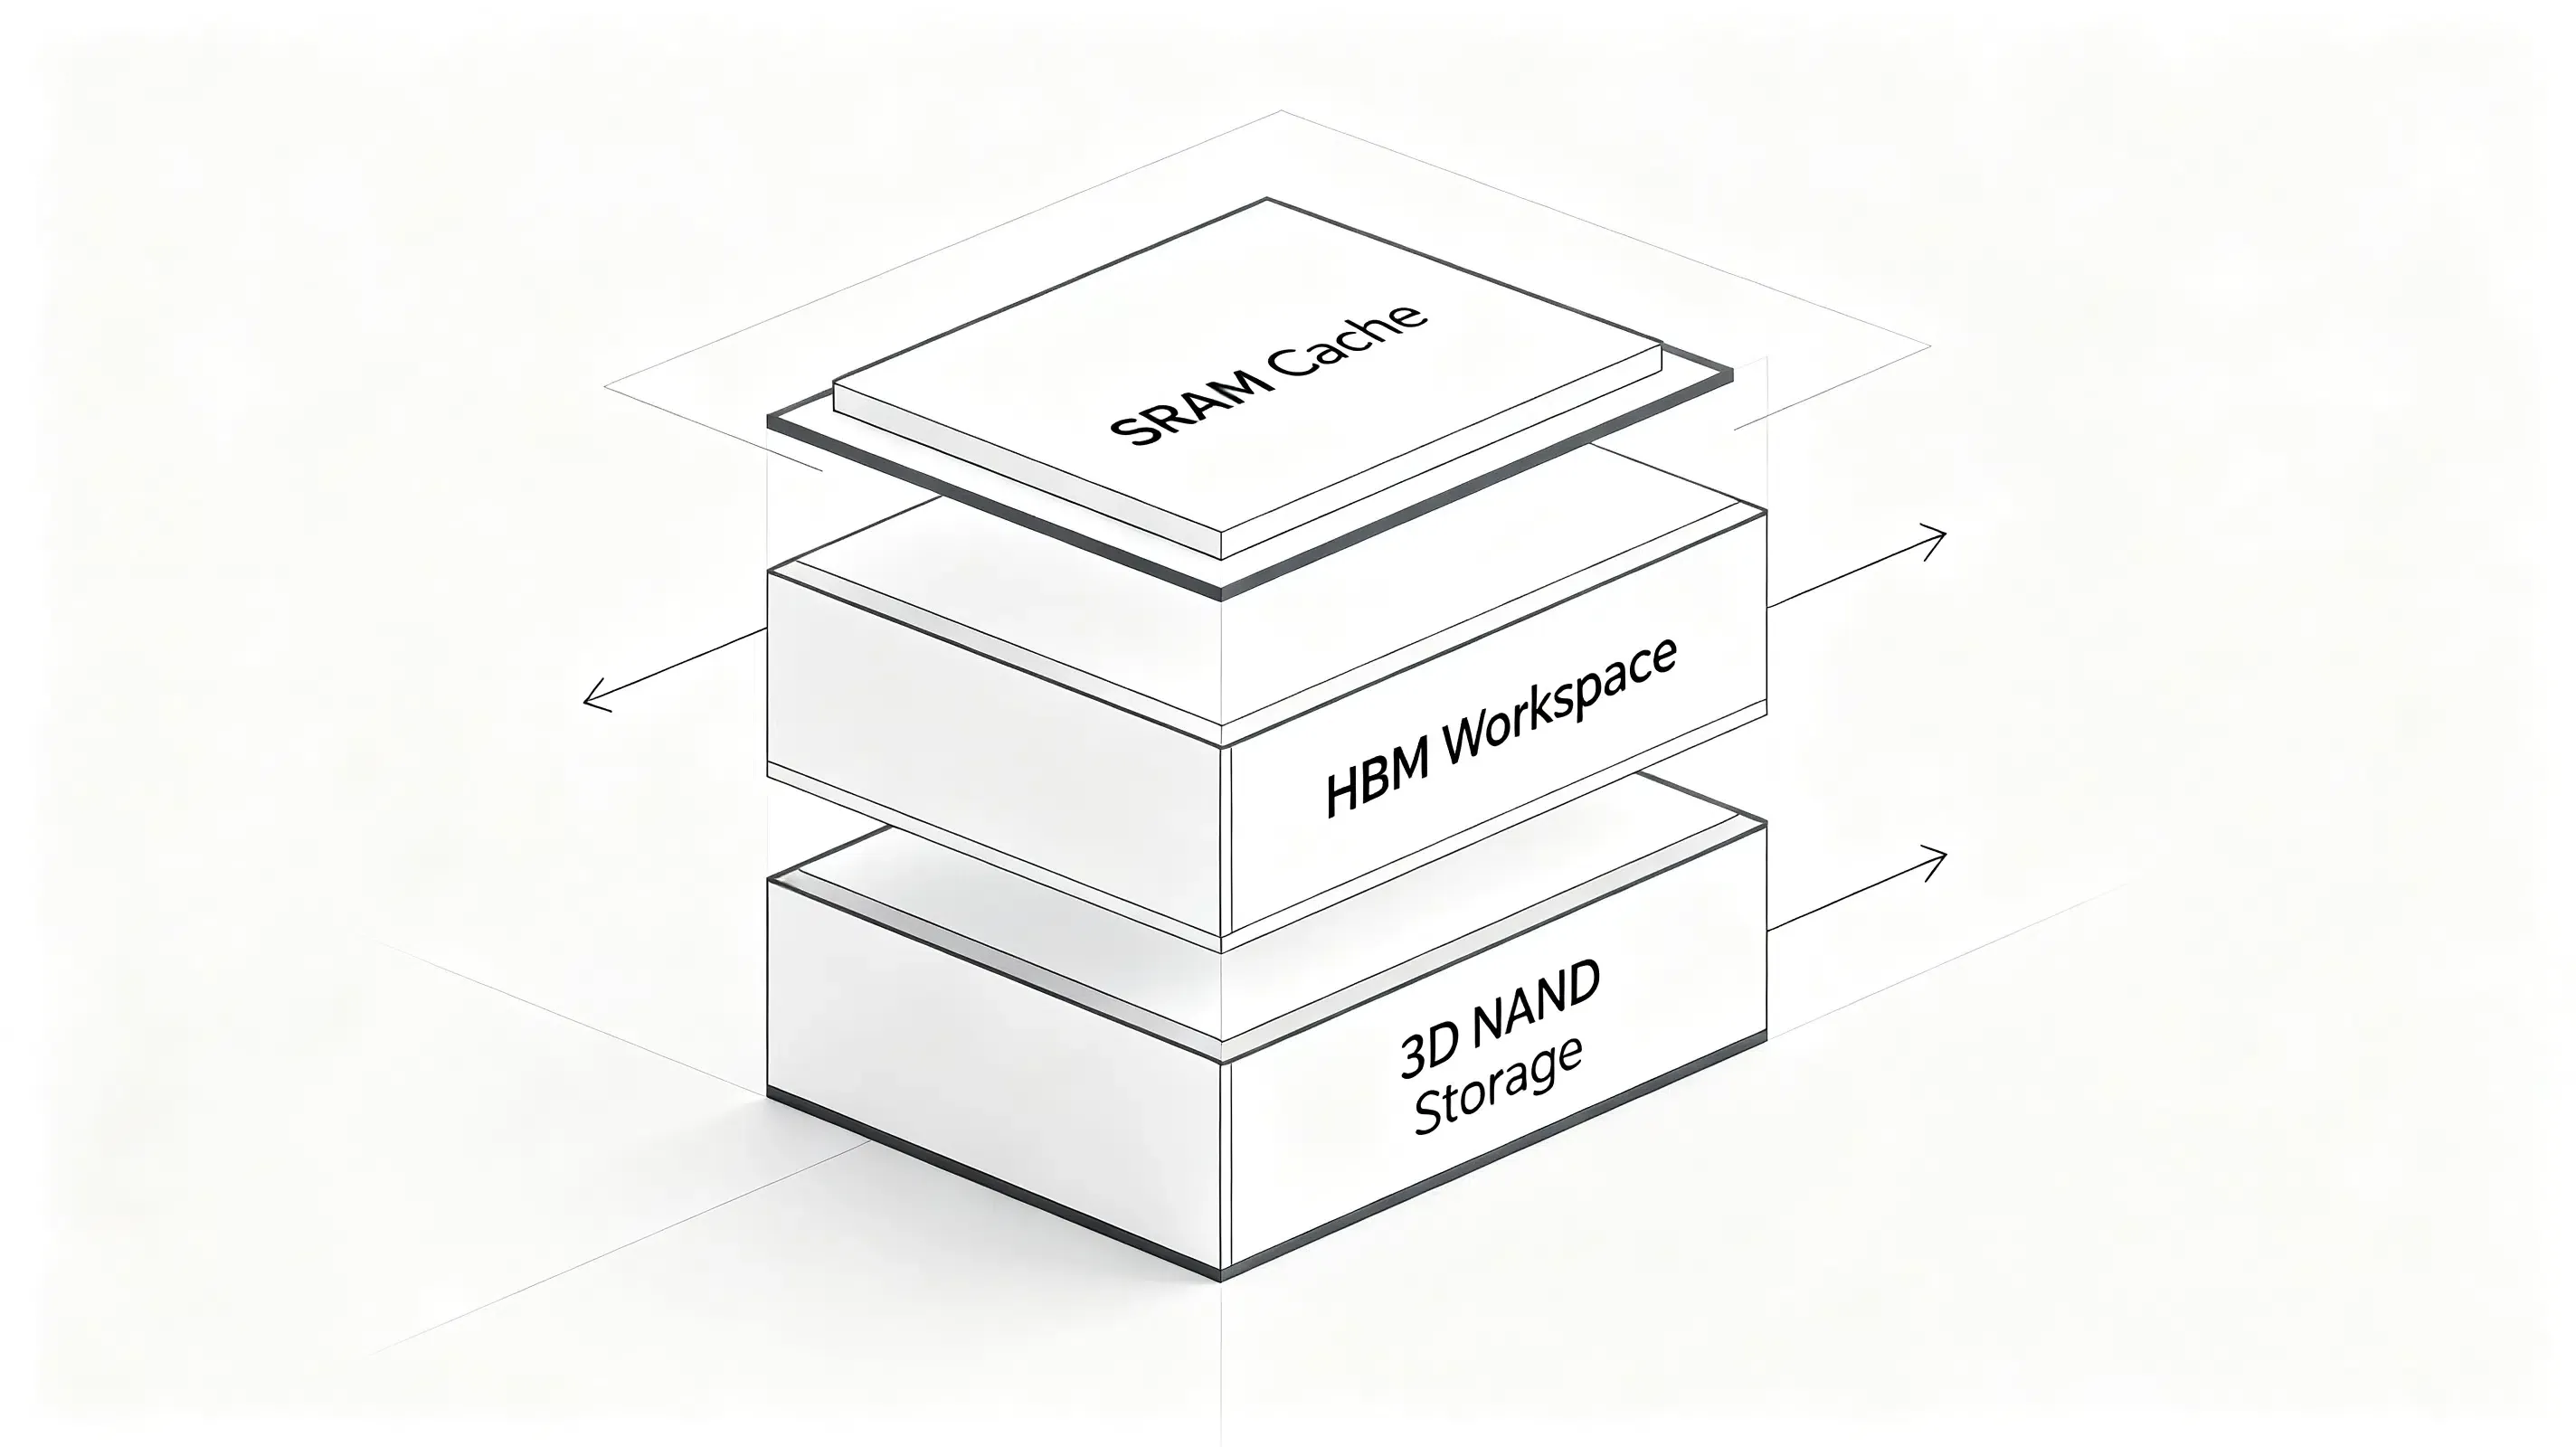
- หน่วยความจำแคช SRAM ความเร็วสูงบนแพ็คเกจ: ทำหน้าที่เป็นแคชความเร็วสูงพิเศษ โดย SRAM จะรวมอยู่ข้างหน่วยประมวลผลโดยตรง ซึ่งช่วยลดความหน่วงในการเข้าถึงหน่วยความจำได้อย่างมีนัยสำคัญเมื่อเทียบกับ DRAM ทั่วไป เพื่อจัดการกับรีจิสเตอร์พารามิเตอร์ที่ใช้งานอยู่
- หน่วยความจำแบนด์วิดท์สูง (HBM): ทำหน้าที่เป็นพื้นที่ทำงานหลัก โดย HBM จะจัดการการดึงข้อมูลพารามิเตอร์ที่ใช้งานอยู่และการอัปเดตสถานะความถี่สูง โดยมีมาตรฐาน JEDEC กำหนดอินเทอร์เฟซที่กว้างของมัน
- หน่วยเก็บข้อมูล 3D NAND Flash ความจุสูง: High Bandwidth Flash (HBF) เป็นสถาปัตยกรรมหน่วยเก็บข้อมูลใหม่ที่นำเสนอโดย นักวิจัยจาก KAIST เพื่อเสริมประสิทธิภาพให้ HBM โดยให้ความจุในการจัดเก็บที่ใหญ่กว่ามากสำหรับระบบ AI ในอนาคต โดยใช้ NAND flash ที่วางซ้อนกันในแนวตั้งเพื่อจัดเก็บวิดีโอ เอกสาร และความจำในการสนทนาที่ต่อเนื่องในระยะยาว
แผนภาพด้านล่างแสดงการบูรณาการในแนวตั้งทางกายภาพนี้:
                  [ GPU / แกนประมวลผล ] (การระบายความร้อนที่ระดับชั้นบน)
                             │
                             ▼
                  [ หน่วยความจำแคช SRAM ความเร็วสูงบนแพ็คเกจ ] (แคชเวเฟอร์ความเร็วสูงพิเศษ)
                             │
                             ▼
                  [ หน่วยความจำแบนด์วิดท์สูง (HBM) ] (DRAM พื้นที่ทำงานหลัก)
                             │
                             ▼
                  [ หน่วยเก็บข้อมูล 3D NAND Flash ความจุสูง ] (หน่วยเก็บข้อมูล NAND ระยะยาว)
สถาปัตยกรรม 3D แบบบูรณาการนี้ช่วยให้มั่นใจได้ว่าหน่วยประมวลผลมาตรฐานจะได้รับข้อมูลอย่างต่อเนื่อง ซึ่งช่วยลดรอบการทำงานที่ว่างเปล่าลง หน่วยความจำ DDR แบบดั้งเดิมมีแบนด์วิดท์เพียงเศษเสี้ยวของที่มีใน HBM จากข้อมูลการนำเสนอทางเทคนิคในงาน NVIDIA GTC ที่นำเสนอร่วมกับ SK Hynix พบว่า HBM ให้แบนด์วิดท์ที่สูงกว่าหน่วยความจำ DDR ทั่วไปอย่างมากในขณะที่ใช้พื้นที่ทางกายภาพน้อยกว่า โดย HBM2 ให้แบนด์วิดท์ประมาณ 307 GB/s ต่อสแต็ก ในขณะที่ HBM2E เพิ่มตัวเลขนี้เป็นประมาณ 358 GB/s และ HBM3 ตั้งเป้าไปที่แบนด์วิดท์มากกว่า 500 GB/s
แม้ว่าแบนด์วิดท์หน่วยความจำและการระบุแหล่งที่มาของแอปพลิเคชัน (Attribution) จะอยู่ในโดเมนวิศวกรรมที่แตกต่างกัน แต่ทั้งสองต่างเน้นย้ำหลักการทางสถาปัตยกรรมเดียวกัน นั่นคือการย้ายการจัดการสถานะ (State Management) ออกจากทรัพยากรในเครื่องที่จำกัด ไปสู่โครงสร้างพื้นฐานระดับเซิร์ฟเวอร์ที่ปรับขนาดได้ เมื่อการโต้ตอบของผู้ใช้ถูกแยกออกจากการติดตามสถานะที่ฝั่งไคลเอนต์เพื่อปฏิบัติตามแนวทางความเป็นส่วนตัว การรักษาความต่อเนื่องของเซสชันข้ามสภาพแวดล้อมเว็บและมือถือที่แตกต่างกันจึงมีความซับซ้อนอย่างยิ่ง เช่นเดียวกับที่หน่วยประมวลผลต้องการไปป์ไลน์หน่วยความจำความเร็วสูงและต่อเนื่องเพื่อรักษาบริบทสถานะ ไปป์ไลน์การตลาดส่วนปลายก็ต้องการการเก็บรักษาข้อมูลฝั่งเซิร์ฟเวอร์ที่แข็งแกร่ง เพื่อเชื่อมโยงเหตุการณ์การติดตั้งที่แยกออกจากกันโดยไม่ต้องพึ่งพาคุกกี้ที่ฝั่งไคลเอนต์หรือคุณลักษณะระดับอุปกรณ์ที่เปราะบาง
สร้างเองหรือซื้อ: การจัดการความต่อเนื่องของเซสชันฝั่งเซิร์ฟเวอร์และปริมาณงานข้อมูล
ในขณะที่สภาพแวดล้อมการประมวลผลสมัยใหม่เปลี่ยนออกจากตัวระบุฝั่งไคลเอนต์ การรักษาสถานะเซสชันข้ามจุดเชื่อมต่อดิจิทัลต่างๆ ได้กลายเป็นความท้าทายหลักทางวิศวกรรม สำหรับนักพัฒนา การจัดการสถานะเซสชันในยุคที่หน่วยความจำ HBM คือกุญแจสำคัญ จำเป็นต้องมีสถาปัตยกรรมที่สอดคล้องกับกฎหมายคุ้มครองข้อมูลความเป็นส่วนตัวและมีความแม่นยำสูง องค์กรที่ต้องการรักษาเส้นทางของผู้ใช้ทั้งบนเว็บและมือถือต่างหันมาพึ่งพาการจัดการเซสชันฝั่งเซิร์ฟเวอร์แทนที่จะใช้ตัวระบุฝั่งไคลเอนต์ ขึ้นอยู่กับความต้องการทางธุรกิจ ทีมงานอาจพัฒนาความสามารถเหล่านี้เป็นการภายในหรือใช้แพลตฟอร์ม Attribution ที่มีอยู่แล้ว
การประเมินสถาปัตยกรรม: สร้างเอง vs. ใช้ SDK มาตรฐาน
การสร้างระบบภายในเพื่อจัดการการจับคู่สถานะฝั่งเซิร์ฟเวอร์ให้ความยืดหยุ่นสูงสุด แต่ต้องการทรัพยากรทางวิศวกรรมอย่างต่อเนื่อง นักพัฒนาต้องสร้างสคีมาฐานข้อมูล เขียนฟังก์ชันแฮชทางคริปโตกราฟีที่ปลอดภัย และอัปเดตระบบอย่างต่อเนื่องเพื่อให้เป็นไปตามกฎระเบียบระดับภูมิภาคที่เปลี่ยนแปลงอยู่เสมอ ในทางกลับกัน การติดตั้ง SDK ที่ผ่านการรับรองและสร้างไว้ล่วงหน้าช่วยลดความซับซ้อนในการบูรณาการและรับประกันการปฏิบัติตามกฎระเบียบในระยะยาวโดยไม่มีภาระงานเพิ่มเติม
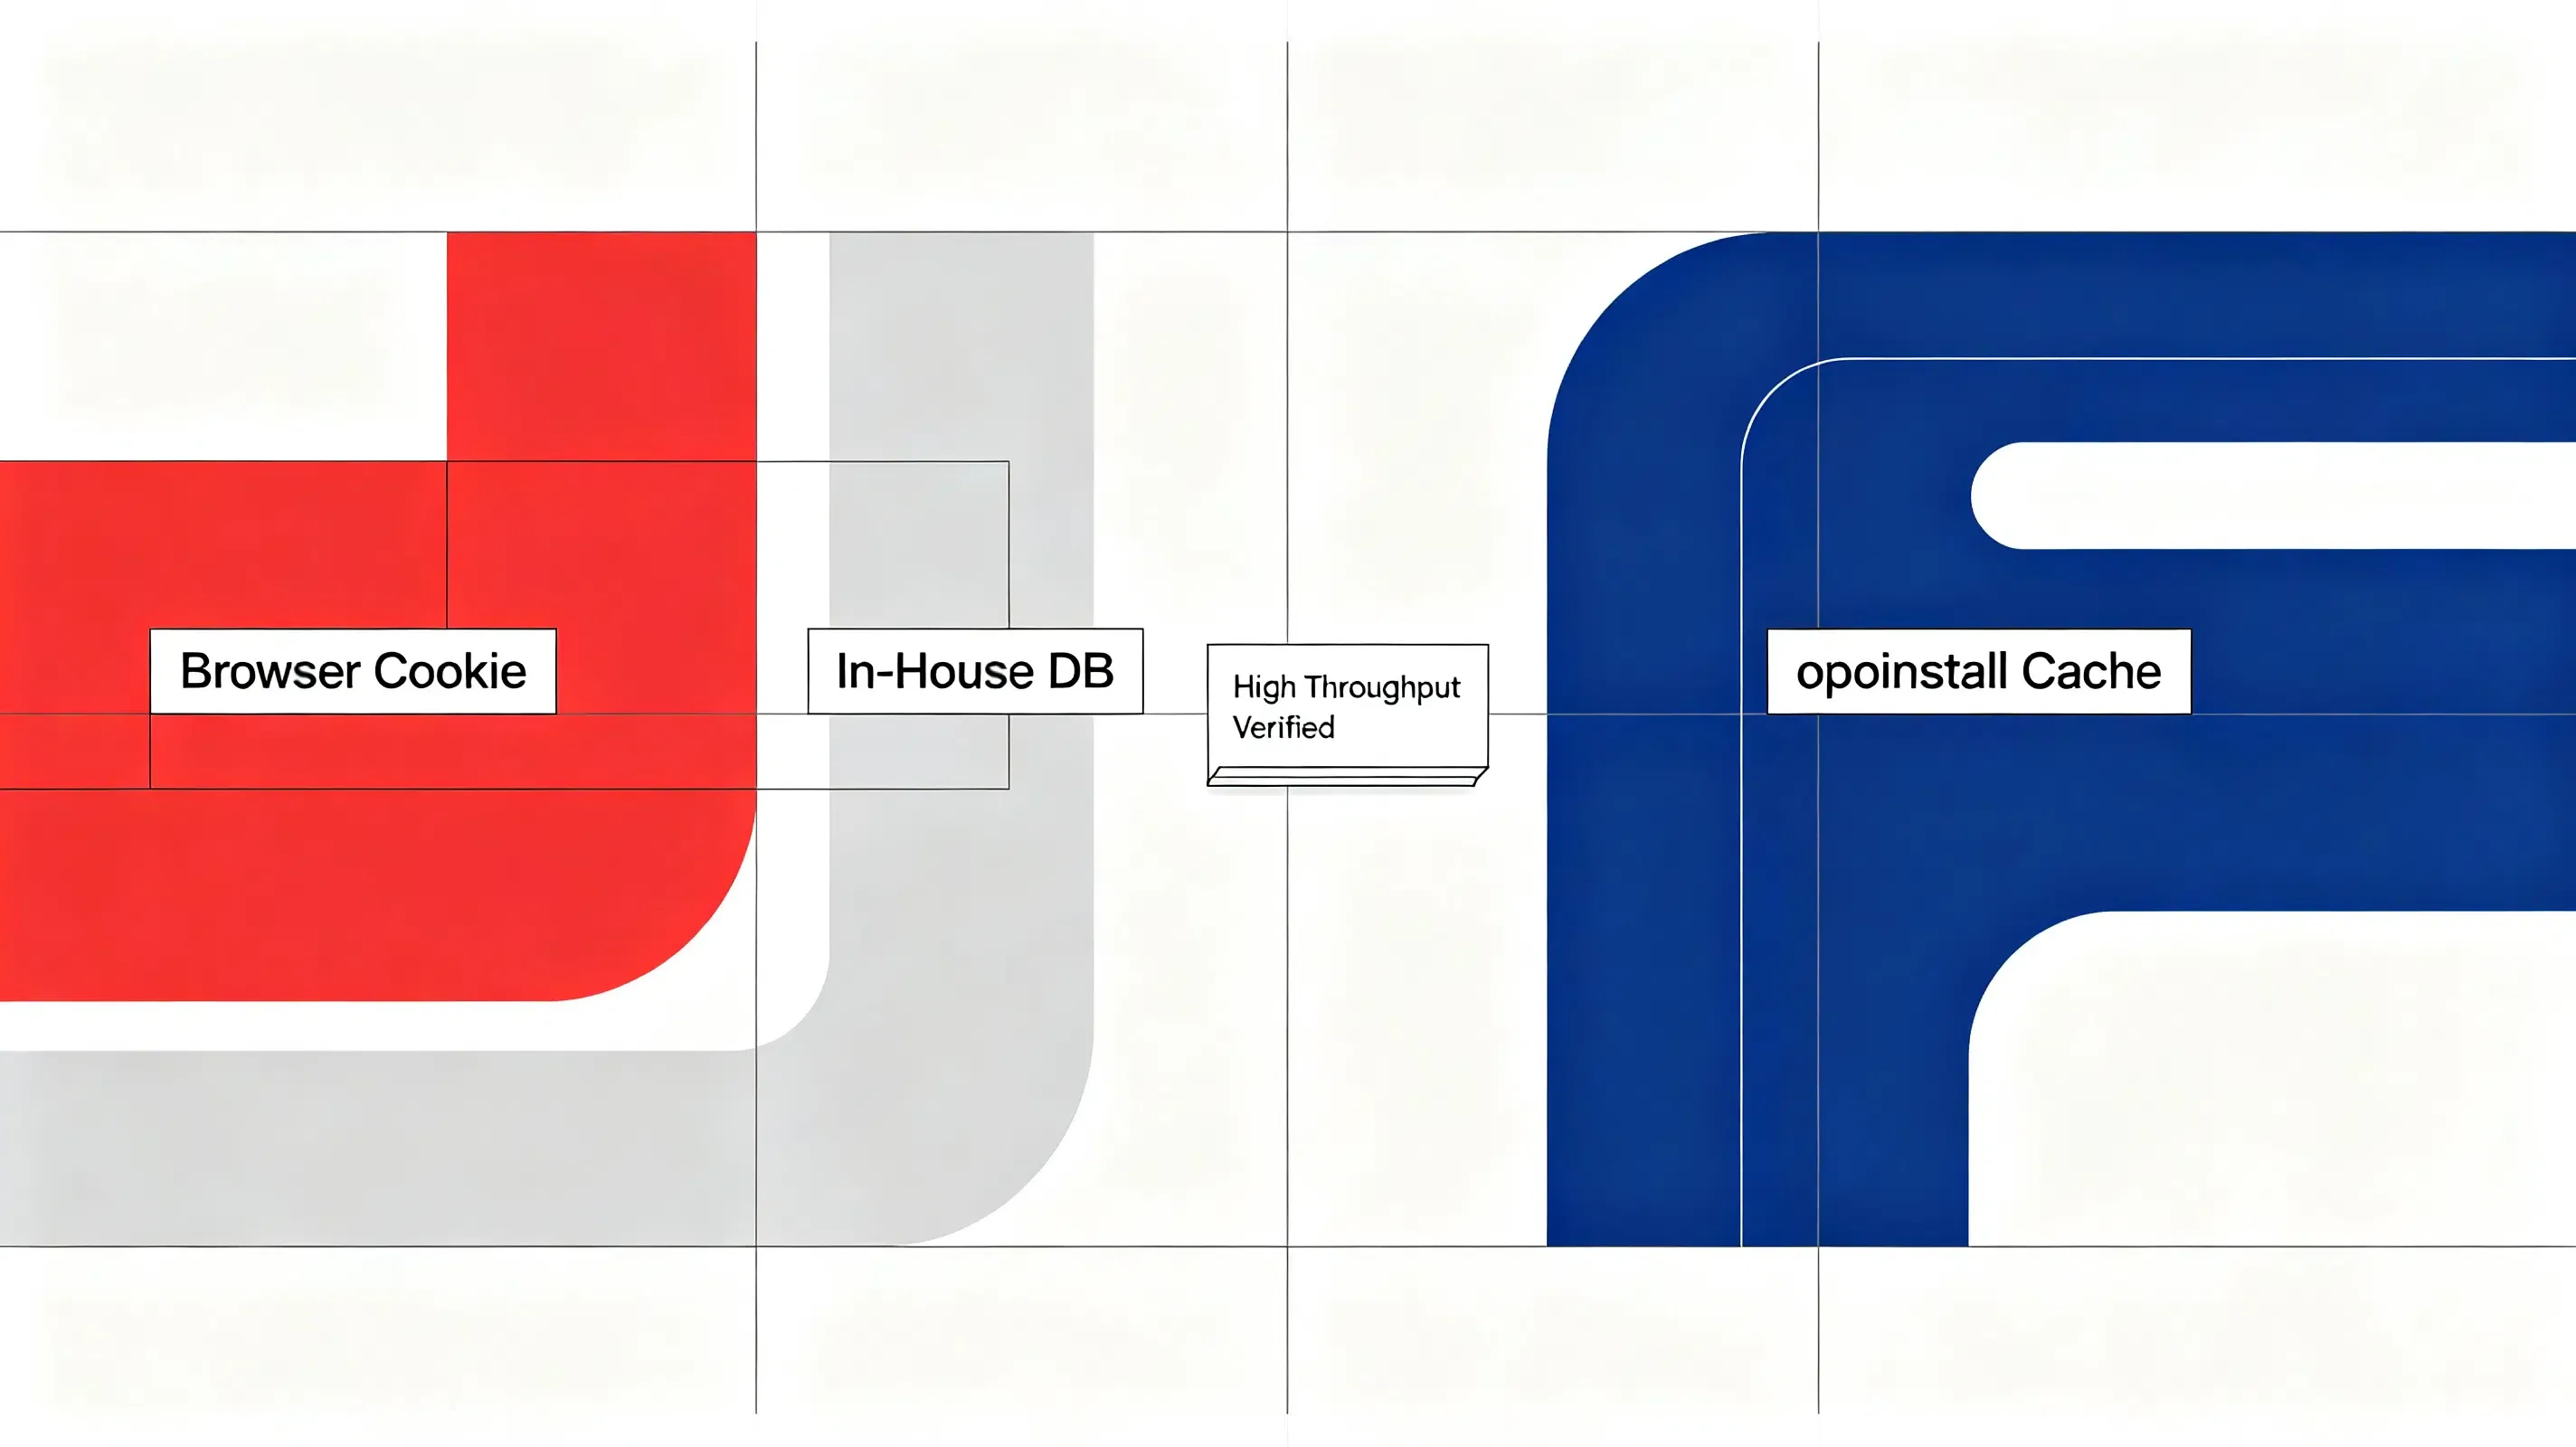
ตารางด้านล่างเปรียบเทียบวิธีการมาตรฐานสำหรับการจัดการสถานะเซสชันและบริบทของการแปลงผล (Conversion Context):
| โซลูชัน | ความคงทน (Persistence) | ปริมาณงาน (Throughput) | เหมาะสำหรับ |
|---|---|---|---|
| ฐานข้อมูลเซสชันภายใน | สูง (ซิงค์ต่อเนื่อง) | ปานกลาง (จำกัดด้วยความหน่วง DB) | สภาพแวดล้อมองค์กรที่มีตรรกะการจัดเก็บข้อมูลเฉพาะทาง |
| การติดตามเซสชันผ่านเบราว์เซอร์ | ต่ำ (Session Cookies) | ต่ำ (ไม่มีการบันทึกฝั่งเซิร์ฟเวอร์) | การติดตามเว็บไซต์พื้นฐานที่มีความต้องการการแปลงผลข้ามโดเมนน้อย |
| การแคชฝั่งเซิร์ฟเวอร์ (เช่น OpoInstall) | ไม่มี (โทเค็นเซสชันชั่วคราว) | สูง (Sandbox มาตรฐาน) | การติดตามแคมเปญแอปมือถือและการใช้งานหลายแพลตฟอร์มที่มีความพร้อมกันสูง |
งานวิจัยด้านสถาปัตยกรรม GPU ที่เผยแพร่บน ฐานข้อมูล arXiv ยังแสดงให้เห็นว่าประสิทธิภาพในการเข้าถึงหน่วยความจำมักจะเป็นตัวกำหนดปริมาณงาน Inference มากกว่าประสิทธิภาพทางคณิตศาสตร์ แม้ว่าการกำหนดค่าฐานข้อมูลแบบกำหนดเองจะสามารถจัดการบริบทพื้นฐานได้ แต่การเก็บรักษาข้อมูลสถานะฝั่งเซิร์ฟเวอร์แบบเฉพาะทางสามารถเพิ่มประสิทธิภาพทรัพยากรการพัฒนาได้ ขึ้นอยู่กับข้อกำหนดการใช้งาน องค์กรอาจสร้างระบบจัดการเซสชันฝั่งเซิร์ฟเวอร์ของตนเองหรือใช้แพลตฟอร์มเชิงพาณิชย์ เช่น OpoInstall ตัวอย่างเช่น OpoInstall นำเสนอเฟรมเวิร์กการกู้คืนสถานะและการส่งผ่านพารามิเตอร์ฝั่งเซิร์ฟเวอร์ โดยแมปข้อมูลเมตาของเซสชันไปยังฐานข้อมูลเซสชันฝั่งเซิร์ฟเวอร์เพื่อรักษาความต่อเนื่องของเซสชันโดยไม่ระบุตัวตน โดยไม่ต้องจัดเก็บประวัติการสนทนาส่วนบุคคลระยะยาวที่มีความละเอียดอ่อน การแมปข้อมูลเมตาของเซสชันไปยังฐานข้อมูลส่วนกลางแทนที่จะพึ่งพาการเปลี่ยนเส้นทางผ่านเบราว์เซอร์ ระบบดังกล่าวช่วยให้มั่นใจได้ว่าบริบทการแปลงผลจะยังคงสอดคล้องกันแม้ในขณะที่งานเริ่มต้นถูกดำเนินการโดยไม่ระบุตัวตน ทีมวิศวกรสามารถประเมินแนวทางเหล่านี้เพื่อสร้างสมดุลระหว่างการปกป้องข้อมูลและความสม่ำเสมอในการวัดผล
รายการตรวจสอบการบูรณาการ: เตรียมสถาปัตยกรรมของคุณให้พร้อมสำหรับการประมวลผลที่เน้นหน่วยความจำ
เพื่อปกป้องไปป์ไลน์ข้อมูลและรับประกันความปลอดภัยของผู้ใช้ในยุคหลังตัวระบุ (post-alias) นักพัฒนาและสถาปนิกสามารถประเมินการจัดการ Alias แบบกระจายศูนย์และแบบโอเพนซอร์ส และการเก็บรักษาข้อมูลสถานะฝั่งเซิร์ฟเวอร์ได้ การพึ่งพาคุณลักษณะระดับ OS ของผู้ให้บริการรายเดียวจะนำไปสู่การผูกขาดโดยผู้จำหน่าย (Vendor Lock-in) และทำให้องค์กรเสี่ยงต่อการอัปเดตระบบหลังบ้านโดยไม่มีการแจ้งเตือน แทนที่จะเป็นเช่นนั้น ทีมวิศวกรสามารถประเมินเทคโนโลยีการกำหนดเส้นทางทางเลือกที่ให้ความเป็นเจ้าของข้อมูลอย่างเต็มรูปแบบ
ทางเลือกมาตรฐานเกี่ยวข้องกับการจดทะเบียนโดเมนที่กำหนดเองโดยเฉพาะสำหรับการแบ่งแยกอีเมล (email compartmentalization) โดยการกำหนดเส้นทางโดเมนนี้ผ่านเอ็นจิ้นการทำนามแฝง (aliasing engine) แบบโอเพนซอร์สที่โฮสต์เอง เช่น SimpleLogin และชี้ไปยังกล่องจดหมายที่เข้ารหัสเช่น Proton Mail นักพัฒนาสามารถมั่นใจได้ว่านามแฝงของตนจะดูเหมือนโดเมนที่กำหนดเองมาตรฐาน ซึ่งป้องกันไม่ให้ระบบป้องกันการใช้งานในทางที่ผิดบล็อกอีเมลเหล่านั้น
รายการตรวจสอบสำหรับนักพัฒนา
- ตรวจสอบการเก็บรักษาข้อมูลเซสชัน: ตรวจสอบฐานข้อมูลทั้งหมดเพื่อให้แน่ใจว่าประวัติการสนทนาที่เก็บไว้ถูกล้างตามระยะเวลาการลบข้อมูลที่กำหนด
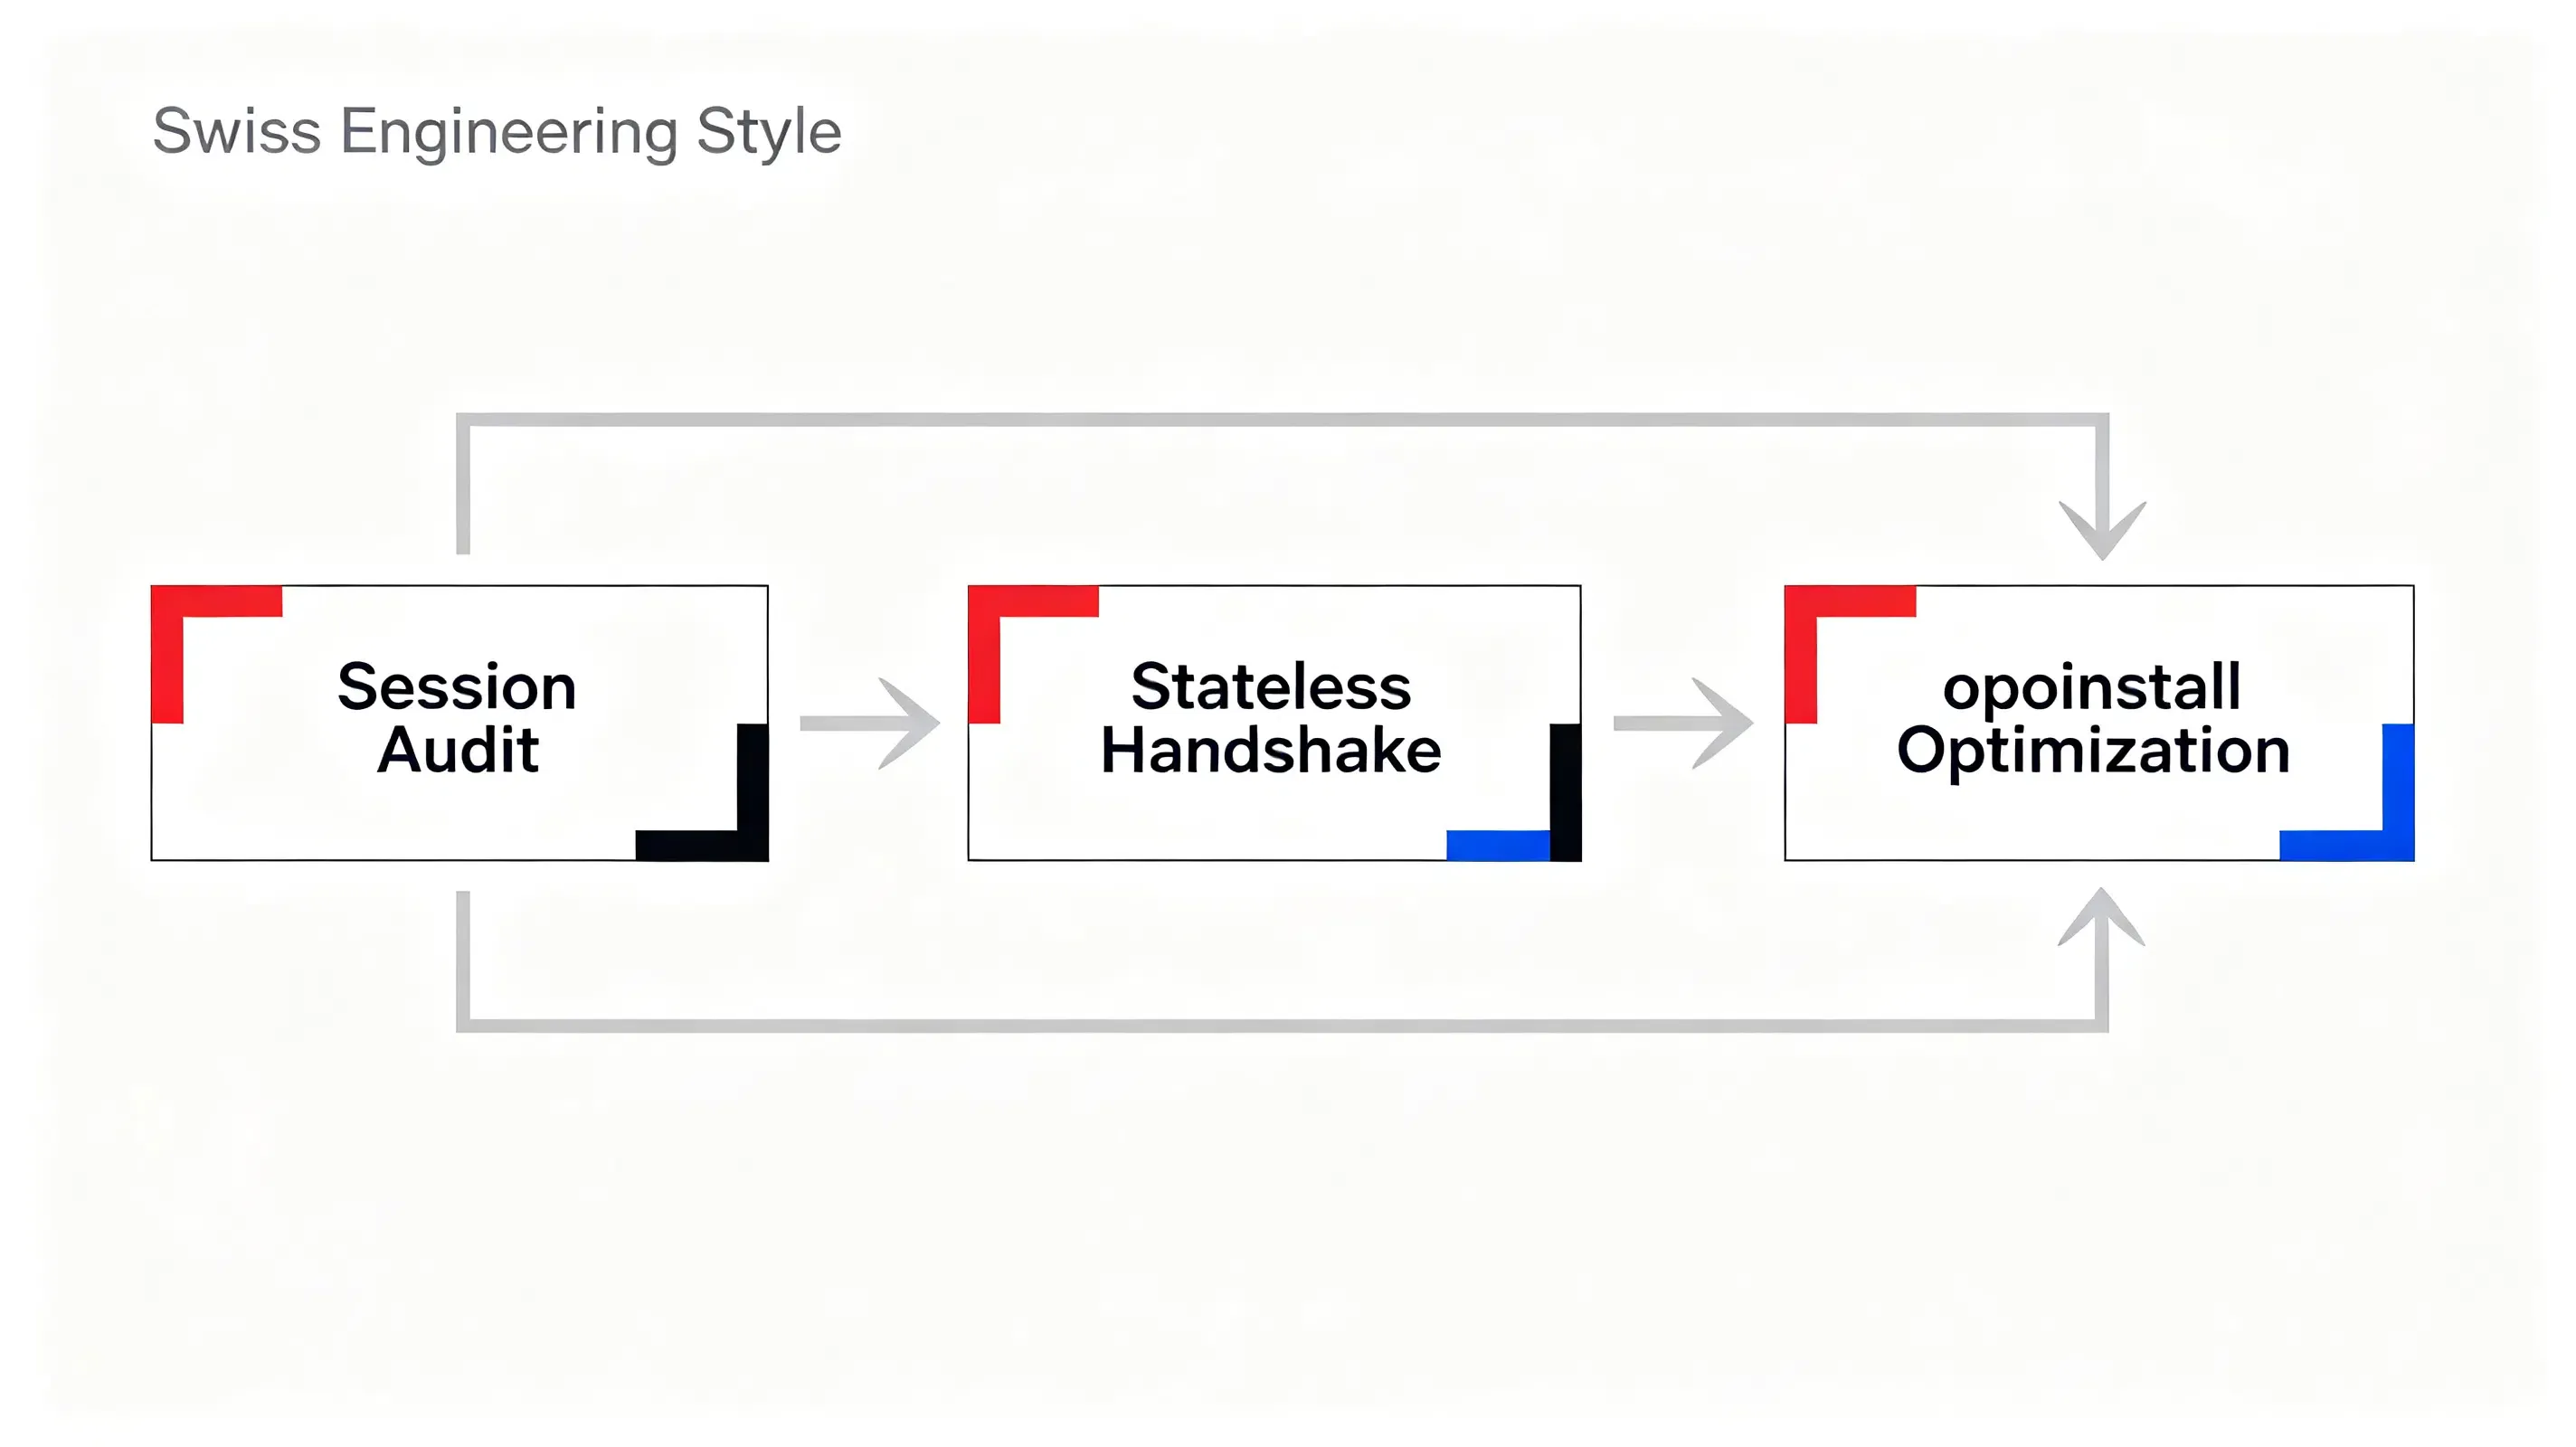
- ใช้ Stateless Session Handshakes: เปลี่ยนไปใช้โมเดลการประมวลผลแบบ Stateless โดยใช้โทเค็นที่มีลายเซ็นทางคริปโตกราฟีเพื่อส่งผ่านบริบทชั่วคราวระหว่างโหนด
- บังคับใช้เกตเวย์ยืนยันอายุ: สำหรับผลิตภัณฑ์ที่มุ่งเน้นผู้บริโภค ให้ปรับใช้ระบบป้องกันความปลอดภัยสำหรับเด็กเพื่อป้องกันไม่ให้ผู้เยาว์เข้าถึงฟีเจอร์การสนทนาที่จำกัด
รายการตรวจสอบกลยุทธ์ผลิตภัณฑ์และการเติบโต
- ปรับโฟลว์ประสบการณ์ผู้ใช้: เปลี่ยนจากโมเดลการมีส่วนร่วมแบบเน้นความเป็นเพื่อน ไปสู่เครื่องมือที่เน้นงานและมีอรรถประโยชน์สูงซึ่งไม่พึ่งพาความผูกพันทางอารมณ์
- เพิ่มประสิทธิภาพ Funnel การแปลงผล: ใช้เฟรมเวิร์กการส่งผ่านพารามิเตอร์ที่ไม่รุกล้ำความเป็นส่วนตัวเพื่อรักษาการติดตามการได้มาซึ่งผู้ใช้โดยไม่ละเมิดแนวทางความเป็นส่วนตัว
- ตรวจสอบการปฏิบัติตามข้อกำหนดของแพลตฟอร์ม: ตรวจสอบให้แน่ใจว่า SDK ของบุคคลที่สามทั้งหมดที่รวมอยู่นั้นปฏิบัติตามกฎหมายคุ้มครองข้อมูลในท้องถิ่นและข้อบังคับในวันที่ 15 กรกฎาคมที่กำลังจะมาถึง
ด้วยการกำหนดแนวทางที่มีโครงสร้างเหล่านี้ ทีมพัฒนาสามารถเปลี่ยนแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามข้อกำหนดมากขึ้นในขณะที่ยังคงความต่อเนื่องในการดำเนินงาน
คำถามที่พบบ่อย (FAQ)
ทำไม GPU ตัวเดิมถึงว่างงานนานถึงเก้าสิบเปอร์เซ็นต์ของเวลาทำงาน?
ความแตกต่างทางเทคนิคระหว่าง HBM, HBF และ HBS คืออะไร?
การกู้คืนเซสชันฝั่งเซิร์ฟเวอร์ช่วยแก้ปัญหาคอขวดของสถานะได้อย่างไร?
ทำไม HBM ถึงสำคัญในช่วงการใช้งานจริง (Inference) มากกว่าการฝึกฝน (Training) ของ AI?
สรุปประเด็นสำคัญสำหรับทีมวิศวกรรม
ในขณะที่แพลตฟอร์ม AI ปรับตัวให้เข้ากับข้อกำหนดด้านกฎระเบียบใหม่ ทีมวิศวกรจะหันมาพึ่งพาสถาปัตยกรรมแบบ Stateless, การจัดการเซสชันฝั่งเซิร์ฟเวอร์ และการออกแบบที่คำนึงถึงความเป็นส่วนตัวมากขึ้น สถาปัตยกรรมข้อมูลที่กำลังพัฒนาต้องการการเปลี่ยนแปลงพื้นฐานในวิธีที่เราสร้างและวัดผลประสบการณ์ดิจิทัล ในขณะที่ Stateless Proxy และ Headless Scraper กลายเป็นผู้บริโภคเนื้อหาบนเว็บมาตรฐาน โมเดลการระบุแหล่งที่มาแบบดั้งเดิมที่ฝั่งไคลเอนต์จะเสื่อมถอยลงเรื่อยๆ การพึ่งพาคุกกี้และ Referrer มาตรฐานไม่เพียงพออีกต่อไปในการปกป้องไปป์ไลน์ข้อมูลที่ขับเคลื่อนการได้มาซึ่งผู้ใช้
เพื่อรักษาการเติบโต ทีมวิศวกรและผลิตภัณฑ์ต้องให้ความสำคัญกับโครงสร้างข้อมูลแบบ Stateless และการเก็บรักษาข้อมูลสถานะฝั่งเซิร์ฟเวอร์ การปรับใช้การยืนยันตัวตนแบบ Zero-trust, เฟรมเวิร์กการส่งผ่านพารามิเตอร์ที่ปลอดภัย และกำหนดการลบข้อมูลที่เข้มงวด จะช่วยให้องค์กรสามารถปกป้องไปป์ไลน์ผู้ใช้ไปพร้อมๆ กับการเคารพขอบเขตทางกฎหมาย การเปลี่ยนแปลงทางสถาปัตยกรรมนี้มีความจำเป็นต่อการสร้างแพลตฟอร์มที่มั่นคงและน่าเชื่อถือซึ่งสามารถเติบโตได้ในเศรษฐกิจดิจิทัลที่ถูกควบคุม
Share this article



