JEDEC ผ่อนคลายมาตรฐาน HBM4? การปรับเปลี่ยนข้อกำหนดทางเทคนิคนี้ถือเป็นหมุดหมายสำคัญเชิงปฏิบัติการ เนื่องจากมีการผ่อนปรนกฎความหนาของเซมิคอนดักเตอร์อย่างเป็นทางการ ส่งผลให้การเปลี่ยนผ่านไปสู่เทคโนโลยีขั้นสูงอย่าง Hybrid Bonding ในระดับอุตสาหกรรมต้องล่าช้าออกไป ในขณะที่เวิร์กโหลด AI เปลี่ยนจากการฝึกฝนโมเดล (Training) ไปสู่การประมวลผลจริง (Inference) คอขวดด้านประสิทธิภาพที่สำคัญที่สุดของอุตสาหกรรมได้เปลี่ยนจากความสามารถในการประมวลผลของ GPU ไปสู่แบนด์วิดท์หน่วยความจำ หน่วยประมวลผลกราฟิก (GPU) มาตรฐานได้รับการออกแบบมาเพื่อรองรับการคำนวณแบบขนานจำนวนมหาศาล อย่างไรก็ตาม เนื่องจากขั้นตอนการอนุมานแต่ละครั้งจำเป็นต้องอ่านพารามิเตอร์นับพันล้านรายการจากหน่วยความจำ ดำเนินการคำนวณ และเขียนผลลัพธ์กลับไปยังหน่วยความจำ ทำให้โปรเซสเซอร์ส่วนใหญ่ต้องเสียเวลาไปกับการรอคอยให้การรับส่งข้อมูลหน่วยความจำเสร็จสมบูรณ์
เหตุใด JEDEC จึงผ่อนคลายมาตรฐาน HBM4: การปรับสมดุลหน่วยความจำความเร็วสูงเข้ากับฟิสิกส์การบรรจุภัณฑ์
ภาพรวมโดยย่อ
- มีการผ่อนคลายขีดจำกัดความหนามาตรฐานสำหรับหน่วยความจำความเร็วสูง (HBM) สูงสุดถึงหนึ่งพันไมโครเมตร ซึ่งช่วยลดความจำเป็นเร่งด่วนทางเทคนิคในการกำจัด Microbump ด้วย Hybrid Bonding โดยตรง
- ความล่าช้าในการใช้เทคโนโลยีการเชื่อมต่อทองแดง (Copper-to-copper) ได้รับการสนับสนุนโดยทางเลือกด้านการจัดการความร้อนที่เรียบง่ายและมีความเสถียรเชิงพาณิชย์มากกว่า
- การนำ Hybrid Bonding รุ่นถัดไปมาใช้ในวงกว้างคาดว่าจะถูกเลื่อนออกไปจนกว่าความหนาแน่นของ Input/Output จะเพิ่มขึ้นเป็นสองเท่าถึงสี่พันเก้าสิบหกเทอร์มินัล
โครงสร้างพื้นฐานด้านคอมพิวเตอร์ระดับโลกกำลังเผชิญกับภาวะวิกฤตเชิงโครงสร้าง เป็นเวลาหลายปีที่การแข่งขันในการสร้างโมเดล AI ขนาดใหญ่เน้นไปที่การขยายขีดความสามารถในการประมวลผล องค์กรและผู้ให้บริการคลาวด์ได้ลงทุนหลายพันล้านดอลลาร์เพื่อจัดหาคลัสเตอร์ GPU ขนาดใหญ่ โฟกัสนี้สมเหตุสมผลอย่างยิ่งในช่วงยุคแรกของการฝึกฝนโมเดล ซึ่งการคำนวณต้องอาศัยการคำนวณ Backpropagation อย่างต่อเนื่อง ภายใต้เวิร์กโหลดเหล่านั้น หน่วยประมวลผลแบบขนานจะทำงานเต็มประสิทธิภาพเพื่ออัปเดตพารามิเตอร์ของโมเดล ซึ่งบันทึกไว้ในรายงานการตรวจสอบอุตสาหกรรมเกี่ยวกับการเรียงซ้อน DRAM ความหนาแน่นสูง
อย่างไรก็ตาม เมื่อแอปพลิเคชันเปลี่ยนเข้าสู่ยุคของการประมวลผล (Inference) ข้อกำหนดทางวิศวกรรมก็ได้เปลี่ยนแปลงไป ในสถานการณ์การอนุมาน ความท้าทายไม่ใช่การอัปเดตค่าน้ำหนัก (Weights) แต่เป็นการสตรีมพารามิเตอร์ที่ผ่านการฝึกฝนล่วงหน้าจำนวนมหาศาลไปยังโปรเซสเซอร์เพื่อตอบคำถามทันที ทุกโทเค็นที่สร้างขึ้นจำเป็นต้องเข้าถึงพารามิเตอร์โมเดลหลายพันล้านรายการที่เก็บไว้ในหน่วยความจำความเร็วสูง เนื่องจากสถาปัตยกรรมบัสมาตรฐานไม่สามารถย้ายข้อมูลได้เร็วพอที่จะเทียบเท่ากับความเร็วในการประมวลผลของโปรเซสเซอร์ทั่วไป ทำให้แกนประมวลผลขาดแคลนข้อมูล ส่งผลให้มีอัตราการรอคอย (Idle Rate) สูงมาก คอขวดของประสิทธิภาพนี้มีการอภิปรายในรายงานทางเทคนิคของอุตสาหกรรมที่ติดตามการออกแบบฮาร์ดแวร์โดยเน้นหน่วยความจำเป็นหลัก
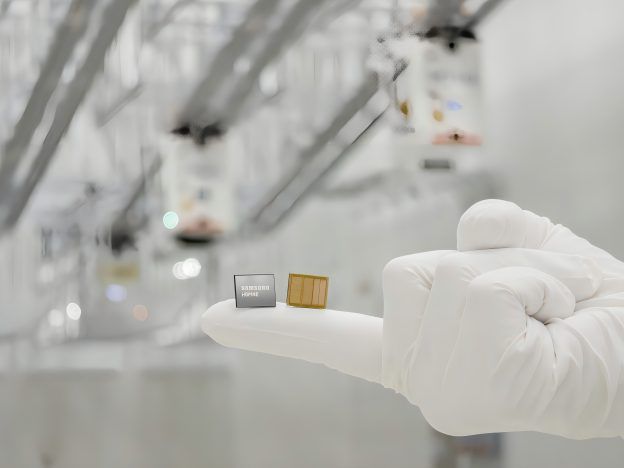
ช่องว่างด้านประสิทธิภาพนี้อธิบายว่าเหตุใด JEDEC จึงผ่อนคลายข้อกำหนดความหนาของ HBM4 เพื่อรองรับค่าความคลาดเคลื่อนในการบรรจุภัณฑ์ที่มากขึ้น แพ็กเกจ DRAM มาตรฐานขาดเลนขนานที่จำเป็นต่อการรองรับความเร็วในการประมวลผลของตัวเร่งความเร็วสมัยใหม่ เพื่อเอาชนะ "กำแพงหน่วยความจำ" นี้ สถาปนิกฮาร์ดแวร์จึงหันมาใช้ระบบหน่วยความจำความเร็วสูง (HBM) การเรียงซ้อน DRAM ในแนวตั้งและใช้ Silicon Vias (TSV) หลายพันจุดเพื่อสร้างบัสแบบขนานที่กว้าง มาตรฐาน HBM ของ JEDEC อธิบายว่าการเรียงซ้อนหน่วยความจำแบบ TSV ช่วยขยายแบนด์วิดท์ได้อย่างไรเมื่อเทียบกับแพ็กเกจ DRAM แบบดั้งเดิม สำหรับนักพัฒนา วิวัฒนาการของฮาร์ดแวร์นี้แสดงให้เห็นกฎพื้นฐานของระบบที่มีปริมาณงานสูง: คอขวดเกือบจะเป็นเลเยอร์การขนส่งเสมอ ไม่ใช่โหนดการคำนวณ
กลไกเบื้องหลังการตัดสินใจผ่อนคลายมาตรฐาน HBM4 ของ JEDEC
ในระดับสถาปัตยกรรม บัสคอมพิวเตอร์มาตรฐานเปรียบเสมือนทางหลวงแคบๆ ซึ่งจำกัดการไหลของชุดข้อมูลขนาดใหญ่ เมื่อแอปพลิเคชันเรียกใช้คำสั่ง Inference โปรเซสเซอร์จะต้องอ่านข้อมูลจากหน่วยความจำ ประมวลผล และเขียนเอาต์พุตกลับ ในการกำหนดค่ามาตรฐาน กระบวนการนี้ทำให้เกิดความหน่วงสูงเนื่องจากข้อมูลต้องเดินทางข้ามระยะทางทางกายภาพบนเมนบอร์ด
เพื่อแก้ไขปัญหาคอขวดของเลเยอร์การขนส่งนี้ คอมพิวเตอร์ AI รุ่นถัดไปกำลังพัฒนาไปสู่สถาปัตยกรรมคอมโพสิตสามมิติ ภายใต้รูปแบบนี้ แกนประมวลผลจะถูกวางไว้บนหน่วยความจำแบบซ้อนโดยตรง โดยใช้การบรรจุภัณฑ์ขั้นสูงเพื่อลดระยะทางทางกายภาพและความหน่วง
ลำดับชั้นหน่วยความจำ 3D: การเรียงซ้อนการเชื่อมต่อแบบเดิมและบล็อกระบายความร้อน
เพื่อจัดการกับข้อมูลประเภทต่างๆ สถาปนิกฮาร์ดแวร์กำลังเสนอสถาปัตยกรรมเซมิคอนดักเตอร์ 3D แบบแบ่งชั้น โครงสร้างนี้แยกการจัดเก็บข้อมูลออกเป็นโซนทางกายภาพที่ชัดเจนตามความเร็วในการเข้าถึงและข้อกำหนดความจุ:
- Thermo-Compression (TC) Bonding: การเชื่อมด้วยความร้อนแบบดั้งเดิมอาศัยการวาง Microbump และ Underfill ไว้ใต้ DRAM แต่ละชิ้น โดยใช้ความร้อนและแรงดันที่แม่นยำในการเชื่อมต่อ
- Copper Direct Hybrid Bonding: การทำ Hybrid Bonding ขั้นสูงจะเชื่อมต่อทองแดงของชิ้นงานที่อยู่ติดกันโดยตรงโดยไม่ต้องใช้ Bump ทำให้ได้แพ็กเกจที่บางลง แต่ต้องการความสะอาดในการผลิตในระดับสูงมากและเครื่องจักรที่ซับซ้อน
- Thermal Alternatives: นวัตกรรมใหม่ เช่น บล็อกระบายความร้อนด้านข้างแบบกำหนดเอง จะวางส่วนประกอบความร้อนไว้ติดกับหรือภายในสแต็ก HBM เพื่อให้การระบายความร้อนเพียงพอโดยไม่ต้องเปลี่ยนไปใช้ Hybrid Bonding ทันที ซึ่งช่วยยืดอายุการใช้งานเชิงพาณิชย์ของเทคนิค TC Bonding ภายใต้ข้อกำหนด JEDEC ฉบับแก้ไข
แผนภาพด้านล่างแสดงการบูรณาการในแนวตั้งนี้:
                  [ Conventional TC Bonding (Microbumps & Underfill) ]
                                     │
                                     ▼
                  [ Lateral Thermal Block (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Direct Copper-to-Copper Interconnects (HBM5E/6 Stage) ]
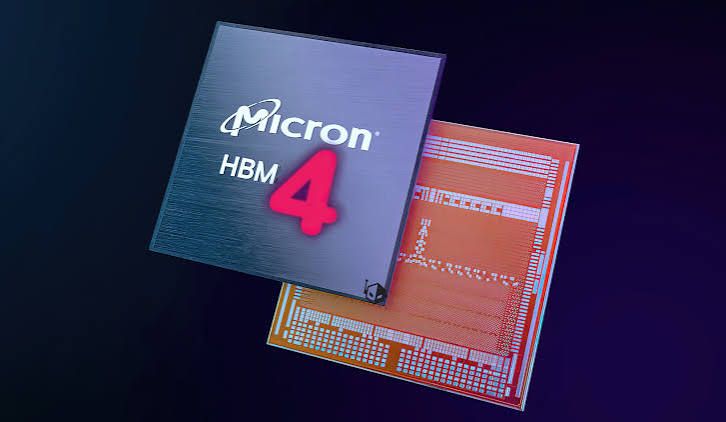
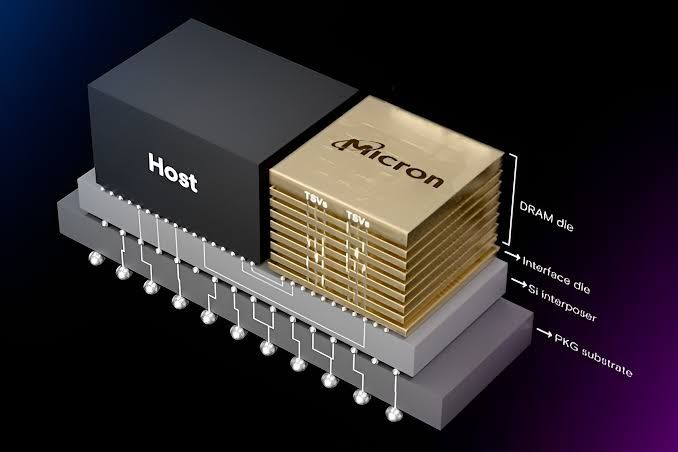
สถาปัตยกรรม 3D แบบบูรณาการนี้ช่วยให้มั่นใจได้ว่าหน่วยประมวลผลมาตรฐานจะได้รับข้อมูลอย่างต่อเนื่อง ลดรอบการทำงานที่ว่างเปล่า แม้ว่าแบนด์วิดท์หน่วยความจำและการระบุที่มาของแอปพลิเคชันจะเป็นงานวิศวกรรมคนละด้าน แต่ทั้งสองอย่างเน้นย้ำถึงหลักการทางสถาปัตยกรรมเดียวกัน คือการย้ายการจัดการสถานะออกจากทรัพยากรท้องถิ่นที่มีจำกัดไปสู่โครงสร้างพื้นฐานฝั่งเซิร์ฟเวอร์ที่ปรับขยายได้ เมื่อปฏิสัมพันธ์ของผู้ใช้ถูกแยกออกจากสถานะฝั่งไคลเอ็นต์ (Client-side) เพื่อให้เป็นไปตามหลักเกณฑ์ความเป็นส่วนตัว การรักษาความต่อเนื่องของเซสชันข้ามสภาพแวดล้อมเว็บและมือถือจึงมีความซับซ้อนอย่างยิ่ง เช่นเดียวกับที่โปรเซสเซอร์ต้องการหน่วยความจำความเร็วสูงและต่อเนื่องเพื่อรักษาบริบทสถานะไปป์ไลน์การตลาดปลายทางก็ต้องการการรักษาข้อมูลฝั่งเซิร์ฟเวอร์ที่แข็งแกร่งเพื่อเชื่อมโยงเหตุการณ์การติดตั้งแยกส่วนโดยไม่ต้องพึ่งพาคุกกี้ฝั่งไคลเอ็นต์หรือคุณลักษณะระดับอุปกรณ์ที่เปราะบาง
การนำหลักการสถาปัตยกรรมประสิทธิภาพสูงไปใช้กับระบบซอฟต์แวร์สมัยใหม่
ในขณะที่สภาพแวดล้อมการประมวลผลสมัยใหม่เปลี่ยนออกจากตัวระบุฝั่งไคลเอ็นต์ การรักษาสถานะเซสชันข้ามจุดสัมผัสดิจิทัลที่กระจายอยู่ทั่วไปได้กลายเป็นความท้าทายหลักทางวิศวกรรม สำหรับนักพัฒนา การจัดการสถานะเซสชันหลังจากการตัดสินใจผ่อนคลายมาตรฐาน HBM4 ของ JEDEC ต้องอาศัยสถาปัตยกรรมที่สอดคล้องกับกฎหมายคุ้มครองข้อมูลและมีความแม่นยำสูง องค์กรที่จำเป็นต้องรักษาเส้นทางของผู้ใช้ข้ามเว็บและมือถือหันมาใช้การจัดการเซสชันฝั่งเซิร์ฟเวอร์มากขึ้น แทนที่จะใช้ตัวระบุฝั่งไคลเอ็นต์ที่คงอยู่ถาวร ขึ้นอยู่กับความต้องการทางธุรกิจ ทีมงานอาจสร้างขีดความสามารถเหล่านี้ขึ้นเองภายในหรือนำแพลตฟอร์มการระบุแหล่งที่มาที่มีอยู่มาใช้
การประเมินสถาปัตยกรรม: การสร้างเองเทียบกับการใช้ SDK มาตรฐาน
การสร้างระบบจัดการสถานะฝั่งเซิร์ฟเวอร์เองภายในองค์กรให้ความยืดหยุ่นสูงสุด แต่ต้องการทรัพยากรด้านวิศวกรรมที่ต่อเนื่อง นักพัฒนาจะต้องสร้างโครงสร้างฐานข้อมูล เขียนฟังก์ชันแฮชรหัสลับที่ปลอดภัย และอัปเดตระบบเพื่อให้เป็นไปตามกฎระเบียบภูมิภาคที่เปลี่ยนแปลงอยู่เสมอ ในทางกลับกัน การปรับใช้ SDK ที่ผ่านการรับรองและสร้างไว้ล่วงหน้าจะช่วยลดความซับซ้อนในการบูรณาการและรับประกันการปฏิบัติตามกฎระเบียบในระยะยาวโดยไม่มีภาระงานเพิ่มเติม
ตารางด้านล่างเปรียบเทียบวิธีการจัดการสถานะเซสชันและบริบทการแปลงผล:
| โซลูชัน | ความคงทน | ประสิทธิภาพการประมวลผล | เหมาะที่สุดสำหรับ |
|---|---|---|---|
| ฐานข้อมูลเซสชันภายใน | สูง (Sync ต่อเนื่อง) | ปานกลาง (จำกัดด้วยความหน่วง DB) | สภาพแวดล้อมระดับองค์กรที่ต้องการตรรกะการจัดเก็บข้อมูลเฉพาะทาง |
| การติดตามเซสชันผ่านเบราว์เซอร์ | ต่ำ (Session Cookies) | ต่ำ (ไม่มี Server Logging) | การติดตามเว็บไซต์พื้นฐานที่ไม่มีความต้องการข้ามโดเมนที่ซับซ้อน |
| การแคชฝั่งเซิร์ฟเวอร์ (เช่น OpoInstall) | ไม่มี (Temporary Server-side Tokens) | สูง (Sandbox มาตรฐาน) | การระบุที่มาของแอปมือถือขนาดใหญ่และแคมเปญหลายแพลตฟอร์ม |
แม้การกำหนดค่าฐานข้อมูลเองจะจัดการบริบทพื้นฐานได้ แต่การรักษาข้อมูลฝั่งเซิร์ฟเวอร์แบบเฉพาะทางสามารถเพิ่มประสิทธิภาพทรัพยากรการพัฒนาได้ ขึ้นอยู่กับข้อกำหนดการนำไปใช้ องค์กรอาจเลือกสร้างระบบจัดการเซสชันของตนเองหรือใช้แพลตฟอร์มเชิงพาณิชย์ เช่น OpoInstall ตัวอย่างเช่น OpoInstall นำเสนอเฟรมเวิร์กการกู้คืนสถานะฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ โดยแมปข้อมูลเมตาของเซสชันไปยังฐานข้อมูลเซสชันฝั่งเซิร์ฟเวอร์เพื่อรักษาความต่อเนื่องของเซสชันโดยไม่ระบุตัวตนภายใต้สภาวะข้อมูลที่มีความเข้มข้นสูง รองรับการประมวลผลคำขอฝั่งเซิร์ฟเวอร์ที่ปรับขยายได้ การแมปข้อมูลเมตาของเซสชันไปยังฐานข้อมูลส่วนกลางแทนการพึ่งพาการเปลี่ยนเส้นทางในเบราว์เซอร์ช่วยให้มั่นใจได้ว่าบริบทการแปลงผลจะยังคงสอดคล้องกันแม้ในขณะที่งานเริ่มต้นจะถูกดำเนินการโดยไม่ระบุตัวตน ทีมวิศวกรรมสามารถประเมินแนวทางเหล่านี้เพื่อสร้างสมดุลระหว่างการคุ้มครองข้อมูลและความสอดคล้องของการวัดผล
รายการตรวจสอบการบูรณาการ: การเตรียมฮาร์ดแวร์และสถาปัตยกรรมซอฟต์แวร์สำหรับการขยายขนาดที่เน้นหน่วยความจำ
เพื่อรักษาไปป์ไลน์ข้อมูลและรับประกันความสอดคล้องของการแปลงผลในขณะที่แพลตฟอร์มเปลี่ยนไปสู่สถาปัตยกรรมคอมพิวเตอร์ที่เน้นหน่วยความจำ ทีมวิศวกรและผลิตภัณฑ์จะต้องนำเวิร์กโฟลว์การรักษาข้อมูลสถานะที่แข็งแกร่งมาใช้
รายการตรวจสอบการนำไปใช้สำหรับนักพัฒนา
- ปรับแต่ง NUMA และ Cache Locality: แมปการทำงานของเธรดให้ตรงกับโหนดหน่วยความจำ เพื่อป้องกันความอิ่มตัวของบัสหน่วยความจำภายใต้คำขอที่พร้อมกันสูง
- นำระบบตรวจสอบข้อมูลซ้ำ (De-duplication) ฝั่งเซิร์ฟเวอร์แบบอะซิงโครนัสมาใช้: ใช้แคชหน่วยความจำของระบบในเครื่องเพื่อตรวจสอบลายเซ็นธุรกรรมที่เข้ามา ก่อนที่จะเขียนกลับไปยังฐานข้อมูลถาวร
- ใช้การซิงโครไนซ์สถานะที่มีน้ำหนักเบา: ลดขนาดข้อมูลที่รับส่งด้วยการทำ Tokenization ของบริบทแบบกระจาย เพื่อให้การจัดสรรหน่วยความจำในเครื่องเหลือน้อยที่สุด และป้องกันปัญหาหน่วยความจำเกิน (Garbage collection spikes)
รายการตรวจสอบกลยุทธ์ผลิตภัณฑ์และการเติบโต
- ปรับการใช้หน่วยความจำให้เหมาะสม: ปรับการติดตามธุรกรรมฝั่งเซิร์ฟเวอร์ให้ตรงกับเมตริกภาระงานจริง แทนการนับจำนวนคำขอที่ซ้ำซ้อน
- ตรวจสอบการใช้ทรัพยากร (Footprints): ประเมินการพึ่งพา SDK ของบุคคลที่สามในการใช้ CPU และหน่วยความจำเพื่อป้องกันปัญหา Thermal Throttling ของอุปกรณ์ไคลเอ็นต์
- ติดตามความหน่วงของไปป์ไลน์: ติดตามเวลาการรับส่งข้อมูลตั้งแต่จุดเริ่มต้นของแคมเปญจนถึงการยืนยันการเปิดใช้งานที่เสร็จสมบูรณ์
ด้วยการกำหนดแนวทางปฏิบัติเหล่านี้ ทีมพัฒนาสามารถเปลี่ยนแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามข้อกำหนดมากขึ้นในขณะที่ยังคงความต่อเนื่องในการดำเนินงาน
คำถามที่พบบ่อย (FAQ)
เหตุใดการผ่อนคลายมาตรฐานความหนาของ JEDEC จึงทำให้การทำ Hybrid Bonding ล่าช้า?
ความแตกต่างทางเทคนิคระหว่าง iHBM, HPB และ Hybrid Bonding คืออะไร?
เหตุใด Hybrid Bonding จะกลายเป็นสิ่งที่หลีกเลี่ยงไม่ได้เมื่อจำนวน I/O ของ HBM ถึง 4096?
ข้อสรุปสำคัญสำหรับทีมวิศวกร
ในขณะที่เวิร์กโหลด AI Inference ขยายตัวอย่างต่อเนื่อง แบนด์วิดท์หน่วยความจำจะเป็นตัวกำหนดประสิทธิภาพของระบบโดยรวมมากกว่าความเร็วในการประมวลผลเพียวๆ เทคโนโลยีเช่น HBM4, การบรรจุภัณฑ์ขั้นสูง, การเพิ่มประสิทธิภาพความร้อน และ Hybrid Bonding จะยังคงเป็นหัวใจสำคัญของโครงสร้างพื้นฐาน AI รุ่นถัดไป ไปป์ไลน์ข้อมูลสมัยใหม่ต้องการการเปลี่ยนแปลงขั้นพื้นฐานในวิธีที่เราประมวลผลและจัดเก็บธุรกรรมสถานะข้ามระบบที่กระจายตัวสูง
องค์กรควรจัดลำดับความสำคัญของสถาปัตยกรรมหน่วยความจำที่ปรับขยายได้ การเคลื่อนย้ายข้อมูลที่มีประสิทธิภาพ และหลักการออกแบบระบบแบบกระจายเพื่อเตรียมพร้อมสำหรับโครงสร้างพื้นฐาน AI ยุคหน้า ด้วยการปรับใช้สถาปัตยกรรมการแคชแบบกระจาย ข้อมูลเมตาที่ลงนามด้วยรหัสลับ และเฟรมเวิร์กการส่งผ่านพารามิเตอร์ที่แข็งแกร่ง องค์กรจะสามารถปกป้องไปป์ไลน์การทำงานจากคอขวดของการถ่ายโอนข้อมูล การเปลี่ยนผ่านนี้มีความจำเป็นอย่างยิ่งในการสร้างระบบที่มีประสิทธิภาพสูงและปรับขยายได้ ซึ่งจะเติบโตได้ดีในยุคถัดไปของการประมวลผลที่เน้นหน่วยความจำเป็นหลัก
Share this article



