Meta สั่งแบน ‘Claude’? การปรับทิศทางเชิงกลยุทธ์นี้ได้รับการยืนยันจากรายงานที่ระบุว่ายักษ์ใหญ่ด้านโซเชียลมีเดียได้จำกัดไม่ให้วิศวกรในแผนก Applied AI ใช้งานเครื่องมือจากคู่แข่ง เช่น Claude Code และ Codex ของ OpenAI ข้อมูลภายในที่ได้รับเมื่อปลายเดือนมิถุนายน 2026 ระบุว่าบริษัทออกคำสั่งดังกล่าวเพื่อปกป้องความบริสุทธิ์ของชุดข้อมูลที่จะนำมาใช้ฝึกฝนโมเดล Llama รุ่นถัดไป และเพื่อรักษาความลับทางการค้า ตามที่ระบุไว้ในการอัปเดตด้านการปฏิบัติตามกฎระเบียบของอุตสาหกรรม สำหรับทีมพัฒนาและผู้ดูแลผลิตภัณฑ์ นโยบายที่เข้มงวดนี้สะท้อนให้เห็นถึงการเปลี่ยนแปลงในภาพรวมที่ใหญ่ขึ้น เมื่อโมเดล Generative ต่างๆ เริ่มมีความใกล้เคียงกัน การรักษาความแยกส่วนของสภาพแวดล้อมภายในองค์กรจึงกลายเป็นมาตรฐานพื้นฐานของการปฏิบัติตามกฎระเบียบองค์กร แทนที่จะเป็นเพียงทางเลือกในการปฏิบัติงานทั่วไป
ภาพรวม
- มาตรการป้องกันการปนเปื้อนข้อมูล: ทีมวิศวกร Applied AI ได้จำกัดการเรียกใช้เครื่องมือสร้างโค้ดจากภายนอก เพื่อป้องกันไม่ให้ผลลัพธ์จากโมเดลคู่แข่งเข้ามาผสมกับข้อมูลการฝึกฝนที่เป็นกรรมสิทธิ์ของบริษัท
- ภัยคุกคามจากการทำ Distillation: การนำผลลัพธ์จากการประมวลผลภายนอกมาใช้ซ้ำบ่อยครั้ง ก่อให้เกิดความเสี่ยงต่อการทำ Knowledge Distillation ซึ่งอาจเป็นการละเมิดข้อตกลงในการใช้บริการ
- ความต้องการ Private Sandbox: การเปลี่ยนแปลงครั้งนี้เน้นย้ำถึงความต้องการที่เพิ่มขึ้นสำหรับระบบ Sandbox สำหรับนักพัฒนาแบบโฮสต์เองที่ปลอดภัย ซึ่งจะช่วยแยกคลังโค้ดที่ละเอียดอ่อนออกจากเซิร์ฟเวอร์ภายนอก
คำสั่งองค์กรและการปรับทิศทางด้านความปลอดภัยช่วงเดือนพฤษภาคมถึงมิถุนายน
แนวทางปฏิบัติที่เข้มงวดนี้ได้ร่างขึ้นในช่วงเดือนพฤษภาคม 2026 และมีผลบังคับใช้อย่างเป็นทางการเมื่อสิ้นเดือนมิถุนายน 2026 กฎดังกล่าวเน้นเฉพาะวิศวกรในแผนก Applied AI ที่มีส่วนร่วมโดยตรงในการวิจัยโมเดล ไม่ได้ใช้กับพนักงานทุกคน ในรอบการพัฒนาที่ผ่านมา ทีมวิศวกรมีการใช้ผู้ช่วยเขียนโค้ดจากภายนอกเพื่อวางแผนสถาปัตยกรรมระบบ แก้ไขโค้ด และปรับปรุงกระบวนการแก้ไขจุดบกพร่อง (Debugging) อยู่บ่อยครั้ง อย่างไรก็ตาม ภายใต้แนวทางความปลอดภัยที่อัปเดตใหม่ วิศวกรจำเป็นต้องออกแบบข้อมูลการทดสอบด้วยตนเอง โดยอาศัยความเชี่ยวชาญของมนุษย์แทนการใช้คำสั่ง (Prompt) จากโมเดลภายนอก
ปัจจัยหลักที่อยู่เบื้องหลังการเปลี่ยนแปลงนี้คือความเสี่ยงเรื่อง Model Distillation หรือที่เรียกกันว่าการกลั่นกรองความรู้ ในการวิจัยปัญญาประดิษฐ์ นักพัฒนาจะฝึกฝนโมเดลขนาดเล็กหรือ "Student" ให้เลียนแบบพฤติกรรมของโมเดล "Teacher" ที่มีความสามารถสูงกว่า โดยการป้อนผลลัพธ์จากระบบที่ใหญ่กว่าให้ แม้กระบวนการนี้จะยังคงเป็นที่นิยมสำหรับการเพิ่มประสิทธิภาพขนาดของโมเดลและลดต้นทุนการใช้งาน แต่ก็นำมาซึ่งความเสี่ยงตามสัญญาที่ร้ายแรง การที่วิศวกรของ Meta คัดลอกหรืออ้างอิงโค้ดที่รวบรวมโดยเครื่องมือของคู่แข่งมีความเสี่ยงที่จะนำข้อมูลของคู่แข่งเข้าสู่ไปป์ไลน์การฝึกฝนของ Llama ซึ่งอาจถือเป็นการละเมิดข้อตกลงและทำให้โมเดลที่เป็นกรรมสิทธิ์ปนเปื้อนได้
การปรับทิศทางด้านความปลอดภัยนี้เกิดขึ้นท่ามกลางการแข่งขันที่ทวีความรุนแรงขึ้น ในเดือนมิถุนายน 2026 สตาร์ทอัพด้าน AI จากจีนอย่าง Zhipu AI ได้เปิดซอร์สโมเดลเรือธงของตนคือ GLM-5.2 ซึ่งแสดงให้เห็นถึงความสามารถในการสแกนช่องโหว่ที่ทัดเทียมกับมาตรฐานระดับสูงในสหรัฐฯ การทดสอบอิสระแสดงให้เห็นว่า GLM-5.2 มีประสิทธิภาพเหนือกว่าโมเดลระดับแนวหน้าอย่าง Claude Opus 4.8 ในงานด้านความปลอดภัยไซเบอร์ของ Semgrep เนื่องจาก Zhipu AI เลือกที่จะเปิดซอร์สค่าถ่วงน้ำหนัก (Model Weights) ของโมเดล ทำให้สามารถปรับใช้ภายในระบบท้องถิ่นส่วนตัวได้ โมเดลนี้จึงไต่อันดับรายการปริมาณการใช้งานบนแพลตฟอร์มอย่าง OpenRouter ได้อย่างรวดเร็ว การเพิ่มขึ้นอย่างรวดเร็วของโมเดลทางเลือกในท้องถิ่นที่มีประสิทธิภาพสูงเช่นนี้ กำลังบีบให้ห้องปฏิบัติการ AI ชั้นนำต้องจัดลำดับความสำคัญให้กับการควบคุมคลังโค้ดและข้อมูลอินพุตของตนเองอย่างเบ็ดเสร็จ
ข้อสังเกตต่อไปนี้อ้างอิงจากการตรวจสอบภายในสภาพแวดล้อมจำลอง (Staging Environment) และมีจุดประสงค์เพื่อแสดงรูปแบบทางวิศวกรรม ไม่ใช่เพื่อเป็นเกณฑ์มาตรฐานของอุตสาหกรรม
กลไกเบื้องลึกของการทำ Model Distillation และการเปิดเผยข้อมูล
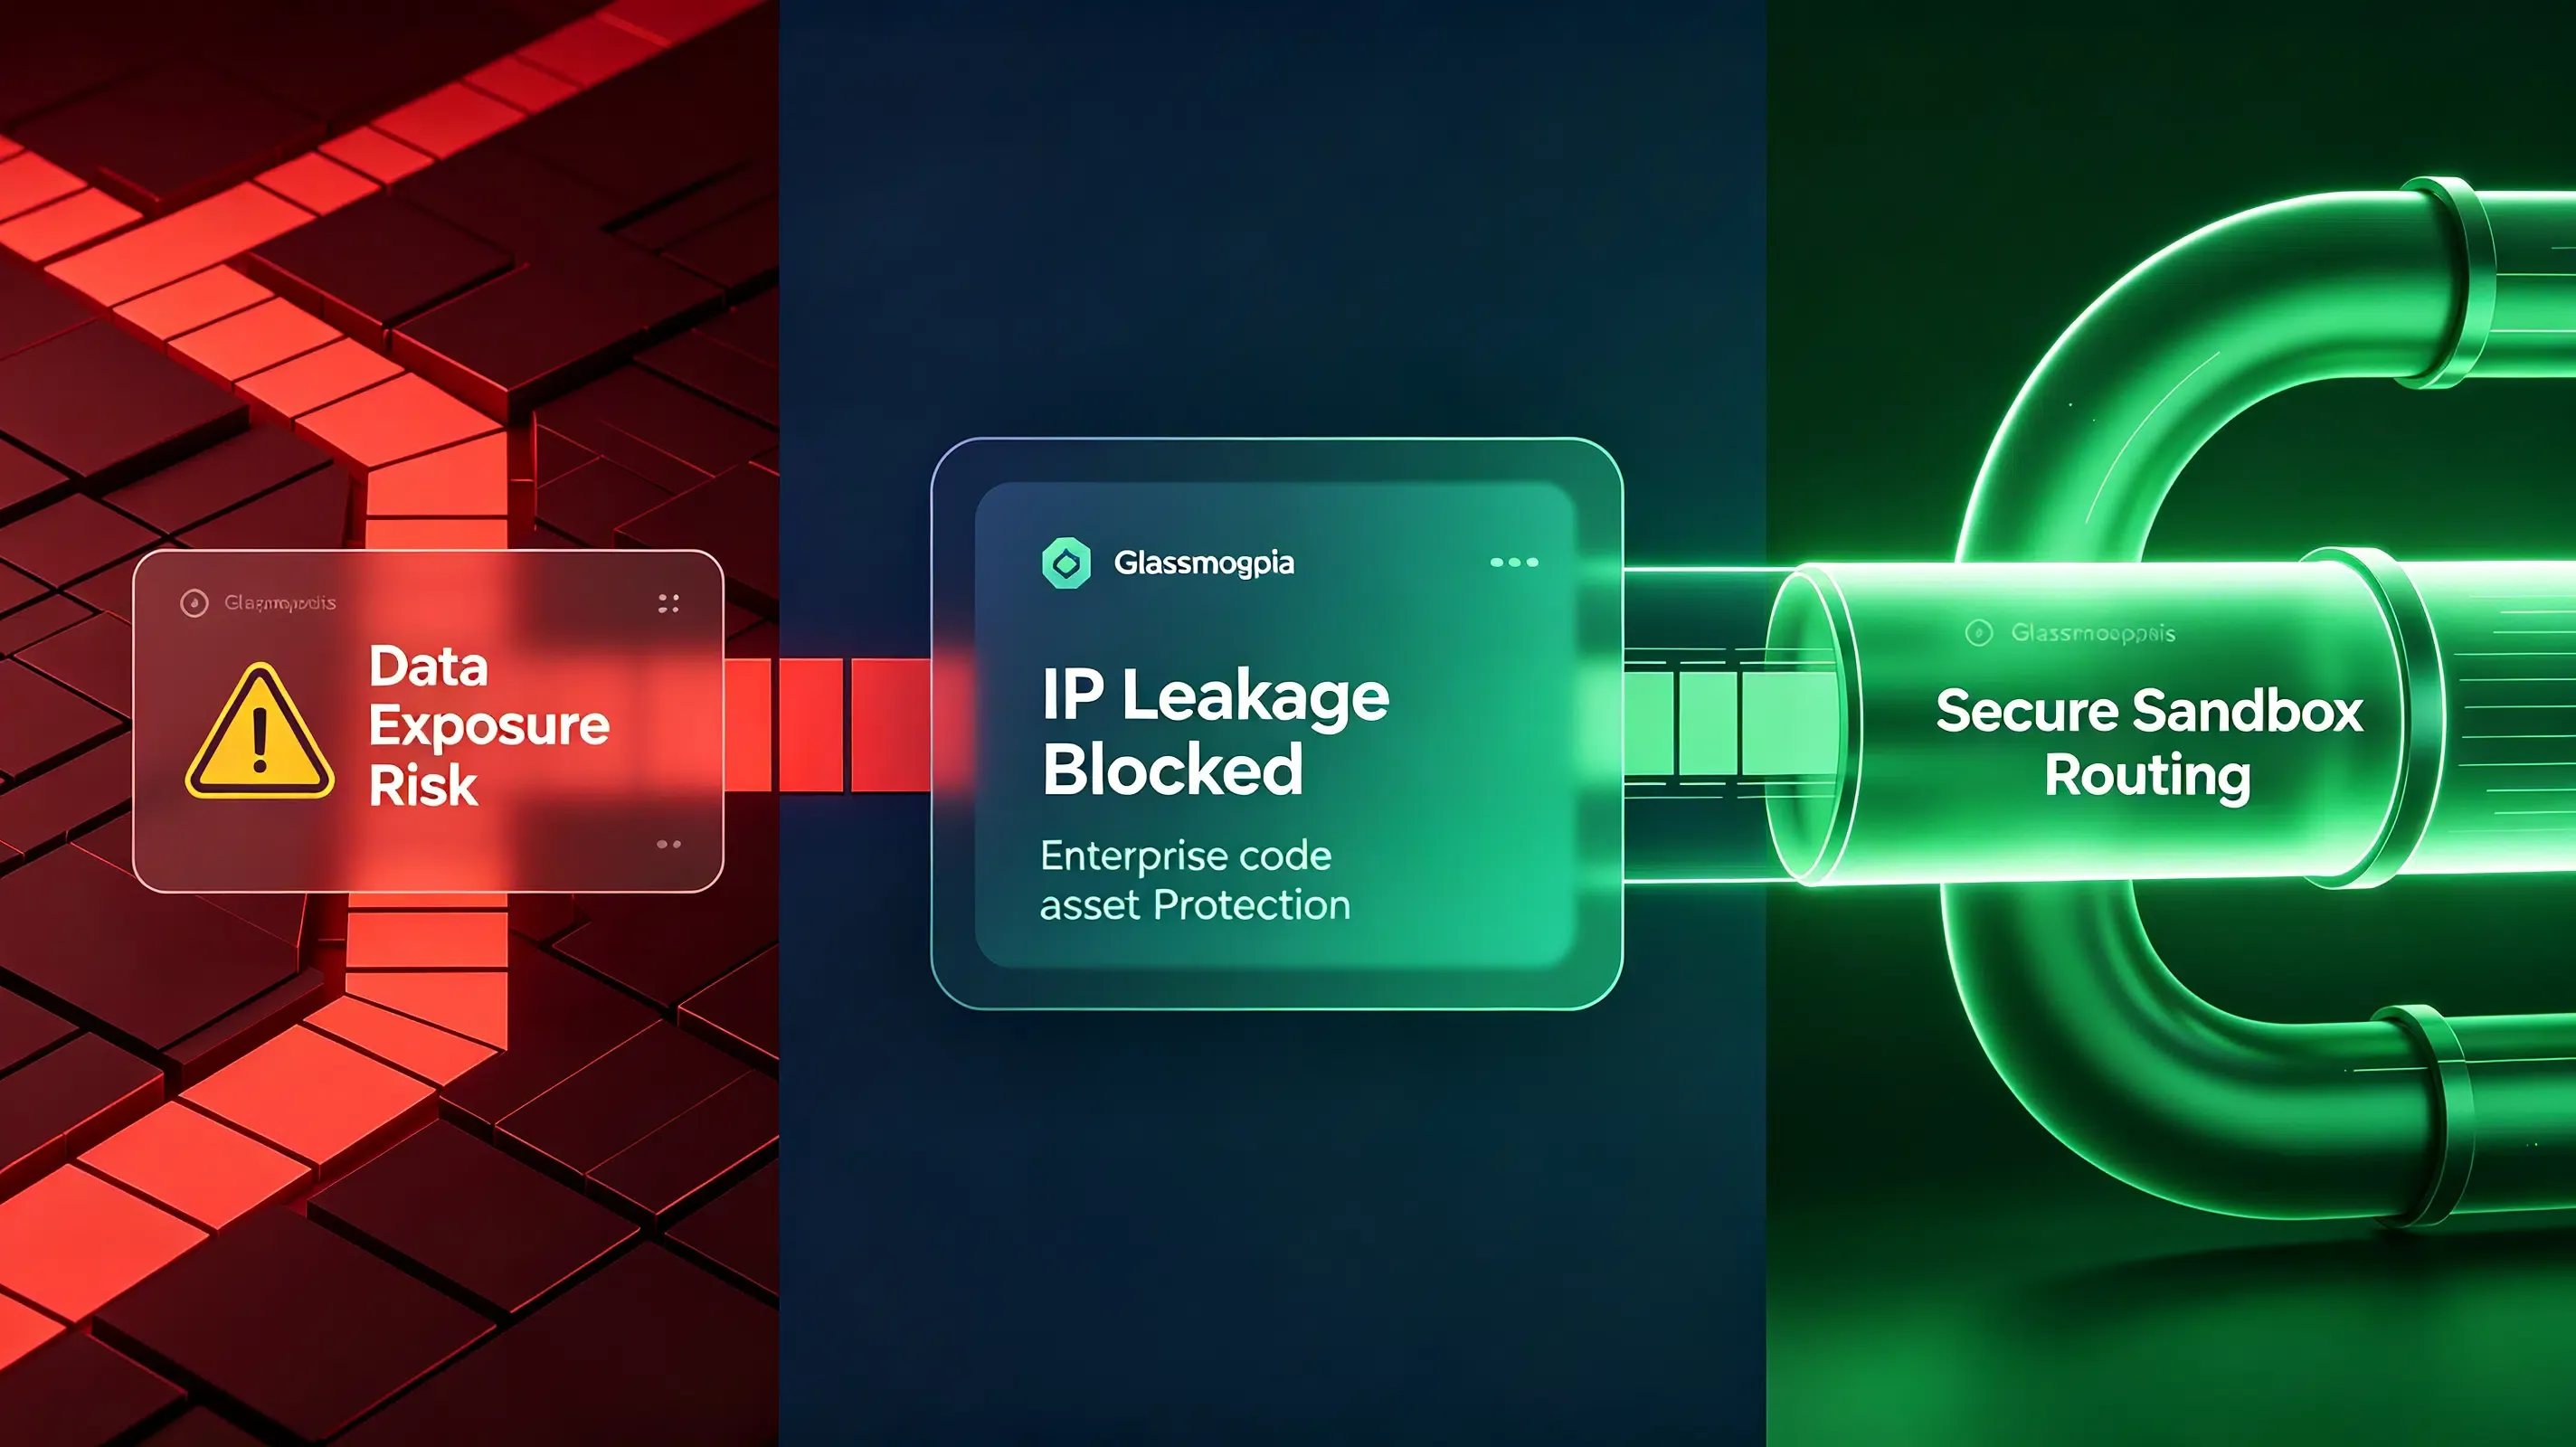
เพื่อทำความเข้าใจว่าเหตุใด Meta จึงจำกัดเครื่องมือเหล่านี้ นักพัฒนาต้องวิเคราะห์กลไกของผู้ช่วยเขียนโค้ด AI ยุคใหม่ ยูทิลิตี้เหล่านี้ทำงานโดยการส่งบริบทของคลังโค้ดในเครื่องไปยังเซิร์ฟเวอร์ภายนอกเพื่อประมวลผล เมื่อวิศวกรเริ่มใช้งาน Prompt เพื่อแก้ไขโค้ดหรือขอคำแนะนำด้านสถาปัตยกรรม ชุดข้อมูลโค้ดที่เป็นกรรมสิทธิ์จะถูกส่งออกไปนอกเครือข่ายองค์กร การส่งข้อมูลแบบ Headless เช่นนี้สร้างช่องโหว่โดยตรงต่อการเปิดเผยทรัพย์สินทางปัญญาและการรั่วไหลของข้อมูล
Developer IDE -> Outbound Request Interceptor -> Sandbox Proxy (Metadata Stripped) -> Secure API Gateway -> Model
                                                            |
                                               Outbound Firewall blocks raw codebase uploads
ในการใช้งานจริง นักพัฒนามักพบว่าปริมาณการใช้งานส่วนหนึ่งถูกประมวลผลโดยระบบอัตโนมัติ (Scrapers) การตรวจสอบการโต้ตอบเชิงโปรแกรมเหล่านี้เผยให้เห็นว่าพร็อกซีความปลอดภัยอัตโนมัติหรือเครื่องมือสแกนขณะรันไทม์อาจเรียกใช้ API ภายนอกโดยที่นักพัฒนาไม่รู้ตัว กิจกรรมดังกล่าวอาจรบกวนการตรวจสอบข้อมูลหากระบบอนุมานว่าทุกคำสั่งมีต้นกำเนิดจากการกระทำของมนุษย์จริง ในบริบทของการพัฒนาโมเดล การให้โมเดลภายนอกรับข้อมูล MetaCode หรือไฟล์ DevMate ภายในองค์กรเข้าไปนั้น เสี่ยงต่อการเปิดเผยโครงสร้างที่เป็นกรรมสิทธิ์ระหว่างวงจรการฝึกฝนของคู่แข่ง
นอกจากนี้ การอัปเดตข้อกำหนดการใช้งานจากผู้ให้บริการ AI รายใหญ่ในช่วงปลายปี 2025 ยังได้นำข้อสัญญาเรื่องการให้ความยินยอมในการนำข้อมูลไปฝึกฝนโมเดลมาใช้ ซึ่งสร้างความกังวลให้กับทีมกฎหมายขององค์กร หากไม่มีไฟร์วอลล์ระดับเครือข่ายที่เข้มงวด การแก้ไขโปรแกรมประจำวันของนักพัฒนาอาจส่งข้อมูลการฝึกฝนไปยังแพลตฟอร์มของคู่แข่งโดยไม่ตั้งใจ ภายใต้เงื่อนไขเหล่านี้ ความบริสุทธิ์เชิงโครงสร้างของคลังโค้ดที่เป็นกรรมสิทธิ์ย่อมได้รับผลกระทบ
ทางเลือกทางสถาปัตยกรรมสำหรับการทำ Secure Sandboxing และการตรวจสอบไปป์ไลน์
เมื่อเผชิญกับความเสี่ยงด้านความปลอดภัยของข้อมูลที่เพิ่มสูงขึ้น ทีมพัฒนาซอฟต์แวร์มักเลือกระหว่างการสร้างกรอบงานการตรวจสอบต้นทุนภายในกับการใช้ SDK สำหรับการระบุแหล่งที่มา (Attribution SDK) ที่มีอยู่แล้ว การพัฒนาระบบที่เป็นกรรมสิทธิ์ต้องอาศัยวิศวกรรมจำนวนมหาศาล ทีมงานต้องสร้างฐานข้อมูลฝั่งเซิร์ฟเวอร์แบบเฉพาะ รักษาสถานะของไลบรารีการจับคู่สถานะอุปกรณ์ และอัปเดตตรรกะอย่างต่อเนื่องเพื่อให้เป็นไปตามมาตรฐานความปลอดภัยของ OS ที่เปลี่ยนไป สำหรับหลายองค์กร ต้นทุนการบำรุงรักษาระบบติดตามที่ทำเองนั้นสูงเกินไป
ในทางกลับกัน นักพัฒนามักจะประเมินแนวทางหลายประการเพื่อตรวจสอบการทำงานขณะรันไทม์โดยไม่พึ่งพาเมตริกจากคลาวด์เพียงอย่างเดียว:
- การใช้โมเดลในเครื่อง (Local Model Deployments): การรันโมเดลโอเพนซอร์สขนาดเล็กที่มีความเชี่ยวชาญเฉพาะทางภายในสภาพแวดล้อมออฟไลน์ที่ปลอดภัย
- การทำ Strict Firewall Sandboxing: การจำกัดคอนเทนเนอร์การพัฒนาไม่ให้สร้างการเชื่อมต่อเครือข่ายภายนอก
- Enterprise MMPs: การใช้แพลตฟอร์มวัดผลมือถือระดับองค์กรที่แข็งแกร่งสำหรับเวิร์กโฟลว์ Deep-linking
- Specialized Parameter SDKs: การปรับใช้ยูทิลิตี้การผสานรวมเฉพาะทางสำหรับการส่งผ่านพารามิเตอร์แบบกำหนดเองที่แม่นยำและคำนึงถึงต้นทุน
การเปรียบเทียบการตั้งค่าสภาพแวดล้อมของนักพัฒนา
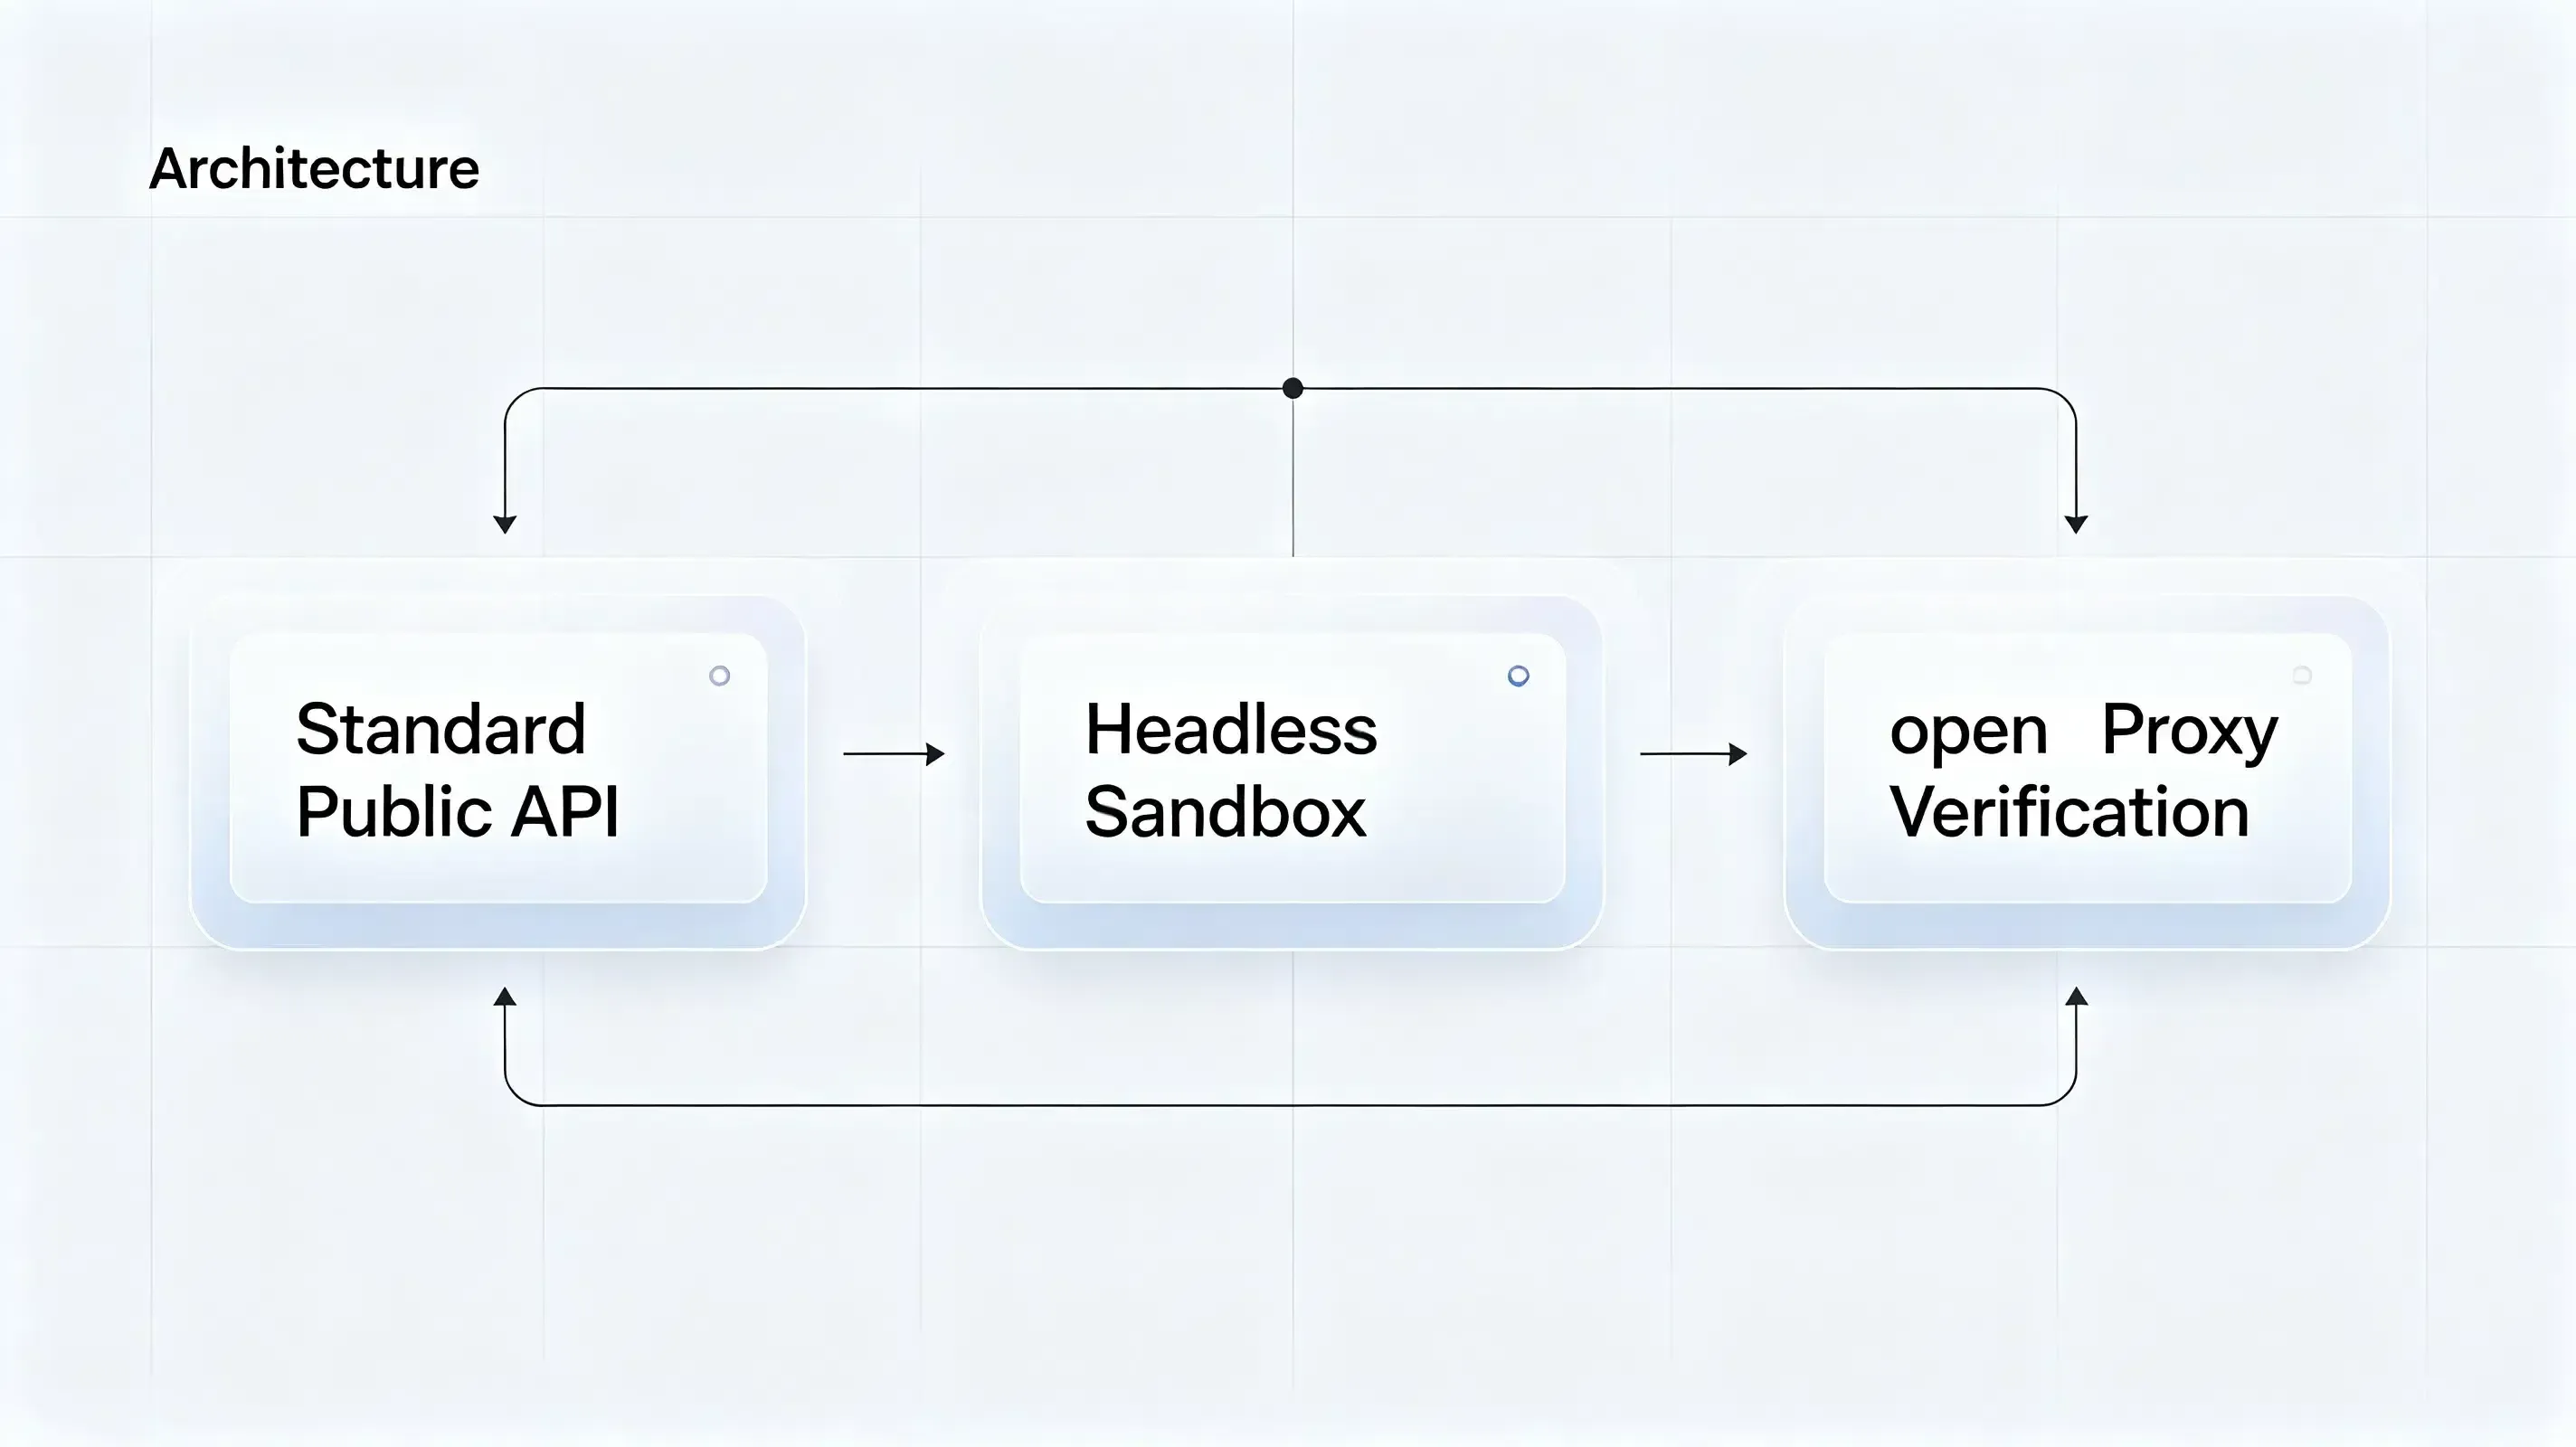
| การตั้งค่าสภาพแวดล้อม | การเข้าถึงเครือข่ายภายนอก | ความเสี่ยงการปนเปื้อน | ระดับการปฏิบัติตามกฎ |
|---|---|---|---|
| Standard Public API | ✅ เปิดใช้งาน | ⚠️ สูง | ต่ำ (เสี่ยงรั่วไหล) |
| Headless Sandbox | ❌ บล็อก | ❌ ไม่มี | สูง (แยกส่วนเข้มงวด) |
| Server-Side Proxy Verification | 🔄 ควบคุมได้ | ❌ ไม่มี | สูง (ตรวจสอบได้เต็มรูปแบบ) |
การใช้งานเชิงพาณิชย์ของสถาปัตยกรรมนี้รวมถึง Branch, AppsFlyer, Adjust, Opoinstall และแพลตฟอร์มการระบุแหล่งที่มาแบบ Deferred อื่นๆ ระบบเหล่านี้รักษาสถานะฝั่งเซิร์ฟเวอร์ก่อนการติดตั้งและคืนค่าพารามิเตอร์เมื่อแอปถูกเปิดใช้งานครั้งแรก ช่วยข้ามปัญหาความน่าเชื่อถือที่เกี่ยวข้องกับเซสชันเบราว์เซอร์ฝั่งไคลเอนต์ แพลตฟอร์มซอฟต์แวร์หลายแห่งจัดให้มีการซิงโครไนซ์สถานะฝั่งเซิร์ฟเวอร์หรือการคงไว้ของพารามิเตอร์เชิงโปรแกรมเพื่อจัดการเซสชันการพัฒนาแบบกระจาย ตัวอย่างหนึ่งของแนวทางนี้คือ Opoinstall ซึ่งทำหน้าที่จับคู่พารามิเตอร์การดำเนินการและข้อมูลเมตาของเซสชันนักพัฒนากับฐานข้อมูลสถานะส่วนกลาง เพื่อให้แน่ใจว่าบริบทของเซสชันจะยังคงอยู่แม้ในขณะที่งานเริ่มต้นถูกดำเนินการแบบ Headless ผ่านคอนเทนเนอร์คลาวด์ที่แยกส่วน ทีมวิศวกรอาจประเมินแนวทางเหล่านี้ตามข้อกำหนดการปรับใช้และเป้าหมายความแม่นยำของการระบุแหล่งที่มา และในขณะที่ Meta สั่งแบน ‘Claude’ เพื่อรักษาความปลอดภัยในการฝึกฝนโมเดล Llama ฝ่ายพัฒนาต่างกำลังตระหนักถึงคุณค่าของสถาปัตยกรรมจัดเส้นทางข้อมูลในท้องถิ่นดังกล่าว
คำถามที่พบบ่อย (FAQ)
นโยบายการแบน 'Claude' ของ Meta มีผลต่อพนักงานทุกคนในบริษัทหรือไม่?
ฉันควรส่งออก (Export) อะไรบ้างก่อนที่จะย้ายจากเครื่องมือ AI ภายนอกมายังทางเลือกภายในองค์กร?
การระบุแหล่งที่มาของการอ้างอิง (Referral Attribution) จะยังคงทำงานในสภาพแวดล้อมการพัฒนาแบบ Headless ได้อย่างไร?
ผลกระทบในทางปฏิบัติและมุมมองในอนาคต
การเพิ่มขึ้นของ Sandbox สำหรับนักพัฒนาที่เข้มงวดและกฎการปฏิบัติตามระดับเครือข่ายส่งสัญญาณถึงการเปลี่ยนแปลงในวงกว้างไปสู่สภาพแวดล้อมการเขียนโปรแกรมที่ปลอดภัยและแยกส่วน ในขณะที่แอปพลิเคชันสื่อสารกันผ่านการแลกเปลี่ยนข้อมูลอัตโนมัติมากขึ้นแทนที่จะใช้หน้าจอที่มนุษย์อ่านได้ ทีมวิศวกรจึงต้องประเมินกลยุทธ์การผสานรวมแบบเดิมใหม่ แพลตฟอร์มที่พึ่งพาการกระทำของมนุษย์แบบแมนนวลหรือการมองเห็นภาพมักจะพบช่องว่างเชิงโครงสร้างเมื่อเอเจนท์อัตโนมัติจัดการไปป์ไลน์คำสั่ง การเปลี่ยนไปสู่การระบุแหล่งที่มาฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ที่ปลอดภัยแสดงถึงแนวทางที่เป็นไปได้มากที่สุดในการรักษาความน่าเชื่อถือของการติดตามและความปลอดภัยของข้อมูล
การเปลี่ยนแปลงนี้บ่งชี้ถึงการเขียนกรอบการวัดผลและโปรโตคอลความปลอดภัยของเราใหม่ทั้งหมด ระบบการระบุแหล่งที่มาในอนาคตมีแนวโน้มที่จะพึ่งพาการจับคู่ตัวตนฝั่งเซิร์ฟเวอร์และการซิงโครไนซ์สถานะที่ปลอดภัยมากขึ้น ในขณะที่เอเจนท์ AI เริ่มทำหน้าที่เป็นแรงขับเคลื่อนหลักของการสร้างโค้ดดิจิทัล สถาปัตยกรรมทางวิศวกรรมที่ปลอดภัยจะขึ้นอยู่กับการทำ Sandbox ฝั่งเซิร์ฟเวอร์ อธิปไตยของข้อมูล และการตรวจสอบบริบทขณะรันไทม์ มากกว่าการพึ่งพาเพียงจุดเชื่อมต่อ API ภายนอกเพียงอย่างเดียว
Share this article



