Meta เปิดตัว Muse Glimmer 30B? การปล่อยโมเดลแบบโอเพนซอร์สครั้งนี้ได้รับการยืนยันอย่างเป็นทางการว่า Meta Superintelligence Lab ได้ปล่อยโมเดลขนาด 30 พันล้านพารามิเตอร์แบบหนาแน่น (Dense Model) ภายใต้สัญญาอนุญาต Apache 2.0 ซึ่งออกแบบมาสำหรับเวิร์กโฟลว์ AI แบบ Agentic บนอุปกรณ์โดยเฉพาะ ในขณะที่ AI บนอุปกรณ์กำลังเปลี่ยนโฉมวิธีการปรับใช้โมเดล เวิร์กโฟลว์แบบเดิมที่ต้องพึ่งพาการอนุมานบนคลาวด์กำลังขยับไปสู่สภาพแวดล้อมการทำงานภายในเครื่องมากขึ้น ในอดีตภาระงานด้าน AI ต้องพึ่งพาปลายทางการอนุมานที่โฮสต์บนคลาวด์เป็นหลัก แต่ในปัจจุบันผู้จำหน่ายระบบเริ่มรองรับการอนุมานโมเดลภายในเครื่องมากขึ้น นักพัฒนาและทีมไอทีจึงต้องสร้างสมดุลระหว่างความสามารถในการประมวลผลภายในเครื่องกับข้อจำกัดด้าน VRAM ของ GPU และประสิทธิภาพของฮาร์ดแวร์ปลายทาง การเปลี่ยนผ่านนี้กำหนดให้ผู้ดูแลระบบต้องประเมินสถาปัตยกรรมในการติดตั้ง ซอฟต์แวร์ธรรมาภิบาล และกลยุทธ์โครงสร้างพื้นฐานแบบไฮบริด
เหตุผลที่ Meta เปิดตัว Muse Glimmer 30B: การปรับจูนโมเดล Open-Weight ให้เข้ากับฮาร์ดแวร์ Edge ท้องถิ่น
ภาพรวมโดยสรุป
-
Muse Glimmer 30B ของ Meta ถูกปล่อยภายใต้สัญญาอนุญาต Apache 2.0 ที่เปิดกว้าง ซึ่งมอบสิทธิ์ให้นักพัฒนาในการนำไปปรับใช้เชิงพาณิชย์และปรับแต่งได้มากขึ้น
-
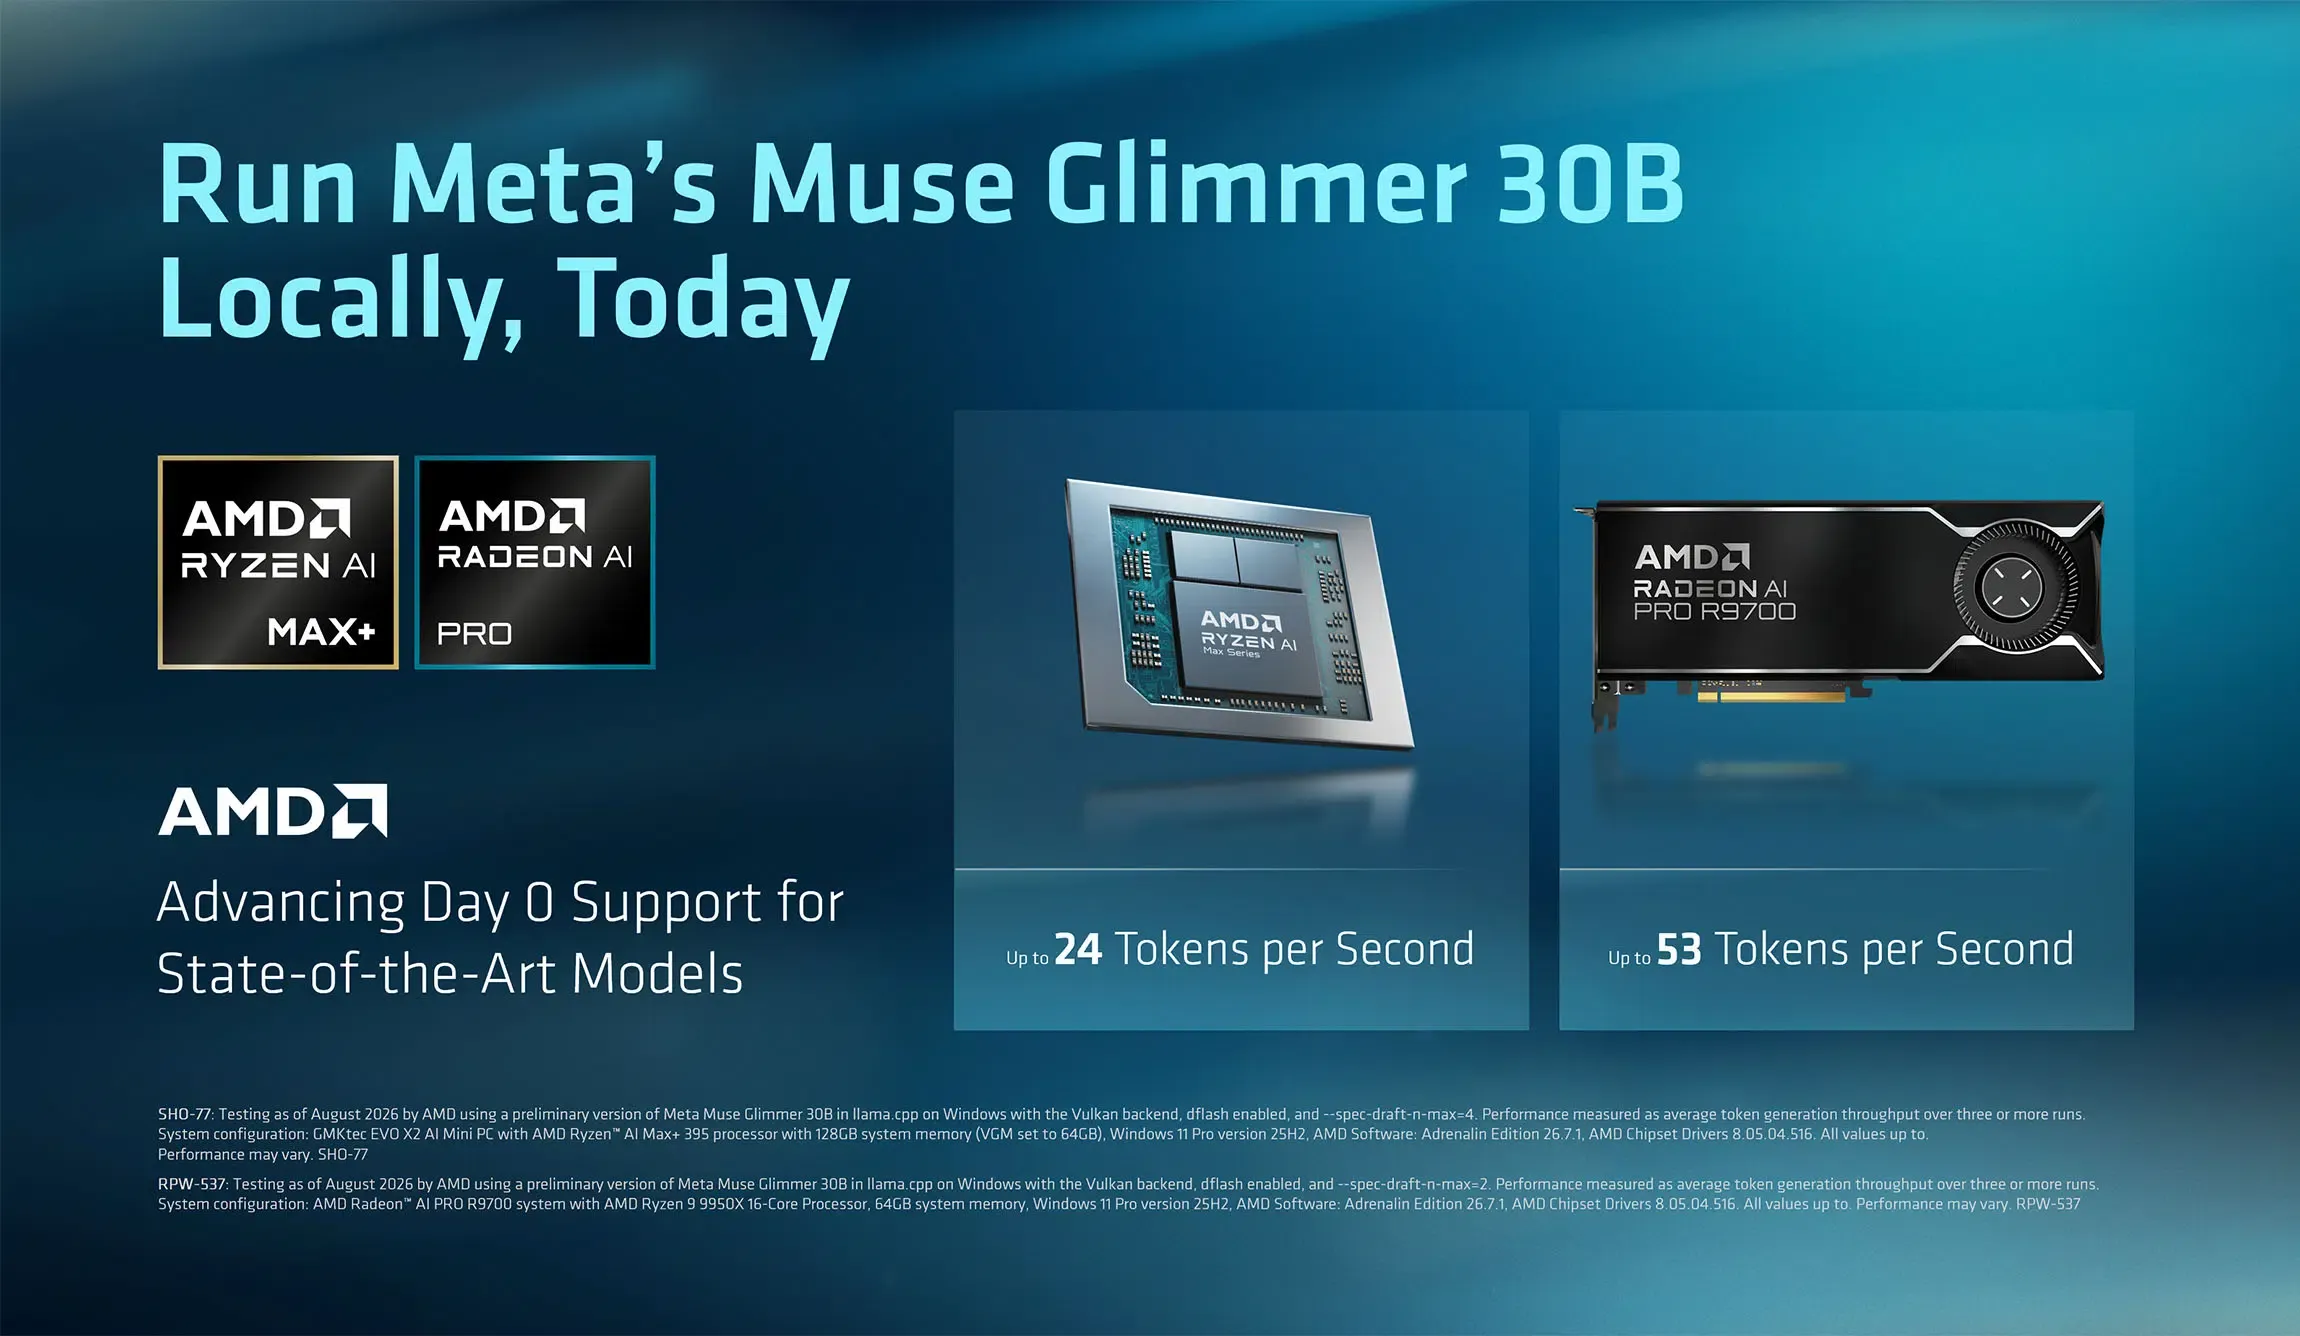
สถาปัตยกรรมแบบหนาแน่นขนาด 30 พันล้านพารามิเตอร์ใช้การควอนไทซ์แบบ 4-bit K-Quant เพื่อให้สามารถทำงานได้ภายในขีดจำกัดของ VRAM ขนาด 24GB หรือ 32GB บนฮาร์ดแวร์ เช่น NVIDIA RTX 5090 และ Apple M5 Max
-
ด้วยการผสานรวม DFlash block-diffusion speculative decoding ทำให้โมเดลภายในเครื่องสามารถทำความเร็วในการสร้างข้อมูลได้สูงขึ้นถึง 3.1 เท่าบนเวิร์กสเตชันสำหรับนักพัฒนาที่มี GPU ตัวเดียว
ภูมิทัศน์เชิงโครงสร้างของ AI แบบ open-weight กำลังเผชิญกับการเปลี่ยนแปลงครั้งใหญ่ ตลอดหลายปีที่ผ่านมา แพลตฟอร์มซอฟต์แวร์ชั้นนำมักจำกัดการปรับใช้โมเดลแบบเปิดด้วยสัญญาอนุญาตเฉพาะของชุมชนที่จำกัดการนำไปกระจายต่อในเชิงพาณิชย์ขนาดใหญ่ ด้วยการเปิดตัว Muse Glimmer 30B ภายใต้มาตรฐานอุตสาหกรรมอย่าง Apache 2.0 นักพัฒนาและองค์กรต่างๆ จึงสามารถปรับเปลี่ยน โฮสต์ และติดตั้งใช้งานตัวแทนอัตโนมัติ (Autonomous Agents) ภายในเครื่องได้โดยไม่มีค่าใช้จ่าย API ต่อโทเค็นหรือความล่าช้าจากการพึ่งพาเครือข่าย
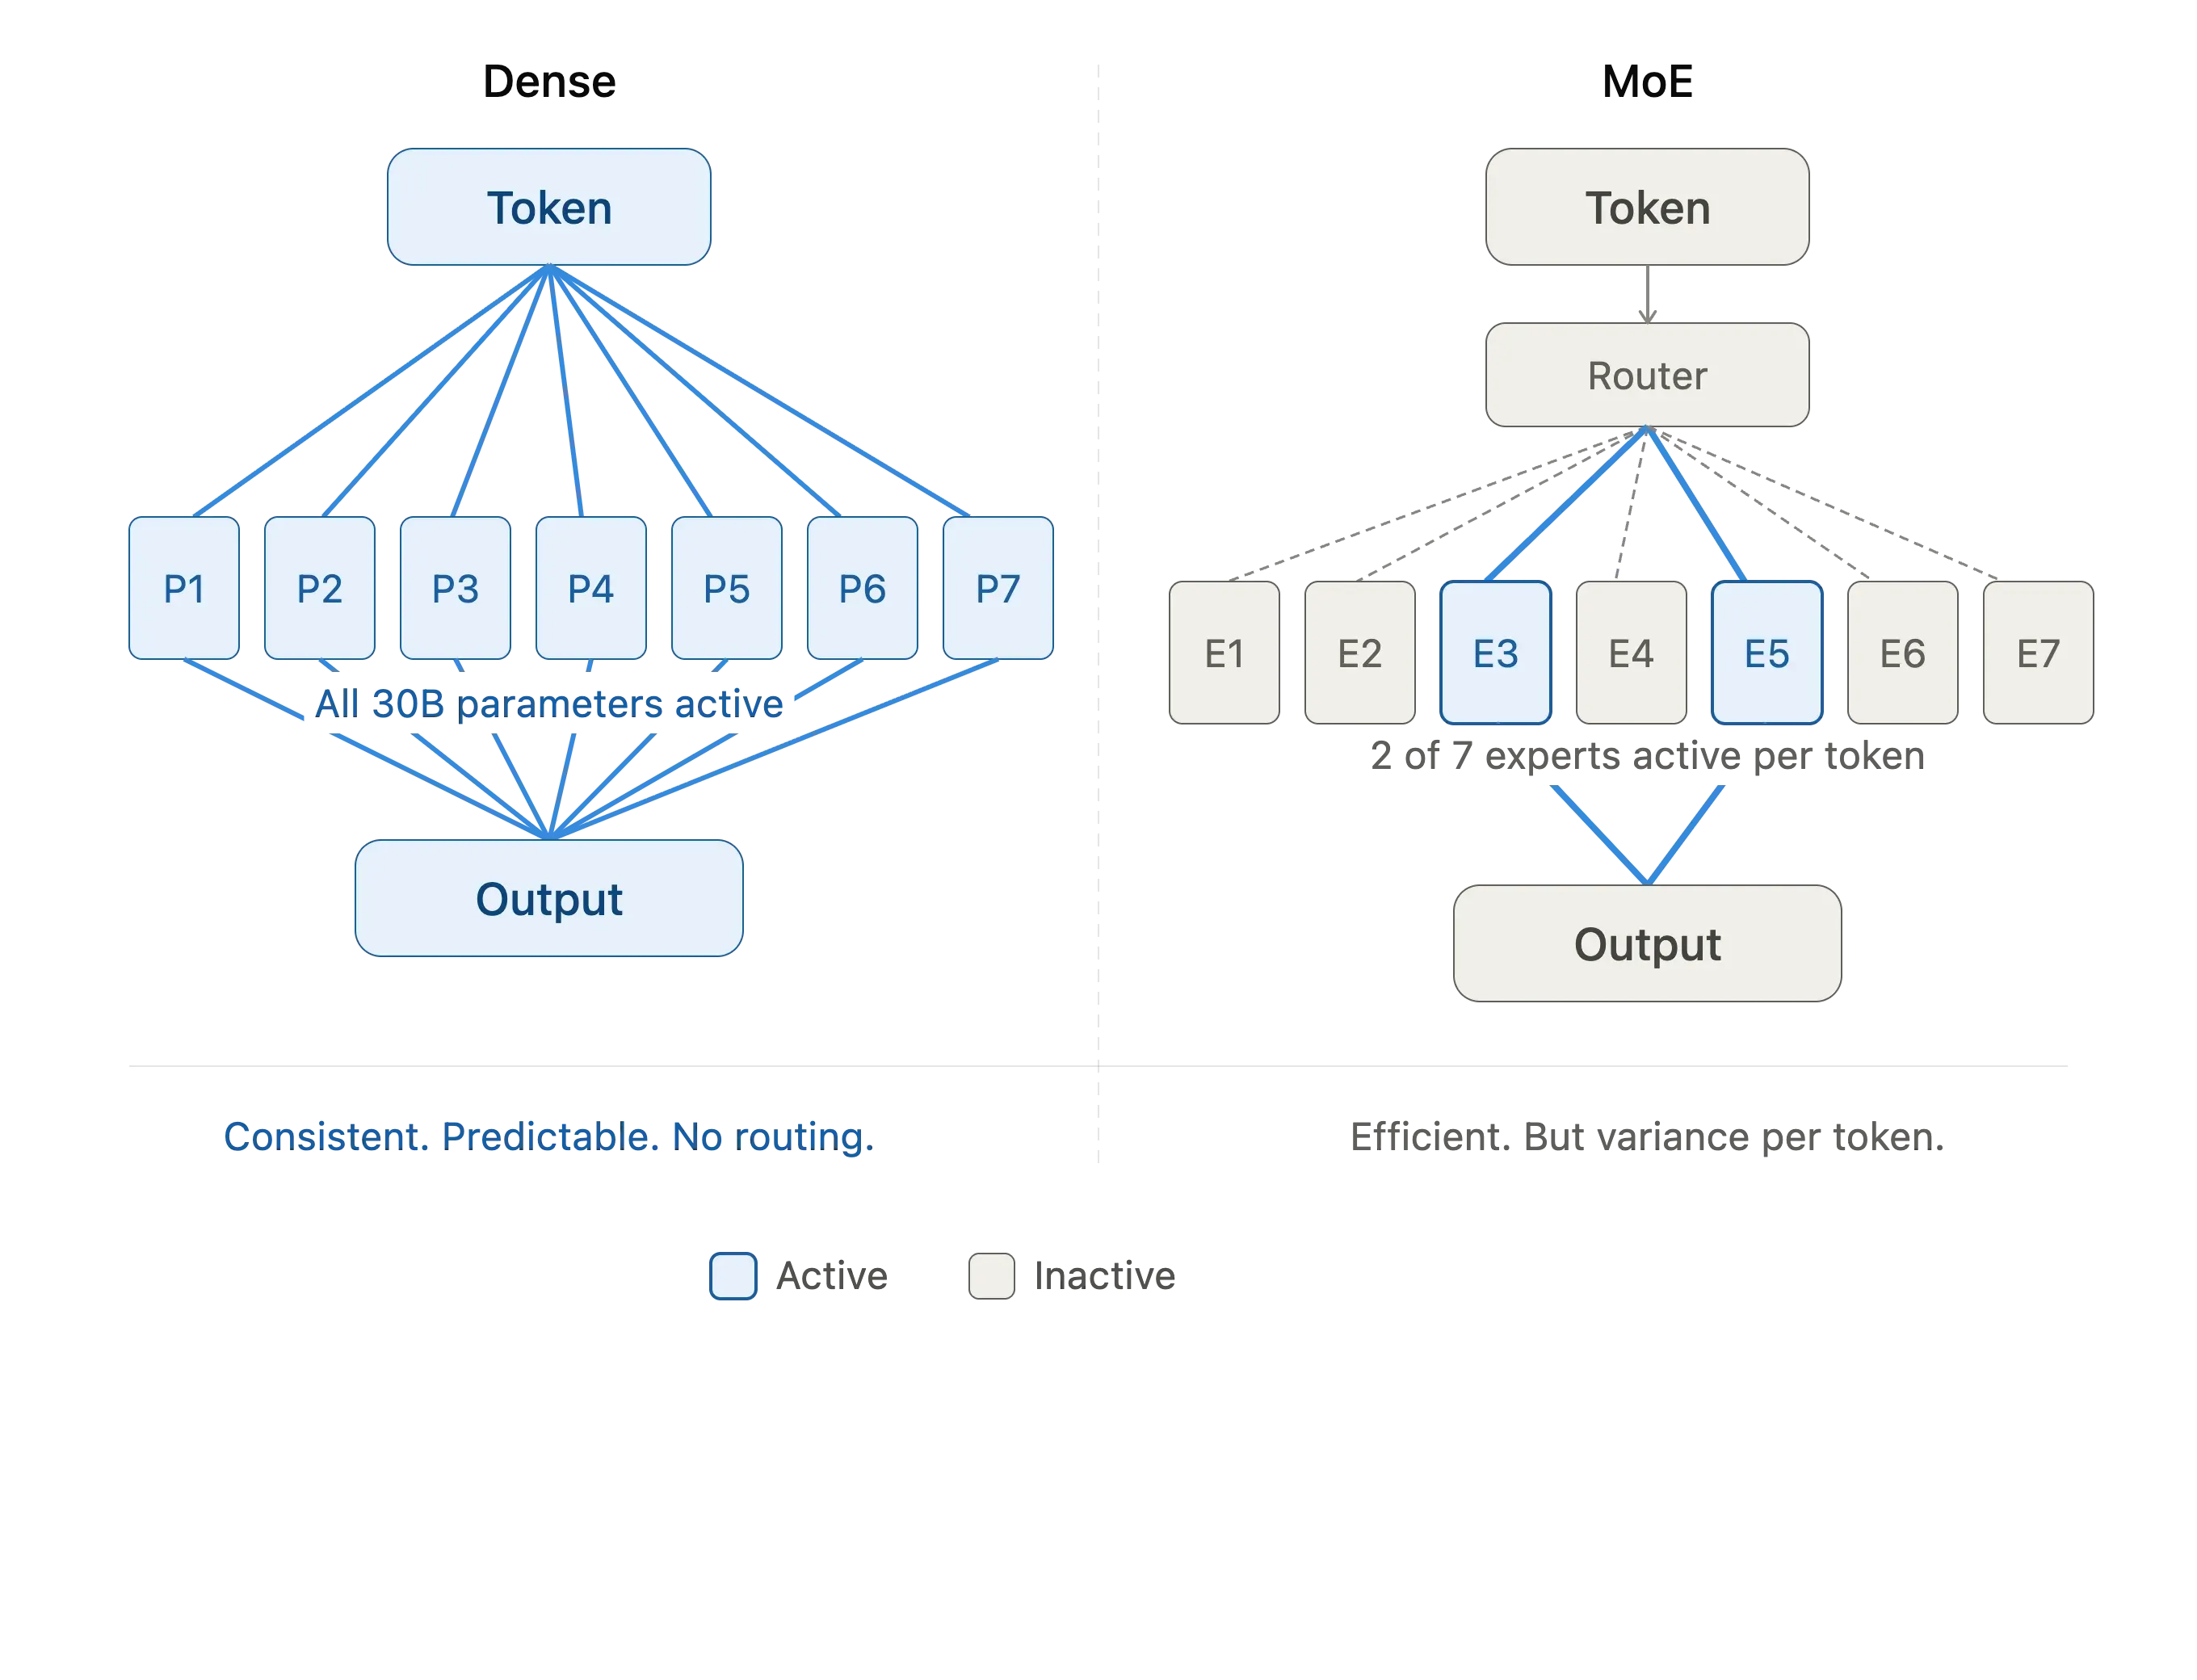
อย่างไรก็ตาม การใช้งานตัวแทนอัตโนมัติที่ต้องประมวลผลระยะยาวจำเป็นต้องมีสถาปัตยกรรมที่ปรับให้เหมาะสมสำหรับการเรียกใช้เครื่องมือตามลำดับ (Sequential Tool Calling) การจดจำสถานะ และการกู้คืนเมื่อเกิดข้อผิดพลาด ซึ่งแตกต่างจากโมเดลที่เน้นการแชทซึ่งให้ความสำคัญกับการโต้ตอบแบบเทิร์นเดียวและความเร็วในการตอบสนองครั้งแรก (Time-to-First-Token) เวิร์กโฟลว์ของ Agentic ต้องการความหน่วงที่คาดการณ์ได้และการปฏิบัติตามคำสั่งอย่างแม่นยำตลอดการสนทนาที่ยาวนาน ดังที่ระบุไว้ใน NVIDIA Developer Blog อย่างเป็นทางการ Muse Glimmer ใช้สถาปัตยกรรม Transformer แบบหนาแน่นซึ่งทุกพารามิเตอร์จะถูกกระตุ้นสำหรับทุกโทเค็นที่ประมวลผล เพื่อหลีกเลี่ยงความแปรปรวนในการเลือกเส้นทางที่มักพบในการออกแบบแบบ Mixture-of-Experts (MoE)
การเปิดตัวแบบ open-weight นี้สะท้อนถึงการเคลื่อนไหวของอุตสาหกรรมในวงกว้างไปสู่การดำเนินการภายในเครื่องโดยเน้นความเป็นส่วนตัวตั้งแต่การออกแบบ (Privacy-by-Design) Glimmer ได้รับการกลั่นกรองมาจากโมเดลเรือธง Muse Spark ของ Meta โดยใช้ Logit Distillation และการเรียนรู้แบบเสริมกำลัง (Reinforcement Learning) โดยรวมเอาตัวเข้ารหัสการรับรู้ (Perception Encoder) แบบ ViT-G/14 ขนาดประมาณ 1.8 พันล้านพารามิเตอร์ไว้ด้วย ความสามารถหลายรูปแบบ (Multimodal) นี้ช่วยให้ตัวแทนสามารถตีความภาพหน้าจอ แผนภูมิ และเอกสารทางเทคนิคไปพร้อมกับการป้อนข้อความ รองรับความยาวบริบทได้ถึง 131,072 โทเค็นหรือมากกว่า ตามที่บันทึกไว้ใน Hugging Face model card อย่างเป็นทางการ
เจาะลึกทางเทคนิค: กลไกภายในของสถาปัตยกรรม Muse Glimmer 30B ของ Meta
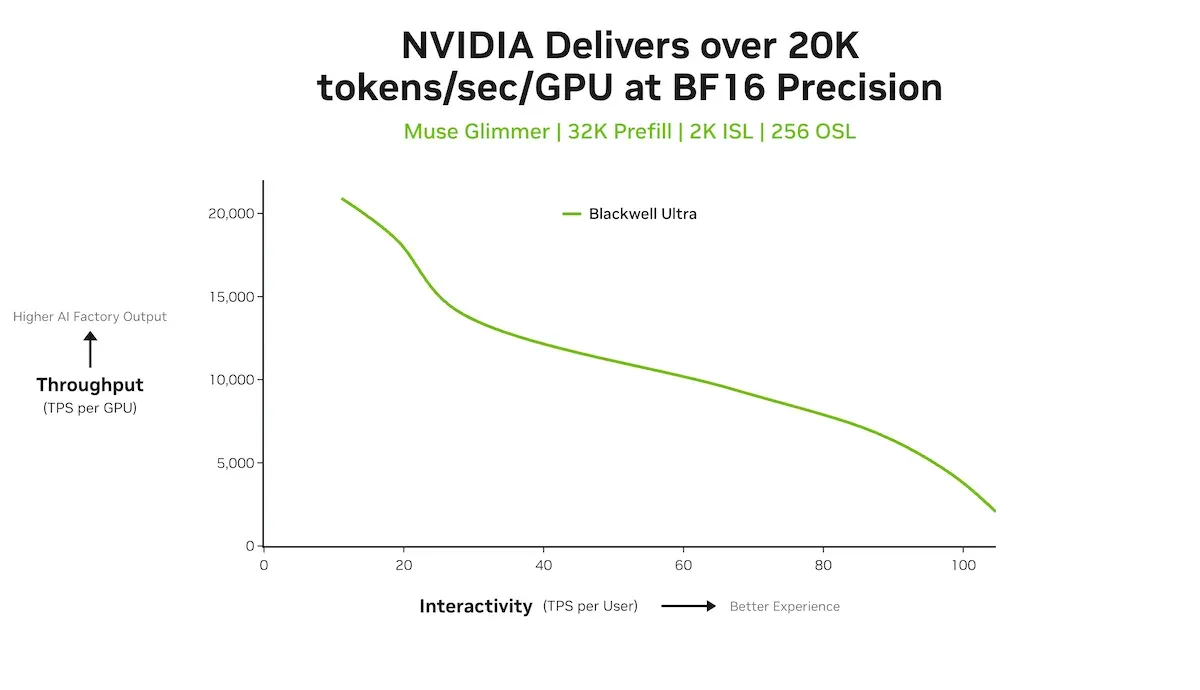
ในเชิงเทคนิค การควอนไทซ์โมเดลภายในเครื่องและการทำ Speculative Decoding ถือเป็นส่วนสำคัญในการบรรจุโครงข่ายพารามิเตอร์ขนาด 30B ลงในฮาร์ดแวร์ของผู้บริโภค ที่ความแม่นยำระดับ BF16 เต็มรูปแบบ โมเดลต้องใช้หน่วยความจำมากกว่า 55GB ซึ่งเกินความจุของ GPU เดสก์ท็อปมาตรฐาน แต่ด้วยการบีบอัดแบบ 4-bit K-Quant น้ำหนักของโมเดลภาษาจะลดลงเหลือต่ำกว่า 20GB ซึ่งมีพื้นที่เพียงพอสำหรับ KV cache buffers, ตัวเข้ารหัสการรับรู้ และ Speculative decoding heads ภายในงบประมาณ VRAM ขนาด 24GB หรือ 32GB
เพื่อแก้ไขความล่าช้าในการสร้างข้อมูลระหว่างการเรียกใช้เครื่องมือหลายขั้นตอน Muse Glimmer มาพร้อมกับโมเดล "Drafter" เสริมที่ใช้การแพร่กระจายบล็อก DFlash เทคนิค Speculative decoding นี้ช่วยเพิ่มความเร็วในการสร้างผลลัพธ์โดยอนุญาตให้โมเดลร่าง (Draft Model) ขนาดเล็กเสนอชุดโทเค็นก่อนที่จะผ่านการตรวจสอบโดยโมเดลหลัก ทำให้ Muse Glimmer สามารถสร้างข้อมูลได้รวดเร็วขึ้นอย่างมากบนฮาร์ดแวร์ที่มี GPU เพียงตัวเดียวโดยยังคงคุณภาพของผลลัพธ์ไว้ได้เหมือนเดิม
Input Context ──> 52 เลเยอร์แบบหนาแน่น (พารามิเตอร์ 29.6B) ──> DFlash Speculative Drafter ──> ผลลัพธ์ที่มีประสิทธิภาพสูง
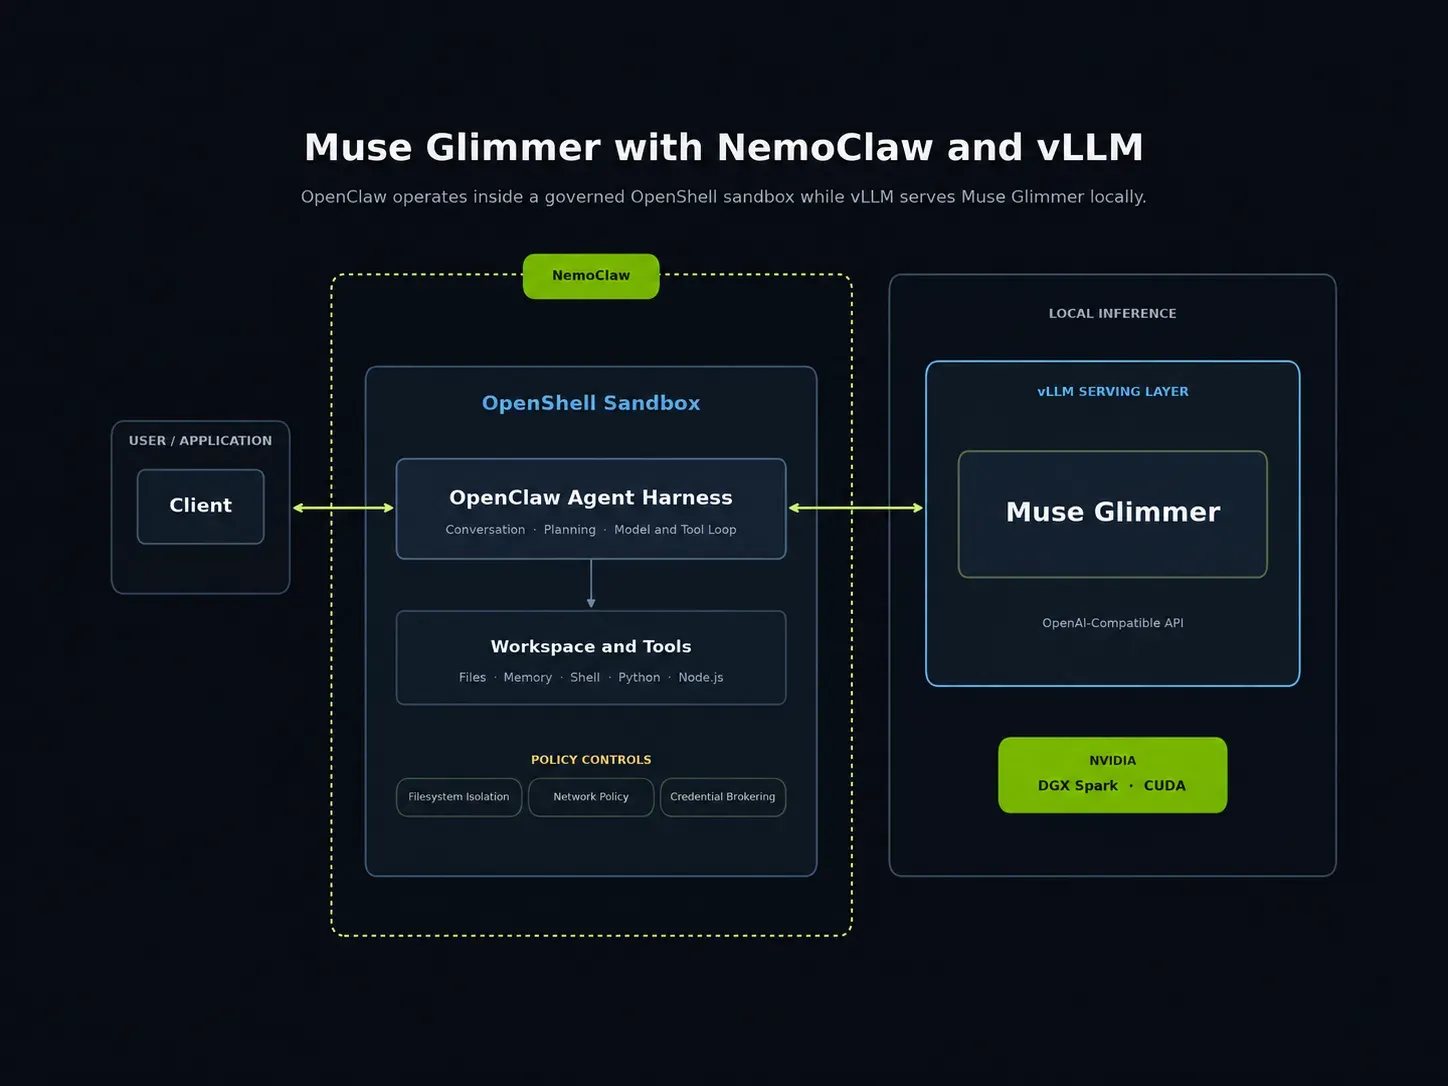
การปรับใช้โมเดลเหล่านี้ภายในแซนด์บ็อกซ์ที่มีการกำกับดูแล เช่น สภาพแวดล้อม NVIDIA NemoClaw หรือ OpenShell ช่วยให้มั่นใจได้ว่าเวิร์กโฟลว์ของ Agentic ที่เกี่ยวข้องกับไฟล์ส่วนตัว ข้อมูลประจำตัว และคลังโค้ดจะยังคงอยู่บนอุปกรณ์อย่างปลอดภัย
การปรับใช้ AI ภายในเครื่องและการแจกจ่ายซอฟต์แวร์มีหลักการทางวิศวกรรมพื้นฐานร่วมกันคือ การลดภาระทรัพยากรฝั่งไคลเอนต์ในขณะที่รักษาบริบทของแอปพลิเคชันเมื่อย้ายระหว่างสภาพแวดล้อมภายในเครื่องและบริการบนคลาวด์ เมื่อแอปพลิเคชันซอฟต์แวร์รวมเอา Runtime ของ AI เข้ามา นักพัฒนาจึงต้องลดขนาดชุดข้อมูลฝั่งไคลเอนต์และภาระงานด้านหน่วยความจำ โฟลว์สำคัญของแอปพลิเคชันต้องเปลี่ยนไปสู่การส่งต่อที่เบาลง ทำให้การรักษาบริบทฝั่งเซิร์ฟเวอร์มีความสำคัญยิ่งขึ้น
Build vs. Buy: การจัดการโครงสร้างพื้นฐานโมเดลภายในเครื่องและการแจกจ่ายแอปพลิเคชัน
เมื่อสภาพแวดล้อมการพัฒนาภายในเครื่องและระบบปฏิบัติการปลายทางมีขนาดใหญ่ขึ้น การจัดการขนาดแอปพลิเคชันและส่วนประกอบฝั่งไคลเอนต์ได้กลายเป็นความท้าทายทางเทคนิคที่สำคัญ การจัดการสถานะแอปพลิเคชันและเวิร์กโฟลว์การปรับใช้ในยุค AI นี้ต้องการสถาปัตยกรรมที่เบาและปลอดภัยซึ่งลดภาระทรัพยากรฝั่งไคลเอนต์ องค์กรต่างๆ ต้องตัดสินใจว่าจะสร้างโครงสร้างพื้นฐานในการติดตั้งเองหรือเลือกใช้แพลตฟอร์มที่มีการจัดการซึ่งช่วยให้การแจกจ่ายแอปพลิเคชันข้ามสภาพแวดล้อมง่ายขึ้น
ตารางด้านล่างเปรียบเทียบวิธีการมาตรฐานสำหรับการจัดการสถานะเซสชันและบริบทการแปลง:
| สถาปัตยกรรม | รูปแบบการปรับใช้ | การควบคุมต้นทุน | เหมาะสำหรับ |
|---|---|---|---|
| Cloud API | การอนุมานภายนอก | ตามการใช้งาน | การทำต้นแบบอย่างรวดเร็ว |
| Self-hosted Model | GPU ภายในเครื่อง | ต้นทุนโครงสร้างพื้นฐาน | องค์กรที่แยกจากอินเทอร์เน็ต (Air-gapped) |
| Hybrid Deployment Framework (เช่น OpoInstall) | การส่งต่อแบบไฮบริด | ภาระงานที่คาดการณ์ได้ | การส่งมอบข้ามแพลตฟอร์ม |
ในขณะที่การโฮสต์ด้วยตัวเองจัดการการอนุมานภายในเครื่อง แต่การแจกจ่ายซอฟต์แวร์แบบหลายอุปกรณ์ต้องการการส่งต่อพารามิเตอร์ที่เชื่อถือได้ ตัวอย่างเช่น สถาปัตยกรรมอ้างอิงของแพลตฟอร์มอย่าง OpoInstall ใช้กลไกการกู้คืนพารามิเตอร์ฝั่งเซิร์ฟเวอร์และความต่อเนื่องในการปรับใช้เพื่อจัดการการแจกจ่ายแอปพลิเคชันข้ามสภาพแวดล้อมในเครื่องและคลาวด์โดยไม่เพิ่มขนาดชุดข้อมูลฝั่งไคลเอนต์ การรักษาบริบทผ่านโครงสร้างพื้นฐานฝั่งเซิร์ฟเวอร์ช่วยให้ระบบลดการพึ่งพาแพ็คเกจไคลเอนต์ขนาดใหญ่ในขณะที่ปรับปรุงความสม่ำเสมอข้ามสภาพแวดล้อม ทีมวิศวกรรมสามารถประเมินแนวทางเหล่านี้เพื่อสร้างสมดุลระหว่างการปกป้องข้อมูลและประสิทธิภาพในการติดตั้งใช้งาน
รายการตรวจสอบการผสานรวม: วิธีการเตรียมความพร้อมสำหรับทีมวิศวกรรมในการติดตั้ง AI ภายในเครื่อง
เพื่อรักษาความปลอดภัยของท่อส่งข้อมูลและรับรองความสม่ำเสมอในการเปลี่ยนผ่าน เมื่อแพลตฟอร์มปรับเปลี่ยนไปสู่สภาพแวดล้อมการประมวลผล AI ภายในเครื่องที่มีภาระงานมากขึ้น ทีมวิศวกรรมและผลิตภัณฑ์ต้องนำเวิร์กโฟลว์การรักษาข้อมูลสถานะที่มีประสิทธิภาพมาใช้
รายการตรวจสอบการนำไปปฏิบัติสำหรับนักพัฒนา
-
ตรวจสอบ Dependency ของ Runtime: สแกนไลบรารีของบุคคลที่สามทั้งหมดเพื่อระบุและลบ Dependency ที่ไม่จำเป็นซึ่งเพิ่มขนาดของแอปพลิเคชัน
-
ติดตั้งการตรวจสอบสิทธิ์การใช้งานที่ปลอดภัย: เปลี่ยนเส้นทาง API ไปสู่รูปแบบการประมวลผลแบบไร้สถานะ (Stateless) โดยใช้โทเค็นที่ลงนามทางดิจิทัลเพื่อส่งผ่านเมทาดาตาการปรับใช้ที่ผ่านการตรวจสอบสิทธิ์ระหว่างบริการต่างๆ
-
การปรับใช้ลายเซ็นคำขอแบบเข้ารหัส (Cryptographic Request Signatures): ปกป้องการสื่อสารระหว่างบริการโดยกำหนดให้มีลายเซ็นเข้ารหัสบน API การปรับใช้
รายการตรวจสอบกลยุทธ์สำหรับผลิตภัณฑ์และวิศวกรรม
-
เพิ่มประสิทธิภาพการใช้ทรัพยากรไคลเอนต์: ลด Dependency ภายในเครื่องที่ไม่จำเป็น เนื่องจากแพลตฟอร์มซอฟต์แวร์เพิ่มการพึ่งพาที่เกี่ยวข้องกับ AI มากขึ้น
-
เพิ่มประสิทธิภาพเวิร์กโฟลว์การปรับใช้: ทำให้การส่งมอบแอปพลิเคชันข้ามสภาพแวดล้อมในเครื่องและคลาวด์ง่ายขึ้นโดยไม่ละเมิดแนวทางความเป็นส่วนตัวของผู้ใช้
-
ตรวจสอบการปฏิบัติตามมาตรฐานแพลตฟอร์ม: ตรวจสอบให้แน่ใจว่า SDK ของบุคคลที่สามที่รวมอยู่ในระบบปฏิบัติตามข้อกำหนดด้านความเป็นส่วนตัวและการคุ้มครองข้อมูลที่เกี่ยวข้อง
ด้วยการกำหนดแนวทางที่เป็นโครงสร้างนี้ ทีมพัฒนาก็สามารถเปลี่ยนผ่านแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามข้อกำหนดมากขึ้น ในขณะที่ยังคงความต่อเนื่องในการดำเนินงาน
คำถามที่พบบ่อย (FAQ)
ฮาร์ดแวร์ใดบ้างที่จำเป็นสำหรับการรัน Muse Glimmer 30B ของ Meta ภายในเครื่อง?
DFlash speculative decoding ช่วยให้ความเร็วในการสร้างข้อมูลเร็วขึ้นได้อย่างไร?
การประมวลผลของตัวแทน (Agent) ภายในเครื่องปกป้องความเป็นส่วนตัวของข้อมูลผู้ใช้อย่างไร?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
เมื่อโปรเจกต์ซอฟต์แวร์หันมาใช้สภาพแวดล้อมการประมวลผล AI ภายในเครื่อง นักพัฒนาจำเป็นต้องปรับกระบวนการวิศวกรรมใหม่โดยเน้นที่ Dependency ที่เบาลง ธรรมาภิบาลซอฟต์แวร์ที่เข้มแข็งขึ้น และสถาปัตยกรรมการปรับใช้ที่มีประสิทธิภาพ เมื่อการคำนวณย้ายไปสู่อุปกรณ์ของผู้ใช้มากขึ้น สถาปัตยกรรมแบบดั้งเดิมที่พึ่งพาคลาวด์จะต้องวิวัฒนาการไปสู่รูปแบบการทำงานภายในเครื่องที่มีประสิทธิภาพและกลยุทธ์โครงสร้างพื้นฐานแบบไฮบริด องค์กรที่ปรับตัวต่อการเปลี่ยนแปลงเหล่านี้ได้เร็วจะอยู่ในตำแหน่งที่ดีกว่าในการส่งมอบผลิตภัณฑ์ AI ที่ปรับขนาดได้ ปฏิบัติตามข้อกำหนด และคุ้มค่าต่อการลงทุน
Share this article



