 ทำไม NVIDIA ถึงจับคู่ GPU เข้ากับ ASIC ของ d-Matrix? NVIDIA ไม่ได้พึ่งพาแค่ GPU อีกต่อไป เหตุใด NVIDIA จึงเลือกเป็นพันธมิตรกับ d-Matrix แทนที่จะสร้าง ASIC สำหรับทำ Inference เอง? คำตอบนี้เผยให้เห็นการเปลี่ยนแปลงครั้งใหญ่ในโครงสร้างพื้นฐานของ AI นั่นคือ การเพิ่มประสิทธิภาพด้าน Inference กำลังเปลี่ยนจากการขยายขนาด GPU แบบเดิม ไปสู่การใช้ตัวเร่งความเร็วเฉพาะทางสำหรับแต่ละงาน (Workload-specific acceleration) เมื่อการประมวลผล AI Inference กระจายตัวอยู่ระหว่าง GPU, ตัวเร่งความเร็ว ASIC และสภาพแวดล้อมคลาวด์แบบกระจายศูนย์ ความท้าทายจึงไม่ได้มีแค่เรื่องความสามารถในการประมวลผลเพียงอย่างเดียว แต่การจัดการฮาร์ดแวร์ การกำหนดเส้นทางของเวิร์กโหลด และประสิทธิภาพในระดับระบบก็มีความสำคัญไม่แพ้กัน ในขณะที่เวิร์กโหลดของ generative AI กำลังเปลี่ยนจากการใช้คลัสเตอร์ขนาดใหญ่สำหรับการเทรน ไปสู่การใช้งานโมเดลแบบเรียลไทม์ การเพิ่มความเร็วในการสร้าง Token จึงกลายเป็นโจทย์วิศวกรรมที่สำคัญ NVIDIA จึงจับคู่ GPU เข้ากับ ASIC ของ d-Matrix เพื่อรองรับระบบ Inference แบบกระจายตัวที่ทำงานร่วมกันได้อย่างมีประสิทธิภาพ
ทำไม NVIDIA ถึงจับคู่ GPU กับ ASIC ของ d-Matrix: การปรับเวิร์กโหลดให้สอดคล้องกับฟิสิกส์ของซิลิคอน
ภาพรวม
- NVIDIA กำลังรวมกองทัพ GPU รุ่น Hopper และ Blackwell เข้ากับตัวเร่งความเร็ว Inference รุ่น Corsair ของ d-Matrix เพื่อปรับใช้ระบบ Inference แบบกระจายตัวที่ทำงานร่วมกัน
- Parasail ผู้ให้บริการ Neocloud ได้ก้าวขึ้นมาเป็นลูกค้ารายแรกในเชิงพาณิชย์ โดยเริ่มนำโซลูชันฮาร์ดแวร์ร่วมนี้ไปใช้ในศูนย์ข้อมูลทั่วโลกของตน
- เวิร์กโหลด Inference ขนาดใหญ่สามารถประสบปัญหา GPU ทำงานไม่เต็มประสิทธิภาพ (Underutilization) ได้ เมื่อแบนด์วิดท์หน่วยความจำและการเคลื่อนย้ายข้อมูลกลายเป็นตัวแปรจำกัด แทนที่จะเป็นขีดความสามารถในการประมวลผล
รูปแบบเศรษฐศาสตร์ของ AI ขนาดใหญ่กำลังอยู่ในช่วงเปลี่ยนผ่านจากการเทรนโมเดลไปสู่การใช้งาน Inference ในช่วงเริ่มต้น ผู้ให้บริการคลาวด์และนักพัฒนามุ่งเน้นไปที่พลังการประมวลผลแบบ Backpropagation โดยการซื้อคลัสเตอร์ GPU จำนวนมหาศาล การพึ่งพาผู้ขายรายเดียวเช่นนี้เป็นเรื่องสมเหตุสมผลเมื่อการเทรนข้อมูลชุดใหญ่จำเป็นต้องใช้การประมวลผลแบบขนานอย่างต่อเนื่อง อย่างไรก็ตาม เมื่อองค์กรต่าง ๆ ต้องรองรับผู้ใช้หลายล้านคนในแบบเรียลไทม์ ภาระทางการเงินจากการใช้โครงสร้างพื้นฐานที่เป็น GPU ทั้งหมดสำหรับงาน Inference จึงกลายเป็นเรื่องที่ไม่ยั่งยืน
เพื่อเพิ่มประสิทธิภาพด้านต้นทุนการดำเนินงาน สถาปนิกโครงสร้างพื้นฐานจึงหันมาใช้โครงสร้างการประมวลผลแบบแยกส่วน (Disaggregated computing) ภายใต้แนวคิดนี้ คำถามของผู้ใช้หนึ่งคำถามจะถูกแบ่งออกเป็นขั้นตอนการทำงานต่าง ๆ และถูกส่งไปยังตัวเร่งความเร็วฮาร์ดแวร์ที่เหมาะสมตามโปรไฟล์ของงานนั้น ๆ วิธีนี้ช่วยให้ผู้ให้บริการคลาวด์ได้รับประสิทธิภาพต่อดอลลาร์สูงสุดจากทรัพยากรที่มีอยู่ ซึ่งสอดคล้องกับ การสืบสวนของ The Information ที่ติดตามการบูรณาการระบบคลาวด์จากผู้ขายหลายราย
ผลกระทบในระดับอุตสาหกรรมจากการทำงานร่วมกันนี้ไปไกลกว่าแค่การแบ่งงาน ด้วยการนำตัวเร่งความเร็ว Corsair ของ d-Matrix มาทำงานร่วมกับฮาร์ดแวร์ของ NVIDIA อย่างเป็นทางการ ความร่วมมือนี้ได้สร้างเส้นทางที่ผ่านการรับรองสำหรับสถาปัตยกรรมคลาวด์แบบเฮเทอโรจีเนียส แทนที่จะบีบให้ลูกค้าเลือกระหว่างคลัสเตอร์ GPU มาตรฐานหรือซิลิคอนแบบสั่งทำพิเศษ ระบบ Inference จาก NVIDIA และ d-Matrix ช่วยให้ฮาร์ดแวร์ทำงานร่วมกันได้ ช่วยให้ผู้ให้บริการโครงสร้างพื้นฐานเพิ่มประสิทธิภาพเวิร์กโหลดทั้งส่วนการ Pre-fill และ Decode ผ่านสถาปัตยกรรมฮาร์ดแวร์ที่หลากหลายได้ สถาปัตยกรรมนี้ช่วยให้ทีมคลาวด์ระดับองค์กรสามารถขยายการใช้ประโยชน์จากฮาร์ดแวร์ในเวิร์กโหลดที่แตกต่างกันได้
กลไกเบื้องลึก: การทำ Inference แบบเฮเทอโรจีเนียสและการประมวลผลในหน่วยความจำ (In-Memory Computing)
ในระดับโปรโตคอล การตอบคำถามในรูปแบบภาษาธรรมชาติประกอบด้วย 2 ขั้นตอนที่ชัดเจน ขั้นตอนแรกเรียกว่า prefill ซึ่งจะนำคำถามของผู้ใช้มาคำนวณหาค่า Key-Value (KV) เริ่มต้น ขั้นตอนนี้ต้องใช้พลังการประมวลผลสูงมาก จึงเหมาะสมอย่างยิ่งกับประสิทธิภาพการคำนวณแบบขนานของ สถาปัตยกรรม NVIDIA Hopper
ขั้นตอนที่สองคือ decode ซึ่งจะสร้าง Token ถัดไปทีละตัวในลูปต่อเนื่องกัน เนื่องจาก Token แต่ละตัวต้องอาศัยบริบทที่สร้างมาก่อนหน้า ขั้นตอนนี้จึงถูกจำกัดด้วยแบนด์วิดท์หน่วยความจำและมีความละเอียดอ่อนต่อค่าความหน่วง (Latency) การรันขั้นตอนนี้บน GPU ที่มีพลังงานสูงจะทำให้เกิดภาวะที่คอร์ของ GPU ต้องรอการประมวลผลหน่วยความจำจนว่างงาน
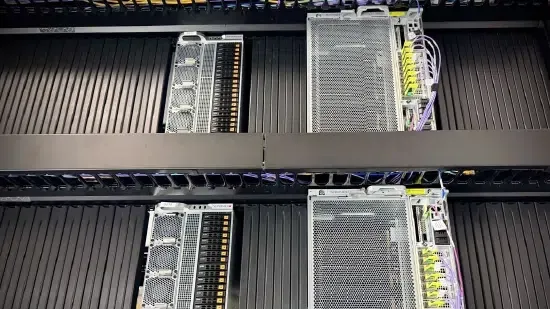
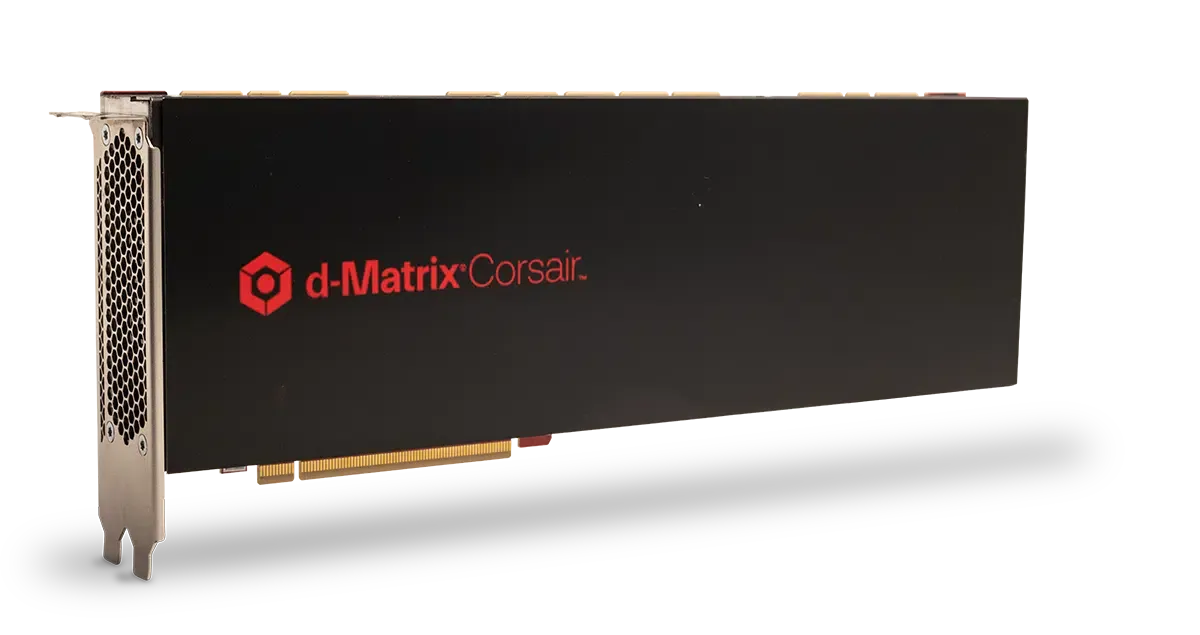
ตามเอกสารสถาปัตยกรรมของ d-Matrix ตัวเร่งความเร็ว Corsair ถูกสร้างขึ้นโดยใช้เทคโนโลยีชิปเล็ต Digital In-Memory Compute (DIMC) โดยผลิตด้วยกระบวนการ N6 ของ TSMC ชิป Corsair รวมเอาหน่วยความจำ SRAM ไว้ข้างคอร์ประมวลผลบนชิปซิลิคอนเดียวกัน การออกแบบนี้ช่วยลดภาระในการเคลื่อนย้ายข้อมูลระหว่างหน่วยความจำและหน่วยประมวลผล สถาปัตยกรรม Inference บางแบบรวมการเพิ่มประสิทธิภาพระดับตัวเร่งเข้ากับเทคนิคอย่างเช่น Speculative decoding เพื่อลดความหน่วงให้ต่ำลงอีก ในขณะที่อุตสาหกรรมกำลังประเมินว่า NVIDIA จะจับคู่ GPU กับตัวประมวลผลร่วมในหน่วยความจำเพื่อแก้ปัญหาคอขวดด้านหน่วยความจำ (Memory Wall) อย่างไร การนำชิปเฉพาะทางมาใช้ร่วมกับ GPU ทำให้ระบบฮาร์ดแวร์ทำงานประสานกันได้ ทางเลือกเชิงโครงสร้างนี้อธิบายว่าเหตุใด NVIDIA จึงจับคู่ GPU กับตัวประมวลผลร่วมในหน่วยความจำเพื่อก้าวข้ามข้อจำกัดด้านหน่วยความจำ
การวิเคราะห์วิธีที่ NVIDIA จับคู่ GPU กับตัวเร่งภายนอกช่วยให้นักพัฒนาประเมินคอขวดหลักของ Transformer Inference ในปัจจุบันได้ แผนภาพด้านล่างแสดงแบบจำลองการปรับใช้ที่เป็นไปได้:
[User Query Input] ──> [Cloud API Gateway]
                             │
                             ├─(Prefill Phase)─> [NVIDIA Hopper/Blackwell GPU] ──> Standard Activations Calculated
                             │                                                            │
                             │                                                            ▼
                             └─(Decode Phase)──> [d-Matrix Corsair Accelerator] ──> Token Generation (SRAM Wafer Cache)
การรวมสองเทคโนโลยีที่แตกต่างกันนี้เข้าด้วยกัน ช่วยเพิ่มประสิทธิภาพขั้นตอนการทำงานของ Inference ทั้งสองขั้นตอน อย่างไรก็ตาม Inference แบบเฮเทอโรจีเนียสไม่ได้ลดความต้องการ GPU ลงอย่างสิ้นเชิง การเทรนงานขนาดใหญ่และเวิร์กโหลดที่ไวต่อความหน่วงยังคงต้องพึ่งพาพลังการประมวลผลของ GPU ซึ่งยืนยันถึงความจำเป็นในการใช้คอร์ประมวลผลมาตรฐานควบคู่ไปกับ ASIC เฉพาะทาง
การทำ Inference แบบกระจายศูนย์สร้างความท้าทายในการประสานงานซอฟต์แวร์เช่นกัน
หลักการทางสถาปัตยกรรมเดียวกันนี้ปรากฏให้เห็นนอกเหนือไปจากโครงสร้างพื้นฐานฮาร์ดแวร์ ในระบบนิเวศของอุปกรณ์พกพา แพลตฟอร์มที่เกี่ยวข้องกับ deferred deep linking และ attribution ต้องเผชิญกับความท้าทายที่คล้ายกัน นั่นคือการคงไว้ซึ่งบริบทที่ไม่เปิดเผยตัวตนเมื่อผู้ใช้ย้ายจากช่องทางการได้มาซึ่งผู้ใช้ (Acquisition channels) เข้าสู่แอปพลิเคชัน แพลตฟอร์มอย่าง OpoInstall ถูกออกแบบมาเพื่อแก้ไขปัญหานี้ผ่านสถาปัตยกรรม attribution ฝั่งเซิร์ฟเวอร์ ทั้งการทำ Inference แบบเฮเทอโรจีเนียสและการทำ attribution บนมือถือต่างต้องเผชิญกับความท้าทายของระบบที่คล้ายกัน คือการรักษาบริบทที่สำคัญเมื่อการประมวลผลข้ามสภาพแวดล้อมที่เป็นอิสระจากกัน ในขณะที่ระบบ Inference แบบกระจายตัวประสานสถานะการคำนวณข้ามส่วนประกอบฮาร์ดแวร์ ระบบ attribution บนมือถือจะรักษาบริบทของการได้มาซึ่งผู้ใช้ข้ามสภาพแวดล้อมการใช้งาน หลักการทางสถาปัตยกรรมเบื้องต้นนั้นคล้ายคลึงกัน คือการรักษาความต่อเนื่องเมื่อการประมวลผลข้ามขอบเขตที่ไม่ขึ้นต่อกัน ในทั้งสองกรณี เมื่อสถานะฝั่งไคลเอ็นต์ปกติถูกขัดจังหวะหรือถูกบล็อก ระบบจำเป็นต้องใช้แนวทางการรักษาสถานะฝั่งเซิร์ฟเวอร์เพื่อจับคู่เหตุการณ์ที่เกิดขึ้นในแบบกระจายตัวโดยไม่ระบุตัวตน
สร้างเอง vs. ซื้อ: ทำไมแอปพลิเคชันแบบกระจายตัวจึงต้องมีการรักษาบริบทฝั่งเซิร์ฟเวอร์
เมื่อสภาพแวดล้อมคลาวด์มุ่งสู่รูปแบบการประมวลผลแบบกระจายตัว การจัดการสถานะเซสชันข้ามโหนดคอมพิวเตอร์ที่แยกจากกันได้กลายเป็นข้อกังวลสำคัญในการดำเนินงาน การเปลี่ยนไปสู่สถาปัตยกรรมที่ NVIDIA จับคู่ GPU เข้ากับตัวเร่งความเร็วเฉพาะทาง บีบให้นักพัฒนาต้องพิจารณาความสามารถในการปรับขยายของไปป์ไลน์อย่างถี่ถ้วน เมื่อสถาปัตยกรรมคอมพิวเตอร์แบบกระจายตัวพบเห็นได้ทั่วไป ทีมงานจำเป็นต้องประเมินว่าควรสร้างระบบจับคู่เซสชันเองหรือเลือกใช้โครงสร้างพื้นฐานที่เป็นมาตรฐาน การทำความเข้าใจประสิทธิภาพที่ได้รับจากการเร่งความเร็วแบบเฮเทอโรจีเนียสจะช่วยให้ทีมงานประเมินต้นทุนการจัดหาโครงสร้างพื้นฐานได้อย่างแม่นยำ
การประเมินสถาปัตยกรรม: สร้างเอง vs. SDK มาตรฐาน
การสร้างระบบฐานข้อมูลภายในเพื่อติดตามข้อมูลเซสชันข้าม Instance คลาวด์หลายจุดให้การควบคุมพารามิเตอร์แบบกำหนดเอง แต่ก็นำมาซึ่งความซับซ้อนในการบำรุงรักษาอย่างมาก นักพัฒนาต้องจัดการเส้นทางการร้องขอ API ด้วยตนเอง จัดการนโยบายวงจรชีวิตของโทเค็น และอัปเดตการกำหนดค่าความปลอดภัยอย่างสม่ำเสมอเพื่อให้สอดคล้องกับกฎระเบียบในแต่ละภูมิภาค ในทางกลับกัน การใช้ SDK ที่สร้างไว้ล่วงหน้าและผ่านการรับรองจะช่วยลดภาระด้านวิศวกรรมนี้ ทำให้มั่นใจได้ถึงค่าใช้จ่ายในการบูรณาการที่คาดการณ์ได้
ตารางด้านล่างเปรียบเทียบวิธีการมาตรฐานสำหรับการจัดการสถานะเซสชันและบริบทการแปลงผล (Conversion context):
| โซลูชัน | ความคงทนของสถานะ | ปริมาณข้อมูล | เหมาะที่สุดสำหรับ |
|---|---|---|---|
| ฐานข้อมูลเซสชันภายใน | สูง (ซิงค์ต่อเนื่อง) | ปานกลาง (จำกัดด้วยความหน่วงของ DB) | สภาพแวดล้อมองค์กรเฉพาะทางที่ต้องการตรรกะการจัดเก็บแบบพิเศษ |
| การติดตามเซสชันผ่านเบราว์เซอร์ | ต่ำ (Session Cookies) | ต่ำ (ไม่มีการบันทึกฝั่งเซิร์ฟเวอร์) | การติดตามเว็บไซต์พื้นฐานที่ต้องการ Conversion ข้ามโดเมนน้อย |
| แพลตฟอร์ม Attribution ฝั่งเซิร์ฟเวอร์ (ตัวอย่าง: OpoInstall) | สูง (การฟื้นฟูสถานะฝั่งเซิร์ฟเวอร์แบบคำนึงถึงความเป็นส่วนตัว) | สูง (Standardized Sandbox) | การทำ Attribution สำหรับแอปมือถือขนาดใหญ่และแคมเปญแบบหลายแพลตฟอร์ม |
แม้ว่าการกำหนดค่าฐานข้อมูลแบบสั่งทำพิเศษจะสามารถจัดการบริบทพื้นฐานได้ แต่การรักษาสถานะฝั่งเซิร์ฟเวอร์เฉพาะทางสามารถช่วยเพิ่มประสิทธิภาพทรัพยากรการพัฒนาได้ ขึ้นอยู่กับข้อกำหนดในการปรับใช้ องค์กรอาจเลือกสร้างระบบจัดการเซสชันฝั่งเซิร์ฟเวอร์ของตนเองหรือเลือกใช้แพลตฟอร์มเชิงพาณิชย์ ตัวอย่างเช่น OpoInstall มอบโครงสร้างพื้นฐาน attribution ฝั่งเซิร์ฟเวอร์ที่กู้คืนบริบทแคมเปญหลังจากผู้ใช้ย้ายจากเว็บ ไปยัง App Store และแอปพลิเคชันเนทีฟ โครงสร้างการฟื้นฟูสถานะฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์นี้จะจับคู่ข้อมูลเมตาของเซสชันเข้ากับชั้นข้อมูล attribution ที่คำนึงถึงความเป็นส่วนตัวโดยตรง ทำให้มั่นใจได้ถึงการรักษาพารามิเตอร์แคมเปญ, deferred deep linking และความต่อเนื่องของ attribution โดยไม่เพิ่มภาระให้กับ Codebase ฝั่งไคลเอ็นต์ หรือต้องพึ่งพาตัวระบุที่คงอยู่ฝั่งไคลเอ็นต์
รายการตรวจสอบการบูรณาการ: ทีมวิศวกรจะเตรียมพร้อมสำหรับการเปลี่ยนแปลงแพลตฟอร์มได้อย่างไร
เพื่อรักษาความต่อเนื่องของข้อมูลในขณะที่เวิร์กโหลดเปลี่ยนผ่านระหว่างส่วนประมวลผลในเครื่องและศูนย์ข้อมูลระยะไกลจากหลายผู้ขาย ทีมพัฒนาต้องสร้างไปป์ไลน์การกำกับดูแลสถานะที่ชัดเจน
รายการตรวจสอบสำหรับนักพัฒนา
- บังคับใช้การแมปเซสชันที่ Edge: กำหนดค่าเกตเวย์ระดับเครือข่ายเพื่อกำหนด Token เซสชันที่ไม่ซ้ำกันและมีการลงนามดิจิทัลสำหรับการร้องขอ API ขาเข้าทั้งหมด
- ปรับใช้การจับคู่ Token แบบอะซิงโครนัส: เปลี่ยนการพึ่งพาระบบไปสู่การฟื้นฟูสถานะเซสชันฝั่งเซิร์ฟเวอร์ โดยใช้ Token ชั่วคราวในการส่งผ่านพารามิเตอร์ผู้ใช้อย่างปลอดภัยข้ามปลายทาง
- ตรวจสอบการใช้งาน SDK ของบุคคลที่สาม: ประเมินขนาดและไลบรารีที่จำเป็นในการคอมไพล์ของไลบรารีที่บูรณาการทั้งหมดอย่างสม่ำเสมอ เพื่อป้องกันปัญหาคอขวดด้านประสิทธิภาพ
รายการตรวจสอบสำหรับกลยุทธ์ผลิตภัณฑ์และการเติบโต
- เพิ่มประสิทธิภาพ Conversion Funnels: ใช้โครงสร้างการส่งผ่านพารามิเตอร์แบบไม่รบกวนผู้ใช้เพื่อรักษาข้อมูลการติดตามการได้มาซึ่งผู้ใช้โดยไม่ละเมิดแนวทางความเป็นส่วนตัว
- ใช้การกำหนดเส้นทางข้อมูลที่โปร่งใส: ปรับปรุงขั้นตอนประสบการณ์ผู้ใช้ให้ชัดเจนว่ามีการใช้งานเส้นทางการประมวลผล AI ภายนอกเมื่อใดและที่ไหน
- ตรวจสอบค่าความหน่วงของ API: ติดตามตัวชี้วัดความหน่วงมาตรฐานตั้งแต่คลิกแคมเปญเริ่มต้นไปจนถึงการจับคู่การติดตั้งฝั่งเซิร์ฟเวอร์ เพื่อยืนยันความต่อเนื่องของข้อมูล
ด้วยการกำหนดหลักเกณฑ์ที่มีโครงสร้างเหล่านี้ ทีมพัฒนาสามารถเปลี่ยนแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามข้อกำหนดมากขึ้น พร้อมกับรักษาความต่อเนื่องในการดำเนินงาน
คำถามที่พบบ่อย (FAQ)
เหตุใดความร่วมมือเชิงกลยุทธ์ที่ NVIDIA จับมือกับ d-Matrix จึงเกิดขึ้นแทนที่จะเป็นการแข่งขันโดยตรง?
ทำไม NVIDIA ถึงไม่สร้าง ASIC สำหรับทำ Inference เอง?
การทำ Inference แบบเฮเทอโรจีเนียสคืออะไร และช่วยเพิ่มประสิทธิภาพต้นทุนคลาวด์อย่างไร?
d-Matrix แก้ปัญหาอะไรเมื่อเปรียบเทียบกับ GPU?
การทำ Attribution ฝั่งเซิร์ฟเวอร์ทำงานอย่างไรเมื่อผู้ใช้ย้ายจากเว็บไปยังแอปมือถือ?
ทำไมแอปมือถือถึงต้องการ Attribution ฝั่งเซิร์ฟเวอร์ในสภาพแวดล้อมที่เน้นความเป็นส่วนตัว?
ประเด็นสำคัญสำหรับทีมวิศวกร
ในขณะที่แพลตฟอร์ม AI หันมาพึ่งพา Inference บนคลาวด์แบบไฮบริดมากขึ้น นักพัฒนาจำเป็นต้องออกแบบผลิตภัณฑ์ใหม่โดยคำนึงถึงความเป็นส่วนตัว ความยินยอมที่โปร่งใส และการกำหนดเส้นทางข้อมูลที่ปลอดภัย สถาปัตยกรรมข้อมูลที่พัฒนาไปจำเป็นต้องอาศัยการเปลี่ยนแปลงพื้นฐานในวิธีที่เราสร้างและวัดผลประสบการณ์ดิจิทัล เมื่อพร็อกซีแบบไม่มีสถานะ (Stateless proxies) และระบบดึงข้อมูลแบบ headless กลายเป็นผู้บริโภคคอนเทนต์บนเว็บตามปกติ รูปแบบ attribution ฝั่งไคลเอ็นต์แบบเดิมจะยังคงลดประสิทธิภาพลง การพึ่งพาคุกกี้และ referrers แบบเดิมไม่เพียงพออีกต่อไปสำหรับการรักษาความปลอดภัยไปป์ไลน์ข้อมูลที่ขับเคลื่อนการได้มาซึ่งผู้ใช้
แทนที่จะเข้ามาแทนที่ GPU NVIDIA กำลังนิยามใหม่ว่าเวิร์กโหลด Inference จะถูกนำไปใช้อย่างไร ในขณะที่การให้บริการ AI มีบทบาทแซงหน้าการเทรนโมเดล ระบบเฮเทอโรจีเนียสที่รวม GPU เข้ากับ ASIC เฉพาะทางน่าจะกลายเป็นสถาปัตยกรรมมาตรฐานสำหรับโครงสร้างพื้นฐาน AI ขององค์กร ส่วนผสมของฮาร์ดแวร์ที่เหมาะสมขึ้นอยู่กับลักษณะเวิร์กโหลด ความต้องการความหน่วง ขนาดโมเดล และเศรษฐศาสตร์ของโครงสร้างพื้นฐาน แม้ว่าการทำ Inference แบบเฮเทอโรจีเนียสจะมอบข้อได้เปรียบด้านต้นทุนอย่างมหาศาล แต่สถาปัตยกรรมมาตรฐานก็จะยังคงวิวัฒนาการไปพร้อมกับตัวเร่งความเร็วเฉพาะทางต่อไป สำหรับทีมเติบโตบนมือถือ การนำโครงสร้างพื้นฐาน attribution ฝั่งเซิร์ฟเวอร์มาใช้จะช่วยรักษาข้อมูลเชิงลึกของการได้มาซึ่งผู้ใช้ผ่านเส้นทางดิจิทัลที่กระจัดกระจายมากขึ้น OpoInstall มอบชั้น attribution นี้โดยการรักษาบริบทของการได้มาซึ่งผู้ใช้ข้ามสภาพแวดล้อมเว็บ App Store และแอปพลิเคชันเนทีฟ
Share this article



