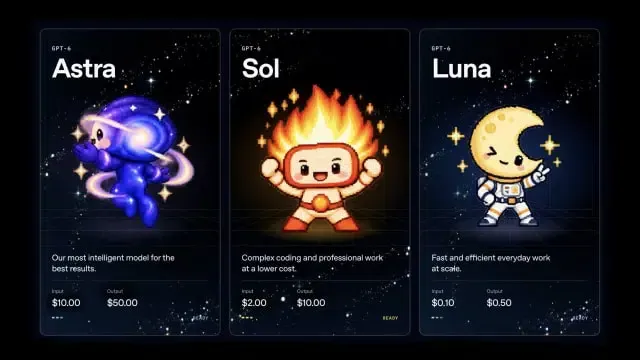
ต้นทุน API Sol ของ OpenAI ลดลงครึ่งหนึ่ง? OpenAI ประกาศเปิดตัว GPT-6 Sol และ GPT-6 Luna อย่างเป็นทางการในเชิงพาณิชย์เมื่อวันที่ 22 กันยายน 2026 โดยปรับลดอัตราค่าบริการโทเค็น API ลง 50% หรือมากกว่าเมื่อเทียบกับราคาโปรโมชั่น GPT-5.6 รุ่นก่อนหน้าบนเอ็นด์พอยต์มาตรฐาน สำหรับการประมวลผลพรอมต์มาตรฐานที่มีอินพุตโทเค็นสูงสุด 272K โทเค็น GPT-6 Sol มีราคาอยู่ที่ $2.00 ต่อล้านอินพุตโทเค็น และ $10.00 ต่อล้านอ웃พุตโทเค็น ในขณะที่รุ่น GPT-6 Luna ซึ่งมีขนาดเล็กกว่ามีราคาอยู่ที่ $0.10 สำหรับอินพุต และ $0.50 สำหรับอ웃พุตต่อล้านโทเค็น เมื่อ OpenAI ลดต้นทุน API Sol ลงครึ่งหนึ่งในระดับนักพัฒนามาตรฐาน การลดลงของต้นทุนการประมวลผลเชิงโครงสร้างนี้ส่งผลให้ข้อจำกัดในการดำเนินงานของซอฟต์แวร์ Generative เปลี่ยนแปลงไป ราคาต่อหน่วยที่ถูกลงทำให้ลูปเอเจนต์แบบเรียกซ้ำ (recursive agentic loops) การดึงข้อมูลเป็นชุดเบื้องหลัง (background batch extraction) และระบบงานอัตโนมัติหลายขั้นตอน (autonomous multi-step workers) สามารถคุ้ม 50% ในแง่เศรษฐศาสตร์และใช้งานได้จริงในสเกลใหญ่ อย่างไรก็ตาม สำหรับสถาปนิกของระบบ วิศวกรความน่าเชื่อถือ และแบ็กเอนด์เดเวลอปเปอร์ การลดลงของอุปสรรคทางการเงินนี้กลับเผยให้เห็นความท้าทายด้านความสามารถในการรองรับขยายตัวที่ปลายทาง (downstream scalability challenges) โดยเปลี่ยนความสนใจทางวิศวกรรมจากงบประมาณโทเค็นไปสู่ขอบเขตอัตราจำกัด (rate-limit boundaries) ขีดจำกัดความพร้อมกัน (concurrency limits) ท่อส่งเทเลเมตรี และคอขวดของระบบแรงดันย้อนกลับ (backpressure bottlenecks)
ปัญหาการดำเนินงานและอุปสรรคทางการเงิน
ตลอดช่วงระยะแรกของการนำ LLM ระดับองค์กรมาใช้งานจริง ค่าธรรมเนียมโทเค็นตามสัญญาทำหน้าที่เสมือนกลไกควบคุมสถาปัตยกรรมโดยพฤตินัย ต้นทุนการอนุมานที่สูงบังคับให้ทีมพัฒนาต้องปฏิบัติต่อการเรียกใช้งานโมเดลเสมือนเป็นธุรกรรมแยกส่วนที่ผู้ใช้เป็นผู้ริเริ่ม แอปพลิเคชันพึ่งพาการอนุมัติที่มีมนุษย์เข้ามามีส่วนร่วม (human-in-the-loop) ประวัติการสนทนาที่มีขอบเขต และการกำหนดเวลาทำงานที่ถูกจำกัดอย่างเข้มงวด เพื่อให้มั่นใจว่าบิลค่าใช้จ่ายของผู้ให้บริการรายเดือนยังคงคาดการณ์ได้ การเปิดตัวการลดราคาโมเดลระดับกลางแบบถาวรนี้ท้าทายความสมดุลในอดีต โดยเปลี่ยนความกังวลด้านวิศวกรรมระบบจากการกำหนดราคาโมเดลไปสู่ความยืดหยุ่นของโครงสร้างพื้นฐานแบ็กเอนด์
สรุปสาระสำคัญ
- การลดราคาฐาน: เมื่อวันที่ 22 กันยายน 2026 OpenAI ได้เปิดตัว GPT-6 Sol ในราคา $2.00 (อินพุต) / $10.00 (อ웃พุต) และ GPT-6 Luna ในราคา $0.10 (อินพุต) / $0.50 (อ웃พุต) ต่อล้านโทเค็นสำหรับการประมวลผลมาตรฐานบนพรอมต์ที่มีขนาดสูงสุด 272K โทเค็น ซึ่งคิดเป็นการลดลงเชิงโครงสร้างประมาณ 50% หรือมากกว่าเมื่อเทียบกับราคาโปรโมชั่น API ของ GPT-5.6
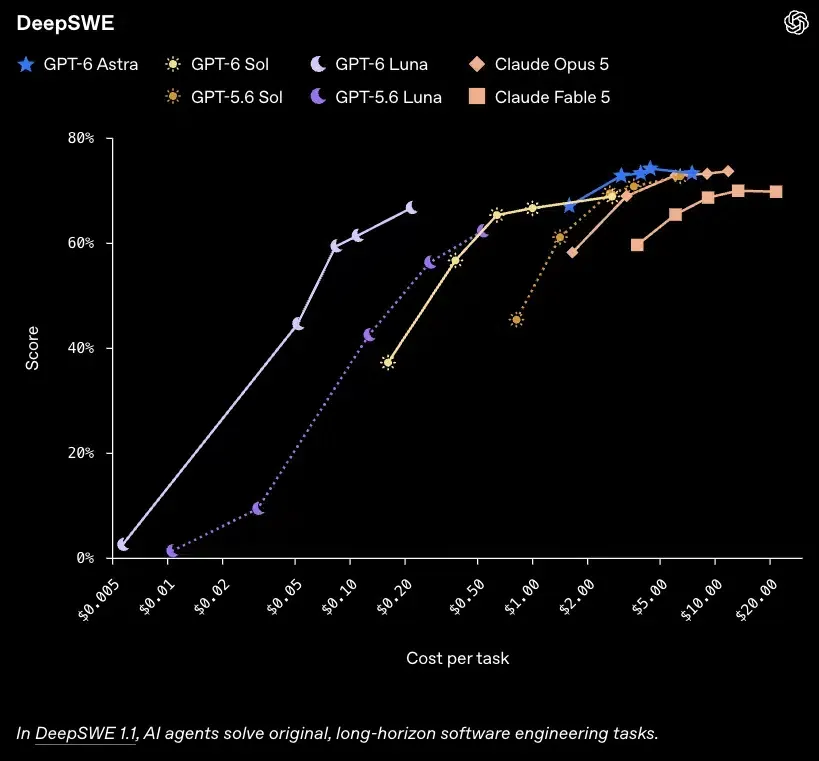
- เศรษฐศาสตร์การประเมินระดับงาน: บน AutomationBench 1.0.6 OpenAI รายงานว่า GPT-6 Sol ที่กำหนดค่าการใช้เหตุผลระดับ xhigh ทำคะแนนเวิร์กโฟลว์ได้ 33.2% ด้วยต้นทุนเฉลี่ยที่รายงานคือ $0.27 ต่อความพยายามในการทำงานหนึ่งครั้ง ซึ่งเปลี่ยนการประเมินของนักพัฒนาจากการกำหนดราคาโทเค็นดิบไปสู่ต้นทุนต่อหน่วยงานที่พยายามทำ
- ไดนามิกส์การแคชพรอมต์: แพลตฟอร์มมอบส่วนลดอัตโนมัติ 90% สำหรับการอ่านอินพุตโทเค็นที่ถูกแคชไว้ (คิดค่าบริการที่ 0.1 เท่าของอัตราอินพุตโทเค็นฐาน) ในขณะที่การเขียนแคชเริ่มต้นจะคิดค่าบริการที่ 1.25 เท่าของอัตราอินพุตโทเค็นที่ไม่ถูกแคช ซึ่งต้องอาศัยการปรับมาตรฐานคำนำหน้า (prefix normalization) อย่างรอบคอบเพื่อรักษาอัตราการเข้าถึงแคชให้สูงตลอดการทำงานแบบหลายขั้นตอนที่มีความไดนามิก
ตามรายละเอียดใน ข้อมูลอ้างอิงราคา API สำหรับนักพัฒนาของ OpenAI และ ประกาศจากคอมมิวนิตี้ของ OpenAI โครงสร้างราคานี้เกิดขึ้นจากการปรับปรุงอย่างต่อเนื่องในท่อส่งการอนุมานระดับต่ำ (low-level inference pipelines) และระบบ KV caching อย่างไรก็ตาม เมื่อต้นทุนในการดำเนินการตามลำดับงานอัตโนมัติลดลงอย่างมาก ทีมวิศวกรรมจึงขยายขอบเขตของงานเบื้องหลังออกไป เกณฑ์ทางเศรษฐกิจที่เคยขัดขวางไม่ให้ระบบงานเบื้องหลังรันการポーลิงอย่างต่อเนื่อง (continuous polling) การตรวจสอบโค้ดอัตโนมัติ หรือท่อส่งการดึงข้อมูลเอกสารหลายขั้นตอน ได้ลดต่ำลง
ทั่วทั้งตลาด ผู้ให้บริการโมเดลพื้นฐานรายอื่น ๆ ได้ลดหรือปรับโครงสร้างราคา API ในระดับนักพัฒนาเช่นกัน Anthropic ได้ปล่อยตัว Claude Opus 5.5 ควบคู่ไปกับข้อกำหนดที่อัปเดตใน ข้อกำหนดแพลตฟอร์ม Anthropic Claude Opus 5.5 โดยระบุราคาไว้ที่ $4 ต่อล้านอินพุตโทเค็น, $0.20 ต่อล้านอินพุตโทเค็นที่แคชไว้ และ $20 ต่อล้านอ웃พุตโทเค็น ซึ่งเน้นย้ำถึงการบริโภคโทเค็นที่ลดลงในเกณฑ์มาตรฐานการรีแฟกเตอร์โค้ด ในขณะเดียวกัน Google ยังคงรักษาราคาโปรโมชั่นเปิดตัวสำหรับ Gemini 3.8 Flash ตามที่ระบุไว้ใน Google AI สำหรับนักพัฒนา และการเปิดตัวโมเดลแบบ open-weight เช่น MiMo-V2.6-Pro ของ Xiaomi ก็ช่วยให้ทีมที่โฮสต์เองมีตัวเลือกต้นทุนโทเค็นที่แข่งขันได้ภายใต้ไลเซนส์ซอฟต์แวร์ที่ผ่อนปรน
เมื่อต้นทุนของโมเดลลดลง พฤติกรรมการพัฒนาจึงเปลี่ยนไป ทีมวิศวกรรมปรับใช้ลูปการเรียกซ้ำที่ลึกขึ้น ฝังเอกสารองค์กรที่ครอบคลุมลงในพรอมต์ของระบบ และกำหนดค่าลอจิกการลองใหม่ (retry logic) อัตโนมัติในกราฟงานที่ซับซ้อน สิ่งที่เริ่มต้นจากการลดต้นทุนที่ชั้น API อาจส่งผลให้เกิดความหน่วง (latency) และปริมาณการรับส่งข้อมูลที่พุ่งสูงขึ้นไปยังบริการภายใน หากเวิร์กสเตชันการประสานงาน (orchestration worker) ออกคำสั่งเรียกโมเดลแบบลำดับหรือขนานหลายสิบครั้งสำหรับธุรกรรมของผู้ใช้เพียงคนเดียว พูลฐานข้อมูลภายใน คลัสเตอร์จัดเก็บข้อมูลเสริม ท่อส่งเทเลเมตรี และตัวจำกัดอัตรา (rate limiters) จะต้องรองรับภาระที่ตามมาทั้งหมด
สาเหตุเชิงระบบและห่วงโซ่คำขอแบบไม่ใช่ภาพภาพ
เมื่อแอปพลิเคชันไคลเอนต์เปลี่ยนจากอินเทอร์เฟซแชทแบบโต้ตอบไปสู่ระบบอัตโนมัติเบื้องหลังที่ไม่ใช่ภาพ (non-visual background automation) โปรไฟล์คำขอต้นน้ำจะเปลี่ยนแปลงไปอย่างมาก เหตุการณ์ทางธุรกิจเพียงรายการเดียวสามารถทริกเกอร์ไปป์ไลน์อัตโนมัติที่ตรวจสอบสคีมา ประเมินตัวแปรสภาพแวดล้อม เรียกใช้เครื่องมือภายนอก และตรวจสอบผลลัพธ์ผ่านการประมวลผลต่อเนื่องหลายรอบ
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ ทริกเกอร์เว็บ / แอปของผู้ใช้ ]                                                           |
|         |                                                                               |
|         v                                                                               |
|  [ เกตเวย์ API ขาเข้า ]                                                                  |
|         |                                                                               |
|         +---> สร้างอินสแตนซ์ของเอเจนต์อัตโนมัติ                                         |
|         |                                                                               |
|         v                                                                               |
|  [ ลูปการประสานงานอัตโนมัติ (GPT-6 Sol / Luna) ]                                          |
|         |                                                                               |
|         +--- ขั้นตอนที่ 1: ค้นหาบริบท (อ่านแคช) -------------------+                      |
|         |                                                        |                      |
|         +--- ขั้นตอนที่ 2: ดำเนินการเครื่องมือ (เรียกแบบไม่แคช)   |                      |
|         |                                                        |                      |
|         +--- ขั้นตอนที่ 3: การตรวจสอบและแก้ไขตนเอง               |                      |
|         |                                                        v                      |
|         +--- ขั้นตอนที่ 4: การแตกแขนงการรันแบบเรียกซ้ำ ---> [ RPC ภายในที่พุ่งสูงขึ้น ]  |
|                                                                  |                      |
|  [ คอขวดของระบบปลายทาง ]                                        |                      |
|         |                                                        |                      |
|         +--- ไมโครเซอร์วิสภายใน <-- (การขาดแคลนการเชื่อมต่อ) ----+                      |
|         +--- PostgreSQL / ที่เก็บแคช <-- (การอิ่มตัวของพูลการเชื่อมต่อ)                 |
|         +--- สตรีมเทเลเมตรีแบบกระจาย <-- (ใช้บัฟเฟอร์ทิ้งข้อมูลที่สูญเสียได้)        |
|         +--- ที่เก็บข้อมูลสำหรับการปฏิบัติตามข้อกำหนด <-- (ความหน่วงของคิวที่ทนทาน/เล่นซ้ำได้) |
|         +--- ขีดจำกัดผู้ให้บริการต้นน้ำ <-- (ข้อผิดพลาด HTTP 429 อัตราจำกัดหมดลง)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
การรันเอเจนต์แบบเรียกซ้ำและการทวีคูณความพร้อมกัน
ในระบบเว็บแบบโต้ตอบดั้งเดิม ปริมาณคำขอจะสอดคล้องกับจังหวะการโต้ตอบของมนุษย์ เธรด HTTP แต่ละเธรดมักจะแมปกับการโต้ตอบของผู้ใช้ที่ชัดเจน โดยมีอัตราการกระจายตัวโดยรวมที่ต่ำกว่าและควบคุมจังหวะด้วยเวลาคิดของมนุษย์ รันไทม์ของไคลเอนต์จะส่งเพย์โหลด รอการตอบสนอง และหยุดชั่วคราวก่อนที่จะเริ่มการโต้ตอบครั้งต่อไป
การเปรียบเทียบโปรไฟล์คำขอเชิงแนวคิด: แบบโต้ตอบเทียบกับแบบเอเจนต์
| ตัวชี้วัดสถาปัตยกรรม | โฟลว์ผู้ใช้แบบโต้ตอบ | ลูปเอเจนต์อัตโนมัติ |
|---|---|---|
| โมเดลความพร้อมกัน (Concurrency) | การกระจายคำขอตามจังหวะมนุษย์มักจะต่ำกว่า | 1 เหตุการณ์ขาเข้า = N การเรียกย่อยที่เชื่อมโยงกัน |
| เวลาในการดำเนินการ | ควบคุมจังหวะโดยการตอบสนองและเวลาคิดของผู้ใช้ | ดำเนินการต่อโดยอัตโนมัติจนกว่าจะติดขีดจำกัดนโยบาย |
| ความไร้ผลของบริบท | เพย์โหลดใหม่ต่อเซสชัน | พึ่งพาบริบทที่แคชไว้อย่างมาก |
| การจัดการข้อผิดพลาด | ผู้ใช้ลองใหม่เมื่อเกิดข้อผิดพลาด | การลองใหม่แบบอัตโนมัติโดยโปรแกรม |
| คอขวดของระบบ | แบนด์วิดท์เกตเวย์ฝั่งฟรนต์เอนด์ | ขีดจำกัดพูลฐานข้อมูลภายใน |
| ความล้มเหลวแบบลูกโซ่ | จำกัดอยู่แค่เซสชันเดียว | สามารถกระตุ้นให้อิ่มตัวของคิวได้ |
เมื่อระบบบูรณาการเอเจนต์อัตโนมัติ จังหวะเหล่านี้จะถูกตัดขาดออกจากกัน เหตุการณ์ที่ถูกทริกเกอร์เพียงครั้งเดียวสามารถสร้างลำดับการเรียกอัตโนมัติที่ต่อเนื่องกัน หากเอเจนต์พบข้อผิดพลาดชั่วคราวหรือเอาต์พุตเครื่องมือที่มีรูปแบบไม่ถูกต้อง ลอจิกการลองใหม่แบบง่าย ๆ อาจสร้างคำขอพุ่งพล่านอย่างรวดเร็วไปยังบริการแบ็กเอนด์ เนื่องจากต้นทุนโทเค็นที่ลดลงทำให้การทำงานที่ยาวนานขึ้นมีราคาคุ้มค่า เวิร์กโฟลว์อัตโนมัติจึงสามารถขยายปริมาณคำขอเบื้องหลังได้อย่างมาก แม้ว่าฐานผู้ใช้ที่ใช้งานอยู่จะเท่าเดิมก็ตาม
กลไกการแคชพรอมต์: การนำ KV กลับมาใช้ใหม่ ค่าใช้จ่ายในการเขียน และความเสถียรของคำนำหน้า
OpenAI ได้จับคู่การเปิดตัว Sol และ Luna เข้ากับการปรับแต่งทั่วทั้งระบบย่อยการแคชพรอมต์ ดังที่บันทึกไว้ใน ข้อกำหนดการแคชพรอมต์ของ OpenAI อินพุตโทเค็นที่ตรงกับคำนำหน้าที่แคชไว้จะได้รับส่วนลด 90% สำหรับราคาการอ่าน การแคชพรอมต์ช่วยลดการคำนวณซ้ำทางฝั่งโมเดลเป็นหลัก มากกว่าที่จะทำหน้าที่เป็นกลไกการบีบอัดเพย์โหลดเครือข่ายอเนกประสงค์ ในการโต้ตอบแบบไร้สถานะ (stateless) ทั่วไป แอปพลิเคชันไคลเอนต์จะส่งบริบทคำขอ และผู้ให้บริการจะข้ามการคำนวณเทนเซอร์ KV ซ้ำสำหรับคำนำหน้าที่ตรงกัน ซึ่งช่วยลดความหน่วงเวลาจนถึงโทเค็นแรก (time-to-first-token latency) และการเรียกเก็บเงินอินพุตได้อย่างมาก
ที่สำคัญ การเขียนคำนำเริ่มต้นลงในแคชฝั่งเซิร์ฟเวอร์จะถูกเรียกเก็บเงินในอัตรา 1.25 เท่าของอัตราอินพุตโทเค็นที่ไม่ถูกแคช การเพิ่มประสิทธิภาพต้นทุนสูงสุดจึงต้องอาศัยการรักษาความเสถียรของคำนำหน้าข้ามการสืบค้นหลายรายการ
ราคาลิสต์ API สาธารณะที่เลือก — ไม่สามารถเปรียบเทียบได้โดยตรงระหว่างผู้ให้บริการ
| ตัวระบุโมเดล | อินพุต ($/1M Tok) | อ웃พุต ($/1M Tok) | นโยบายการอ่านแคช |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | ส่วนลด 90% (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | ส่วนลด 90% (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | การกำหนดราคาแบบแบ่งชั้นไดนามิก |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M การอ่าน (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | สูงถึง 90% บนแคช |
| Google Gemini 3.8 Flash | $0.75 (เปิดตัว) | $3.75 (เปิดตัว) | $0.075/1M การอ่านแบบแคช |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M การอ่านแบบแคช |
หมายเหตุ: อัตรามาตรฐานมีผลกับระดับบริบทสั้น (พรอมต์สูงสุด 272K อินพุตโทเค็นสำหรับ OpenAI) ผู้ให้บริการบังคับใช้ค่าใช้จ่ายในการเขียนแคช ขีดจำกัดบริบท และข้อกำหนดโปรโมชั่นที่มีกำหนดเวลาแตกต่างกัน
การรักษาคำนำหน้าจำเป็นต้องจัดการตัวเลือกการกำหนดค่า API อย่างระมัดระวัง ในสถาปัตยกรรม API ของ OpenAI การเปลี่ยนพารามิเตอร์ความพยายามในการใช้เหตุผลโดยตรงหรือการเปลี่ยนแปลงอาร์เรย์คำจำกัดความของเครื่องมือจะเปลี่ยนคำนำหน้าพรอมต์ที่เรนเดอร์ และทำให้สถานะที่แคชไว้ก่อนหน้านี้ไม่ถูกต้อง
เพื่อรักษาบริบทที่แคชไว้ในระหว่างเซสชันแบบหลายรอบ นักพัฒนาต้องเก็บสคีมาเครื่องมือและคำแนะนำพื้นฐานไว้ในลำดับที่สอดคล้องกัน หากจำเป็นต้องปรับเปลี่ยนขณะรันไทม์ นักพัฒนาควร更新พารามิเตอร์ผ่านการควบคุมเซสชันที่มีโครงสร้าง (เช่น configuration_update) หรือสลับการทำงานของเครื่องมือโดยใช้ tool_choice หรือ allowed_tools แทนที่จะปรับเปลี่ยนอาร์เรย์คำจำกัดความของเครื่องมือโดยตรง
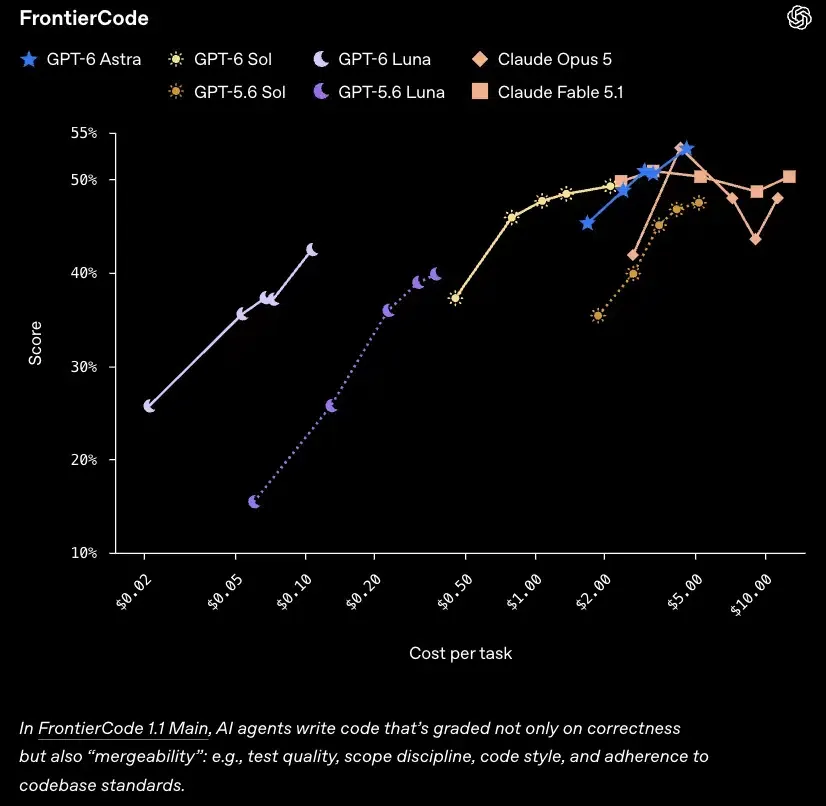
เมื่อเกิดการแคชพลาด (cache misses) ผู้ให้บริการต้นน้ำจะประมวลผลลำดับอินพุตซ้ำโดยไม่มีส่วนลดการอ่าน 90% ในสเกลใหญ่ สิ่งนี้อาจเพิ่มความหน่วงในการอนุมานและแรงกดดันด้านไทม์เอาต์ สำหรับการดำเนินการทำงานหลายขั้นตอน การประเมินต้นทุนจะเปลี่ยนจากการคูณโทเค็นธรรมดาไปสู่ค่าใช้จ่ายของงานที่เสร็จสมบูรณ์ ดังที่เห็นใน รายงานของ VentureBeat เกี่ยวกับเกณฑ์มาตรฐาน GPT-6 Sol และ Luna ซึ่ง GPT-6 Sol ทำคะแนนได้ 33.2% บน AutomationBench 1.0.6 ด้วยค่าใช้จ่ายเฉลี่ย $0.27 ต่อความพยายามในการทำงานหนึ่งครั้ง
สถาปัตยกรรมเทเลเมตรี: การแยกเมตริกการดำเนินงานออกจากตรวจสอบการปฏิบัติตามข้อกำหนด
การพุ่งขึ้นของคำขอ LLM อัตโนมัติสร้างแรงกดดันอย่างมากต่อการสังเกตการณ์แบ็กเอนด์ (observability) และไปป์ไลน์การปฏิบัติตามข้อกำหนด เวิร์กโฟลว์เอเจนต์ที่มีความพร้อมกันสูงจำเป็นต้องมีการแยกสถาปัตยกรรมที่ชัดเจนระหว่างเทเลเมตรีการดำเนินงานและบันทึกการตรวจสอบทางกฎหมาย
นโยบายการปฏิบัติตามข้อกำหนดขององค์กร spesso กำหนดให้ต้องบันทึกเมตริกเซสชัน หลักฐานการทำงานของเครื่องมือ และบันทึกธุรกรรม การปฏิบัติต่อเทเลเมตรีการดำเนินงานและข้อมูลการปฏิบัติตามข้อกำหนดเหมือนกันทุกประการจะสร้างข้อแลกเปลี่ยนทางวิศวกรรมที่ร้ายแรง:
- ช่องทางการตรวจสอบความปลอดภัยและการปฏิบัติตามข้อกำหนด: ต้องให้การส่งมอบที่ทนทานและสามารถเล่นซ้ำได้ (replayable) พร้อมการลองใหม่ที่ชัดเจน ความคงทน และการจัดการความล้มเหลวเข้าสู่ที่เก็บข้อมูลการตรวจสอบที่เขียนได้ครั้งเดียวและมีการควบคุมการเข้าถึง เพย์โหลดควรจับเมตริกที่มีโครงสร้าง ตัวตนของผู้โทร และสถานะการเข้ารหัส พร้อมทั้งทำความสะอาดข้อมูลที่สามารถระบุตัวบุคคลได้ (PII) และคีย์ลับอย่างเป็นระบบ ภายใต้ภาระงานสูง ไปป์ไลน์เหล่านี้ต้องใช้แรงดันย้อนกลับหรือจัดคิวงานอย่างทนทาน แทนที่จะทิ้งบันทึกข้อมูลทิ้งไป
- ช่องทางเทเลเมตรีการดำเนินงาน: ติดตามตัวชี้วัดประสิทธิภาพ เช่น จำนวนโทเค็น อัตราการเข้าถึงแคชของพรอมต์ และความหน่วงในการตอบสนองของต้นน้ำ เนื่องจากร่องรอยเหล่านี้ใช้สำหรับการตรวจสอบและแก้ไขข้อบกพร่องแบบเรียลไทม์ จึงสามารถประมวลผลผ่านบัฟเฟอร์การลดลงแบบสูญเสียที่ถูกจำกัด (bounded, lossy drop buffers) ได้ หากตัวรวบรวมปลายทางทำงานช้าลง แอปพลิเคชันจะสามารถลดเทเลเมตรีการดำเนินงานส่วนเกินได้อย่างปลอดภัยเพื่อรักษาความพร้อมใช้งานของบริการหลักไว้
เมื่อผู้ให้บริการภายนอกส่งคืนข้อผิดพลาดอัตราจำกัด HTTP 429 นโยบายการลองใหม่ที่กำหนดค่าไว้อย่างไม่เหมาะสมอาจทำให้เกิดปัญหาการดำเนินงานที่รุนแรง การลองใหม่ทันทีหรือกิจวัตรการถอยกลับแบบเอกซ์โพเนนเชียลที่ซิงโครไนซ์กันโดยไม่มีการสั่นแบบสุ่ม (randomized jitter) จะสร้างคลื่นการลองใหม่ที่สามารถแพร่กระจายผ่านไมโครเซอร์วิสระดับกลาง ส่งผลให้พูลเธรดและการเชื่อมต่อฐานข้อมูลเต็ม
การเปรียบเทียบโซลูชัน: ข้อดีข้อเสียระหว่างการสร้างเองกับการซื้อ
การจัดการภาระการดำเนินงานที่เกิดจากต้นทุนการอนุมานที่ลดลง ทำให้องค์กรต้องประเมินเกตเวย์ AI และสถาปัตยกรรมพร็อกซีของตน ทีมงานต้องตัดสินใจว่าจะพัฒนาการกำหนดเส้นทางแบบกำหนดเอง การจำกัดอัตรา และพร็อกซีเทเลเมตรีภายในองค์กร หรือจะปรับใช้โครงสร้างพื้นฐานของบุคคลที่สามที่มีความเฉพาะทาง
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ คำขอแอปพลิเคชันขาเข้า ]                                                               |
|         |                                                                               |
|         v                                                                               |
|  [ ตัวจำกัดอัตราหน้าต่างเลื่อน (Sliding-Window) ] <--- แคชในหน่วยความจำหรือแบบกระจาย |
|         |                                                                               |
|         +--->ปฏิเสธ / ชะลอความพร้อมกันส่วนเกิน (ป้องกัน HTTP 429)                       |
|         |                                                                               |
|         v                                                                               |
|  [ เอ็นจิ้นการปรับมาตรฐานพรอมต์และการจัดแนวแคช ]                                        |
|         |                                                                               |
|         +---> ตรึงพรอมต์ระบบแบบคงคาและคำจำกัดความเครื่องมือไว้ที่คำนำหน้าฐาน           |
|         +---> ใช้การควบคุมที่มีโครงสร้างเพื่อแก้ไขพารามิเตอร์เซสชัน                       |
|         |                                                                               |
|         v                                                                               |
|  [ การจ่ายงานผู้ให้บริการต้นน้ำ (OpenAI / Anthropic / API ท้องถิ่น) ]                     |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (เส้นทางเร็วแบบซิงโครนัส)             |                                       |
|  [ การประกอบการตอบสนองของไคลเอนต์ ]              |                                       |
|         |                                       v (เส้นทางคู่แบบอะซิงโครนัส)            |
|         v                               +-----------------------------------------------+
|  [ ส่งคืนเพย์โหลดไปยังแอป ]              |                                               |
|                                         v (ริงบัฟเฟอร์แบบสูญเสีย)  v (ที่เก็บออกบ็อกซ์ทนทาน) |
|                                    [ เมตริกการดำเนินงาน ]   [ ที่เก็บตรวจสอบการปฏิบัติตาม ] |
|                                    (ทิ้งเมื่อเกิดความแออัด) (ทนทาน / เล่นซ้ำได้)        |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
ไปป์ไลน์ความยืดหยุ่นที่สร้างขึ้นภายในองค์กร
การพัฒนาโครงสร้างพื้นฐานแบบกำหนดเองช่วยให้ทีมวิศวกรรมสามารถควบคุมนโยบายเครือข่าย การทำความสะอาดข้อมูล และกลยุทธ์การกำหนดเส้นทางได้อย่างสมบูรณ์ องค์กรสามารถสร้างพร็อกซีที่ขอบ (edge proxies) ที่ปรับให้เข้ากับโทโพโลยีไมโครเซอร์วิสภายในได้อย่างแม่นยำ
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
อย่างไรก็ตาม การพัฒนาภายในองค์กรต้องมีการบำรุงรักษาทางวิศวกรรมอย่างต่อเนื่อง ทีมงานต้องปรับตัวให้เข้ากับการอัปเดต API ของผู้ให้บริการด้วยตนเอง จัดการอัตราจำกัดที่พัฒนาขึ้นจากผู้ให้บริการหลายราย และจัดการคิวเทเลเมตรีแบบกระจาย ค่าใช้จ่ายในการบำรุงรักษานี้อาจเบี่ยงเบนทรัพยากรนักพัฒนาภายในให้ออกจากฟีเจอร์หลักของผลิตภัณฑ์
เกตเวย์เชิงพาณิชย์และเครื่องมือโครงสร้างพื้นฐาน
เพื่อหลีกเลี่ยงการสร้างความสามารถเหล่านี้ขึ้นมาใหม่ตั้งแต่ต้น องค์กรจำนวนมากจึงปรับใช้พร็อกซี API แบบจัดการ (managed API proxies) เกตเวย์ LLM และเครื่องมือควบคุมขอบ เกตเวย์ที่มีการจัดการบางแห่งให้การประสานงานอัตราจำกัดที่รับรู้ถึงผู้ให้บริการ (provider-aware) การสังเกตการณ์ การควบคุมนโยบาย และการกำหนดเส้นทางที่รับรู้แคช ความสามารถที่แน่นอนจะแตกต่างกันไปตามผู้ให้บริการ และการเพิ่มประสิทธิภาพคำเน้นมักจะยังคงต้องอาศัยระเบียบวินัยในการร้องขอระดับแอปพลิเคชันอยู่ดี
แพลตฟอร์มเชิงพาณิชย์ช่วยให้ทีมวิศวกรรมสามารถบังคับใช้โควตาต้นทุนต่อสภาพแวดล้อม กำหนดค่าการกำหนดเส้นทางสำรองอัตโนมัติข้ามตระกูลโมเดล และลบข้อมูลลูกค้าที่ละเอียดอ่อนออกก่อนที่จะบันทึกเมตริกคำขอ เกตเวย์ที่สร้างขึ้นมาเพื่อวัตถุประสงค์เฉพาะจะจัดการกับการพุ่งขึ้นของความพร้อมกัน ตรวจสอบแนวโน้มการบริโภค API และปกป้องไมโครเซอร์วิสปลายทางในสภาพแวดล้อมแอปพลิเคชันที่ซับซ้อน
เมทริกซ์การตัดสินใจ: ไปป์ไลน์ภายในเทียบกับแพลตฟอร์มที่มีการจัดการ
| เกณฑ์การประเมิน | เครื่องมือความยืดหยุ่นภายใน | โครงสร้างพื้นฐานการกำหนดเส้นทางที่มีการจัดการ |
|---|---|---|
| ความพยายามในการพัฒนาก่อนหน้า | สูง (3-6 สัปดาห์ทางวิศวกรรม) | ต่ำ (บูรณาการผ่าน API มาตรฐาน) |
| การบำรุงรักษาโปรโตคอล | ความรับผิดชอบของทีมอย่างต่อเนื่อง | จัดการโดยการอัปเดตของผู้ให้บริการ |
| การควบคุมการดำเนินงาน | การมองเห็นสแต็กที่สมบูรณ์ | จำกัดโดยอินเทอร์เฟซของผู้ให้บริการ |
| การปรับแต่งแคชพรอมต์ | ต้องใช้พร็อกซีแบบกำหนดเอง | ขึ้นอยู่กับผู้ให้บริการ มักจะต้องอาศัยความร่วมมือจากแอปพลิเคชัน |
| การแยกเทเลเมตรี | การจัดการคิวแบบกำหนดเอง | ขึ้นอยู่กับผู้ให้บริการ |
| โปรไฟล์ต้นทุนทางการเงิน | ค่าใช้จ่ายเงินเดือนวิศวกรรม | ค่าบริการ SaaS / ตามการใช้งานแบบวนซ้ำ |
รายการตรวจสอบการบูรณาการและตารางการกำกับดูแล
องค์กรที่ขยายการใช้งานโมเดลของตนตามการลดราคาของ GPT-6 Sol และ Luna สามารถใช้กรอบการดำเนินงานนี้เพื่อป้องกันความโอเวอร์โหลดของระบบ:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] ตรวจสอบแอปพลิเคชันไคลเอนต์เพื่อระบุลูปการเรียกโมเดลแบบเรียกซ้ำที่ไม่มีขอบเขต          |
| [ ] กำหนดขีดจำกัดไทม์เอาต์ที่เข้มงวดและการลองใหม่แบบไม่เป็นเชิงเส้นพร้อมการสั่นแบบสุ่ม   |
| [ ] ใช้อัตราจำกัดโทเค็นบัคเก็ตที่ขอบและท้องถิ่นก่อนเรียกไปยังต้นน้ำ                      |
| [ ] จัดระเบียบโครงสร้างพรอมต์เพื่อเพิ่มการนำคำนำหน้าการแคชพรอมต์กลับมาใช้ใหม่สูงสุด        |
| [ ] แยกเทเลเมตรีการดำเนินงานแบบสูญเสียออกจากบันทึกการตรวจสอบที่ทนทานและเล่นซ้ำได้        |
| [ ] เพิ่มการสุ่มตัวอย่างรันไทม์เพื่อลบเนื้อหาพรอมต์ดิบออกจากร่องรอยความถี่สูง            |
| [ ] ตรวจสอบแนวโน้มสถานะ HTTP 429 และกำหนดทริกเกอร์แรงดันย้อนกลับอัตโนมัติ              |
| [ ] กำหนดค่าการแจ้งเตือนต้นทุนและตัวตัดวงจรเพื่อจับงานอัตโนมัติที่หลุดรอด               |
+-----------------------------------------------------------------------------------------+
การกำหนดค่าไปป์ไลน์เทเลเมตรี
ระบบการสังเกตการณ์ต้องแยกการบันทึกพรอมต์ออกจากเส้นทางคำขอแบบเรียลไทม์ เมื่อประมวลผลเวิร์กโหลดเอเจนต์ความถี่สูง แอปพลิเคชันควรเขียนเมตริกเทเลเมตรีไปยังคิวอะซิงโครนัสที่มีหน่วยความจำจำกัด เพื่อป้องกันการหยุดชะงักของ I/O หากตัวรวบรวมเทเลเมตรีปลายทางทำงานช้าลง
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
คำถามที่พบบ่อย (FAQ)
อัตรา API อย่างเป็นทางการสำหรับ GPT-6 Sol และ Luna คือเท่าไร?
การแคชพรอมต์ช่วยลดต้นทุนในการสนทนายาว ๆ ได้อย่างไร?
เหตุใดโทเค็นที่ถูกลงจึงเพิ่มความเสี่ยงในการดำเนินงานแบ็กเอนด์?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
การเปิดตัว GPT-6 Sol และ Luna เร่งให้แนวโน้มในวงกว้างชัดเจนยิ่งขึ้น: ความฉลาดระดับแนวหน้ากำลังมีราคาถูกลงและเข้าถึงได้ง่ายขึ้น เมื่อต้นทุนโทเค็นต่อหน่วยลดลงอย่างรวดเร็ว ข้อจำกัดทางการเงินจึงไม่ใช่กลไกควบคุมที่มีประสิทธิภาพสำหรับสถาปัตยกรรมซอฟต์แวร์อีกต่อไป
ในขณะที่องค์กรนำเอเจนต์ความถี่สูงและโทโพโลยีโมเดลหลายระดับมาใช้ วิศวกรรมการดำเนินงานจึงกลายเป็นสิ่งสำคัญต่อความสำเร็จขององค์กร ทีมงานต้องก้าวข้ามการประเมินโมเดลเพียงแค่ราคาโทเค็นตามชื่อหรือคะแนนเกณฑ์มาตรฐาน ความน่าเชื่อถือในระยะยาวจะขึ้นอยู่กับว่าระบบจัดการความพร้อมกัน ปรับบริบทพรอมต์เพื่อการนำแคชกลับมาใช้ใหม่ จัดการอัตราจำกัดของต้นน้ำอย่างราบรื่น และแยกเทเลเมตรีออกจากเส้นทางแอปพลิเคชันที่สำคัญได้อย่างมีประสิทธิภาพเพียงใด องค์กรที่สร้างโครงสร้างพื้นฐานที่มีความยืดหยุ่นจะสามารถขยายเวิร์กโฟลว์เอเจนต์อัตโนมัติของตนได้อย่างประสบความสำเร็จโดยไม่สูญเสียเวลาการทำงานของแอปพลิเคชันหรือเสถียรภาพของระบบ
แหล่งข้อมูลหลักและเอกสารอ้างอิง
-
ข้อมูลอ้างอิงราคา API สำหรับนักพัฒนาของ OpenAI: บัตรอัตราค่าบริการสำหรับนักพัฒนาอย่างเป็นทางการ ข้อจำกัดหน้าต่างบริบท (เกณฑ์มาตรฐาน ≤272K) และตารางกำหนดราคาการอ่าน/เขียนแคชสำหรับ GPT-6 Sol, Luna และ Astra
-
ประกาศจากคอมมิวนิตี้ของ OpenAI: การเปิดเผยข้อมูลต่อสาธารณะยืนยันการลดราคาฐานลง 50% เมื่อเทียบกับระดับโปรโมชั่นของ GPT-5.6 และรายละเอียดการทยอยปล่อยอัปเดต
-
ข้อกำหนดการแคชพรอมต์ของ OpenAI: เอกสารสถาปัตยกรรมการนำคำนำหน้า Key-Value ฝั่งเซิร์ฟเวอร์กลับมาใช้ใหม่ ค่าใช้จ่ายในการเขียนแคช และกฎการทำให้โมฆะของการกำหนดค่า
-
ข้อกำหนดแพลตฟอร์ม Anthropic Claude Opus 5.5: ข้อมูลจำเพาะการเปิดตัวอย่างเป็นทางการยืนยันอัตราโทเค็นอินพุต $4 / อ웃พุต $20 / การอ่านแคช $0.20 และประสิทธิภาพของเกณฑ์มาตรฐาน
-
ภาพรวม Anthropic Claude Sonnet 5: บัตรอัตราค่าบริการสำหรับนักพัฒนาอย่างเป็นทางการและตัวชี้วัดประสิทธิภาพการแคชพรอมต์ (อินพุต $2 / อ웃พุต $10 / ส่วนลดแคชสูงสุด 90%)
-
บัตรอัตราค่าบริการ Google AI สำหรับนักพัฒนา: ภาพรวมบัตรอัตราค่าบริการสำหรับนักพัฒนาและนโยบายราคาเปิดตัวสำหรับ Gemini 3.8 Flash
-
กำหนดการและราคา API อย่างเป็นทางการของ Xiaomi MiMo: อัตราโทเค็นแบบจ่ายตามการใช้งานจริงในต่างประเทศสำหรับอินพุต MiMo-V2.6-Pro ($0.435 อินพุต / $0.87 อ웃พุต / $0.0036 การเข้าถึงแคช)
-
รายงานของ VentureBeat เกี่ยวกับเกณฑ์มาตรฐาน GPT-6 Sol และ Luna: การครอบคลุมเศรษฐศาสตร์การเปิดตัว การรับประกันราคาถาวร และตัวเลขต้นทุนงาน AutomationBench 1.0.6 ($0.27 ต่อความพยายามในการทำงานหนึ่งครั้ง)
Share this article