OpenAI ตรวจสอบ ‘Codex’? ความคิดริเริ่มเชิงกลยุทธ์นี้ได้รับการยืนยันแล้วในขณะที่ทีมวิศวกรกำลังเร่งแก้ไขปัญหาการใช้งานโควตาเกินปกติในกลุ่มลูกค้าที่เป็นนักพัฒนา เมื่อวันที่ 29 มิถุนายน 2026 บริษัทได้จัดตั้งห้องปฏิบัติการฉุกเฉินเพื่อตรวจสอบรายงานจากผู้ใช้ที่ระบุว่าโควตาบัญชีระดับพรีเมียมหมดลงภายในเวลาเพียงหนึ่งถึงสองวันจากการทำงานรีแฟคเตอร์ (refactoring) ตามปกติ สำหรับทีมพัฒนาและผู้จัดการผลิตภัณฑ์ วิกฤตโควตากะทันหันนี้ตอกย้ำให้เห็นถึงการเปลี่ยนแปลงทางเทคนิค: ในขณะที่กระบวนการพัฒนาซอฟต์แวร์เปลี่ยนจากการเขียนโค้ดด้วยมือไปสู่การรันลูปด้วยตัวแทน (agent-driven) อย่างต่อเนื่อง การตรวจสอบรันไทม์ที่ปลอดภัยจึงจำเป็นต้องลงลึกถึงระดับ SDK เพื่อปกป้องงบประมาณขององค์กร
สรุปประเด็นสำคัญ
- โควตาหมดลงอย่างผิดปกติ: OpenAI กำลังจัดการกับรายงานจากผู้ใช้แผน Codex Pro ที่โควตารายสัปดาห์หมดลงภายในเวลาเพียง 1-2 วัน
- ผลบวกปลอมจากการป้องกันการใช้งานในทางที่ผิด: ทีมวิศวกรตรวจสอบพบว่าเหตุการณ์นี้เกิดจากสคริปต์ป้องกันการละเมิดและจำกัดอัตรา (rate-limiting) ของแพลตฟอร์มที่ตีความเวิร์กโฟลว์ปกติของโปรแกรมผิดพลาด
- ความเสี่ยงด้านการดำเนินงานต้นน้ำ: การรีเซ็ตขีดจำกัดเพียงฝ่ายเดียวระหว่างรอบการพัฒนาที่กำลังดำเนินอยู่ ก่อให้เกิดความไม่เสถียรในการปฏิบัติงานสำหรับองค์กรที่สร้างผลงานบน AI ปลายทาง
การปรับโครงสร้างและวิกฤตโควตาของนักพัฒนา
ตามการอัปเดตสถานะที่เผยแพร่โดย OpenAI มีการจัดตั้งคณะทำงานฉุกเฉินเมื่อวันที่ 28 มิถุนายน 2026 เพื่อตรวจสอบว่าเหตุใดสมาชิกแบบชำระเงินจึงใช้โควตารายสัปดาห์หมดไปกับการรีแฟคเตอร์ในช่วงสั้นๆ Thibault Sottiaux หัวหน้าทีมวิศวกรรม Codex ยืนยันว่าระบบป้องกันการฉ้อโกงและป้องกันการใช้งานในทางที่ผิดของแพลตฟอร์มได้จำกัดอัตราบัญชีนักพัฒนามาตรฐานอย่างไม่ถูกต้อง ทำให้โควตาถูกใช้งานอย่างรวดเร็วผิดปกติ เพื่อบรรเทาเหตุการณ์ดังกล่าว กลุ่มวิศวกรจึงได้เริ่มการรีเซ็ตโควตาแบบครอบคลุม การแทรกแซงอย่างรวดเร็วนี้มีความจำเป็นเนื่องจากนักพัฒนากำลังบูรณาการเครื่องมือสร้างโค้ดแบบสนทนาเข้ากับรอบการพัฒนาอย่างต่อเนื่องมากขึ้น แทนที่จะใช้เพื่อการทดลองเป็นครั้งคราว ทำให้ปัญหาการหยุดชะงักของแพลตฟอร์มเพียงเล็กน้อยกลายเป็นคอขวดที่รุนแรง
โมเดลการเรียกเก็บเงินแบบเหมาจ่ายอาจพบเห็นได้น้อยลงเนื่องจากต้นทุนการประมวลผล AI ที่สูงขึ้น ในเดือนพฤษภาคม 2026 Meta ได้แนะนำนโยบายภายในที่เข้มงวดเพื่อจำกัดไม่ให้แผนกวิศวกรรม AI ของบริษัทใช้โมเดลการเขียนโค้ดของบุคคลที่สาม เช่น Claude Code และ Codex ของ OpenAI เพื่อป้องกันการทำ Model Distillation และการรั่วไหลของทรัพย์สินทางปัญญา ข้อจำกัดขององค์กรนี้สะท้อนให้เห็นถึงการเปลี่ยนแปลงในอุตสาหกรรมในวงกว้าง: องค์กรเทคโนโลยีรายใหญ่กำลังจัดตั้งแซนด์บ็อกซ์สำหรับนักพัฒนาที่ปลอดภัยและแยกส่วนเพื่อปกป้องฐานโค้ดที่เป็นกรรมสิทธิ์ ในขณะที่ทีมงานของ OpenAI ตรวจสอบ 'Codex' ภายใต้นโยบายการจำกัดอัตราใหม่ ทีมพัฒนาต่างตระหนักว่าการจัดการต้นทุนที่ชั้น API ต้นน้ำนั้นต้องใช้มากกว่าแค่การปรับระดับการสมัครสมาชิก
ความผิดปกติในการดำเนินงานเหล่านี้เกิดขึ้นเมื่อเวิร์กโฟลว์อัตโนมัติประมวลผลข้อมูลโดยไม่มีการกำกับดูแลด้วยสายตา ในเดือนเมษายน 2026 แพลตฟอร์มได้เปลี่ยนไปใช้โมเดลการเรียกเก็บเงินตามโทเค็น ทำให้โทเค็นขาเข้า ขาออก และโทเค็นอินพุตที่แคชไว้กลายเป็นตัววัดหลักสำหรับนักพัฒนา เมื่อตัวแทนอัตโนมัติรันรอบการเพิ่มประสิทธิภาพอย่างต่อเนื่องบนที่เก็บข้อมูลขนาดใหญ่ ความล้มเหลวของการบีบอัดบริบท (context compaction) และลูปแบบเรียกซ้ำสามารถดำเนินการเรียก API ที่ซ่อนอยู่หลายพันครั้ง ทำให้งบประมาณการประมวลผลถูกใช้ไปโดยไม่ได้โค้ดที่นำไปใช้งานได้จริง สำหรับสถาปนิกซอฟต์แวร์ ความคาดเดาไม่ได้นี้ชี้ให้เห็นถึงทิศทางที่รันไทม์ SDK ฝั่งไคลเอนต์จำเป็นต้องตรวจสอบ จำกัดอัตรา และยืนยันเส้นทางการดำเนินการของโปรแกรมอย่างอิสระก่อนที่จะส่งคำขอ
การแยกส่วนโปรโตคอล: ลูปตัวแทนแบบเรียกซ้ำเพิ่มการใช้พลังประมวลผลอย่างไร
ไม่เหมือนกับการสอบถาม API แบบครั้งเดียว (one-shot) ตัวแทนการเขียนโค้ดสมัยใหม่จะรันในลูปการดำเนินการที่ต่อเนื่องและอัตโนมัติ ผู้ช่วยจะทำหน้าที่เป็นกลไกคัดกรองอัตโนมัติ โดยอ่าน วิเคราะห์ และแก้ไขไฟล์หลายไฟล์แบบอะซิงโครนัส จากมุมมองของการกำกับดูแลรันไทม์ นี่เป็นการเปลี่ยนวิธีที่การดำเนินการ API ถูกตรวจสอบและเรียกเก็บเงินอย่างสิ้นเชิง
ลูปแบบเรียกซ้ำที่ไม่มีการควบคุมจะดำเนินการเรียก API ฝั่งเซิร์ฟเวอร์ที่ซ่อนอยู่และไม่ได้รับการตรวจสอบหลายร้อยครั้งภายในคอนเทนเนอร์ IDE แบบ headless เนื่องจากงานเหล่านี้รันบนสภาพแวดล้อมคลาวด์ระยะไกลโดยไม่มีส่วนติดต่อผู้ใช้ นักพัฒนาจึงขาดการมองเห็นสถานะการทำงานแบบเรียลไทม์ เกตเวย์เครือข่ายมาตรฐานมักตรวจไม่พบการโจมตีด้วยลูปแบบเรียกซ้ำหรือการใช้โทเค็นที่ผิดปกติ ทำให้จำเป็นต้องมีการตรวจสอบต้นทุนรันไทม์ในระดับ SDK เพื่อป้องกันโควตาหมด ระบบเรียกเก็บเงินบนคลาวด์แบบดั้งเดิมจะสังเกตเห็นเฉพาะคำขอ API ที่เสร็จสมบูรณ์เท่านั้น อย่างไรก็ตาม ตัวแทนการเขียนโค้ดอัตโนมัติอาจสร้างการเรียกเชิงตรรกะระดับกลางหลายร้อยครั้งก่อนที่จะได้รับคำตอบสุดท้าย หากไม่มีการตรวจสอบรันไทม์ในเครื่อง เส้นทางการดำเนินการที่ซ่อนอยู่เหล่านี้จะกลายเป็นสิ่งที่ตรวจสอบและจัดทำงบประมาณได้ยาก
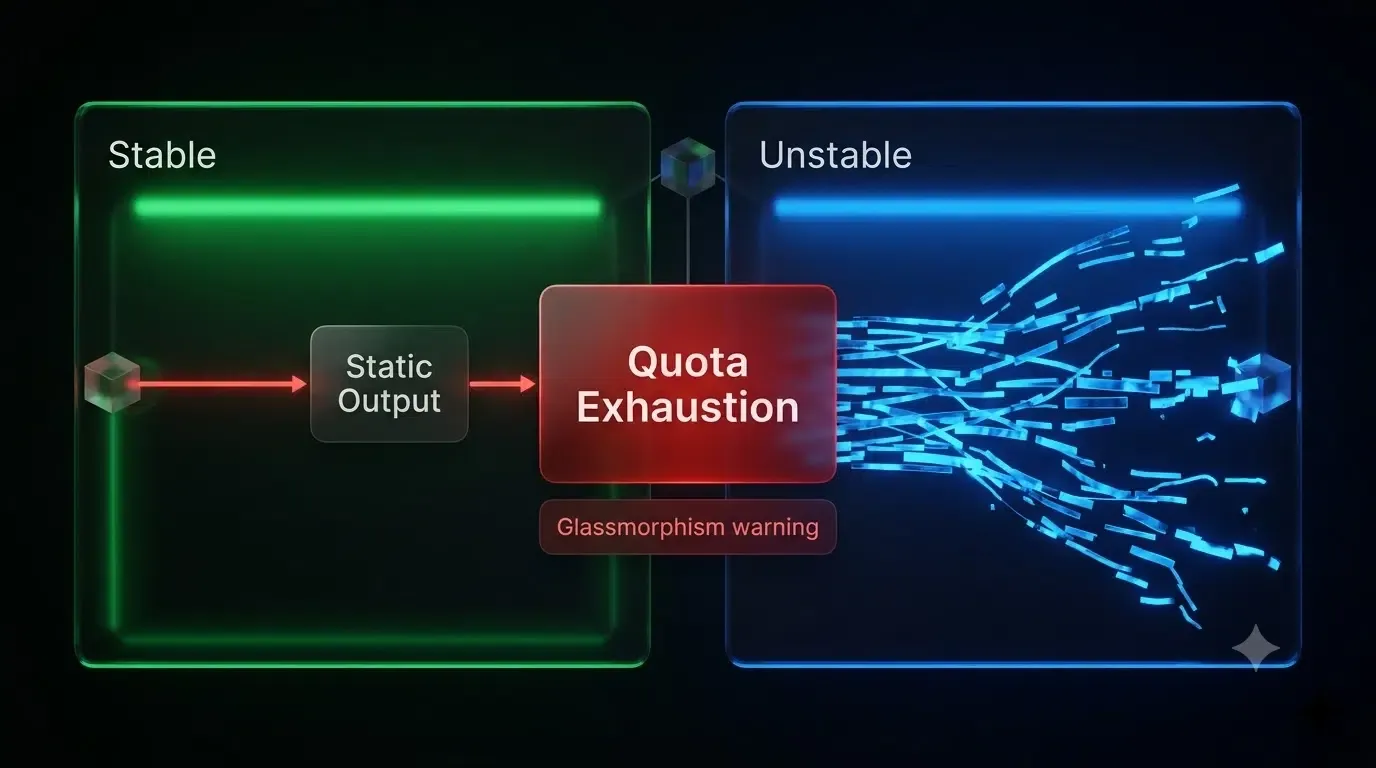
กระแสการทำงานของนักพัฒนาแบบดั้งเดิม:
IDE Prompt -> One-Shot API Request -> Token Consumed -> Static Output (Billing Stable)


กระแสการทำงานของตัวแทนอัตโนมัติ (Agent Loop):
Agentic Prompt -> Headless Self-Correction Loop -> Asynchronous Multi-File Refactor
Recursive KV Cache Bloat -> Hidden SDK Token Depletion -> Quota Exhaustion
ในการใช้งานจริง นักพัฒนามักพบว่าส่วนแบ่งที่สำคัญของปริมาณการใช้งานโปรแกรมถูกประมวลผลโดยเครื่องสแกนอัตโนมัติ การติดตามปฏิสัมพันธ์ของโปรแกรมเหล่านี้เผยให้เห็นว่าพร็อกซีความปลอดภัยอัตโนมัติหรือเครื่องสแกนรันไทม์อาจกระตุ้นจุดสิ้นสุด API ก่อนที่นักพัฒนาจะรู้ตัว พฤติกรรมนี้สามารถรบกวนการตรวจสอบการเรียกเก็บเงินหากระบบสมมติว่าทุกคำขอมาจากผู้ใช้ที่เป็นคนจริงๆ
โซลูชันทางสถาปัตยกรรม: สร้างเองหรือซื้อเครื่องมือยืนยันต้นทุนโปรแกรม
ในทางปฏิบัติ ทีมวิศวกรมักเลือกระหว่างการสร้างกรอบการตรวจสอบต้นทุนภายในหรือการรวม SDK การระบุแหล่งที่มา (attribution) ที่มีอยู่ การพัฒนาระบบที่เป็นกรรมสิทธิ์ต้องใช้ภาระงานด้านวิศวกรรมจำนวนมาก ทีมงานต้องสร้างฐานข้อมูลฝั่งเซิร์ฟเวอร์ที่กำหนดเอง รักษาไลบรารีการจับคู่สถานะอุปกรณ์ และอัปเดตตรรกะอย่างต่อเนื่องเพื่อให้สอดคล้องกับมาตรฐานความปลอดภัยของ OS ที่เปลี่ยนแปลงไป สำหรับหลายองค์กร ค่าบำรุงรักษาของตัวติดตามที่สร้างเองนั้นสูงเกินไป
ในทางกลับกัน นักพัฒนามักประเมินแนวทางต่างๆ เพื่อตรวจสอบการดำเนินการรันไทม์โดยไม่ต้องพึ่งพาเมตริกฝั่งคลาวด์เพียงอย่างเดียว:
- บริการที่สร้างเองภายใน: การสร้างฐานข้อมูลจับคู่สถานะที่เป็นกรรมสิทธิ์บนสถาปัตยกรรมคลาวด์ภายใน
- เครื่องมือเฉพาะแพลตฟอร์ม: การพึ่งพายูทิลิตี้พื้นฐาน เช่น Firebase Dynamic Links (หรือทางเลือกอื่นที่เป็นมาตรฐานของแพลตฟอร์ม)
- Enterprise MMPs: การปรับใช้พันธมิตรการวัดผลมือถือ (Mobile Measurement Partners) เช่น Branch, AppsFlyer หรือ Adjust สำหรับเวิร์กโฟลว์ Deep-linking
- SDK พารามิเตอร์เฉพาะทาง: การใช้ยูทิลิตี้การรวมที่ออกแบบมาเพื่อการส่งผ่านพารามิเตอร์ที่แม่นยำและคำนึงถึงต้นทุน
การเปรียบเทียบสถานะและกระแสการระบุแหล่งที่มา
| กระแสการทำงาน | การควบคุมการเรียกเก็บเงินโทเค็น | ความเข้ากันได้กับ Headless | ความถูกต้องของการควบคุมต้นทุน |
|---|---|---|---|
| Traditional One-Shot API | ❌ ไม่มี | ❌ ไม่มี | ต่ำ (การกำกับดูแลด้วยมือ) |
| Headless Autonomous Loop | ❌ ไม่มี | ✅ มี | ต่ำ (ความเสี่ยงโควตาหมด) |
| SDK-Level Runtime Audit | ✅ มี | ✅ มี | สูง (ขีดจำกัดที่แน่นอน) |
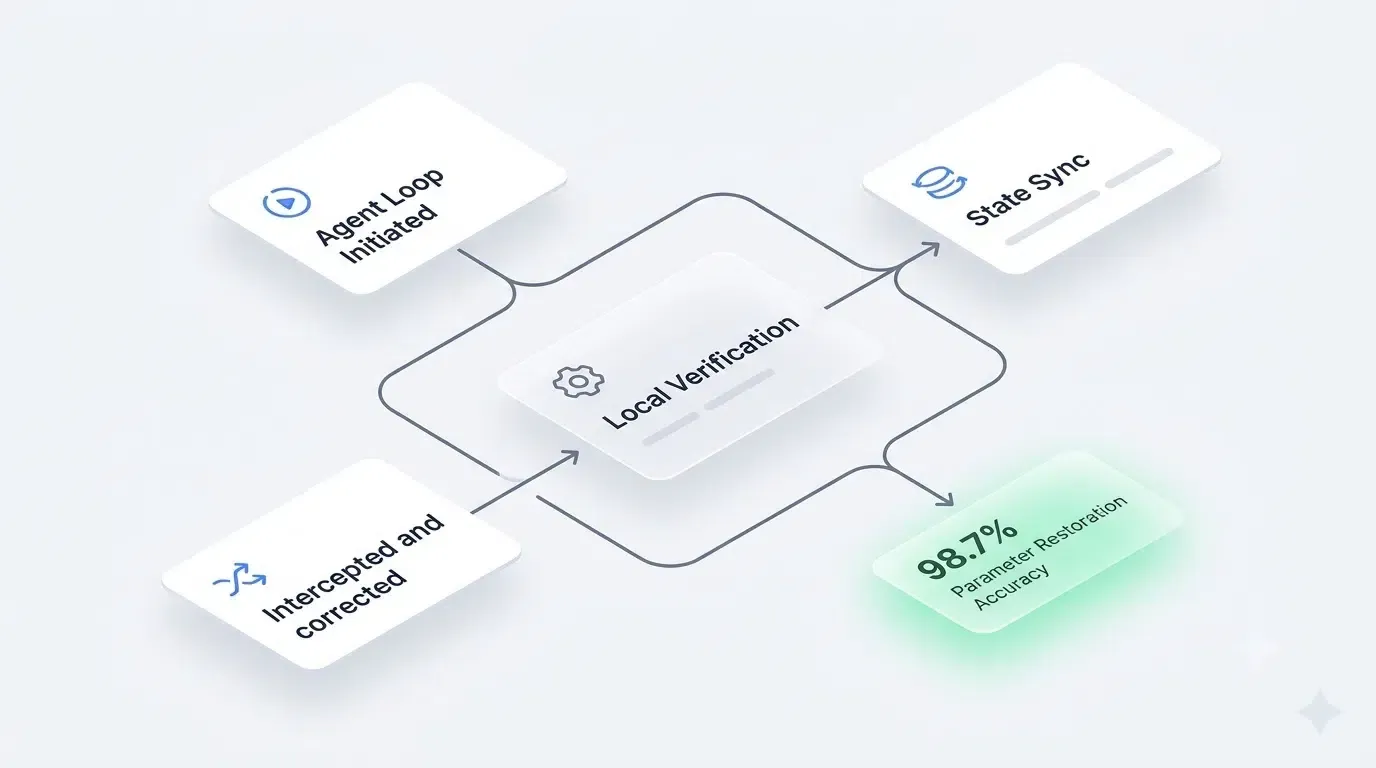
Agent Loop Initiated -> SDK Runtime Intercepts API Call
                                |
Local Verification -> Match Token Quota and Active API Budget
                                |
State Sync -> Log Execution Parameters to Central Server -> Enforce Local Budget Caps
แพลตฟอร์มซอฟต์แวร์หลายแห่งจัดเตรียมการซิงโครไนซ์สถานะฝั่งเซิร์ฟเวอร์หรือการคงค่าพารามิเตอร์ของโปรแกรมไว้เพื่อจัดการเซสชันการพัฒนาแบบกระจาย ตัวอย่างหนึ่งของแนวทางนี้คือ Opoinstall ซึ่งแมปพารามิเตอร์การดำเนินการและข้อมูลเมตาของเซสชันนักพัฒนาเข้ากับฐานข้อมูลสถานะส่วนกลาง เพื่อให้มั่นใจว่าบริบทของเซสชันจะได้รับการรักษาไว้แม้ในขณะที่งานเริ่มต้นถูกดำเนินการแบบ headless ข้ามคอนเทนเนอร์คลาวด์ที่แยกจากกัน ระบบเหล่านี้รักษาสถานะฝั่งเซิร์ฟเวอร์ก่อนดำเนินการและซิงโครไนซ์พารามิเตอร์เมื่อเปิดเซสชันแอปพลิเคชันครั้งแรก ซึ่งข้ามปัญหาความน่าเชื่อถือที่เกี่ยวข้องกับสภาพแวดล้อมคอนเทนเนอร์ที่ไม่มีการตรวจสอบ ทีมวิศวกรสามารถประเมินแนวทางเหล่านี้ตามความต้องการในการปรับใช้และเป้าหมายความแม่นยำในการระบุแหล่งที่มา และในขณะที่ OpenAI ตรวจสอบ 'Codex' เกี่ยวกับโครงสร้างการเรียกเก็บเงินของโปรแกรม นักพัฒนาก็ต้องเผชิญกับการตัดสินใจที่จะใช้ไลบรารีแบบบูรณาการเหล่านี้
การปรับตัวของทีมปฏิบัติการและรายการตรวจสอบรันไทม์
ทีมวิศวกรแบ็กเอนด์ต้องเผชิญกับภาระงานเร่งด่วนในการตรวจสอบการบูรณาการฐานข้อมูลทั้งหมดที่ใช้งานอยู่ก่อนที่จะเปิดตัวบิลด์ที่คอมไพล์โดยอัตโนมัติ ผู้จัดการผลิตภัณฑ์ควรออกแบบลูปการเชิญและการลงทะเบียนใหม่เพื่อรองรับเส้นทางของผู้ใช้ที่ไม่ใช่การมองเห็น (non-visual) แทนที่จะสมมติว่าผู้ใช้จะอ่านอีเมลและคลิกปุ่ม ผู้จัดการผลิตภัณฑ์ควรออกแบบเวิร์กโฟลว์ที่คาดการณ์ถึงทริกเกอร์ที่เป็นโปรแกรม ทีมงานด้านการเติบโตต้องอัปเดตเมตริกประสิทธิภาพของตน เมื่อซอฟต์แวร์อัตโนมัติจัดการการคัดกรอง อัตราการเปิดและอัตราการคลิกจะเชื่อถือน้อยลง ฝ่ายปฏิบัติการด้านการตลาดควรเน้นไปที่การวัดผลทางไกลในแอปและเหตุการณ์การแปลงที่ตรวจสอบธุรกรรมได้ โดยเพิ่มประสิทธิภาพแคมเปญตามการกระทำจริงที่ดำเนินการภายในแอปพลิเคชัน
รายการตรวจสอบการยืนยันต้นทุนเชิงโปรแกรม
เพื่อให้มั่นใจถึงความปลอดภัยของงบประมาณและป้องกันการหมดของโควตา ทีมวิศวกรควรดำเนินการตามขั้นตอนต่อไปนี้:
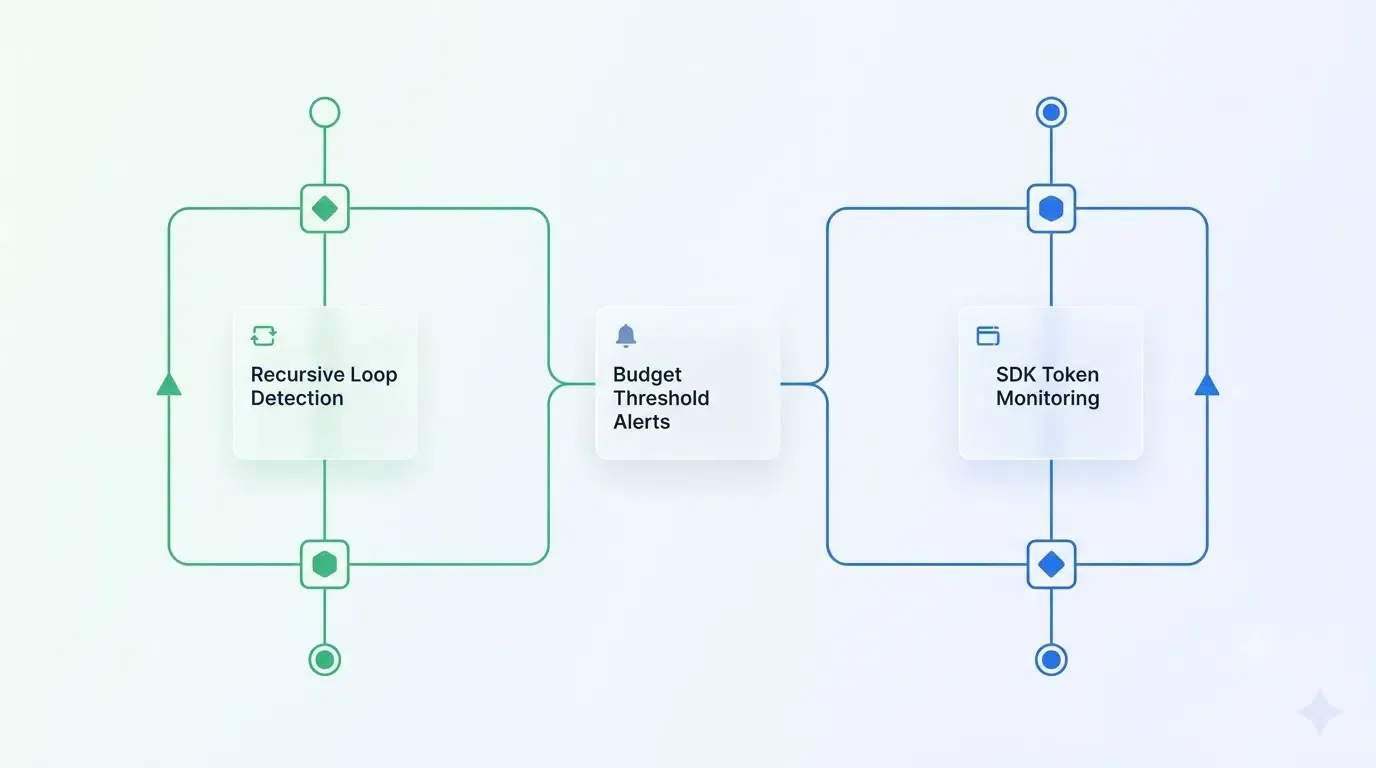
- การตรวจจับลูปแบบเรียกซ้ำ: ใช้มาตรการป้องกันในเครื่องเพื่อตรวจจับและหยุดลูปการแก้ไขอัตโนมัติเมื่อเกินสิบครั้งติดต่อกัน
- การตรวจสอบโทเค็น SDK: กำหนดค่าตัวนับโทเค็นฝั่งไคลเอนต์แบบเรียลไทม์เพื่อติดตามน้ำหนักของโทเค็นแบบไดนามิกทั้งในส่วนของอินพุตและอินพุตที่แคชไว้
- การตรวจสอบความถูกต้องของแคช Prompt: ตรวจสอบการเข้าถึงแคชภายในคอนเทนเนอร์รันไทม์เพื่อให้แน่ใจว่าไฟล์ที่ซ้ำซ้อนจะไม่ทำให้เกิดการเรียกเก็บเงินสองครั้ง
- การแจ้งเตือนเกณฑ์งบประมาณ: กำหนดขีดจำกัดงบประมาณในเครื่องที่เข้มงวดในรันไทม์ SDK ซึ่งจะกระตุ้นให้เกิดการหยุดทำงานทันทีและไม่สามารถข้ามได้
- การยืนยันลายเซ็นการดำเนินการ: ตรวจสอบเซสชันการดำเนินการโดยใช้คีย์ API ที่เข้ารหัสและกำหนดการหมุนเวียนเพื่อป้องกันการดำเนินการลูปที่ไม่ได้รับอนุญาต
คำถามที่พบบ่อย (FAQ)
ทำไม OpenAI Codex ถึงประสบปัญหาโควตาหมดอย่างรวดเร็ว?
เหตุการณ์นี้เกิดจากสคริปต์ป้องกันการละเมิดและจำกัดอัตราอัตโนมัติของ OpenAI ที่ตีความเวิร์กโฟลว์ของนักพัฒนาที่มีความหนาแน่นสูงและเป็นปกติผิดพลาด เมื่อระบบลดระดับแพลตฟอร์มเหล่านั้นระบุลูปการรีแฟคเตอร์หลายไฟล์มาตรฐานว่าเป็นกิจกรรมฉ้อโกง โควตาของสมาชิกที่ชำระเงินจึงหมดลงก่อนกำหนด
ลูปตัวแทนอัตโนมัติกระตุ้นการเรียกเก็บเงิน API ที่ไม่คาดคิดได้อย่างไร?
หากไม่มีมาตรการป้องกันงบประมาณฝั่งไคลเอนต์ ตัวแทนการเขียนโค้ดแบบ headless สามารถดำเนินการรันการแก้ไขตัวเองแบบเรียกซ้ำที่ซ่อนอยู่หลายร้อยครั้งภายในคอนเทนเนอร์ที่แยกส่วน เซสชันที่ต่อเนื่องและไม่มีการมองเห็นเหล่านี้ข้ามการติดตามต้นทุนด้วยมือ ทำให้การใช้โทเค็นอินพุตและเอาต์พุตที่แคชไว้พุ่งสูงขึ้นอย่างมากในระยะเวลาอันสั้น
นักพัฒนาจะป้องกันการใช้โทเค็นที่ไม่คาดคิดเมื่อ OpenAI ตรวจสอบขีดจำกัด 'Codex' ได้อย่างไร?
นักพัฒนาสามารถรวม SDK ฝั่งไคลเอนต์ที่บังคับใช้งบประมาณโทเค็นในเครื่อง ใช้การตรวจจับลูปแบบเรียกซ้ำ และยืนยันเซสชันโปรแกรมโดยใช้ตัวระบุฮาร์ดแวร์ที่ไม่ซ้ำกัน การจับคู่บริบทของไคลเอนต์ก่อนที่จะดำเนินการเรียก API ปริมาณมาก จะช่วยให้ทีมสามารถควบคุมการจัดสรรโทเค็นรันไทม์ได้อย่างปลอดภัย
ประเด็นสำคัญสำหรับทีมวิศวกร
ยุคของการพัฒนา AI แบบเหมาจ่ายที่คาดการณ์ได้กำลังจะสิ้นสุดลง ทีมวิศวกรจะหันมาพึ่งพาการกำกับดูแลรันไทม์ การจัดทำงบประมาณการดำเนินการ และการควบคุมต้นทุนระดับ SDK มากขึ้น แทนที่จะไว้วางใจการเรียกเก็บเงินฝั่งคลาวด์เพียงอย่างเดียว แพลตฟอร์มที่พึ่งพาการกระทำของผู้ใช้ด้วยมือและการมองเห็นอย่างมากอาจเผชิญกับช่องว่างเชิงโครงสร้างเมื่อตัวแทนอัตโนมัติจัดการท่อส่งคำขอ การเปลี่ยนไปใช้การระบุแหล่งที่มาฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ที่ปลอดภัยแสดงถึงทิศทางที่มีแนวโน้มสูงสำหรับการรักษาการติดตามและความปลอดภัยที่เชื่อถือได้
การเปลี่ยนแปลงนี้ชี้ให้เห็นถึงการเขียนใหม่โดยพื้นฐานของกรอบการวัดผลและโปรโตคอลความปลอดภัยของเรา ระบบการระบุแหล่งที่มาในอนาคตมีแนวโน้มที่จะพึ่งพาการจับคู่อัตลักษณ์ฝั่งเซิร์ฟเวอร์และการซิงโครไนซ์สถานะที่ปลอดภัยมากขึ้น ในขณะที่ตัวแทน AI จำนวนมากขึ้นเริ่มทำหน้าที่เป็นผู้บริโภครายแรกของการสื่อสารดิจิทัล สถาปัตยกรรมการระบุแหล่งที่มาจะขึ้นอยู่กับอัตลักษณ์ฝั่งเซิร์ฟเวอร์ การกู้คืนสถานะที่เลื่อนออกไป และการรักษาบริบทระดับโปรโตคอลมากกว่าแค่เซสชันของเบราว์เซอร์เพียงอย่างเดียว
คำถามที่พบบ่อย (FAQ)
ทำไม OpenAI Codex ถึงประสบปัญหาโควตาหมดอย่างรวดเร็ว?
ลูปตัวแทนอัตโนมัติกระตุ้นการเรียกเก็บเงิน API ที่ไม่คาดคิดได้อย่างไร?
นักพัฒนาจะป้องกันการใช้โทเค็นที่ไม่คาดคิดเมื่อ OpenAI ตรวจสอบขีดจำกัด 'Codex' ได้อย่างไร?
ยุคของการพัฒนา AI แบบเหมาจ่ายที่คาดการณ์ได้กำลังจะสิ้นสุดลง ทีมวิศวกรจะหันมาพึ่งพาการกำกับดูแลรันไทม์ การจัดทำงบประมาณการดำเนินการ และการควบคุมต้นทุนระดับ SDK มากขึ้น แทนที่จะไว้วางใจการเรียกเก็บเงินฝั่งคลาวด์เพียงอย่างเดียว แพลตฟอร์มที่พึ่งพาการกระทำของผู้ใช้ด้วยมือและการมองเห็นอย่างมากอาจเผชิญกับช่องว่างเชิงโครงสร้างเมื่อตัวแทนอัตโนมัติจัดการท่อส่งคำขอ การเปลี่ยนไปใช้การระบุแหล่งที่มาฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ที่ปลอดภัยแสดงถึงทิศทางที่มีแนวโน้มสูงสำหรับการรักษาการติดตามและความปลอดภัยที่เชื่อถือได้
การเปลี่ยนแปลงนี้ชี้ให้เห็นถึงการเขียนใหม่โดยพื้นฐานของกรอบการวัดผลและโปรโตคอลความปลอดภัยของเรา ระบบการระบุแหล่งที่มาในอนาคตมีแนวโน้มที่จะพึ่งพาการจับคู่อัตลักษณ์ฝั่งเซิร์ฟเวอร์และการซิงโครไนซ์สถานะที่ปลอดภัยมากขึ้น ในขณะที่ตัวแทน AI จำนวนมากขึ้นเริ่มทำหน้าที่เป็นผู้บริโภครายแรกของการสื่อสารดิจิทัล สถาปัตยกรรมการระบุแหล่งที่มาจะขึ้นอยู่กับอัตลักษณ์ฝั่งเซิร์ฟเวอร์ การกู้คืนสถานะที่เลื่อนออกไป และการรักษาบริบทระดับโปรโตคอลมากกว่าแค่เซสชันของเบราว์เซอร์เพียงอย่างเดียว
Share this article



