การระบุแหล่งที่มาตามหลักความน่าจะเป็น (Probabilistic Attribution) ทำงานอย่างไรภายใต้กฎความเป็นส่วนตัวที่เข้มงวด? Probabilistic attribution ทำงานโดยการคำนวณค่าความน่าจะเป็นของความสัมพันธ์ทางสถิติ จากสัญญาณเซสชันชั่วคราวที่ไม่ถาวร เช่น บริบทเครือข่ายแบบคร่าวๆ (Coarse Network Context), สัญญาณความเข้ากันได้ของเบราว์เซอร์ และความใกล้ชิดของช่วงเวลา (Temporal Proximity) ภายในกรอบเวลา Lookback Window ที่กำหนด โดยไม่มีการสร้างตัวระบุอุปกรณ์ข้ามแอปแบบถาวร
Probabilistic attribution คือระเบียบวิธีวัดผลทางสถิติที่คำนวณความเป็นไปได้เชิงคณิตศาสตร์ว่า การติดตั้งแอปพลิเคชันมีความสัมพันธ์ทางสถิติกับการมีส่วนร่วมในแคมเปญการตลาดหรือไม่ แทนที่จะเป็นการยืนยันตัวตนผู้ใช้ที่แน่นอน โมเดลความน่าจะเป็นจะประมาณการความสัมพันธ์ของการแปลง (Conversion) โดยการเชื่อมโยงสัญญาณเซสชันชั่วคราวที่ไม่เจาะจงตัวตนภายในกรอบเวลาที่จำกัด
| คำศัพท์ | คำจำกัดความ |
|---|---|
| Probabilistic Attribution | การเชื่อมโยงทางสถิติของสัญญาณเซสชันชั่วคราวเพื่อประมาณการที่มาของการติดตั้ง |
| Attribution Model | กฎทางคณิตศาสตร์ที่กำหนดการกระจายเครดิต Conversion ให้กับจุดสัมผัสทางการตลาด (Touchpoints) ต่างๆ |
| Mobile Attribution | กรอบการวัดผลที่ใช้ในการระบุแหล่งที่มาทางการตลาดที่ขับเคลื่อนการติดตั้งแอปและ Conversion |
| Tracking Parameters | พารามิเตอร์ Contextual Query แบบ First-party ที่ต่อท้าย URL แคมเปญเพื่อส่งต่อข้อมูล Metadata สำหรับการกำหนดเส้นทาง |
บทสรุปสำหรับผู้บริหาร
ในยุคโมบายล์หลังสิ้นสุดยุค IDFA ทีมวิศวกรรมไม่สามารถพึ่งพาตัวระบุอุปกรณ์แบบถาวรสำหรับการจับคู่การติดตั้งแบบ Deterministic ได้อีกต่อไป Probabilistic attribution จึงกลายมาเป็นกรอบการประมาณการทางสถิติที่ประเมินบริบทของเซสชันชั่วคราวที่ใช้ร่วมกัน เช่น สัญญาณเครือข่ายแบบคร่าวๆ, คุณลักษณะสภาพแวดล้อมทั่วไปของเบราว์เซอร์ และการประทับเวลาของเหตุการณ์ที่บันทึกไว้ภายใน Attribution Window ที่จำกัด เพื่อวัดผลลัพธ์ของแคมเปญในภาพรวมแบบ Aggregate
คู่มือนี้จะอธิบายหลักการพื้นฐานทางคณิตศาสตร์ของการให้คะแนนความน่าจะเป็น กำหนดขอบเขตด้านกฎระเบียบที่แยกการจับคู่เซสชันชั่วคราวออกจาก Fingerprinting อุปกรณ์ที่ถูกสั่งห้ามภายใต้กรอบ App Tracking Transparency (ATT) ของ Apple พร้อมทั้งเน้นข้อจำกัดสำคัญของแพลตฟอร์ม (เช่น iCloud Private Relay) และแสดงให้เห็นว่า First-party Routing Layer ทำงานร่วมกับ API ระดับเนทีฟของแพลตฟอร์มอย่าง Apple AdAttributionKit และ Google Play Install Referrer ได้อย่างไร
ขอบเขตสำคัญด้านกฎระเบียบ: Probabilistic attribution ไม่ได้บายพาสหรือหลีกเลี่ยงข้อกำหนด App Tracking Transparency ของ Apple แต่อย่างใด การนำสัญญาณมารวมกันเพื่อระบุตัวตนหรือติดตามผู้ใช้ข้ามแอปหรือเว็บไซต์ที่บุคคลอื่นเป็นเจ้าของ อาจถือเป็นการ Tracking และจำเป็นต้องได้รับการยินยอมผ่าน ATT อย่างชัดเจนตามนโยบายแพลตฟอร์มของ Apple บทความนี้อธิบายถึงสถาปัตยกรรมการวัดผลเชิงเทคนิคเท่านั้น และไม่ถือเป็นคำแนะนำทางกฎหมายเกี่ยวกับข้อกำหนดด้านความเป็นส่วนตัว
คำตอบโดยย่อ: Probabilistic Attribution ทำงานอย่างไรภายใต้กฎความเป็นส่วนตัวยุคใหม่
Probabilistic attribution คำนวณค่าความน่าจะเป็นของการแปลง (Conversion) โดยประมาณ ระหว่างการมีส่วนร่วมกับโฆษณาและการเปิดใช้งานแอป โดยประเมินจากแอตทริบิวต์บริบทชั่วคราวที่ใช้ร่วมกัน ซึ่งสถาปัตยกรรมนี้ดำเนินการภายใต้ขอบเขตการทำงานที่ชัดเจน:
-
Statistical Confidence Scoring: แทนที่จะเป็นการจับคู่แบบ Binary (ใช่/ไม่ใช่) เอนจินจะคำนวณคะแนนความเชื่อมั่นเชิงสถิติ (
S \\in \[0.0, 1.0\] ) ที่ได้มาจากความใกล้ชิดของช่วงเวลา, บริบทเครือข่ายแบบคร่าวๆ และคุณสมบัติของสภาพแวดล้อมทั่วไป -
Decay Functions: ค่าความเชื่อมั่นในการระบุแหล่งที่มาจะลดลงแบบทวีคูณ (Exponential) เมื่อช่วงเวลา (Delta) ระหว่างการคลิกบนเว็บกับการเปิดแอปเนทีฟเพิ่มขึ้น
-
Compliance Boundaries: ไม่สามารถใช้โมเดลทางสถิติเพื่อหลีกเลี่ยงนโยบายความเป็นส่วนตัวของแพลตฟอร์มได้ ภายใต้กรอบ Apple App Tracking Transparency (ATT) การไม่มีตัวระบุแบบถาวรเพียงอย่างเดียวไม่ได้เป็นสิ่งยืนยันความสอดคล้องกับนโยบาย เพราะสัญญาณชั่วคราวก็อาจถือเป็น Tracking ได้หากนำมารวมกันเพื่อระบุตัวตนหรือเชื่อมโยงผู้ใช้/อุปกรณ์ข้ามแอปหรือบริการ
สถาปัตยกรรมไปป์ไลน์ระดับโปรดักชันแบบ End-to-End
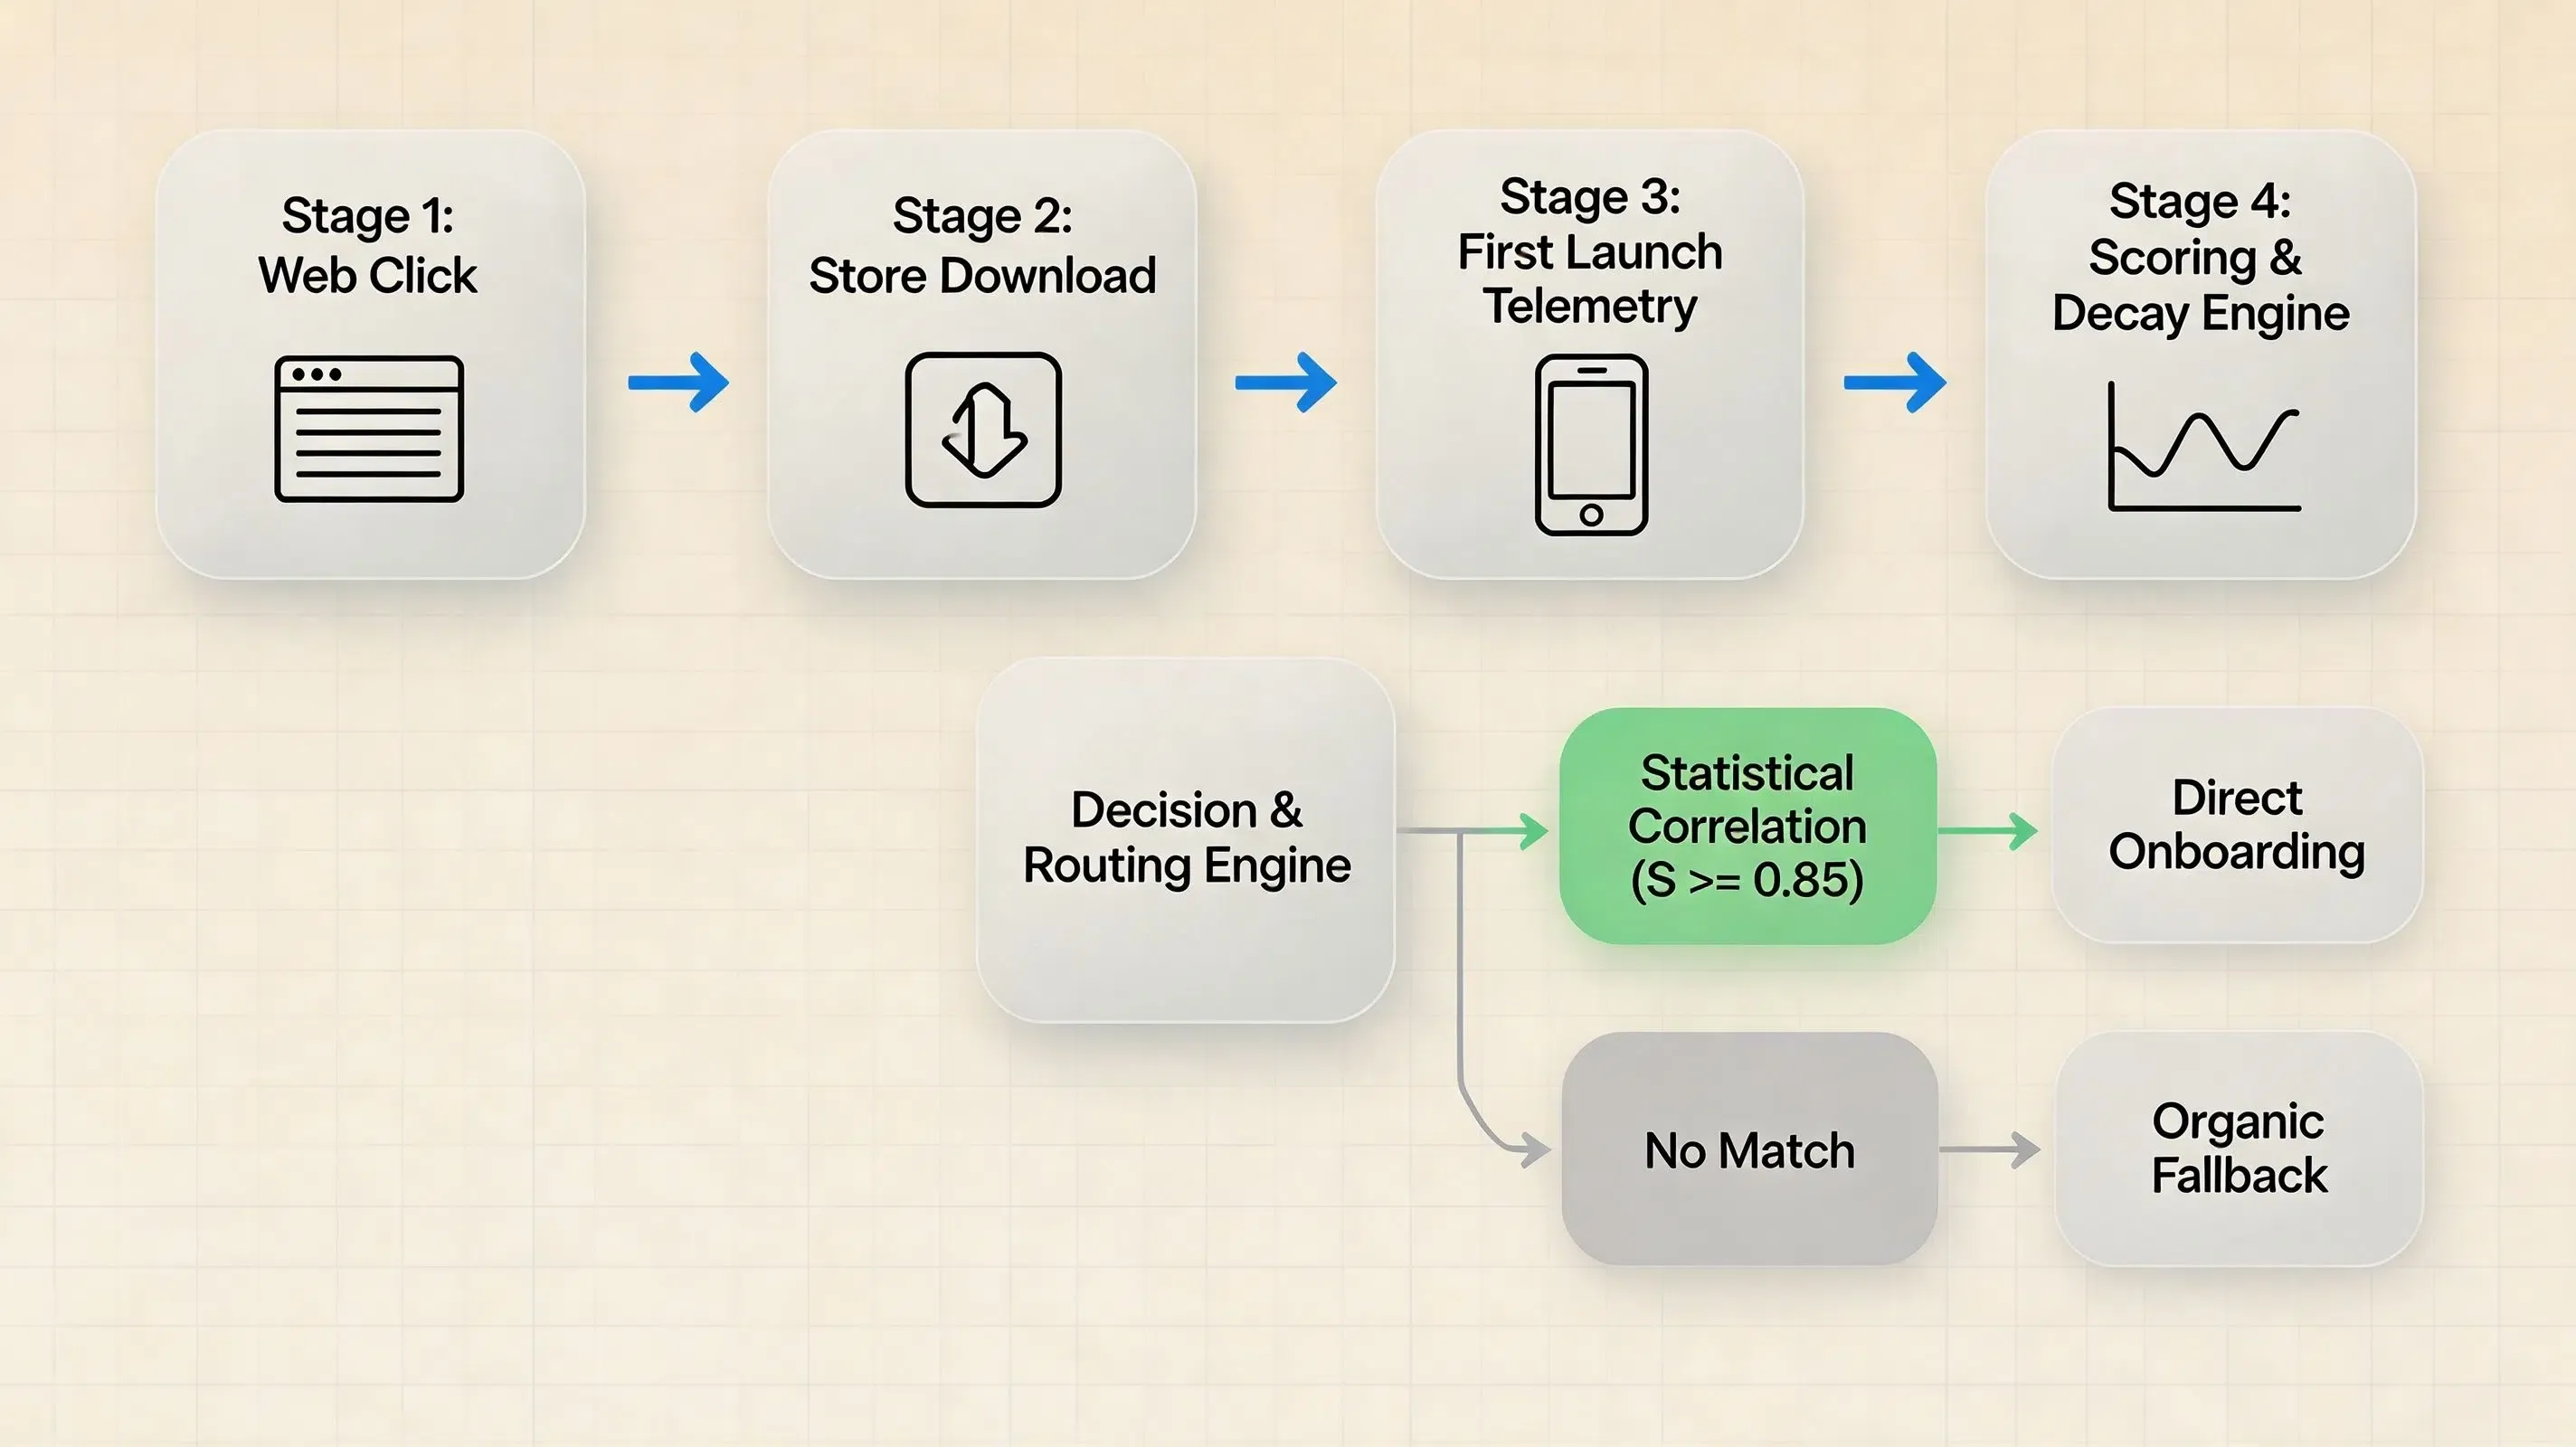
ไปป์ไลน์การกำหนดเส้นทางและระบุแหล่งที่มาตามความน่าจะเป็นระดับโปรดักชัน จะแยกการเก็บข้อมูล Telemetry ชั่วคราวออกจากพื้นที่จัดเก็บข้อมูลระบุตัวตนแบบถาวรอย่างสิ้นเชิง:
[User Web Click] ──> [First-Party Routing / Ephemeral Context Logger]
                                  │
                                  ▼
[Store Redirection] ──> [App Store / Google Play] ──> [App Install]
                                                          │
                                                          ▼
[First App Launch] ──> [SDK Initialization Telemetry (Local Context)]
                                  │
                                  ▼
[Backend Processing] ──> [Entropy Weighting & Decay Scoring Pipeline]
                                  │
                                  ▼
[Decision Engine] ──> [Aggregate Campaign Reporting / Direct Onboarding]
Probabilistic Attribution คืออะไร และทำงานอย่างไรโดยไม่ต้องใช้ตัวระบุอุปกรณ์
การเปลี่ยนผ่านเชิงโครงสร้างจากการระบุตัวตนแบบ Deterministic สู่การอนุมานทางสถิติ
การระบุแหล่งที่มาแบบ Deterministic จำเป็นต้องมีตัวระบุเฉพาะที่เหมือนกันทุกประการที่ปลายทั้งสองด้านของ Conversion Funnel (เช่น การจับคู่ IDFA จากการคลิกโฆษณากับ IDFA ภายในแอป) เมื่อกรอบความเป็นส่วนตัวของแพลตฟอร์ม เช่น Apple App Tracking Transparency (ATT) จำกัดการเข้าถึงตัวระบุเหล่านี้ การเชื่อมโยงข้อมูลแบบ Deterministic จึงไม่สามารถทำได้สำหรับผู้ใช้ที่ไม่อนุญาตให้ติดตาม
Probabilistic attribution จึงเข้ามาแทนที่การค้นหาตัวระบุที่ตรงกันด้วยการอนุมานทางสถิติ เมื่อผู้ใช้คลิกลิงก์แคมเปญบนหน้าเว็บ เซิร์ฟเวอร์ Attribution จะบันทึกเรคอร์ดการมีส่วนร่วมที่มีข้อมูล Telemetry ของบริบท และเมื่อเกิดการติดตั้งขึ้น SDK ฝั่งไคลเอ็นต์จะส่งบริบทการเปิดใช้งานครั้งแรกกลับมา เอนจิน Attribution จะประเมินว่าเหตุการณ์ที่สังเกตพบนั้นมีความสอดคล้องทางสถิติกับเส้นทางการมีส่วนร่วมทางการตลาดเดียวกันหรือไม่ โดยแนวทางทางสถิตินี้จะไม่มีการระบุตัวตนผู้ใช้ที่เจาะจงแต่อย่างใด
เวกเตอร์ข้อมูลนำเข้าหลักในการจับคู่เซสชันชั่วคราว
เอนจิน Probabilistic attribution จะประเมินเวกเตอร์ Metadata แบบไม่ถาวรซึ่งประกอบด้วยสัญญาณบริบทหลายรายการ:
-
Network Context: สัญญาณบริบทจากเครือข่ายที่ประมวลผลในรูปแบบรวม (Aggregated) หรือแบบคร่าวๆ ภายใต้ข้อกำหนดด้านความเป็นส่วนตัวและนโยบายแพลตฟอร์มที่เกี่ยวข้อง
-
Device Environment Properties: คุณลักษณะทั่วไปของสภาพแวดล้อมแอปพลิเคชันและเบราว์เซอร์ ซึ่งใช้สำหรับการวิเคราะห์ความเข้ากันได้ของเซสชันเท่านั้น
-
Locale and Configuration: การตั้งค่าภาษาของอุปกรณ์, ภูมิภาคท้องถิ่น และ Timezone Offset ที่ใช้งานอยู่
-
Temporal Proximity: การประทับเวลาของเหตุการณ์ที่บันทึกไว้ภายใน Attribution Window ที่จำกัด โดยวัดระยะเวลาที่ผ่านไประหว่างเหตุการณ์คลิก (
) และการเปิดแอปครั้งแรก ( )
Lookback Windows และการลดทอนตามเวลา (Temporal Decay) ในเอนจินความน่าจะเป็น
เนื่องจากสัญญาณบริบทแต่ละรายการ (เช่น คุณลักษณะเบราว์เซอร์ทั่วไป หรือสภาพแวดล้อมเครือข่ายแบบคร่าวๆ) อาจถูกแชร์ใช้งานร่วมกันในอุปกรณ์หลายพันเครื่อง โมเดลความน่าจะเป็นจึงต้องกำหนด Lookback Window ที่สั้นและรัดกุม ขณะที่ระบบ Deterministic แบบเดิมอาจใช้ช่วงเวลา 7 ถึง 30 วัน แต่การจับคู่แบบ Probabilistic จะจำกัดอยู่เพียงช่วงเวลาสั้นๆ (มักอยู่ที่ 1 ถึง 24 ชั่วโมง) หากเกินกว่าช่วงเวลานี้ เอนโทรปี (Entropy) ทางสถิติของสภาพแวดล้อมเครือข่ายที่แชร์ร่วมกันจะเสื่อมลงอย่างรวดเร็ว ส่งผลให้อัตราการจับคู่ผิดพลาด (False-positive Collisions) เพิ่มสูงขึ้น
การประเมินโมเดลการระบุแหล่งที่มาทางสถิติ
ประสิทธิภาพของโมเดล Probabilistic attribution และความน่าเชื่อถือของความมั่นใจจะมีความยืดหยุ่นตามลักษณะของทราฟฟิก สัญญาณที่มีอยู่ และข้อจำกัดในการปฏิบัติงาน:
-
ความหนาแน่นของทราฟฟิกและขนาด Subnet: ในเครือข่ายระดับภูมิภาคที่มีความหนาแน่นต่ำ การปรับเทียบความมั่นใจของโมเดลจะมีความแม่นยำทางสถิติสูงกว่า ส่วนในสภาพแวดล้อมองค์กรขนาดใหญ่ที่มีผู้ใช้จำนวนมากแชร์ Network Gateway เดียวกัน ความมั่นใจจะลดลงเว้นแต่จะจำกัดด้วยกรอบเวลาที่สั้นและเข้มงวด
-
ระยะเวลาที่ผ่านไป (Elapsed Time Delta): ความน่าเชื่อถือของโมเดลจะสูงสุดเมื่อเปิดแอปภายในเวลาไม่กี่นาทีหลังจากการคลิกบนเว็บ และจะลดลงแบบทวีคูณเมื่อเวลาผ่านไป
-
ความแม่นยำระดับภาพรวม (Aggregate) เทียบกับระดับบุคคล: Probabilistic attribution สามารถให้ข้อมูลประมาณการเชิงทิศทางสำหรับการวิเคราะห์แคมเปญเมื่อนำไปใช้อย่างถูกต้องตามข้อกำหนดความเป็นส่วนตัวและการตรวจสอบทางสถิติ แต่ไม่สามารถให้ความแน่นอนในระดับรายบุคคลได้
สำหรับทีม Growth และการตลาด:
-
สิ่งที่ตอบได้: “แคมเปญการตลาดหรือช่องทางใดมีส่วนสนับสนุนทางสถิติต่อปริมาณการติดตั้งนี้?”
-
สิ่งที่ไม่สามารถตอบได้: “ผู้ใช้รายบุคคลที่เจาะจงคนใดเป็นผู้คลิกโฆษณานี้?”
สิ่งที่ Probabilistic Attribution ไม่สามารถทำได้
เพื่อสร้างความเข้าใจที่ถูกต้องในเชิงวิศวกรรม สถาปัตยกรรมระบบต้องระบุขีดจำกัดทางเทคนิคของโมเดลทางสถิติไว้อย่างชัดเจน:
-
ไม่สามารถคืนความแม่นยำระดับ IDFA ได้: การสร้างโมเดลความน่าจะเป็นไม่ได้จำลองการติดตามระดับผู้ใช้แบบ Binary ที่แน่นอน
-
ไม่สามารถแทนที่ Platform Postbacks ได้: การประมาณการทางสถิติไม่สามารถใช้แทน Attribution Postbacks ที่ลงนามทางเข้ารหัสลับ (Cryptographically Signed) จาก Apple AdAttributionKit หรือ SKAdNetwork ได้
-
ไม่สามารถสร้างตัวตนข้ามแอป (Cross-App Identity) ได้: โมเดลต้องไม่สร้างโปรไฟล์ข้ามแอปหรือกราฟผู้ใช้แบบถาวรโดยไม่ได้รับความยินยอมผ่าน ATT
-
ไม่สามารถรับประกัน Conversion ได้ทุกกรณี: ในสภาพแวดล้อมที่บริบทเครือข่ายเปลี่ยนไป (เช่น สลับจากเน็ตมือถือเป็น Wi-Fi) ความมั่นใจของความน่าจะเป็นจะลดลงเหลือศูนย์โดยอัตโนมัติ ซึ่งต้องมีระบบรองรับการทำงานอย่างเหมาะสม (Graceful Degradation)
รากฐานทางคณิตศาสตร์ของโมเดล Probabilistic Attribution
โมเดลการให้คะแนนความน่าจะเป็นและการตีความแบบเบย์เซียน (Bayesian Interpretation)
Probabilistic attribution คำนวณความน่าจะเป็นภายหลัง (Posterior Probability)
โดยที่:
-
แสดงถึงเวกเตอร์ความแตกต่างระหว่างข้อมูล Telemetry ของการคลิกและการเปิดแอป -
คือความเป็นไปได้ที่จะสังเกตพบเวกเตอร์ สำหรับเส้นทางการแปลงที่เป็นจริง -
แสดงถึงความน่าจะเป็นก่อนหน้า (Prior Probability) ว่าคู่ของการคลิกและการติดตั้งที่สังเกตพบเป็นการแปลงที่แท้จริง ก่อนที่จะมีการประเมินหลักฐานเชิงบริบท -
คือความน่าจะเป็นส่วนขอบ (Marginal Probability) ของการสังเกตพบเวกเตอร์ จากผู้ใช้ที่ใช้งานอยู่ทั้งหมดในกลุ่มเครือข่ายนั้น
ระบบการระบุแหล่งที่มาในระดับโปรดักชันอาจนำแนวคิดนี้ไปปรับใช้ผ่านโมเดลเบย์เซียน, ตัวจำแนกประเภทที่มีการปรับเทียบ (Calibrated Classifiers) หรือไปป์ไลน์การให้คะแนนแบบถ่วงน้ำหนัก โดยการติดตั้งจะถูกเชื่อมโยงกับจุดสัมผัสของแคมเปญก็ต่อเมื่อคะแนนความเชื่อมั่นรวมสูงกว่าเกณฑ์ที่กำหนดไว้ล่วงหน้า (เช่น
ตัวอย่าง Trace จริง: การให้คะแนน Conversion แบบ Web-to-App
เพื่อแสดงให้เห็นว่าโมเดลการให้คะแนนประมวลผลเหตุการณ์ Telemetry ในทางปฏิบัติอย่างไร:
-
เหตุการณ์การคลิก (
): เวลา = 10:00:00 UTC, แพลตฟอร์ม = iOS, เบราว์เซอร์ = Safari, ภาษา = en-US, เครือข่าย = Coarse Regional Gateway -
เหตุการณ์การติดตั้ง (
): เวลา = 10:08:30 UTC ( ), แพลตฟอร์ม = iOS, เบราว์เซอร์ = Safari, ภาษา = en-US, เครือข่าย = Coarse Regional Gateway
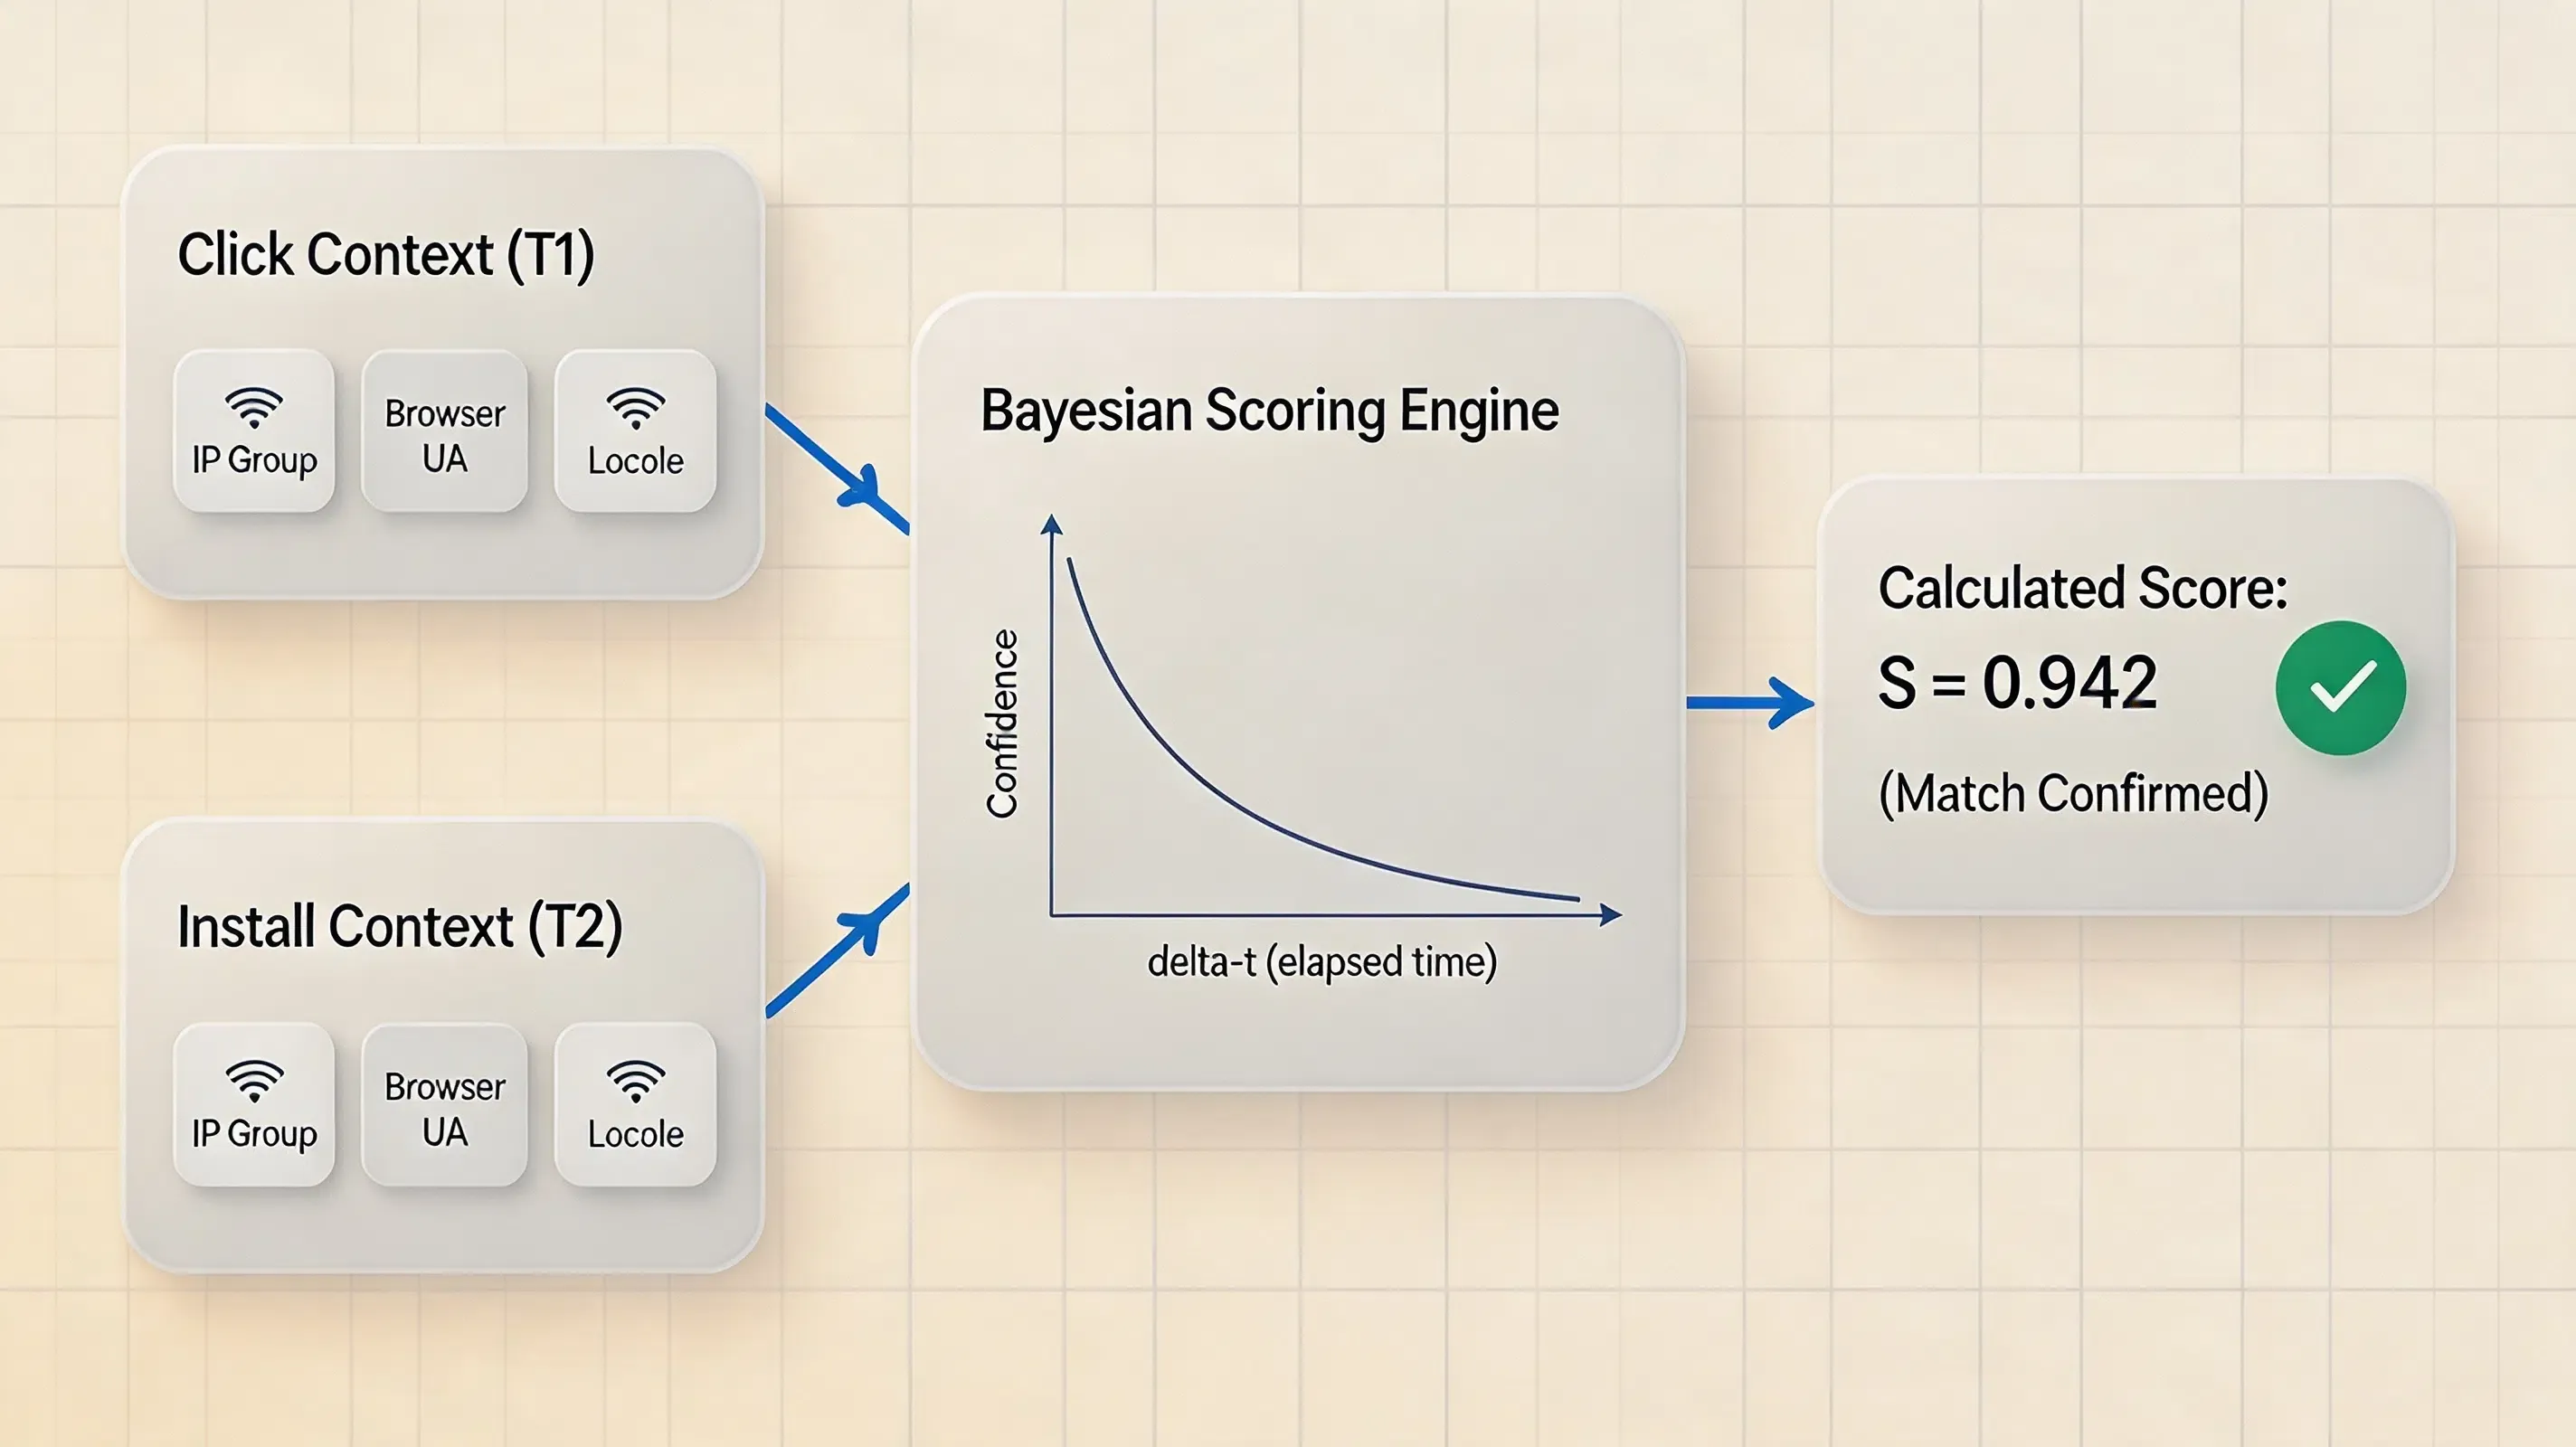
เนื่องจากช่วงเวลาใกล้เคียงกันมาก (
ฟังก์ชันความคล้ายคลึงของเวกเตอร์และการปรับเทียบเมทริกซ์เวลา
ในการประเมินความคล้ายคลึงของสภาพแวดล้อม เอนจินจะคำนวณเมทริกซ์ระยะทางแบบ Normalized และแปลงเป็นความเชื่อมั่นทางสถิติ:
-
Continuous Temporal Metrics: ระยะห่างของเวลา
จะเพิ่มขึ้นตามเวลาที่ผ่านไป โดยมีขอบเขตระหว่าง 0 ถึง 1: จะลดทอนลงเมื่อระยะห่างเพิ่มขึ้น: คือค่าคงที่การลดทอนครึ่งชีวิต (Half-life Decay Constant) ของช่องทางแคมเปญนั้นๆ -
Categorical Features (ความสามารถของเบราว์เซอร์, การตั้งค่าภาษา): ประเมินโดยใช้ Weighted Jaccard Similarity จากชุดแอตทริบิวต์ที่ไม่ต่อเนื่อง
และ :
[Web Ad Click: Context Payload (T1)] ──> [Transient Cache: Coarse Net + UA + Time]
                   │                                      │
                   ▼                                      ▼
        [User Redirects to Store]             [Mathematical Scoring Engine]
                   │                          P(Match | x) = f(Δt, Net, Env)
                   ▼                                      │
        [App Launch: SDK Telemetry (T2)] ──>  [Correlation Threshold Verification]
                   │                                      │
                   ▼                                      ▼
     [Statistical Correlation Estimated] <──> [Statistical Confidence Score ≥ 0.85]
การถ่วงน้ำหนักคุณลักษณะและพลังในการจำแนก (Discriminatory Power)
สัญญาณบริบทไม่ได้มีพลังในการจำแนกเท่ากันทั้งหมด ในเครือข่ายองค์กรที่มีผู้ใช้หนาแน่นหรือ Public Wi-Fi สัญญาณเครือข่ายแบบดิบจะมีความเป็นเอกลักษณ์ต่ำ คุณลักษณะต่างๆ จึงอาจได้รับการถ่วงน้ำหนักทางสถิติที่แตกต่างกันสำหรับการปรับเทียบโมเดลในภาพรวม โดยหลีกเลี่ยงการระบุตัวตนของอุปกรณ์แต่ละเครื่องอย่างเด็ดขาด
แอตทริบิวต์ของอุปกรณ์แต่ละเครื่องควรอยู่ในระดับคร่าวๆ (Coarse-grained) และต้องไม่นำมารวมกันเพื่อสร้างตัวระบุระดับอุปกรณ์แบบถาวร
เอนโทรปีของสัญญาณและการลดทอนตามเวลากำหนดความมั่นใจในการระบุแหล่งที่มาอย่างไร
ฟังก์ชันการลดทอนแบบทวีคูณ (Exponential Decay) ของระยะเวลาตั้งแต่คลิกจนถึงติดตั้ง
ความมั่นใจในการระบุแหล่งที่มาจะลดลงแบบทวีคูณเมื่อเวลาผ่านไประหว่างการคลิกและการติดตั้ง ตัวคูณความมั่นใจตามเวลา
โดยที่:
-
คือตัวคูณความเชื่อมั่นเริ่มต้นพื้นฐาน ( ) -
คือระยะเวลาที่ผ่านไป -
คือพารามิเตอร์ครึ่งชีวิตเฉพาะของแคมเปญ (เช่น สำหรับโฆษณาบนเว็บโดยตรง)
หากผู้ใช้ติดตั้งแอปภายใน 15 นาทีหลังจากคลิก
การจัดการกับ Dynamic IP และ Carrier-Grade NAT
ผู้ให้บริการเครือข่ายมือถือใช้ Carrier-Grade NAT (CGNAT) ในการกำหนดเส้นทางอุปกรณ์มือถือหลายหมื่นเครื่องผ่าน Public IPv4 Gateway ร่วมกัน ภายใต้โครงสร้าง CGNAT อุปกรณ์สองเครื่องที่ไม่มีความเกี่ยวข้องกันเลยในเขตเมืองเดียวกัน อาจแชร์หมายเลข IP สาธารณะเดียวกันได้
เอนจิน Probabilistic attribution รับมือกับปัญหา CGNAT Pooling ดังนี้:
-
การประมวลผลสัญญาณแบบคร่าวๆ: ใช้บริบทจากเครือข่ายเป็นเพียงสัญญาณสภาพแวดล้อมระดับกว้าง เช่น การจัดกลุ่มตามภูมิภาค แทนที่จะใช้เป็นคีย์หลักในการจับคู่ตัวตน
-
การตรวจสอบความถูกต้องร่วมกันหลายแอตทริบิวต์ (Multi-Attribute Cross-Validation): กำหนดให้ต้องมีบริบทแอปพลิเคชันที่สอดคล้องกัน สัญญาณความเข้ากันได้ของเบราว์เซอร์ และ Header ภาษา เพื่อตรวจสอบความสัมพันธ์
-
การควบคุมปริมาณทราฟฟิก (Traffic Volume Throttling): ตรวจสอบอัตราส่วนคลิกต่อการติดตั้งต่อ IP Pool เพื่อตรวจจับและตัดทราฟฟิกที่ผิดปกติจากเครือข่าย Proxy
-
ข้อจำกัดด้านวัตถุประสงค์และระยะเวลาจัดเก็บ: สัญญาณที่ได้จากเครือข่ายควรได้รับการประเมินตามวัตถุประสงค์และระยะเวลาที่ระบุไว้เท่านั้น และต้องไม่นำไปใช้ในการระบุตัวตนข้ามบริบทแบบถาวร
นักพัฒนาและสถาปนิกข้อมูลสามารถศึกษา เอกสารประกอบเกี่ยวกับโมเดล Attribution สำหรับข้อกำหนดทางเทคนิคเกี่ยวกับการจัดการเพย์โหลดของเซสชัน
สกีมา JSON ด้านล่างแสดงเพย์โหลด Telemetry แบบมีโครงสร้างที่ใช้โดยเอนจินการให้คะแนนการระบุแหล่งที่มาทางสถิติ:
{
“event_type”: “attribution_scoring_request”,
“click_context”: {
“event_reference”: “ephemeral_click_event_ref”,
“timestamp_utc”: “2026-08-17T07:15:00Z”,
“ttl_seconds”: 86400,
“network_context”: {
“region_group”: “us-west”
},
“environment_metadata”: {
“platform_family”: “mobile_os”,
“browser_family”: “mobile_browser”,
“locale_group”: “en-region”
},
“campaign_metadata”: {
“channel_code”: “web_display_01”,
“campaign_id”: “cmp_fall_launch”,
“custom_token”: “example_referral_token”
}
},
“install_context”: {
“event_reference”: “ephemeral_launch_event_ref”,
“timestamp_utc”: “2026-08-17T07:22:30Z”,
“network_context”: {
“region_group”: “us-west”
},
“environment_metadata”: {
“platform_family”: “mobile_os”,
“browser_family”: “mobile_browser”,
“locale_group”: “en-region”
}
},
“scoring_parameters”: {
“elapsed_time_seconds”: 450,
“temporal_half_life_seconds”: 7200,
“calculated_confidence_score”: 0.942,
“confidence_threshold”: 0.85,
“match_disposition”: “STATISTICAL_CORRELATION_ESTIMATED”
}
}
Probabilistic Attribution เทียบกับ Fingerprinting: ความแตกต่างที่สำคัญ
การเข้าใจขอบเขตพื้นฐานที่แยกโมเดลสถิติที่สอดคล้องกับข้อกำหนด ออกจากการทำ Fingerprinting อุปกรณ์ที่ถูกสั่งห้าม ถือเป็นสิ่งจำเป็นสำหรับธรรมาภิบาลทางวิศวกรรม:
| มิติทางสถาปัตยกรรม | Probabilistic Attribution ที่สอดคล้องกับนโยบาย | Persistent Device Fingerprinting |
|---|---|---|
| วัตถุประสงค์หลัก | การวัดผลการดำเนินงานของแคมเปญแบบชั่วคราว | การระบุตัวตนผู้ใช้ข้ามแอปพลิเคชันในระยะยาว |
| การเก็บรักษาข้อมูล | กำหนด Time-to-Live ที่เข้มงวด ( |
จัดเก็บประวัติอย่างถาวรต่อเนื่อง |
| Identity Graphs | ไม่มี (ปราศจากกราฟระบุตัวตนข้ามแอป) | มี (สร้างโปรไฟล์อุปกรณ์ที่เชื่อมโยงหลายแอป) |
| ความละเอียดของสัญญาณ | บริบทสภาพแวดล้อมระดับกว้างแบบรวม | ลายเซ็นฮาร์ดแวร์/เบราว์เซอร์ที่มีค่า Entropy สูง |
| ผลกระทบต่อความสอดคล้องกับ ATT | ขึ้นอยู่กับวัตถุประสงค์ การแชร์ข้อมูล และนโยบาย | โดยทั่วไปถือเป็น Tracking ที่ถูกสั่งห้าม |
ความแตกต่างทางเทคนิคระหว่าง Contextual Session Matching และ Device Fingerprinting
การกำหนดขอบเขตด้านกฎระเบียบและสถาปัตยกรรมภายใต้ Apple ATT
มีความแตกต่างสำคัญทางเทคนิคและการปฏิบัติตามข้อกำหนด ระหว่างการจับคู่บริบทชั่วคราวและการทำ Fingerprinting อุปกรณ์แบบถาวร:
-
Persistent Device Fingerprinting (ข้อห้าม): แนวปฏิบัติในการดึงการกำหนดค่าฮาร์ดแวร์ ลายเซ็น Audio Stack สถานะแบตเตอรี่ หรือรายการฟอนต์ เพื่อสร้างค่าแฮชอุปกรณ์ถาวรที่มีเอกลักษณ์ โดยมีเจตนาเพื่อติดตามผู้ใช้ที่เจาะจงข้ามแอปพลิเคชันและเว็บไซต์ต่างๆ เมื่อเวลาผ่านไปโดยไม่ได้รับความยินยอมจากผู้ใช้
-
Contextual Session Matching: การเชื่อมโยงชั่วคราวของบริบทเซสชันที่ไม่เจาะจงตัวตน ซึ่งเกี่ยวข้องกับขั้นตอนการแปลงเพียงครั้งเดียวที่เริ่มต้นจากการมีส่วนร่วมทางการตลาด (เช่น การคลิกลิงก์แล้วดาวน์โหลดแอปทันที) การปรับใช้ที่ถูกต้องควรจำกัดขอบเขตของข้อมูลไว้เฉพาะขั้นตอนการแปลงนั้นๆ บังคับใช้ระยะเวลาจัดเก็บที่จำกัด และป้องกันการนำไปใช้ซ้ำเพื่อการติดตามที่ไม่เกี่ยวข้อง ความสอดคล้องกับนโยบายจะขึ้นอยู่กับรายละเอียดการใช้งาน รวมถึงการจัดการข้อมูล การจำกัดวัตถุประสงค์ ความคาดหวังของผู้ใช้ และสัญญาณนั้นถูกนำไปใช้เพื่อติดตามข้ามแอปหรือบริการหรือไม่
ตาม เอกสาร User Privacy and Data Use ของ Apple การนำข้อมูลจากอุปกรณ์มาประมวลผลเพื่อระบุตัวตนอุปกรณ์ข้ามแอปของบุคคลที่สามถือเป็น Tracking ซึ่งต้องได้รับการอนุญาตผ่าน ATT อย่างชัดเจน ภายใต้กรอบ ATT ของ Apple การไม่มีตัวระบุแบบถาวรเพียงอย่างเดียวไม่ได้หมายความว่าสอดคล้องกับนโยบาย สัญญาณที่ไม่ถาวรอาจยังคงถือเป็นการติดตามได้หากนำมารวมกันเพื่อระบุตัวตนหรือเชื่อมโยงผู้ใช้หรืออุปกรณ์ข้ามแอปหรือบริการ วัตถุประสงค์ ผู้รับข้อมูล และรูปแบบการใช้สัญญาณที่เก็บรวบรวมยังคงเป็นปัจจัยสำคัญ กลไกทางเทคนิคเดียวกันอาจมีผลกระทบด้านความเป็นส่วนตัวที่แตกต่างกันไปขึ้นอยู่กับวัตถุประสงค์ การเก็บรักษาข้อมูล การเปิดเผยข้อมูล และความคาดหวังของผู้ใช้
Probabilistic attribution เป็นเทคนิคการวัดผล ไม่ใช่สิ่งที่จะนำมาใช้แทนกลไกการขอความยินยอมจากผู้ใช้หรือ API การระบุแหล่งที่มาที่แพลตฟอร์มจัดเตรียมไว้
การลดปริมาณข้อมูลให้น้อยที่สุด (Data Minimization) และวิศวกรรมความเป็นส่วนตัว
เพื่อให้สอดคล้องกับนโยบายความเป็นส่วนตัวของแพลตฟอร์มและมาตรฐานการคุ้มครองข้อมูล:
-
ปราศจาก Identity Graphs แบบถาวร: เวกเตอร์บริบทแบบดิบต้องไม่ถูกนำไปต่อท้ายโปรไฟล์ประวัติผู้ใช้หรือกราฟตัวตนข้ามแอปโดยเด็ดขาด
-
การล้างข้อมูลอัตโนมัติตาม TTL: เลเยอร์ Caching ต้องบังคับใช้นโยบายการหมดอายุอัตโนมัติ (Time-to-Live
) เรคอร์ดการคลิกที่ไม่สามารถจับคู่ได้ต้องถูกลบหรือหมดอายุตามนโยบายการเก็บรักษาที่กำหนดไว้ -
การลดทอนสัญญาณเครือข่าย: สัญญาณจากเครือข่ายควรได้รับการย่อ ตัดทอน หรือรวมกลุ่มตามวัตถุประสงค์ที่กำหนด การแฮชเพียงอย่างเดียวไม่ได้ทำให้ตัวระบุกลายเป็นนิรนาม เนื่องจากพื้นที่ค้นหา (Search Space) ของที่อยู่ IP มีจำกัด
สิ่งที่ ID-Free Attribution ไม่ได้หมายถึง
ID-free attribution ไม่ได้หมายถึงการวิเคราะห์ข้อมูลที่ปราศจากตัวระบุอย่างสิ้นเชิง แอปพลิเคชันยังคงสามารถประมวลผล User Account ID ภายใน บัญชีเข้าสู่ระบบที่ยืนยันตัวตนแล้ว หรือ First-party Session Token ที่จำเป็นต่อการทำงานหลักของผลิตภัณฑ์ได้ เป้าหมายเชิงสถาปัตยกรรมคือการเลิกพึ่งพาตัวระบุโฆษณาข้ามแอปที่มีข้อจำกัดสำหรับการจับคู่การติดตั้ง มากกว่าการอ้างว่าข้อมูล Telemetry ของแอปพลิเคชันทั้งหมดเป็นข้อมูลนิรนามโดยสมบูรณ์
ข้อจำกัดสำคัญของแพลตฟอร์มในการวัดผลแบบ Probabilistic
ทีมวิศวกรรมที่กำลังประเมินสถาปัตยกรรมความน่าจะเป็นจำเป็นต้องคำนึงถึงข้อจำกัดพื้นฐานของแพลตฟอร์ม:
-
ไม่สามารถเข้าถึง Signed Postbacks ได้: โมเดลความน่าจะเป็นไม่สามารถสร้าง Postback ที่ผ่านการตรวจสอบทางเข้ารหัสลับโดยตรงจากระบบปฏิบัติการมือถือได้ แต่จะเป็นการสร้างค่าประมาณการทางสถิติฝั่งเซิร์ฟเวอร์
-
ไม่มี SKAN Conversion Values: การจับคู่เซสชันทางสถิติไม่สามารถถอดรหัสหรืออ่านค่า Apple SKAdNetwork หรือ AdAttributionKit Conversion Values ที่ฝังอยู่ในธุรกรรมของสโตร์ได้
-
การพรางข้อมูลของ iCloud Private Relay: บนอุปกรณ์ iOS ที่เปิดใช้งาน iCloud Private Relay ทาง Safari จะส่งผ่านทราฟฟิกผ่าน Proxy เข้ารหัสแบบ Dual-hop ซึ่งทำให้ IP ขาออกกลายเป็นโหนด Egress ของ Proxy ประจำภูมิภาค และลดเอนโทรปีของสัญญาณเครือข่ายลงอย่างมาก
-
การบังคับใช้การปฏิเสธการติดตาม (Opt-Out): ระบบความน่าจะเป็นต้องเคารพการตั้งค่าปฏิเสธของผู้ใช้ และต้องไม่นำไปใช้สร้างตัวตนข้ามแอปสำหรับผู้ใช้ที่ไม่อนุญาตการติดตามผ่าน ATT
Probabilistic Attribution เทียบกับ SKAN และ AdAttributionKit
ทีม Growth ที่ประเมินการวัดผลบน iOS มักเปรียบเทียบโมเดลความน่าจะเป็นกับเฟรมเวิร์กเนทีฟของ Apple (SKAdNetwork และ AdAttributionKit):
| มิติทางสถาปัตยกรรม | Apple AdAttributionKit / SKAN | โมเดลเซสชันแบบ Probabilistic |
|---|---|---|
| ความน่าเชื่อถือของข้อมูล | ลายเซ็นเข้ารหัสแบบ Deterministic ที่ตรวจสอบโดย Apple | การประมาณการความเชื่อมั่นทางสถิติที่คำนวณโดยเซิร์ฟเวอร์ |
| ความหน่วงในการรายงานผล (Latency) | Postback มีความล่าช้า (ควบคุมโดยตัวจับเวลาแบบสุ่ม) | ประมาณการได้เกือบเรียลไทม์เมื่อเปิดแอปครั้งแรก |
| ความละเอียดของ Conversion | Campaign ID แบบรวม และ Conversion Value แบบ Coarse/Fine | พารามิเตอร์ระดับเซสชัน (เช่น Referral Token เฉพาะ) |
| ข้อกำหนดการแจ้งเตือน ATT | ไม่ต้องขออนุญาตผ่าน ATT Prompt | ต้องหลีกเลี่ยงการติดตามข้ามแอปหากไม่ได้รับอนุญาตผ่าน ATT |
| กรณีการใช้งานหลัก | การคำนวณ ROI ของเครือข่ายโฆษณาและการทำ Media Mix Modeling | การคืนค่า Onboarding ของ First-party และการนำทางทันที |
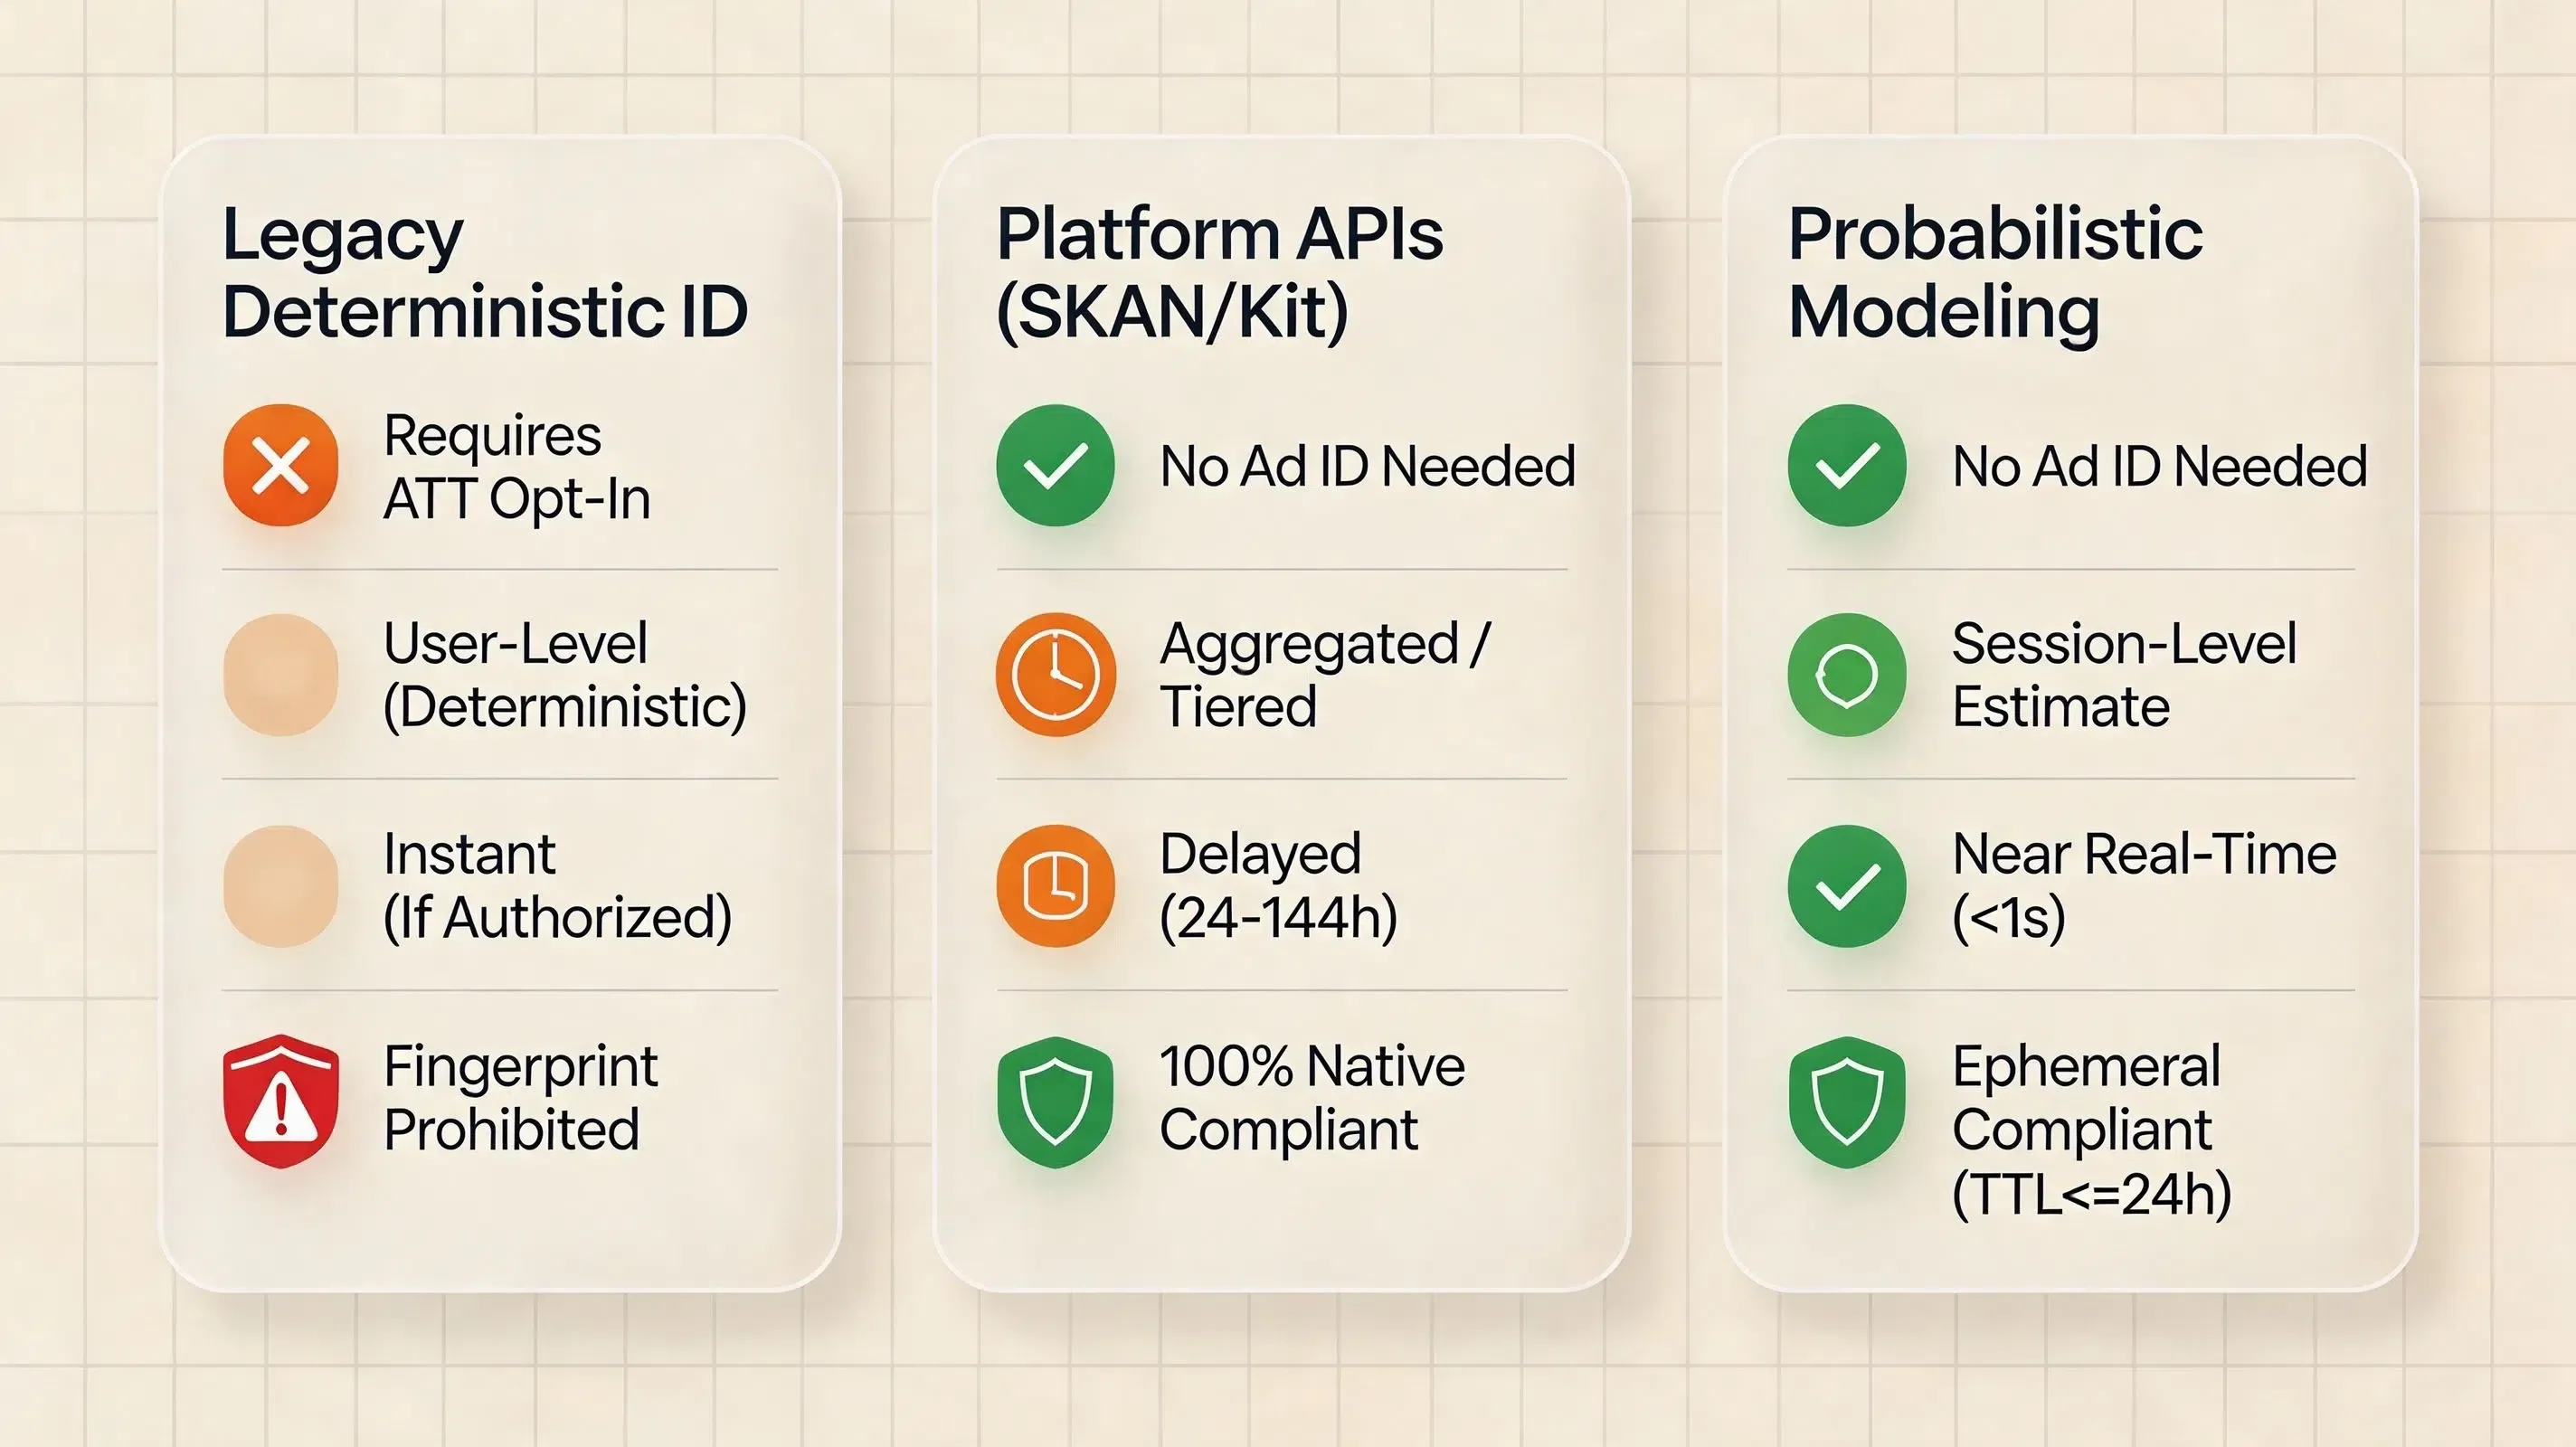
การวิเคราะห์เปรียบเทียบ: Deterministic vs Probabilistic vs Platform Primitives
| เกณฑ์การประเมิน | การจับคู่ Deterministic ID (แบบดั้งเดิม) | Platform Attribution APIs (AdAttributionKit / SKAN) | โมเดลเซสชันแบบ Probabilistic |
|---|---|---|---|
| ต้องใช้ตัวระบุถาวรหรือไม่ | ต้องใช้ (GAID / IDFA) | ไม่ต้องใช้ | ไม่ต้องใช้ (ใช้สัญญาณเซสชันชั่วคราว) |
| ความละเอียดของการวัดผล | ระดับผู้ใช้ (User-level) | ระดับกลุ่ม/ภาพรวม (Aggregated / Cohort-level) | การประมาณการความน่าจะเป็นระดับเซสชัน / แคมเปญ |
| ความหน่วงของ Attribution | ทันทีทันใด | ล่าช้า (ตามตัวจับเวลา Postback ของแพลตฟอร์ม) | เกือบเรียลไทม์ (ขึ้นอยู่กับเกณฑ์ความเชื่อมั่น) |
| การคืนค่าบริบท Onboarding | ต้องค้นหาข้อมูลรอบสอง | ไม่รองรับ (สำหรับการวัดผลโฆษณาเท่านั้น) | รองรับ (การส่งต่อพารามิเตอร์ First-party) |
| การกำกับดูแลตามนโยบายแพลตฟอร์ม | อยู่ภายใต้ความยินยอมของ ATT / AD_ID | เฟรมเวิร์กระดับเนทีฟของแพลตฟอร์ม | ต้องหลีกเลี่ยงการทำ Fingerprinting ข้ามแอปแบบถาวร |
ทีมพัฒนาที่กำลังประเมิน SDK การวัดผลสามารถ ดาวน์โหลด Mobile Attribution SDK เพื่อศึกษาข้อกำหนดในการผสานรวมฝั่งไคลเอ็นต์
ทีมวิศวกรรมควรเริ่มใช้โมเดล Probabilistic Attribution เมื่อใด
เงื่อนไขที่เหมาะสมสำหรับการเชื่อมโยงเซสชันทางสถิติ
การเชื่อมโยงเซสชันตามความน่าจะเป็นจะมอบคุณค่าทางวิศวกรรมที่ใช้ได้จริงภายใต้เงื่อนไขการดำเนินงานที่เจาะจง:
-
การประเมินแคมเปญบนเว็บช่วงต้น Funnel (Top-of-Funnel): การประมาณการผลลัพธ์ Conversion รวมของโฆษณาบนเว็บมือถือและ Landing Page ของ Influencer ในกรณีที่ไม่มีเฟรมเวิร์ก Attribution เนทีฟของแพลตฟอร์ม
-
First-Party Onboarding และ Deep Linking: การคืนค่าพารามิเตอร์การกำหนดเส้นทางของแคมเปญ รหัสเชิญ และสถานะ Onboarding ที่กำหนดเองสำหรับ Conversion Funnel แบบ Web-to-App ที่ผู้ใช้เป็นผู้เริ่มใช้งาน
-
การเปรียบเทียบตรวจสอบรายงานภาพรวมของแพลตฟอร์ม: การให้ข้อมูล Telemetry เชิงทิศทางแบบเรียลไทม์ เพื่อใช้อ้างอิงเทียบเคียงกับ Postback ภาพรวมของแพลตฟอร์มที่มีความล่าช้า (เช่น Apple AdAttributionKit)
เงื่อนไขที่ไม่เหมาะสมสำหรับการเชื่อมโยงเซสชันทางสถิติ
Probabilistic attribution ไม่เหมาะสมและไม่ควรนำไปใช้ในสถานการณ์ต่อไปนี้:
-
การทำโปรไฟล์ผู้ใช้ข้ามแอป: การพยายามติดตามผู้ใช้ข้ามแอปพลิเคชันของบุคคลที่สามโดยไม่ได้รับความยินยอมอย่างชัดเจนจากผู้ใช้
-
การยืนยันสิทธิ์ทางการเงินที่มีความปลอดภัยสูง: เวิร์กโฟลว์ที่ต้องการความแน่นอนแบบ Deterministic แบบ Binary เด็ดขาด (เช่น การประมวลผลการชำระเงินหรือการยืนยันสิทธิ์ของธนาคาร)
-
Conversion Funnel ปริมาณน้อยและทิ้งช่วงนาน: แคมเปญที่คาดว่าระยะเวลาระหว่างการคลิกและการติดตั้งจะยาวนานเกินกว่า 24 ถึง 48 ชั่วโมง
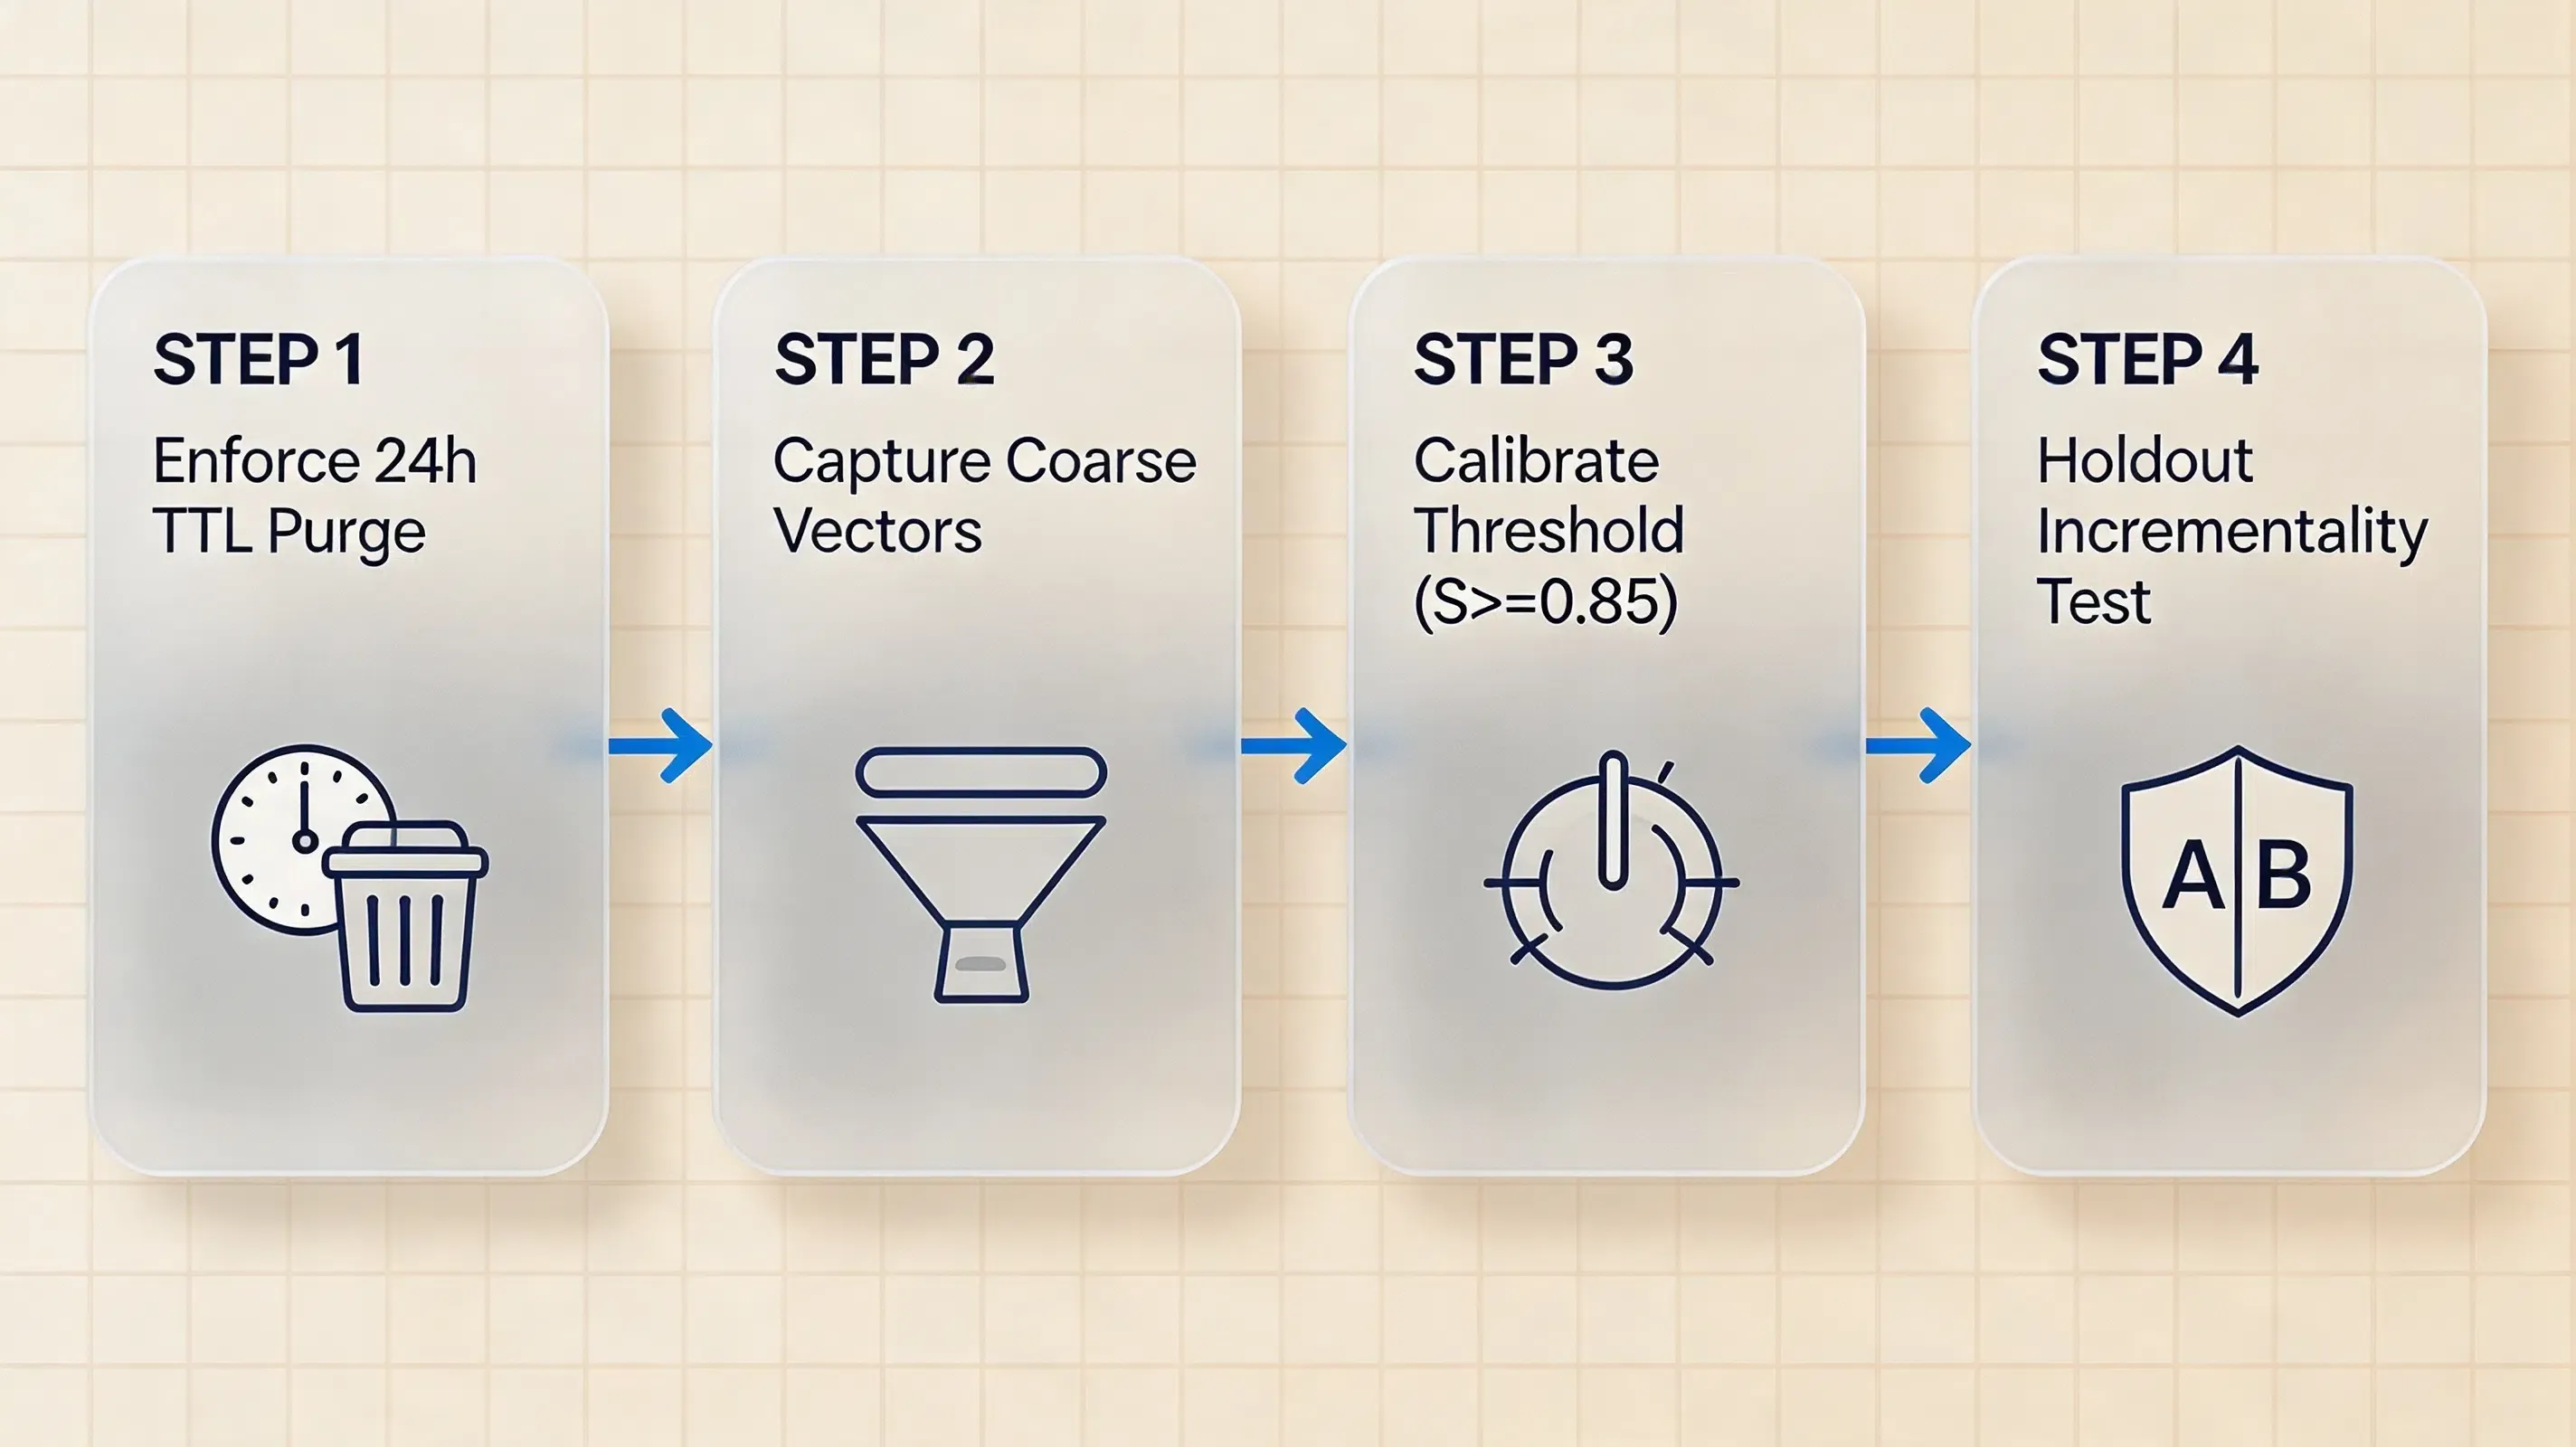
วิธีที่ทีมโปรดักชันใช้ในการตรวจสอบและปรับเทียบโมเดลความน่าจะเป็น
ในสภาพแวดล้อมโปรดักชัน ทีมวิศวกรรมข้อมูลจะประเมินความสมบูรณ์ของโมเดลและ Calibration Curve อย่างต่อเนื่องเพื่อป้องกันปัญหา Data Drift:
-
เส้นโค้งความน่าเชื่อถือของการปรับเทียบ (Calibration Reliability Curves): การพล็อตกราฟกลุ่มความน่าจะเป็นที่คาดการณ์เทียบกับความถี่ของ Conversion จริง เพื่อให้มั่นใจว่าการคาดการณ์
สอดคล้องกับความน่าจะเป็นของ Conversion ที่ 85% จริงในกลุ่มทดสอบ -
การปรับจูนความไว Precision-Recall: การปรับเกณฑ์การจำแนกประเภท (
) เพื่อสร้างสมดุลระหว่างผลบวกลวง (False-positive Misattributions) กับการติดตั้งแบบ Organic ที่ไม่ถูกจัดสรร -
การทดลองส่วนเพิ่มแบบ Holdout (Holdout Incrementality Experiments): การใช้กลุ่มควบคุมโฆษณาบริการสาธารณะ (PSA) หรือ Ghost Ad เพื่อวัดสัญญาณรบกวนพื้นฐานและประเมินผลลัพธ์ส่วนเพิ่มที่แท้จริง (Incremental Lift)
-
การตรวจสอบอัตราส่วนที่ไม่สามารถจับคู่ได้: การติดตามสัดส่วนการเปิดแอปแบบ Organic ที่ไม่ได้รับการระบุแหล่งที่มา เพื่อตรวจสอบว่า Lookback Window มีข้อจำกัดมากเกินไปหรือสภาพแวดล้อมเครือข่ายเกิดการเปลี่ยนแปลงหรือไม่
ข้อพิจารณาด้านการวัดผลในระดับโปรดักชันสำหรับทีมวิศวกรรม
ในสภาพแวดล้อมโปรดักชัน ทีมวิศวกรรมที่นำโมเดลความน่าจะเป็นไปใช้ควรตรวจสอบเมทริกซ์การดำเนินงานหลักอย่างต่อเนื่องเพื่อรักษาความน่าเชื่อถือของข้อมูล:
-
Attribution Confidence Calibration Error: การเปรียบเทียบความน่าจะเป็นของความสัมพันธ์ที่คาดการณ์ไว้กับอัตรา Conversion จริงในกลุ่ม Holdout เพื่อตรวจจับความมั่นใจที่สูงเกินจริงของโมเดลอย่างเป็นระบบ
-
False-Positive Correlation Drift: การตรวจสอบการกระจายตัวของความมั่นใจในการจับคู่อย่างสม่ำเสมอ เพื่อให้แน่ใจว่าอัตรา Conversion พื้นฐานไม่ได้เพิ่มขึ้นอย่างผิดปกติตลอดช่วงเวลาทราฟฟิกหนาแน่น
-
Unmatched Install Ratios: การติดตามปริมาณพื้นฐานของการเปิดแอปแบบ Organic ที่ไม่ได้รับการระบุแหล่งที่มา เพื่อระบุว่า Lookback Window หรือตัวกรองเกณฑ์มีความเข้มงวดเกินไปหรือไม่
-
Organic Install Contamination Ratio: การวัดเปอร์เซ็นต์ของผู้ใช้แบบ Organic ที่ถูกระบุแหล่งที่มาผิดพลาดไปยังแคมเปญที่กำลังทำงานอยู่เนื่องจาก Network Gateway ที่ทับซ้อนกัน
สถานการณ์จำลองในระดับโปรดักชัน: การประเมินพฤติกรรมของสัญญาณ
ลองพิจารณาแอปพลิเคชันอีคอมเมิร์ซบนมือถือที่ใช้งานลิงก์โปรโมชันแบบ Web-to-App ในการตรวจสอบระดับโปรดักชัน:
-
ผู้ใช้ที่ดาวน์โหลดแอปจนเสร็จสิ้นบนเครือข่ายในบ้านเดียวกันภายใน 5 นาที แสดงความมั่นใจในการเชื่อมโยงในระดับสูง และไม่พบการชนกันของข้อมูล (Zero Collision)
-
ผู้ใช้ที่สลับจากการเชื่อมต่อเน็ตมือถือในที่ทำงานไปยัง Wi-Fi ขององค์กร แสดงให้เห็นความคล้ายคลึงของเครือข่ายที่ลดลงตามที่คาดไว้ และระบบจะปรับสถานะเป็น Unattributed โดยอัตโนมัติอย่างราบรื่น เพื่อป้องกันการอ้างสิทธิ์ Conversion ที่ผิดพลาดไปยังแคมเปญที่กำลังดำเนินการอยู่
รายการตรวจสอบการติดตั้งสำหรับระบบ Attribution ที่ใส่ใจความเป็นส่วนตัว
ก่อนเริ่มใช้งานโมเดลการวัดผลตามความน่าจะเป็นหรือตามบริบท ควรตรวจสอบว่าสถาปัตยกรรมทางวิศวกรรมของคุณปฏิบัติตามมาตรฐานความเป็นส่วนตัวอย่างครบถ้วน:
-
กำหนด Retention Windows: บังคับใช้ขีดจำกัด Time-to-Live ที่เข้มงวด (
) สำหรับบริบทเซสชันที่แคชไว้ใน Datastore ฝั่งแบ็กเอนด์ -
ตัดตัวระบุถาวรออกทั้งหมด: ตรวจสอบให้แน่ใจว่าไม่มีการรวมแอตทริบิวต์ฮาร์ดแวร์เพื่อสร้างกราฟอุปกรณ์แบบถาวร
-
แยกการวัดผลออกจากการระบุตัวตน: ปฏิบัติต่อผลลัพธ์ทางสถิติในฐานะสัญญาณเชิงทิศทางในภาพรวม มากกว่าการเป็นตัวตนผู้ใช้ที่ยืนยันแล้ว
-
ประสานงานร่วมกับ Platform APIs: ใช้ Apple AdAttributionKit และ Google Play Install Referrer เป็นพื้นฐานการวัดผลหลักเมื่อทำได้
-
ตรวจสอบการเก็บข้อมูลของ SDK: ทบทวนข้อมูล Telemetry ฝั่งไคลเอ็นต์เพื่อยืนยันว่าการลดปริมาณข้อมูลสอดคล้องกับนโยบายระบบปฏิบัติการ
คำถามทบทวนความเป็นส่วนตัวสำหรับทีมวิศวกรรม
ก่อนการเปิดตัวสู่โปรดักชัน คณะกรรมการตรวจสอบทางเทคนิคควรยืนยันข้อคำถามเหล่านี้:
-
มีสัญญาณบริบทใดที่ถูกเก็บรักษาไว้นานเกินกว่า Attribution Window ที่กำหนดหรือไม่?
-
โมเดลพยายามระบุตัวตนซ้ำของผู้ใช้เดิมข้ามแอปพลิเคชันของบุคคลที่สามที่ไม่เกี่ยวข้องกันหรือไม่?
-
สัญญาณเซสชันถูกจำกัดขอบเขตไว้เฉพาะเวิร์กโฟลว์การแปลงที่เกิดขึ้นทันทีหรือไม่?
คำถามที่พบบ่อย (FAQ)
Probabilistic attribution ได้รับอนุญาตภายใต้กฎ App Tracking Transparency ของ Apple หรือไม่?
Probabilistic attribution สามารถให้ความแม่นยำเทียบเท่าระดับ IDFA ได้หรือไม่?
Probabilistic attribution ยังคงทำงานได้หรือไม่หลังจากการเปลี่ยนแปลงความเป็นส่วนตัวใน iOS 17 และ iOS 18?
Probabilistic attribution จัดการกับการเปลี่ยนเครือข่ายระหว่างการคลิกและการติดตั้งอย่างไร?
Probabilistic attribution สามารถแทนที่เฟรมเวิร์กของแพลตฟอร์มอย่าง AdAttributionKit ได้หรือไม่?
บทสรุปและกรอบการตัดสินใจ
ในทางปฏิบัติ ควรพิจารณาว่า Probabilistic attribution เป็นทางเลือกที่ลงตัวสำหรับการวัดผล: โดยสามารถให้สัญญาณ Conversion เชิงทิศทางและบริบท Onboarding ได้ แต่ไม่สามารถสร้างความแน่นอนเทียบเท่ากับตัวระบุแบบ Deterministic ได้ การประเมินสัญญาณเซสชันชั่วคราวภายในกรอบเวลาที่รัดกุม ช่วยให้ทีมวิศวกรรมสามารถประมาณการประสิทธิภาพของแคมเปญได้โดยไม่ต้องสร้างตัวระบุอุปกรณ์ข้ามแอปแบบถาวร
สถาปัตยกรรมการเติบโตยุคใหม่สร้างความยืดหยุ่นโดยการผสานรวมเครื่องมือวัดผลเนทีฟของแพลตฟอร์ม (เช่น Apple AdAttributionKit และ Google Play Install Referrer) สำหรับการรายงานผลระดับ Macro ควบคู่ไปกับเลเยอร์ First-party Contextual Routing (เช่น OpoInstall โครงสร้างพื้นฐานด้านการกำหนดเส้นทางและระบุแหล่งที่มาบนโมบายล์แบบ First-party) เพื่อการคืนค่า Onboarding ในระดับ Micro
หากต้องการศึกษารูปแบบการนำไปใช้สำหรับการวัดผลและกำหนดเส้นทางบนมือถือที่สอดคล้องกับมาตรฐานความเป็นส่วนตัว โปรดดูที่ เอกสารอ้างอิงการติดตั้ง Mobile Attribution สำหรับนักพัฒนา สามารถศึกษา เอกสารสำหรับนักพัฒนาของ OpoInstall เพื่อดูข้อกำหนดทางเทคนิคและคู่มือการผสานรวม
เนื้อหาที่เกี่ยวข้อง
-
แนวคิด: Probabilistic Modeling, Signal Entropy, Temporal Decay, Contextual Routing, App Tracking Transparency
-
เทคโนโลยี: Bayesian Matching Engines, Apple AdAttributionKit, Google Play Install Referrer API, OpoInstall Mobile SDK
-
มาตรฐาน: W3C Client Hints Specification, IETF RFC 7231 HTTP Semantics, OWASP Mobile Security Guidance
-
APIs: OpoInstall Context API, Apple ATTrackingManager, Google Play Install Referrer API
เอกสารอย่างเป็นทางการ
Share this article