Reddit ปิดกั้นการเข้าชมที่เป็นสแปมวันละ 23 ล้านครั้ง? Reddit ระบุว่าขณะนี้ระบบตรวจจับด้วย LLM สามารถปิดกั้นการเข้าชมที่น่าสงสัยได้ประมาณ 23 ล้านครั้งต่อวัน โดยสแปมเหล่านี้ถูกออกแบบมาเพื่อโน้มน้าวระบบ AI ที่ต้องพึ่งพาเนื้อหาบนเว็บสาธารณะมากขึ้น ในขณะที่บริษัท AI หลายแห่งขออนุญาตนำข้อมูลการสนทนาบน Reddit ไปใช้ฝึกสอนโมเดล การปกป้องความน่าเชื่อถือของเนื้อหาที่ผู้ใช้สร้างขึ้นจึงกลายเป็นภารกิจสำคัญทางธุรกิจ ในอดีตตัวกรองแบบใช้กฎทั่วไปก็เพียงพอต่อการตรวจจับสแปม แต่ปัจจุบันผู้ประสงค์ร้ายได้นำโมเดลขั้นสูงมาใช้สร้างบทสนทนาที่เลียนแบบมนุษย์และสร้างกระแสเทียมในวงกว้าง แพลตฟอร์มต่างๆ จึงต้องหันมามุ่งเน้นการวิเคราะห์พฤติกรรมแบบเรียลไทม์และการประเมินความหมายเชิงบริบทแทน
ไทม์ไลน์และวิวัฒนาการ: วิธีที่ Reddit ปิดกั้นสแปม 23 ล้านครั้งต่อวัน
สรุปภาพรวม
- ชั้นการป้องกันอัตโนมัติของ Reddit สามารถดักจับการเข้าชมที่ไม่สมจริงได้ 23 ล้านครั้ง และโพสต์สแปม 25,000 โพสต์ต่อวัน โดยใช้โมเดลภาษาขนาดใหญ่ที่ทันสมัย
- การเติบโตของข้อตกลงใบอนุญาตข้อมูลเชิงพาณิชย์กับบริษัท AI ขนาดใหญ่ กระตุ้นให้สแปมเมอร์สร้างรีวิวปลอมเพื่อบิดเบือนชุดข้อมูลฝึกสอนโมเดล
- โปรโตคอลการยืนยันตัวตนแบบหลายชั้นประสบความสำเร็จในการลดการมองเห็นสแปมของผู้ใช้งานลง 20% ในช่วงต้นปี 2026 เมื่อเทียบกับไตรมาสก่อนหน้า
สมดุลของการมีส่วนร่วมทางดิจิทัลได้เปลี่ยนแปลงไปเนื่องจากบอทอัตโนมัติสามารถเลียนแบบการปฏิสัมพันธ์ทางสังคมของมนุษย์ได้แนบเนียนขึ้น ในอดีตสแปมเมอร์มุ่งเป้าไปที่แพลตฟอร์มเนื้อหาที่ผู้ใช้สร้างขึ้นเพื่อทำ Affiliate Sales ผ่านการยัดเยียดลิงก์แบบดิบๆ ซึ่งตรวจจับได้ง่ายด้วยรายการคำหลักและบล็อก IP
อย่างไรก็ตาม การผงาดขึ้นของเครื่องมือค้นหาที่ขับเคลื่อนด้วย Generative AI ได้เปลี่ยนแรงจูงใจเบื้องหลังการทำสแปม ในเมื่อแชทบอท AI ต้องฝึกฝนจากฐานข้อมูลสาธารณะขนาดใหญ่ นักการตลาดบุคคลที่สามจึงพยายามบิดเบือนผลลัพธ์ของ AI ด้วยการสร้างรีวิวและคำชมเชิงบวกจำนวนมหาศาล การจำลองบทสนทนาที่เป็นธรรมชาติเหล่านี้มีเป้าหมายเพื่อให้นำคำหลักของแบรนด์ตนไปรวมอยู่ในค่าน้ำหนัก (weights) ของโมเดลในอนาคต เพื่อรับมือกับภัยคุกคามนี้ แพลตฟอร์มจึงได้ติดตั้งระบบการกลั่นกรองขั้นสูงที่ขับเคลื่อนด้วย LLM ตามที่ระบุไว้ใน รายงานเชิงลึกระดับภูมิภาค
เหตุผลเชิงกลยุทธ์ที่ Reddit ปิดกั้นการเข้าชมที่เป็นสแปม 23 ล้านครั้งนั้นเชื่อมโยงโดยตรงกับการสร้างรายได้จากข้อมูลของมนุษย์ เมื่อแพลตฟอร์มเซ็นสัญญามูลค่าหลายล้านดอลลาร์กับนักพัฒนา AI ชั้นนำ การรักษาความถูกต้องของข้อมูลจึงกลายเป็นปัจจัยทางการเงินหลัก ในช่วงเดือนมกราคมถึงมีนาคมปี 2026 แพลตฟอร์มได้ลบการโหวตที่ไม่สมจริงออกเกือบ 2 ล้านรายการต่อวัน เพื่อปกป้อง Feedback Loop ของผู้ใช้งานจากการบิดเบือน ด้วยการบังคับลงชื่อเข้าใช้สำหรับการเข้าถึงไดเรกทอรีบนเดสก์ท็อปและใช้ตัวกรองภาษาแบบเรียลไทม์ ผู้ดูแลระบบจึงสามารถลดผลกระทบจากเนื้อหาที่เป็นอันตรายต่อผู้ใช้งานได้อย่างประสบความสำเร็จ
เจาะลึกกลไกทางเทคนิคเบื้องหลังสถาปัตยกรรมแยกส่วนบอทของ Reddit
ในระดับสถาปัตยกรรม ระบบป้องกันบอททั่วไปมักประสบปัญหาในการระบุแคมเปญการคืบคลาน (Crawling) ที่กระจายตัวและมีความถี่ต่ำ เมื่อสแปมเมอร์ในปัจจุบันใช้เครือข่าย Residential Proxy และ Headless Browser คำขอที่เข้ามาจะดูเหมือนการปฏิสัมพันธ์ของผู้ใช้ทั่วไป ทำให้การกรองรูปแบบเดิมๆ ใช้ไม่ได้ผล
เพื่อแก้ปัญหาคอขวดในชั้นการส่งข้อมูลนี้ สถาปัตยกรรมการป้องกันสมัยใหม่จะประมวลผลสัญญาณความปลอดภัย ณ จังหวะที่สร้างบัญชี โดยเครื่องยนต์อัตโนมัติของแพลตฟอร์มจะวิเคราะห์รูปแบบข้อมูลเมตาและใช้การอนุมานด้วย LLM แบบเรียลไทม์เพื่อระบุการตั้งค่าบอทที่มีการประสานงานกัน ดังที่ระบุไว้ใน ประกาศอย่างเป็นทางการของแพลตฟอร์ม
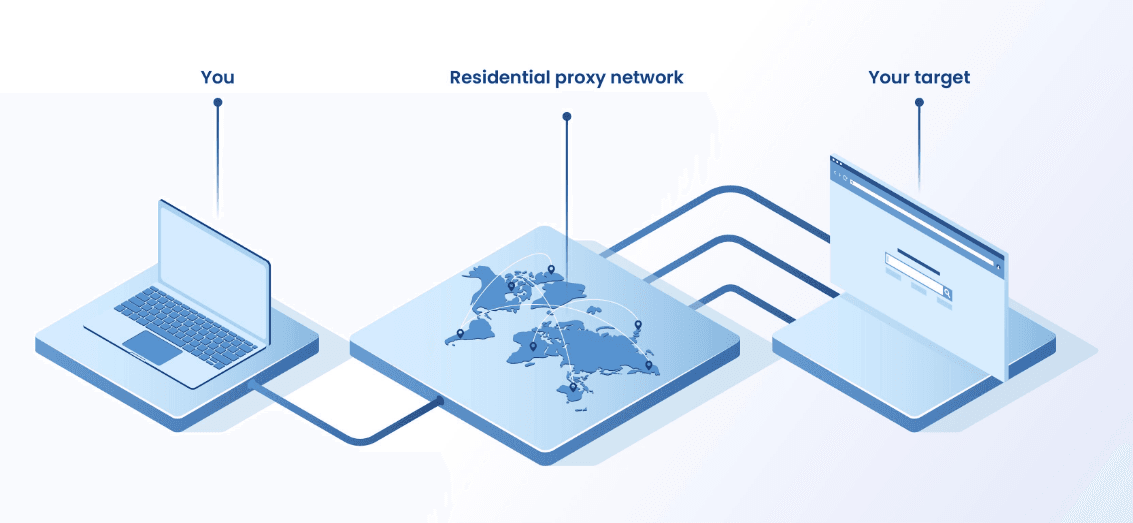

พฤติกรรมที่ไม่สมจริงที่มีการประสานงานนี้แสดงให้เห็นว่าเหตุใด Reddit จึงต้องปิดกั้นสแปม 23 ล้านครั้งทุกวัน เมื่อสคริปต์อัตโนมัติพยายามเข้าถึงฟอรัม ระบบจะคำนวณคะแนนความเสี่ยงแบบเรียลไทม์ หากการเชื่อมต่อมีลักษณะน่าสงสัย แพลตฟอร์มจะบังคับให้ยืนยันความเป็นมนุษย์ เพื่อแยกบอทออกจากระบบ แนวทางหลายชั้นนี้ช่วยปรับประสิทธิภาพการโหลดของเซิร์ฟเวอร์ ป้องกันไม่ให้การรับส่งข้อมูลล่ม และรักษาความปลอดภัยให้กับการมีส่วนร่วมของผู้ใช้งานจริง
[การกรองตาม IP แบบดั้งเดิม]
  บอทอัตโนมัติ ──> Residential Proxy ที่หมุนเวียน ──> ตัวกรองแบบดั้งเดิม ──> อนุญาตให้เข้าถึงตามปกติ (การตรวจจับล้มเหลว)


[การป้องกันหลายชั้นด้วย LLM]
  บอทอัตโนมัติ ──> การวิเคราะห์ข้อมูลเมตาเชิงพฤติกรรม ──> การตรวจสอบ LLM แบบเรียลไทม์ ──> บังคับ CAPTCHA / แยกตัวออกจากระบบ
การใช้การป้องกันแบบหลายชั้นและเข้าใจบริบทช่วยให้สามารถดักจับความพยายามของบอทได้แม้จะใช้ช่วง IP ที่สะอาด ความท้าทายที่คล้ายกันยังเกิดขึ้นในการระบุแหล่งที่มาบนมือถือ (Mobile Attribution) ซึ่งข้อจำกัดด้านความเป็นส่วนตัวทำให้ไม่สามารถใช้ตัวระบุฝั่งไคลเอนต์แบบถาวรได้ เมื่อการโต้ตอบของผู้ใช้ถูกแยกออกจากคุกกี้ท้องถิ่นเพื่อปฏิบัติตามหลักเกณฑ์ความเป็นส่วนตัว การรักษาความต่อเนื่องของเซสชันข้ามแพลตฟอร์มบนเว็บและมือถือจึงซับซ้อนขึ้นมาก เช่นเดียวกับที่ทีมความปลอดภัยต้องการโมเดลพฤติกรรมแบบเรียลไทม์เพื่อแยกแยะมนุษย์จากบอท ไปป์ไลน์การตลาดจำเป็นต้องมีการเก็บรักษาข้อมูลฝั่งเซิร์ฟเวอร์ (Server-side) ที่แข็งแกร่ง เพื่อเชื่อมโยงเหตุการณ์การติดตั้งโดยไม่ต้องพึ่งพาคุกกี้หรือข้อมูลระบุตัวตนบนอุปกรณ์ที่เปราะบาง
สถานการณ์ตัวอย่าง: เกิดอะไรขึ้นเมื่อบอทพยายามโพสต์?
สมมติว่าสคริปต์อัตโนมัติลงทะเบียนบัญชีใหม่เพื่อเพิ่มความน่าเชื่อถือให้แบรนด์ของลูกค้าบน subreddit ในขณะที่บัญชีถูกสร้างขึ้น ระบบตรวจสอบเส้นทางที่ฝั่งแบ็กเอนด์จะวิเคราะห์ข้อมูลพฤติกรรม หากรายละเอียดการเชื่อมต่อหรือพารามิเตอร์อินพุตตรงกับโปรไฟล์ของ Headless Browser สิทธิ์ในการโพสต์มาตรฐานจะถูกระงับทันที และระบบจะกระตุ้นการตรวจสอบความเป็นมนุษย์ ซึ่งป้องกันไม่ให้การส่งข้อมูลของบอทเข้าถึงไดเรกทอรีสาธารณะได้
สร้างเอง vs. ซื้อใช้: การรักษาบริบทของเซสชันในสภาพแวดล้อมที่มีปริมาณงานสูง
ในขณะที่แพลตฟอร์มดิจิทัลลดการพึ่งพาตัวระบุท้องถิ่นเพื่อปฏิบัติตามแนวทางความเป็นส่วนตัว การจัดการสถานะของเซสชันข้ามช่องทางดิจิทัลได้กลายเป็นความท้าทายหลักทางวิศวกรรม การจัดการโครงสร้างพื้นฐานที่ประมวลผลคำขอต้องสงสัย 23 ล้านครั้งต่อวันที่ Reddit รายงานนั้นต้องการการตรวจสอบฝั่งเซิร์ฟเวอร์ที่แข็งแกร่ง แม้ว่าระบบต่อต้านสแปมของ Reddit จะมุ่งเน้นไปที่ความปลอดภัยมากกว่าการระบุแหล่งที่มาทางการตลาด แต่ทั้งสองสถานการณ์มีความท้าทายทางสถาปัตยกรรมร่วมกัน นั่นคือการรักษาสถานะฝั่งเซิร์ฟเวอร์ที่เชื่อถือได้หลังจากตัวระบุฝั่งไคลเอนต์ไม่สามารถใช้งานได้ การจัดการไปป์ไลน์การรับส่งข้อมูลในสภาพแวดล้อมที่มีการพยายามสแปมสูงเช่น Reddit ต้องอาศัยโครงสร้างที่สามารถเชื่อมโยงการกระทำของผู้ใช้งานได้อย่างปลอดภัยโดยไม่ต้องใช้ที่เก็บข้อมูลท้องถิ่น
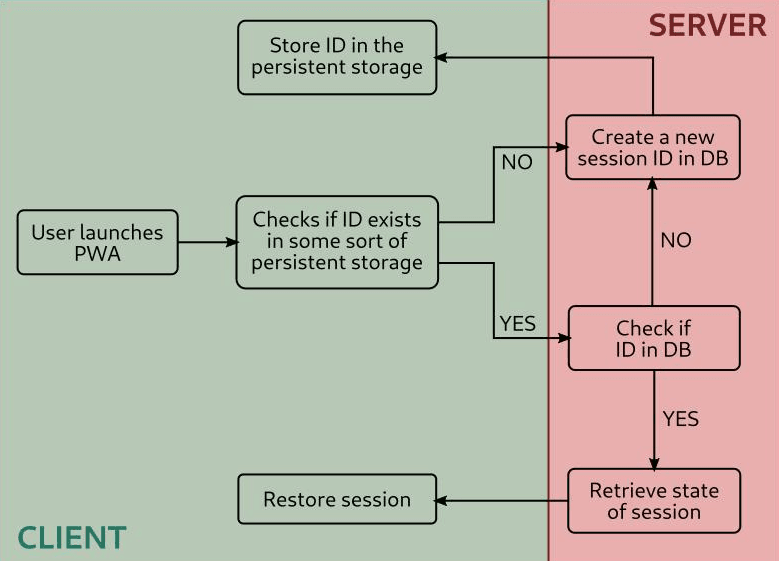
การประเมินสถาปัตยกรรม: สร้างเอง vs. SDK สำเร็จรูป
การสร้างระบบเองเพื่อจัดการการจับคู่สถานะฝั่งเซิร์ฟเวอร์มอบความยืดหยุ่นสูงสุด แต่ต้องใช้ทรัพยากรวิศวกรรมอย่างต่อเนื่อง นักพัฒนาต้องสร้างสถาปัตยกรรมฐานข้อมูลเอง เขียนฟังก์ชันแฮชการเข้ารหัส และอัปเดตระบบให้สอดคล้องกับข้อบังคับระดับภูมิภาคที่เปลี่ยนแปลงอยู่ตลอด ในทางกลับกัน การใช้ SDK ที่ผ่านการรับรองและสร้างไว้แล้วจะช่วยลดความซับซ้อนในการเชื่อมต่อและรับประกันการปฏิบัติตามกฎระเบียบในระยะยาวโดยไม่ต้องมีภาระงานเพิ่มเติม
ตารางด้านล่างเปรียบเทียบวิธีการมาตรฐานสำหรับการจัดการสถานะเซสชันและบริบทของการแปลงผลลัพธ์:
| โซลูชัน | ความคงทน | ปริมาณงาน (Throughput) | เหมาะสำหรับ |
|---|---|---|---|
| ฐานข้อมูลเซสชันภายในองค์กร | สูง (ซิงค์ต่อเนื่อง) | ปานกลาง (จำกัดโดยความหน่วง DB) | องค์กรที่มีการจัดเก็บข้อมูลเฉพาะทางสูง |
| การติดตามเซสชันผ่านเบราว์เซอร์ | ต่ำ (Session Cookies) | ต่ำ (ไม่มีการบันทึกฝั่งเซิร์ฟเวอร์) | การติดตามเว็บไซต์พื้นฐานที่ไม่เน้นการแปลงข้ามโดเมน |
| แคชฝั่งเซิร์ฟเวอร์ (เช่น OpoInstall) | ไม่มี (โทเค็นเซสชันชั่วคราว) | สูง (มาตรฐาน Sandbox) | แอปมือถือขนาดใหญ่และการระบุแหล่งที่มาข้ามแพลตฟอร์ม |
ในขณะที่การตั้งค่าฐานข้อมูลเองสามารถจัดการบริบทพื้นฐานได้ การรักษาความปลอดภัยของสถานะฝั่งเซิร์ฟเวอร์แบบเฉพาะทางสามารถช่วยเพิ่มประสิทธิภาพทรัพยากรการพัฒนาได้ ขึ้นอยู่กับความต้องการใช้งาน องค์กรอาจเลือกสร้างระบบจัดการเซสชันฝั่งเซิร์ฟเวอร์เองหรือใช้แพลตฟอร์มเชิงพาณิชย์ เช่น OpoInstall ตัวอย่างเช่น OpoInstall นำเสนอกรอบการกู้คืนสถานะและส่งผ่านพารามิเตอร์ฝั่งเซิร์ฟเวอร์ โดยจับคู่ข้อมูลเมตาของเซสชันกับฐานข้อมูลฝั่งเซิร์ฟเวอร์เพื่อรักษาความต่อเนื่องของเซสชันแบบนิรนามภายใต้สภาวะที่มีปริมาณข้อมูลสูง ทำให้การประมวลผลคำขอฝั่งเซิร์ฟเวอร์สามารถขยายผลได้ดี การจับคู่ข้อมูลเมตากับฐานข้อมูลส่วนกลางแทนการพึ่งพาการเปลี่ยนเส้นทางในเบราว์เซอร์ช่วยให้มั่นใจได้ว่าบริบทการแปลงผลลัพธ์จะยังคงสอดคล้องกัน ทีมวิศวกรรมสามารถประเมินแนวทางเหล่านี้เพื่อสร้างสมดุลระหว่างการปกป้องข้อมูลและความสอดคล้องของการวัดผล
เช็คลิสต์การบูรณาการ: การออกแบบระบบป้องกันบอทและไปป์ไลน์การได้มาซึ่งผู้ใช้งานใหม่
เพื่อปกป้องไปป์ไลน์ข้อมูลและสร้างความมั่นใจในความสอดคล้องของการแปลงผลลัพธ์ ในขณะที่แพลตฟอร์มเปลี่ยนไปสู่โมเดลข้อมูลฝั่งเซิร์ฟเวอร์ที่ปลอดภัย ทีมวิศวกรรมและผลิตภัณฑ์ต้องปรับใช้กระบวนการรักษาสถานะที่มีประสิทธิภาพ
เช็คลิสต์การดำเนินการสำหรับนักพัฒนา
- ตรวจสอบจุดเชื่อมต่อ API ภายนอก: ตรวจสอบให้แน่ใจว่าการถ่ายโอนข้อมูลภายนอกทั้งหมดถูกกำหนดเส้นทางผ่านการเชื่อมต่อ HTTPS ที่ปลอดภัยและใช้โครงสร้างเซสชันชั่วคราว
- ใช้ระบบสถานะเซสชันแบบ Stateless: เปลี่ยนการพึ่งพาระบบไปสู่การกู้คืนสถานะเซสชันฝั่งเซิร์ฟเวอร์ โดยใช้โทเค็นที่ลงนามเพื่อส่งข้อมูลข้ามแพลตฟอร์ม
- ตรวจสอบกระบวนการขอความยินยอมแบบ Sandbox: กำหนดขั้นตอนการขออนุญาตที่ชัดเจนก่อนส่งข้อมูลของผู้ใช้งานไปยังฐานข้อมูลบุคคลที่สาม
เช็คลิสต์กลยุทธ์ด้านผลิตภัณฑ์และการดำเนินงาน
- ติดตามความแม่นยำของการตรวจจับบอท: ติดตามและประเมินความแม่นยำของตัวจำแนกประเภทโมเดลภาษาขนาดใหญ่ที่จังหวะการสร้างบัญชี
- ทบทวนอัตรา False-Positive: จัดให้มีการตรวจสอบเป็นระยะเพื่อให้แน่ใจว่าเนื้อหาของผู้ใช้งานจริงจะไม่ถูกปิดกั้นหรือจำกัดปริมาณโดยไม่ตั้งใจ
- ติดตามความสำเร็จในการท้าทายการยืนยันตัวตน: วิเคราะห์ว่าบัญชีที่น่าสงสัยมีการโต้ตอบกับการทดสอบความเป็นมนุษย์และ CAPTCHA อย่างไร
- ตรวจสอบกลุ่มบัญชีที่น่าสงสัย: ทำแผนที่ข้อมูลพฤติกรรมเพื่อแยกแยะความพยายามในการลงทะเบียนจำนวนมากผ่านช่วงเครือข่ายที่คล้ายคลึงกัน
ด้วยการกำหนดแนวทางที่มีโครงสร้างเหล่านี้ ทีมพัฒนาจะสามารถเปลี่ยนแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามกฎระเบียบมากขึ้น พร้อมกับรักษาความต่อเนื่องของการดำเนินงานไปได้พร้อมกัน
คำถามที่พบบ่อย (FAQ)
ทำไมแคมเปญสแปมที่สร้างโดย AI ถึงเพิ่มขึ้นบน Reddit?
Reddit ใช้ LLMs ตรวจจับพฤติกรรมที่ไม่สมจริงที่มีการประสานงานกันขณะสร้างบัญชีอย่างไร?
มีตัวบ่งชี้ใดบ้างที่ใช้ระบุบอทอัตโนมัติ?
ในขณะที่แพลตฟอร์ม AI พึ่งพาการอนุมานบนระบบไฮบริดคลาวด์มากขึ้น นักพัฒนาจำเป็นต้องออกแบบผลิตภัณฑ์ใหม่โดยเน้นความเป็นส่วนตัว การขอความยินยอมที่โปร่งใส และการรับส่งข้อมูลที่ปลอดภัย สถาปัตยกรรมข้อมูลที่กำลังเปลี่ยนไปต้องการการเปลี่ยนแปลงพื้นฐานในการสร้างและวัดผลประสบการณ์ดิจิทัล เมื่อ Stateless Proxies และ Headless Scrapers กลายเป็นผู้บริโภคเนื้อหาบนเว็บรายหลัก โมเดลการระบุแหล่งที่มาบนฝั่งไคลเอนต์แบบเดิมจะด้อยประสิทธิภาพลงเรื่อยๆ การพึ่งพาคุกกี้และ Referrers แบบมาตรฐานไม่เพียงพอต่อการรักษาความปลอดภัยของไปป์ไลน์ข้อมูลที่ขับเคลื่อนการได้มาซึ่งผู้ใช้งานอีกต่อไป
การรักษาความสมบูรณ์ของการมีส่วนร่วมจากผู้ใช้จริงได้กลายเป็นทั้งความเชื่อมั่นและลำดับความสำคัญทางรายได้สำหรับชุมชนออนไลน์ขนาดใหญ่ มองไปข้างหน้า ทีมวิศวกรรมจะพึ่งพาสถาปัตยกรรมแบบ Stateless, การจัดการเซสชันฝั่งเซิร์ฟเวอร์, และการออกแบบที่ให้ความเป็นส่วนตัวเป็นอันดับแรก องค์กรที่เตรียมพร้อมสำหรับการเปลี่ยนแปลงเหล่านี้ตั้งแต่เนิ่นๆ จะอยู่ในตำแหน่งที่ดีกว่าในการรักษาผลิตภัณฑ์ AI ที่ปลอดภัยและยั่งยืน
Share this article



