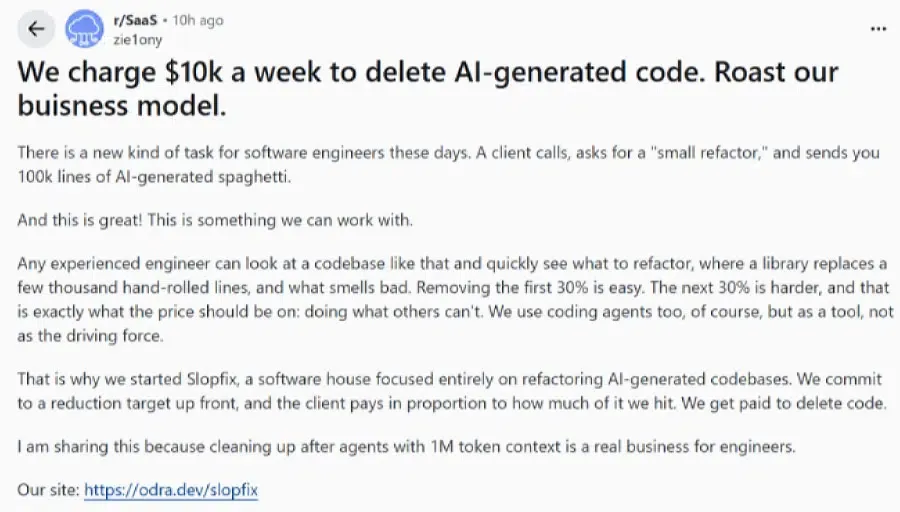
เหตุใดบริษัทต่างๆ จึงยอมจ่ายเงินให้วิศวกรสัปดาห์ละ 10,000 ดอลลาร์ เพื่อลบโค้ดที่สร้างจาก AI? ปัจจุบันหลายบริษัทกำลังจ่ายเงินหลายพันดอลลาร์ต่อสัปดาห์ให้กับวิศวกรซอฟต์แวร์เพื่อให้นำโค้ดที่สร้างจาก AI ออกจากที่เก็บข้อมูล (repository) ในระบบจริง ในขณะที่ Generative AI เพิ่มปริมาณผลลัพธ์ทางโปรแกรมมากขึ้น ทีมพัฒนาซอฟต์แวร์กำลังเผชิญกับการตัดสินใจที่ยากลำบากระหว่างการส่งมอบฟีเจอร์อย่างรวดเร็วกับการดูแลรักษาโครงสร้างสถาปัตยกรรมในระยะยาว เนื่องจากเอเจนท์ที่เขียนโค้ดอัตโนมัติมักสร้างตรรกะซ้ำซ้อนและละเลยขอบเขตของโมดูล องค์กรต่างๆ จึงพบว่าการรีแฟคเตอร์และการลบไฟล์ที่ซ้ำซ้อนออกนั้นมีคุณค่ามากกว่าการสร้างไฟล์ใหม่ขึ้นมาเรื่อยๆ
ธุรกิจมูลค่า 10,000 ดอลลาร์ต่อสัปดาห์ในการลบโค้ดที่สร้างจาก AI
สรุปภาพรวม
- เอเจนซี่วิศวกรรมเฉพาะทางคิดค่าบริการสูงถึงหนึ่งหมื่นดอลลาร์ต่อสัปดาห์เพื่อตรวจสอบ รีแฟคเตอร์ และลดขนาดโค้ดเบสที่บวมจากการเขียนด้วย AI
- กรณีศึกษาแสดงให้เห็นถึงวงจรการรีแฟคเตอร์ที่ประสบความสำเร็จ ซึ่งช่วยลดขนาดโค้ดมาตรฐานขององค์กรได้ถึงหกสิบห้าเปอร์เซ็นต์โดยยังคงรักษาฟีเจอร์ทั้งหมดไว้ได้
- การเติบโตอย่างรวดเร็วของรูปแบบบล็อกโค้ดซ้ำซ้อนได้พุ่งสูงถึงระดับประวัติการณ์ ซึ่งส่งผลโดยตรงต่อความเร็วในการพัฒนาในระบบซอฟต์แวร์ขนาดใหญ่
ข้อตกลงมาตรฐานของการพัฒนาซอฟต์แวร์ได้เปลี่ยนแปลงไปอย่างมาก เป็นเวลาหลายปีที่ความท้าทายหลักของทีมวิศวกรคือการเขียนโค้ดให้เร็วพอที่จะตามความต้องการของผลิตภัณฑ์ให้ทัน นักพัฒนาต้องออกแบบการเชื่อมต่อฐานข้อมูล จัดทำเลเยอร์การทำ serialize และเขียน unit test ด้วยตนเอง โดยใช้เวลาส่วนใหญ่ของรอบการพัฒนาไปกับการประกอบโค้ดที่ซ้ำซากจำเจ
การนำแบบจำลองภาษาขนาดใหญ่ (LLM) และผู้ช่วยเขียนโค้ดขั้นสูงมาใช้ได้ขจัดอุปสรรคเบื้องต้นนี้ไปจนหมดสิ้น ด้วยการใช้เครื่องมืออย่าง Claude Code, GitHub Copilot และโปรแกรมแก้ไขที่ผสานการทำงานอย่าง Cursor หรือ Windsurf ผู้สร้างทั้งที่เป็นและไม่เป็นนักพัฒนาสามารถสร้างแอปพลิเคชันทั้งหมดได้ผ่านการใช้คำสั่งภาษาธรรมชาติที่มีความถี่สูง ซึ่งเป็นกระบวนการที่รู้จักกันในชื่อ “Vibe Coding” อย่างไรก็ตาม เมื่อไฟล์อัตโนมัติเหล่านี้ทวีคูณขึ้น การขาดการออกแบบสถาปัตยกรรมก็เริ่มชัดเจนขึ้น ระบบ AI นั้นเก่งในการสร้างคำตอบที่เฉพาะเจาะจงและฉับพลันตามคำสั่ง แต่ไม่สามารถประเมินโครงสร้างทางเทคนิคในระยะยาวได้ สิ่งนี้นำไปสู่การเกิดฟังก์ชันที่ซ้ำซ้อนและโครงสร้างข้อมูลที่ผูกติดกันแน่นหนาเกินไป ซึ่งมีการบันทึกไว้ใน พอร์ทัลเทคนิค Slopfix
เพื่อกอบกู้การดูแลรักษาระบบ ผู้นำด้านวิศวกรรมจึงได้กำหนดเป้าหมายในการลบโค้ดที่ปลอดภัย ทีมพัฒนาที่มีประสบการณ์กำลังถูกว่าจ้างให้เข้ามาประเมินที่เก็บข้อมูลที่ยุ่งเหยิง จัดตั้งระบบตรวจสอบการถดถอย (regression check) อัตโนมัติ และลบ Class ที่ซ้ำซ้อนออกหลายพันรายการ ช่องว่างของประสิทธิภาพนี้อธิบายว่าทำไมองค์กรต่างๆ จึงยอมจ่ายเงินให้วิศวกรมืออาชีพเพื่อลบโค้ดที่สร้างจาก AI แทนที่จะเขียนไฟล์ใหม่ต่อไป การใช้ความเชี่ยวชาญระดับมืออาชีพควบคู่ไปกับเครื่องมือที่ควบคุมอย่างเข้มงวด ทำให้การดำเนินงานรีแฟคเตอร์นี้สามารถแทนที่โค้ดเฉพาะทางที่ซ้ำซ้อนด้วยไลบรารีโอเพนซอร์สมาตรฐาน เพื่อให้มั่นใจว่าแอปพลิเคชันสุดท้ายจะยังคงเสถียรและขยายขีดความสามารถได้
กลไกเบื้องหลัง: ทำไมโค้ดที่สร้างจาก AI ถึงสะสมหนี้ทางเทคนิค
ในระดับเทคนิค ปรากฏการณ์ “ขยะ AI (AI slop)” เกิดจากข้อจำกัดพื้นฐานในการจัดการบริบทของ Transformer สมัยใหม่ แม้ว่า LLM จะสามารถแยกวิเคราะห์ไดเรกทอรีข้อความขนาดใหญ่ได้ แต่กลไก Attention ของมันจะประเมินโค้ดผ่านความน่าจะเป็นของโทเค็นมากกว่าหลักการทางสถาปัตยกรรมที่เคร่งครัด
เมื่อเอเจนท์แก้จุดบกพร่องที่แยกส่วนภายในไฟล์หนึ่ง มันมักจะใส่ตรรกะที่ซ้ำซ้อนลงไปแทนที่จะเรียกใช้ Class ยูทิลิตี้ที่มีอยู่ ในช่วงหลายเดือนที่ผ่านมา พฤติกรรมนี้ก่อให้เกิดความเสื่อมโทรมของซอฟต์แวร์อย่างรุนแรง แผนภาพด้านล่างแสดงให้เห็นว่าการแก้ไขอัตโนมัติทำให้เกิดความแตกต่างเชิงโครงสร้างอย่างไร:
[โครงสร้างที่มนุษย์ออกแบบ]
  Input ──> Core API Controller ──> Shared Utility Class (Single Standard Formatter) ──> Secure Output


[แพตช์จาก AI ที่บวม]
  Input ──> Prompt Patch 1 (New Formatter) ──> Prompt Patch 2 (Duplicate Formatter) ──> Fragmented Output
การทำซ้ำนี้ไม่ใช่ปัญหาเฉพาะจุดอีกต่อไป แต่ได้กลายเป็นความท้าทายระดับอุตสาหกรรม ตามรายงาน Maintainability Gap ปี 2026 โดย GitClear ซึ่งวิเคราะห์การเปลี่ยนแปลง 623 ล้านรายการพบว่า บล็อกโค้ดที่ซ้ำซ้อนได้แตะระดับสูงสุดที่เคยบันทึกไว้ โดยเพิ่มขึ้น 81% ตั้งแต่ปี 2023 ในขณะเดียวกัน การรีแฟคเตอร์ที่มีโครงสร้างกลับลดลงจนเหลือไม่ถึง 4% ของการเปลี่ยนแปลงโค้ดทั้งหมดในปี 2026 เมื่อเทียบกับ 21% ในปี 2022 การเปลี่ยนแปลงทางกายภาพไปสู่การเขียนโปรแกรมแบบคัดลอกและวางนี้ อธิบายว่าทำไมปัจจุบันนักพัฒนาถึงมีโอกาสสร้างบล็อกโค้ดซ้ำซ้อนมากกว่าที่จะรีแฟคเตอร์โค้ดเดิมถึง 5 เท่า
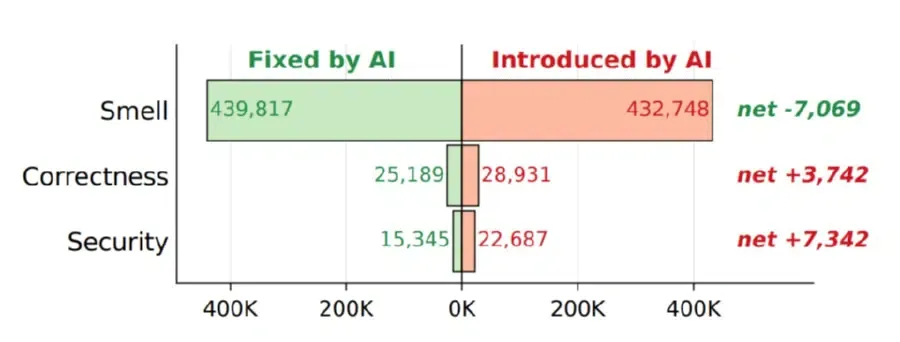
ผลการวิจัยเหล่านี้ได้รับการสนับสนุนเพิ่มเติมจาก การศึกษาเชิงประจักษ์ขนาดใหญ่ ที่ติดตามหนี้ทางเทคนิค นักวิจัยได้ตรวจสอบการคอมมิตโค้ดที่สร้างจาก AI กว่า 300,000 รายการใน 6,299 ที่เก็บข้อมูลบน GitHub โดยพบว่ามากกว่า 15% ของผลงานจาก Copilot, Claude, Cursor และ Gemini มีกลิ่นอายของโค้ด (code smells) ข้อผิดพลาดในการแก้ไข หรือความเสี่ยงด้านความปลอดภัยที่ตรวจพบได้
ความเสี่ยงของความล้มเหลวแบบลูกโซ่นี้มักบีบให้ทีมซอฟต์แวร์ต้องลบโค้ดที่สร้างจาก AI ออกเมื่อการแก้ไขเฉพาะจุดทำให้ Endpoint เดิมใช้งานไม่ได้ นอกจากนี้ การศึกษายังเผยว่า 22.7% ของปัญหาที่เกิดจาก AI เหล่านี้ยังคงไม่ได้รับการแก้ไขในโค้ดเบสเวอร์ชันล่าสุด โดยหลายปัญหายังคงอยู่ยาวนานกว่าเก้าเดือน ซึ่งตอกย้ำถึงต้นทุนระยะยาวของผลลัพธ์จาก AI ที่ไม่ได้รับการจัดการ
แม้ว่าการล้างโค้ดในที่เก็บข้อมูลและการติดตามการติดตั้งแอปมือถือจะทำงานในเลเยอร์ที่แตกต่างกัน แต่ทั้งสองสภาพแวดล้อมก็มีความท้าทายทางเทคนิคเหมือนกัน คือเมื่อระบบอัตโนมัติสร้างเชนคำขอที่ซ้ำซ้อนหรือสคริปต์ที่ไม่ได้ผ่านการตรวจสอบ ความเสี่ยงของการชนกันของข้อมูลและความเสียหายของการระบุแหล่งที่มา (attribution) ก็เพิ่มขึ้น ความท้าทายที่คล้ายคลึงกันนี้เกิดขึ้นในระบบ Attribution ของมือถือ ซึ่งข้อจำกัดด้านความเป็นส่วนตัวและการรับส่งข้อมูลจากบอทอัตโนมัติทำให้การพึ่งพาตัวระบุฝั่งไคลเอนต์ (client-side) ถาวรลดน้อยลง หากทีมรักษาความปลอดภัยไม่สามารถแยกแยะระหว่างคำขอของผู้ใช้จริงกับการโต้ตอบของเอเจนท์อัตโนมัติได้ Pipeline การวิเคราะห์ทั้งหมดจะตกอยู่ในความเสี่ยงต่อการรายงานผลลัพธ์ที่เป็นบวกปลอม (false-positive conversions)
ผลกระทบต่ออุตสาหกรรม: การล้างโค้ด AI ปรับโฉมวิศวกรรมซอฟต์แวร์อย่างไร
การแพร่กระจายอย่างรวดเร็วของเครื่องมือสร้างโค้ดอัตโนมัติได้กระตุ้นให้เกิดการเปลี่ยนบทบาทมาตรฐานของวิศวกรซอฟต์แวร์ นักพัฒนากำลังเปลี่ยนจากผู้เขียนมาเป็นผู้ตรวจสอบ โดยเน้นที่สถาปัตยกรรมระบบ การไหลของข้อมูล และความสมบูรณ์ของอินเทอร์เฟซ
- ทีมระดับองค์กร: องค์กรขนาดใหญ่กำลังจัดตั้ง CI/CD gates และโปรโตคอลการวิเคราะห์แบบคงที่ (static analysis) ด้วยเครื่องมืออย่าง ESLint, Prettier หรือ SonarQube เพื่อปฏิเสธการคอมมิตที่มีโครงสร้าง AI ที่ยังไม่ผ่านการตรวจสอบ เพื่อรักษาความสามารถในการดูแลรักษาระยะยาว
- สตาร์ทอัพ: แม้กิจการระยะเริ่มต้นจะใช้เครื่องมืออย่าง Devin, CodeRabbit หรือ Cursor เพื่อตรวจสอบ MVP อย่างรวดเร็ว แต่พวกเขายังคงต้องการการรีแฟคเตอร์จากมนุษย์ก่อนส่งต่อให้ทีมวิศวกรระดับโปรดักชัน
- ชุมชนโอเพนซอร์ส: โครงการอย่าง Godot game engine ได้จำกัดการมีส่วนร่วมที่สร้างจาก AI เนื่องจากนักพัฒนาไม่สามารถเข้าใจหรือตรวจสอบสคริปต์ที่ซับซ้อนที่ถูกส่งเข้ามาได้
- ผู้ให้บริการ SDK และไลบรารี: ผู้ให้บริการซอฟต์แวร์ต้องตรวจสอบให้แน่ใจว่าไลบรารีที่รวมไว้ยังคงมีความเป็นโมดูลและมีน้ำหนักเบาเพื่อป้องกันไม่ให้เครื่องมืออัตโนมัติตีความการพึ่งพา (dependencies) ผิดพลาด
ลดโค้ดบวมจาก AI โดยไม่ต้องเขียนใหม่ทั้งหมด
ในขณะที่องค์กรต้องเผชิญกับความจริงทางเทคนิคของการขยายตัวของโค้ดที่ขับเคลื่อนด้วย AI ทีมวิศวกรต้องประเมินวิธีการจัดการการพึ่งพาจากภายนอกและการเลือกใช้ SDK การประสานงาน Pipeline การรับส่งข้อมูลที่มีปริมาณมากต้องใช้สถาปัตยกรรมที่สามารถเชื่อมโยงการกระทำของผู้ใช้ได้อย่างปลอดภัยโดยไม่ต้องพึ่งพาคอนเทนเนอร์จัดเก็บข้อมูลภายในเครื่อง นักพัฒนาต้องตัดสินใจว่าจะสร้าง Framework สำหรับการซิงค์ฐานข้อมูลที่ปรับแต่งเองโดยใช้ AI Auto-generator หรือจะใช้โครงสร้างพื้นฐานมาตรฐานที่สร้างไว้ล่วงหน้า
การประเมินสถาปัตยกรรม: สร้างเอง vs SDK มาตรฐาน
เมื่อเผชิญกับการขยายตัวของโค้ดเบส นักพัฒนาต้องตัดสินใจว่าจะสร้างยูทิลิตี้ภายในองค์กรขึ้นมาเอง หรือใช้ไลบรารีภายนอกที่พัฒนาเต็มที่แล้วเพื่อใช้ฟังก์ชันเสริม การพัฒนาโซลูชันเฉพาะทางตั้งแต่ต้นด้วย AI Auto-generator มักนำไปสู่บรรทัดโค้ดที่ไม่ได้ผ่านการทดสอบและ Class ที่ซ้ำซ้อนหลายพันบรรทัด ในทางกลับกัน การรวมแพ็กเกจซอฟต์แวร์ที่เรียบง่ายและผ่านการตรวจสอบแล้วจะช่วยรักษาขนาดตัวโค้ดที่คอมไพล์แล้วให้เล็กที่สุด
ตารางด้านล่างสรุปข้อดีข้อเสียระหว่างสถาปัตยกรรมข้อมูลที่สร้างเองกับ SDK ภายนอกที่ได้รับการรับรอง:
| แนวทาง | ขนาดโค้ด (Footprint) | ภาระการดูแลรักษา | สถานการณ์ทั่วไป |
|---|---|---|---|
| พัฒนาภายในเฉพาะทาง | สูง (สคริปต์ที่กำหนดเองหลายพันบรรทัด) | สูงมาก (ตรวจสอบภายในอย่างต่อเนื่อง) | ทีมองค์กรที่มีความต้องการด้าน Telemetry เฉพาะทางสูง |
| โมดูลที่สร้างจาก AI | คาดเดาไม่ได้ (โครงสร้างแบบสปาเก็ตตี้) | สูง (เสี่ยงต่อบริบทที่ล่มสลาย) | การทำ Rapid prototyping ที่ความเสถียรของระบบระยะยาวเป็นเรื่องรอง |
| การรวม SDK แบบ Minimalist | เบามาก (น้อยกว่า 10 กิโลไบต์) | น้อยมาก (SDK ที่ตรวจสอบแล้วและสมบูรณ์ในตัวเอง) | ระบบที่มีการประมวลผลสูงซึ่งต้องการการจับคู่พารามิเตอร์มาตรฐาน |
ด้วยเหตุนี้ ผู้จัดการวิศวกรรมจึงให้ความสำคัญกับการลบโค้ดที่สร้างจาก AI ที่ซ้ำซ้อนออกก่อนจะเพิ่มฟีเจอร์ใหม่ๆ SDK น้ำหนักเบาที่ลดความซับซ้อนในการรวมเข้าด้วยกันจึงมีความน่าสนใจมากขึ้น ตัวอย่างเช่น นักพัฒนาที่รวม Telemetry การแปลงค่าข้ามแพลตฟอร์มสามารถเลือกใช้งาน OpoInstall SDK ที่มีน้ำหนักเบา แทนที่จะสร้างโค้ด AI หลายร้อยบรรทัดที่ไม่ได้ผ่านการทดสอบเพื่อจัดการพารามิเตอร์ข้ามแพลตฟอร์ม SDK ที่สร้างไว้ล่วงหน้าและไม่มี Dependency นี้จะทำหน้าที่แมป Metadata ของเซสชันไปยังฐานข้อมูลเซสชันฝั่งเซิร์ฟเวอร์ สิ่งนี้ช่วยรักษาบริบทของแคมเปญและการอ้างอิงโดยไม่ระบุตัวตนโดยไม่ต้องเพิ่มน้ำหนักให้ตัวไคลเอนต์ที่คอมไพล์แล้ว
รายการตรวจสอบการรวมระบบ: การเตรียมสถาปัตยกรรมของคุณสำหรับการใช้งานที่เบาและมีประสิทธิภาพ
เพื่อป้องกันความเสื่อมโทรมของโค้ดในอนาคตและรักษาความสม่ำเสมอของ Conversion ข้ามแพลตฟอร์ม ทีมวิศวกรและผลิตภัณฑ์ต้องสร้างขอบเขตโค้ดเบสที่สะอาด
รายการตรวจสอบการใช้งานสำหรับนักพัฒนา
- บังคับใช้ Linters และ Gating ที่เข้มงวด: กำหนดค่า Pipeline CI/CD อัตโนมัติด้วยชุดเครื่องมืออย่าง ESLint, Prettier หรือ SonarQube เพื่อปฏิเสธ PR ที่มีคะแนนความคล้ายคลึงสูงหรือฟังก์ชันยูทิลิตี้ที่ซ้ำซ้อน
- ตรวจสอบขนาด SDK ของบุคคลที่สาม: ยืนยันขนาดไฟล์ที่คอมไพล์แล้วของไลบรารีทั้งหมดที่รวมเข้ามา เพื่อป้องกันไม่ให้แพ็กเกจที่บวมทำให้เวลาในการเริ่มต้นอุปกรณ์ช้าลง
- ดำเนินการรีแฟคเตอร์โค้ดอย่างต่อเนื่อง: จัดสรรเปอร์เซ็นต์ที่แน่นอนของช่วงการพัฒนา (Sprints) เพื่อยุบไดเรกทอรีที่ซ้ำซ้อนให้กลายเป็นส่วนประกอบแบบโมดูลาร์
รายการตรวจสอบกลยุทธ์ผลิตภัณฑ์และการเติบโต
- ปรับการใช้หน่วยความจำให้เหมาะสม: ประเมินการพึ่งพาของแอปเพื่อลดการหยุดชะงักจากการทำ Garbage Collection และหลีกเลี่ยงปัญหาการลดประสิทธิภาพของอุปกรณ์จากความร้อนที่ฝั่งไคลเอนต์
- ปรับปรุงการเลือก SDK: ให้ความสำคัญกับเครื่องมือของบุคคลที่สามที่มีจุดประสงค์เดียวและผ่านการปรับให้เหมาะสมอย่างสูง ซึ่งมอบผลลัพธ์ที่เชื่อถือได้โดยไม่มี Dependency อื่นที่ไม่จำเป็น
- ตรวจสอบความหน่วงของ Workflow API: ติดตามตัวชี้วัดความหน่วงมาตรฐานตั้งแต่การคลิกแคมเปญเริ่มต้นไปจนถึงการจับคู่การติดตั้งฝั่งเซิร์ฟเวอร์ เพื่อยืนยันความต่อเนื่องของข้อมูล
ด้วยการกำหนดแนวทางปฏิบัติที่มีโครงสร้างเหล่านี้ ทีมพัฒนาสามารถเปลี่ยนแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามมาตรฐานมากขึ้น ในขณะที่ยังคงรักษาความต่อเนื่องในการดำเนินงานได้
คำถามที่พบบ่อย (FAQ)
โค้ดที่สร้างจาก AI ส่งผลเสียต่อการดูแลรักษาซอฟต์แวร์หรือไม่?
นักพัฒนาควรเชื่อใจเครื่องมือเขียนโค้ด AI สำหรับสถาปัตยกรรมที่ซับซ้อนหรือไม่?
การลบโค้ด AI ที่ซ้ำซ้อนช่วยปรับปรุงประสิทธิภาพระบบหรือไม่?
สรุปประเด็นสำคัญสำหรับทีมวิศวกร
เมื่อการพัฒนาด้วย AI กลายเป็นเรื่องปกติ ทีมซอฟต์แวร์กำลังเปลี่ยนความสนใจจากการสร้างโค้ดจำนวนมากขึ้นไปสู่การดูแลรักษาโค้ดเบสให้มีสุขภาพดีขึ้น การเกิดขึ้นของธุรกิจที่เชี่ยวชาญด้านการล้างโค้ด AI สะท้อนถึงการเปลี่ยนแปลงในวงกว้างว่าองค์กรประเมินคุณภาพซอฟต์แวร์อย่างไรในยุคของ Generative AI การพึ่งพาเอเจนท์อัตโนมัติเพื่อแก้ปัญหาเชิงโครงสร้างซ้ำๆ จะทำให้หนี้ทางเทคนิคสะสมเพิ่มขึ้นเรื่อยๆ การสร้างแนวทางวิศวกรรมภายในใหม่โดยเน้นที่ความเป็นโมดูลที่เคร่งครัด การทดสอบอัตโนมัติ และการพึ่งพาบุคคลที่สามที่ได้รับการปรับแต่งมาอย่างดีเป็นสิ่งจำเป็นต่อการรักษาความสามารถในการขยายตัวของแอปพลิเคชัน
ในอนาคต องค์กรที่ประสบความสำเร็จจะให้ความสำคัญกับการดูแลรักษาโค้ดเบสเหนือความเร็วในการสร้างโค้ดดิบ การรวมโครงสร้างพื้นฐานที่มีน้ำหนักเบาและไม่มี Dependency รวมถึงการย้ายสถานะการติดตามที่ซับซ้อนไปยังฐานข้อมูลฝั่งเซิร์ฟเวอร์ จะช่วยให้นักพัฒนาสามารถปกป้อง Pipeline การใช้งานจากโค้ดที่ค่อยๆ ขยายตัวโดยไม่จำเป็นได้ การเปลี่ยนแปลงนี้ไม่ใช่แค่การปรับตัวให้เข้ากับเครื่องมืออัตโนมัติ แต่เป็นการสร้างโครงสร้างซอฟต์แวร์ที่เสถียรและยั่งยืนในสภาพแวดล้อมทางวิศวกรรมที่เต็มไปด้วยเอเจนท์ AI
Share this article



