هل تتفوق سرعة Anthropic Sonnet 5.5 بـ 30%؟ أطلقت Anthropic رسمياً نموذج Claude Sonnet 5.5، حيث تشير التقارير إلى تحسن في سرعة توليد المخرجات بأكثر من 30%، وانخفاض في التكلفة لكل مهمة مكتملة بنسبة تصل إلى 30%. مع انتقال منصات الذكاء الاصطناعي التوليدي من النماذج التجريبية إلى أنظمة الإنتاج واسعة النطاق، يواجه مهندسو البرمجيات ضغوطاً متزايدة للتحكم في استهلاك الرموز (tokens) وزمن الاستجابة. تاريخياً، كان يُعتقد في أوساط الهندسة المؤسسية أن تحقيق أفضل أداء برمجي يتطلب استخدام أكبر النماذج وأكثرها تكلفة. اليوم، وبفضل البنى المحسنة للنماذج متوسطة الحجم التي يمكنها حل تحديات برمجية معقدة في خطوات تشغيلية أقل واستدعاءات أدوات محدودة، تحولت اقتصاديات أدوات المطورين المؤتمتة نحو كفاءة التنفيذ.
اقتصاديات الإنتاج: لماذا تهم تكلفة إتمام المهمة أكثر من سعر الرمز؟
نظرة سريعة
- أطلقت Anthropic نموذج Claude Sonnet 5.5 في 28 سبتمبر 2026، مما أدى إلى زيادة سرعة توليد المخرجات بنسبة تفوق 30% وخفض تكلفة المهمة الواحدة بنسبة تصل إلى 30%.
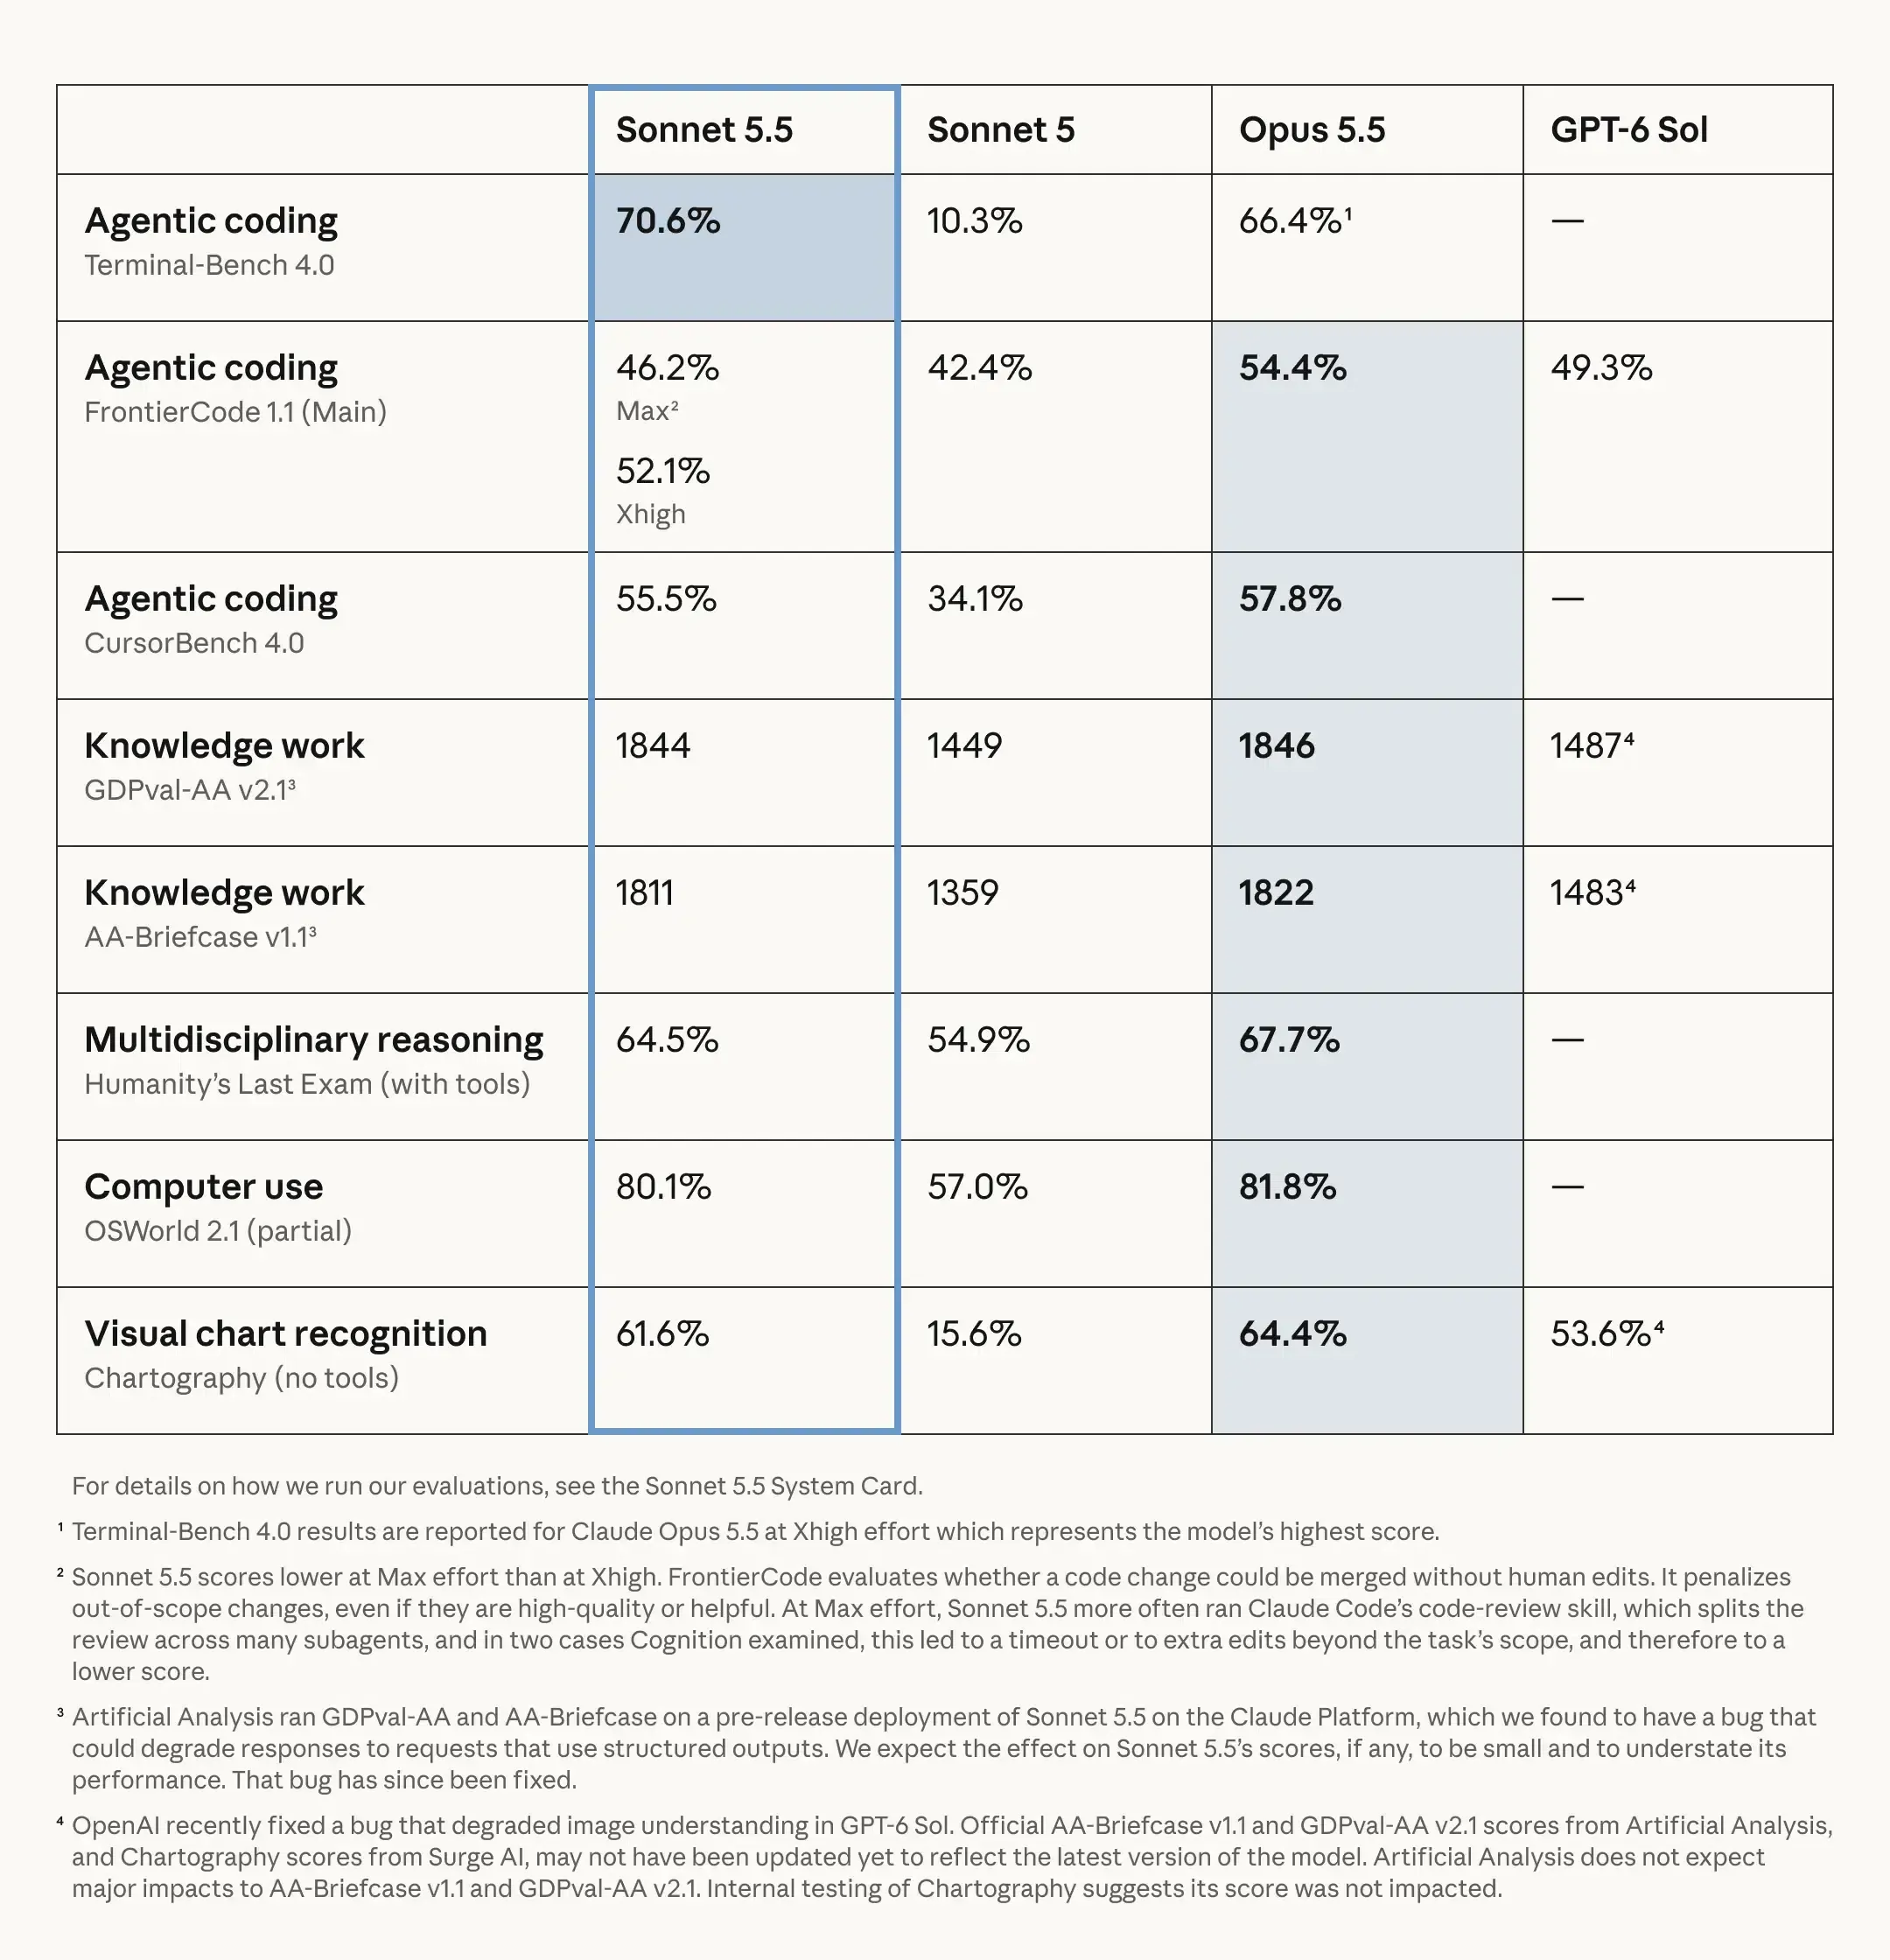
- في تقييم برمجة الوكلاء Terminal-Bench 4.0، سجل Sonnet 5.5 نسبة 70.6%، متفوقاً على النموذج الرئيسي Claude Opus 5.5 الذي سجل 66.4%، وSonnet 5 الذي سجل 10.3%.
- تظل أسعار الرموز البرمجية عبر API ثابتة عند $2 لكل مليون رمز مدخل و$10 لكل مليون رمز مخرج، مع تحقيق خفض التكاليف عبر تقليل خطوات التنفيذ واستدعاءات الأدوات المجمعة.
لطالما واجهت الجدوى التجارية لنشر وكلاء هندسة البرمجيات المستقلين قيوداً اقتصادية صعبة. فتشغيل أدوات المطورين متعددة الخطوات التي تفحص قواعد الأكواد، وتنفذ أوامر النظام، وتصلح اختبارات الوحدة بشكل تكراري يستهلك حجماً هائلاً من الرموز. وبينما تظهر النماذج الرائدة عمقاً استثنائياً في التفكير، فإن تكلفتها العالية للرموز وزمن الاستجابة المرتفع يجعلان التشغيل المستمر دون إشراف مكلفاً للمؤسسات البرمجية الكبيرة.
عند تقييم البنية التحتية للمطورين، غالباً ما تحجب أسعار الـ API المعلنة التكلفة الحقيقية لإتمام المهمة. فالنموذج الذي يتمتع بسعر منخفض لكل رمز ولكنه يمر عبر عشرات الاستدعاءات التكرارية للأدوات قد يكلف في النهاية أكثر بكثير من نموذج يحل المشكلات في خطوات أقل. يتم استكشاف هذه الديناميكية في التقارير الصناعية حول Sonnet 5.5، التي تسلط الضوء على كيفية فصل تكاليف إتمام المهام عن أسعار الرموز المباشرة.
صممت Anthropic نموذج Claude Sonnet 5.5 لمعالجة هذه الاختناقات التشغيلية بشكل مباشر. فمع الحفاظ على أسعار الأساس بـ $2 لكل مليون رمز مدخل و$10 لكل مليون رمز مخرج، يحقق النموذج خفضاً يصل إلى 30% في صافي تكاليف المهام بفضل الحاجة لخطوات تفكير أقل بكثير. وتبرز اختبارات العملاء التي نشرتها Anthropic مكاسب ملحوظة في الكفاءة عبر بيئات العمل الإنتاجية:
- Box أفادت أن Sonnet 5.5 عمل بسرعة أكبر بـ 2.4 مرة مع استهلاك رموز أقل بنسبة 12% لإعادة فحص مستندات المصدر وتحديد أخطاء الكود.
- Zendesk لاحظت أن تذاكر الدعم تمت معالجتها بسرعة أكبر بنسبة 20% مع حدوث أخطاء قرار مؤتمتة أقل مقارنة بالنماذج السابقة.
- Slack أظهرت أن النموذج تفوق على Sonnet 5 في تقييمات الروبوتات دون تعديلات، مستهلكاً رموز مخرجات أقل بنسبة 14% تقريباً.
- Lovable وجدت أن Sonnet 5.5 تطلب استدعاءات أدوات أقل بثلث الكمية، ونفذ أوامر النظام بنصف التكرارات أثناء عمليات بناء التطبيقات المؤتمتة.
- Base44 تحققت من أن النموذج أكمل عمليات بناء التطبيقات الكاملة بمتوسط 3.6 تكرار، مقارنة بـ 7.7 تكرار لـ Opus 5.
توضح هذه النتائج كيف تغير كفاءة التنفيذ من إنتاجية المطور بشكل جوهري. فمن خلال تقليل استدعاءات الأدوات الفاشلة والقضاء على التكرارات الزائدة، توفر النماذج متوسطة المستوى أساساً مستداماً للأتمتة المؤسسية المستمرة.
التشريح التقني: تقييم معايير البرمجة وتوسيع نطاق الوكلاء الفرعيين
يعكس ظهور نماذج متوسطة المستوى تتفوق على النماذج الرائدة في معايير تقنية محددة تحولاً في تدريب النماذج الأساسية. كانت قوانين القياس المبكرة تشير إلى أن عدد المعلمات (parameters) هو المحدد الرئيسي لذكاء النموذج. ومع ذلك، تعتمد المهام الوكيلة المعقدة—مثل التنقل في بيئات النظام وتحرير مستودعات الأكواد الكبيرة—بشكل كبير على إدارة السياق، ودقة استخدام الأدوات، والتحكم في النطاق.
تمتلك النماذج الرائدة مثل Opus 5.5 قدرة استدلال هائلة، وتتفوق في القرارات المعمارية الغامضة والمفتوحة. ومع ذلك، قد يؤدي عمق التفكير الموسع أحياناً إلى عبء تشغيلي في المهام محددة النطاق. على سبيل المثال، في تقييمات FrontierCode، لاحظت Anthropic أن Sonnet 5.5 عند ضبطه على أقصى مجهود (Max effort) سجل نتائج أقل من ضبطه على المجهود العالي (Xhigh) لأنه استدعى مهارة مراجعة الكود الخاصة بـ Claude Code بشكل متكرر. أدى تقسيم المراجعات هذا إلى وكلاء فرعيين مما تسبب في أوقات انتظار (timeouts) أو تعديلات خارج النطاق. في المقابل، فإن Sonnet 5.5 عند تشغيله بمجهود قياسي مناسب جداً للتنفيذ المحدود والمنظم، حيث يقوم بتحليل هياكل المستودعات وتقييم التغييرات المقترحة بدقة ضمن حدود الملفات المحددة.
تكافؤ المعايير: Terminal-Bench، وCursorBench، وGDPval-AA
تُظهر التقييمات المنشورة من Anthropic أن Sonnet 5.5 يضاهي أو يتجاوز المعايير الرائدة في المجالات التقنية اليومية. في Terminal-Bench 4.0، الذي يقيم حل المشكلات عبر سطر الأوامر متعدد الخطوات، سجل Sonnet 5.5 نسبة 70.6%، متفوقاً على Opus 5.5 (66.4%) وSonnet 5 (10.3%). وفي CursorBench 4.0، المستمد من جلسات مطوري Cursor الواقعية، وصل Sonnet 5.5 إلى 55.5%، بفارق ضئيل عن Opus 5.5 (57.8%). علاوة على ذلك، في GDPval-AA v2.1، الذي يقيس المهام المهنية الواقعية عبر 44 مهنة، حقق Sonnet 5.5 تصنيف Elo قدره 1844، متقارباً جداً مع Opus 5.5 الذي سجل 1846.
لفحص كيفية تحسين النماذج الانسيابية للتنفيذ المستقل، لننظر إلى اختلافات سير العمل:
[حلقة الوكيل الرائد المتجانس]
  مطالبة المستخدم ──> سلسلة تفكير ثقيلة ──> استدعاءات أدوات واسعة (استهلاك مرتفع للرموز) ──> خطر التحرير المفرط وأوقات الانتظار

[حلقة الوكيل المتوسط الانسيابي]
  مطالبة المستخدم ──> تعيين القصد المحدود ──> استدعاءات أدوات مجمعة ──> خطوات تنفيذ أقل ──> تسليم رقعة كود دقيقة
يمكن لحلقة التنفيذ الانسيابية هذه تقليل فرص انحراف السياق والرحلات غير الضرورية. تفيد Anthropic بزيادة سرعة توليد المخرجات بنسبة تزيد عن 30% مع تقليل عدد الخطوات مقارنة بـ Sonnet 5. يقوم النموذج بتجميع استدعاءات الأدوات معاً، مما يقلل من زمن الانتقال بين وقت تشغيل الوكيل وبيئات الاستضافة.
يُدخل Sonnet 5.5 أيضاً بنية تحتية أمنية من الفئة الأولى إلى فئة النماذج المتوسطة. وهو أول نموذج من فئة Sonnet يتم إطلاقه مع ضمانات أمن سيبراني مشابهة لـ Opus 5.5. المهام عالية المخاطر الخاصة باكتشاف الثغرات تعود تلقائياً إلى بنى معمارية أقدم، بينما يتلقى المدافعون المعتمدون أذونات طبقيّة من خلال برنامج التحقق السيبراني. بالإضافة إلى ذلك، يتضمن النظام مصنفات أمان مصممة لتقليل استخراج التفكير على نطاق صناعي وإبقاء التفكير المحفوظ مرتبطاً بالحساب الأصلي.
استراتيجية البنية المعمارية: تخصيص أعباء العمل عبر النماذج الرائدة والمتوسطة
مع انقسام نماذج الذكاء الاصطناعي الأساسية إلى محركات تفكير عميقة ونماذج تنفيذ مرنة، يجب على قادة الهندسة إعادة تقييم كيفية تخصيص مستويات النماذج عبر دورة حياة تطوير البرمجيات. إن نشر نموذج رائد واحد عبر خط إنتاج هندسي كامل يؤدي إلى زمن استجابة وتكلفة غير ضروريين. بدلاً من ذلك، تعتمد البنية التحتية الحديثة للمطورين بشكل متزايد على التوجيه الديناميكي للنماذج، وتعيين المهام بناءً على التعقيد الهيكلي.
عند بناء سير العمل الإنتاجي، يجب على الفرق موازنة المقايضات بين التفكير المفاهيمي العميق وحل المهام عالي الإنتاجية. بينما تظل النماذج الرائدة لا غنى عنها للتخطيط المعماري الواسع، تتعامل النماذج المتوسطة مع الغالبية العظمى من عمليات تنفيذ الكود اليومية باستجابة فائقة.
يوضح مصفوفة القرار التالية التوافق الفني عبر مستويات النماذج:
| فئة عبء العمل | خيار النموذج الأساسي | ملف التكلفة | ملف زمن الاستجابة | الأفضل لـ |
|---|---|---|---|---|
| إصلاح الأخطاء الروتينية ومراجعة PR | Claude Sonnet 5.5 | منخفض ($2 / $10 لكل 1 مليون رمز) | سريع (سرعة مخرجات أكبر بـ 30%+) | المهام البرمجية اليومية محددة النطاق وفحوصات CI/CD |
| هيكلة كامل قاعدة الكود والترحيل | Claude Opus 5.5 | مرتفع ($4 / $20 لكل 1 مليون رمز) | دورات تفكير عميقة وقابلة للتكيف | إعادة الهيكلة المعقدة والغامضة عبر المستودعات الضخمة |
| النماذج الأولية التفاعلية وتصميم الواجهة | Claude Sonnet 5.5 | منخفض ($2 / $10 لكل 1 مليون رمز) | تكرار سريع ومستجيب | تصميم تدفقات المستخدم، وتوليد المخططات، وهيكلة الواجهة الأمامية |
| أبحاث الأمن السيبراني المتقدمة | نماذج Claude ذات الوصول المعتمد | يعتمد على النموذج ومستوى الوصول | تحقق دقيق متعدد الخطوات | أبحاث أمنية عالية المخاطر مصرح بها ضمن برامج التحقق من Anthropic |
تنظم Anthropic قدرات الأمن السيبراني من خلال ضمانات طبقية. وبينما يتم إجراء معالجة الثغرات الروتينية بشكل طبيعي على Sonnet 5.5، تعود مهام الأمان ذات المخاطر الأعلى تلقائياً إلى بنى أقدم. بالنسبة للمدافعين المعتمدين الذين يجرون أبحاثاً أمنية متقدمة، تتم إدارة الوصول إلى قدرات موسعة عبر نماذج Sonnet 5.5 وOpus 5.5 وMythos من خلال برنامج التحقق السيبراني متعدد الطبقات.
من خلال إنشاء قواعد توجيه ديناميكية، يمكن للمؤسسات الهندسية توجيه مراجعات طلبات السحب الروتينية، وتوليد اختبارات الوحدة، وتحديد مواقع الأخطاء إلى Sonnet 5.5. وهذا يحافظ على سعة Opus الرائدة لعمليات إعادة الهيكلة المعمارية عالية التعقيد، مما يبقي ميزانيات الهندسة قابلة للتنبؤ دون المساس بموثوقية البرنامج.
قوائم مراجعة التكامل: تفعيل Sonnet 5.5 في المؤسسات CI/CD
مع دمج المؤسسات البرمجية لنماذج سريعة وفعالة التكلفة مثل Sonnet 5.5 في خطوط إنتاجها، يجب على الفرق الهندسية وضع جداول حوكمة قوية. تعظيم وفورات التكلفة يتطلب مواءمة إعدادات معاملات الـ API مع تعقيد المهام مع منع الانحراف غير المراقَب للوكلاء.
قائمة مراجعة تنفيذ المطورين
- تكوين مستويات المجهود الديناميكي: استخدم إعدادات المجهود الأصلية للنموذج—التي تضبط افتراضياً على المتوسط في تطبيقات Claude وClaude Code، والعالية في منصة Claude—لموازنة عمق التفكير مقابل استهلاك الرموز.
- الاستفادة من التخزين المؤقت للمطالبات (Prompt Caching): طبق التخزين المؤقت للمطالبات على مطالبات النظام الثابتة وخرائط المستودعات لتأمين خصم 90% على رموز قراءة التخزين المؤقت ($0.20 لكل مليون رمز).
- نشر المعالجة الجماعية غير المتزامنة: قم بتوجيه التقييمات غير الفورية، وعمليات تدقيق الكود المؤتمتة، والترحيلات الجماعية عبر واجهات برمجة تطبيقات الدفع (batch APIs) لتحقيق خصم 50% على تكاليف الرموز القياسية.
- دمج آليات الحماية من الفشل: أنشئ قواطع دائرة برمجية تنهي الطلبات أو تعيد توجيهها بذكاء إذا تجاوزت حلقات الأدوات المؤتمتة ميزانيات التكرار المحددة مسبقاً.
قائمة مراجعة الحوكمة والبنية التحتية
- إعادة تقييم اقتصاديات وحدة الاشتراك: احسب تكاليف الحوسبة الهامشية لكل مطور نشط لتحديد ما إذا كانت النماذج المتوسطة عالية السرعة تسمح بتقديم حصص استخدام أعلى أو أسعار فئة أقل.
- مراقبة نسب التكرار: قم بقياس متوسط عدد استدعاءات الأدوات المطلوبة لحل مهام المستخدم؛ فالتخفيضات في أعداد التكرار تحسن مباشرة من رضا المطور.
- تكوين المعالجة داخل الولايات المتحدة عند الحاجة: للعملاء المؤسسيين الخاضعين للتنظيم ومتطلبات تخزين البيانات المحلية، قم بتكوين نقاط نهاية استدلال مقتصرة على الولايات المتحدة (متاحة بسعر 1.1x بموجب شروط المؤسسة المؤهلة).
- التحقق من أهلية عدم الاحتفاظ بالبيانات: أكد حالة عدم الاحتفاظ بالبيانات مع مزود الـ API، مما يضمن امتثال المؤسسة، مع ملاحظة أن الميزات المتخصصة مثل مخابئ المطالبات المستمرة قد تعمل بموجب شروط مختلفة للاحتفاظ بالبيانات.
من خلال اعتماد هذه الممارسات التشغيلية المنظمة، يمكن للمؤسسات البرمجية تحويل السرعة الخوارزمية وكفاءة الرموز إلى مكاسب تطويرية يمكن التنبؤ بها.
الأسئلة الشائعة (FAQ)
لماذا يكلف Sonnet 5.5 أقل لكل مهمة إذا كان سعر الرمز مطابقاً لـ Sonnet 5؟
هل يمكن لـ Claude Sonnet 5.5 استبدال Opus 5.5 في هندسة البرمجيات؟
كيف يؤثر التخزين المؤقت للمطالبات على تكاليف التشغيل في وكلاء البرمجة؟
أفكار رئيسية للفرق الهندسية
يعكس إصدار Claude Sonnet 5.5 تطوراً صناعياً من قياس المعلمات غير المقيد نحو كفاءة المهام التشغيلية. لا تتطلب منصات هندسة البرمجيات عالية الإنتاجية بالضرورة العبء الحسابي للنماذج الرائدة في كل مرحلة تشغيلية. عندما يقوم نموذج متوسط بحل مهام قاعدة الكود المحددة في تكرارات أقل، يصبح تطوير البرمجيات المؤتمتة أكثر فعالية من حيث التكلفة عند النشر على نطاق واسع.
الاستفادة من مكاسب الكفاءة هذه تتطلب إنشاء بنية منضبطة: توجيه المهام ديناميكياً بناءً على التعقيد، وفرض حدود استخدام الأدوات، وتطبيق التخزين المؤقت للمطالبات بشكل منهجي. مع استمرار مزودي النماذج الأساسية في تحسين كفاءة الرموز جنباً إلى جنب مع التفكير الخام، ستحافظ الفرق الهندسية التي تصمم خطوط أنابيب معيارية ومراقبة التكاليف على أكثر سير عمل إنتاجية استدامة وقابلية للتوسع.
المراجع
-
Anthropic. تقديم Claude Sonnet 5.5.
-
Anthropic. بطاقة نظام Claude Sonnet 5.5.
-
Anthropic. أسعار Claude API وتوطين البيانات.
-
Anthropic. شروط الخدمة التجارية وسياسة الاحتفاظ بالبيانات.
-
VentureBeat. Anthropic تطلق Claude Sonnet 5.5 مع خفض تكلفة المهام بنسبة 30%.
-
TechCrunch. Anthropic تطلق Sonnet 5.5 كشريك عمل أرخص وأسرع بكثير.
Share this article



