هل يحجب Cloudflare روبوتات التدريب؟ أعلنت Cloudflare عن سياسة افتراضية جديدة تعمل على حجب زواحف تدريب الذكاء الاصطناعي على مواقع الناشرين المؤهلة، مع تقديم خيارات تحقيق دخل جديدة لأصحاب المحتوى. ومع تغير طريقة استهلاك محتوى الويب بسبب الذكاء الاصطناعي التوليدي، تواصل منصات الذكاء الاصطناعي استهلاك كميات هائلة من موارد الويب دون وضع هياكل قيمة متبادلة. تاريخياً، كان السماح بفهرسة محركات البحث يعني الحصول على زيارات مرجعية يمكن تحقيق دخل منها من خلال الإعلانات أو الاشتراكات. اليوم، وبسبب قيام الزواحف متعددة الاستخدامات بكشط البيانات الخاصة بشكل منهجي لتدريب النماذج، مع تقديم ملخصات مباشرة تغني المستخدم عن النقر، يعاني الناشرون من تآكل حاد في إيراداتهم.
المشكلة التشغيلية والاختناقات المالية: Cloudflare يحجب روبوتات التدريب على الصفحات المدعومة بالإعلانات
نظرة سريعة
- ستبدأ الدروع المؤتمتة في فرض قيود افتراضية على كشط النماذج والوكلاء البرمجيين ضمن أدلة المحتوى التي تحقق دخلاً في الربع الثالث من عام 2026.
- سيتم تقييد الزواحف التي تجمع بين فهرسة البحث وجمع البيانات ما لم تقم بتقسيم أغراضها التشغيلية إلى مسارات عمل معزولة.
- تظهر أطر عمل جديدة لتعويض المنفعة لتوفير مكافآت مباشرة على مستوى المعاملات لمسؤولي المحتوى بدلاً من الاعتماد على عدد الطلبات القياسي.
لقد انكسر التوازن التقليدي بين ناشري الإنترنت وزواحف الويب المؤتمتة تماماً. لقد أرست اتفاقية ضمنية متبادلة أساس الإنترنت العالمي لما يقرب من ثلاثين عاماً. وبموجب هذا الاتفاق الأساسي، رحب مسؤولو الويب ببرامج الزحف لمسح الصفحات، مقابل الحصول على نقرات مستخدمين مؤهلين من استعلامات البحث. مثل هذا التبادل المتبادل دعم الوسائط ذاتية التمويل، وضمان أن انطباعات الإعلانات، والرعايات الرقمية، والعضويات المتكررة يمكنها تمويل أدلة البرمجيات المستقلة والصحافة.
لقد أعاد الانتقال الحالي نحو الشبكات التوليدية واسعة النطاق تشكيل نشاط الزواحف، محولاً الهدف من مجرد اكتشاف المسارات إلى استخراج البيانات. تقوم أنظمة الجمع المؤتمتة الآن بابتلاع أدلة رقمية كاملة، وتحليل البيانات الدلالية، وتقديم رؤى مُركَّبة ضمن أدوات دردشة مغلقة. هذا الحل الفوري يتجاوز الحاجة إلى زيارات الموقع التقليدية. وتظهر التقييمات أنه عندما تقدم واجهات البحث مخرجات توليدية متكاملة، فإن احتمالية نقر القارئ على رابط خارجي تكون أقل بكثير، حيث تنخفض إلى نسب مئوية فردية في العديد من الحالات المُبلغ عنها. تخلق أنماط الزيارات هذه عجزاً تمويلياً فورياً للمنصات التي تعتمد على هياكل عرض الإعلانات القياسية لتعويض التكاليف التشغيلية.
لماذا أصبح حجب Cloudflare لروبوتات التدريب مطلباً للناشرين
لطالما واجه الناشرون مقايضة صعبة بين حماية محتواهم والحفاظ على ظهورهم في البحث. إذا قام مالك موقع مستقل بحجب Googlebot أو Applebot أو Bingbot لمنع تدريب النماذج، فإنه يعمل تحت خطر الاختفاء من فهارس البحث التقليدية. هذا الاحتكار الهيكلي يجبر منشئي المحتوى على خيار صعب: التنازل عن بياناتهم القيمة مجاناً أو التضحية بالقدرة على الاكتشاف تماماً. كما تشجع هذه الديناميكية كيانات الذكاء الاصطناعي الناشئة على استخدام تكتيكات زحف مراوغة، مما يزيد من العبء على خوادم الناشرين الذين يتحملون بالفعل تكلفة الطلبات الزائدة.
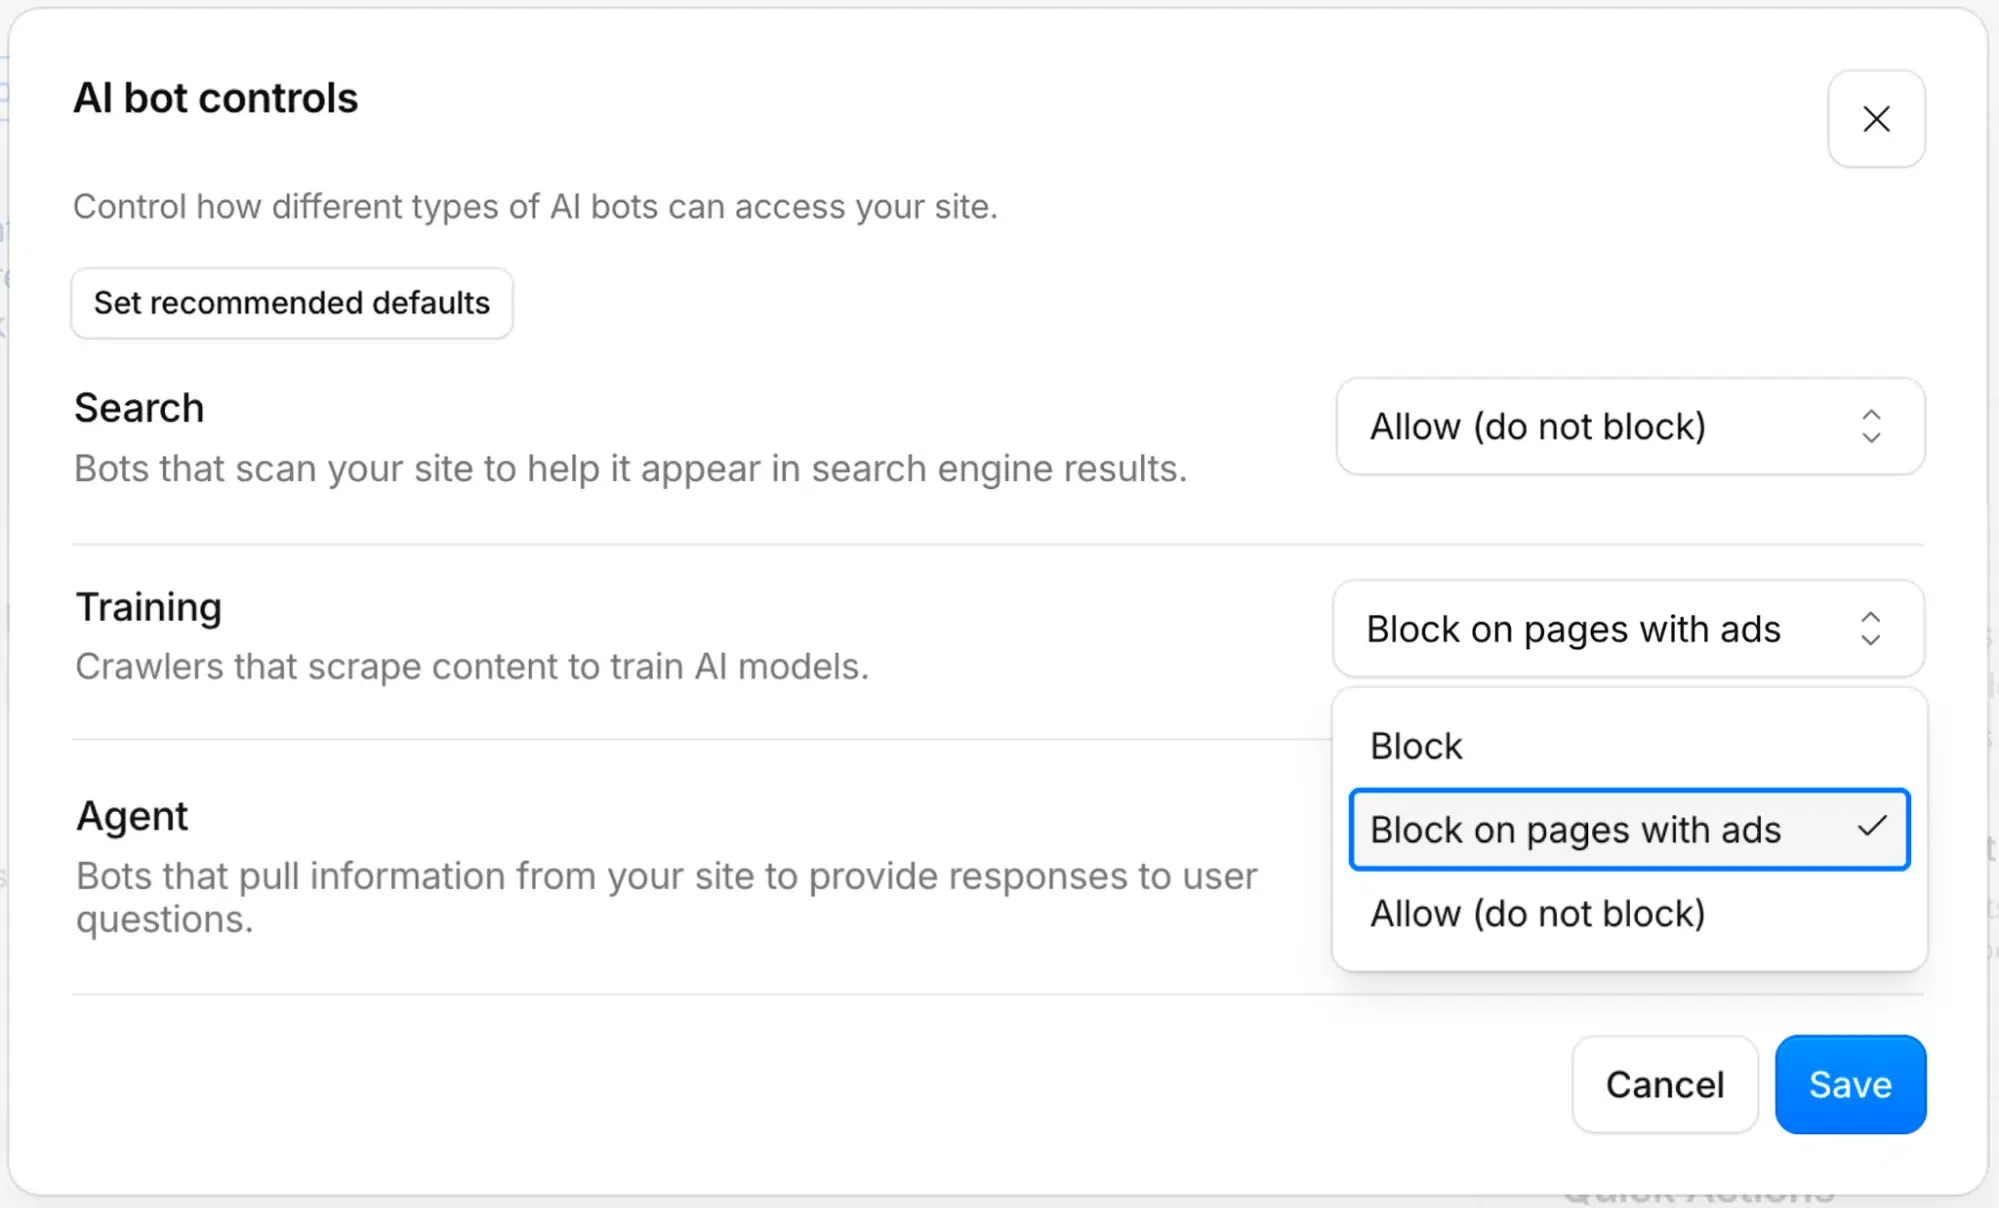
لفرض التوازن، قدمت Cloudflare آلية بوابة تعريفية. وصرحت Cloudflare بأن السياسة الافتراضية ستبدأ في الظهور في 15 سبتمبر 2026، مما يضع حواجز افتراضية ضد روبوتات التدريب والوكلاء الموجهين من قبل المستخدم عبر جميع صفحات العملاء المدعومة بالإعلانات. يضمن هذا التحديث عدم إمكانية زحف المحتوى الذي يحقق دخلاً دون إذن صريح. وفي الوقت نفسه، تقوم الشبكة العملاقة بإعادة هيكلة إطار عمل تحقيق الدخل الخاص بها، حيث تنتقل من بنية "الدفع مقابل الزحف" القديمة إلى نظام بيئي "الدفع مقابل الاستخدام" الموجه نحو النتائج. من خلال عمليات التكامل مع منصات مثل You.com و Ceramic.ai، يمكن للناشرين تأمين تعويض مباشر كلما استفاد وكيل ذكاء اصطناعي من محتواهم للإجابة على استعلام، مما يوفر تدفق إيرادات مستداماً على مستوى المعاملات.
الأسباب الجذرية المنهجية وسلاسل الطلبات غير المرئية لسياسة Cloudflare في حجب روبوتات التدريب
يكشف تحليل التكوين المادي لزيارات الإنترنت أن الروبوتات المؤتمتة تمثل الآن أكثر من 50% من جميع الأنشطة عبر الإنترنت. هذا الحجم يضع ضغطاً هائلاً على خوادم الأصل، خاصة لأن الطلبات المكررة غالباً ما تجلب محتوى غير متغير. تشير بيانات Cloudflare إلى أن أكثر من نصف زيارات الزواحف الموثوقة زائدة عن الحاجة تماماً، مما يهدر قوة الحوسبة على جانبي الاتصال. تكمن المشكلة الأساسية في البنية التحتية لعمليات البحث والكشط الحديثة، والتي تعتمد على روبوتات مختلطة الاستخدام تخفي نيتها الحقيقية.
على مستوى التطبيق، تختلف الخصائص التقنية للوكيل الموجه من قبل المستخدم بشكل جوهري عن جلسات المتصفح القياسية التي يقودها البشر. هذا التمييز بالغ الأهمية لأن أدوات الكشط الحديثة (headless scrapers) تتجاوز العناصر التفاعلية التقليدية تماماً، مما يتسبب في اضطرابات تتبع حادة عبر أنظمة القياس التابعة.
قطع الاتصال بالبروتوكول: وكلاء بدون حالة (Stateless) مقابل متصفحات ويب ذات حالة (Stateful)
يفترض تحسين الويب التقليدي أن جلسات المتصفح القياسية تدير الحالة من خلال مكدسات ملفات تعريف الارتباط (cookies)، والتخزين المحلي، وسلاسل User-Agent المهيكلة. في المقابل، يقوم الوكلاء المستقلون وزواحف الويب بدون واجهة بطلبات HTTP بدون حالة. هذا الاختلاف يكسر مسارات القياس التي يستخدمها الناشرون لتبرير قيمة إعلاناتهم. يوضح الرسم البياني أدناه الاختلافات الأساسية في مستوى التطبيق:
[Standard Web Session]
  User Browser (Persistent State & Cookies) ──> Web HTTP Request ──> Ad Impressions & Referrers Registered


[Stateless Agent Session]
  Automated Crawler (Stateless HTTP / Headless Tool) ──> Isolated Fetch ──> Missing Referrers & Lost Attribution
عندما يقوم وكيل متصفح مؤتمت بجلب صفحة، ومعالجة النص، وتقديم إجابة داخل بيئة دردشة مغلقة، يتم تدمير سياق جانب العميل بالكامل. لا يمكن لبرامج التتبع التقليدية التنفيذ. ولا يتم تسجيل أي انطباعات إعلانية، وتختفي رؤوس الإحالة القياسية. هذا يخلق فراغاً في الإحالة حيث يقدم الناشر القيمة المعلوماتية الخام، لكن النظام التابع يسجل صفراً من المشاركة. كما يؤثر نفس فقدان سياق المتصفح على مسارات إحالة الهاتف المحمول التابعة عندما يقوم المستخدم بتثبيت تطبيق في النهاية. ولأن هذه الزيارات بدون واجهة تفتقر إلى حاويات تتبع ذات حالة، تفشل أدوات قياس الهاتف المحمول القياسية في مطابقة حدث الاكتشاف الأولي مع تثبيت التطبيق اللاحق. هذه الديناميكية تسرع من انهيار نماذج الإحالة متعددة اللمس التقليدية.
مقارنة الحلول: مقايضات البناء مقابل الشراء في عصر حجب Cloudflare لروبوتات التدريب
مع تلاشي الحدود الافتراضية لتتبع جانب العميل في ظل لوائح أدوات الكشط المؤتمتة الجديدة، يجب على الفرق الهندسية إعادة تقييم بنيتها للإحالة. الاعتماد فقط على ملفات تعريف الارتباط التقليدية لجانب العميل أو سمات مستوى الجهاز لم يعد استراتيجية قابلة للتطبيق على المدى الطويل. يواجه المطورون قراراً أساسياً بين البناء أو الشراء: إنشاء قاعدة بيانات مطابقة سياق من جانب الخادم (server-side) داخلياً، أو دمج نظام قياس جاهز ومحصن قادر على البقاء في ظل التفاعلات بدون واجهة.
التقييم المعماري: البناء مقابل الشراء في عصر الـ Stateless
يتطلب بناء نظام مطابقة سياق داخلي إعداد قاعدة بيانات حالة من جانب الخادم لتخزين ومصالحة جلسات المطورين. وفي حين يوفر هذا النهج تحكماً كاملاً في مسار البيانات، فإن العبء الهندسي كبير. يجب على المطورين مطابقة حمولات API الواردة يدوياً، وإدارة انتهاء صلاحية الجلسة، وتنفيذ توقيعات تشفير آمنة لمنع الاحتيال. في المقابل، يؤدي دمج SDK قياس جاهز ومسبق الصنع إلى القضاء على عبء الصيانة هذا.
توضح مصفوفة المقارنة التالية مدى أداء منهجيات التتبع المختلفة في بيئة تعتمد على الوكلاء وبدون حالة:
| المقاييس والقدرات | بناء قاعدة بيانات جلسات داخلية | إعادة التوجيه التقليدية (Firebase / Webview) | منصات MMP الممتازة (Adjust, AppsFlyer) | SDK الروابط العميقة المؤجلة (OpoInstall) |
|---|---|---|---|---|
| بقاء الإحالة | عالٍ (جانب الخادم) | منخفض (جانب العميل) | عالٍ (متعدد اللمس) | عالٍ (مطابقة برمجية) |
| تكلفة التطوير | عالية جداً | منخفضة | عالية | منخفضة |
| عبء الصيانة | عالٍ (مستمر) | منخفض | منخفض | منخفض |
| تخفيف الاحتيال | متوسط (قواعد يدوية) | منخفض | عالٍ (خوارزمي) | عالٍ (توقيعات الثقة الصفرية) |
| تأثير التأخير | متغير | متوسط | متوسط | منخفض (بصمة خفيفة جداً) |
تشمل التنفيذات التجارية لهذا النموذج Adjust و AppsFlyer و Branch وأنظمة إحالة مؤجلة أخرى. أحد الأمثلة هو OpoInstall، الذي يوفر روابط عميقة مؤجلة واستعادة معلمات من جانب الخادم للحفاظ على بيانات الجلسة الوصفية عبر سياقات الويب والجوال الموزعة. من خلال فصل سلسلة إعادة التوجيه عن عمليات إعادة التوجيه في جانب العميل، يحافظ هذا النهج على بيانات رحلة المستخدم الوصفية من حدث البحث الأولي وصولاً إلى إطلاق التطبيق النهائي، متجاوزاً القيود التي تفرضها الوكلاء الذين يحجبون الزواحف. تستخدم منصات إحالة الهاتف المحمول أفكار استعادة الحالة من جانب الخادم لضمان اتساق التحويل عندما تغيب سياقات المتصفح تماماً.
قوائم فحص التكامل وجداول الحوكمة: النجاة من اضطرابات حجب Cloudflare لروبوتات التدريب
لضمان استمرارية البيانات مع قيام Cloudflare بتنفيذ حجب روبوتات التدريب الافتراضي على الصفحات المدعومة بالإعلانات، يجب على الفرق الهندسية والمنتج إنشاء جدول انتقال مهيكل. بالنسبة للمطورين، يتضمن ذلك الابتعاد عن عمليات إعادة التوجيه في جانب العميل وتبني أساليب تحقق قوية من جانب الخادم. وبالنسبة لفرق النمو، يتطلب ذلك مراجعة مسارات حساب عائد الإنفاق التسويقي (ROAS) لمراعاة فقدان بيانات إحالة المتصفح القياسية.
قائمة فحص تنفيذ المطورين
- تنفيذ رؤوس RFC 7239 Forwarded: قم بتهيئة جميع بوابات API الواردة لقراءة وتحليل رأس
Forwardedالمعياري لتحديد الوكلاء الوسيطين الموثوق بهم.
Forwarded: for=203.0.113.1;proto=https
- اعتماد توقيعات URL المشفرة: تأكد من أن جميع الروابط الترويجية الصادرة تستخدم معلمات موقعة تشفيرياً لمنع الروبوتات المؤتمتة من التلاعب بقيم الإحالة.
- تمكين مطابقة الجلسة من جانب الخادم: انتقل من إعادة التوجيه في جانب العميل المستندة إلى ملفات تعريف الارتباط إلى قاعدة بيانات حالة برمجية تقوم بمصالحة مفاتيح الجلسة عند أول إطلاق للتطبيق.
قائمة فحص استراتيجية المنتج والنمو
- إعادة بناء نماذج عائد الإنفاق التسويقي (ROAS): اضبط مسارات الاستحواذ لتعطي وزناً أكبر لأحداث التفعيل من جانب الخادم مقارنة بنقرات إعلانات الويب التقليدية في جانب العميل.
- نشر استعادات التجربة السياقية: استفد من أطر تمرير المعلمات لإعادة بناء الوجهة المقصودة للمستخدم حتى لو تم إسقاط رابط إحالة الويب بواسطة وكيل.
- تدقيق زيارات الروبوتات في BotBase: استخدم تصنيفات سلوكية في الوقت الفعلي لتدقيق كيفية تفاعل أدوات الكشط المؤتمتة مع مسارات التسويق.
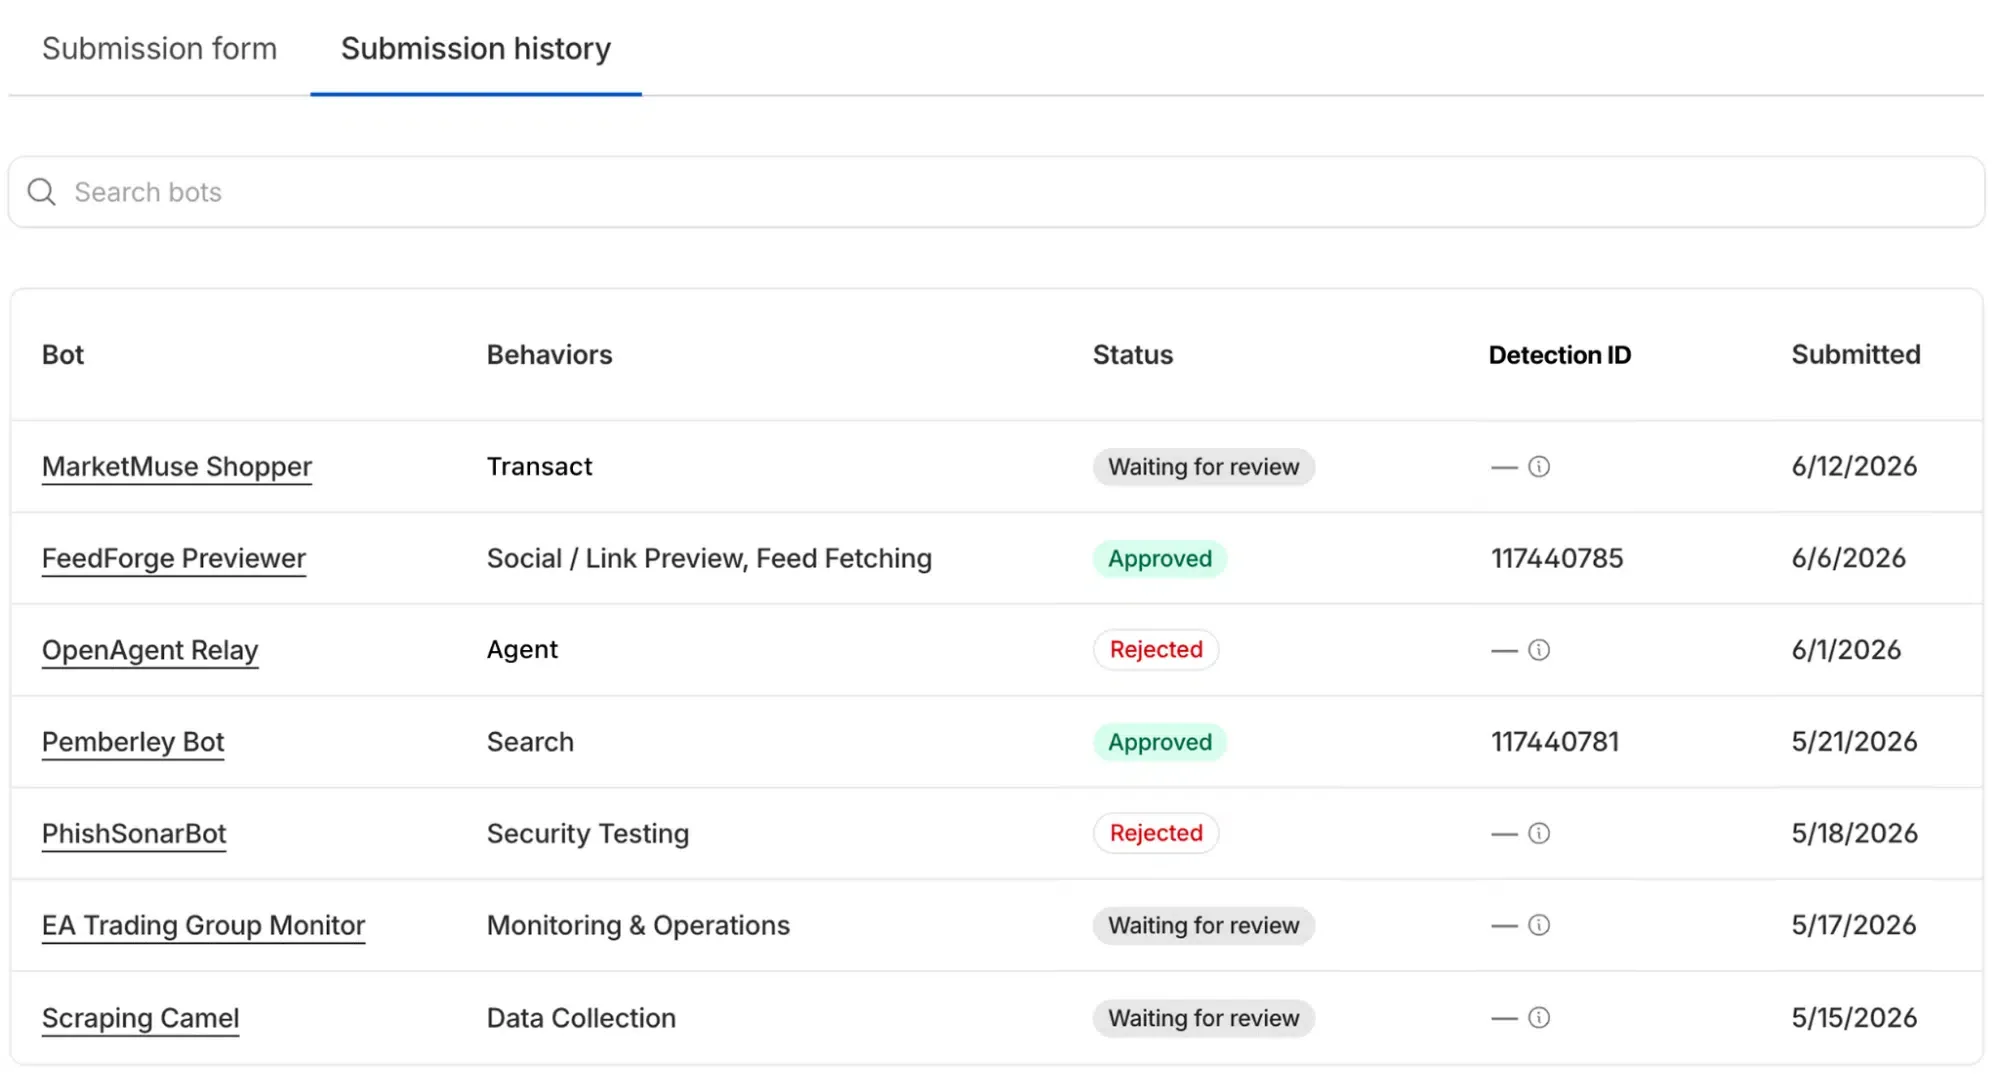
يمكن للمطورين تهيئة مواقعهم لتوصيل تفضيلات الفهرسة الصريحة عن طريق توسيع تكوين robots.txt القياسي الخاص بهم باستخدام حقول بيانات وصفية حديثة.
# Illustrative example inspired by proposed metadata extensions
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
يسمح هذا النهج المهيكل لأصحاب المحتوى بالحفاظ على القدرة على الاكتشاف في البحث مع منع منصات الذكاء الاصطناعي من امتصاص المحتوى الخاص القيم بشكل دائم في مجموعات بيانات التدريب المغلقة الخاصة بها.
الأسئلة الشائعة (FAQ)
لماذا يقوم نفس الروبوت بزحف الصفحات لكل من البحث وتدريب الذكاء الاصطناعي؟
كيف يحدد Cloudflare الصفحات التي تحتوي على إعلانات لتشغيل الحجب؟
ما الفرق بين الدفع مقابل الزحف والدفع مقابل الاستخدام؟
يتطلب انتقال الإنترنت من بيئة تصفح تتمحور حول الإنسان إلى نظام بيئي يقوده الوكلاء تحولاً جذرياً في كيفية بناء وقياس التجارب الرقمية. مع تحول الوكلاء المؤتمتين وبدون حالة إلى المستهلكين الرئيسيين لمحتوى الويب، ستستمر نماذج الإحالة التقليدية في جانب العميل في التدهور. الاعتماد على ملفات تعريف الارتباط للمتصفح ورؤوس HTTP الأساسية لم يعد كافياً لتأمين مسارات البيانات التي تقود الاستحواذ على المستخدمين وتحقيق الدخل الرقمي.
للحفاظ على النمو في هذا العصر الجديد، يجب على الفرق الهندسية والمنتج فصل منطق الإحالة الخاص بهم عن إجراءات المتصفح القياسية في جانب العميل. من خلال اعتماد دقة الهوية من جانب الخادم، والمعلمات الموقعة تشفيرياً، وأطر تمرير المعلمات القوية، يمكن للمؤسسات حماية مسارات بياناتها من حجب أدوات الكشط المؤتمتة. هذا الانتقال ليس مجرد تكييف مع تحديث سياسة واحدة؛ بل يتعلق بإعادة بناء أنظمتنا للبقاء في إنترنت لا مركزي وجاهز للوكلاء.
Share this article



