Anthropic Sonnet 5.5: 30% schneller? Anthropic hat offiziell Claude Sonnet 5.5 veröffentlicht. Laut dem Labor bietet das Modell eine über 30% schnellere Generierung der Ausgaben und bis zu 30% geringere Kosten pro abgeschlossener Aufgabe. Während sich Plattformen für generative KI von experimentellen Prototypen zu produktiven Systemen mit hohem Durchsatz entwickeln, stehen Software-Entwicklungsteams unter wachsendem Druck, Token-Verbrauch und Laufzeitlatenz zu kontrollieren. In der Vergangenheit gingen Enterprise-Architekten davon aus, dass für erstklassige Codierungsleistung die größten und teuersten Flaggschiff-Modelle erforderlich seien. Da optimierte Architekturen der mittleren Leistungsklasse heute komplexe Software-Herausforderungen mit weniger operativen Schritten und Tool-Aufrufen lösen können, verlagert sich die grundlegende Ökonomie automatisierter Entwickler-Tools hin zur Effizienz bei der Ausführung.
Produktionsökonomie: Warum die Kosten pro Aufgabe wichtiger sind als der Token-Preis
Auf einen Blick
- Anthropic veröffentlichte Claude Sonnet 5.5 am 28. September 2026 mit über 30% schnellerer Ausgabe und bis zu 30% niedrigeren Kosten pro Aufgabe.
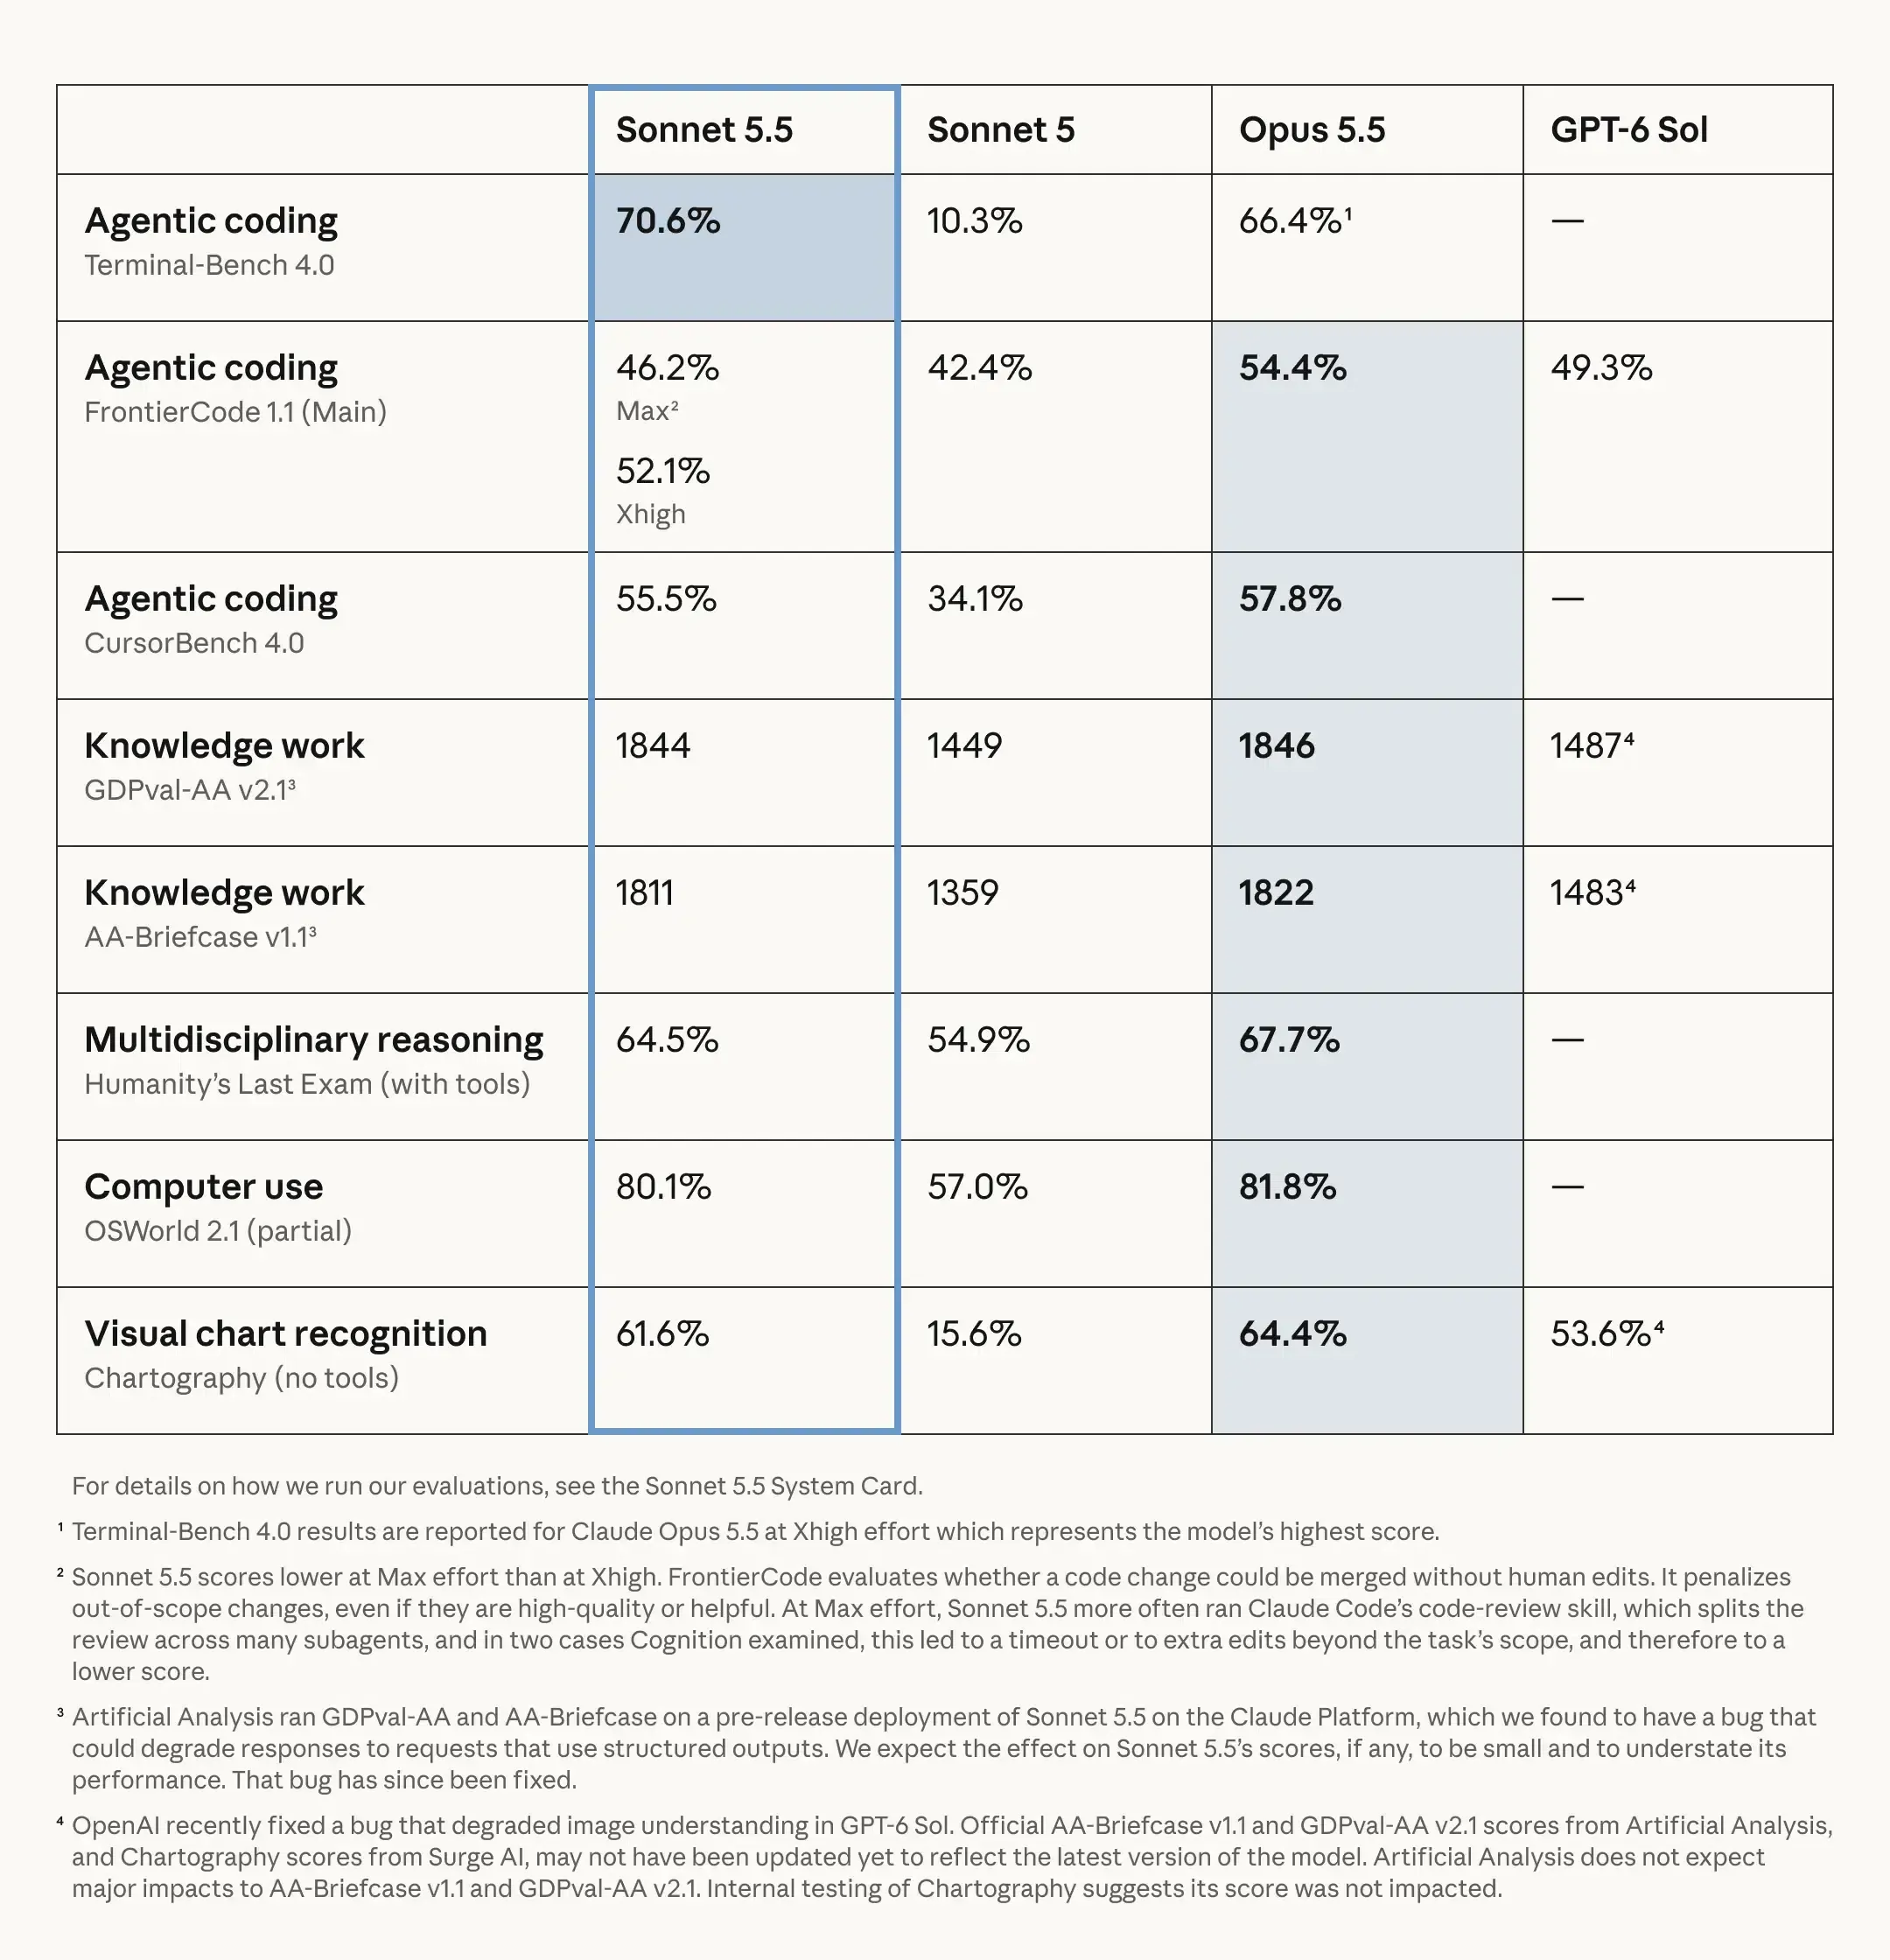
- Beim agentenbasierten Codierungs-Benchmark Terminal-Bench 4.0 erzielte Sonnet 5.5 70,6% und übertraf damit das Flaggschiff Claude Opus 5.5 mit 66,4% sowie Sonnet 5 mit 10,3%.
- Die Preise für API-Token bleiben bei $2 pro Million Input-Token und $10 pro Million Output-Token stabil; Kosteneinsparungen ergeben sich durch weniger Ausführungsschritte und gebündelte Tool-Aufrufe.
Die wirtschaftliche Rentabilität beim Einsatz autonomer Software-Agenten stieß in der Vergangenheit oft an harte ökonomische Grenzen. Das Ausführen mehrstufiger Entwickler-Tools, die Codebasen untersuchen, Shell-Befehle ausführen und iterativ Unit-Tests korrigieren, verbraucht enorme Token-Volumina. Während erstklassige Spitzenmodelle bemerkenswerte Argumentationstiefe zeigen, machen ihre hohen Token-Kosten und erhöhte Latenz bei der Generierung eine kontinuierliche, unbeaufsichtigte Ausführung für skalierende Software-Unternehmen teuer.
Bei der Bewertung der Entwickler-Infrastruktur verdeckt der API-Listenpreis oft die tatsächlichen Kosten einer Aufgabe. Ein Modell mit niedrigen Preisen pro Token, das jedoch dutzende Male wiederholte Tool-Aufrufe und Retries durchführt, ist letztlich deutlich teurer als ein Modell, das Probleme in weniger Schritten löst. Diese Dynamik wird in Branchenberichten zu Sonnet 5.5 beleuchtet, die aufzeigen, wie sich die Kosten für die Aufgabenbewältigung von den reinen Token-Listenpreisen entkoppeln.
Anthropic hat Claude Sonnet 5.5 strukturell darauf ausgelegt, diese operativen Engpässe direkt anzugehen. Unter Beibehaltung der Basis-API-Preise von $2 pro Million Input-Token und $10 pro Million Output-Token erreicht das Modell eine Senkung der Netto-Aufgabenkosten um bis zu 30%, da es wesentlich weniger logische Schritte benötigt. Veröffentlichte Berichte von Anthropic-Kunden zeigen deutliche Effizienzgewinne in Produktions-Workloads:
- Box berichtete, dass Sonnet 5.5 2,4-mal schneller arbeitete und dabei 12% weniger Gesamttoken verbrauchte, um Quelldokumente zu prüfen und Code-Regressionen zu identifizieren.
- Zendesk beobachtete, dass Support-Tickets 20% schneller und mit weniger automatisierten Entscheidungsfehlern bearbeitet wurden als bei bestehenden Produktionsmodellen.
- Slack zeigte, dass das Modell bei Offline-Bot-Bewertungen ohne Prompt-Anpassungen besser abschnitt als Sonnet 5 und dabei etwa 14% weniger Output-Token verbrauchte.
- Lovable stellte fest, dass Sonnet 5.5 bei automatisierten Anwendungs-Builds etwa ein Drittel weniger Tool-Aufrufe und halb so viele Shell-Ausführungen benötigte.
- Base44 verifizierte, dass das Modell vollständige Anwendungs-Builds in durchschnittlich 3,6 Iterationen abschloss, im Vergleich zu 7,7 Iterationen bei Opus 5.
Diese Ergebnisse veranschaulichen, wie Ausführungseffizienz die Produktivität der Entwickler grundlegend verändert. Durch die Reduzierung fehlgeschlagener Tool-Aufrufe und die Eliminierung redundanter Iterationen bieten Modelle der mittleren Leistungsklasse ein nachhaltiges Fundament für kontinuierliche Automatisierung im Unternehmen.
Technische Analyse: Bewertung von Codierungs-Benchmarks und Subagent-Skalierung
Dass Modelle der mittleren Leistungsklasse bei bestimmten technischen Benchmarks Flaggschiffe übertreffen, spiegelt einen Wandel im Post-Training von Foundation-Modellen wider. Frühe Skalierungsgesetze legten nahe, dass die reine Parameteranzahl der primäre Bestimmungsfaktor für die Modellintelligenz sei. Komplexe agentische Aufgaben – etwa das Navigieren in Terminal-Umgebungen und das Bearbeiten umfangreicher Repositories – hängen jedoch stark von Kontextmanagement, präziser Disziplin beim Tool-Einsatz und der Kontrolle des Aufgabenbereichs ab.
Flaggschiff-Modelle wie Opus 5.5 verfügen über immense Argumentationskapazitäten und brillieren bei mehrdeutigen, offenen architektonischen Entscheidungen. Doch eine zu tiefe Argumentationslogik kann bei präzise definierten Aufgaben gelegentlich operativen Overhead erzeugen. Bei den FrontierCode-Benchmark-Auswertungen stellte Anthropic beispielsweise fest, dass Sonnet 5.5 bei maximalem Aufwand schlechter abschnitt als bei "Xhigh", da es häufiger die Code-Review-Fähigkeit von Claude Code aufrief. Diese Fähigkeit teilte Reviews auf mehrere Subagenten auf, was in den untersuchten Fällen zu Timeouts oder unzulässigen Änderungen führte, die vom Benchmark-Tool bestraft wurden. Im Gegensatz dazu eignet sich Sonnet 5.5 bei Standardaufwand besonders gut für begrenzte, wohldefinierte Ausführungen: Es analysiert schnell Repository-Strukturen, bewertet Änderungsvorschläge und arbeitet innerhalb klar definierter Dateigrenzen.
Benchmark-Vergleich: Terminal-Bench, CursorBench und GDPval-AA
Die veröffentlichten Bewertungen von Anthropic zeigen, dass Sonnet 5.5 in alltäglichen technischen Bereichen mit Top-Benchmarks gleichzieht oder diese übertrifft. Bei Terminal-Bench 4.0, das die mehrstufige Befehlszeilen-Problemlösung bewertet, erreichte Sonnet 5.5 70,6% und übertraf damit Opus 5.5 mit 66,4% sowie Sonnet 5 mit 10,3%. Bei CursorBench 4.0, das auf realen Cursor-Entwicklersitzungen basiert, erreichte Sonnet 5.5 55,5% und lag damit nur gut zwei Prozentpunkte hinter Opus 5.5 (57,8%). Zudem erzielte Sonnet 5.5 beim GDPval-AA v2.1, das reale professionelle Aufgaben in 44 Berufen misst, ein Elo-Rating von 1844 und liegt damit dicht am Wert von Opus 5.5 (1846).
Um zu verstehen, wie optimierte Modelle die autonome Ausführung beschleunigen, betrachten wir die Unterschiede im Arbeitsablauf:
[Monolithische Flaggschiff-Agenten-Schleife]
  Nutzer-Prompt ──> Schwere Argumentationskette ──> Ausufernde Tool-Aufrufe (Hoher Token-Verbrauch) ──> Risiko für Überbearbeitung & Timeouts

[Optimierte Mid-Tier-Agenten-Schleife]
  Nutzer-Prompt ──> Abgegrenztes Intent-Mapping ──> Gebündelte Tool-Aufrufe ──> Weniger Ausführungsschritte ──> Präziser Patch geliefert
Diese gestraffte Ausführungsschleife kann Möglichkeiten für Kontextdrift und unnötige Hin-und-Her-Kommunikation reduzieren. Anthropic berichtet von über 30% schnellerer Generierung bei gleichzeitig geringerer Schrittanzahl im Vergleich zu Sonnet 5. Das Modell bündelt Tool-Aufrufe, wodurch die Latenz zwischen der Agenten-Laufzeit und der Host-Umgebung minimiert wird.
Sonnet 5.5 führt zudem Sicherheitsinfrastruktur der ersten Stufe in die mittlere Leistungsklasse ein. Es ist die erste Sonnet-Variante, die mit Cybersecurity-Schutzmaßnahmen ausgestattet ist, die denen von Opus 5.5 ähneln. Aufgaben mit hoher Gefahr für Sicherheitslücken fallen automatisch auf frühere Architekturen zurück, während autorisierte Verteidiger durch das Cyber Verification Program abgestufte Berechtigungen erhalten. Zusätzlich beinhaltet das System Sicherheitsklassifizierer, um die Extraktion logischer Schlussfolgerungen in industriellem Maßstab zu reduzieren und das gespeicherte Wissen an das ursprüngliche Konto zu binden.
Architekturstrategie: Zuweisung von Workloads zwischen Frontier- und Mid-Tier-Modellen
Da sich KI-Foundation-Modelle in Engines für extrem tiefes logisches Denken und agile Ausführungsmodelle aufspalten, müssen Engineering-Führungskräfte neu bewerten, wie sie Modellstufen über den Softwareentwicklungszyklus hinweg zuweisen. Der Einsatz eines einzigen Flaggschiff-Modells über die gesamte Pipeline hinweg erzeugt unnötige Latenz und Kosten. Stattdessen setzt moderne Entwickler-Infrastruktur zunehmend auf dynamisches Modell-Routing, bei dem Aufgaben basierend auf struktureller Komplexität zugewiesen werden.
Bei der Architektur von Produktions-Workflows müssen Teams die Kompromisse zwischen tiefer konzeptioneller Argumentation und hochdurchsatzfähiger Aufgabenlösung abwägen. Während Flaggschiff-Modelle für breite architektonische Planungen unverzichtbar bleiben, erledigen Zwischenmodelle den Großteil der täglichen Code-Ausführung mit überlegener Reaktionszeit.
Die folgende Entscheidungsmatrix verdeutlicht die technische Ausrichtung der Modellstufen:
| Workload-Kategorie | Primäre Modellwahl | Kostenprofil | Latenzprofil | Am besten für |
|---|---|---|---|---|
| Routine-Bugfixes & PR-Reviews | Claude Sonnet 5.5 | Niedrig ($2 / $10 pro 1M Token) | Schnell (30%+ schnellere Ausgabe) | Wohldefinierte tägliche Softwareaufgaben und CI/CD-Checks |
| Gesamt-Architektur & Migrationen | Claude Opus 5.5 | Hoch ($4 / $20 pro 1M Token) | Adaptiv, tiefe Denkzyklen | Komplexes, unklares Refactoring |
| Interaktives Prototyping & UI-Design | Claude Sonnet 5.5 | Niedrig ($2 / $10 pro 1M Token) | Schnelle, reaktionsfähige Iteration | Design von User Flows und Frontend-Gerüsten |
| Fortgeschrittene Security-Forschung | Verifizierte Claude-Modelle | Je nach Modell/Zugang | Gründliche, mehrstufige Verifizierung | Autorisierte Security-Forschung |
Anthropic strukturiert Cybersicherheitsfunktionen durch abgestufte Schutzmaßnahmen. Während routinemäßige Behebung von Schwachstellen normal mit Sonnet 5.5 erfolgt, greifen risikoreichere Aufgaben automatisch auf frühere Architekturen zurück. Für autorisierte Sicherheitsexperten in der fortgeschrittenen Forschung wird der Zugang zu erweiterten Fähigkeiten über das mehrstufige Cyber Verification Program gesteuert.
Durch die Etablierung dynamischer Routing-Regeln können Engineering-Organisationen Routine-Reviews von Pull-Requests, Unit-Test-Generierung und Bug-Lokalisierung an Sonnet 5.5 leiten. Dies bewahrt die Kapazität des erstklassigen Opus-Modells für hochkomplexe architektonische Umstellungen und hält die Budgets berechenbar, ohne die Zuverlässigkeit der Software zu gefährden.
Integrations-Checklisten: Sonnet 5.5 in Enterprise-CI/CD
Da Software-Organisationen schnelle, kosteneffiziente Modelle wie Sonnet 5.5 in ihre Produktions-Pipelines integrieren, müssen Entwicklungsteams robuste Governance-Pläne aufstellen. Die Maximierung von Einsparungen erfordert die Abstimmung der API-Parameter auf die Aufgabenkomplexität bei gleichzeitiger Vermeidung unüberwachter Agenten-Drifts.
Checkliste für die Entwickler-Implementierung
- Dynamische Aufwandsstufen konfigurieren: Nutzen Sie die nativen Einstellungen des Modells – Standard auf "Medium" in Claude-Apps und Claude Code, "High" auf der Claude-Plattform – um Argumentationstiefe gegen Token-Kosten abzuwägen.
- Prompt Caching nutzen: Implementieren Sie Prompt-Caching bei statischen System-Prompts und Repository-Maps, um einen 90%-Rabatt auf Cache-Read-Token ($0,20 pro Million Token) zu sichern.
- Asynchrone Batch-Verarbeitung: Leiten Sie nicht zeitkritische Auswertungen, automatisierte Code-Audits und Batch-Migrationen über Batch-APIs, um 50% Rabatt auf Standard-Token-Kosten zu erzielen.
- Fail-Safe-Fallback integrieren: Richten Sie programmatische Schutzschalter ein, die Anfragen beenden oder umleiten, wenn automatisierte Tool-Schleifen vordefinierte Budgets überschreiten.
Checkliste für Governance & Infrastruktur
- Abonnement-Einheitspreise neu bewerten: Berechnen Sie die marginalen Rechenkosten pro aktivem Entwickler, um festzustellen, ob Hochgeschwindigkeitsmodelle höhere Nutzungskontingente oder niedrigere Preise ermöglichen.
- Iterationsverhältnisse überwachen: Messen Sie die durchschnittliche Anzahl der für Aufgaben benötigten Tool-Ausführungen; Reduzierungen dieser Zahlen verbessern direkt die Entwicklerzufriedenheit.
- US-Only-Verarbeitung bei Bedarf: Für regulierte Unternehmenskunden mit Anforderungen an die Datenlokalität können US-only-Inferenz-Endpunkte konfiguriert werden (zu 1,1-fachem Preis unter bestimmten Enterprise-Bedingungen).
- Null-Daten-Aufbewahrung verifizieren: Bestätigen Sie den Status der Null-Daten-Aufbewahrung mit dem API-Anbieter, um Enterprise-Compliance sicherzustellen; beachten Sie jedoch, dass spezielle Features wie persistente Caches anderen Richtlinien unterliegen können.
Durch die Annahme dieser strukturierten operativen Praktiken können Software-Organisationen algorithmische Geschwindigkeit und Token-Effizienz in messbare Entwicklungsfortschritte umwandeln.
Häufig gestellte Fragen (FAQ)
Warum kostet Sonnet 5.5 weniger pro Aufgabe, wenn die Token-Preise denen von Sonnet 5 entsprechen?
Kann Claude Sonnet 5.5 Opus 5.5 in der Softwareentwicklung ersetzen?
Wie beeinflusst Prompt Caching die Betriebskosten von Coding-Agenten?
Wichtige Erkenntnisse für Engineering-Teams
Die Veröffentlichung von Claude Sonnet 5.5 spiegelt eine Entwicklung der Branche wider: weg von unbegrenzter Skalierung der Parameter, hin zur operativen Aufgabeneffizienz. Hochperformante Software-Plattformen benötigen nicht zwingend den Rechen-Overhead von Flaggschiff-Modellen für jede operative Phase. Wenn ein Zwischenmodell zuverlässig begrenzte Aufgaben in weniger Iterationen löst, wird automatisierte Softwareentwicklung in der Skalierung deutlich kosteneffizienter.
Die Nutzung dieser Effizienzgewinne erfordert eine disziplinierte Architektur: dynamisches Routing nach Komplexität, die Durchsetzung von Tool-Grenzen und die systematische Anwendung von Prompt Caching. Während Anbieter von Foundation-Modellen weiterhin Token-Effizienz neben reiner Argumentationslogik optimieren, werden Engineering-Teams, die modulare und kostenüberwachte Pipelines entwerfen, die nachhaltigsten und skalierbarsten Produktions-Workflows beibehalten.
Referenzen
-
Anthropic. Einführung in Claude Sonnet 5.5.
-
Anthropic. Claude Sonnet 5.5 System Card.
-
Anthropic. Claude API-Preise und Datenresidenz.
-
Anthropic. Kommerzielle Nutzungsbedingungen und Aufbewahrungsrichtlinien.
-
VentureBeat. Anthropic startet Claude Sonnet 5.5 mit 30% Kostenreduktion pro Aufgabe.
-
TechCrunch. Anthropic veröffentlicht Sonnet 5.5 als deutlich günstigeren und schnelleren Arbeitspartner.
-
9to5Mac. Anthropic rüstet Claude mit neuem Sonnet 5.5 Modell auf.
Share this article



