Google stellt Gemini 4 Hydrogen vor? Google DeepMind hat Gemini 4 Hydrogen am 12. November 2026 offiziell vorgestellt und positioniert das Modell als kosteneffizientes Hochdurchsatzsystem für die alltägliche Softwareentwicklung und mehrstufige agentische Workflows, wie in der offiziellen Ankündigung von Google DeepMind detailliert beschrieben. Da Softwareteams zunehmend autonome Agenten einsetzen, um Repositorien zu durchsuchen und Tests auszuführen, führt die ausschließliche Nutzung großer Frontier-Reasoning-Modelle zu spürbaren Latenzen und steigenden API-Kosten. Während tiefgehende architektonische Analysen für den Entwurf komplexer Systeme unverzichtbar bleiben, erfordern routinemäßige technische Aufgaben wie das Schreiben lokaler Anpassungen, das Ausführen von Test-Harnesses und das Parsen von Build-Protokollen eine schnelle Ausführung. Hydrogen ist so konzipiert, dass es sowohl als eigenständiges Werkzeug für die hochvolumige Entwicklung als auch als Ausführungs-Engine in Kombination mit Frontier-Modellen in Multi-Modell-Routing-Pipelines dient.
Grundlegende Branchen-Neuausrichtung: Google stellt Gemini 4 Hydrogen für Workflows mit hohem Durchsatz vor
Auf einen Blick
- Google DeepMind hat Gemini 4 Hydrogen als Hochdurchsatzmodell eingeführt, das für die Bewältigung von Routine-Codierung, Repository-Fragen und -Antworten sowie agentischen Workflows mit geringerer Latenz als Frontier-Stufen entwickelt wurde.
- Das Modell arbeitet innerhalb eines einheitlichen Kontextfensters von 1.048.576 Token, das sich auf Eingaben und Ausgaben aufteilt. Die Preise liegen bei 1,50 $ pro Million Eingabe-Token und 7,50 $ pro Million Ausgabe-Token.
- Die Verfügbarkeit erstreckt sich auf Google AI Studio, die Gemini API, Android Studio, die Google-Suche und Unternehmensplattformen, wobei die Zugriffsstufen zwischen kostenlosen Verbrauchertarifen und kostenpflichtigen Entwicklerarbeitsbereichen variieren.
Die operativen Anforderungen von Softwareentwicklungs-Workflows sind über die reine Code-Vervollständigung per Einzel-Prompt hinausgewachsen. Moderne agentische Setups lösen häufig Dutzende autonomer Schritte aus, darunter das Lesen von Verzeichnisstrukturen, das Inspizieren von Abhängigkeitsbäumen, das Vorschlagen von Patches und das Ausführen von Regressionstests. Wenn Entwickler jede Routineaktion über Frontier-Reasoning-Modelle leiten, verlangsamt sich die Aufgabenausführung erheblich. In iterativen Umgebungen können sich selbst moderate Latenzen bei einzelnen Tool-Aufrufen zu langen Verzögerungen über automatisierte Entwicklungszyklen hinweg summieren.
Branchengespräche rund um die Einführung spiegeln ein wachsendes Bewusstsein dafür wider, dass Modell-Spezialisierung für die Skalierbarkeit in der Produktion entscheidend ist. Anstatt ein einzelnes Allzweckmodell als Standardwahl für jede Entwicklungsaufgabe zu behandeln, evaluieren Teams gestaffelte Architekturen. In diesen Konfigurationen verwalten kapazitätsstarke Reasoning-Modelle das Systemdesign und die Formulierung ambivalenter Probleme, während dedizierte Ausführungsmodelle repetitive Codebasis-Operationen übernehmen. Google hat Hydrogen entwickelt, um diese operative Stufe zu adressieren, und bietet sofortige Entwicklerverfügbarkeit über Standard-API-Endpunkte und programmatische Umgebungen.
Benchmark-Analyse und technische Grenzen von Gemini 4 Hydrogen
Google beschreibt Hydrogen als eine Weiterentwicklung von Gemini 4 Carbon. Veröffentlichte technische Dokumentationen enthalten jedoch keine spezifischen internen Details zu Gewichtstransfer-Mechanismen, Tokenizer-Architekturen oder Destillations-Pipelines. Technische Bewertungen müssen sich daher auf beobachtbare Benchmark-Daten, dokumentierte Kontextgrenzen und berichtete Betriebsbeschränkungen konzentrieren anstelle von abgeleiteten internen Mechanismen.
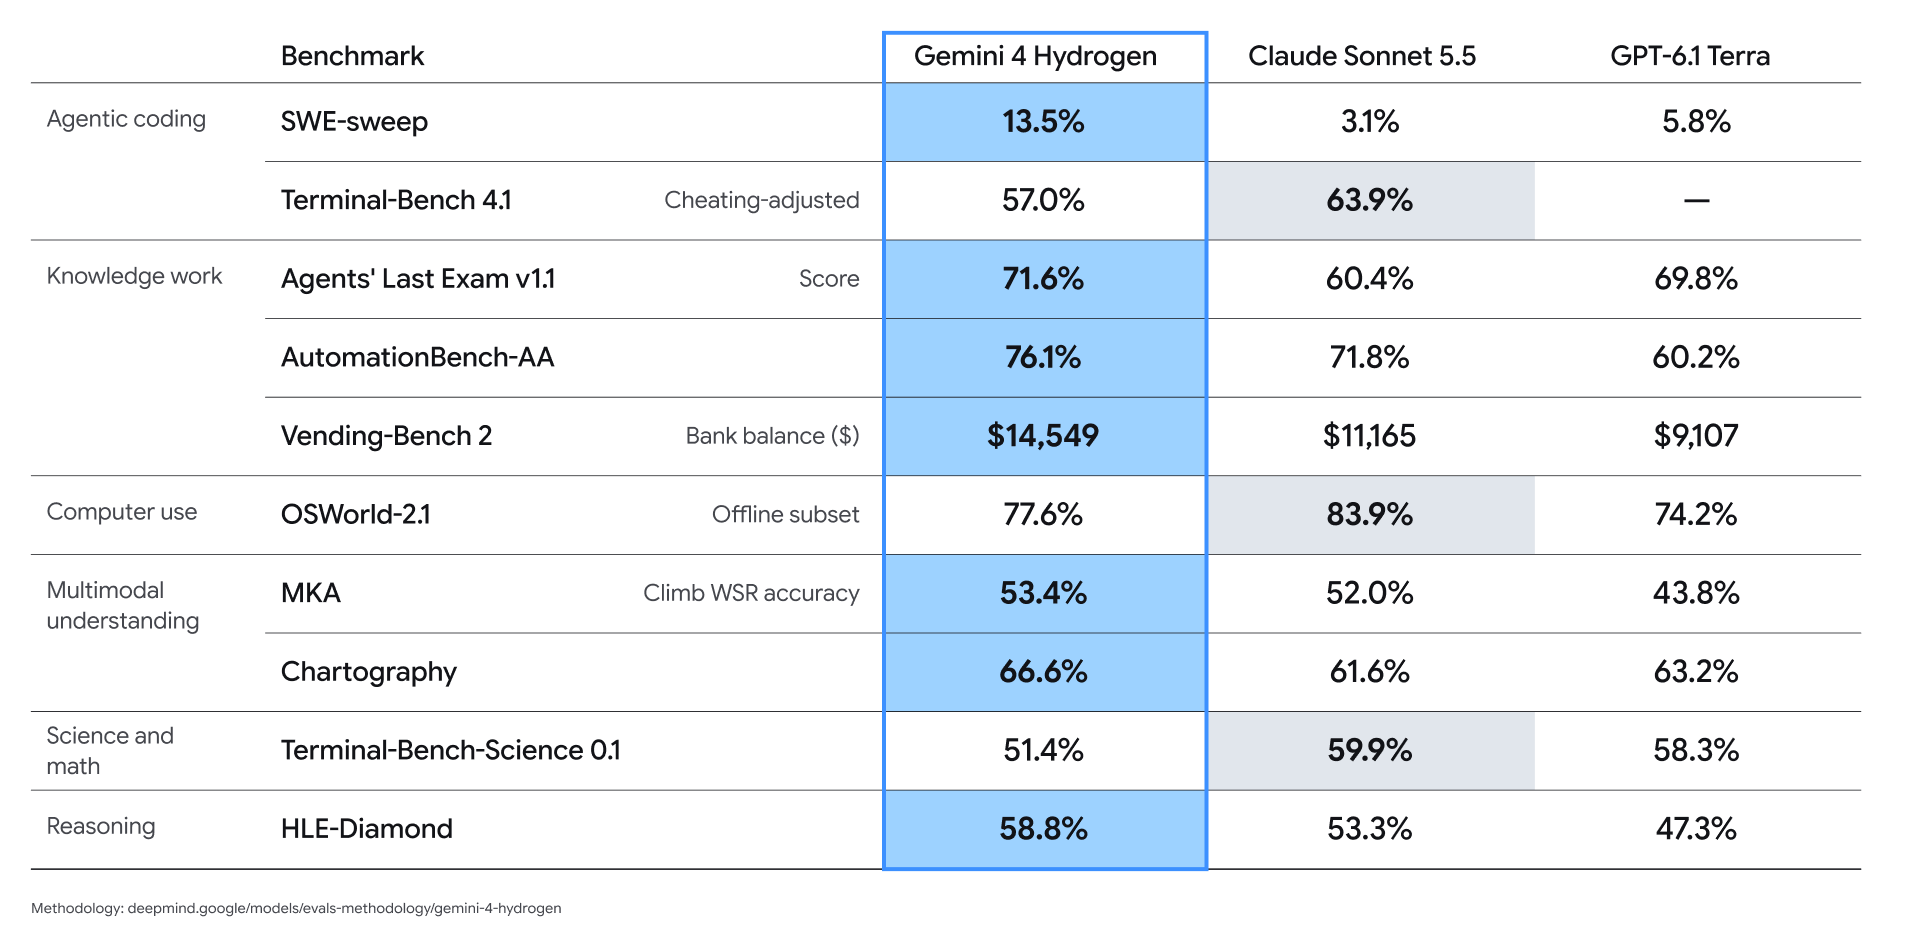
In Standardbewertungen, die in der Modellkarte zu Gemini 4 Hydrogen berichtet werden, zeigt Hydrogen klare Leistungsunterschiede über verschiedene Aufgabenkategorien hinweg. Beim SWE-Sweep-Benchmark zur Problemlösung meldete Google eine Lösungsrate von 13,5 % für Hydrogen, verglichen mit 3,1 % für Claude Sonnet 5.5 und 5,8 % für GPT-6.1 Terra unter den angegebenen Bewertungsbedingungen. Umgekehrt erreichte Hydrogen bei Terminal-Bench 4.1 unter Cheat-angepassten Parametern 57,0 %, was eine wesentliche Verbesserung gegenüber Gemini 3.8 Flash (18,2 %) darstellt, aber hinter Claude Sonnet 5.5 zurückbleibt, das 63,9 % verzeichnete. Auf dem unabhängigen Artificial Analysis Intelligence Index erzielte Hydrogen in der Standardeinstellung für hohes Nachdenken (high thinking) 51 Punkte und in der Einstellung xhigh 54 Punkte, verglichen mit 50 Punkten für das Flaggschiff Gemini 4 Argon.
Ein kritischer architektonischer Aspekt ist die Kontextkapazität des Modells, wie in der Dokumentation zum Google Cloud-Modell dokumentiert. Hydrogen bietet eine einheitliche Kontextobergrenze von 1.048.576 Token, die sich auf alle Eingaben und Ausgaben verteilt. Das bedeutet, dass umfangreiche Eingabedateien die verbleibende Token-Kapazität für Modellausgaben reduzieren. Ein einzelnes Vordergrundsegment unterstützt bis zu 65.536 Ausgabe-Token. Längere Generierungen nutzen unterstützte Fortsetzungsmechanismen, einschließlich SDK-verwalteter Fortsetzung, einer benutzerdefinierten Fortsetzungs-Token-Schleife oder serververwalteter Hintergrundausführung, sofern verfügbar. Alle Segmente unterliegen weiterhin dem gemeinsam genutzten Kontextlimit. Ausgabe-Token umfassen interne Reasoning-Token, generierte Tool-Anfragen und sichtbaren Text.
[Multi-Model Orchestrator Architecture in Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Architektonische Planung & komplexes Reasoning)
                         └───────────┬────────────┘
                                     │ Aufgaben delegieren & Plan überprüfen
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Parallele Codegenerierung & Tool-Aufrufe)
                         └───────────┬────────────┘
                                     │ Strukturierte Tool-Aufrufe
                                     ▼
                [ Lokale Laufzeit / Test-Suiten / Dateisystem ]
Um Latenz und analytische Tiefe auszugleichen, enthält Hydrogen vier konfigurierbare Reasoning-Stufen: low, medium, high (Standard) und xhigh. Niedrigere Einstellungen reduzieren die Antwortlatenz für einfache syntaktische Anpassungen, während höhere Ebenen mehr interne Reasoning-Token zuweisen, um Randfälle zu bewerten. Entwickler sollten beachten, dass dokumentierte Einschränkungen bestehen: Das Modell hat einen Wissensstopp im März 2026, kann bei schwerer Hintergrundverarbeitung gelegentlich Zeitüberschreitungen (Timeouts) erfahren und bei mehrdeutigen Prompts Halluzinationen oder übermäßige Verweigerungen erzeugen.
Entkoppelte Systeme und Kompromisse bei der Multi-Modell-Orchestrierung
Die Multi-Modell-Orchestrierung ermöglicht es Entwicklungsplattformen, Engineering-Workflows auf verschiedene Modellstufen aufzuteilen. In diesem Muster werden komplexe Systemmodellierungen und Sicherheitsbewertungen an Frontier-Reasoning-Modelle delegiert, während konkrete Code-Änderungen und Test-Assertionen schnellen Ausführungsmodellen zugewiesen werden.
Google hat diesen Ansatz unter Verwendung des experimentellen Orchestrators in Google Antigravity evaluiert. Bei Tests mit Terminal-Bench 4.0 berichtete Google, dass die dynamische Umschaltung zwischen Carbon und Hydrogen Aufgaben-Erfolgsraten nahe Carbon erzielte, während gleichzeitig 24 % weniger Kontingent verbraucht und Aufgaben 19 % schneller abgeschlossen wurden als bei der alleinigen Ausführung von Carbon. Google berichtete auch über frühe Partnertests, die eine 2- bis 2,8-mal schnellere Ausführung und eine um 12 % bis 23 % geringere Token-Nutzung im Vergleich zu Gemini 3.8 Flash bei ausgewählten Workflows zeigten. Beispielsweise berichtete Box über eine etwa doppelt so schnelle Ausführung und 12 % weniger Token bei komplexen Dokumenten- und Tabellenaufgaben. Diese vom Anbieter gemeldeten Beispiele spiegeln spezifische Integrationsumgebungen wider und stellen keine kontrollierten Schätzungen der Einsparungen über alle Produktionseinsätze hinweg dar.
| Systemkomponente | Repräsentative Werkzeuge | Definierte Verantwortung | Operativer Umfang und Einschränkungen |
|---|---|---|---|
| Systemkoordinator | Gemini 4 Carbon / Argon | High-Level-Architekturdesign, repositoryübergreifende Planung, komplexe Logikbewertung | Hohe Reasoning-Kapazität; verursacht höhere Kosten pro Token und längere Generierungslatenz |
| Ausführungs-Engine | Gemini 4 Hydrogen | Lokalisierte Codegenerierung, automatisierte Dateibearbeitungen, schnelle Tool-Aufrufschleifen | Hoher Generierungsdurchsatz; kann eigenständig oder unter einem Koordinator arbeiten |
| Verifikations-Tor | Unit-Test-Harnesses / Statische Linter | Deterministische Regelprüfung, Syntaxvalidierung, Regressionstests | Prüft definierte Zusicherungen und statische Regeln; die Absicherung hängt von Testqualität, Abdeckung und unabhängiger Überprüfung ab |
Die Evaluierung einer Multi-Modell-Architektur erfordert von Engineering-Teams, Systemkomplexität und Auseffizienz gegeneinander abzuwägen. Während dynamisches Modell-Routing die Token-Ausgaben bei repetitiven Aufgaben senken kann, führt es zu Orchestrierungs-Overhead, Herausforderungen bei der Status-Synchronisierung über Sub-Agenten hinweg und einer Abhängigkeit von Routing-Klassifikatoren. Engineering-Teams müssen diese Kompromisse anhand ihrer eigenen Aufgabenverteilungen, Repositoriumsstrukturen und API-Latenzanforderungen messen.
Checklisten für technische Implementierung und Workflow-Governance
Die Integration von Gemini 4 Hydrogen in automatisierte Entwickler-Toolchains erfordert klare Ausführungsgrenzen, Token-Überwachung und eine defensive Agenten-Governance.
Checkliste für die Entwicklerimplementierung
- Denk-Ebenen an operative Aufgaben anpassen: Konfigurieren Sie die Parameter für den Reasoning-Aufwand entsprechend der Komplexität der Arbeitslast. Reservieren Sie
xhighfür komplexe algorithmische Randfälle, behalten Siehighals Standardbasis für die Repository-Navigation bei und nutzen Siemediumoderlowfür latenzsensitive Aufgaben wie die Formatierung von Code oder einfache Dokumentationssuchen. - Parallele Tool-Schnittstellen strukturieren: Entwerfen Sie Tool-Definitionen so, dass sie gebündelte Argumente akzeptieren, sofern dies von der Laufzeit unterstützt wird. Dies ermöglicht es Arbeiter-Agenten, mehrere Datei-Inspektionen oder Syntaxprüfungen in konsolidierten Anfragen anstelle von sequenziellen Roundtrips anzufordern.
- Modellgenerierung von der Ausführung entkoppeln: Stellen Sie sicher, dass Modelle Tool-Aufrufe und Code-Modifikationen als strukturierte Daten vorschlagen, während eine isolierte Client-Laufzeit oder ein containerisierter Test-Runner Befehle ausführt und nach Möglichkeit Ausführungsergebnisse und reproduzierbare Belege zurückgibt.
Checkliste für die Enterprise-Governance
- Sitzungsprotokollierung einrichten: Protokollieren Sie Tool-Anfragen, Ausführungsergebnisse, Berechtigungsentscheidungen, Code-Änderungen, Testergebnisse und verfügbare Modellzusammenfassungen. Behandeln Sie Reasoning-Zusammenfassungen nicht als vollständige oder originalgetreue Ausführungsverläufe.
- Mehrschichtige Sicherheitskontrollen anwenden: Betrachten Sie externe Dokumentationen, Problemverfolgungssysteme und Pull-Request-Kommentare als nicht vertrauenswürdige Eingaben. Obwohl Hydrogen eine 2,3-fache Resilienzverbesserung beim Gray Swan-Benchmark für indirekte Prompt-Injektionen zeigte, bleiben eine automatisierte Eingabebereinigung (Sanitization) und Ausführungsberechtigungs-Tore unerlässlich.
- Kumulierten Token-Verbrauch überwachen: Verfolgen Sie Eingabe-Token und abrechenbare Ausgabe-Token, einschließlich Denken-Token (Thinking-Token), über die Nutzungsfelder der ausgewählten API. Fügen Sie Denken-Token nicht erneut hinzu, wenn diese bereits im abgerechneten Ausgabewert enthalten sind.
Häufig gestellte Fragen (FAQ)
Wie schneidet Gemini 4 Hydrogen in Produktions-Workflows im Vergleich zu Carbon und Argon ab?
Was sind die vier Denke-Ebenen und wann sollten Entwickler xhigh verwenden?
Wie funktioniert das Pauschalpreismodell über das eine Million Token umfassende Kontextfenster hinweg?
Wichtige Erkenntnisse für Engineering-Teams
Der Einsatz autonomer Codierungstools in Produktionsumgebungen erfordert von Entwicklungsteams, über Frontier-Benchmark-Ergebnisse hinauszuschauen und sich auf die Wirtschaftlichkeit einer iterativen Tool-Ausführung zu konzentrieren. Die Weiterleitung jeder routinemäßigen Code-Änderung über Reasoning-Modelle mit hoher Latenz führt zu unnötigen Betriebsopfern und Budgetaufblähung. Gleichzeitig erfordert die Steuerung von Ausführungslatenzen und Aufgabenerfolgsraten realistische Erwartungen hinsichtlich Benchmark-Ergebnissen und Fehlerbehebungsverhalten.
Durch die Etablierung gestaffelter Architekturen, die kapazitätsstarke Reasoning-Modelle mit schnellen, vorhersehbaren Ausführungs-Engines kombinieren, können Engineering-Organisationen automatisierte Entwicklungs-Workflows nachhaltig skalieren. Teams, die ein diszipliniertes Multi-Modell-Routing, strukturierte Testgrenzen und eine rigorose Eingabevalidierung implementieren, sind am besten positioniert, um robuste, wartbare KI-gestützte Software-Pipelines aufzubauen.
Referenzen
-
Google DeepMind. Introducing Gemini 4 Hydrogen. Offizielle Ankündigung.
-
Google DeepMind. Gemini 4 Hydrogen Model Card. Technische Spezifikation und Sicherheitsbericht.
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. Technische Referenz.
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. Übersicht zur Multi-Modell-Orchestrierung.
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. Unabhängige KI-Evaluierung.
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. Technische Analyse.
Share this article