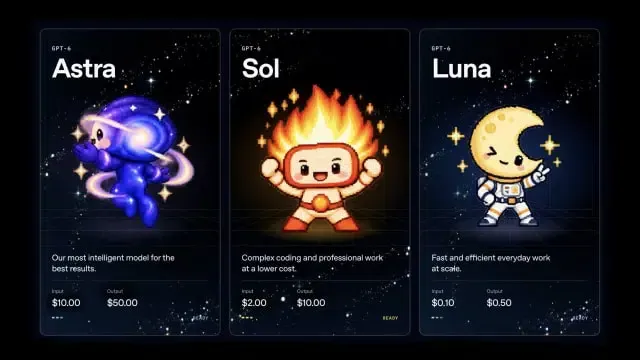
Halbiert OpenAI die Sol-API-Kosten? OpenAI hat am 22. September 2026 offiziell die kommerzielle Verfügbarkeit von GPT-6 Sol und GPT-6 Luna bekannt gegeben und damit die API-Token-Preise im Vergleich zur früheren GPT-5.6-Aktionspreisgestaltung bei Standard-Endpunkten um 50 % oder mehr gesenkt. Für die Standardverarbeitung von Prompts mit bis zu 272.000 Input-Token kostet GPT-6 Sol 2,00 $ pro Million Input-Token und 10,00 $ pro Million Output-Token, während das kleinere Modell GPT-6 Luna bei 0,10 $ für den Input und 0,50 $ für den Output pro Million Token liegt. Wenn OpenAI die Sol-API-Kosten über Standard-Entwicklerebenen hinweg halbiert, verschieben strukturelle Rechenleistungsdeflationen die operativen Einschränkungen generativer Software. Geringere Stückpreise machen rekursive Agentenschleifen, Batch-Extraktionen im Hintergrund und autonome, mehrstufige Worker in großem Maßstab wirtschaftlich rentabel. Für Systemarchitekten, Zuverlässigkeitsingenieure und Backend-Entwickler offenbart eine reduzierte finanzielle Reibung jedoch nachgelagerte Skalierbarkeitsherausforderungen, wodurch sich der ingenieurtechnische Fokus von Token-Budgets auf Rate-Limit-Grenzen, Parallelisierungslimits, Telemetriepipelines und Gegendruck-Engpässe verlagert.
Das operative Problem und finanzielle Engpässe
In den frühen Phasen der produktiven Unternehmensintegration von LLM-Modellen dienten nominelle Token-Gebühren als informeller architektonischer Regler. Hohe Inferenzkosten zwangen Entwicklungsteams dazu, Modellaufrufe als diskrete, vom Benutzer initiierte Transaktionen zu behandeln. Anwendungen verließen sich stark auf menschliche Freigaben, einen begrenzte Konversationsverlauf und streng gedrosselte, geplante Worker, um sicherzustellen, dass die monatlichen Rechnungen des Anbieters vorhersehbar blieben. Die Einführung dauerhafter Preissenkungen bei Modellen der mittleren Preisklasse stellt diese historischen Kompromisse infrage und verlagert die Bedenken der Systemtechnik von der Modellpreisgestaltung hin zur Resilienz der Backend-Infrastruktur.
Auf einen Blick
- Basiskostenreduzierung: Am 22. September 2026 führte OpenAI GPT-6 Sol mit 2,00 $ Input / 10,00 $ Output und GPT-6 Luna mit 0,10 $ Input / 0,50 $ Output pro Million Token für die Standardverarbeitung bei Prompts mit bis zu 272K Token ein, was einer nominalen Reduzierung von 50 % oder mehr im Vergleich zur GPT-5.6-Aktions-API-Preisgestaltung entspricht.
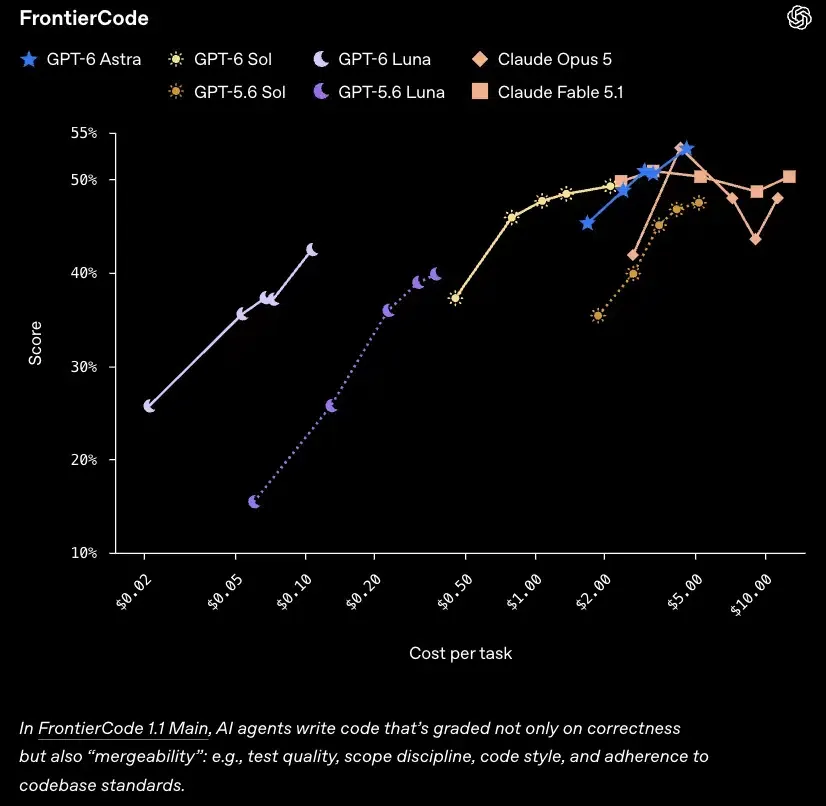
- Wirtschaftlichkeit auf Task-Ebene: Laut Berichten von OpenAI auf AutomationBench 1.0.6 erreichte GPT-6 Sol bei einer Konfiguration mit xhigh-Schlussfolgerungsaufwand einen Workflow-Wert von 33,2 % bei durchschnittlich gemeldeten Kosten von 0,27 $ pro versuchter Aufgabe, wodurch die Evaluierung durch Entwickler von reinen Token-Preisen auf die Kosten pro versuchter Arbeitseinheit verlagert wird.
- Prompt-Caching-Dynamik: Die Plattform bietet einen automatisierten Rabatt von 90 % auf gecachte Input-Token-Lesevorgänge (abgerechnet mit dem 0,1-fachen des Basis-Input-Token-Satzes), während erste Cache-Schreibvorgänge mit dem 1,25-fachen des ungecachten Input-Token-Satzes berechnet werden, was eine sorgfältige Präfix-Normalisierung erfordert, um hohe Cache-Trefferquoten über dynamische, mehrstufige Abläufe hinweg aufrechtzuerhalten.
Wie in der offiziellen Referenz zur OpenAI-Entwickler-API-Preisgestaltung und der OpenAI-Community-Ankündigung dargelegt, resultieren diese Preisstrukturen aus kontinuierlichen Verbesserungen der Low-Level-Inferenz-Pipelines und KV-Caching-Systeme. Wenn jedoch die Kosten für die Ausführung automatisierter Aufgabenabfolgen erheblich sinken, erweitern Engineering-Teams den Umfang ihrer Hintergrundaufgaben. Die wirtschaftliche Untergrenze, die zuvor Hintergrund-Worker davon abhielt, kontinuierliches Polling, automatisierte Code-Review-Durchläufe oder mehrstufige Dokumentenextraktions-Pipelines auszuführen, wurde gesenkt.
Auf dem gesamten Markt haben mehrere Anbieter von Basismodellen ihre API-Preise über Entwicklerstufen hinweg gesenkt oder umstrukturiert. Anthropic hat Claude Opus 5.5 zusammen mit aktualisierten Spezifikationen in den Anthropic Claude Opus 5.5 Platform Specifications veröffentlicht und nennt 4 $ pro Million Input-Token, 0,20 $ pro Million gecachte Input-Lesevorgänge und 20 $ pro Million Output-Token, was einen reduzierten Token-Verbrauch bei Code-Refactoring-Benchmarks unterstreicht. Gleichzeitig behält Google seine Werbe-Einführungspreise für Gemini 3.8 Flash bei, die unter Google AI for Developers dokumentiert sind, und Open-Weight-Releases wie MiMo-V2.6-Pro von Xiaomi bieten Selbsthosting-Teams aggressive Token-Kostenoptionen unter freizügigen Softwarelizenzen.
Wenn die Modellkosten sinken, ändern sich die Entwicklungsgewohnheiten. Engineering-Teams setzen tiefere rekursive Schleifen ein, fügen umfassende Unternehmensdokumentationen in System-Prompts ein und konfigurieren eine automatisierte Wiederholungslogik über komplexe Aufgaben-Graphen hinweg. Was als Kostenentlastung auf der API-Ebene beginnt, kann Latenz- und Datenverkehrsspitzen auf interne Dienste verlagern. Wenn ein Orchestrierungs-Worker Dutzende sequenzielle oder parallele Modellaufrufe für eine einzelne Benutzertransaktion ausführt, müssen interne Datenbank-Pools, sekundäre Speichercluster, Telemetriepipelines und Ratenbegrenzer die resultierende Last auffangen.
Systemische Ursachen und nicht-visuelle Anforderungsketten
Wenn Client-Anwendungen von interaktiven Chat-Schnittstellen zu nicht-visuellen Hintergrundautomatisierungen übergehen, verändern sich die Upstream-Anforderungsprofile drastisch. Ein einzelnes Geschäftsereignis kann eine autonome Pipeline auslösen, die Schemata prüft, Umgebungsvariablen auswertet, externe Tools aufruft und Ausgaben über mehrere kontinuierliche Durchläufe hinweg verifiziert.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Rekursive Agentenausführung und Parallelisierungsmultiplikation
In traditionellen interaktiven Websystemen spiegelt das Anforderungsvolumen menschliche Interaktionsrhythmen wider. Jeder HTTP-Thread wird typischerweise einer expliziten Benutzerinteraktion zugeordnet, wobei ein geringerer Gesamt-Fan-Out und ein durch menschliche Denkzeiten begrenztes Tempo vorliegen. Die Client-Laufzeit sendet eine Nutzlast, wartet auf eine Antwort und pausiert, bevor nachfolgende Interaktionen eingeleitet werden.
Konzeptioneller Vergleich von Anforderungsprofilen: Interaktiv vs. Agentenbasiert
| Architektonische Metrik | Interaktiver Benutzerfluss | Autonome Agentenschleife |
|---|---|---|
| Parallelisierungsmodell | Der vom Menschen gesteuerte Anfrage-Fan-Out ist typischerweise geringer | 1 Ingress-Ereignis = N verkettete Unteraufrufe |
| Ausführungszeitpunkt | Vom Benutzer durch Antwort- und Denkzeiten bestimmt | Wird automatisch fortgesetzt, bis Richtlinienlimits eingreifen |
| Kontext-Invalidierung | Frische Nutzlasten pro Sitzung | Stützt sich stark auf den gecachten Kontext |
| Fehlerbehandlung | Erneuter Versuch durch den Benutzer bei Fehler | Automatisierte programmatische Wiederholungen |
| System-Engpässe | Frontend-Gateway-Bandbreite | Interne Datenbank-Pool-Limits |
| Fehlerkaskaden | Auf eine einzelne Sitzung isoliert | Kann Warteschlangensättigung auslösen |
Wenn Systeme autonome Agenten integrieren, entkoppelt sich dieses Tempo. Ein einzelnes ausgelöstes Ereignis kann eine ununterbrochene Sequenz automatisierter Aufrufe erzeugen. Wenn ein Agent auf einen transienten Fehler oder eine fehlerhafte Tool-Ausgabe stößt, kann eine naive Wiederholungslogik schnelle Anfragespitzen gegen Backend-Dienste erzeugen. Da reduzierte Token-Kosten längere Ausführungszeiten ermöglichen, können automatisierte Workflows das Hintergrund-Anforderungsvolumen erheblich skalieren, selbst bei einer stabilen aktiven Nutzerbasis.
Prompt-Cache-Mechanik: KV-Wiederverwendung, Schreib-Overheads und Präfix-Stabilität
OpenAI hat die Veröffentlichungen von Sol und Luna mit Optimierungen seines Prompt-Caching-Subsystems gekoppelt. Wie in der OpenAI-Spezifikation für Prompt-Caching dokumentiert, erhalten Input-Token, die einem gecachten Präfix entsprechen, einen Rabatt von 90 % auf den Lese,preis. Das Prompt-Caching reduziert primär die modellseitige Neuberechnung, anstatt als allgemeiner Mechanismus zur Komprimierung von Netzwerknutzlasten zu dienen. Bei standardmäßigen zustandslosen Interaktionen überträgt die Client-Anwendung den Anfragekontext, und der Anbieter überspringt die Neuberechnung der KV-Tensoren für das übereinstimmende Präfix, wodurch die Latenz bis zum ersten Token und die Input-Abrechnung erheblich reduziert werden.
Entscheidend ist, dass das Schreiben eines anfänglichen Präfixes in den serverseitigen Cache mit dem 1,25-fachen des ungecachten Input-Token-Satzes berechnet wird. Die Maximierung der Kosteneffizienz erfordert die Aufrechterhaltung der Präfix-Stabilität über mehrere Abfragen hinweg.
Ausgewählte öffentliche API-Listenpreise – Nicht direkt vergleichbar zwischen Anbietern
| Modellbezeichner | Input ($/1M Tok) | Output ($/1M Tok) | Cache-Lese-Richtlinie |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | 90% Rabatt (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | 90% Rabatt (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | Dynamische gestaffelte Preisgestaltung |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M Lesen (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | Bis zu 90% im Cache |
| Google Gemini 3.8 Flash | $0.75 (Intro) | $3.75 (Intro) | $0.075/1M gecachtes Lesen |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M gecachtes Lesen |
Hinweis: Standardtarife gelten für Tarife mit kurzem Kontext (Prompts bis zu 272K Input-Token für OpenAI). Anbieter erzwingen unterschiedliche Cache-Schreib-Overheads, Kontextlimits und zeitlich begrenzte Aktionsbedingungen.
Die Beibehaltung des Präfixes erfordert eine sorgfältige Handhabung der API-Konfigurationsoptionen. In der API-Architektur von OpenAI führt das direkte Ändern von Parametern für den Argumentationsaufwand oder das Ändern von Tool-Definitionsarrays dazu, dass sich das gerenderte Prompt-Präfix ändert und zuvor gecachte Zustände ungültig werden.
Um den gecachten Kontext während Sitzungen mit mehreren Turns beizubehalten, müssen Entwickler Tool-Schemata und Basis-Anweisungen in einer konsistenten Reihenfolge halten. Wenn Laufzeitanpassungen erforderlich sind, sollten Entwickler Parameter über strukturierte Sitzungssteuerungen (wie configuration_update) aktualisieren oder die Tool-Ausführung über tool_choice oder allowed_tools umschalten, anstatt das Tool-Definitions-Array direkt zu modifizieren.
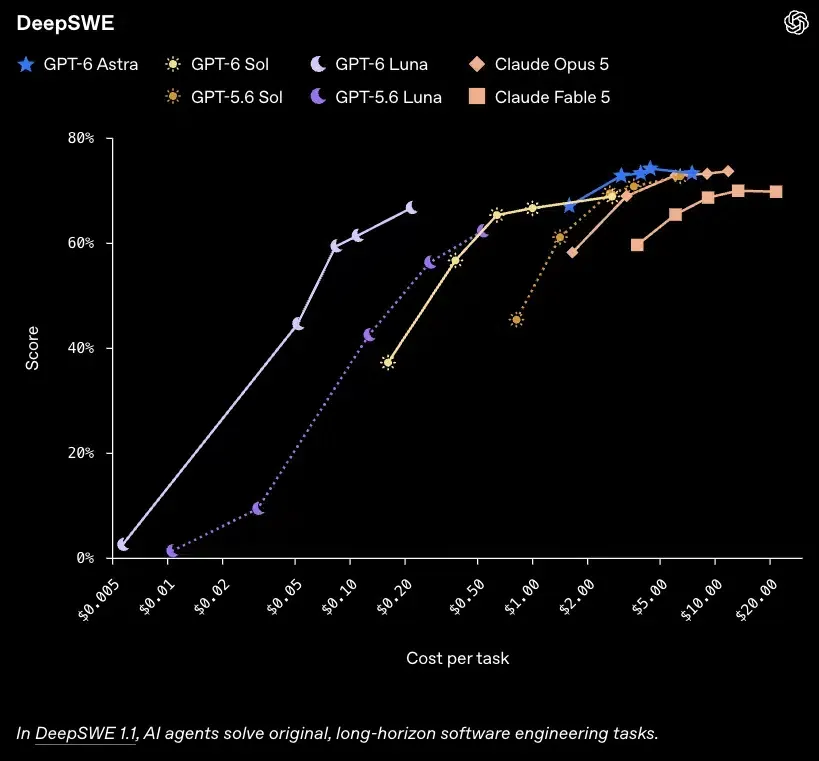
Wenn Cache-Misses auftreten, verarbeitet der Upstream-Anbieter die Eingabesequenz ohne den 90-prozentigen Leserabatt neu. Dies kann im großen Maßstab die Inferenzlatenz und den Timeout-Druck erhöhen. Für die mehrstufige Aufgabenausführung verlagert sich die Kosteneffizienz von einfachen Token-Multiplikatoren hin zu den Ausgaben für abgeschlossene Aufgaben, wie in der VentureBeat-Berichterstattung über GPT-6 Sol und Luna Benchmarks zu sehen ist, wo GPT-6 Sol auf AutomationBench 1.0.6 einen Wert von 33,2 % bei durchschnittlich 0,27 $ pro versuchter Aufgabe erzielte.
Telemetriearchitektur: Entkopplung von Betriebskennzahlen und Compliance-Audits
Ein sprunghafter Anstieg automatisierter LLM-Anfragen belastet die Backend-Observability- und Compliance-Pipelines erheblich. Agenten-Workflows mit hoher Parallelität erfordern eine klare architektonische Trennung zwischen Betriebstelemetrie und rechtlichen Audit-Pfaden.
Unternehmens-Compliance-Richtlinien verlangen oft die Aufzeichnung von Sitzungsmetadaten, Beweisen zur Tool-Ausführung und Transaktionsdatensätzen. Die identische Behandlung von Betriebstelemetrie und Compliance-Daten führt zu schwerwiegenden technischen Kompromissen:
- Compliance- und Sicherheits-Audit-Kanäle: Müssen eine dauerhafte, abspielbare Zustellung mit expliziten Wiederholungs-, Persistenz- und Fehlerbehandlungsmechanismen in einmal beschreibbare, zugriffsgeschützte Auditspeicher gewährleisten. Nutzlasten sollten strukturierte Metadaten, die Identität des Aufrufenden und den kryptografischen Zustand erfassen und gleichzeitig persönlich identifizierbare Informationen (PII) und geheime Schlüssel systematisch bereinigen. Unter hoher Last müssen diese Pipelines Gegendruck anwenden oder Aufgaben dauerhaft in Warteschlangen einreihen, anstatt Datensätze zu verwerfen.
- Betriebs-Telemetriekanäle: Verfolgen Leistungsmetriken wie Token-Zahlen, Trefferquoten von Prompt-Caches und Upstream-Antwortlatenzen. Da diese Traces für die Echtzeitüberwachung und das Debugging verwendet werden, können sie über begrenzte, verlustbehaftete Verwerfungspuffer verarbeitet werden. Wenn nachgelagerte Kollektoren langsamer werden, kann die Anwendung überschüssige Betriebstelemetrie sicher verwerfen, um die Verfügbarkeit des Kerndienstes aufrechtzuerhalten.
Wenn externe Anbieter HTTP 429 Rate-Limit-Fehler zurückgeben, können falsch konfigurierte Wiederholungsrichtlinien schwere Betriebsprobleme verursachen. Sofortige Wiederholungsversuche oder synchronisierte exponentielle Backoff-Routinen ohne randomisiertes Jitter erzeugen Wiederholungswellen, die sich durch intermediäre Mikroservices kaskadieren und Thread-Pools sowie Datenbankverbindungen beanspruchen können.
Lösungsvergleich: Kompromisse beim Eigenbau (Build) versus Zukauf (Buy)
Die Bewältigung der operativen Last, die sich aus niedrigeren Inferenzkosten ergibt, erfordert von Unternehmen die Evaluierung ihrer KI-Gateway- und Proxy-Architekturen. Teams müssen entscheiden, ob sie benutzerdefinierte Routing-, Ratenbegrenzungs- und Telemetrieproxys intern entwickeln oder spezialisierte Drittanbieter-Infrastruktur einsetzen möchten.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Benutzerdefinierte, interne Resilienz-Pipelines
Die Entwicklung einer eigenen Infrastruktur gibt Engineering-Teams die vollständige Kontrolle über Netzwerkrichtlinien, Datenbereinigung und Routing-Strategien. Unternehmen können Edge-Proxies entwickeln, die genau auf ihre internen Mikroservice-Topologien zugeschnitten sind.
// Referenzimplementierung: Synchronisierter Token Bucket mit fraktioniertem Rest und begrenzter Sättigung
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Skalierter Rest-Zähler im Bereich [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Ungültige Grenzkonfiguration für TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Basiszeitstempel monoton vorrücken
        this.lastRefillNanos = nowNanos;

        // Wenn der Bucket bereits voll ist, nicht verbrauchte Bruchteilguthaben verwerfen, um Timing-Drift zu verhindern
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-Path: Wenn mindestens eine vollständige Periode vergangen ist, füllt sich der Bucket vollständig auf.
        // Dies eliminiert die Multiplikationsüberlauf-Oberfläche (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Unter Perioden-unterteilenden Mikro-Intervallen exakte Bruchteil-Token mit BigInteger-Arithmetik berechnen
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Die interne Entwicklung erfordert jedoch eine laufende technische Wartung. Teams müssen sich manuell an Aktualisierungen der Anbieter-APIs anpassen, sich entwickelnde Ratenbegrenzungen über mehrere Anbieter hinweg handhaben und verteilte Telemetriewarteschlangen verwalten. Dieser Wartungsaufwand kann interne Entwicklerressourcen von den Kernproduktfunktionen ablenken.
Kommerzielle Gateways und Infrastruktur-Tools
Um die Erstellung dieser Funktionen von Grund auf zu vermeiden, setzen viele Unternehmen verwaltete API-Proxys, LLM-Gateways und Edge-Control-Planes ein. Einige verwaltete Gateways bieten anbieterbewusste Ratenbegrenzungskoordination, Observability, Richtlinienkontrollen und Caching-bewusstes Routing; die genauen Funktionen variieren je nach Anbieter, und die Präfix-Optimierung erfordert oft dennoch eine anwendungsspezifische Anforderungsdisziplin.
Kommerzielle Plattformen ermöglichen es Engineering-Teams, Kostenbudgets pro Umgebung durchzusetzen, ein automatisiertes Fallback-Routing über Modellfamilien hinweg zu konfigurieren und sensible Kundeninformationen vor dem Protokollieren von Anfragemetadaten herauszufiltern. Maßgeschneiderte Gateways bewältigen Parallelitätsspitzen, auditieren API-Verbrauchstrends und schützen nachgelagerte Mikroservices in komplexen Anwendungsumgebungen.
Entscheidungsmatrix: Interne Pipeline vs. Verwaltete Plattformen
| Evaluierungskriterien | Interne Resilienz-Tools | Verwaltete Routing-Infrastruktur |
|---|---|---|
| Initiale Entwicklungsaufwände | Hoch (3-6 Entwicklungswochen) | Gering (Integration über Standard-API) |
| Protokollpflege | Laufende Teamverantwortung | Wird durch Anbieterupdates gehandhabt |
| Operative Kontrolle | Vollständige Stack-Sichtbarkeit | Durch Anbieterschnittstelle begrenzt |
| Prompt-Cache-Tuning | Erfordert benutzerdefinierte Proxies | Anbieterabhängig; erfordert meist Anwendungskooperation |
| Telemetrie-Isolierung | Benutzerdefiniertes Warteschlangenmanagement | Anbieterabhängig |
| Finanzielles Kostenprofil | Overhead durch Entwicklergehälter | Wiederkehrende SaaS- / Nutzungsgebühren |
Integrations-Checklisten und Governance-Zeitpläne
Unternehmen, die ihre Modellnutzung nach den Preissenkungen für GPT-6 Sol und Luna hochskalieren, können diesen operationellen Rahmen nutzen, um systemische Überlastungen zu verhindern:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
Konfiguration der Telemetriepipeline
Observability-Systeme müssen die Prompt-Protokollierung von Echtzeit-Anfragepfaden entkoppeln. Bei der Verarbeitung hochfrequenter Agenten-Workloads sollten Anwendungen Telemetriemetadaten in speicherbegrenzte, asynchrone Warteschlangen schreiben, um E/A-Staus zu verhindern, falls nachgelagerte Telemetriekollektoren langsamer werden.
// Referenzimplementierung: Speicherbegrenzter Telemetrie-Logger mit verlustbehaftetem Load Shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Die Warteschlangenkapazität muss positiv sein.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Nicht blockierende Einreichung: verwirft Telemetrie bei Last, um die App-Stabilität zu wahren
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Häufig gestellte Fragen (FAQ)
Was sind die offiziellen API-Tarife für GPT-6 Sol und Luna?
Wie senkt Prompt-Caching die Kosten bei langen Konversationen?
Warum erhöhen günstigere Token das operationelle Risiko im Backend?
Wichtige Erkenntnisse für Engineering-Teams
Die Einführung von GPT-6 Sol und Luna beschleunigt einen breiteren Trend: Spitzenintelligenz wird günstiger und zugänglicher. Da die Token-Stückpreise stark sinken, hören finanzielle Einschränkungen auf, ein wirksamer Kontrollmechanismus für Softwarearchitekturen zu sein.
Da Unternehmen hochfrequente Agenten und Modelltopologien mit mehreren Ebenen einführen, wird die operative Technik für den Unternehmenserfolg von entscheidender Bedeutung. Teams müssen über die alleinige Bewertung von Modellen anhand nomineller Token-Preise oder Benchmark-Ergebnisse hinausgehen. Die langfristige Zuverlässigkeit hängt davon ab, wie effektiv Systeme die Parallelität verwalten, Prompt-Kontexte für die Cache-Wiederverwendung abgleichen, Upstream-Ratenbegrenzungen sauber handhaben und die Telemetrie von kritischen Anwendungspfaden entkoppeln. Unternehmen, die eine resiliente Infrastruktur aufbauen, werden ihre automatisierten Agenten-Workflows erfolgreich skalieren, ohne die Anwendungsverfügbarkeit oder Systemstabilität zu opfern.
Primärquellen und Referenzdokumentation
-
Referenz zur OpenAI-Entwickler-API-Preisgestaltung: Offizielle Entwickler-Preiskarten, Einschränkungen des Kontextfensters (≤272K Standard-Schwellenwert) und Preispläne für Cache-Lese-/Schreibvorgänge für GPT-6 Sol, Luna und Astra.
-
OpenAI-Community-Ankündigung: Öffentliche Bekanntgabe zur Bestätigung der 50-prozentigen Basiskostenreduzierung im Vergleich zu den GPT-5.6-Aktionsstufen sowie Details zur schrittweisen Einführung.
-
OpenAI-Spezifikation für Prompt-Caching: Architektonische Dokumentation zur serverseitigen Key-Value-Präfix-Wiederverwendung, Cache-Schreib-Overheads und Regeln zur Konfigurations-Invalidierung.
-
Anthropic Claude Opus 5.5 Platform Specifications: Offizielle Veröffentlichungsspezifikation zur Bestätigung von 4 $ Input / 20 $ Output / 0,20 $ Cache-Lese-Token-Raten und Benchmark-Leistung.
-
Anthropic Claude Sonnet 5 – Übersicht: Offizielle Entwickler-Preiskarte und Metriken zur Prompt-Caching-Effizienz (2 $ Input / 10 $ Output / bis zu 90 % Cache-Rabatt).
-
Google AI for Developers – Preiskarte: Übersicht der Entwickler-Preiskarten und Einführungspreisrichtlinien für Gemini 3.8 Flash.
-
Xiaomi MiMo – Offizielle API-Preise und Tarifübersicht: Kanonische Pay-as-you-go-Token-Raten für MiMo-V2.6-Pro-Inferenz (0,435 $ Input / 0,87 $ Output / 0,0036 $ Cache-Treffer) im Ausland.
-
VentureBeat-Berichterstattung über GPT-6 Sol und Luna Benchmarks: Berichterstattung über Release-Ökonomie, dauerhafte Preisgarantien und die Task-Zahlen von AutomationBench 1.0.6 (0,27 $ pro versuchter Aufgabe).
Share this article



