 Amap lanza ‘damax’. Esta iniciativa estratégica se ha consolidado a medida que el gigante de la cartografía se introduce en el espacio de trabajo de generación de código de bajo código (low-code) para automatizar la creación de aplicaciones. El 29 de junio de 2026 surgieron detalles sobre ‘damax’ (también denominado ‘袋马’), una herramienta de Vibe Coding diseñada para compilar mini-programas de WeChat y aplicaciones nativas de iOS directamente a partir de instrucciones en lenguaje natural. Para los equipos de desarrollo y los líderes de producto, este modelo de generación rápida subraya una transición tecnológica: los asistentes de IA actúan cada vez más como una capa de middleware programático entre los usuarios finales y las aplicaciones, reduciendo las configuraciones manuales de desarrollo.
Resumen
- Generación rápida: El motor ‘damax’ automatiza la conversión de instrucciones en lenguaje natural en mini-programas de WeChat y compilaciones nativas de iOS, lo que reduce significativamente los ciclos de lanzamiento de productos.
- Audiencia objetivo: La herramienta está dirigida a propietarios de pequeñas empresas, creadores independientes y equipos pequeños sin departamentos de ingeniería internos dedicados.
- Fragmentación del contexto: El aumento de aplicaciones generadas automáticamente plantea desafíos únicos para el seguimiento, la restauración de sesiones y la preservación de enlaces profundos (deep links) a través de plataformas fragmentadas.
Realineación estructural y el espacio de trabajo de generación de bajo código
Beijing Amap Yuntu Technology Co., Ltd. desarrolló y opera la nueva herramienta de espacio de trabajo ‘damax’. Este lanzamiento posiciona a Amap directamente en el mercado competitivo de generación de aplicaciones por IA, desafiando a plataformas establecidas como Tusi de Tencent, Miada de Baidu, Qoder de Alibaba y Trae de ByteDance. Informes recientes de seguimiento de la industria indican un crecimiento en el envío de nuevas aplicaciones, lo que resalta cómo la programación asistida por IA está reduciendo las barreras de entrada. En lugar de ofrecer simples maquetas, esta herramienta compila software nativo de iOS y mini-programas de WeChat totalmente funcionales. Genera códigos QR para dispositivos reales para su ejecución y prueba inmediata en WeChat, lo que permite a los creadores sin conocimientos técnicos ejecutar y perfeccionar proyectos en tiempo real.
La retirada de los ciclos de desarrollo tradicionales parece probable a medida que estos sistemas de código cero ganan terreno. La integración continua de compiladores conversacionales en los ecosistemas SaaS sugiere que las grandes empresas tecnológicas están priorizando los flujos de trabajo automatizados sobre el mantenimiento manual de clientes. En consecuencia, cuando Amap lanza ‘damax’ para pruebas beta internas, esto desencadena un cambio más amplio hacia protocolos de intercambio de datos nativos de programas. Los estudios de la industria demuestran que los flujos de trabajo asistidos por IA pueden generar configuraciones multipantalla completas a partir de instrucciones simples, lo que demuestra que la construcción manual de diseños visuales se está convirtiendo en un punto de fricción importante en el software empresarial moderno.
Los proveedores de SaaS se están reposicionando rápidamente para evitar la obsolescencia. Los equipos de software están explorando infraestructuras de correo electrónico agentic para admitir flujos de trabajo de bandeja de entrada programáticos. Al ampliar esta tendencia de automatización, las principales suites de productividad han adquirido tecnologías de creación de agentes para ejecutar tareas complejas entre sistemas. Operando en paralelo, las plataformas de chat empresarial han implementado capacidades asistidas por IA dentro de sus sistemas nativos. Esta consolidación en toda la industria indica una dirección probable donde la integración del backend tiene prioridad sobre el software de escritorio independiente.
Análisis del protocolo: Cómo los scrapers headless alteran la atribución
Muchos portales de correo electrónico empresarial y asistentes de IA inspeccionan automáticamente los enlaces entrantes antes de que los usuarios interactúen con ellos. Desde la perspectiva de los sistemas de atribución, esto cambia toda la cadena de solicitud.
Cuando un usuario humano hace clic en un enlace, un navegador web estándar carga la página, ejecuta scripts de seguimiento y escribe una cookie. Por el contrario, un agente de IA obtiene la página de forma programática. Envía una solicitud HTTP headless directamente desde un servidor en la nube. Debido a que la solicitud se ejecuta dentro de un entorno aislado (sandbox) sin estado, no hay DOM visual, ni historial de navegador, ni almacenamiento de cookies. El enrutamiento headless a menudo aísla la sesión del sistema del lado del cliente. Los métodos de atribución tradicionales basados en el navegador pueden dejar de capturar el viaje completo del usuario porque dependen de las cookies del navegador para vincular el clic inicial con la instalación. Bajo estas condiciones, la precisión de la atribución disminuye significativamente en toda la pila de comunicación.
Flujo humano tradicional:
Enlace de correo -> Clic visual -> Sesión del navegador (Cookies, DOM) -> App Store -> Instalación de la app (Atribuida)


Flujo headless gestionado por agente:
Enlace de correo -> Escaneo programático -> Solicitud HTTP headless (Sin UI, sin DOM, sin cookies) -> Enlace visitado
Instalación de la app (Después) -> Lanzamiento de la app -> Estado de cliente vacío (Atribución perdida)
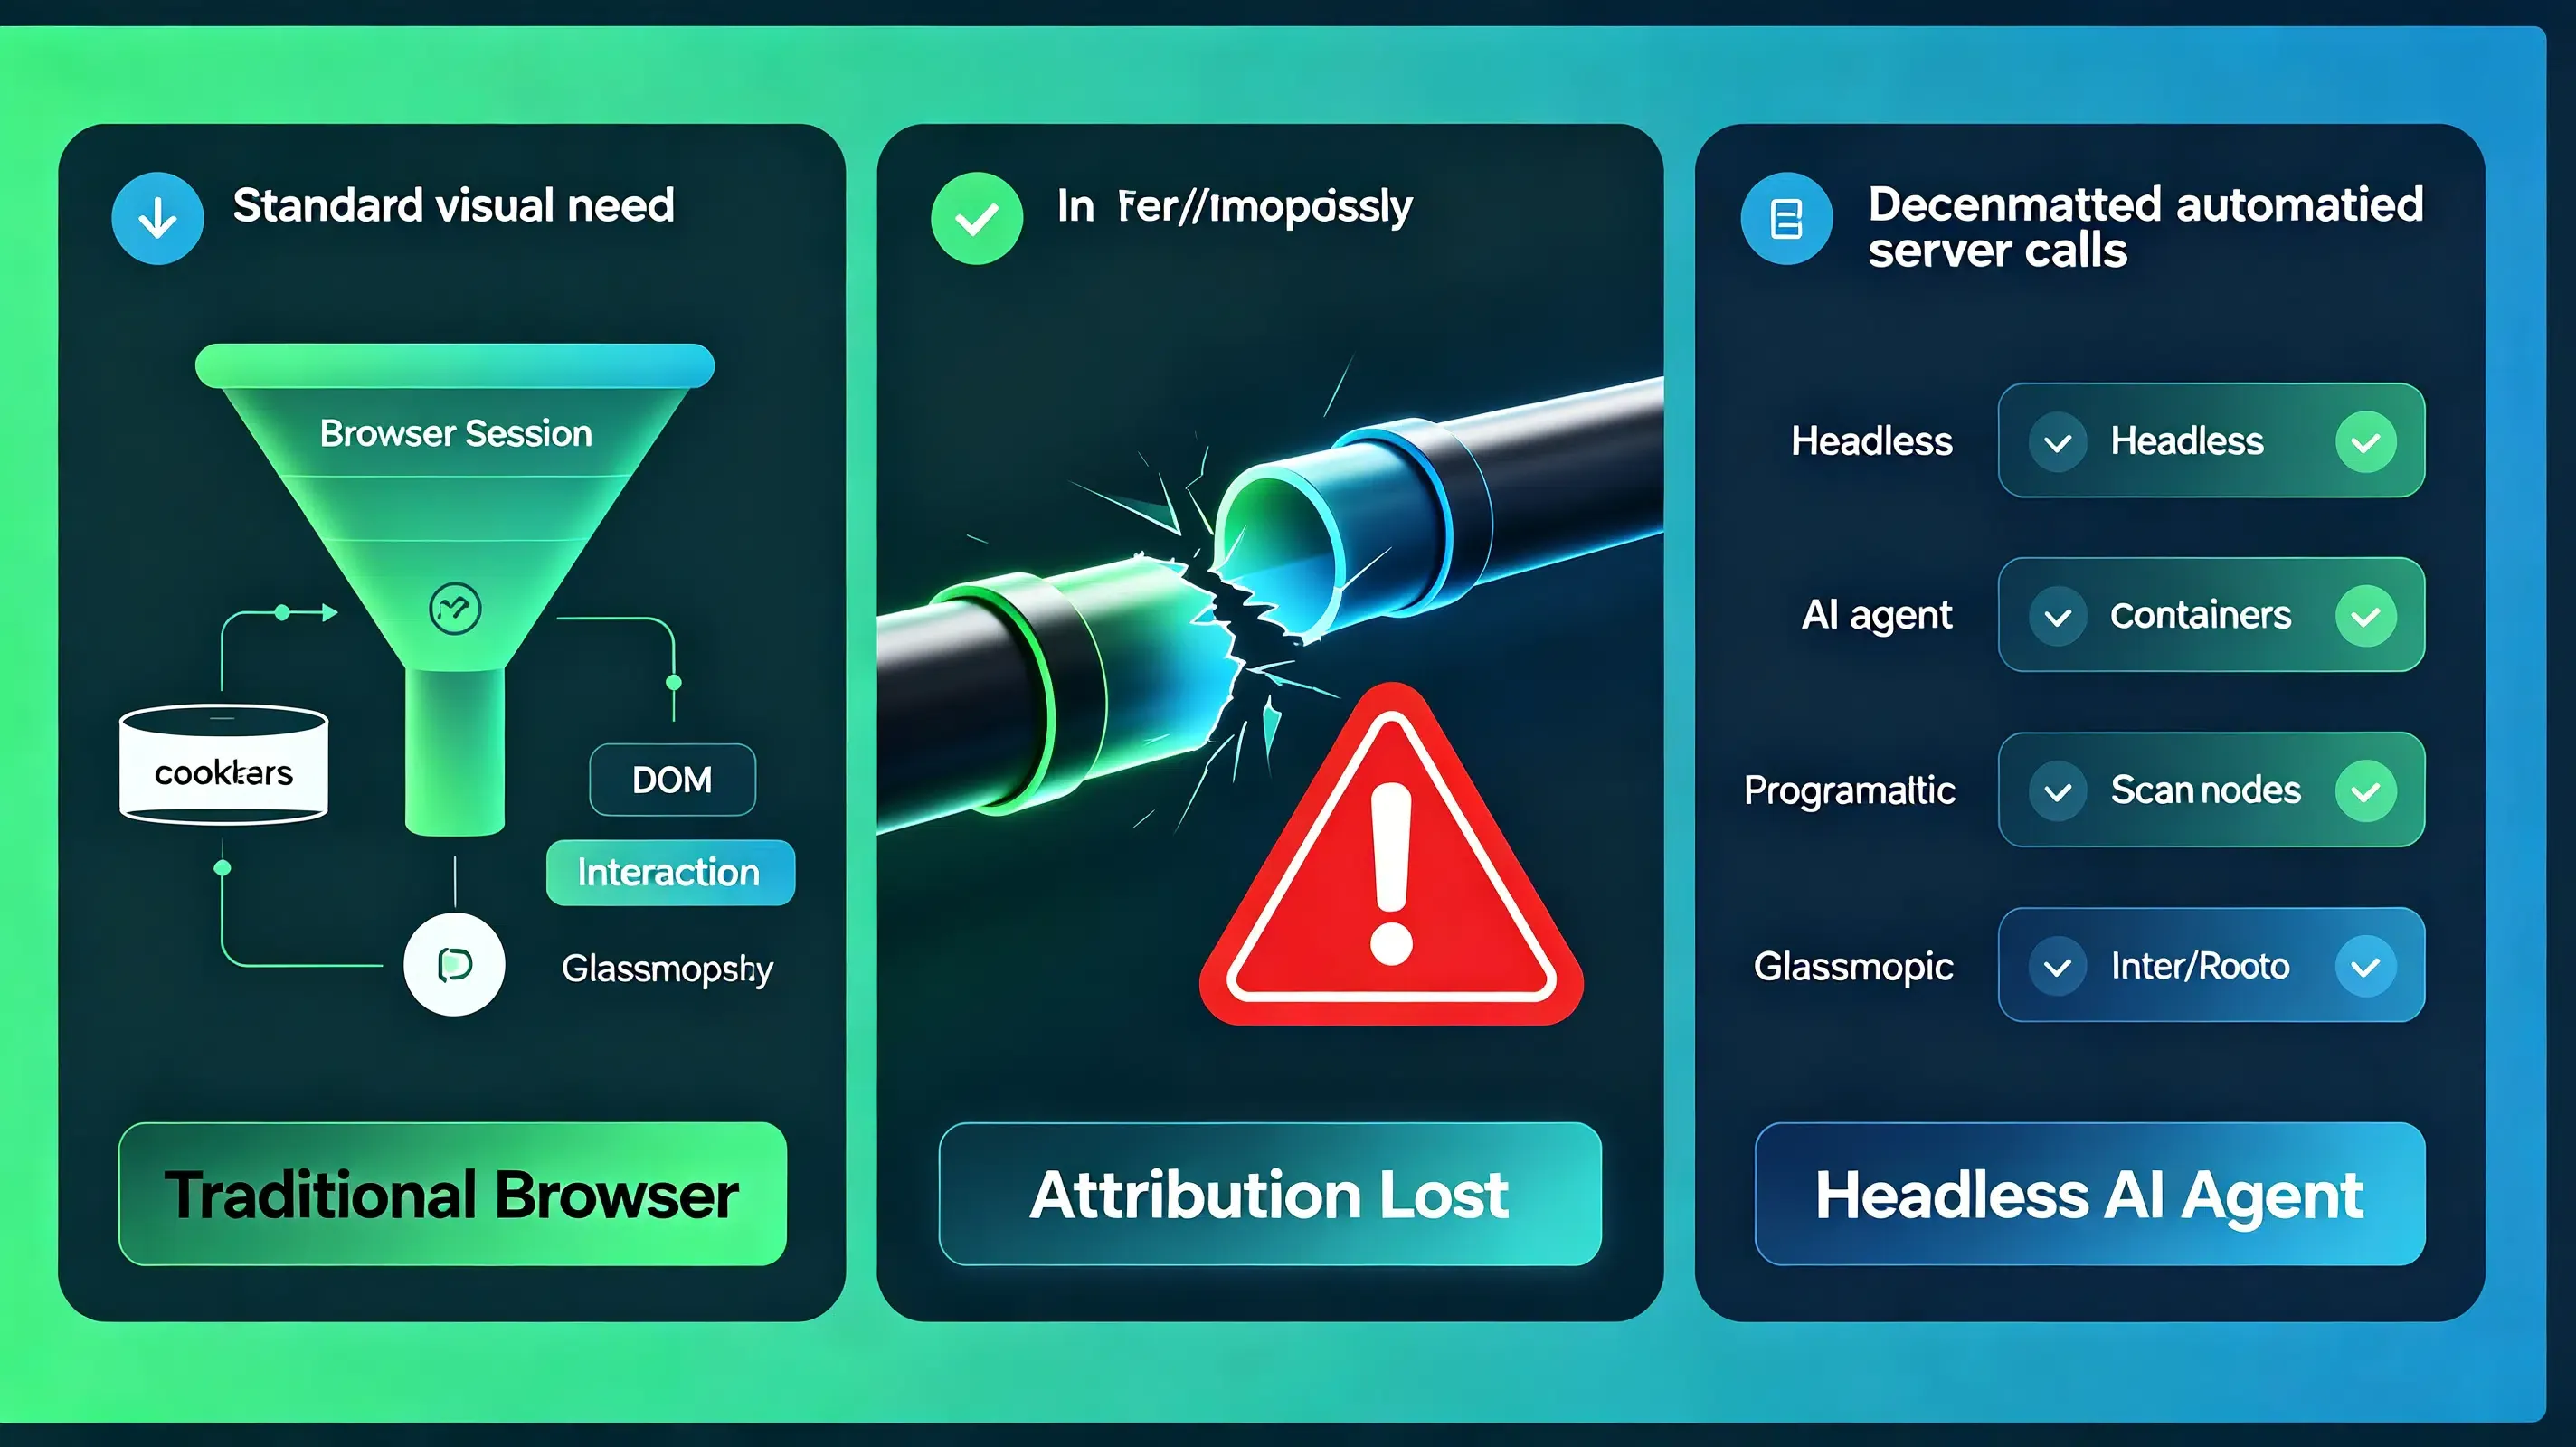
En implementaciones de producción típicas, los desarrolladores suelen encontrar una parte notable del tráfico procesado por scrapers automatizados. El seguimiento de estas interacciones programáticas revela que las pasarelas de seguridad de correo electrónico o los escáneres de buzones automatizados pueden visitar los enlaces antes que los usuarios finales. Este comportamiento puede interferir con la atribución basada en el navegador si los sistemas asumen que cada solicitud proviene de un usuario real. En consecuencia, en algunas implementaciones, el contexto de referencia original puede dejar de estar disponible para la aplicación cliente, lo que genera brechas de atribución significativas.
Soluciones arquitectónicas: ¿Desarrollar internamente o integrar la gestión de estado?
En la práctica, los equipos de ingeniería suelen elegir entre construir una canalización de atribución interna o integrar un SDK de atribución existente. Desarrollar un sistema propietario requiere una importante carga de ingeniería. Los equipos deben construir bases de datos personalizadas del lado del servidor, mantener bibliotecas de coincidencia de estado del dispositivo y actualizar continuamente la lógica para cumplir con los estándares de seguridad cambiantes del SO. Para muchas organizaciones, el coste de mantenimiento de un rastreador interno es prohibitivamente alto.
Alternativamente, los desarrolladores generalmente evalúan varios enfoques para preservar el estado de la sesión sin cookies del lado del cliente:
- Servicios personalizados internos: Construir bases de datos de coincidencia de estado propietarias sobre la arquitectura de nube interna.
- Herramientas específicas de la plataforma: Confiar en utilidades básicas como Firebase Dynamic Links (o sus alternativas nativas de la plataforma).
- MMPs empresariales: Desplegar socios de medición móvil como Branch, AppsFlyer o Adjust para flujos de trabajo de enlaces profundos.
- SDKs de parámetros especializados: Utilizar utilidades de integración dedicadas para la transferencia precisa y rentable de parámetros personalizados.
Comparación del flujo de estado y atribución
| Flujo de interacción | Almacén de cookies visual | Compatibilidad headless | Integridad de la atribución |
|---|---|---|---|
| Viaje tradicional en navegador | ✅ Sí | ❌ No | Alta (Sesión del lado del cliente) |
| Triaje por agente IA headless | ❌ No | ✅ Sí | Baja (Pérdida de datos contextuales) |
| Bloqueo de estado en servidor | ❌ No | ✅ Sí | Alta (Recuperación asíncrona) |
Generación de enlace -> Prerregistro de metadatos en servidor de estado central
                                     |
Scraper/Usuario hace clic en URL -> Registrar bloqueo de estado temporal en servidor
                                     |
Lanzamiento de App en dispositivo -> Consulta de contexto programática del SDK -> Coincidencia de bloqueo de estado y restauración de parámetros
Las implementaciones comerciales de esta arquitectura incluyen Branch, AppsFlyer, Adjust, Opoinstall y otras plataformas de atribución diferida. Estos sistemas mantienen el estado del lado del servidor antes de la instalación y restauran los parámetros cuando la aplicación se inicia por primera vez, evitando los problemas de fiabilidad asociados con las sesiones del navegador del lado del cliente. El SDK personalizado de Opoinstall asigna de forma segura los parámetros de referencia a una base de datos centralizada de recuperación de estado, asegurando que los contextos de referencia se conserven incluso cuando la interacción inicial ocurre a través de una transacción headless gestionada por máquina en la pila de comunicación y, a medida que Amap lanza ‘damax’, los desarrolladores generalmente evalúan estas arquitecturas para proteger sus canalizaciones de atribución.
Adaptaciones de los equipos operativos y listas de verificación de integración
Los equipos de ingeniería de backend se enfrentan a la tarea inmediata de auditar todas las integraciones de bases de datos activas antes de lanzar compilaciones compiladas automáticamente. Los líderes de producto deben rediseñar los ciclos de invitación y registro para adaptarse a los viajes de usuario no visuales. En lugar de asumir que el usuario leerá un correo electrónico y hará clic en un botón, los líderes de producto deben diseñar flujos de trabajo que esperen activadores programáticos. Los equipos de crecimiento deben actualizar sus métricas de rendimiento. Cuando el software autónomo maneja el triaje, las tasas de apertura y las tasas de clics se vuelven menos fiables. Las operaciones de marketing deben centrarse en la telemetría dentro de la aplicación y en hitos de conversión verificados por transacciones, optimizando las campañas en función de las acciones reales realizadas dentro de la aplicación.
Lista de verificación de integración de aplicaciones generativas
Para garantizar la continuidad de los datos antes de lanzar sus aplicaciones recién generadas, los equipos de ingeniería deben ejecutar los siguientes pasos:
- Verificación de ruta contextual: Audite cómo el compilador de IA asigna los parámetros de URL personalizados para garantizar la supervivencia de los enlaces profundos.
- Preservación de referencia headless: Asigne cabeceras HTTP alternativas para capturar parámetros de referencia durante los escaneos de códigos QR y las ejecuciones de mini-programas.
- Pruebas en sandbox de telemetría: Asegúrese de que el informe de datos local no active advertencias de fraude en entornos de prueba sandbox.
- Verificaciones de enrutamiento multiplataforma: Alinee los Enlaces Universales con los esquemas de mini-programas de WeChat para evitar la fricción del usuario durante las transiciones multipantalla.
En las migraciones de sistemas típicas, los desarrolladores suelen encontrar una parte notable del tráfico procesado por scrapers automatizados. El seguimiento de estas interacciones programáticas revela que los contextos de referencia se eliminan con frecuencia, lo que confirma que los marcos de seguimiento tradicionales son menos fiables en configuraciones automatizadas
Preguntas frecuentes (FAQ)
¿Afecta el 'damax' de Amap a las tiendas de aplicaciones existentes?
¿Cómo sobreviven las aplicaciones automatizadas sin entornos de desarrollo locales?
¿Cómo puede sobrevivir la atribución de referencias cuando las nuevas aplicaciones se lanzan de forma programática?
La retirada del ciclo de desarrollo de aplicaciones visual y orientado a humanos destaca un cambio fundamental hacia protocolos de comunicación basados en backend y flujos de trabajo asistidos por IA. A medida que las aplicaciones se comunican cada vez más a través de intercambios de datos automatizados en lugar de diseños renderizados por humanos, los equipos de ingeniería deben reevaluar las estrategias de integración tradicionales. Las plataformas que dependen en gran medida de acciones manuales y visuales de los usuarios pueden enfrentar brechas estructurales cuando los agentes automatizados gestionan la canalización de solicitudes. La transición a la atribución del lado del servidor y la transferencia segura de parámetros representa una dirección altamente probable para mantener un seguimiento y una cobertura de seguridad fiables.
Esta transición sugiere una reescritura fundamental de nuestros marcos de medición y protocolos de seguridad. Es probable que los futuros sistemas de atribución dependan en mayor medida de la coincidencia de identidad del lado del servidor y la sincronización segura de estados. A medida que más agentes de IA comiencen a actuar como los primeros consumidores de la comunicación digital, las arquitecturas de atribución dependerán cada vez más de la identidad del lado del servidor, la recuperación de estado diferida y la preservación del contexto a nivel de protocolo, en lugar de depender únicamente de las sesiones del navegador.
Share this article



