¿Apple dirige las peticiones de IA a Google Cloud? Esta arquitectura de delegación en la nube híbrida representa un cambio notable en materia de transparencia, ya que iOS 27 introduce avisos de consentimiento explícito para el usuario antes de enviar cargas de trabajo generativas específicas a Google Cloud. A medida que la IA de consumo se expande más allá de los modelos locales en el dispositivo, la inferencia basada en la nube se está convirtiendo en una parte esencial de los servicios de IA modernos. Hoy en día, las plataformas de IA distribuyen cada vez más cargas de trabajo intensivas en computación a través de entornos de nube de terceros de confianza, lo que hace que el consentimiento explícito del usuario y el enrutamiento transparente sean fundamentales. Dado que estas plataformas gestionan solicitudes generativas más complejas a través de infraestructuras externas, las rutas de verificación seguras en entornos multinube se han vuelto críticas para preservar la confianza del usuario.
Por qué Apple dirige las peticiones de IA a Google Cloud: conciliando las promesas de privacidad con el escalado multinube
Resumen
- Los avisos de permiso introducidos en las versiones beta de los sistemas operativos estándar alertan a los usuarios cuando las peticiones generativas específicas se dirigen a servidores externos.
- Los modelos base (Foundation Models) de Apple y las cargas de trabajo locales permanecen estrictamente separados de las tuberías de ejecución en la nube de terceros.
- La arquitectura ampliada introduce un patrón de delegación en la nube híbrida, utilizando entornos aislados y cifrados para procesar solicitudes generativas complejas.
El diseño de la inteligencia artificial de consumo actual depende en gran medida de un delicado equilibrio entre el procesamiento local y la escalabilidad en la nube. Cuando los modelos estándar en el dispositivo realizan tareas rutinarias, los datos permanecen almacenados de forma segura en la memoria local del terminal. Sin embargo, cuando se solicitan funciones generativas complejas y que requieren muchos recursos (como la generación avanzada de imágenes o el procesamiento de presentaciones complejas), el hardware local debe delegar la computación a clústeres en la nube de alto rendimiento. Esto crea un desafío de flujo de datos: ¿cómo puede un sistema escalar sus capacidades de computación sin comprometer sus compromisos fundamentales de privacidad?
En los últimos dos años, las arquitecturas de IA híbrida se han convertido en una estrategia de despliegue importante para las plataformas de consumo. Al aprovechar tanto los modelos base en el dispositivo como las redes de servidores remotos, estos servicios pueden ofrecer experiencias generativas altamente avanzadas sin sobrecargar el terminal del usuario. Sin embargo, el requisito de equilibrar la escala de la nube con la seguridad de los datos ha desplazado las prioridades arquitectónicas hacia entornos multinube seguros y aislados.

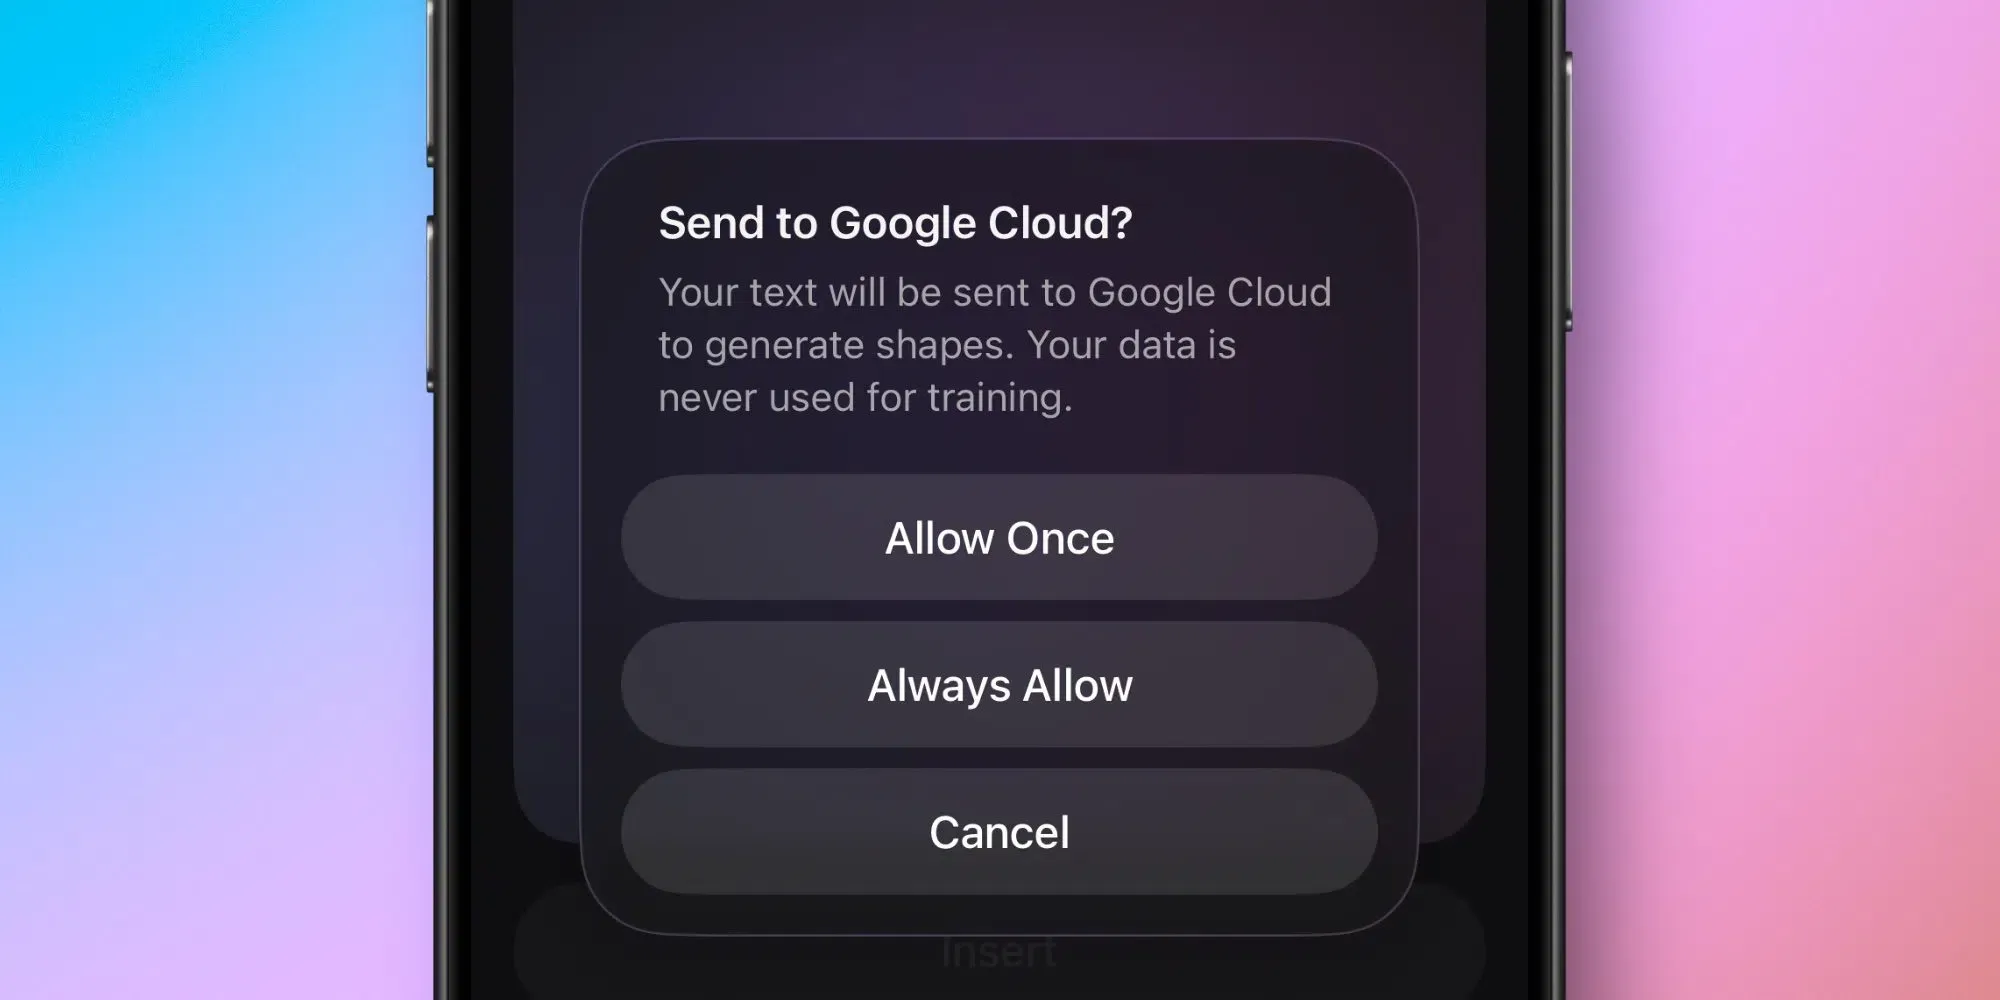
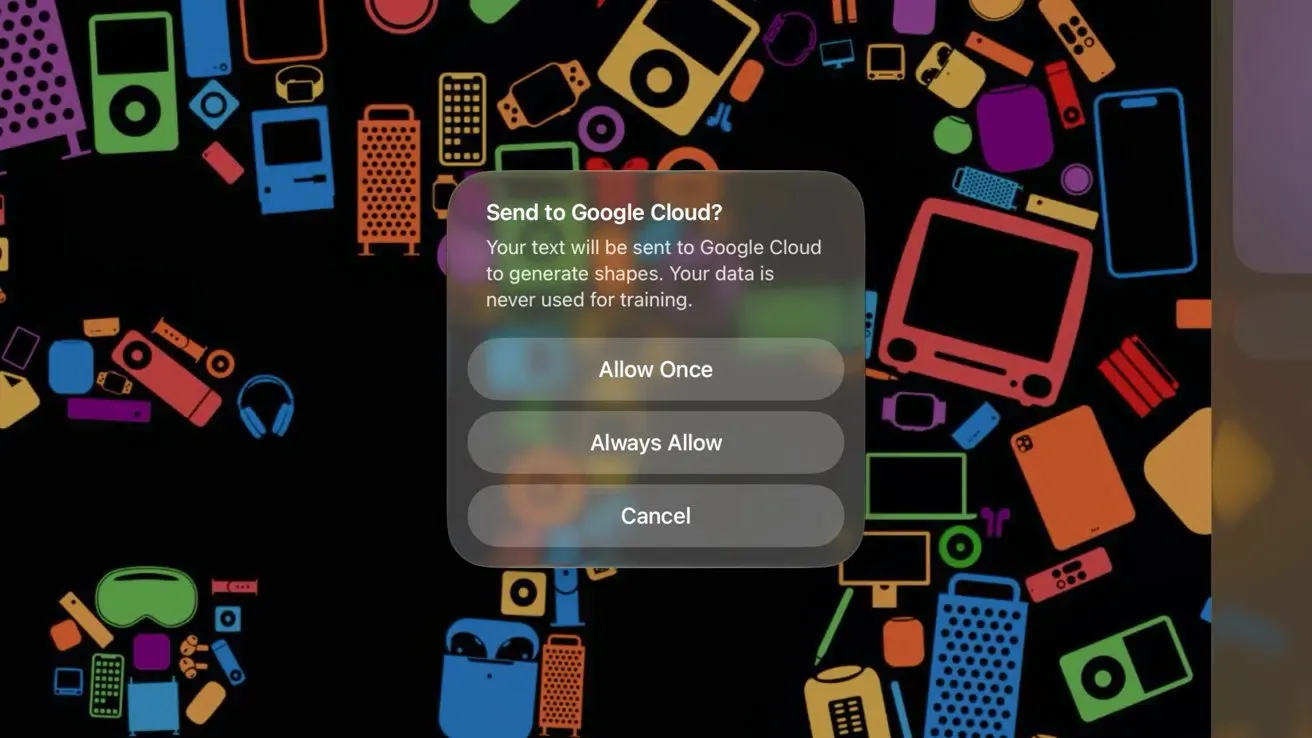
La decisión de Apple de dirigir peticiones seleccionadas de IA a Google Cloud va más allá de la simple distribución de carga de trabajo. Bajo este marco actualizado, determinadas cargas de trabajo no locales (como la generación de imágenes en aplicaciones de productividad y el renderizado avanzado en estudios de creación) activan una solicitud de permiso explícita antes de dirigir los datos a los servidores de Google Cloud. Este cambio no afecta a los modelos base principales en el dispositivo, que siguen ejecutándose localmente. Comprender cómo se gestiona la dirección de las peticiones de IA de Apple a infraestructuras externas ayuda a los desarrolladores a evaluar cómo se hace visible para el usuario final el enrutamiento externo de las solicitudes generativas pesadas, dando a los individuos el poder de aceptar o rechazar la transferencia de datos caso por caso.
Mecánica interna: IA local frente al enrutamiento de peticiones de IA híbrida
El motor fundamental detrás de esta arquitectura híbrida es la necesidad de mantener fuertes protecciones de privacidad mientras se escala la infraestructura. Para lograrlo, el operador de la plataforma está extendiendo sus patrones de seguridad de «Cómputo en la Nube Privada» (PCC) directamente a centros de datos de terceros. Bajo este modelo colaborativo, las cargas de trabajo delegadas a servidores externos se procesan dentro de entornos de ejecución altamente seguros y aislados, como se explica en el análisis de los modelos base de Apple.
Estos nodos seguros aprovechan el sandboxing a nivel de hardware, como las máquinas virtuales confidenciales y procesos aislados dedicados. Esto garantiza que el proveedor de nube externo no pueda almacenar permanentemente, registrar ni utilizar las peticiones transmitidas para el entrenamiento de modelos. Los datos se procesan de forma efímera y se eliminan inmediatamente una vez completada la tarea. Esta arquitectura establece un modelo seguro de enrutamiento de peticiones para servicios de IA híbrida mientras preserva la privacidad del usuario.
Distinción técnica: redirección con estado frente a flujos de sesión sin estado
Desde una perspectiva de ingeniería, dirigir datos a través de múltiples límites de nube requiere un estricto aislamiento de sesión. En las arquitecturas con estado estándar, las identidades de usuario se rastrean a través de diferentes entornos mediante cookies persistentes, lo que crea riesgos significativos de cumplimiento y fugas de datos. Por el contrario, un enfoque sin estado (stateless) procesa cada petición como un evento independiente y aislado, asegurando que no se establezca ningún contexto de relación permanente. Esta alineación potencial ocurre sin interacción directa del usuario, destacando los desafíos técnicos fundamentales asociados con el tema de las peticiones de IA que Apple dirige.
El siguiente diagrama ilustra esta separación física:
[Ejecución estándar en el dispositivo]
  Entrada del usuario ──> Modelo base de Apple (Procesamiento local) ──> Cero datos fuera del dispositivo


[Delegación en nube híbrida]
  Entrada del usuario ──> Puerta de enlace de seguridad PCC ──> Máquina virtual confidencial de Google Cloud ──> Contexto temporal (contexto soberano preservado)
La implementación del procesamiento de solicitudes sin estado minimiza los identificadores persistentes y reduce la cantidad de datos de usuario almacenados por la plataforma. Aunque el ancho de banda de memoria y la atribución de aplicaciones pertenecen a diferentes dominios de ingeniería, ambos destacan el mismo principio arquitectónico: mover la gestión del estado desde recursos locales limitados hacia una infraestructura de servidor escalable. Desafíos similares existen en la atribución móvil, donde las restricciones de privacidad también reducen la dependencia de identificadores persistentes del lado del cliente. Cuando las interacciones de los usuarios se desacoplan de las cookies locales persistentes y con estado para cumplir con las pautas de privacidad, mantener una continuidad de sesión fluida entre diferentes entornos se vuelve altamente complejo. Del mismo modo que los procesadores requieren tuberías de memoria persistentes y de alta velocidad para igualar los contextos de estado, las tuberías de marketing downstream requieren una preservación de datos robusta y del lado del servidor para correlacionar eventos de instalación separados sin depender de cookies vulnerables del lado del cliente o atributos a nivel de dispositivo.
Escenario de ejemplo: ¿qué sucede cuando generas una imagen?
Supongamos que un usuario crea una presentación generada por IA dentro de la suite de productividad de Apple. Si la solicitud supera las capacidades del modelo base del dispositivo, el sistema operativo muestra primero un diálogo de permiso explicando que la tarea será procesada por Google Cloud. Solo después de una aprobación explícita se reenvía la petición cifrada a través de Private Cloud Compute a un entorno de ejecución aislado. Una vez completado el procesamiento, los datos temporales se eliminan de acuerdo con la arquitectura de privacidad publicada por Apple.
Construir frente a comprar: preservación del contexto de sesión en cargas de trabajo de IA híbrida
A medida que las plataformas reestructuran sus marcos conversacionales para cumplir con estrictas pautas de privacidad de datos, los desarrolladores deben reevaluar cómo gestionan el estado de la sesión y la identidad del usuario. La gestión de los estados de sesión en entornos donde Apple dirige peticiones de IA requiere arquitecturas que sean tanto conformes con las leyes de privacidad de datos como altamente precisas. Además, cuando Apple dirige peticiones de IA a través de proveedores de nube externos, las organizaciones deben alejarse de los identificadores tradicionales a nivel de dispositivo. Dependiendo de los requisitos comerciales, los equipos pueden construir estas capacidades internamente o adoptar plataformas de atribución existentes.
Evaluación arquitectónica: desarrollo personalizado frente a SDK estandarizado
Construir un sistema interno para gestionar la coincidencia de estados del lado del servidor ofrece la máxima flexibilidad, pero exige importantes recursos de ingeniería continuos. Los desarrolladores deben construir manualmente esquemas de base de datos, escribir funciones de hash criptográfico seguras y actualizar continuamente el sistema para cumplir con las cambiantes regulaciones regionales. Por el contrario, implementar un SDK preconstruido y certificado reduce la complejidad de la integración y garantiza el cumplimiento a largo plazo sin gastos adicionales.
La siguiente tabla compara metodologías estándar para gestionar el estado de sesión y el contexto de conversión:
| Solución | Persistencia | Rendimiento | Ideal para |
|---|---|---|---|
| Base de datos de sesión interna | Alta (Sincronización continua) | Media (Límites de latencia de BD) | Entornos empresariales personalizados con lógica de almacenamiento altamente especializada |
| Rastreo de sesión basado en navegador | Baja (Cookies de sesión) | Baja (Sin registro en servidor) | Rastreo web básico con requisitos de conversión multidominio mínimos |
| Caché del lado del servidor (ej. OpoInstall) | Ninguna (Tokens de sesión temporales en servidor) | Alta (Entorno aislado estandarizado) | Atribución de aplicaciones móviles y campañas multiplataforma a gran escala |
Si bien las configuraciones de base de datos personalizadas pueden manejar un contexto básico, la preservación especializada del estado del lado del servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones en el servidor o adoptar plataformas comerciales como OpoInstall. Por ejemplo, OpoInstall ofrece marcos de restauración de estado del lado del servidor y transferencia de parámetros, asignando metadatos de sesión a una base de datos de sesión en el servidor para mantener la continuidad de forma anónima, sin almacenar historiales conversacionales personales sensibles a largo plazo. Al asignar metadatos de sesión a una base de datos centralizada en lugar de depender de redirecciones basadas en navegador, dicho sistema garantiza que los contextos de conversión permanezcan consistentes incluso cuando las tareas iniciales se ejecutan de forma anónima. Los equipos de ingeniería pueden evaluar estos enfoques para equilibrar la protección de datos y la consistencia de la medición.
Listas de verificación de integración: cómo pueden prepararse los equipos de ingeniería para los cambios de plataforma
Para prepararse para cargas de trabajo de IA cada vez más distribuidas, los equipos de ingeniería y producto deben establecer calendarios claros de gobernanza de datos. Esto garantiza que los datos del usuario se manejen de forma segura, se respeten los límites de cumplimiento y las tuberías de marketing permanezcan intactas.
Lista de verificación de implementación para desarrolladores
- Auditar transferencias de datos de terceros: Revisar todas las llamadas API externas para asegurar que las cargas útiles de las peticiones no se registren permanentemente en retransmisiones intermedias.
- Implementar saludos de sesión sin estado: Realizar la transición de las rutas de API a modelos de procesamiento sin estado, utilizando tokens firmados criptográficamente para pasar contexto temporal entre nodos.
- Validar flujos de consentimiento de terceros: Implementar la validación de avisos explícitos del lado del cliente antes de reenviar cargas de trabajo generativas a nubes externas.
Lista de verificación de estrategia de producto y crecimiento
- Optimizar experiencias de IA híbrida: Reconstruir funciones generativas orientadas a tareas y de alta utilidad que expliquen claramente las rutas de procesamiento de IA externa a los usuarios.
- Optimizar embudos de conversión: Aprovechar marcos de transferencia de parámetros no intrusivos para mantener el seguimiento de adquisición sin violar las pautas de privacidad del usuario.
- Monitorear el cumplimiento de la plataforma: Asegurar que todos los SDK de terceros integrados cumplan con las leyes locales de protección de datos y los requisitos de la plataforma.
Al establecer estas directrices estructuradas, los equipos de desarrollo pueden hacer la transición de sus aplicaciones hacia arquitecturas más seguras y conformes, manteniendo al mismo tiempo la continuidad operativa.
Preguntas frecuentes (FAQ)
¿Por qué Apple muestra un aviso antes de enviar peticiones de IA a Google Cloud?
¿Cómo asegura Private Cloud Compute que los datos del usuario permanezcan seguros en servidores de terceros?
¿Qué peticiones de IA de Apple se dirigen a Google Cloud?
Puntos clave para los equipos de ingeniería
A medida que las plataformas de IA dependen cada vez más de la inferencia en la nube híbrida, los desarrolladores deben rediseñar los productos en torno a la privacidad, el consentimiento transparente y el enrutamiento seguro de datos. Las arquitecturas de datos en evolución requieren un cambio fundamental en la forma en que construimos y medimos las experiencias digitales. A medida que los proxies sin estado y los scrapers sin interfaz se convierten en consumidores estándar de contenido web, los modelos de atribución tradicionales del lado del cliente seguirán degradándose. Confiar en cookies y referentes estándar ya no es suficiente para asegurar los canales de datos que impulsan la adquisición de usuarios.
A medida que Apple expande su infraestructura de IA híbrida, es probable que el enrutamiento transparente en la nube y el consentimiento explícito del usuario se conviertan en requisitos arquitectónicos estándar en toda la industria. Mirando hacia el futuro, los equipos de ingeniería dependerán cada vez más de arquitecturas sin estado, gestión de sesiones del lado del servidor y diseño que prioriza la privacidad. Las organizaciones que se preparen para estos cambios con antelación estarán mejor posicionadas para mantener productos de IA sostenibles y conformes a la normativa.
Share this article



