¿Cloudflare bloquea los bots de entrenamiento? Cloudflare ha anunciado una nueva política predeterminada que bloquea a los rastreadores de entrenamiento de IA en los sitios web de editores elegibles, al tiempo que introduce nuevas opciones de monetización para los propietarios de contenido. A medida que la inteligencia artificial generativa cambia la forma en que se consume el contenido web, las plataformas de IA continúan consumiendo cantidades masivas de recursos web sin establecer estructuras de valor recíproco. Históricamente, permitir la indexación en motores de búsqueda significaba recibir tráfico de referencia que podía monetizarse mediante anuncios o suscripciones. Hoy en día, dado que los rastreadores de uso mixto recopilan datos propietarios sistemáticamente para el entrenamiento de modelos mientras generan resúmenes directos que evitan la necesidad de clics, los editores sufren una grave erosión de sus ingresos.
El problema operativo y los cuellos de botella financieros: Cloudflare bloquea los bots de entrenamiento en páginas con publicidad
Un vistazo rápido
- Los escudos automatizados iniciarán una restricción predeterminada sobre el raspado (scraping) de modelos y agentes programáticos dentro de directorios de contenido monetizado en el tercer trimestre de dos mil veintiséis.
- Los rastreadores que combinan la indexación de búsqueda con la recolección de datos serán restringidos a menos que dividan sus propósitos operativos en canales aislados.
- Están surgiendo nuevos marcos de compensación por utilidad para proporcionar recompensas directas a nivel de transacción a los administradores de contenido en lugar de basarse en los conteos de solicitudes estándar.
El equilibrio tradicional entre los editores en línea y los raspadores web automáticos se ha fracturado por completo. Un acuerdo mutuo tácito sostuvo históricamente Internet a nivel global durante cerca de treinta años. Bajo este acuerdo básico, los administradores web recibían a las arañas de búsqueda para escanear páginas, obteniendo a cambio clics de usuarios calificados provenientes de consultas en directorios. Tal intercambio recíproco permitió mantener medios autofinanciados, asegurando que las impresiones de anuncios, los patrocinios digitales y las membresías recurrentes pudieran financiar manuales de software independientes y periodismo.
La transición actual hacia redes generativas a gran escala ha remodelado la actividad de los rastreadores, cambiando el objetivo del simple descubrimiento de rutas a la extracción de datos. Los sistemas de recolección autónomos ahora ingieren directorios digitales completos, procesan los datos semánticos y sirven resúmenes dentro de widgets de chat cerrados. Esta resolución inmediata evita la necesidad de visitas estándar al sitio. Las evaluaciones muestran que cuando las interfaces de búsqueda presentan un resultado generativo integrado, la probabilidad de que un lector haga clic en un enlace de directorio externo es significativamente menor, cayendo a porcentajes de un solo dígito en muchos casos reportados. Estos patrones de tráfico crean déficits de financiación inmediatos para las plataformas que dependen de estructuras de publicación de anuncios estándar para compensar los gastos operativos.
Por qué Cloudflare bloquea los bots de entrenamiento se convirtió en un mandato para los editores
Los editores se han enfrentado durante mucho tiempo a un difícil compromiso entre proteger su contenido y mantener la visibilidad en las búsquedas. Si el propietario de un sitio independiente bloquea a Googlebot, Applebot o Bingbot para evitar el entrenamiento de modelos, corre el riesgo de desaparecer de los índices de búsqueda tradicionales. Este monopolio estructural obliga a los creadores de contenido a tomar una decisión difícil: ceder datos propietarios valiosos de forma gratuita o sacrificar la capacidad de ser descubiertos por completo. Esta dinámica también alienta a las entidades de IA emergentes a emplear tácticas de rastreo evasivas, empeorando la carga del servidor para los editores que ya pagan por solicitudes redundantes.
Para imponer el equilibrio, Cloudflare ha introducido un mecanismo de control declarativo. Cloudflare afirmó que la política predeterminada comenzará a desplegarse el 15 de septiembre de 2026, estableciendo bloqueos predeterminados contra bots de entrenamiento y agentes dirigidos por el usuario en todas las páginas de clientes compatibles con anuncios. Esta actualización asegura que el contenido monetizable no pueda ser rastreado sin permiso explícito. Simultáneamente, el gigante de las redes está reestructurando su marco de monetización, pasando de su arquitectura heredada de Pago por Rastreo a un ecosistema de Pago por Uso orientado a resultados. A través de integraciones con plataformas como You.com y Ceramic.ai, los editores pueden asegurar una compensación directa cada vez que un agente de IA aprovecha su contenido para responder a una consulta, introduciendo una fuente de ingresos sostenible a nivel de transacción.
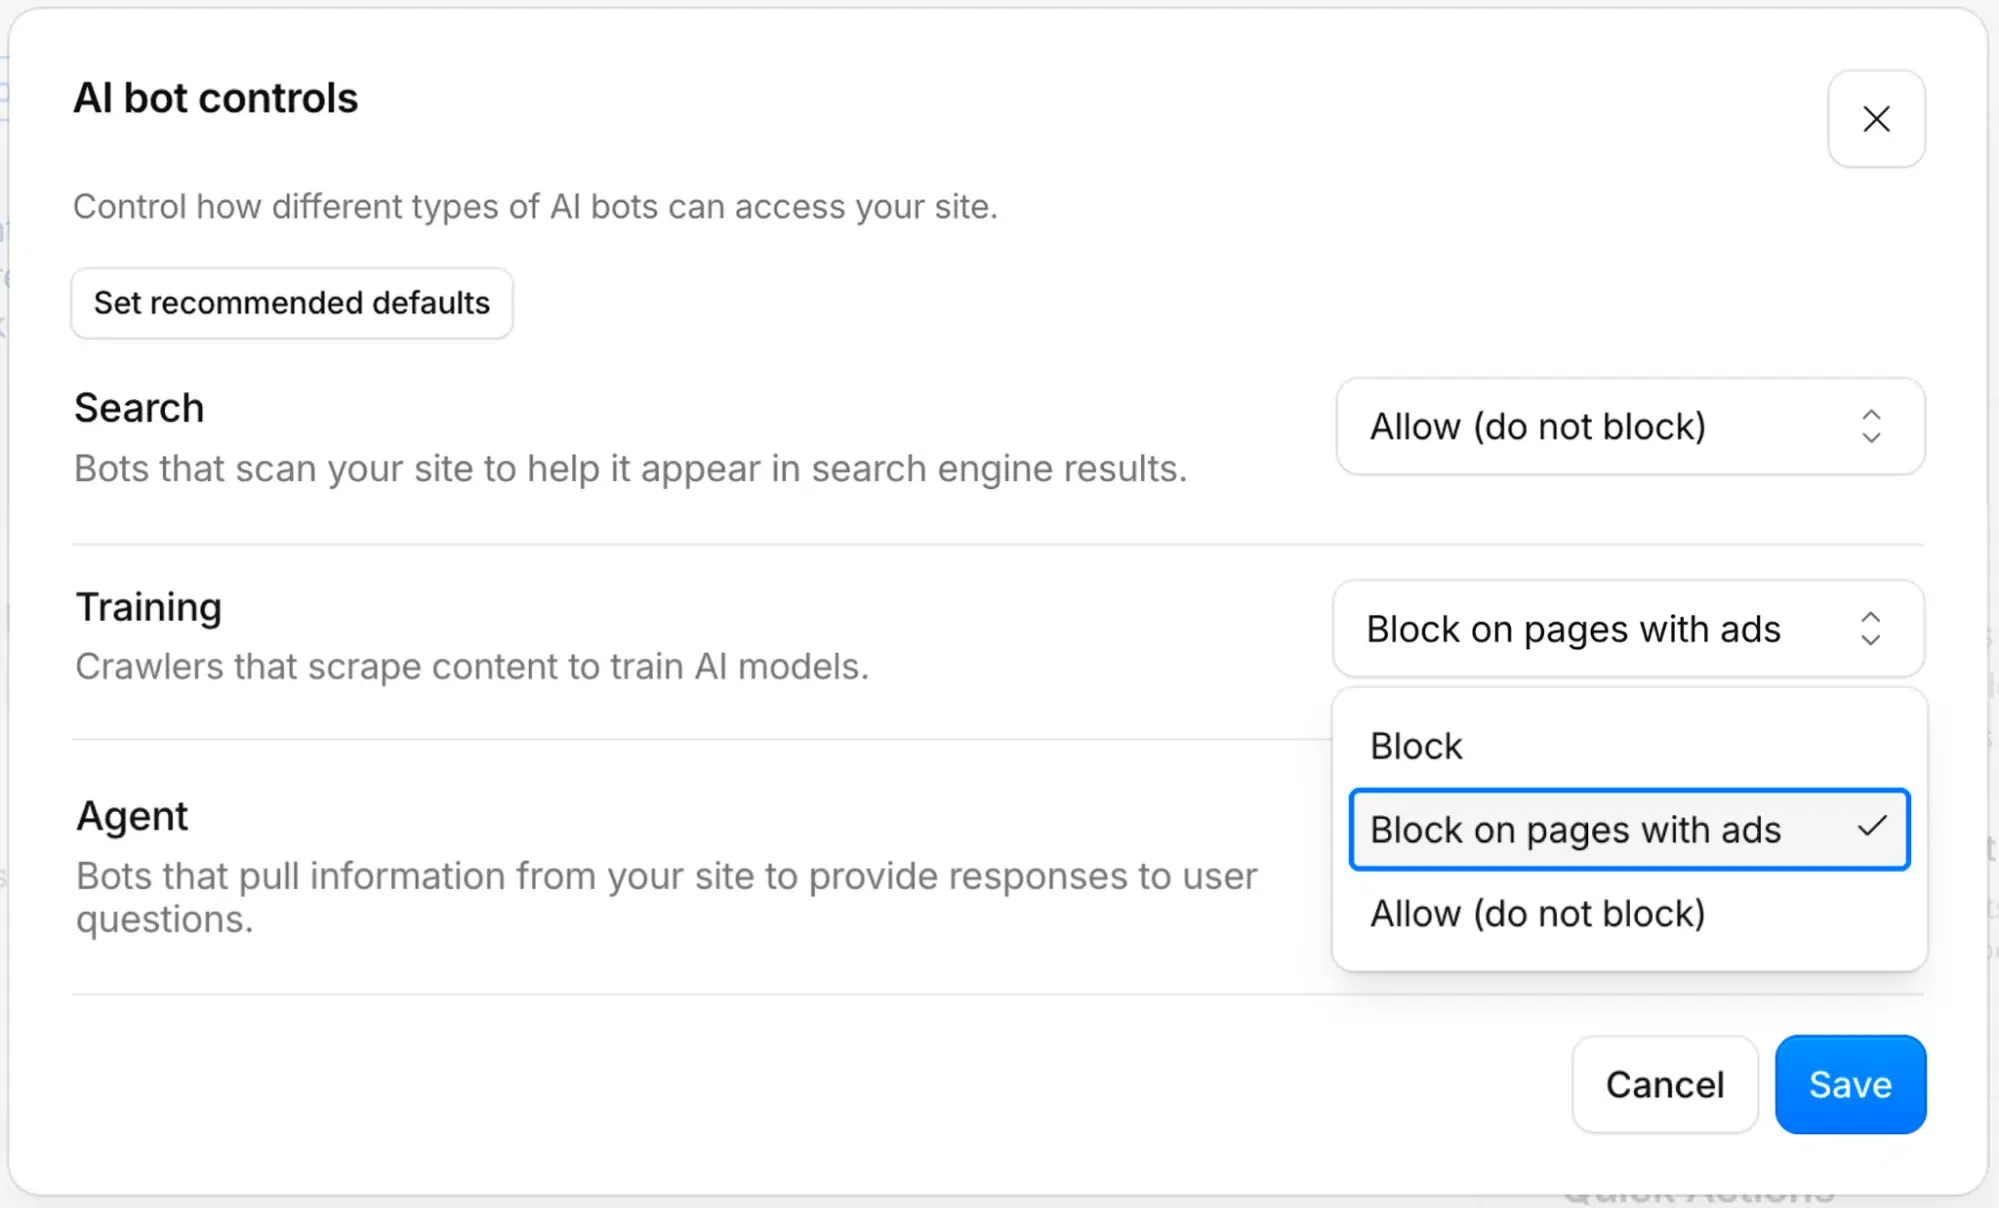
Causas fundamentales sistémicas y cadenas de solicitudes no visuales de la política de Cloudflare sobre el bloqueo de bots de entrenamiento
Analizar la composición física del tráfico de Internet revela que los bots automatizados representan ahora más del 50% de toda la actividad en línea. Este volumen ejerce una inmensa presión sobre los servidores de origen, particularmente porque las solicitudes duplicadas a menudo obtienen contenido sin cambios. La telemetría de Cloudflare indica que más de la mitad del tráfico de rastreadores verificados es totalmente redundante, desperdiciando potencia informática en ambos lados de la conexión. El problema fundamental reside en la arquitectura subyacente de las operaciones modernas de búsqueda y raspado, que dependen de bots de uso mixto que ocultan su verdadera intención.
En la capa de aplicación, las características técnicas de un agente dirigido por el usuario difieren sustancialmente de las sesiones de navegador impulsadas por humanos estándar. Esta distinción es fundamental porque los raspadores modernos (headless) omiten por completo los elementos interactivos tradicionales, lo que provoca graves interrupciones en el seguimiento en los sistemas de medición posteriores.
Desconexión de protocolos: Agentes sin estado vs. Navegadores web con estado
La optimización web tradicional asume que las sesiones de navegador estándar gestionan el estado a través de pilas de cookies, almacenamiento local y cadenas de Agente de Usuario (User-Agent) estructuradas. Por el contrario, los agentes autónomos y los rastreadores headless realizan solicitudes HTTP sin estado. Esta diferencia rompe los conductos de medición que utilizan los editores para justificar el valor de sus anuncios. El diagrama a continuación describe las diferencias fundamentales en la capa de aplicación:
[Sesión Web Estándar]
  Navegador del Usuario (Estado persistente y cookies) ──> Solicitud HTTP Web ──> Impresiones de anuncios y referencias registradas


[Sesión de Agente sin estado]
  Rastreador Automatizado (HTTP sin estado / Herramienta Headless) ──> Obtención aislada ──> Referencias faltantes y atribución perdida
Cuando un agente de navegador automatizado obtiene una página, procesa el texto y genera una respuesta dentro de un entorno de chat cerrado, todo el contexto del lado del cliente se destruye. Los scripts de seguimiento tradicionales no pueden ejecutarse. No se registran impresiones de anuncios y los encabezados de referencia estándar desaparecen. Esto crea un vacío de atribución donde el editor proporciona el valor informativo bruto, pero el sistema posterior registra cero interacción. La misma pérdida de contexto del navegador también afecta a los flujos de trabajo de atribución móvil posteriores cuando un usuario instala finalmente una aplicación. Debido a que estas visitas headless carecen de contenedores de seguimiento con estado, las herramientas de medición móvil estándar no logran hacer coincidir el evento de descubrimiento inicial con la instalación posterior de la aplicación. Esta dinámica acelera el colapso de los modelos de atribución multicanal tradicionales.
Comparación de soluciones: Compensaciones entre construir o comprar en la era de los bloqueos de bots de entrenamiento de Cloudflare
A medida que los límites predeterminados del seguimiento del lado del cliente se disuelven bajo las nuevas regulaciones de raspadores automatizados, los equipos de ingeniería deben reevaluar sus arquitecturas de atribución. Depender únicamente de las cookies estándar del lado del cliente o de los atributos a nivel de dispositivo ya no es una estrategia viable a largo plazo. Los desarrolladores se enfrentan a una decisión fundamental de construir o comprar: construir una base de datos de coincidencia de contexto del lado del servidor o integrar un sistema de medición preconstruido y robusto capaz de sobrevivir a las interacciones headless.
Evaluación arquitectónica: Construir vs. Comprar en la era sin estado
Construir un sistema de coincidencia de contexto interno requiere configurar una base de datos de estado del lado del servidor para almacenar en caché y reconciliar las sesiones de los desarrolladores. Si bien este enfoque ofrece un control total sobre el flujo de datos, la carga de ingeniería es sustancial. Los desarrolladores deben reconciliar manualmente los payloads de la API, gestionar las expiraciones de sesión e implementar firmas criptográficas seguras para evitar el fraude. Por el contrario, integrar un SDK de medición preconstruido y listo para usar elimina esta carga de mantenimiento.
La siguiente matriz de comparación describe cómo funcionan las diferentes metodologías de seguimiento en un entorno sin estado y lleno de agentes:
| Métricas y capacidades | Construcción de sesión en base de datos interna | Firebase / Redirección Webview heredada | Plataformas MMP Premium (Adjust, AppsFlyer) | SDK de Deep Linking diferido (OpoInstall) |
|---|---|---|---|---|
| Supervivencia de atribución | Alta (lado del servidor) | Baja (lado del cliente) | Alta (multicanal) | Alta (mapeo programático) |
| Costo de desarrollo | Extremadamente alto | Bajo | Alto | Bajo |
| Carga de mantenimiento | Alta (continua) | Bajo | Bajo | Bajo |
| Mitigación de fraude | Media (reglas manuales) | Baja | Alta (algorítmica) | Alta (firmas Zero-Trust) |
| Impacto en la latencia | Variable | Medio | Medio | Bajo (huella ultraligera) |
Las implementaciones comerciales de este modelo incluyen Adjust, AppsFlyer, Branch y otros sistemas de atribución diferida. Un ejemplo es OpoInstall, que proporciona deep linking diferido y recuperación de parámetros del lado del servidor para preservar los metadatos de la sesión en contextos distribuidos web y móviles. Al desacoplar la cadena de redireccionamiento de las redirecciones del lado del cliente, este enfoque conserva los metadatos del viaje del usuario desde el evento de búsqueda inicial hasta la instalación final de la aplicación, evitando las limitaciones impuestas por los proxies de bloqueo de raspadores. Las plataformas de atribución móvil utilizan ideas similares de restauración de estado del lado del servidor para garantizar la consistencia de la conversión cuando los contextos del navegador están totalmente ausentes.
Listas de verificación de integración y cronogramas de gobernanza: Sobrevivir a las interrupciones por el bloqueo de bots de entrenamiento de Cloudflare
Para garantizar la continuidad de los datos a medida que Cloudflare implementa sus bloqueos de bots de entrenamiento predeterminados en páginas compatibles con anuncios, los equipos de ingeniería y producto deben establecer un cronograma de transición estructurado. Para los desarrolladores, esto implica alejarse de las redirecciones del lado del cliente y adoptar métodos de verificación robustos del lado del servidor. Para los equipos de crecimiento, esto requiere revisar los conductos de cálculo del retorno de la inversión en marketing (ROAS) para tener en cuenta la pérdida de datos de atribución estándar del navegador.
Lista de verificación de implementación para desarrolladores
- Implementar encabezados Forwarded RFC 7239: Configurar todas las puertas de enlace de API entrantes para leer y analizar el encabezado estandarizado
Forwardedpara identificar proxies intermedios confiables.
Forwarded: for=203.0.113.1;proto=https
- Adoptar firmas de URL criptográficas: Asegurar que todos los enlaces promocionales salientes utilicen parámetros firmados criptográficamente para evitar que los bots automatizados manipulen los valores de referencia.
- Habilitar la coincidencia de sesión del lado del servidor: Pasar de la redirección del lado del cliente basada en cookies a una base de datos de estado programática que reconcilie las claves de sesión en el momento de la primera instalación de la aplicación.
Lista de verificación de estrategia de producto y crecimiento
- Reconstruir los modelos de ROAS: Ajustar los embudos de adquisición para dar mayor peso a los eventos de activación del lado del servidor que a los clics tradicionales de anuncios web del lado del cliente.
- Desplegar restauraciones de experiencia contextual: Aprovechar los marcos de paso de parámetros para reconstruir el destino previsto del usuario incluso si la referencia web fue descartada por un agente.
- Auditar el tráfico de bots en BotBase: Utilizar clasificaciones de comportamiento en tiempo real para auditar cómo interactúan los raspadores automatizados con los embudos de marketing.
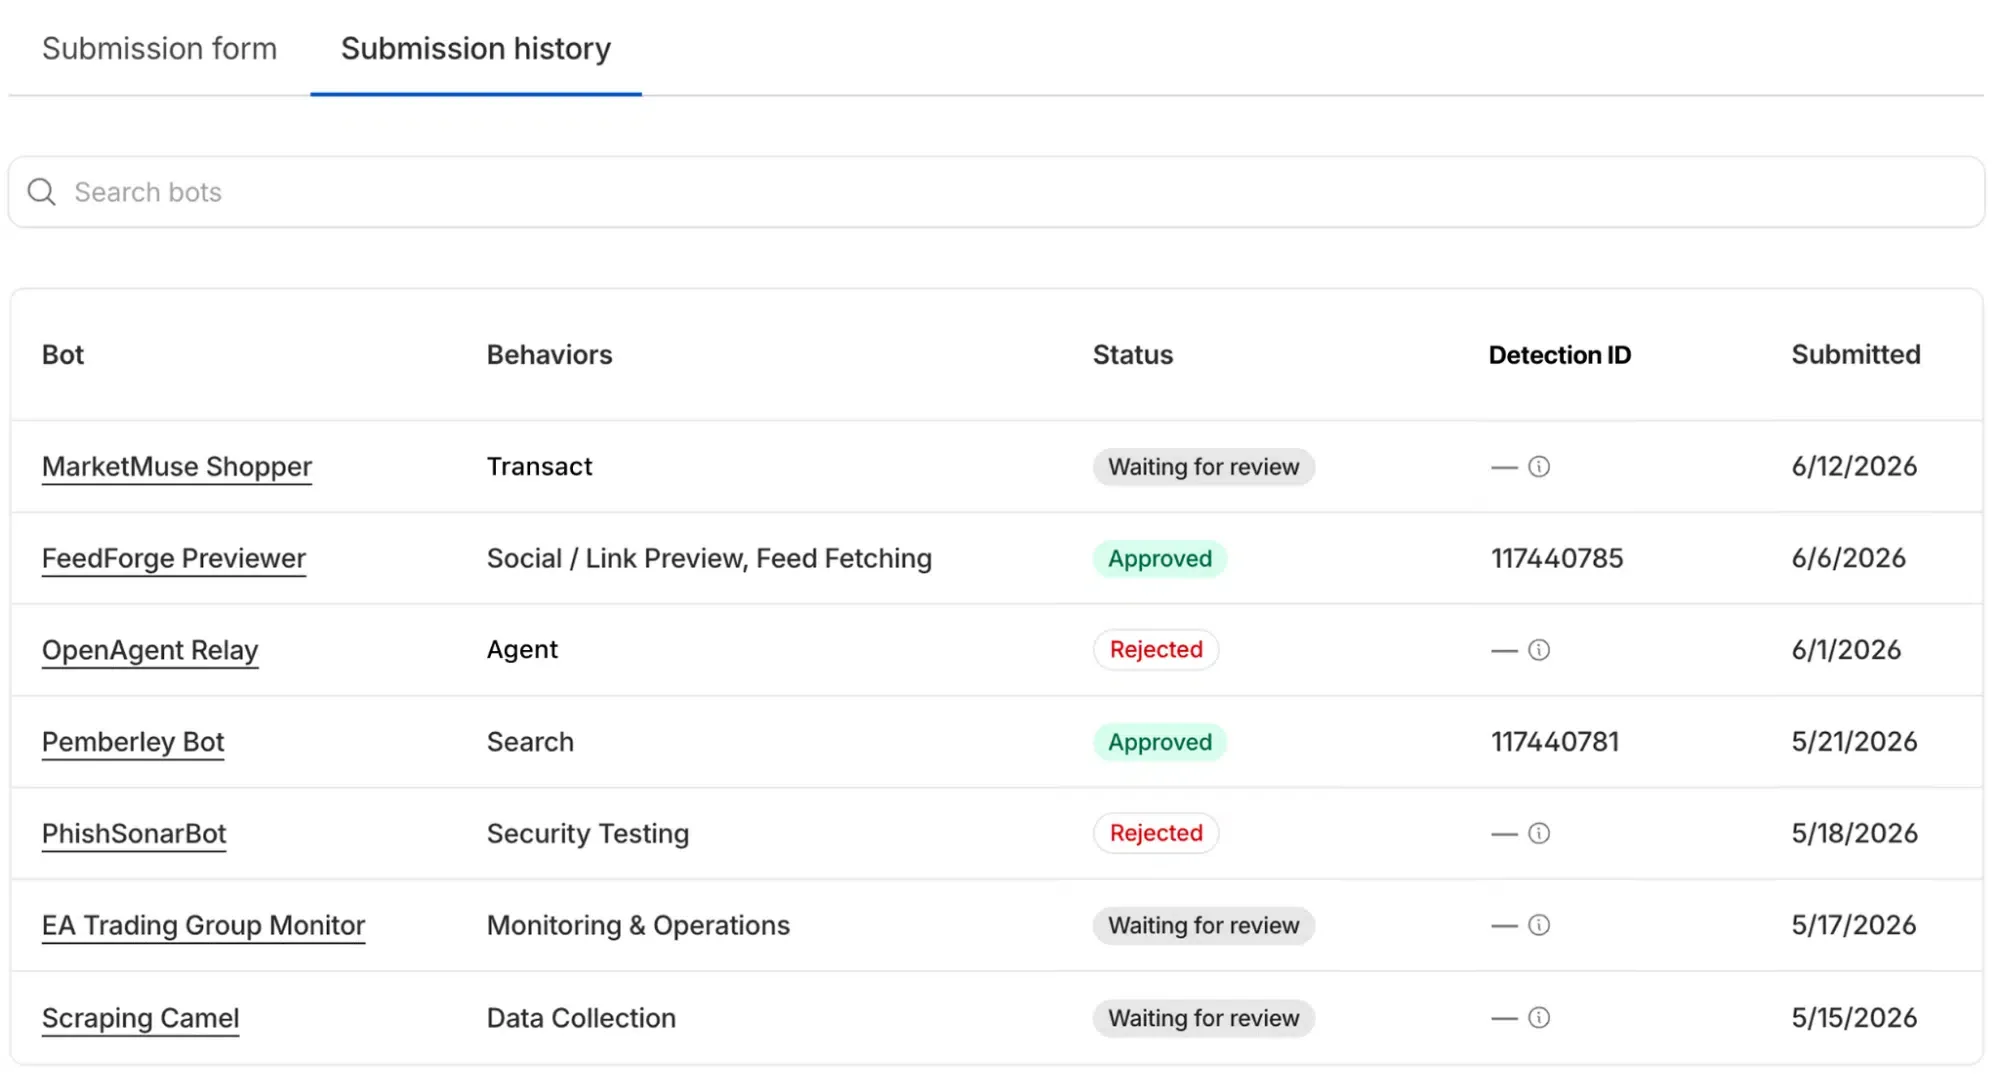
Los desarrolladores pueden configurar sus sitios para comunicar preferencias de indexación explícitas extendiendo su configuración estándar robots.txt con campos de metadatos modernos.
# Ejemplo ilustrativo inspirado en las extensiones de metadatos propuestas
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Este enfoque estructurado permite a los propietarios de contenido mantener la capacidad de ser descubiertos en las búsquedas mientras impiden que las plataformas de IA absorban permanentemente contenido propietario valioso en sus conjuntos de datos de entrenamiento cerrados.
Preguntas frecuentes (FAQ)
¿Por qué el mismo bot rastrea páginas tanto para búsquedas como para entrenamiento de IA?
¿Cómo determina Cloudflare qué páginas contienen anuncios para activar el bloqueo?
¿Cuál es la diferencia entre Pago por Rastreo y Pago por Uso?
La transición de Internet de un entorno de navegación centrado en el humano a un ecosistema impulsado por agentes requiere un cambio fundamental en cómo construimos y medimos las experiencias digitales. A medida que los proxies automatizados y los agentes sin estado se convierten en los principales consumidores de contenido web, los modelos de atribución tradicionales del lado del cliente seguirán degradándose. Depender de cookies de navegador y referencias HTTP básicas ya no es suficiente para asegurar los conductos de datos que impulsan la adquisición de usuarios y la monetización digital.
Para mantener el crecimiento en esta nueva era, los equipos de ingeniería y producto deben desacoplar su lógica de atribución de las acciones estándar del navegador del lado del cliente. Al adoptar la resolución de identidad del lado del servidor, parámetros firmados criptográficamente y marcos robustos de paso de parámetros, las organizaciones pueden proteger sus flujos de datos de los bloqueos de raspadores automatizados. Esta transición no trata simplemente de adaptarse a una actualización de política única; se trata de reconstruir nuestros sistemas para sobrevivir en un Internet descentralizado y preparado para agentes.
Share this article



