¿Google presenta Gemini 4 Hydrogen? Google DeepMind presentó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026, posicionando al modelo como un sistema rentable y de alto rendimiento para la ingeniería de software cotidiana y flujos de trabajo agénticos de múltiples pasos, tal como se detalla en el Anuncio oficial de Google DeepMind. A medida que los equipos de software implementan cada vez más agentes autónomos para navegar por repositorios y ejecutar pruebas, depender exclusivamente de modelos de razonamiento de frontera grandes genera una latencia notable y gastos de API compuestos. Si bien el razonamiento arquitectónico profundo sigue siendo esencial para el diseño de sistemas complejos, las tareas rutinarias de ingeniería como escribir ediciones localizadas, ejecutar arneses de pruebas y analizar registros de compilación requieren una ejecución rápida. Hydrogen está diseñado para servir tanto como una herramienta independiente para desarrollo de alto volumen como un motor de ejecución combinado con modelos de frontera en canales de enrutamiento multi-modelo.
Realineación central de la industria: Google presenta Gemini 4 Hydrogen para flujos de trabajo de alto rendimiento
De un vistazo
- Google DeepMind introdujo Gemini 4 Hydrogen como un modelo de alto rendimiento diseñado para gestionar código de rutina, preguntas y respuestas de repositorios y flujos de trabajo agénticos con menor latencia que los niveles de frontera.
- El modelo opera dentro de una ventana de contexto unificada de 1,048,576 tokens compartida entre entradas y salidas, con precios listados en $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida.
- La disponibilidad abarca Google AI Studio, la API de Gemini, Android Studio, Google Search y plataformas empresariales, con niveles de acceso que varían entre planes gratuitos para consumidores y espacios de trabajo para desarrolladores de pago.
Las demandas operativas de los flujos de trabajo de ingeniería de software han evolucionado más allá de la cumplimentación de código de un solo mensaje. Las configuraciones agénticas modernas a menudo activan decenas de pasos autónomos, incluida la lectura de estructuras de directorios, la inspección de árboles de dependencias, la propuesta de parches y la ejecución de pruebas de regresión. Cuando los desarrolladores enrutan cada acción rutinaria a través de modelos de razonamiento de frontera, la ejecución de tareas se ralentiza significativamente. En entornos iterativos, incluso una latencia moderada en llamadas a herramientas individuales puede acumularse en retrasos prolongados a lo largo de los ciclos de desarrollo automatizados.
Las discusiones de la industria en torno al lanzamiento reflejan un reconocimiento creciente de que la escalabilidad de la producción requiere la especialización de modelos. En lugar de tratar un único modelo de propósito general como la opción predeterminada para cada tarea de desarrollo, los equipos están evaluando arquitecturas por niveles. En estas configuraciones, los modelos de razonamiento de alta capacidad gestionan el diseño del sistema y el planteamiento de problemas ambiguos, mientras que los modelos de ejecución dedicados manejan operaciones repetitivas en la base de código. Google diseñó Hydrogen para abordar este nivel operativo, ofreciendo disponibilidad inmediata para desarrolladores a través de puntos finales de API estándar y entornos programáticos.
Análisis de puntos de referencia y límites técnicos de Gemini 4 Hydrogen
Google describe a Hydrogen como una versión adaptada de Gemini 4 Carbon. Sin embargo, la documentación técnica publicada no divulga detalles internos específicos sobre los mecanismos de transferencia de pesos, la arquitectura del tokenizador o los conductos de destilación. Por lo tanto, las evaluaciones técnicas deben centrarse en datos de pruebas observables, límites de contexto documentados y restricciones operativas reportadas en lugar de mecánicas internas inferidas.
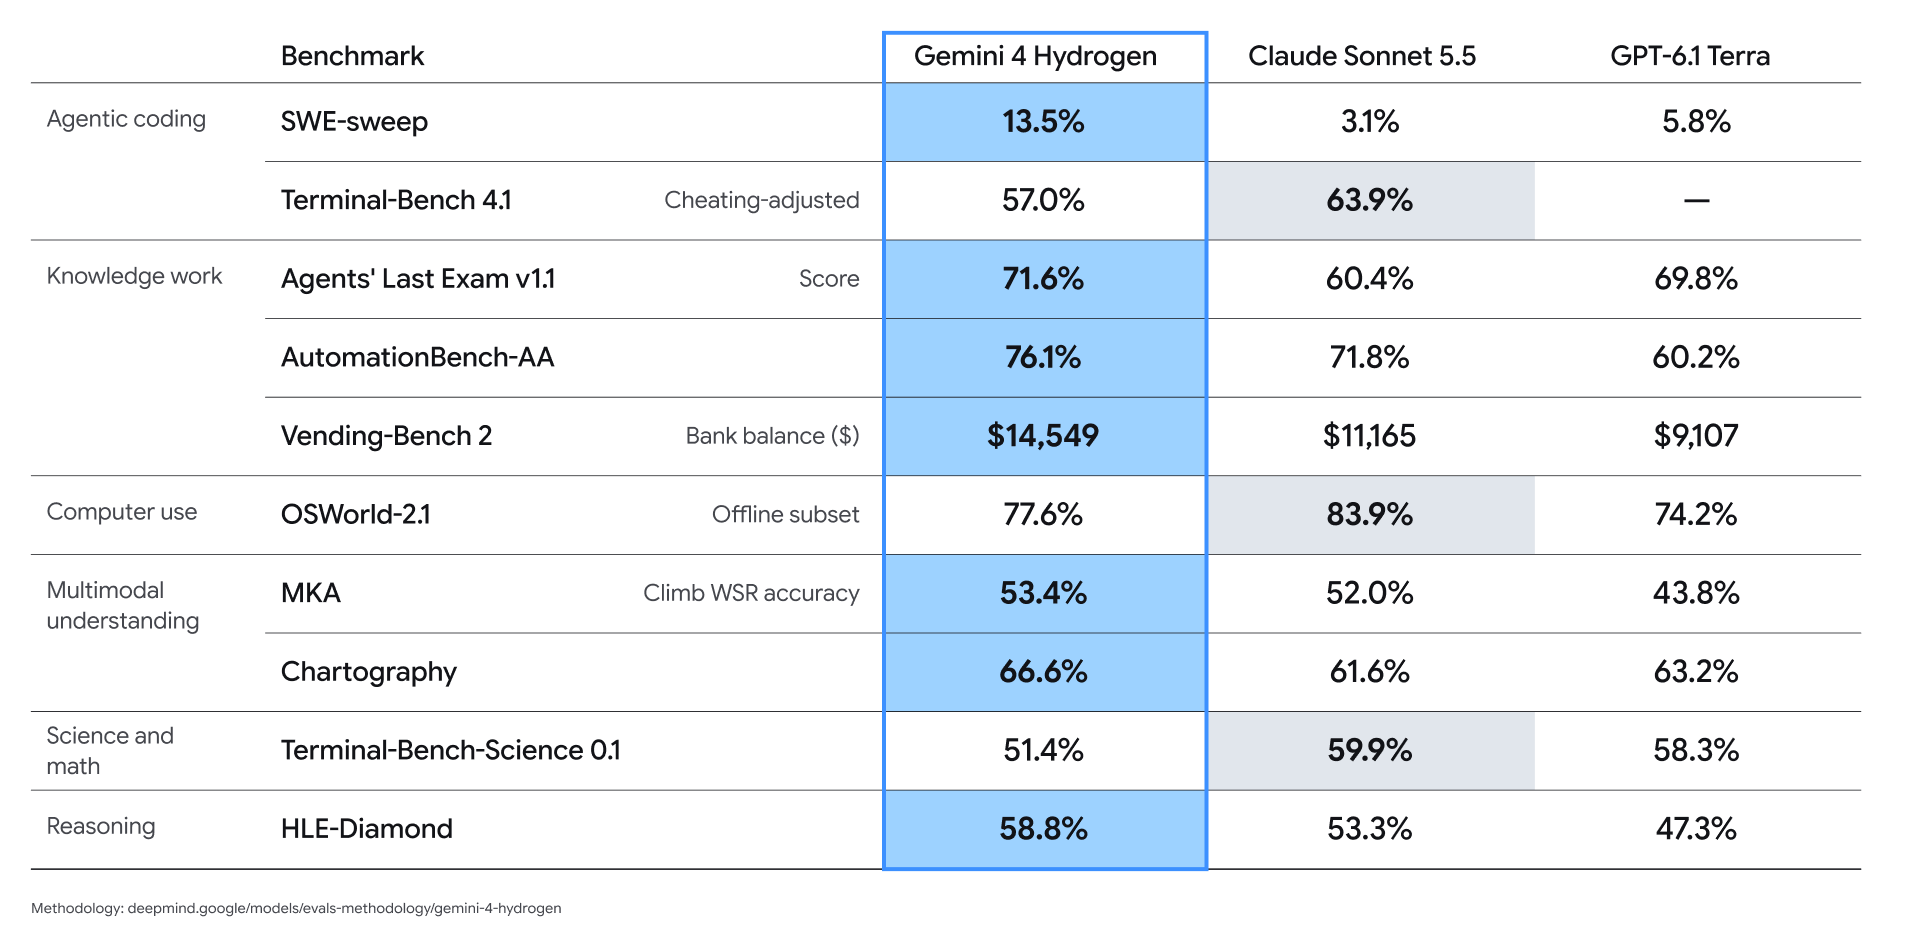
En las evaluaciones estándar reportadas en la Tarjeta del modelo Gemini 4 Hydrogen, Hydrogen demuestra claras diferencias de rendimiento en distintas categorías de tareas. En el punto de referencia SWE-sweep para la resolución de incidencias, Google reportó una tasa de resolución del 13.5% para Hydrogen, en comparación con el 3.1% para Claude Sonnet 5.5 y el 5.8% para GPT-6.1 Terra bajo las condiciones de evaluación especificadas. Por el contrario, en Terminal-Bench 4.1 bajo parámetros ajustados contra trampas, Hydrogen alcanzó el 57.0%, lo que mejora sustancialmente a Gemini 3.8 Flash (18.2%) pero se queda atrás de Claude Sonnet 5.5, que registró el 63.9%. En el índice independiente Artificial Analysis Intelligence Index, Hydrogen obtuvo una puntuación de 51 en su configuración predeterminada de pensamiento alto y de 54 en su configuración xhigh, en comparación con el 50 del modelo insignia Gemini 4 Argon.
Una consideración arquitectónica crítica es la capacidad de contexto del modelo, tal como se documenta en la Documentación de modelos de Google Cloud. Hydrogen proporciona un límite de contexto unificado de 1,048,576 tokens que se comparte entre todas las entradas y salidas. Esto significa que los archivos de entrada extensos reducen la capacidad de tokens restante disponible para las salidas del modelo. Un solo segmento en primer plano admite hasta 65,536 tokens de salida. El uso de generación más larga admite mecanismos de continuación, incluida la continuación gestionada por SDK, un bucle personalizado de tokens de continuación o la ejecución en segundo plano gestionada por el servidor cuando esté disponible. Todos los segmentos siguen estando sujetos al límite de contexto compartido. Los tokens de salida abarcan tokens de razonamiento interno, solicitudes de herramientas generadas y texto visible.
[Multi-Model Orchestrator Architecture in Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Planificación arquitectónica y razonamiento complejo)
                         └───────────┬────────────┘
                                     │ Delegación de tareas y revisión de planes
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Generación de código en paralelo y llamada a herramientas)
                         └───────────┬────────────┘
                                     │ Invocaciones de herramientas estructuradas
                                     ▼
                [ Local Runtime / Test Suites / File System ]
Para equilibrar la latencia y la profundidad analítica, Hydrogen incorpora cuatro niveles de razonamiento configurables: bajo, medio, alto (predeterminado) y xhigh. Los ajustes más bajos reducen la latencia de respuesta para ajustes sintácticos simples, mientras que los niveles más altos asignan más tokens de razonamiento interno para evaluar casos límite. Los desarrolladores deben tener en cuenta que persisten las limitaciones documentadas: el modelo tiene un límite de conocimiento de marzo de 2026, puede experimentar tiempos de espera ocasionales durante el procesamiento pesado en segundo plano y puede producir alucinaciones o rechazos excesivos en indicaciones ambiguas.
Sistemas desacoplados y compensaciones de la orquestación multi-modelo
La orquestación multi-modelo permite que las plataformas de desarrollo dividan los flujos de trabajo de ingeniería en distintos niveles de modelos. En este patrón, el modelado de sistemas complejos y las evaluaciones de seguridad se delegan a modelos de razonamiento de frontera, mientras que las ediciones de código concretas y las afirmaciones de pruebas se asignan a modelos de ejecución rápida.
Google evaluó este enfoque utilizando el Orchestrator experimental en Google Antigravity. En las pruebas realizadas en Terminal-Bench 4.0, Google informó que el cambio dinámico entre Carbon y Hydrogen logró tasas de éxito de tareas cercanas a las de Carbon, consumiendo un 24% menos de cuota y completando las tareas un 19% más rápido que ejecutando Carbon solo. Google también informó de pruebas tempranas con socios que mostraron una ejecución de 2× a 2.8× más rápida y un uso de tokens entre un 12% y un 23% menor que Gemini 3.8 Flash en flujos de trabajo seleccionados. Por ejemplo, Box informó una ejecución aproximadamente 2× más rápida y un 12% menos de tokens en tareas complejas de documentos y tablas. Estos ejemplos reportados por los proveedores reflejan configuraciones de integración específicas y no representan estimaciones controladas de ahorros en todas las implementaciones de producción.
| Componente del sistema | Herramientas representativas | Responsabilidad definida | Alcance operativo y limitaciones |
|---|---|---|---|
| Coordinador del sistema | Gemini 4 Carbon / Argon | Diseño de arquitectura de alto nivel, planificación entre repositorios, evaluación de lógicas complejas | Alta capacidad de razonamiento; incurre en mayores costos por token y mayor latencia de generación |
| Motor de ejecución | Gemini 4 Hydrogen | Generación de código localizado, ediciones automatizadas de archivos, bucles rápidos de llamadas a herramientas | Alto rendimiento de generación; puede operar de forma independiente o bajo un coordinador |
| Puerta de verificación | Arneses de pruebas unitarias / Analizadores estáticos | Comprobación de reglas deterministas, validación de sintaxis, pruebas de regresión | Verifica afirmaciones definidas y reglas estáticas; la garantía depende de la calidad de las pruebas, la cobertura y la revisión independiente |
Evaluar una arquitectura multi-modelo requiere que los equipos de ingeniería equilibren la complejidad del sistema frente a la eficiencia de ejecución. Si bien el enrutamiento dinámico de modelos puede reducir el gasto de tokens en tareas repetitivas, introduce una sobrecarga de orquestación, desafíos de sincronización de estados entre subagentes y dependencia de clasificadores de enrutamiento. Los equipos de ingeniería deben medir estas compensaciones frente a sus propias distribuciones de tareas, estructuras de repositorios y requisitos de latencia de API.
Listas de verificación de implementación de ingeniería y gobernanza de flujos de trabajo
La integración de Gemini 4 Hydrogen en cadenas de herramientas de desarrollo automatizadas requiere límites de ejecución claros, supervisión de tokens y gobernanza defensiva de agentes.
Lista de verificación para la implementación del desarrollador
- Alinear los niveles de pensamiento con las tareas operativas: Configure los parámetros de esfuerzo de razonamiento según la complejidad de la carga de trabajo. Reserve
xhighpara casos límite algorítmicos complejos, mantengahighcomo la línea base estándar para la navegación de repositorios y usemediumolowpara tareas sensibles a la latencia como el reformateo de código o la búsqueda simple de documentación. - Estructurar interfaces de herramientas en paralelo: Diseñe definiciones de herramientas para aceptar argumentos por lotes cuando el tiempo de ejecución lo admita, lo que permite a los agentes trabajadores solicitar múltiples inspecciones de archivos o verificaciones de sintaxis en solicitudes consolidadas en lugar de viajes de ida y vuelta secuenciales.
- Desacoplar la generación de modelos de la ejecución: Asegúrese de que los modelos propongan invocaciones de herramientas y modificaciones de código como datos estructurados, mientras que un tiempo de ejecución de cliente aislado o un ejecutor de pruebas en contenedores ejecuta los comandos y devuelve los resultados de la ejecución y la evidencia reproducible cuando sea posible.
Lista de verificación de gobernanza empresarial
- Establecer registro de sesiones: Registre solicitudes de herramientas, resultados de ejecución, decisiones de permisos, cambios de código, resultados de pruebas y resúmenes de modelos disponibles. No trate los resúmenes de razonamiento como trazas de ejecución completas o fieles.
- Aplicar controles de seguridad en capas: Trate la documentación externa, los rastreadores de incidencias y los comentarios de solicitudes de incorporación de cambios como entradas no confiables. Si bien Hydrogen demostró una mejora de resistencia de 2.3x en el punto de referencia de inyección de indicaciones indirectas de Gray Swan, la sanitización de entradas automatizada y las puertas de permisos de ejecución siguen siendo necesarias.
- Supervisar el consumo acumulativo de tokens: Realice un seguimiento de los tokens de entrada y los tokens de salida facturables, incluidos los tokens de pensamiento, utilizando los campos de uso de la API seleccionada. No vuelva a sumar los tokens de pensamiento cuando ya estén incluidos en el total facturado de la salida.
Preguntas frecuentes (FAQ)
¿Cómo se compara Gemini 4 Hydrogen con Carbon y Argon en cargas de trabajo de producción?
¿Cuáles son los cuatro niveles de pensamiento y cuándo deben usar los desarrolladores xhigh?
¿Cómo opera el modelo de precios planos en la ventana de contexto de un millón de tokens?
Puntos clave para los equipos de ingeniería
La implementación de herramientas de código autónomas en entornos de producción requiere que los equipos de desarrollo miren más allá de las puntuaciones de los puntos de referencia de frontera y se centren en la economía de la ejecución iterativa de herramientas. Enrutar cada modificación de rutina del código a través de modelos de razonamiento de alta latencia introduce retrasos operativos innecesarios e inflación presupuestaria. Al mismo tiempo, gestionar la latencia de ejecución y las tasas de éxito de las tareas requiere expectativas realistas sobre las puntuaciones de los puntos de referencia y los comportamientos de recuperación de errores.
Al establecer arquitecturas por niveles que combinen modelos de razonamiento de alta capacidad con motores de ejecución rápidos y predecibles, las organizaciones de ingeniería pueden escalar los flujos de trabajo de desarrollo automatizados de manera sostenible. Los equipos que implementen un enrutamiento multi-modelo disciplinado, límites de pruebas estructurados y una rigurosa validación de entradas estarán en la mejor posición para construir canales de software asistidos por IA sólidos y fáciles de mantener.
Referencias
-
Google DeepMind. Introducing Gemini 4 Hydrogen. Anuncio oficial.
-
Google DeepMind. Gemini 4 Hydrogen Model Card. Especificación técnica e informe de seguridad.
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. Referencia técnica.
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. Descripción general de la orquestación multi-modelo.
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. Evaluación de IA independiente.
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. Análisis técnico.
Share this article