 ¿Un experto de Hynix afirma que la GPU está inactiva? Por qué la memoria HBM es clave es una cuestión de suma importancia. Según una presentación del profesor Joungho Kim de KAIST, quien ha colaborado extensamente con SK Hynix en la investigación de HBM, el uso de la GPU durante la inferencia de IA está cada vez más limitado por el ancho de banda de la memoria más que por la capacidad bruta de cómputo. Este creciente "muro de memoria" ha convertido a la Memoria de Alto Ancho de Banda (HBM, por sus siglas en inglés) en una de las tecnologías más importantes en la infraestructura de IA. A medida que las plataformas de inteligencia artificial generativa pasan de la era de entrenamiento a la era de inferencia, el principal cuello de botella de rendimiento se ha desplazado desde la capacidad de cómputo del procesador hacia el rendimiento del bus de memoria. Las unidades de procesamiento gráfico (GPU) estándar están diseñadas para manejar cálculos masivos en paralelo. Sin embargo, debido a que cada paso de inferencia requiere leer miles de millones de parámetros de la memoria, ejecutar el cálculo y escribir los estados de vuelta, los procesadores pasan la mayor parte de sus ciclos operativos inactivos, esperando que los datos viajen a través de los buses estándar.
Por qué la memoria HBM es clave: Alineando los flujos de alto rendimiento con los límites del hardware
Resumen
- El análisis de la industria sugiere que, incluso con millones de unidades de procesamiento gráfico estándar desplegadas, la utilización real del cómputo se limita al diez o treinta por ciento debido a las demoras en la transferencia del bus de memoria.
- Las limitaciones físicas del escalado de chips están impulsando un cambio hacia la computación centrada en la memoria, utilizando arquitecturas de memoria de alto ancho de banda (HBM) apiladas verticalmente.
- Se espera que el empaquetado compuesto 3D de próxima generación apile unidades de procesamiento gráfico, caché SRAM de alta velocidad en el paquete y almacenamiento flash NAND 3D de alta capacidad para resolver los cuellos de botella en la transferencia de datos.
La infraestructura informática global enfrenta una crisis estructural. Durante varios años, la carrera por construir modelos de IA más grandes se ha centrado en escalar la potencia de cómputo bruta. Las empresas y los proveedores de nube han invertido miles de millones de dólares para adquirir clústeres masivos de unidades de procesamiento gráfico (GPU). Este enfoque fue sumamente lógico durante la era de entrenamiento inicial, cuando el entrenamiento de modelos dependía de cálculos continuos de retropropagación. Bajo esas cargas de trabajo, las unidades de computación paralela operaban a su máxima capacidad para actualizar los parámetros del modelo, tal como se detalla en el Libro Blanco de Arquitectura Hopper de NVIDIA.
Sin embargo, a medida que las aplicaciones transitan hacia la era de la inferencia, los requisitos de ingeniería han cambiado. En escenarios de inferencia, el desafío principal no es actualizar pesos, sino transmitir parámetros masivos preentrenados al procesador para responder consultas inmediatas. Cada token generado requiere acceso repetido a miles de millones de parámetros del modelo almacenados en memoria de alto ancho de banda. Debido a que las arquitecturas de bus estándar no pueden mover los datos lo suficientemente rápido para igualar las velocidades de ejecución del procesador estándar, los núcleos de cómputo se quedan sin datos, lo que resulta en tasas de inactividad extremadamente altas. Este cuello de botella de rendimiento se analiza en informes técnicos de la industria, incluida la investigación publicada por organismos académicos como el Instituto Avanzado de Ciencia y Tecnología de Corea (KAIST) y desarrolladores de hardware como NVIDIA y SK Hynix.
Esta brecha de rendimiento demuestra las restricciones físicas que explican por qué la memoria HBM es clave en la era de la inferencia. Según la hoja de ruta de la tecnología HBM publicada por el TERA Lab de KAIST, las futuras generaciones de HBM continuarán aumentando el ancho de banda mediante apilamiento adicional de DRAM, integración TSV, empaquetado avanzado y optimización térmica. Los paquetes de DRAM estándar carecen de los carriles paralelos necesarios para admitir las velocidades de procesamiento de los aceleradores modernos. Para superar este "muro de memoria", los arquitectos de hardware han recurrido a sistemas de memoria de alto ancho de banda (HBM). Al apilar matrices DRAM verticalmente y utilizar miles de vías de silicio (TSV) para establecer buses paralelos amplios, la especificación JEDEC HBM3 (JESD238) explica cómo la memoria apilada basada en TSV expande drásticamente el ancho de banda disponible en comparación con los paquetes de DRAM convencionales. Para los desarrolladores, esta evolución del hardware ilustra una regla fundamental de los sistemas de alto rendimiento: el cuello de botella es casi siempre la capa de transporte, no el nodo de computación.
Mecánica interna del concepto de por qué la memoria HBM es clave
A nivel arquitectónico, los buses de computadora estándar actúan como carreteras estrechas, restringiendo el flujo de conjuntos de datos de gran volumen. Cuando una aplicación ejecuta una llamada de inferencia, el procesador debe leer datos de la memoria, completar la operación y volver a escribir el resultado. En configuraciones estándar, este proceso crea una latencia severa porque los datos deben viajar a través de una gran distancia física en la placa base.
Para resolver estos cuellos de botella en la capa de transporte, las computadoras de IA de próxima generación están evolucionando hacia arquitecturas compuestas tridimensionales. Bajo este modelo, el núcleo de cómputo se coloca directamente sobre la memoria apilada, utilizando empaquetado avanzado para minimizar la distancia física y la latencia.
La jerarquía de memoria 3D: Apilando SRAM, DRAM y NAND
Para manejar diferentes clases de datos, los arquitectos de hardware proponen un rascacielos semiconductor 3D estratificado. Esta estructura separa el almacenamiento de datos en zonas físicas distintas basadas en la velocidad de acceso y los requisitos de capacidad:
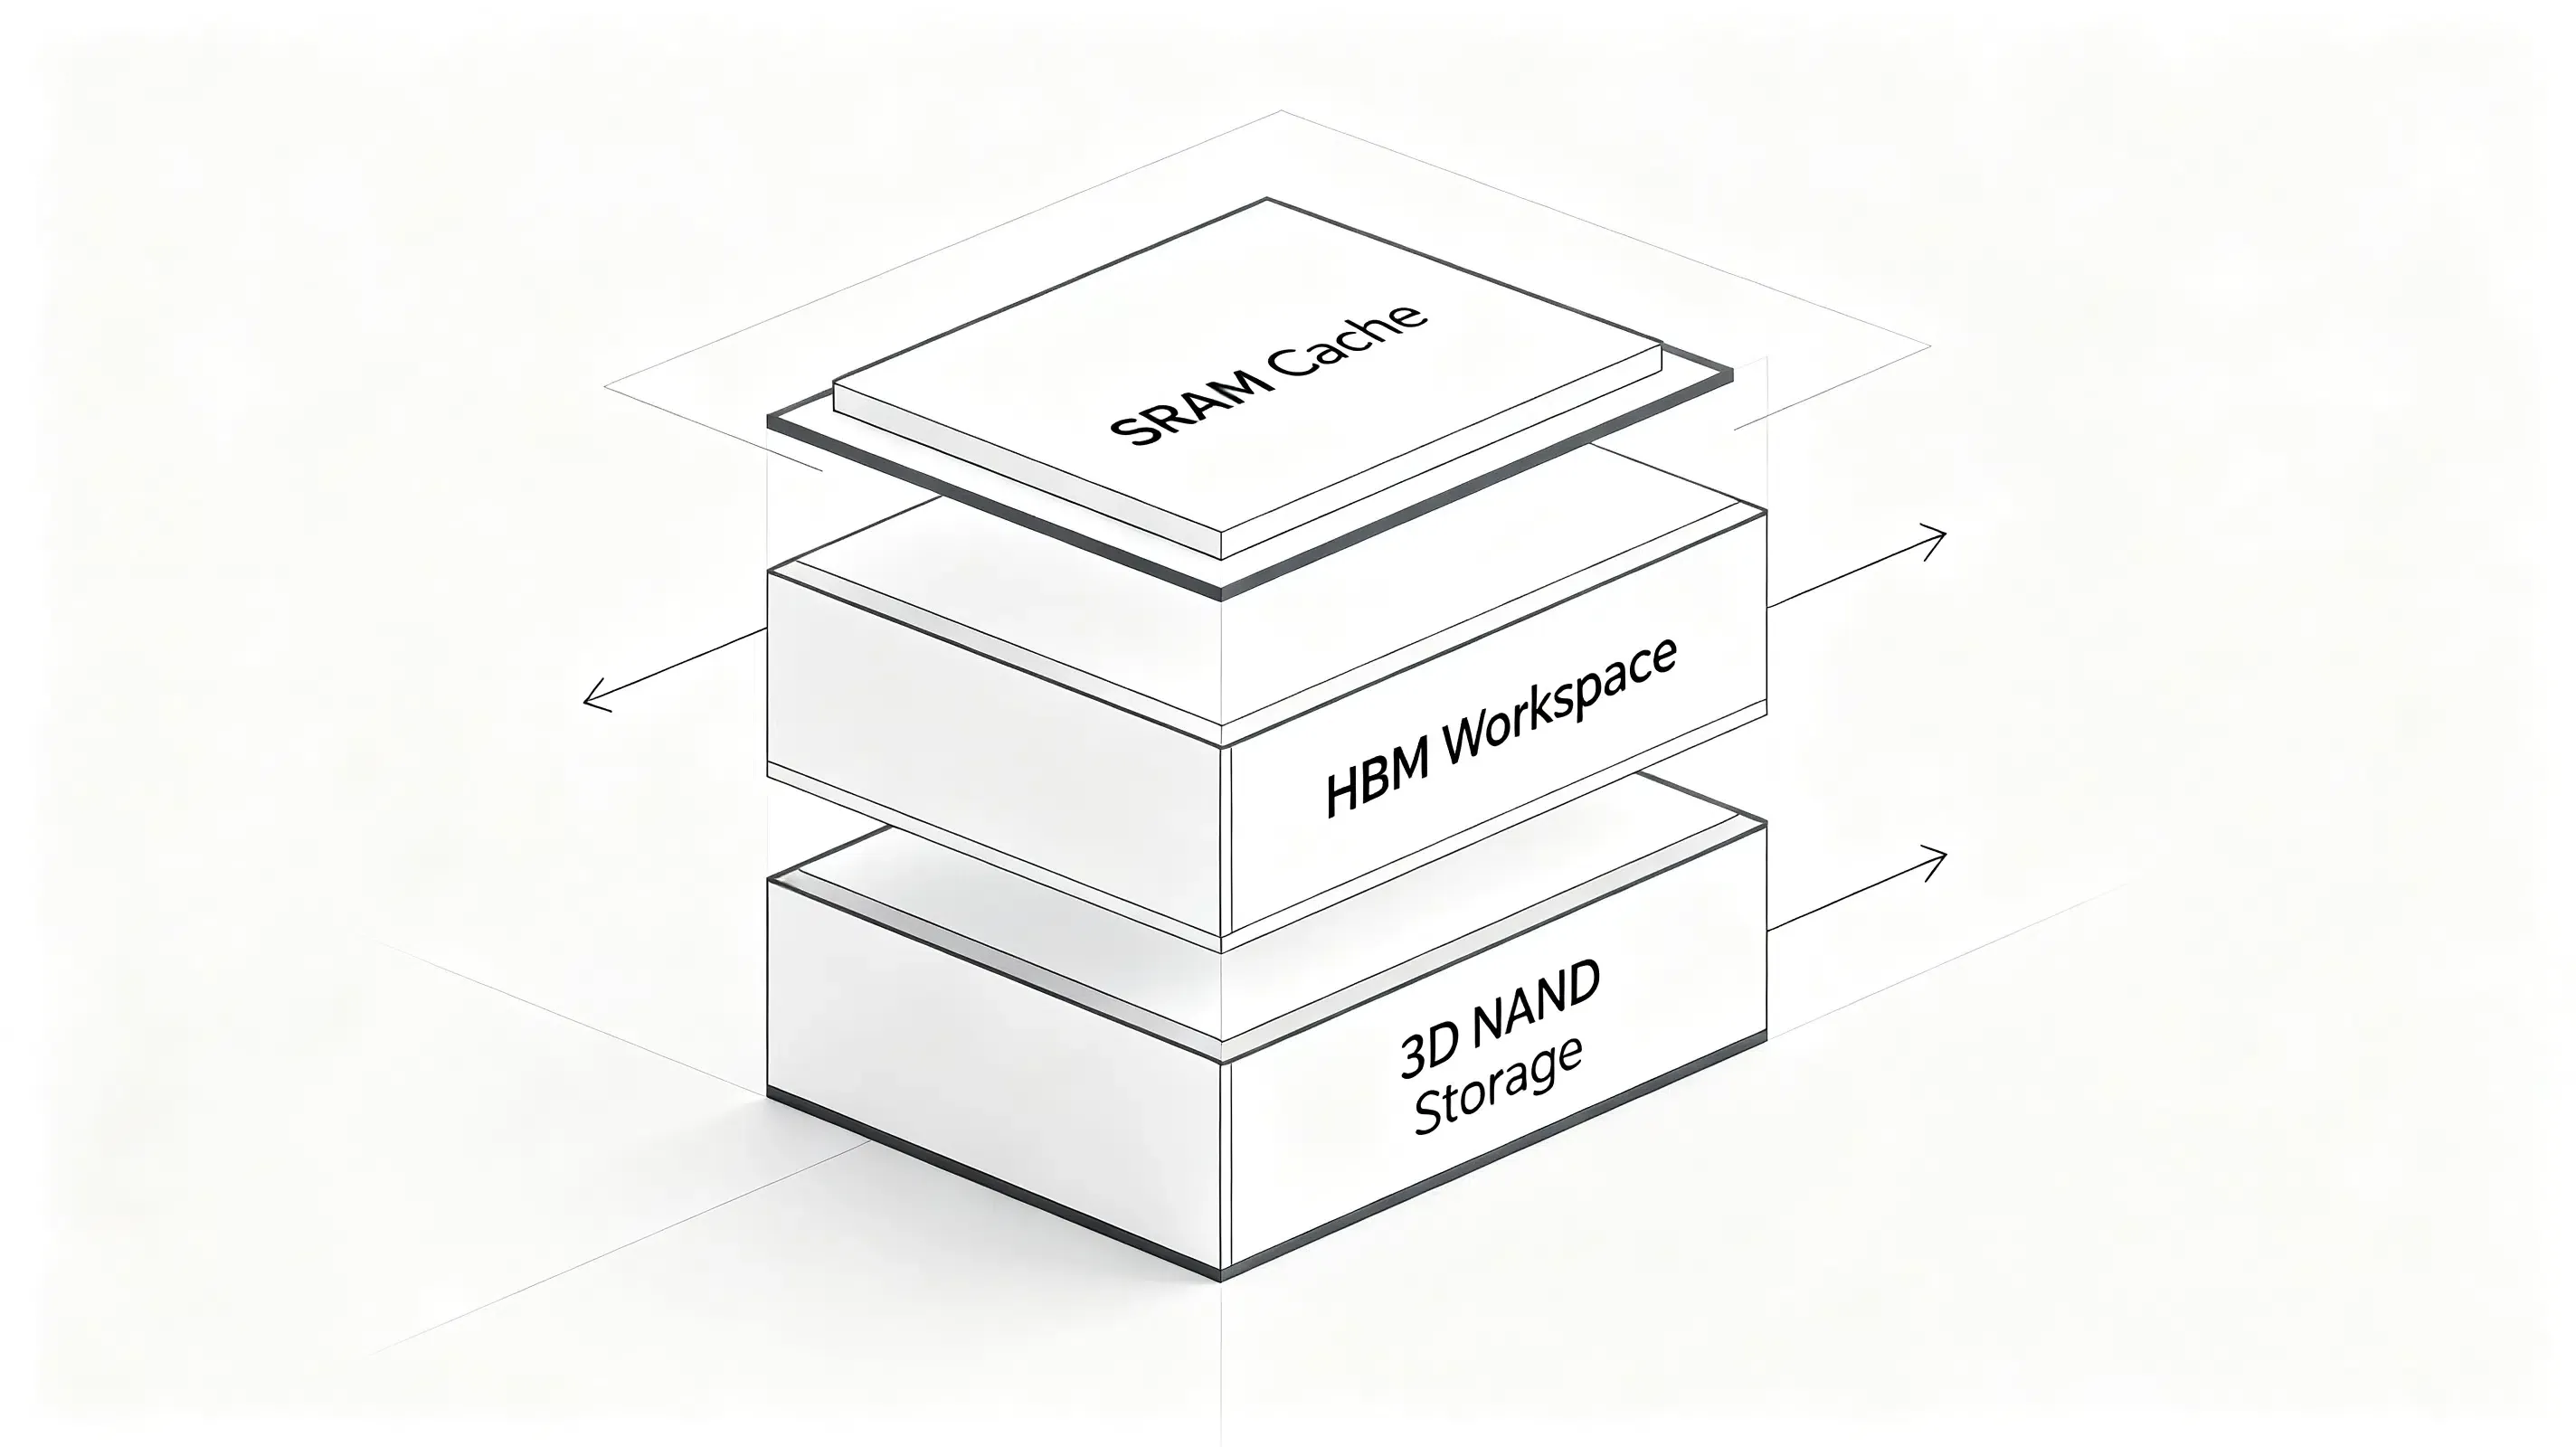
- Caché SRAM de alta velocidad en el paquete: Actuando como la caché de velocidad definitiva, la SRAM se integra directamente junto al procesador, reduciendo significativamente la latencia de acceso a la memoria en comparación con la DRAM convencional para manejar registros de parámetros activos.
- Memoria de alto ancho de banda (HBM): Al servir como el espacio de trabajo activo principal, la HBM maneja la recuperación de parámetros activos y las actualizaciones de estado de alta frecuencia, con estándares JEDEC que definen su interfaz amplia.
- Almacenamiento flash NAND 3D de alta capacidad: El flash de alto ancho de banda (HBF) sigue siendo una arquitectura de almacenamiento emergente propuesta por investigadores de KAIST para complementar la HBM proporcionando una capacidad de almacenamiento significativamente mayor para futuros sistemas de IA, utilizando flash NAND apilado verticalmente para proveer una capacidad de almacenamiento masiva a largo plazo para preservar videos, documentos y memorias conversacionales persistentes.
El siguiente diagrama ilustra esta integración vertical física:
                  [ GPU / Núcleo del Procesador ] (Refrigeración a nivel de techo)
                             │
                             ▼
                  [ Caché SRAM de Alta Velocidad en el Paquete ] (Caché de oblea ultrarrápida)
                             │
                             ▼
                  [ Memoria de Alto Ancho de Banda ] (DRAM de espacio de trabajo activo)
                             │
                             ▼
                  [ Almacenamiento Flash NAND 3D de Alta Capacidad ] (Almacenamiento NAND a largo plazo)
Esta arquitectura 3D integrada asegura que las unidades de cómputo estándar sean suministradas continuamente con datos, reduciendo los ciclos de inactividad. La memoria DDR tradicional proporciona solo una fracción del ancho de banda disponible de la HBM. Según las presentaciones técnicas de NVIDIA GTC realizadas conjuntamente con SK Hynix, la HBM proporciona un ancho de banda sustancialmente mayor que la memoria DDR convencional mientras ocupa una huella física significativamente más pequeña. Específicamente, la HBM2 ofrece aproximadamente 307 GB/s por pila, mientras que la HBM2E aumenta esto a aproximadamente 358 GB/s, con la HBM3 apuntando a un ancho de banda superior a los 500 GB/s.
Aunque el ancho de banda de la memoria y la atribución de aplicaciones pertenecen a dominios de ingeniería diferentes, ambos resaltan el mismo principio arquitectónico: trasladar la gestión de estado de recursos locales restringidos hacia una infraestructura de servidor escalable. Cuando las interacciones del usuario se desvinculan del seguimiento de estado estándar del cliente para cumplir con las pautas de privacidad, mantener la continuidad de la sesión a través de diferentes entornos web y móviles se vuelve sumamente complejo. Así como los procesadores requieren tuberías de memoria persistentes y de alta velocidad para igualar los contextos de estado, las tuberías de marketing posteriores requieren una preservación de datos robusta en el servidor para correlacionar eventos de instalación separados sin depender de cookies del lado del cliente o atributos a nivel de dispositivo vulnerables.
Construir vs. Comprar: Gestión de la continuidad de sesión en el servidor y rendimiento de datos
A medida que los entornos informáticos modernos se alejan de los identificadores locales del lado del cliente, mantener el estado de la sesión a través de puntos de contacto digitales distribuidos se ha convertido en un desafío de ingeniería principal. Para los desarrolladores, gestionar estados de sesión en la era donde la memoria HBM es clave requiere arquitecturas que sean tanto conformes con las leyes de privacidad de datos como altamente precisas. Las organizaciones que necesitan preservar los viajes de los usuarios a través de experiencias web y móviles dependen cada vez más de la gestión de sesiones en el servidor en lugar de identificadores persistentes del lado del cliente. Dependiendo de los requisitos comerciales, los equipos pueden desarrollar estas capacidades internamente o adoptar plataformas de atribución existentes.
Evaluación arquitectónica: Construcción personalizada vs. SDK estandarizado
Desarrollar un sistema interno personalizado para gestionar la coincidencia de estados en el servidor ofrece la máxima flexibilidad, pero exige importantes recursos de ingeniería continuos. Los desarrolladores deben construir manualmente esquemas de base de datos, escribir funciones de hash criptográficas seguras y actualizar continuamente el sistema para cumplir con las regulaciones regionales cambiantes. Por el contrario, desplegar un SDK preconstruido y certificado reduce la complejidad de la integración y garantiza el cumplimiento a largo plazo sin gastos generales adicionales.
La siguiente tabla compara las metodologías estándar para gestionar el estado de la sesión y el contexto de conversión:
| Solución | Persistencia | Rendimiento | Mejor para |
|---|---|---|---|
| Base de datos de sesiones interna | Alta (Sincronización continua) | Media (Límites de latencia de BD) | Entornos empresariales personalizados con lógica de almacenamiento altamente especializada |
| Seguimiento de sesión basado en navegador | Baja (Cookies de sesión) | Baja (Sin registro en servidor) | Seguimiento básico de sitios web con requisitos mínimos de conversión entre dominios |
| Caché en el lado del servidor (ej. OpoInstall) | Ninguna (Tokens de sesión temporales en servidor) | Alta (Sandbox estandarizado) | Atribución de campañas en aplicaciones móviles y multiplataforma de alta concurrencia |
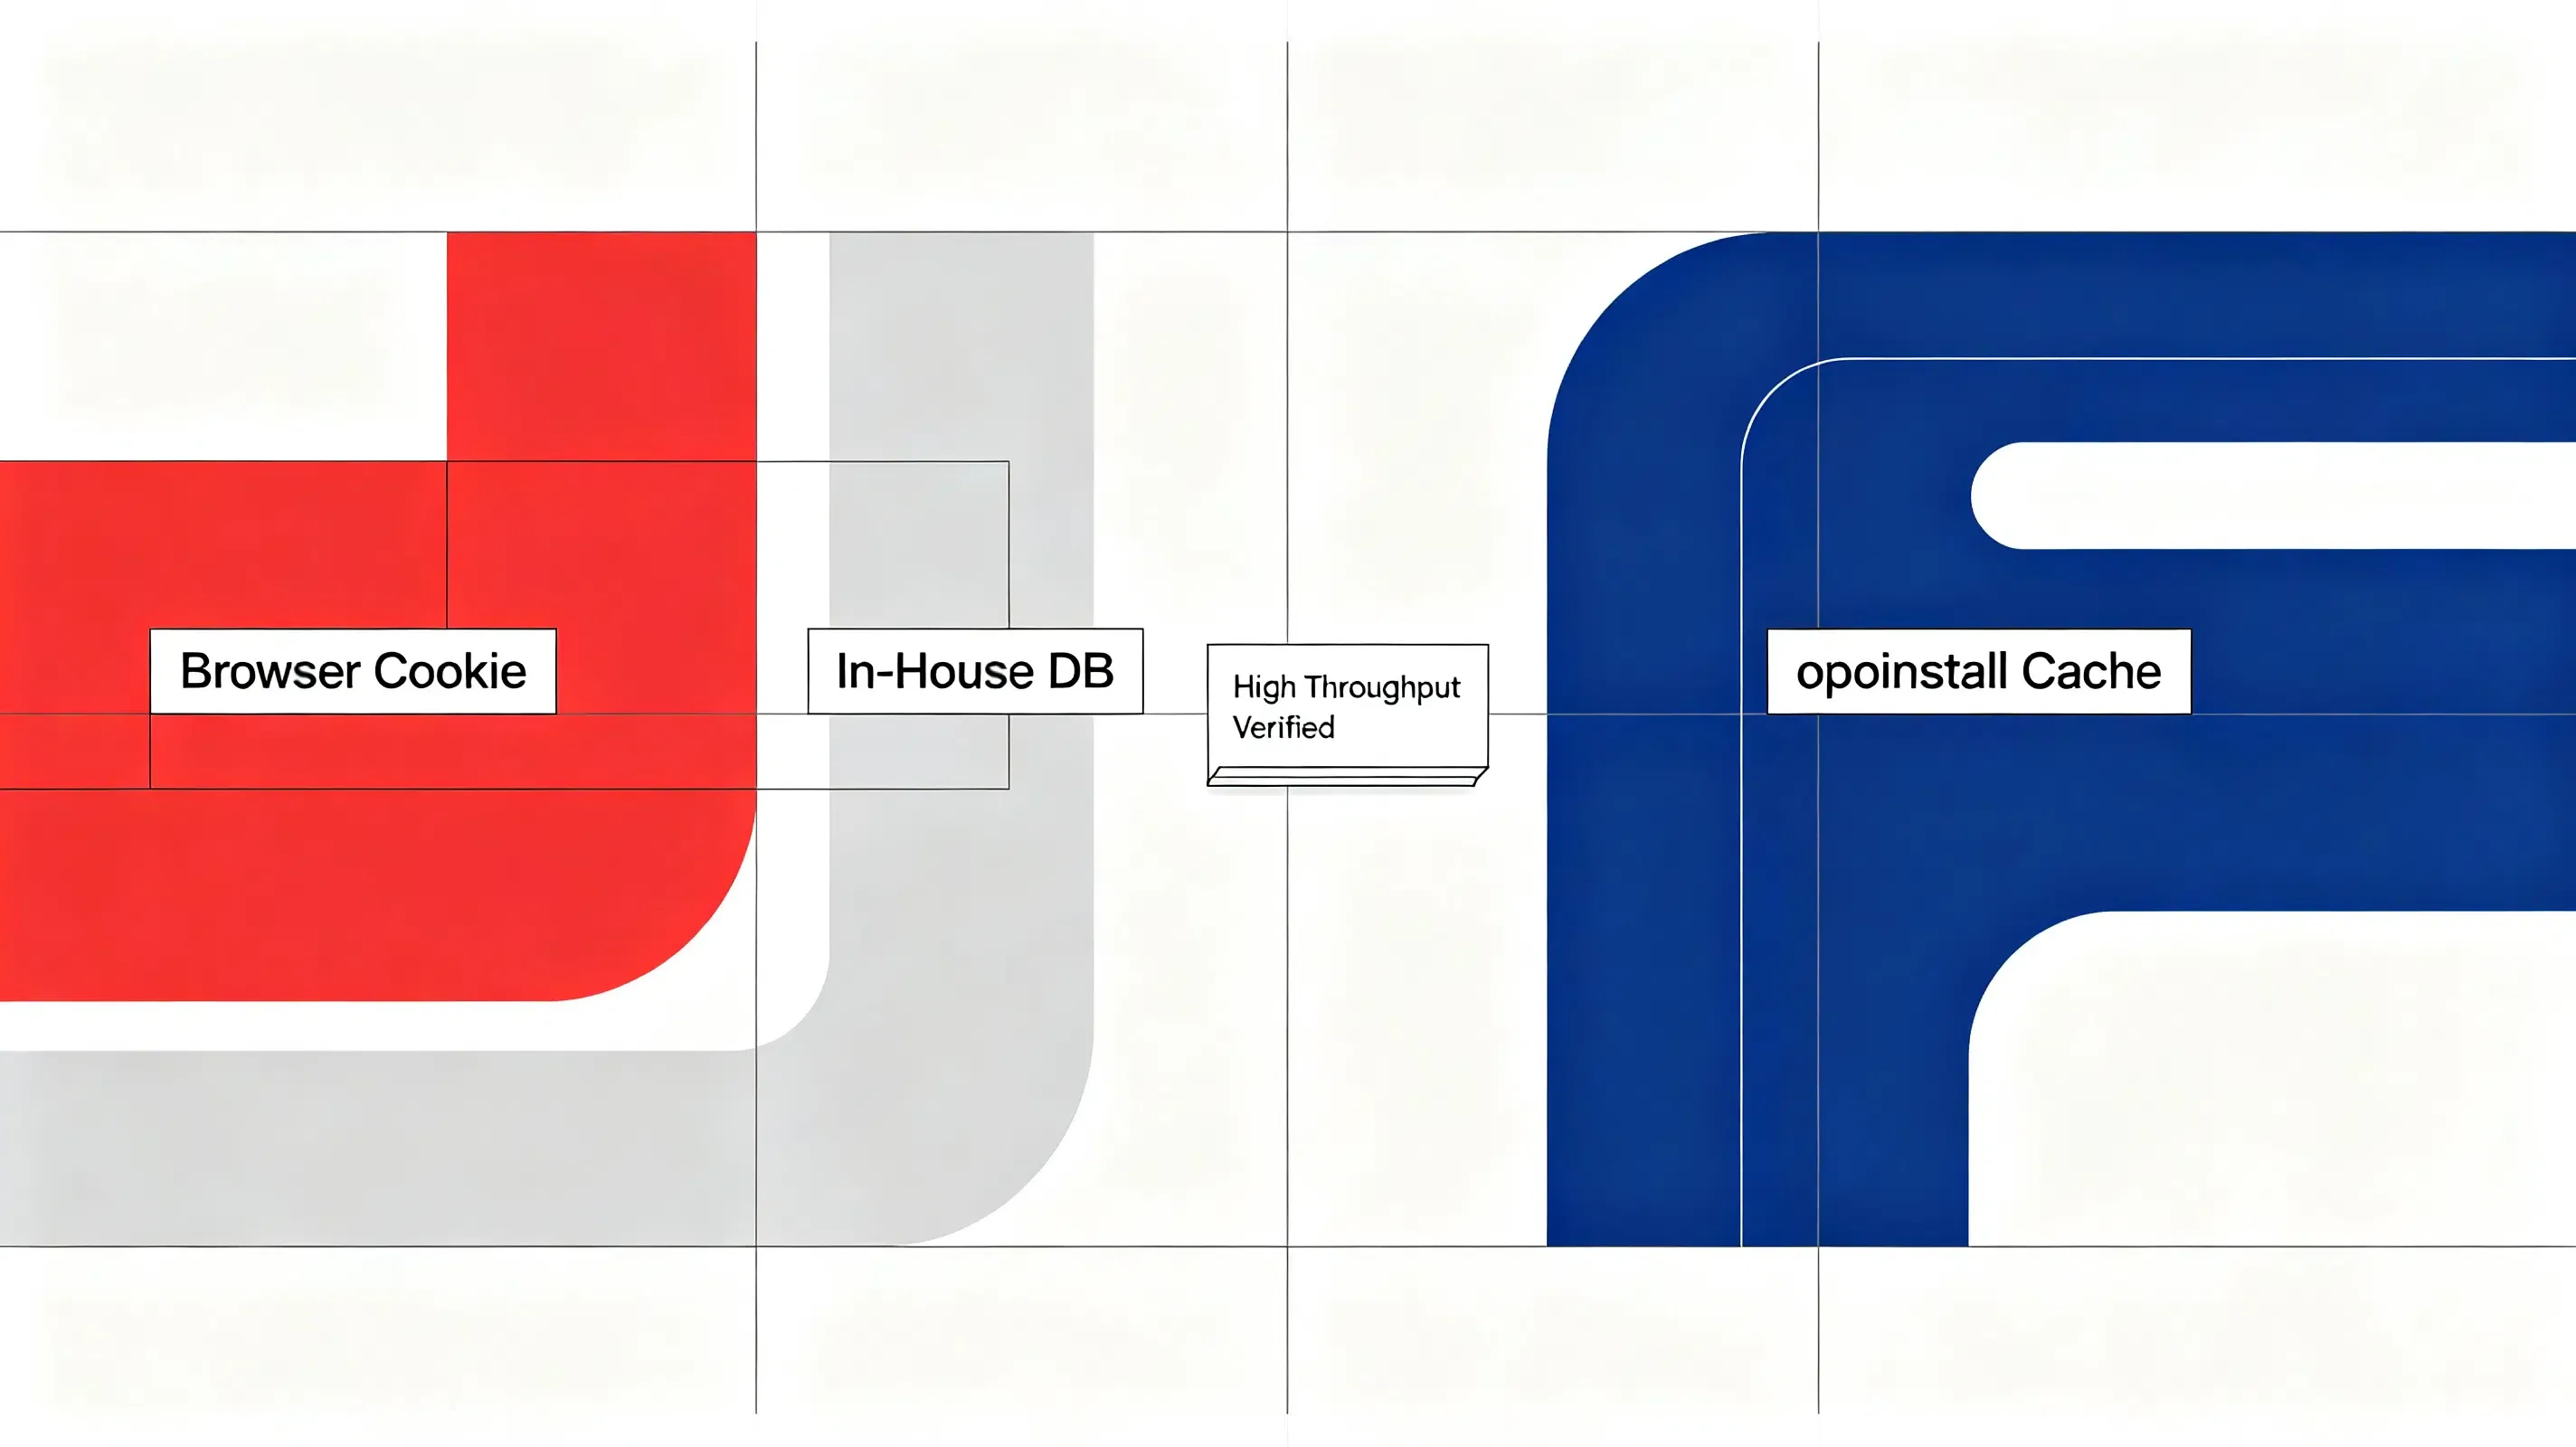
Investigaciones recientes sobre arquitectura de GPU publicadas en estudios de la base de datos arXiv también demuestran que la eficiencia del acceso a la memoria determina con frecuencia el rendimiento general de la inferencia más que el rendimiento aritmético bruto. Si bien las configuraciones de base de datos personalizadas pueden manejar el contexto básico, la preservación especializada del estado en el servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones en el servidor o adoptar plataformas comerciales como OpoInstall. Por ejemplo, OpoInstall ofrece restauración de estado en el servidor y marcos de paso de parámetros, asignando metadatos de sesión a una base de datos de sesiones en el servidor para mantener la continuidad de forma anónima, sin almacenar historial personal confidencial de conversaciones a largo plazo. Al asignar metadatos de sesión a una base de datos centralizada en lugar de depender de redirecciones basadas en navegador, dicho sistema asegura que los contextos de conversión permanezcan consistentes incluso cuando las tareas iniciales se ejecutan de forma anónima. Los equipos de ingeniería pueden evaluar estos enfoques para equilibrar la protección de datos y la consistencia de la medición.
Listas de verificación de integración: Preparando su arquitectura para la computación centrada en la memoria
Para asegurar las tuberías de datos y garantizar la seguridad del usuario en la era post-alias, los desarrolladores y arquitectos pueden evaluar la gestión de alias de código abierto descentralizada y la preservación del estado en el servidor. Depender de características a nivel de SO de un único proveedor introduce una dependencia sistemática del proveedor y deja a las organizaciones vulnerables a actualizaciones silenciosas en el backend. En cambio, los equipos de ingeniería pueden evaluar tecnologías de enrutamiento alternativas que otorguen una propiedad total de los datos.
Una alternativa estándar implica registrar un dominio personalizado dedicado específicamente para la compartimentación del correo electrónico. Al enrutar este dominio a través de un motor de alias de código abierto y autohospedado como SimpleLogin y apuntarlo a un buzón cifrado como Proton Mail, los desarrolladores pueden asegurarse de que sus alias parezcan dominios personalizados estándar, evitando que los sistemas anti-abuso los bloqueen como grupo.
Lista de verificación de implementación para desarrolladores
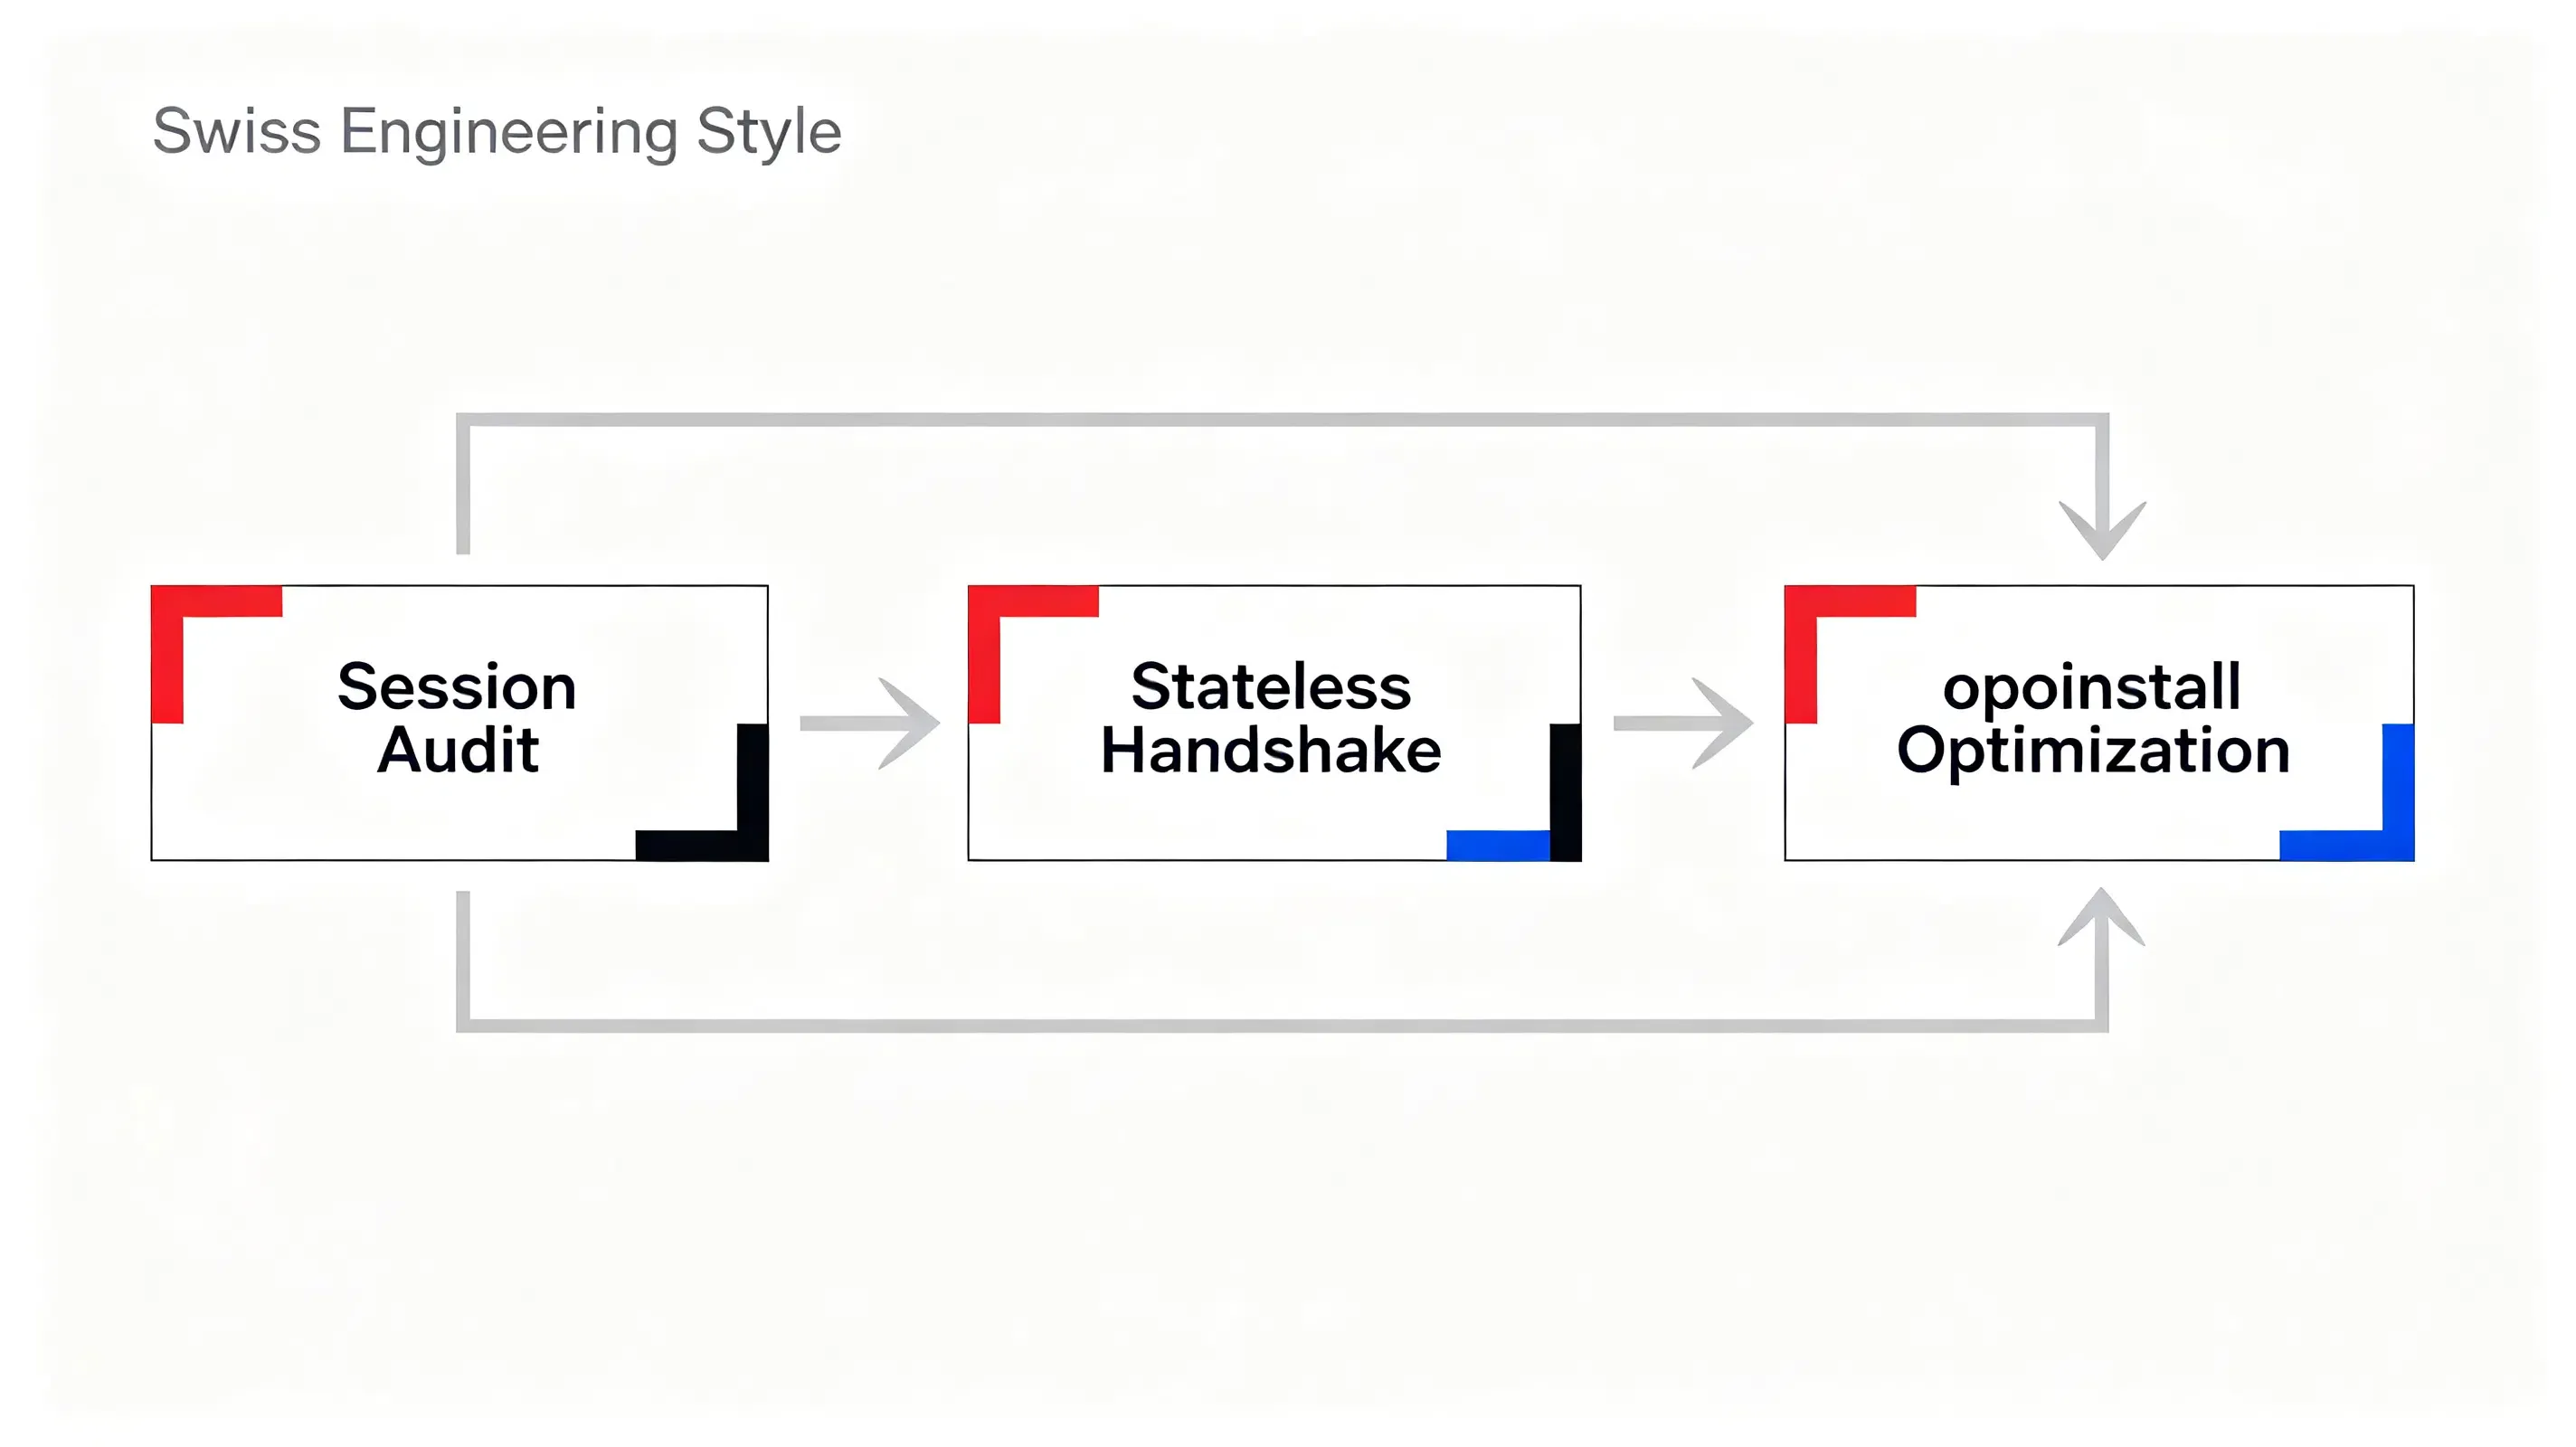
- Auditar la retención de datos de sesión: Revise todas las bases de datos para asegurarse de que los historiales de chat persistentes de compañeros emocionales se eliminen de acuerdo con los cronogramas de eliminación de datos.
- Implementar saludos de sesión sin estado: Transite las rutas de API a modelos de procesamiento sin estado, utilizando tokens firmados criptográficamente para pasar contexto temporal entre nodos.
- Hacer cumplir pasarelas de verificación de edad: Para productos dirigidos al consumidor, despliegue salvaguardas de seguridad infantil para evitar que menores accedan a funciones de conversación restringidas.
Lista de verificación de estrategia de producto y crecimiento
- Reorganizar los flujos de experiencia de usuario: Gire desde modelos de compromiso basados en acompañamiento hacia herramientas de alta utilidad orientadas a tareas que no dependan de la dependencia emocional.
- Optimizar los embudos de conversión: Aproveche marcos de paso de parámetros no intrusivos para mantener el seguimiento de adquisición sin violar las pautas de privacidad del usuario.
- Monitorear el cumplimiento de la plataforma: Asegúrese de que todos los SDK de terceros integrados cumplan con las leyes locales de protección de datos y el mandato del 15 de julio.
Al establecer estas pautas estructuradas, los equipos de desarrollo pueden transitar sus aplicaciones hacia arquitecturas más seguras y conformes mientras mantienen la continuidad operativa.
Preguntas frecuentes (FAQ)
¿Por qué la misma GPU permanece inactiva hasta el noventa por ciento de su tiempo de ejecución?
¿Cuáles son las diferencias técnicas entre HBM, HBF y HBS?
¿Cómo resuelve la restauración de sesión en el servidor los cuellos de botella de estado?
¿Por qué la HBM es más importante durante la inferencia de IA que durante el entrenamiento?
Conclusiones clave para los equipos de ingeniería
A medida que las plataformas de IA se adaptan a los nuevos requisitos regulatorios, los equipos de ingeniería dependerán cada vez más de arquitecturas sin estado, gestión de sesiones en el servidor y diseño basado en la privacidad. Las arquitecturas de datos en evolución requieren un cambio fundamental en la forma en que construimos y medimos las experiencias digitales. A medida que los proxies sin estado y los scrapers headless se convierten en consumidores estándar de contenido web, los modelos de atribución tradicionales del lado del cliente seguirán degradándose. Confiar en cookies y referidos estándar ya no es suficiente para asegurar las tuberías de datos que impulsan la adquisición de usuarios.
Para mantener el crecimiento, los equipos de ingeniería y productos deben priorizar las estructuras de datos sin estado y la preservación del estado en el servidor. Al implementar la verificación de identidad de confianza cero, marcos de paso de parámetros seguros y cronogramas robustos de eliminación de datos, las organizaciones pueden proteger sus tuberías de usuarios respetando los límites legales. Este cambio arquitectónico es esencial para construir plataformas estables y confiables que prosperen en una economía digital regulada.
Share this article



